WAF 防火牆完整指南:應用層防護原理、部署選擇與 SEO 爬蟲誤擋排查
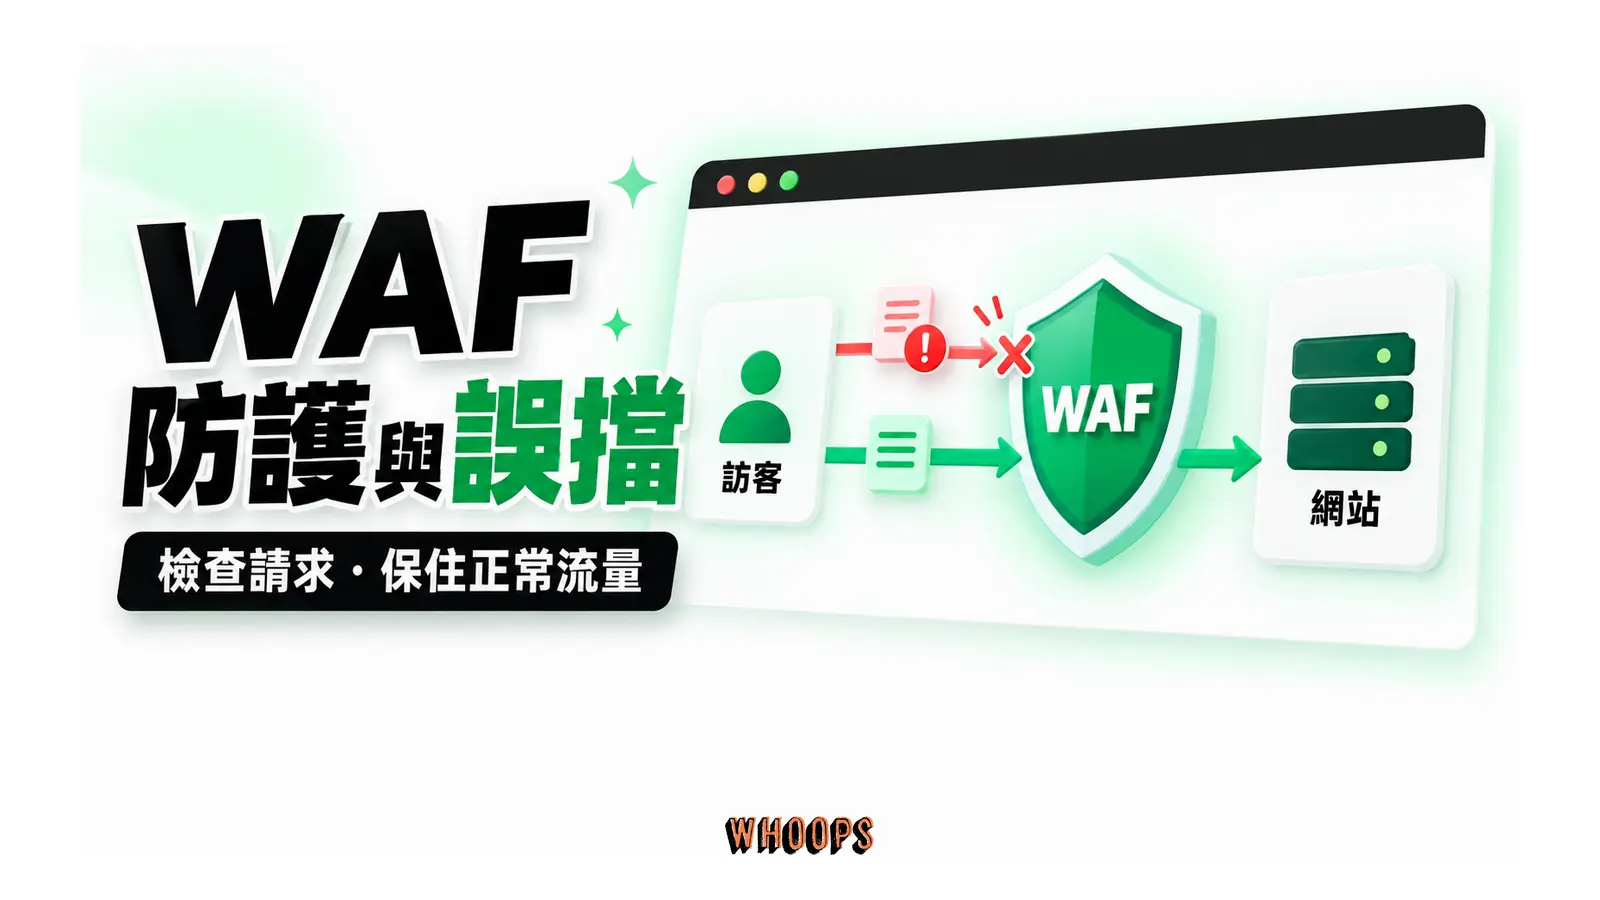
WAF(網頁應用程式防火牆)在應用層檢查每筆 HTTP/HTTPS 請求的內容,依規則放行、阻擋、計數或要求挑戰。本文從運作原理、檢查上限、三種部署方式講到誤擋排查,並整合爬蟲視角:403/429 對索引與 AI 引用的影響、Googlebot 反向 DNS 驗證與 robots.txt 的分工界線。
WAF(Web Application Firewall,網頁應用程式防火牆)是一道架在訪客與網站之間的請求檢查層:每一筆 HTTP/HTTPS 請求都會先經過它比對規則,判斷放行、阻擋、記錄或要求驗證,然後才被轉交給網站程式處理。它和一般防火牆最本質的差異在於檢查的層級:一般網路防火牆看「這條連線從哪來、要通往哪個埠」,WAF 看的是「這筆請求的內容長什麼樣子」,也就是 OSI 模型裡的第七層、應用層。這個定位決定了它的兩面:它擋得住藏在表單與網址裡的攻擊特徵,也可能在你沒注意到的地方,把不該擋的請求一起擋下來。
先講兩個會直接改變你判斷的條件。第一,買了 WAF 不等於流量真的經過 WAF:雲端式部署需要 DNS 或代理設定正確引導流量,主機式部署需要規則真的啟用,任何一段沒接上,防護就只是帳單上的名目。第二,WAF 的規則不是全知的:它只檢查它看得到的請求內容,而且多數服務對可檢查的本文大小設有上限(後面會給具體數字),超過上限的部分它其實沒有讀。把這兩個限制放在心裡,你對 WAF 的期待才會落在對的位置。
這篇指南走一條跟多數資安文章不同的路線:除了把 WAF 的原理、規則動作、部署方式與誤擋排查講清楚,還會把一個常被忽略的後果拉到主線:WAF 誤擋的不只是客人,還有搜尋引擎與 AI 服務的爬蟲。爬蟲被 403 擋在門外,Google 不會索引那個頁面;被 429 壓慢,Googlebot 會暫時降低對整個網站的抓取步調。對靠內容獲客的網站來說,「防護規則擋到爬蟲」和「防護規則漏掉攻擊」都可能造成重大損失,值得放進同一套變更風險管理裡衡量。文中 Cloudflare、AWS 與 Google 的官方口徑,均以 2026 年 10 月查閱的文件版本為準。
WAF 是什麼?從一筆請求的旅程說起
拆開名字就懂了一半。防火牆(Firewall)負責在門口做檢查,WAF 的 W 是 Web Application:它專門檢查「網頁應用程式」收到的請求。當訪客在你的網站搜尋商品、填聯絡表單、登入會員,瀏覽器送出的不只是一個網址,還包含請求方法、一串標頭、可能還有一包提交資料。這些內容全部走 HTTP 或 HTTPS 協定,也就是 WAF 的管轄範圍。
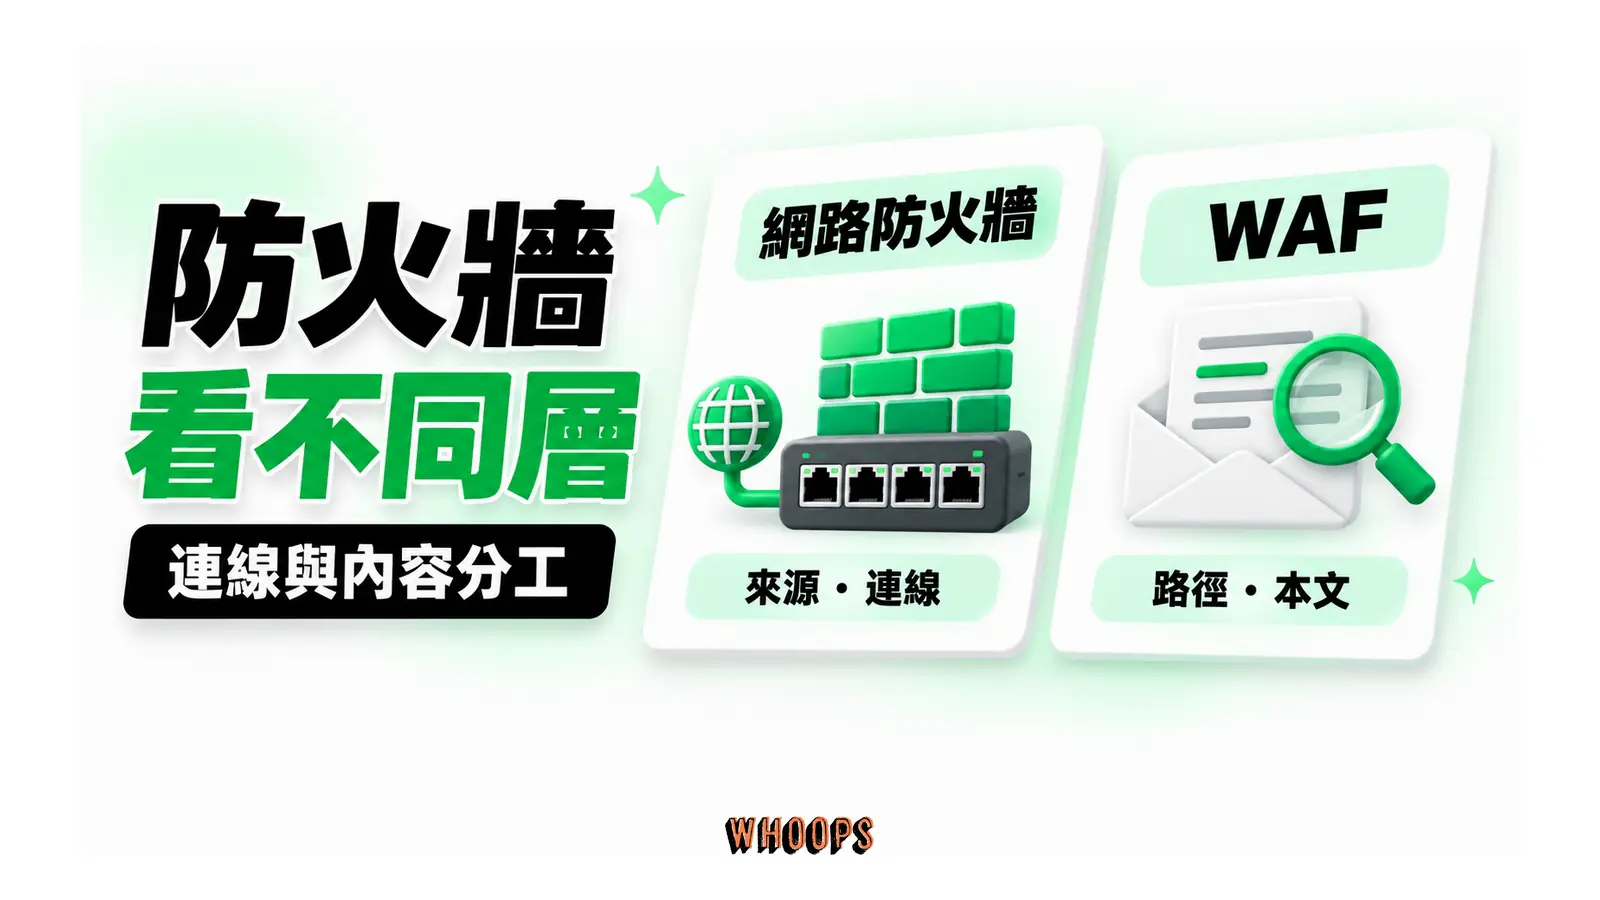
Cloudflare 對 WAF 的定義很直白:它檢查進站的網頁與 API 請求,根據 IP 位址、URL 路徑、標頭、本文內容這類請求屬性過濾流量。注意這個清單的指向性:來源、去處、身分宣告、提交內容,都屬於「這筆請求本身」的資訊;至於這條網路連線從哪個埠進來,交給網路層的防火牆去管。一般防火牆規則的典型寫法是「允許某個 IP 段連到 443 埠」,WAF 規則的典型寫法是「如果查詢參數裡出現 SQL 指令片段,就阻擋這筆請求」。一個看門牌,一個看信件內容。
所以「WAF 是防火牆嗎」這個常見疑問,答案是要看「防火牆」這個詞在你句子裡指哪一層。它確實是防火牆家族的成員,也常被稱為應用層防火牆或第七層防火牆;但它跟公司機房裡那台管控網路流量的設備、跟主機上用 iptables 寫的規則,不是互相取代的關係。網路層的防火牆問「這個來源可以連進來嗎」,WAF 問「這筆請求的內容有沒有問題」。網站同時需要兩種問題都有人回答。
還有一個名稱上的小陷阱值得先說:WAF 裡的 F 已經是防火牆(Firewall),所以「WAF 防火牆」這個說法嚴格來說重複了一個詞,但它在台灣的搜尋與口語裡就是最普遍的講法,本文標題也跟著這個用法走。你在向主機商或廠商詢問時,用 WAF、網頁應用程式防火牆、應用層防火牆指的都是同一類東西。
一筆請求進站,WAF 到底檢查什麼
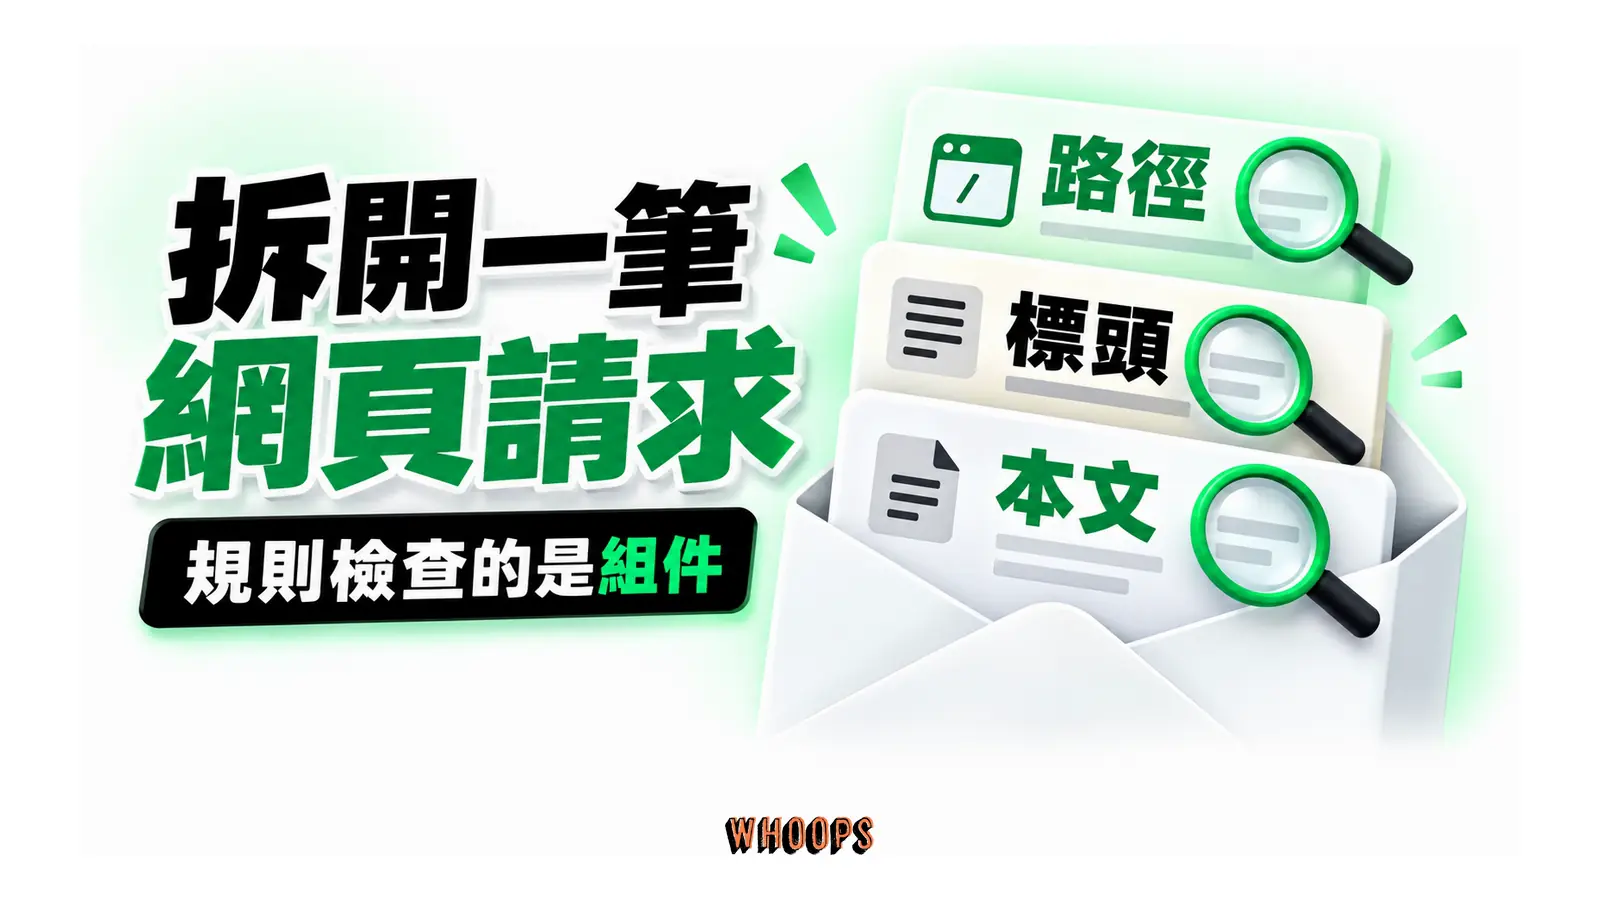
具體拆解一筆 HTTP 請求的組成,你才知道規則能在哪些地方發揮作用。以 AWS WAF 的文件為例,它可以檢查的請求組件涵蓋:HTTP 方法、單一或全部標頭、標頭順序、Cookie、URI 路徑與片段(片段僅限 CloudFront 與 ALB 前緣)、查詢字串與個別查詢參數、請求本文(純文字或解析後的 JSON),甚至包含從 TLS 交握衍生的 JA3 與 JA4 指紋。這兩個指紋是客戶端 TLS 設定的雜湊值,常用來辨識特定的自動化工具。對照到實際情境:
左右捲動檢視完整表格
| 受檢組件 | 實際內容 | 規則能問的問題 |
|---|---|---|
| URI 路徑 | /products/123、/wp-login.php | 請求是否正在摸不該公開的入口 |
| 查詢字串與參數 | ?s=筆電&sort=price | 搜尋與篩選值裡有沒有夾帶指令 |
| 請求標頭 | User-Agent、Referer、Authorization | 身分宣告與來源是否異常或偽造 |
| Cookie | 工作階段識別、偏好設定 | 工作階段是否被固定或重放 |
| 請求本文 | 表單欄位、JSON API payload | 提交內容是否含攻擊特徵 |
| TLS 指紋 | JA3/JA4 雜湊 | 客戶端是否為特定腳本或工具 |
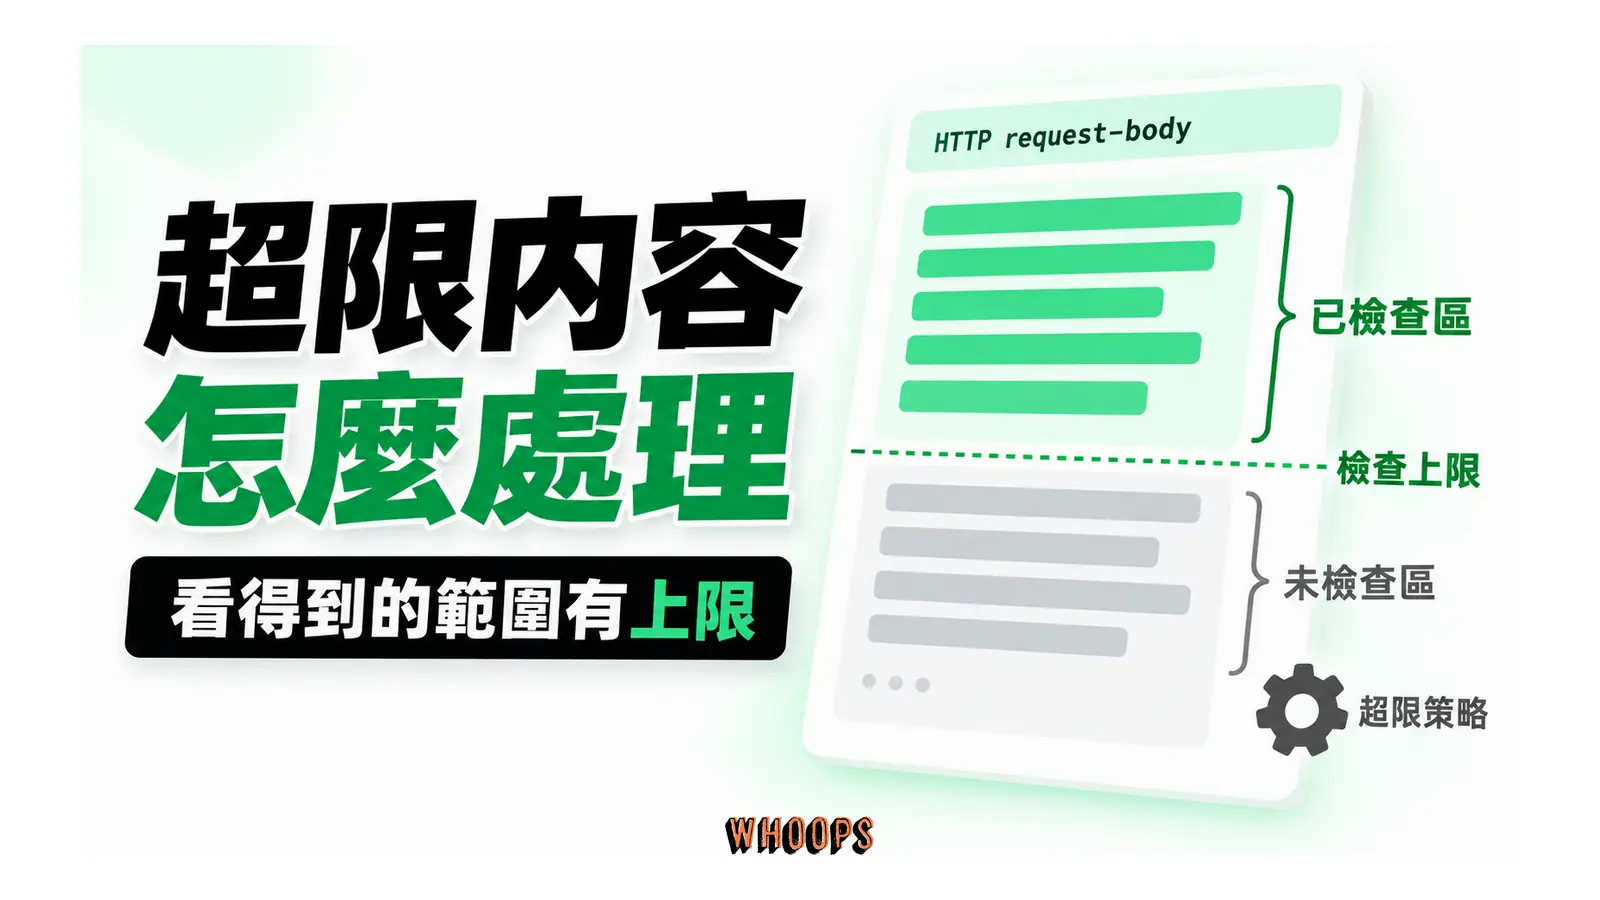
但「可以檢查」不等於「全部都看得到」,這是許多導入討論裡被跳過的一件事。AWS WAF 的請求組件文件明列了檢查上限:標頭最多檢查前 8 KB(8,192 位元組)與前 200 個標頭,Cookie 同樣是 8 KB 與 200 個;請求本文在 Application Load Balancer 與 AppSync 前緣只檢查前 8 KB,在 CloudFront、API Gateway 等前緣預設檢查前 16 KB,且可在設定中調高到 64 KB。超過上限的內容怎麼辦?AWS 要求你對每個有上限的組件指定超限處理:繼續只檢查看得到的部分、直接視為符合規則、或直接視為不符合。三種選擇對應三種風險態度,沒有預設的正確答案,但你要知道自己的規則站在哪一邊。
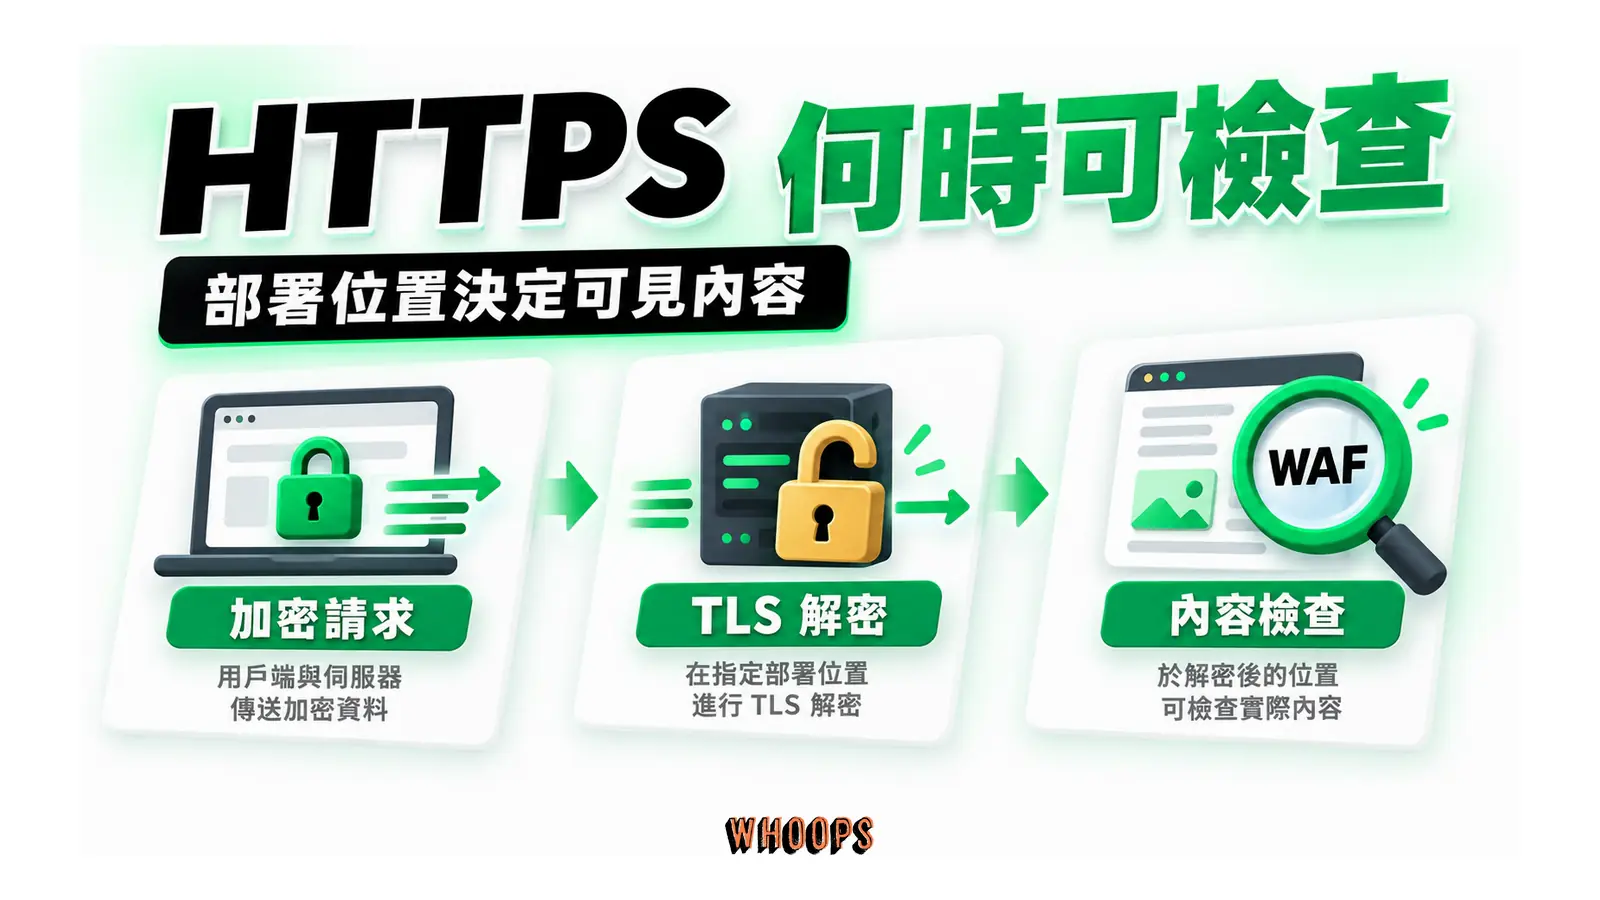
HTTPS 的問題也常被問:內容都加密了,WAF 還看得到什麼?答案取決於部署位置。AWS WAF 官方說明的用語是監控「被轉送到受保護資源」的 HTTP 與 HTTPS 請求。能這樣做,是因為雲端式 WAF 站在 TLS 終止點之後,拿到的是解密後的明文請求。反過來說,如果某個防護元件被放在只看得到加密流量的位置,它就無法檢查表單內容,只能做來源與流量型態的判斷。這也是「買了不等於有用」的技術版:部署位置錯了,規則寫得再細都是空談。
規則命中後的結局:放行、阻擋、計數與挑戰
規則比對到符合條件的請求後,接下來發生什麼,由「動作」決定。各家的動作名稱略有差異,但可以用四個概念涵蓋:放行讓請求繼續前進;阻擋直接拒絕,多數服務的預設拒絕回應是 HTTP 403;計數只記錄命中、不改變請求的命運;挑戰要求客戶端先通過某種驗證才放行。
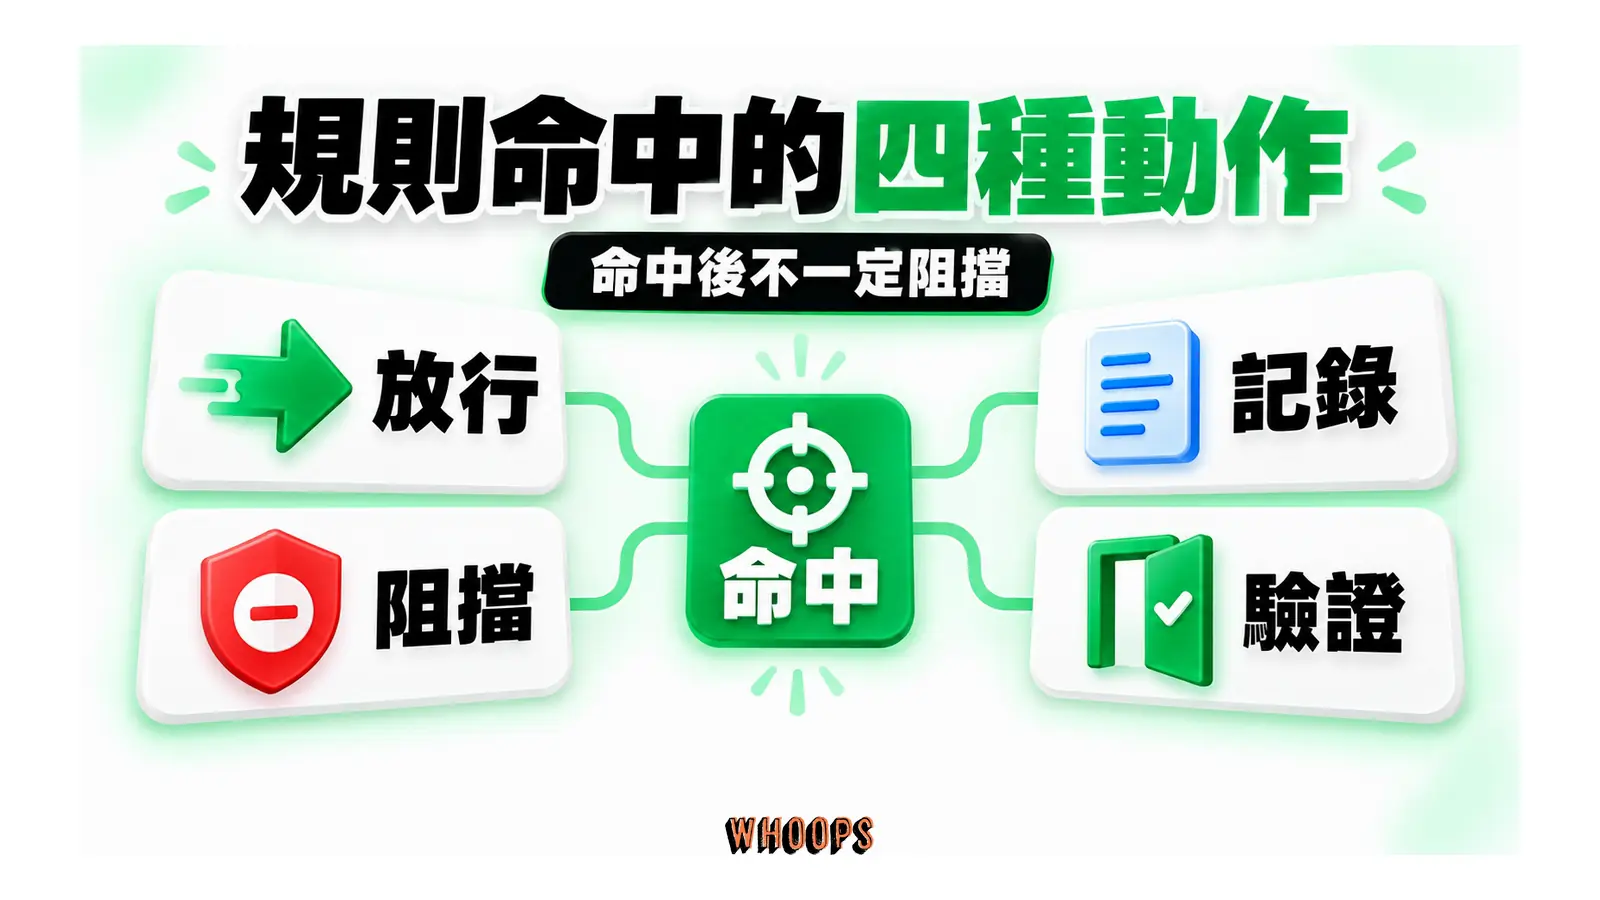
Cloudflare 的規則動作文件把動作分成終止型與非終止型:Block、Interactive Challenge(互動式挑戰,即傳統 CAPTCHA 類)、Non-Interactive Challenge(非互動式挑戰,由瀏覽器在背景執行檢查)、Managed Challenge(由系統自行決定挑戰強度)與 Redirect 是終止型,一旦命中就停止後續規則比對;Log 是非終止型,只記錄不停下來(此動作限 Enterprise 方案)。文件裡還有一個對誤擋處理特別重要的動作:Skip,用途是「動態略過一或多項安全功能或產品」。也就是說,例外可以是精準的手術刀,只跳過某一項檢查,不必整個關掉防護。
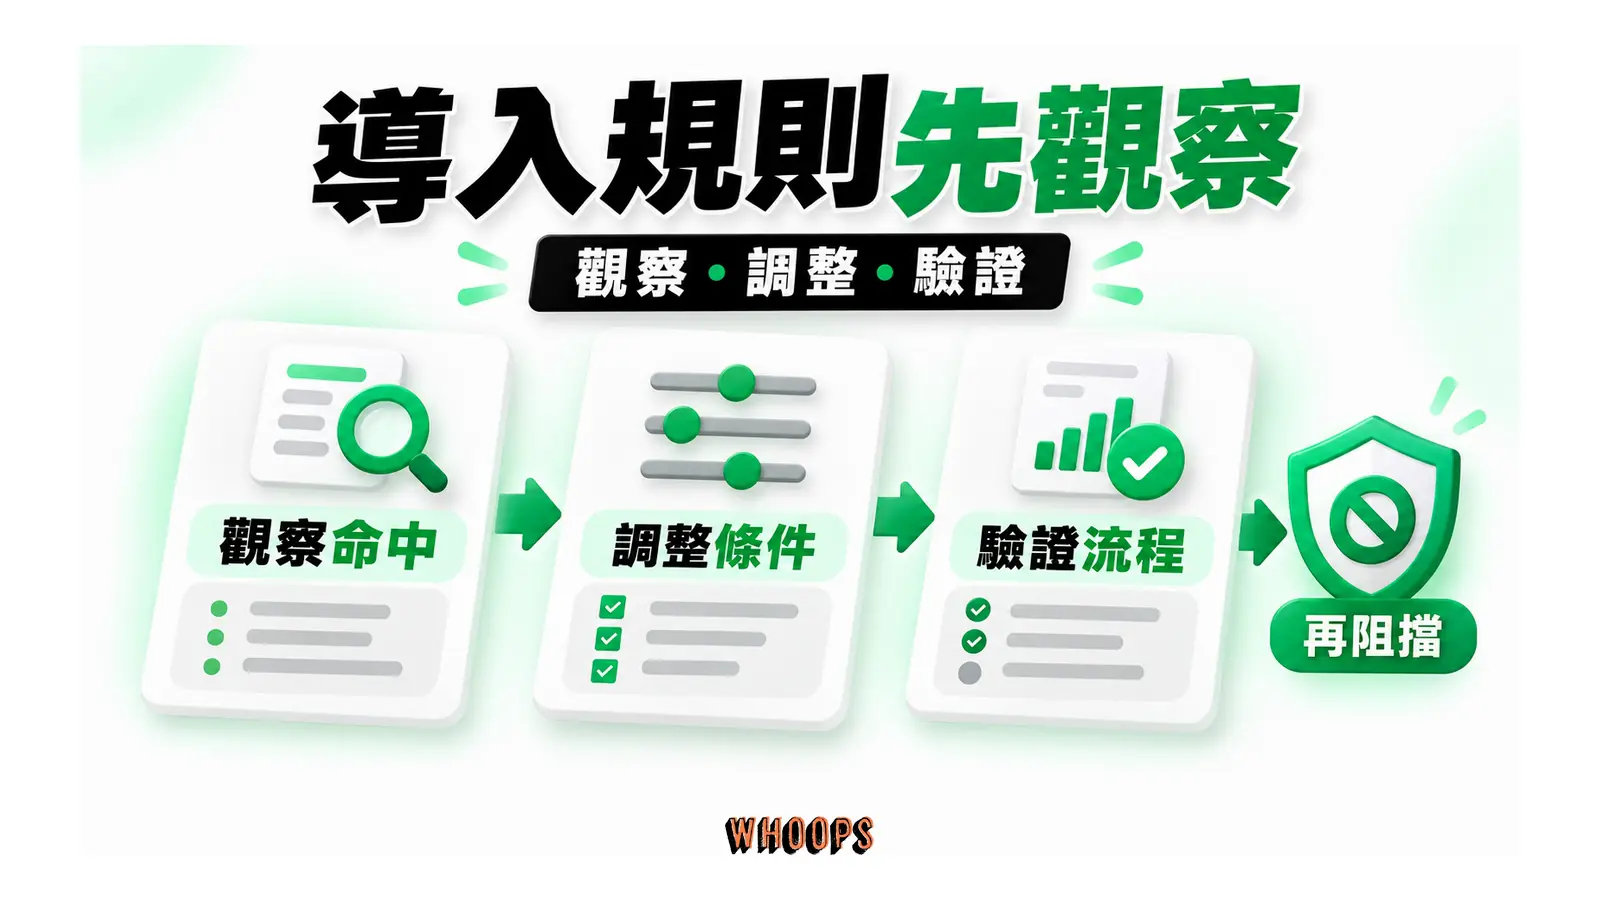
AWS WAF 這邊,官方文件列出的主要規則動作包括:允許(Allow,可附帶注入自訂標頭)、阻擋(Block,回應 403 或自訂回應)、計數(Count,不改變請求處理方式,用於監控與測試新規則)、以及對符合條件的請求執行 CAPTCHA 或靜默挑戰。官方對 Count 的定位特別值得停下來看:當你打算根據新的條件允許或阻擋流量時,先把規則設成 Count,確認這個設定會影響哪些請求,再切換成實際的擋放。這個「先觀察再動手」的節奏,是後文導入章節的骨架。
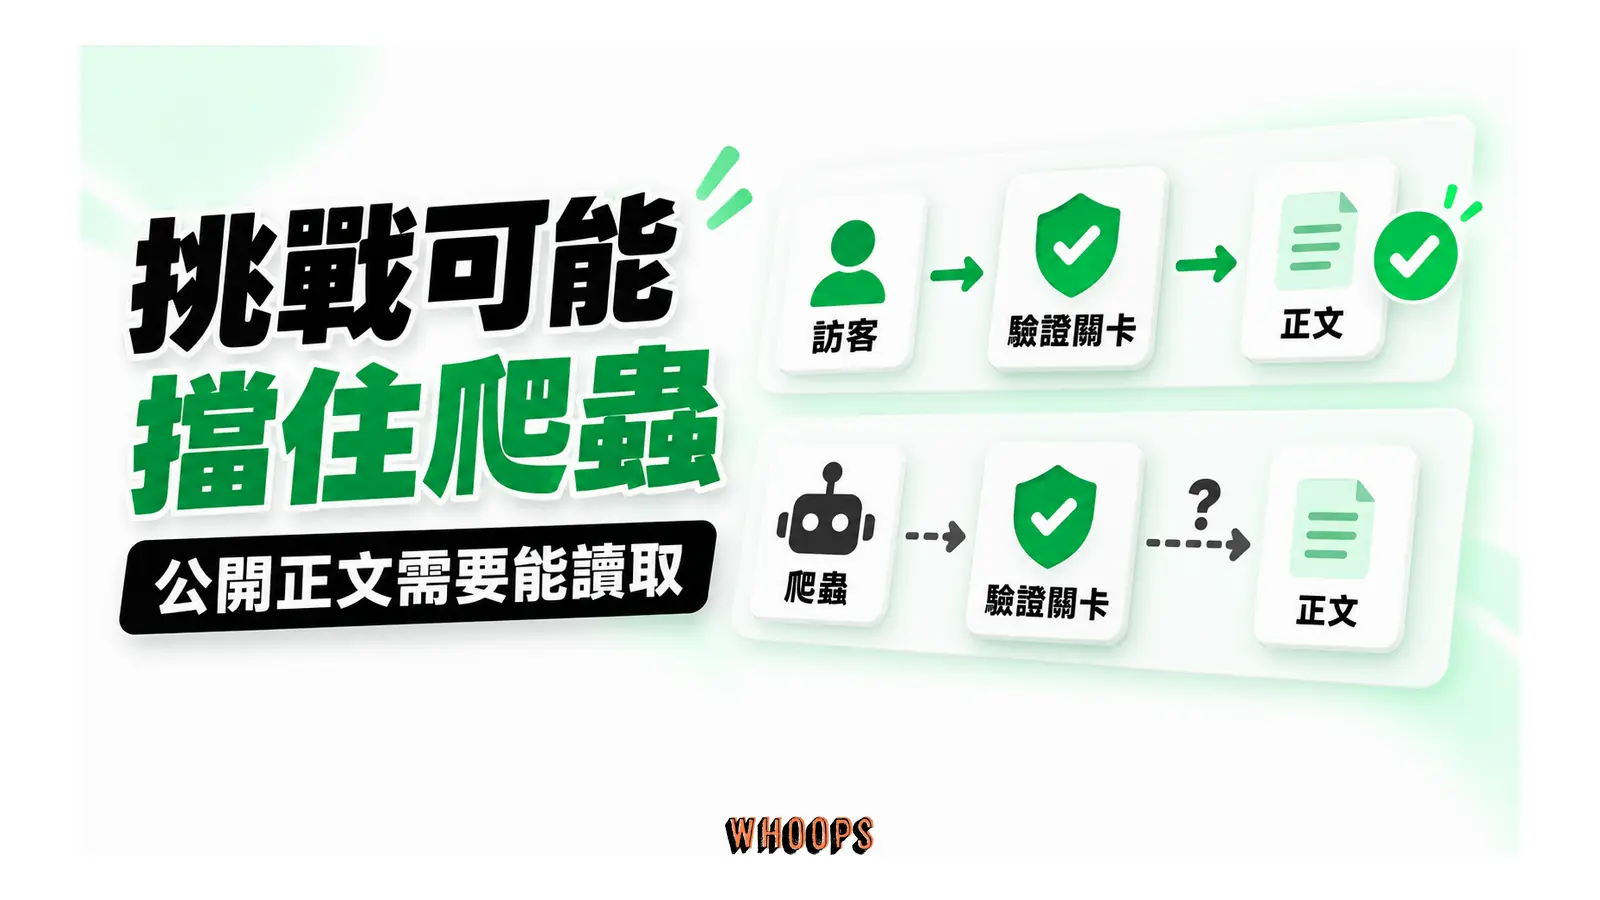
挑戰類動作值得單獨停下來想一下,因為它是 SEO 影響的源頭。互動式挑戰需要人做題目;非互動式挑戰需要一個能執行 JavaScript 的真實瀏覽器環境。這些關卡是為人類訪客設計的,而爬蟲,不管是搜尋引擎的、AI 服務的、還是攻擊者的,未必具備通過條件。對登入頁或結帳流程套用挑戰,是在擋自動化攻擊;對公開內容頁套用挑戰,等於把「讀得到正文」變成「能否通過關卡」,這條界線畫在哪裡,是後文 SEO 與 AI 爬蟲兩章的主題。
WAF 能擋哪些攻擊:SQL 注入、XSS 與受管理規則
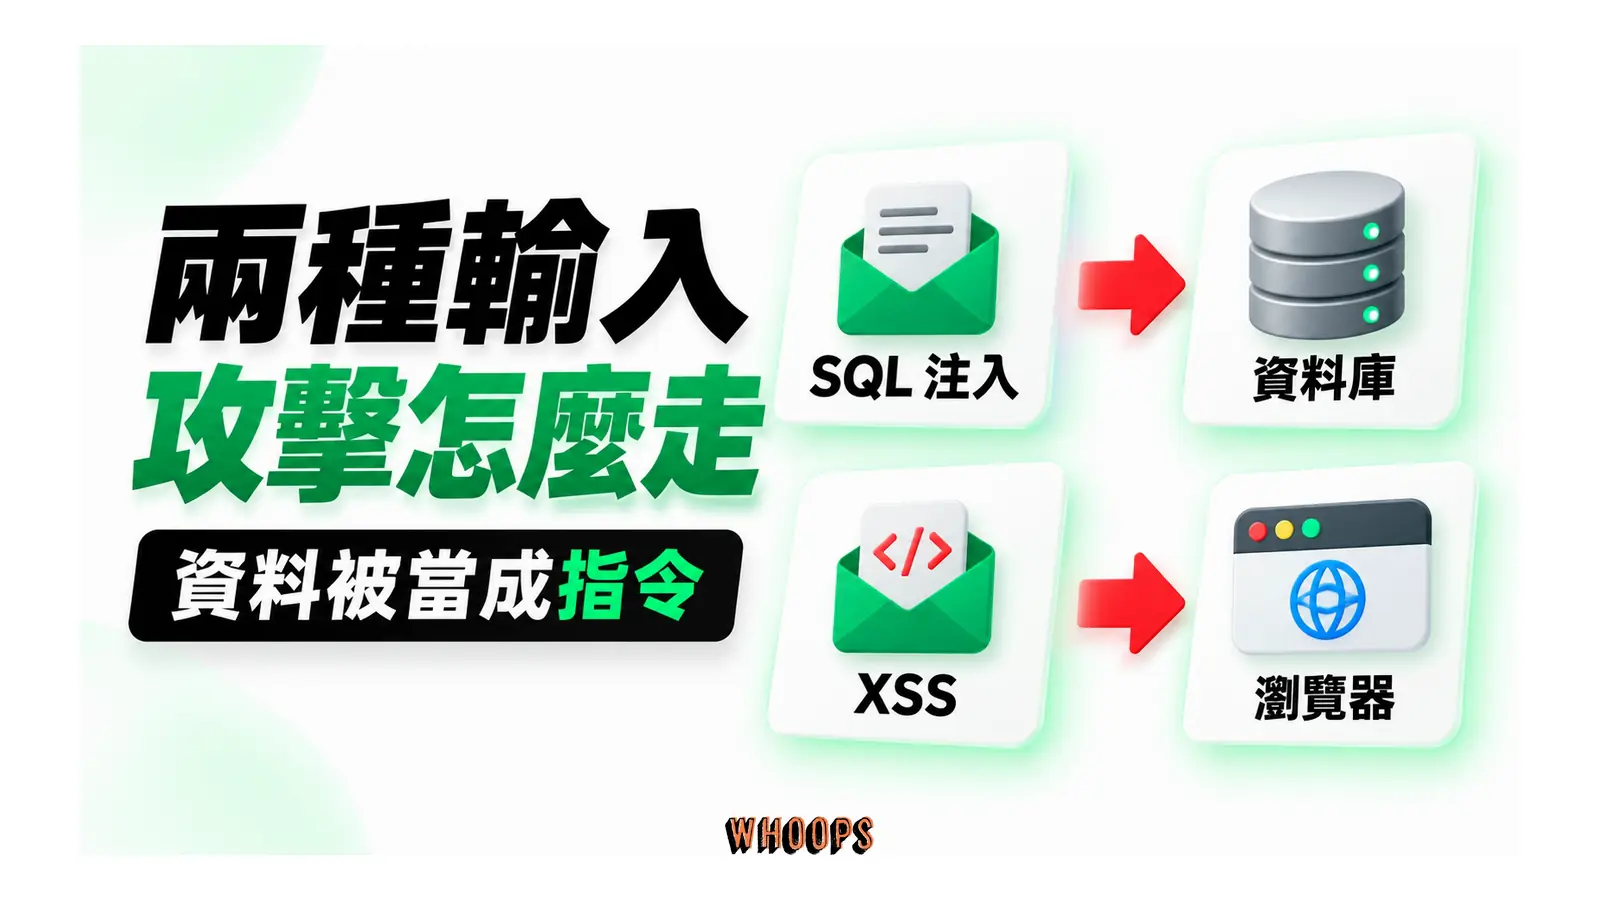
WAF 最經典的兩個戰場是 SQL 注入(SQL Injection)與跨站腳本攻擊(XSS)。SQL 注入的原理,是攻擊者把資料庫指令混進網站的輸入欄位,讓網站誤把「資料」當「指令」執行;XSS 則是把惡意腳本塞進網頁會輸出的位置,讓其他訪客的瀏覽器執行它。這兩類攻擊的共通點是特徵藏在請求內容裡:一段異常的引號與指令組合、一個輸入值裡不該出現的 script 標籤,正好落在 WAF 的檢查範圍。AWS WAF 甚至把「請求中是否存在疑似惡意的 SQL 程式碼」「是否存在疑似惡意的腳本」直接列為可用的比對條件,等於把這類偵測做成現成積木。
大多數網站經營者不會自己寫特徵規則,而是依賴「受管理規則」(managed rules):由供應商或社群維護、持續更新的規則包。這個領域最有名的社群成果是 OWASP Core Rule Set(CRS),一套開源的通用攻擊偵測規則集,自我定位為「第一道防線」,設計目標是以儘量低的誤報率防禦 OWASP Top Ten,涵蓋 SQL 注入、XSS、檔案包含、程式碼注入、命令注入、工作階段固定與掃描器偵測等類別,可搭配 ModSecurity 或相容引擎使用。許多主機服務與自架環境的 WAF 能力,底層就是 CRS 或其變體;挑選主機時若在規格表看到這些名字,指的就是這套規則體系。網站架構與主機類型怎麼影響你能用的防護層,可以另看虛擬主機的完整指南,本文把力氣留在 WAF 本身。
受管理規則之外,WAF 平台通常也提供速率限制(rate limit)類的規則:短時間內同一來源對同一入口發出超量請求就觸發動作。這對暴力破解登入、批量灌表單、惡意爬梳內容這類行為有嚇阻力,但要記住它的判斷依據是「頻率」而不是「意圖」:一位真的忘記密碼連按五次重送的會員,跟一支每秒嘗試三十組帳密的腳本,在速率規則眼裡需要被區分開來,規則條件(時間窗、閾值、排除條件)寫得粗細,決定了誤擋率。
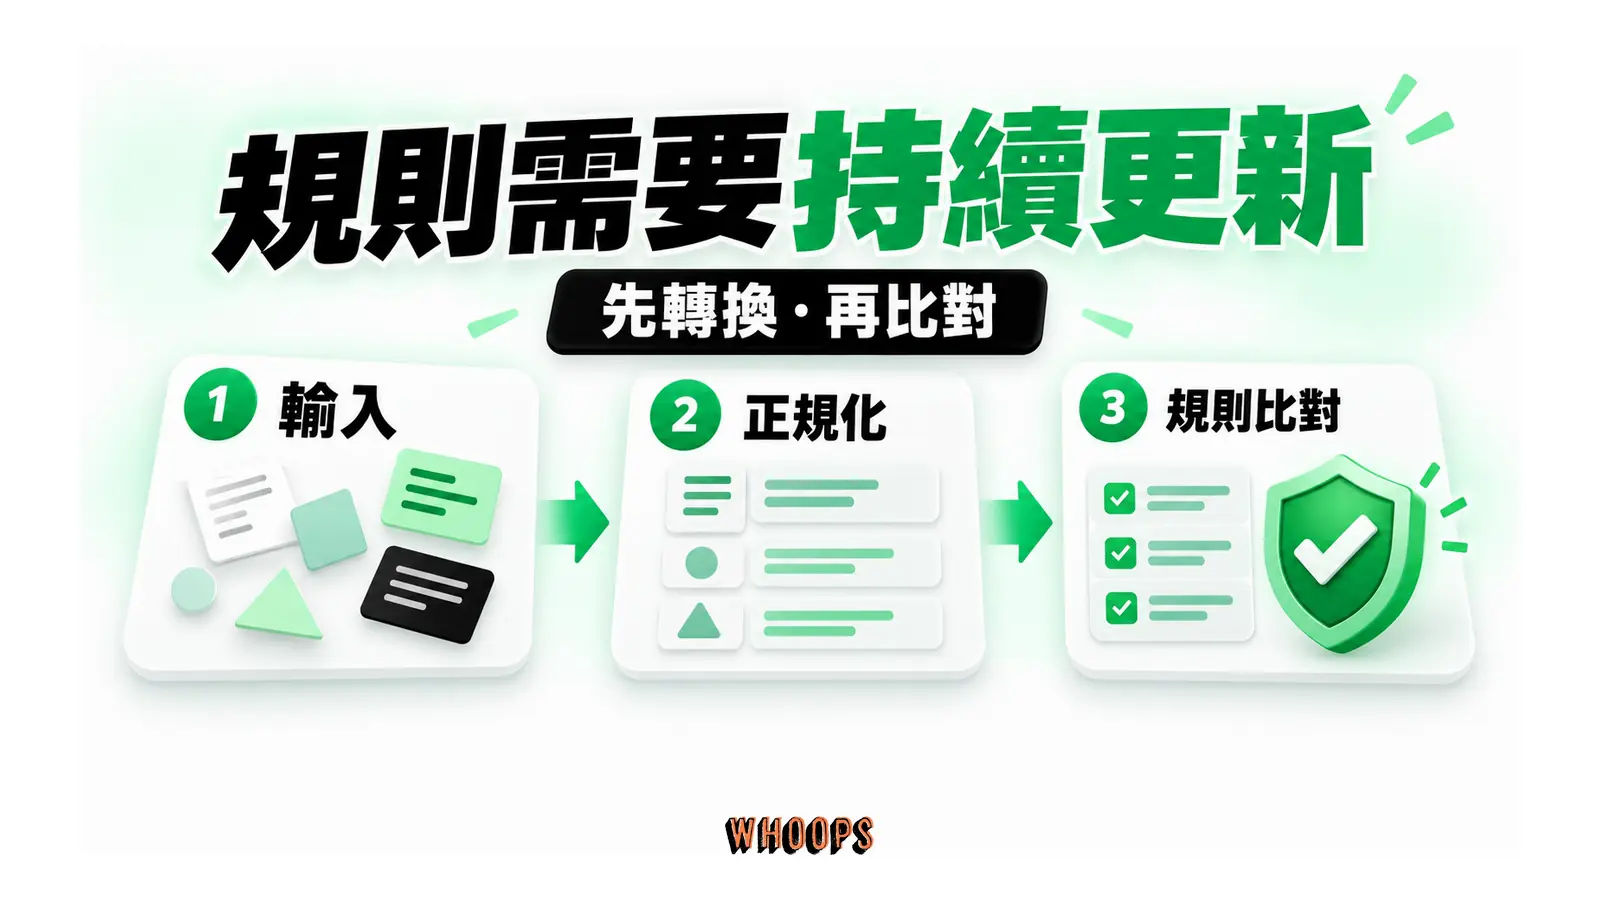
還有一層貓捉老鼠值得知道:攻擊者不會老老實實送出教科書範例裡的攻擊字串,編碼、大小寫混排、插入註解符號都是基本混淆手法。WAF 的對策是在比對前先對受檢文字做轉換,把文字正規化、解碼之後再套規則,讓換過包裝的特徵現形;AWS WAF 的請求組件文件就把這類文字轉換列為比對前的標準步驟。這也解釋了受管理規則為什麼需要持續更新:它對抗的是會演進的對手,不是一份寫完就固定的黑名單。你不需要懂每一條規則的寫法,但要知道這個動態本質,它直接影響你怎麼看待「規則更新誰負責」這個採購問題。
WAF 的邊界:它不能取代更新、備份與權限管理
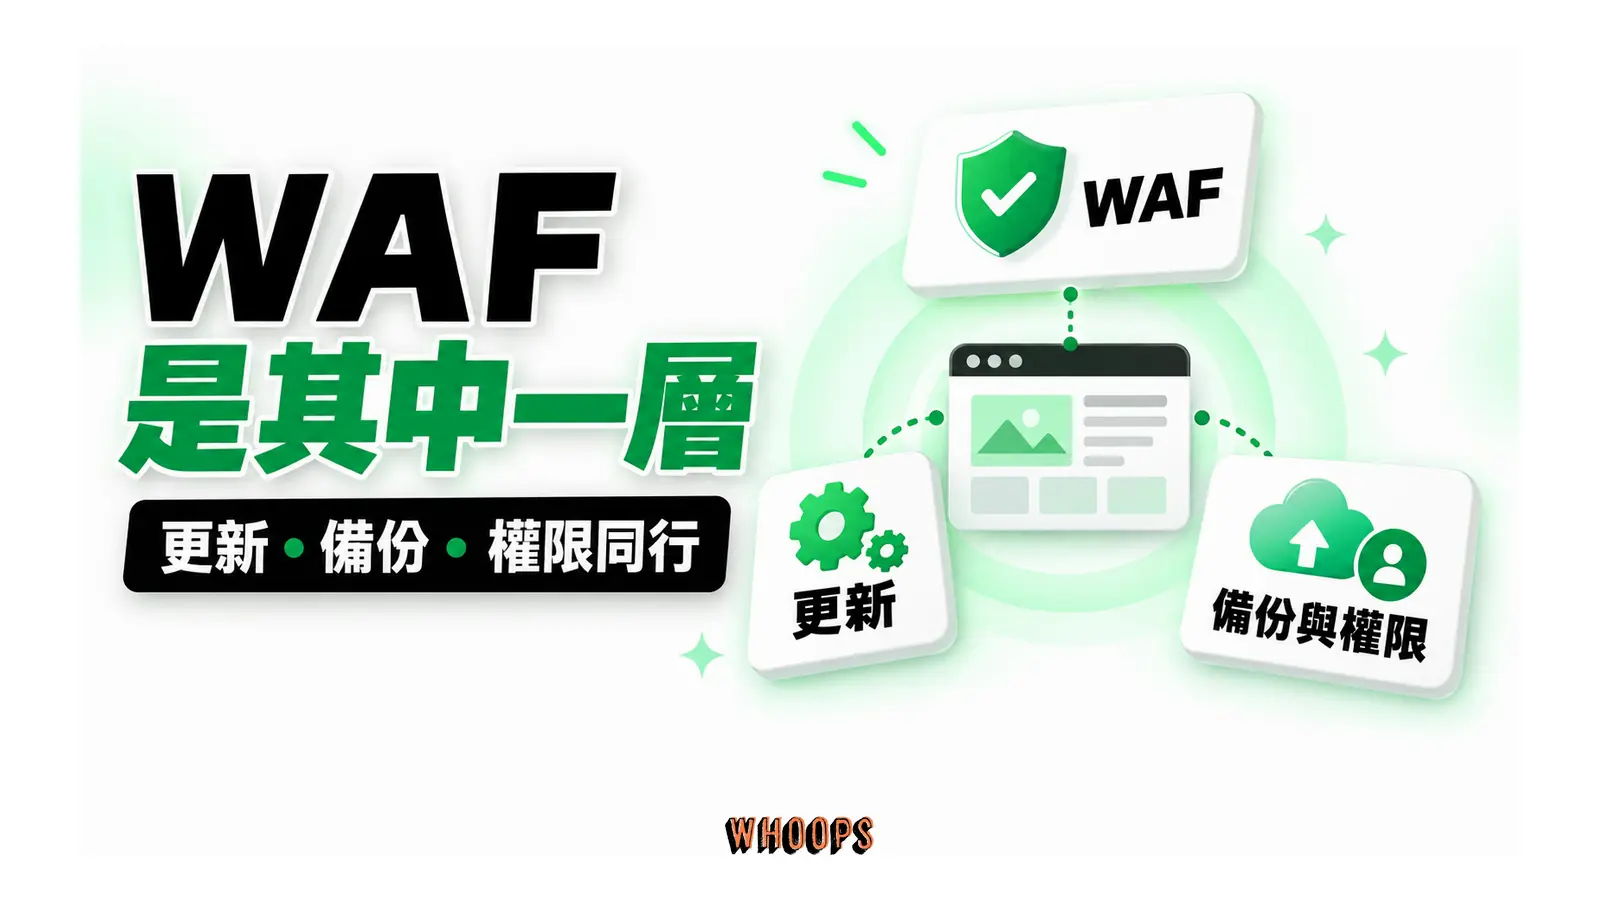
把 WAF 講得太神是這個主題最常見的失衡。回到機制:WAF 在請求到達網站程式之前做特徵與條件比對,它能做的是「降低帶有攻擊特徵的請求到達網站的機率」。這句話的每一個限定詞都是邊界。
- 它不能取代修補。外掛漏洞存在於網站程式碼裡,WAF 能擋的是「利用這個漏洞的已知攻擊模式」;變種攻擊、未被規則收錄的新漏洞利用,仍然會穿過去。把外掛更新到修復版,是移除漏洞本身;WAF 只是在門口多攔一道。兩件事同時做,不是二選一。
- 它不能取代備份。任何防護都有失守的可能,資安的基本紀律是假設防線會破。沒有可還原的備份,一次成功的入侵就是永久性損失;有備份,它是可復原的事故。
- 它不能取代權限管理。WAF 看的是請求,不是「這個已登入帳號有沒有權利看這筆訂單」。會員 A 能不能存取會員 B 的資料,屬於應用程式的授權邏輯,外部流量層的規則管不到已通過身分驗證的內部行為。管理者帳號的強密碼與雙因素驗證,也不因為前面有 WAF 而變得可有可無。
- 它不懂你的業務規則。「促銷檔期同一會員下單二十次」是異常還是正常?「客服系統用 API 批次更新兩千筆資料」是攻擊還是日常?這些判斷需要業務語意,通用規則集給不了,只能靠你自己以自訂規則逼近,而且永遠逼近不完美。
換句話說,WAF 是縱深防禦裡的一層,不是全部。一個健康的網站安全組合至少包含:程式與外掛的持續更新、可還原的備份、最小權限的帳號管理、登入入口的額外防護(這層的實作可以參考隱藏登入頁網址的討論),以及本文的主題 WAF。每一層都有它獨自堵不住的東西,疊起來才是防線。
三種部署方式:雲端代理、主機軟體與網路設備
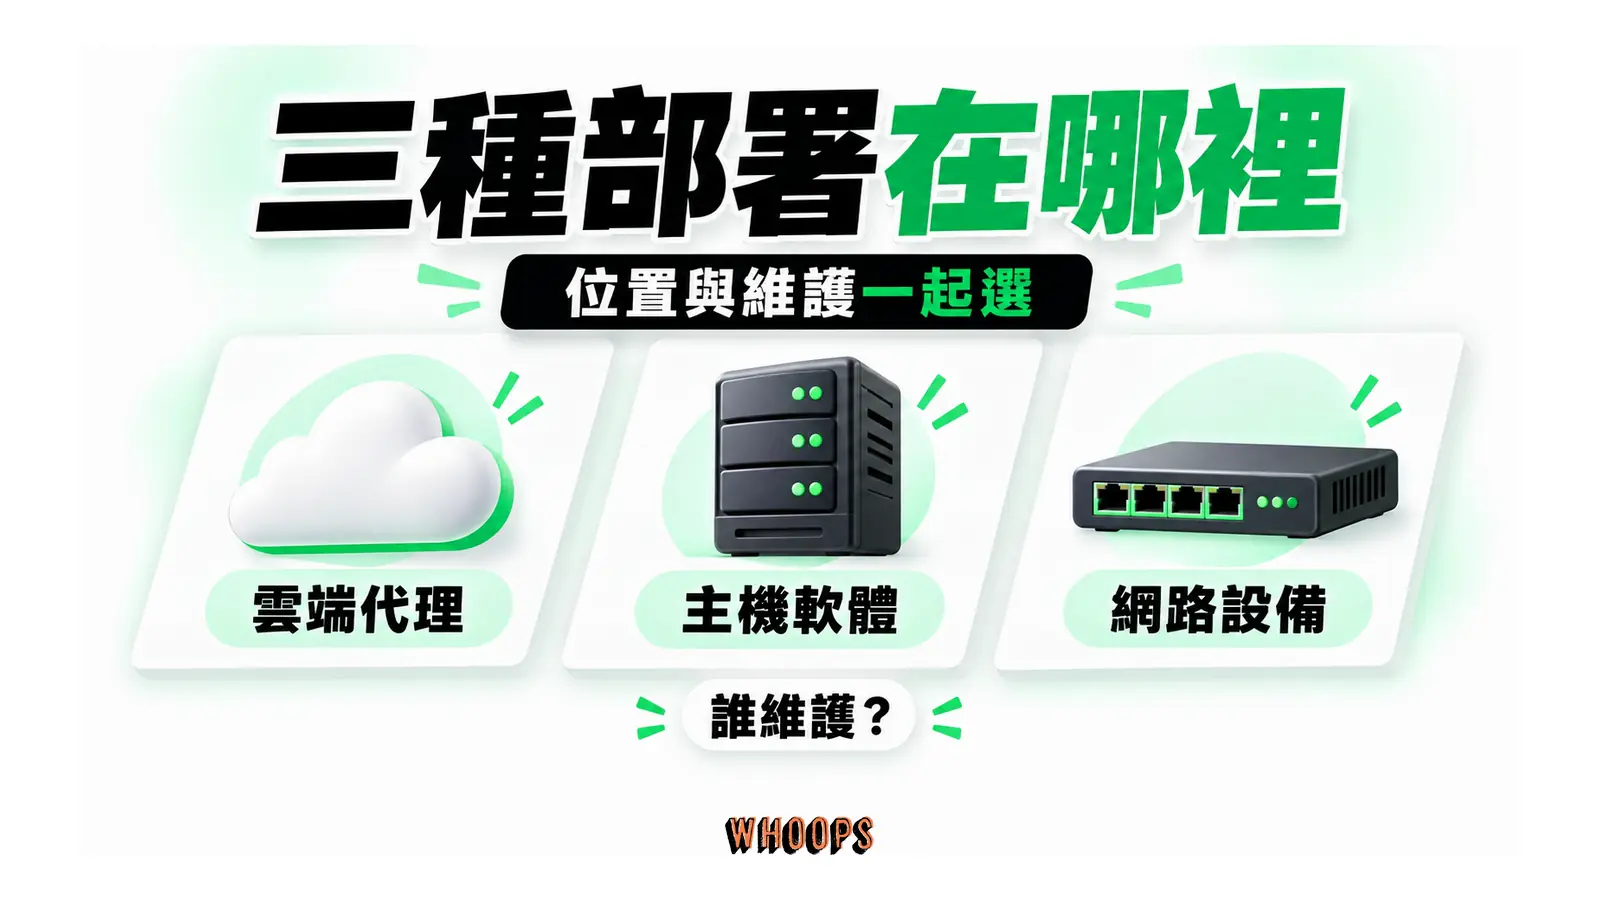
同一套概念,落地有三條路,差別在「檢查發生在哪裡」與「誰負責維護」。
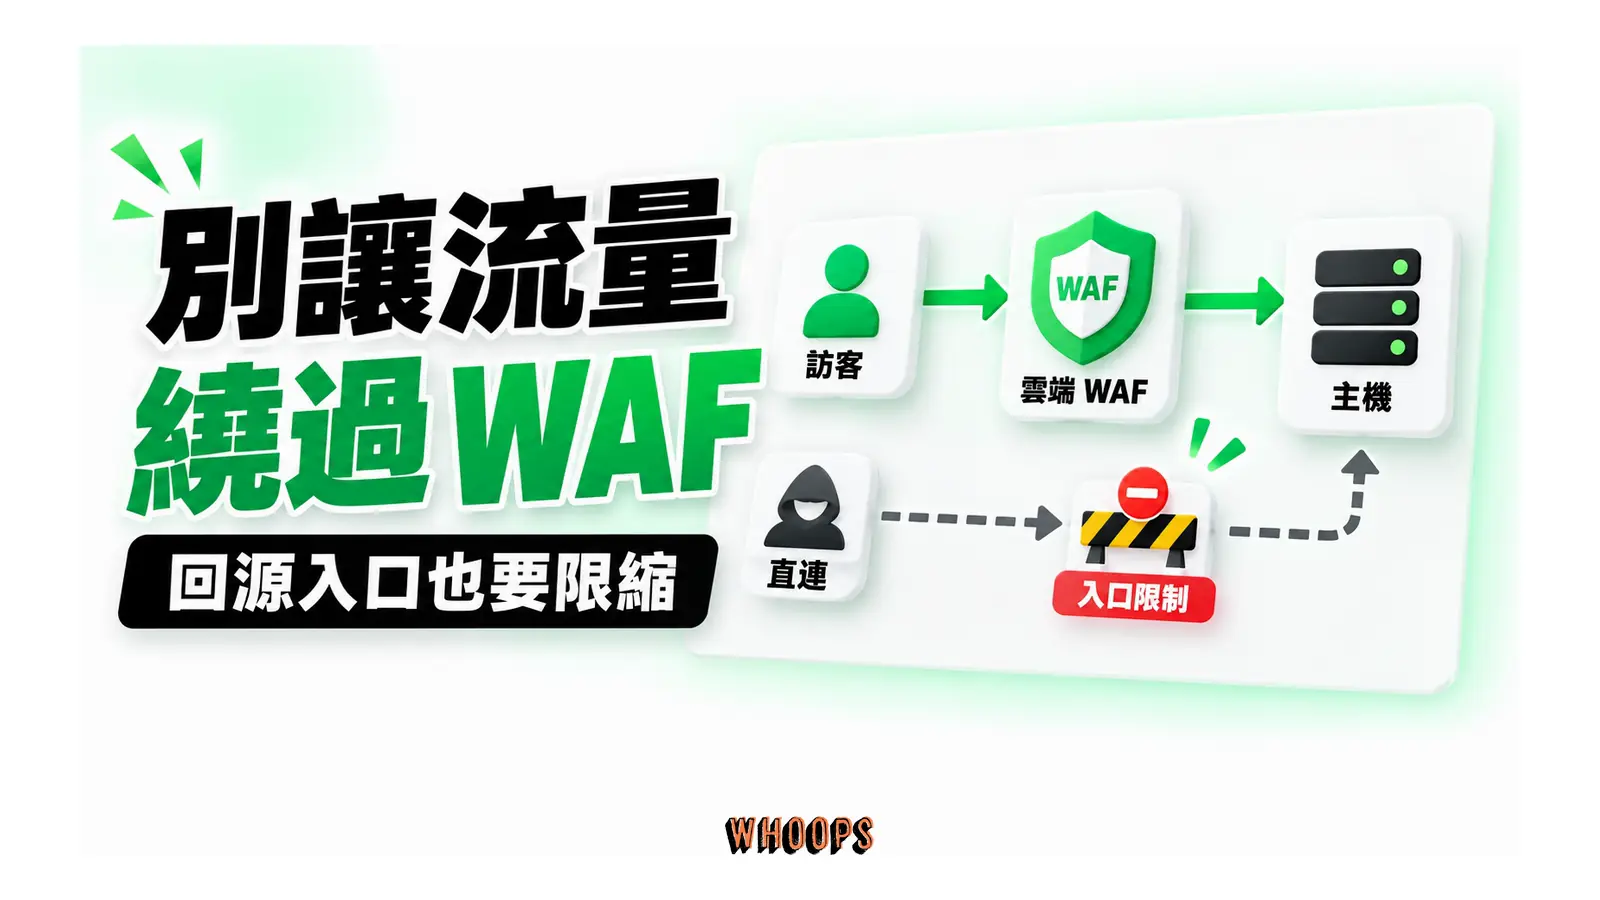
雲端代理式是目前最主流的路線:DNS 把網域流量導到供應商的邊緣網路,請求在那裡先被檢查,通過後才回源到你的主機。Cloudflare 的反代模式、AWS WAF 掛在 CloudFront 或 Application Load Balancer 前面,都屬於這類。優點是規則由供應商持續更新、不需要動主機、通常橫跨 L3/L4 防護與應用層檢查;代價是流量多繞一段路,以及一個常被低估的風險:origin 繞過。既然正常流量都從代理進來,主機的原始 IP 就不該再對全世界公開。如果攻擊者拿到或猜到 origin IP 直接連線,雲端那層 WAF 就整層被跳過。標準作法是將 origin 的入口限定只接受代理服務的 IP 段,這件事在導入時就要跟維運人員確認,別等到被繞過才補。
主機軟體式把檢查放進伺服器或應用環境本身:WordPress 站長最熟悉的形態是安全外掛內建的防火牆模組,在 PHP 層攔截請求,規則更新跟著外掛走。這條路的好處是與網站應用貼得近、設定粒度細、常常連惡意程式碼掃描與登入防護一起包;它的限制是檢查發生在主機上,會消耗主機資源,而且若主機本身被壓垮或被網路層攻擊打滿,應用層的規則沒有機會發揮。以 WordPress 生態來說,這一層的完整實作(Wordfence 的防火牆設定、掃描與雙因素驗證)已另有深文:Wordfence 安全教學講單一工具的完整設定,安全外掛怎麼選談同類工具的組合判斷。本文站在通用概念層,兩篇互補不重疊。
網路設備式是企業機房裡的硬體或虛擬設備,掛在自己的網路環境裡,由內部維運團隊管理。它的位置決定了適合大型組織:需要自管資料路徑、有專職維運人力、流量大到值得持有設備。對多數中小網站與內容站來說,這條路的管理成本不成比例,知道它存在、知道託管主機商口中「我們機房有防火牆」可能指這一層就夠了。
三條路沒有絕對優劣,但有一個共同的追問:規則誰維護、事件誰看得到。雲端式把規則更新外包給供應商,但「開啟哪些規則包、怎麼處理誤擋」仍是你的事;主機式一切自理,人力就是上限;設備式考驗內部維運紀律。無論哪條路,下一節的導入順序都適用。
導入前的正確順序:先盤點合法流量,再分批開規則
誤擋的種子幾乎都在導入那天就種下:規則一次全開、直接套用阻擋動作、然後等使用者回報「表單送不出去」。避免的方法不聰明但有效:在開啟任何阻擋之前,先把「網站的正常流量長什麼樣子」寫成清單。
清單從人類流程開始:閱讀文章、站內搜尋、會員登入與忘記密碼、聯絡表單、檔案上傳、結帳與付款、退款通知。接著把非人類但合法的流程也列進來:金流服務的 webhook 通知、ERP 或 CRM 的 API 串接、排程備份的回連、電子報系統的勾稽。這裡有一個在多數資安導入文件裡缺席、但對內容網站至關重要的項目:搜尋引擎與 AI 服務的抓取。Googlebot 每天來抓幾次、抓哪些目錄,AI 搜尋服務的爬蟲有沒有被你的商業策略開放,這些也是網站的正常流量,而且是被擋之後最安靜的一群:客人被擋會寫信來罵,爬蟲被擋只是安靜地不再來,等你在排名與流量報表裡發現時,損失已經發生幾個星期了。把爬蟲視為一級流程寫進清單,是內容站與電商站在 WAF 導入上最大的差異。
清單列完,用觀察模式跑一輪。前面提過 AWS WAF 的 Count 動作:只記錄命中、不阻擋,官方明說這是拿來測試新規則用的;Cloudflare 的 Log 動作同理,不過它限 Enterprise 方案;其他方案至少把規則範圍先限縮再上線,並靠帳號內可見的流量與安全事件報表回看命中。把你想啟用的規則以計數或記錄模式掛上,讓真實流量跑幾天,然後看事件清單裡有誰:如果正常流程的請求反覆出現在命中清單,那條規則上線就會誤擋,先調條件再說。
驗證的標準也要換掉。「頁面打得開」不是驗證,是最低門檻。真正的功能驗證是走完整行為:表單送出後收得到信、會員真的登入得去、訂單建立且付款結果回流、webhook 觸發了對應的狀態更新。檢查的當下也順手確認回應狀態碼與內容:一個回 200 卻帶著挑戰頁或空白正文的回應,對爬蟲來說跟被擋沒有兩樣,這個判準在後文 SEO 章節會展開。
發生誤擋時怎麼排查:事件紀錄、Ray ID 與攔截層
就算導入謹慎,誤擋仍會發生:網站會改版、規則會更新、攻擊特徵會演進。排查的目標不是「找到一個 403 然後關掉某個功能」,而是定位到「哪一層、哪一條規則、因為什麼條件」攔下了這筆請求。
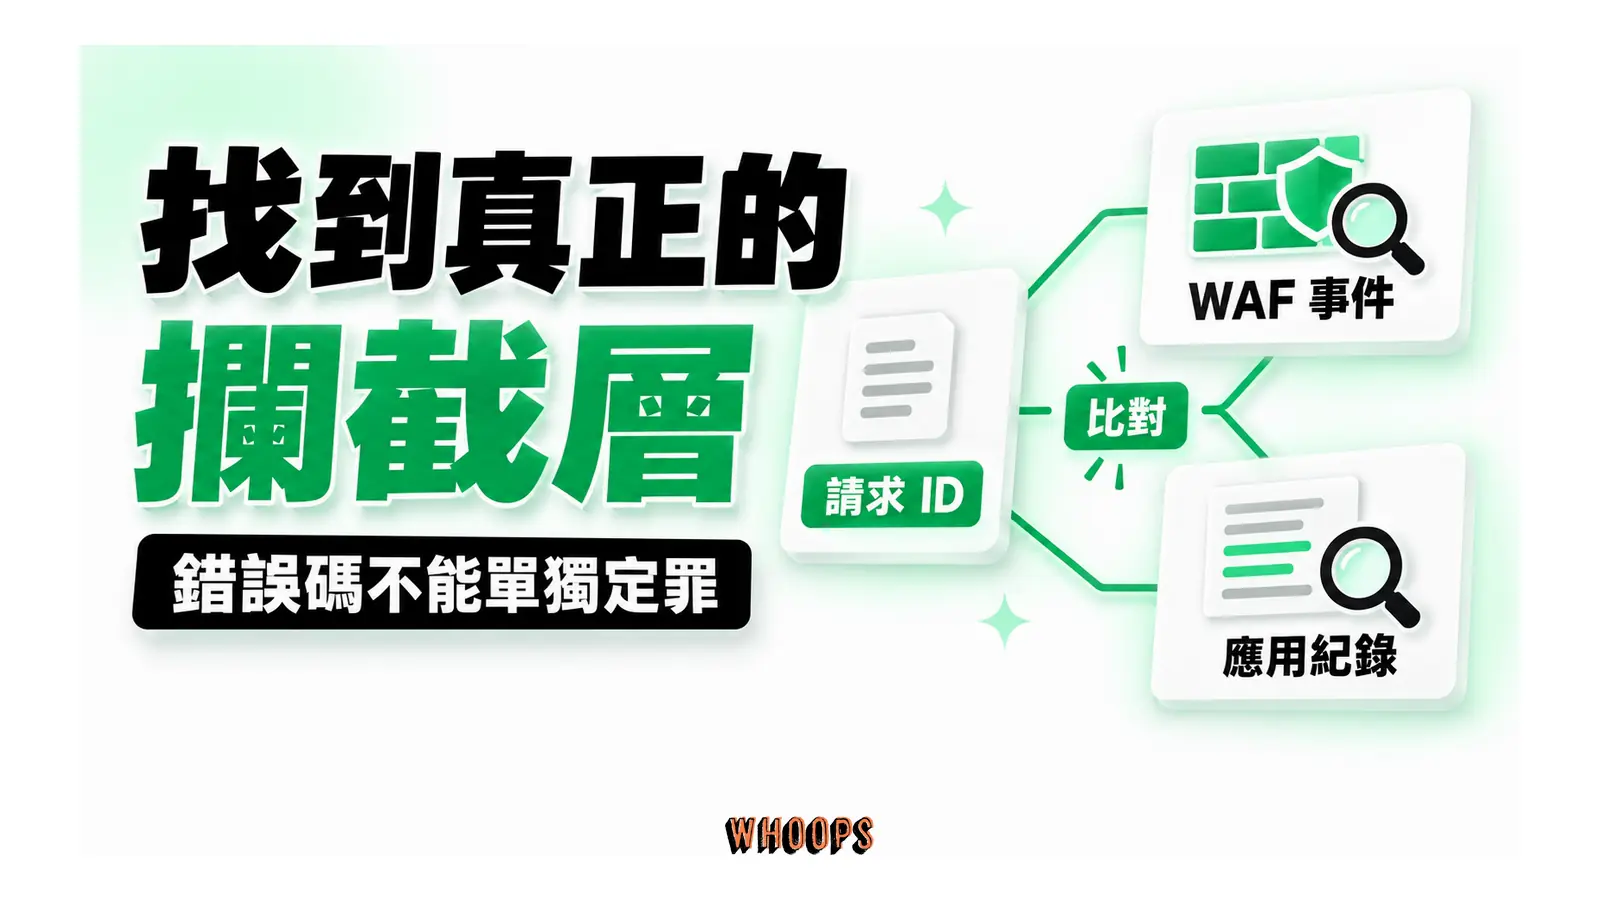
第一步,把事故變成可查的資料。記下四件事:發生時間(含時區,事件紀錄多半存 UTC)、被擋的網址、當時的操作(送了哪個表單、按了哪顆按鈕)、以及錯誤頁面上顯示的請求識別碼。Cloudflare 的錯誤頁與事件紀錄用 Ray ID 對應單筆請求,其他服務多半叫 request ID 或 trace ID。有識別碼,管理者能在幾秒內從百萬筆事件裡撈出那一筆;沒有,只能靠時間範圍粗撈,雙方都痛苦。
第二步,對照事件紀錄,確認攔截發生在哪一層。403 的來源比你想的多:可能是 WAF 的受管理規則、你的自訂規則、速率限制、機器人政策,也可能是網站外掛自己的防護、主機層的規則,甚至 origin 之後的應用程式邏輯。事件紀錄裡找不到這筆請求,答案往往就不是 WAF。這一步防止最常見的冤案:把別層的擋誤判成 WAF 誤擋,然後把 WAF 越調越鬆。
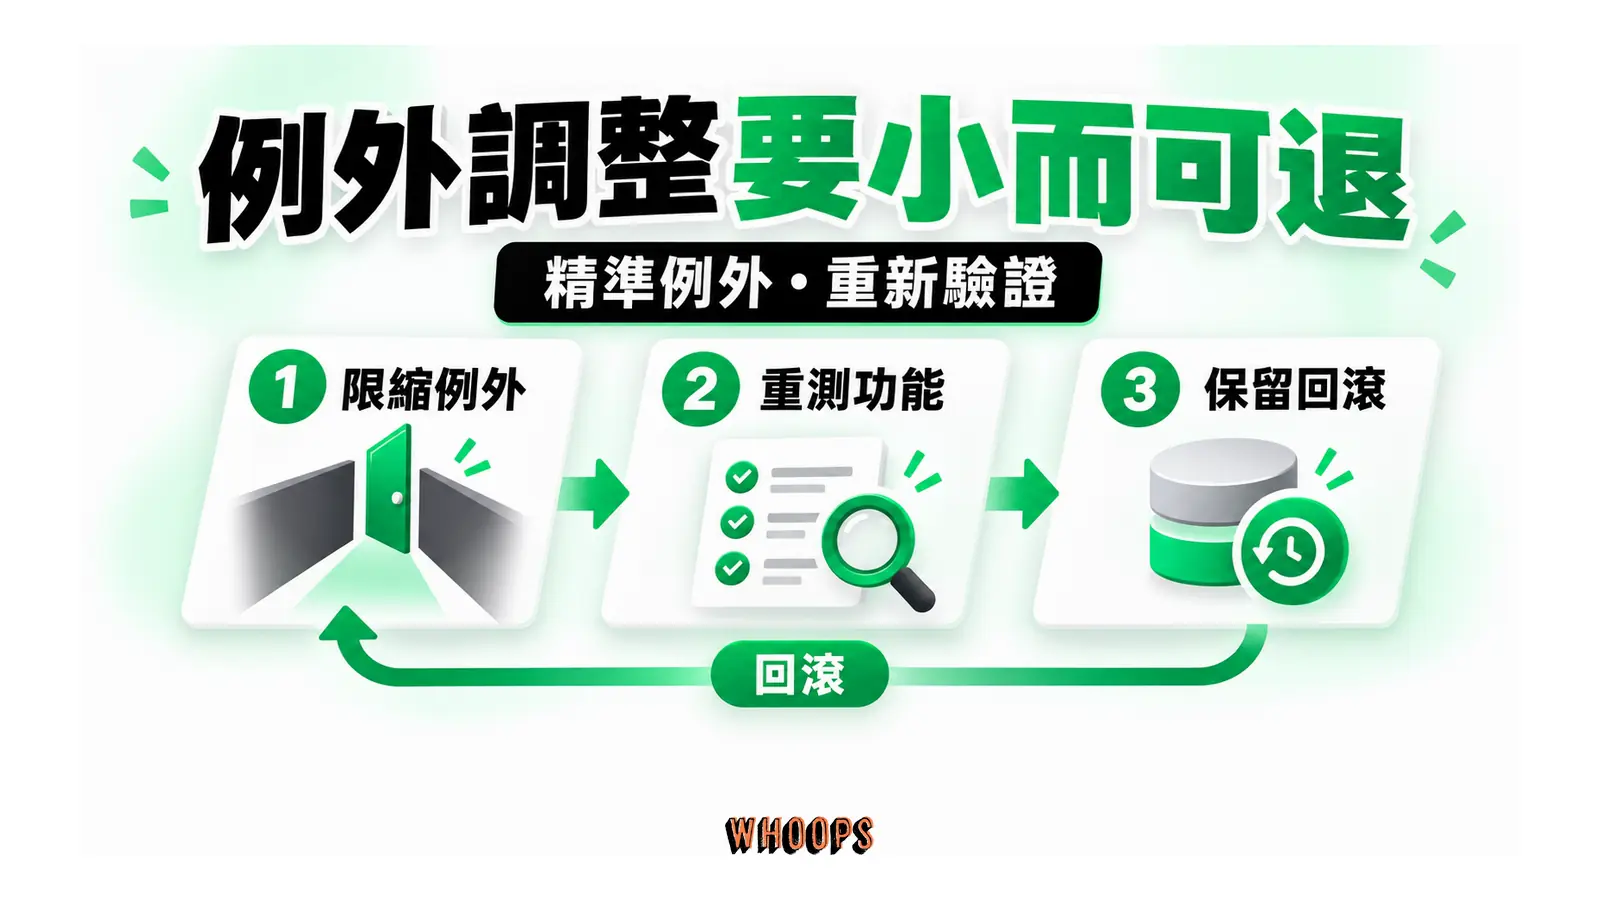
第三步,例外要最小化,把全面放行留作最後手段。找到命中的規則後,思考的順序是:能不能只對「這個路徑+這個方法+已驗證的來源」放行?能不能只略過這一條規則,保留其他檢查?Cloudflare 的 Skip 動作正是為此設計,依設定可以只略過特定規則、規則集、階段或某項安全產品,範圍由配置決定;AWS WAF 的做法則是以更精確的規則條件包住例外範圍。公開文章頁、登入頁、結帳頁的風險屬性不同,不該共用同一個寬鬆例外。全域關閉某個規則包來救一個表單,等於為了修一扇窗把整面牆拆了。
第四步,重驗並留下回滾路徑。調整後重做原本失敗的操作,確認恢復;同時抽一兩個攻擊特徵(對測試環境)確認防護仍在。保留調整前的規則與設定紀錄,萬一新例外打開了新的洞,你能回到已知的狀態,免於在鬆緊之間來回試錯。
WAF 誤擋的 SEO 代價:403、429 與「讀不到就等於不存在」
搜尋引擎對你網站的認識,完全建立在「爬蟲拿回了什麼」。Google 的爬蟲 Googlebot 是什麼、怎麼運作,站上已有完整解析(Googlebot 全解析);這裡聚焦在 WAF 視角:當防護規則作用在爬蟲身上,搜尋端會發生什麼。這不是理論風險:挑戰頁、速率限制、機器人規則這些 WAF 生態的標準配備,作用對象都包含爬蟲。
狀態碼的語意值得精確理解,因為它是排查時的分流訊號。Google 對 HTTP 狀態碼的文件說得很清楚:403 屬於 4xx 錯誤,Google 不會索引回傳 4xx 的網址,已索引的網址若持續回傳 4xx 會被移出索引,抓取頻率也會逐步下降;但 Google 同時明講,除了 429 之外的 4xx 不影響整體抓取速率。換句話說,403 是「這一頁沒了」的訊號,不是「這個網站有問題」的訊號。429 的待遇完全不同:Google 把它當成伺服器過載的訊號,與 5xx 同級處理,爬蟲會暫時放慢對整個網站的抓取,等伺服器恢復正常回應才逐步加速。
把這兩段官方口徑翻譯成排查語言:如果 Search Console 或日誌裡看到 Googlebot 收到 403,問題多半是「某條規則擋中了爬蟲的請求」,去 WAF 事件紀錄裡找那筆請求,修正規則或加例外;如果看到 429,問題在「速率類或頻率類的設定」,門檻對 Googlebot 的抓取節奏來說太緊,或限流範圍把正當爬蟲與攻擊流量混在一起算。兩者的修法不同,先分清楚再動手。也要留意一個反向的證據:Google 自己的文件把「暫時回傳 500、503 或 429」列為緊急壓低抓取的官方手段,限用一到兩天,之後讓爬蟲自動恢復步調。這反過來印證了 429 對抓取的煞車力道:WAF 的速率規則沒調好、對 Googlebot 持續回 429,等於有人在你不知情的情況下一直踩著這個煞車。文件同時提醒,不要用 401 或 403 來控制抓取頻率;若抓取量真的異常偏高,透過 Search Console 提出特殊需求才是正路。
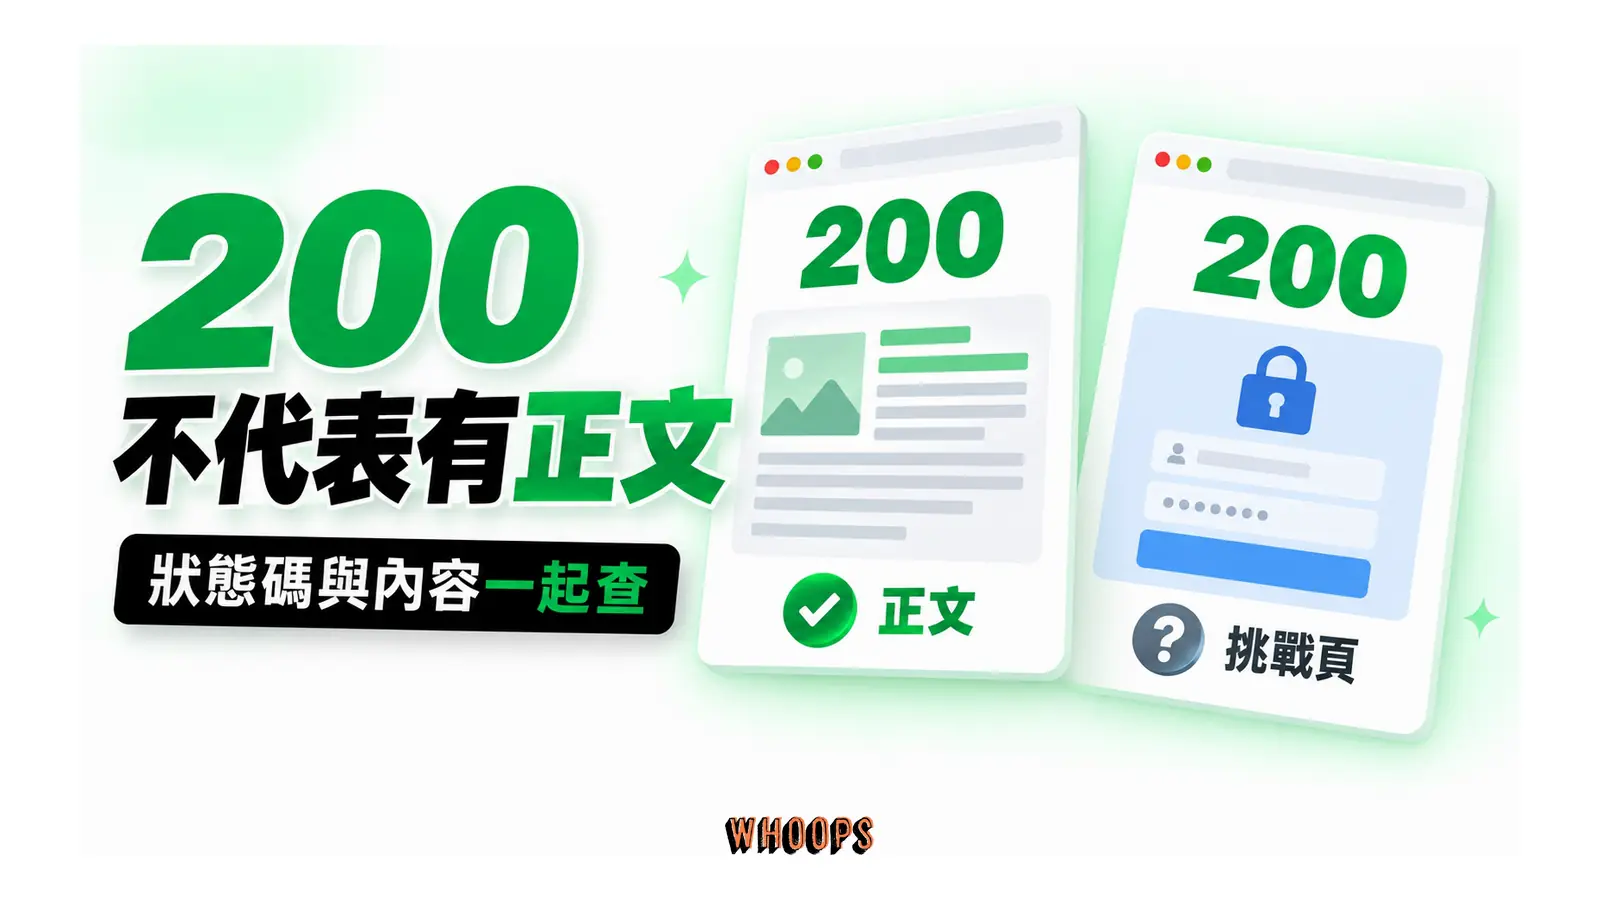
狀態碼之外還有一個更隱蔽的層次:200 不等於讀到內容。回應狀態碼是 200,正文卻是挑戰頁、登入頁或近乎空白的殼,爬蟲一樣沒有拿到你的文章。驗證方法不神祕:在 Search Console 裡對單一網址執行檢查,就能看到 Google 實際取得的 HTML,把它跟你預期的頁面內容對照;網站伺服器日誌則能從源頭回答「誰、何時、抓了什麼、拿到什麼狀態碼」,這套方法在爬蟲日誌分析有完整流程,WAF 排查時可以直接沿用同一套儀器。
這裡必須處理一個常見的誤解:「robots.txt 已經允許爬蟲了,為什麼還被擋?」因為兩者管的事不同層。robots.txt 表達的是「同意不同意被抓」的抓取禮節;WAF 規則決定的是「這筆請求會不會被放進門」。合規的搜尋爬蟲通常會遵守 robots.txt(以 Google 為例,常規搜尋爬蟲會遵守,但特殊用途與使用者觸發的擷取器不保證),而 WAF 攔在爬蟲看到 robots.txt 之前,更別提多數 WAF 的封鎖判定根本不看 robots.txt。所以「允許抓取」與「真的送出正文」是兩道獨立的關卡,要分開確認:前者查 robots.txt 與中繼標籤,後者查 WAF 事件紀錄與實際回應內容。這組對稱的陷阱,購買不等於保護、允許不等於讀到,貫穿了 WAF 導入的每個階段。
AI 爬蟲時代的新變數:先驗證身分,再決定開放
搜尋引擎爬蟲之外,另一批訪客正在快速長大:AI 服務的爬蟲與代理,從搜尋型(為了 AI 搜尋回答抓網頁)、代理型(使用者請求觸發的即時讀取)到訓練型(為了模型訓練抓語料),行為與商業意義都不同。Cloudflare 的機器人分類說明就是按行為把 AI 程式分成搜尋、代理、訓練幾類,拒絕用一個「AI 爬蟲」標籤統包。對 WAF 管理者來說,這表示「要不要放 AI 爬蟲進來」不是一個是非題,而是一組按用途分開的決策,每一類對你的內容策略意義不同,Cloudflare 平台上怎麼分類與設定,AI 爬蟲預設封鎖與因應有專文深談,此處不重複。
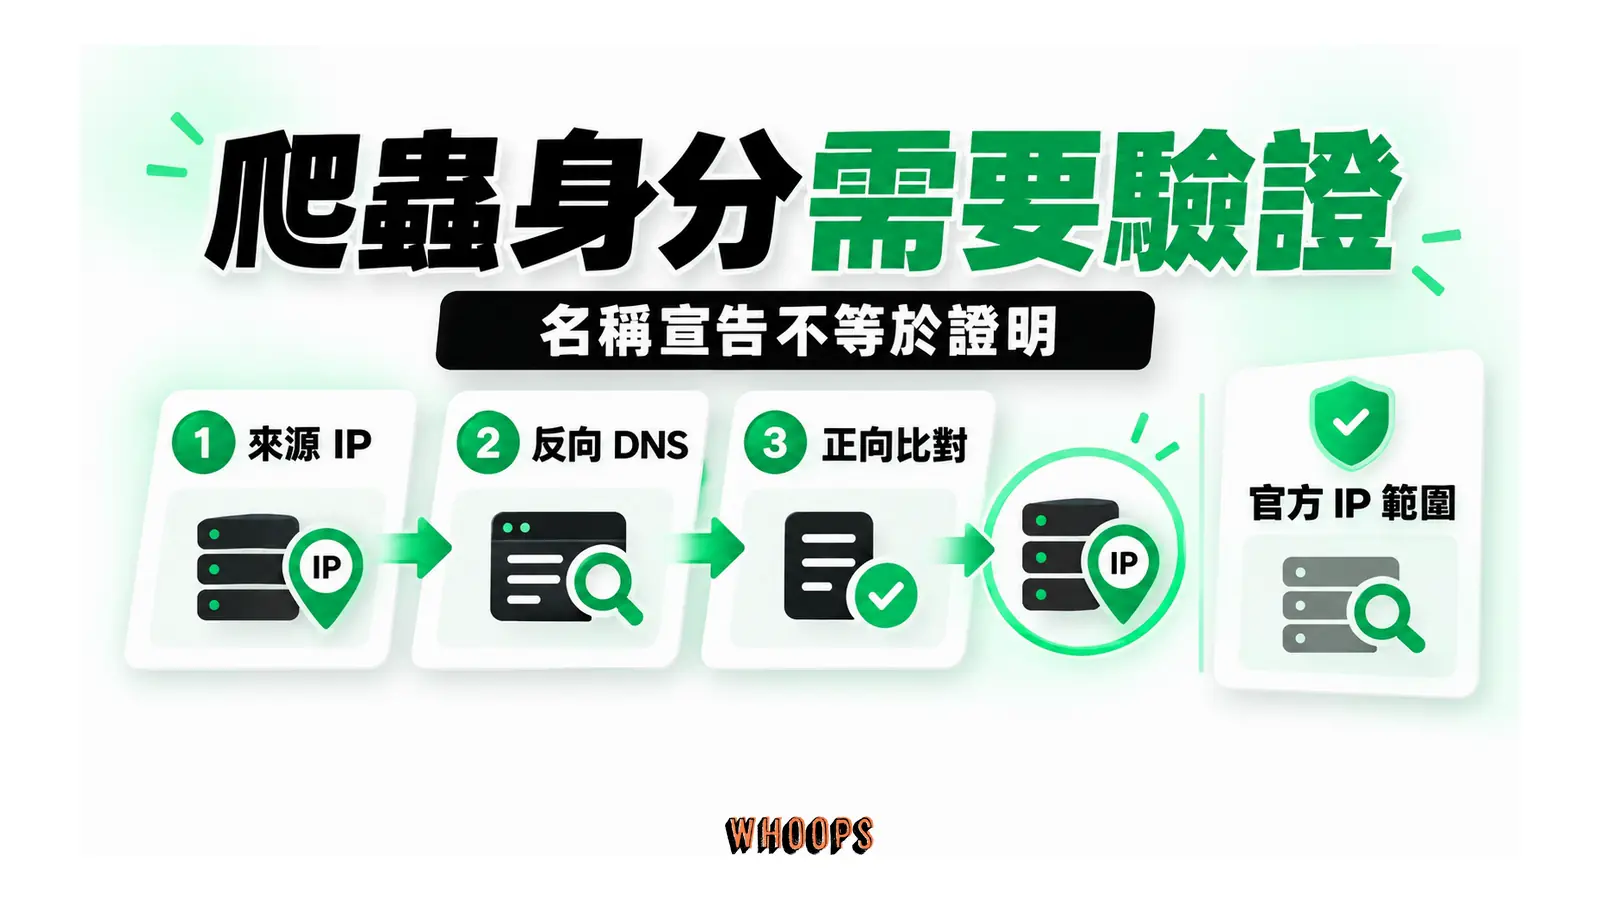
想在 WAF 規則裡對爬蟲做例外,第一個技術關卡是身分驗證。User-Agent 是請求裡的自填欄位,任何腳本都能宣稱自己是 Googlebot;只對特定 UA 字串放行,等於讓門票可以自己印。正規做法是驗證請求來源的真實性。Google 的 Googlebot 驗證說明給了完整流程:對來源 IP 做反向 DNS,確認網域是 googlebot.com、google.com 或 googleusercontent.com;再對該網域做正向 DNS,確認解析回同一個 IP。雙向都吻合,才是真的 Google 爬蟲。管理大量 IP 時,Google 也提供以 CIDR 格式發布的官方 IP 範圍清單(JSON 格式),可以直接餵給防火牆或自動化腳本比對。其他搜尋引擎與 AI 服務各有自己的官方驗證方式,原則一致:以官方文件為準,不猜。
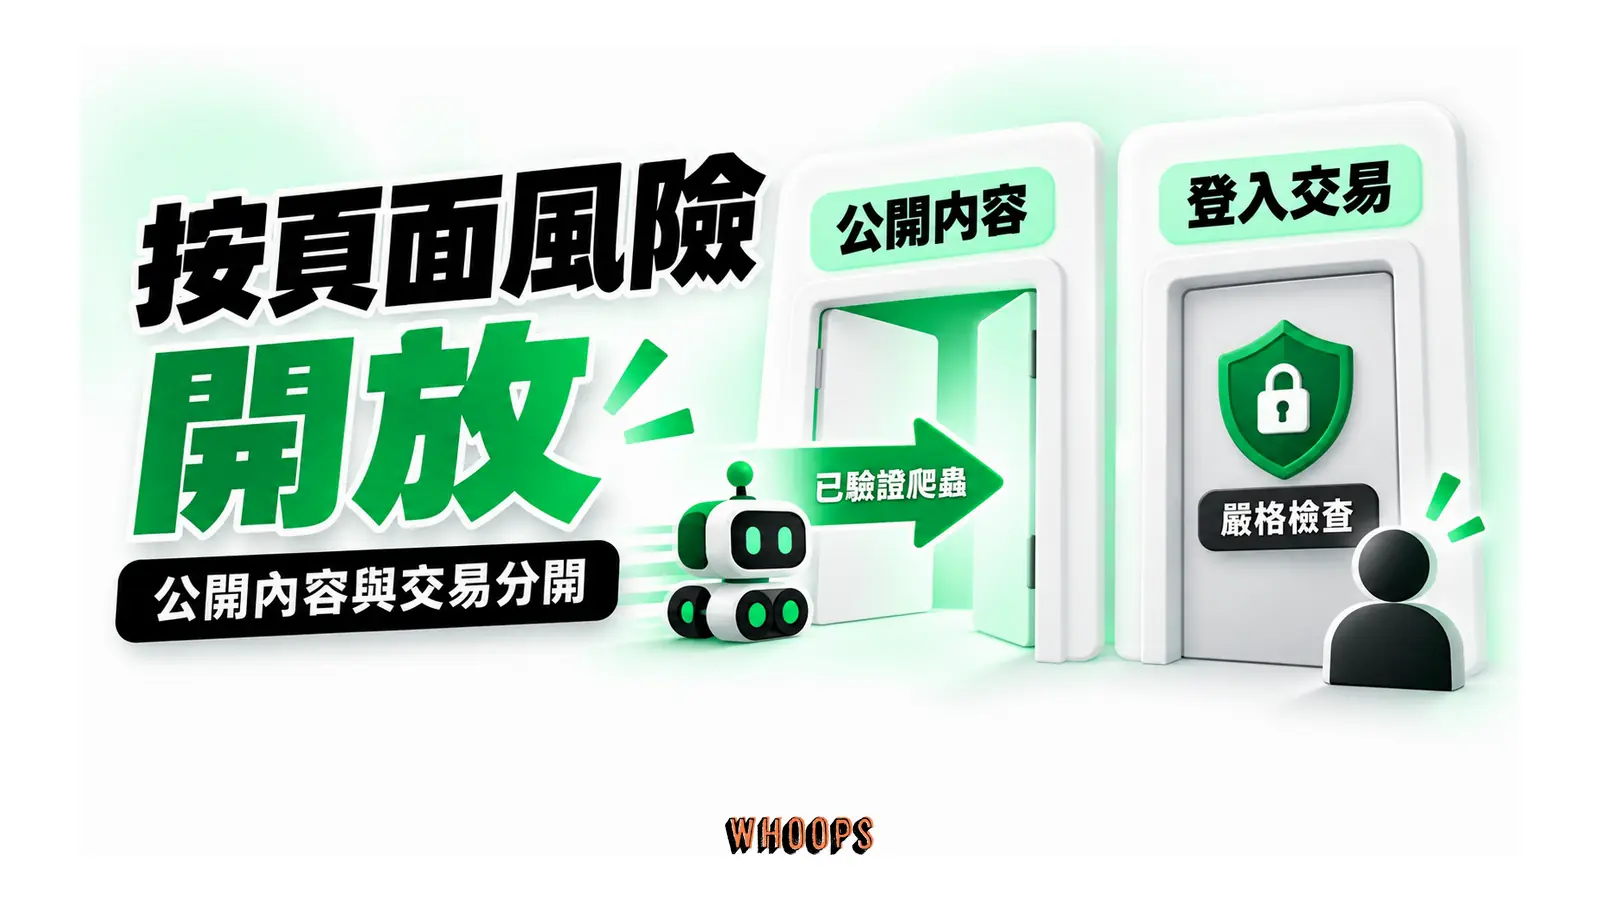
驗證之後才是決策。一個可用的思考框架是把站內路徑分成三類:公開內容(文章、產品頁、登入頁以外的行銷頁)對已驗證的搜尋爬蟲保持暢通,挑戰與阻擋都不要落在這裡;互動入口(搜尋、表單、登入)可以維持較嚴的規則,因為爬蟲不需要送你的表單;交易與私有區域(結帳、會員資料、API)繼續最強防護,只需要確認金流與第三方串接的合法流量有乾淨的例外通道。這個框架的精神跟前面誤擋排查的最小化例外一致:開放要精準,別把「對爬蟲友善」理解成全域調鬆。
決策做完後要有驗證閉環。開放也好、封鎖也好,接下來兩到四週盯著日誌:已驗證的搜尋爬蟲是否穩定回訪、被放行的 AI 服務是否真的來抓、事件紀錄裡有沒有新的誤擋模式浮出來。GEO 的邏輯與 SEO 同構:AI 服務要引用你的內容,前提一樣是它讀得到正文;防護規則在無聲中把這條路掐斷,你不會收到任何通知,只會在一段時間後的能見度變化裡看到結果。把「爬蟲讀得到」當成每次規則變更後的固定檢查項,是內容網站管理 WAF 與純資安視角最大的分流點。
WAF 與一般防火牆、CDN、DDoS 防護各管什麼
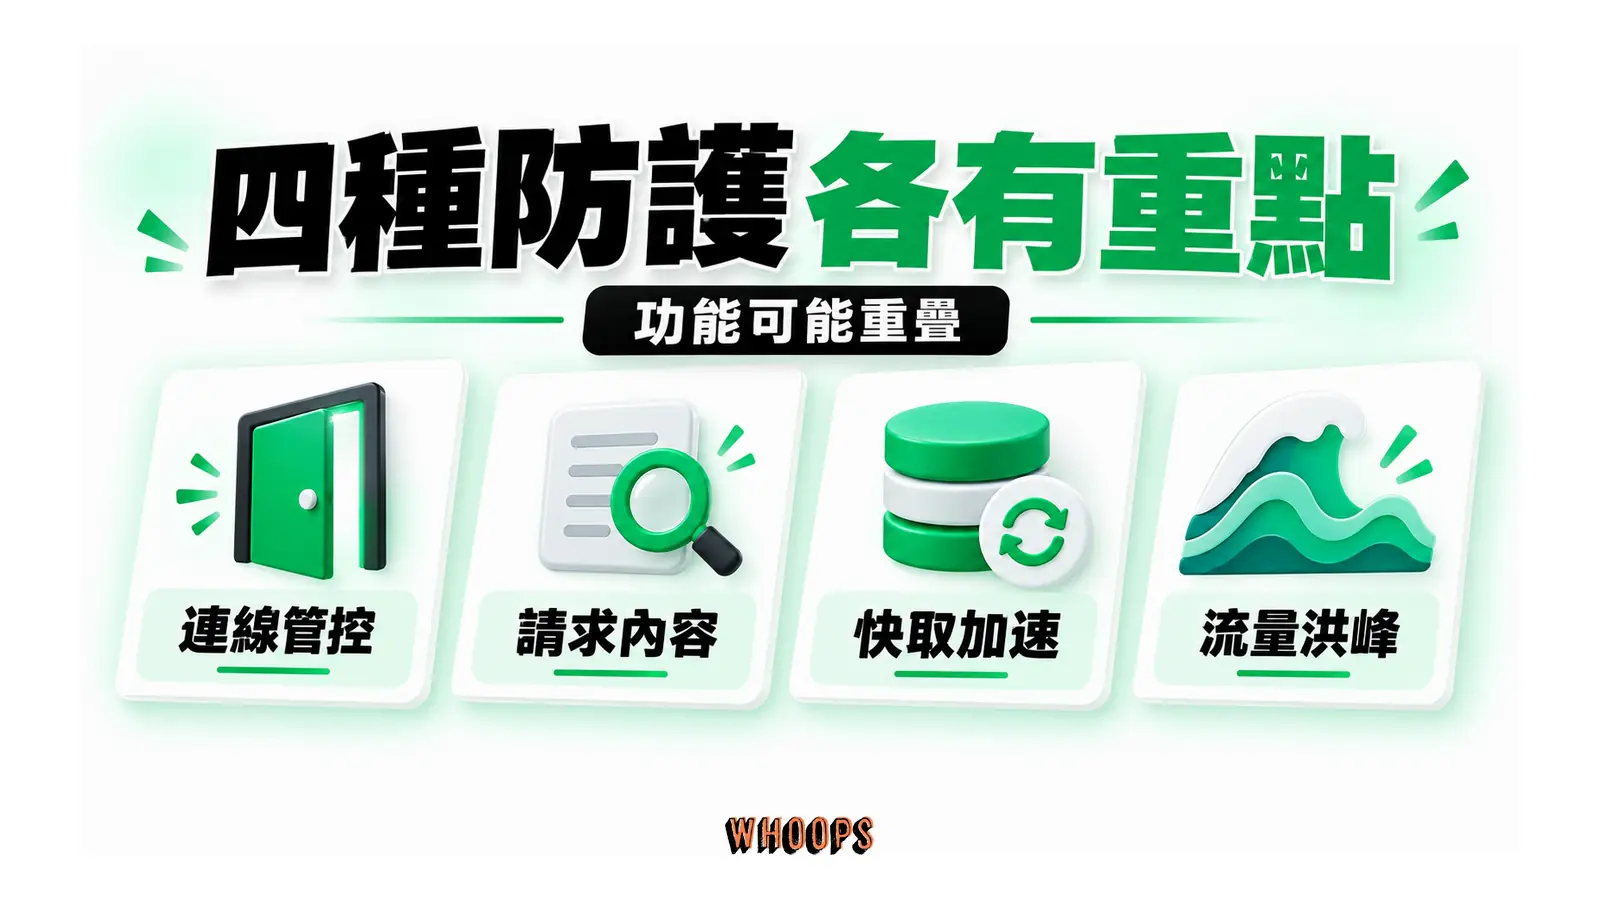
這四個名詞經常打包出現在同一張方案簡報裡,但它們解決的問題確實不同。用一個比喻先定調:一般防火牆管的是「哪些車可以開進這條路」,WAF 管的是「車上載的東西有沒有危險」,CDN 管的是「把常被索取的東西放到離你更近的倉庫」,DDoS 防護管的是「被幾萬輛車塞爆時路還通不通」。
左右捲動檢視完整表格
| 防護層 | 處理的問題 | 網站情境 |
|---|---|---|
| 一般網路防火牆 | 依連線來源、埠號與網路規則控制存取 | 只允許特定來源連到管理介面 |
| WAF | 在請求內容裡比對攻擊特徵與異常條件 | 攔下表單裡的 SQL 注入嘗試 |
| CDN | 以分散節點與快取交付內容、縮短載入距離 | 圖片與靜態資源從近端節點回應 |
| DDoS 防護 | 吸收與過濾海量攻擊流量,維持服務可用 | 流量尖峰時網站仍打得開 |
表格畫出來很乾淨,現實卻充滿重疊:現代網路防火牆多半具備應用層檢查能力;CDN 供應商幾乎都附帶 WAF 與 DDoS 功能;雲端 WAF 服務本身就以全球邊緣網路吸收流量。所以「用了 CDN 就有 WAF 嗎」這個問題的誠實答案是:不一定,要看方案與設定。同一供應商的免費與付費層,可用的規則類型可能差一個等級;CDN 開了但 WAF 功能沒啟用、或啟用了但規則包沒打開,都是常見狀態。判斷的動作永遠一樣:登入控制台,確認你的流量真的流經哪一層、那一層的哪些檢查是開的。CDN 的加速機制(命中、回源、邊緣節點)想深究的話,CDN 加速機制解析拆解得很完整,與本文的防護軸剛好互補。
分工表還提醒一件採購上的事:不要因為名稱裡有「防護」就推定需求被滿足。網站被大量流量打掛時,單靠 WAF 不是解方:它處理得了部分應用層的異常請求,體積型攻擊的吸收仍要靠 DDoS 防護與 CDN 的清洗能量;網站被挖洞注入時,DDoS 防護幫不上忙,因為它不看請求內容。對照自己的威脅清單(你的網站更可能遇到掃描與注入,還是流量攻擊?)再決定組合。
什麼時候需要 WAF?該問主機商與廠商的三個問題
不是每個網站都急著上 WAF。幾個訊號出現時,優先級才會拉高:網站有表單、會員、金流任何一種輸入入口;日誌裡出現大量異常請求(對 xmlrpc.php 或 wp-login.php 的持續敲門、奇怪的長查詢字串);同主機鄰居或同外掛生態傳出被入侵的消息;或是你的內容已經成為商業資產,任何一週的索引與流量流失都是真金白銀的損失。
若網站是交給架站公司、主機商或委外維運團隊管理,與其自己研究產品,不如把下面三個問題拿去問,答案的具體程度直接反映對方的專業水準:
- 目前網站的哪些入口受到哪一層防護?問的不是「有沒有防火牆」,而是網域清單、頁面與提交入口對應到哪個產品的哪種檢查。答不出來的,多半是方案文宣背多了。
- 規則誰更新、事件紀錄誰在看?受管理規則的自動更新是否開啟、有沒有人定期看誤擋與攻擊事件,這決定防護是活的還是布景。
- 正常流量被擋時,我該提供什麼、找誰、多久能修?誤擋一定會發生,差別在修復的介面與速度。最好當場要一次事故處理的實際流程,別接受「我們會處理」這種答案。
費用結構也值得在採購前理解清楚,三種部署對應三種成本形態:雲端代理式以訂閱方案加用量計費為主,方案等級決定可用的規則類型與功能,用量(請求數、規則數)影響帳單尾段;主機軟體式常是免費與付費版並存,成本錨在功能解鎖與支援;網路設備式則是設備採購或租賃加內部維運人力的資本型支出。具體數字隨供應商與方案變動,以各官方定價頁為準,但形態上的差異是穩定的:雲端式把成本變動化、設備式把成本前置、外掛式把成本綁在功能邊界上。還有一個隱性成本常被漏算:兩套 WAF 疊在一起(主機商一層、你自己又裝一層)不只重複計費,排查時「哪一層攔的」會變成噩夢,採購前先盤點已有的,重複的功能寧可擇一深耕。
回到開頭那句:WAF 是一道可調整的請求檢查層,它的價值取決於你把它放在哪、開了什麼、以及被它擋掉的是誰。把正常流程列清楚再上線,把爬蟲當成正常流量的一部分去保護,誤擋時用事件紀錄定位到具體規則再做最小例外。這套紀律比選哪個牌子更能決定結果。防護與可見度從來不是二選一:一個設定得當的 WAF,同時守住了網站與讓網站被世界讀到的路。