爬取預算是什麼?7 大策略提升 Google 抓取效率
爬取預算不是一個能調高的數字,而是由爬取速率上限與爬取需求兩股力量決定的抓取額度。本文完整解析爬取預算的運作機制、用 Google Search Console 檢查的方法,以及 7 大優化策略,幫你把有限預算留給真正值得收錄的內容。
本頁目錄
- 「爬取預算」到底在算什麼?先把 Google 那套黑話翻成白話
- 一個殘酷的事實:你的網站可能根本不需要為爬取預算失眠
- 怎麼知道自己有沒有「爬取預算不足」的問題?四個診斷訊號
- 七大爬取預算優化策略:沿著「速率」與「需求」兩條線下手
- 策略一(需求側):狠下心砍掉沒人要看的低價值頁面
- 策略二(速率側):用 robots.txt 把「不必被抓」的頁面說清楚
- 策略三(速率側):用 canonical 收斂重複內容,別讓爬蟲在鏡像裡打轉
- 策略四(需求側):把 XML Sitemap 當成你遞給 Google 的 VIP 名單
- 策略五(需求側):用內部連結架構決定「重要頁面離首頁多遠」
- 策略六(速率側):修正失效入口、軟 404 與冗餘重新導向
- 策略七(速率側):把網站變快,等於抬高爬蟲的速率天花板
- 三個常見的爬取預算迷思,一次拆掉
- 你的下一步行動方案
頁面進不了索引可能出在發現、檢索、重複內容、品質或技術設定,爬取預算只是其中一種原因,而且主要影響大型或高頻更新網站。網站有幾百篇文章或上千個商品頁時,不能看到未索引就先認定 Google「沒時間抓完」。
這個「Google 願意花在你網站上的抓取時間與資源」,有一個正式的名字,叫爬取預算(Crawl Budget)。而這篇要談的,就是當你網站規模漸漸變大,怎麼讓 Google 用更有效率的方式把該抓的頁面都抓到。
重點摘述:爬取預算是什麼,7 大優化策略又優化在哪?
爬取預算指的是 Googlebot 在一段時間內,願意且能夠在你的網站上抓取多少個網址。它由兩個東西決定:一是 crawl capacity limit(檢索容量上限),也就是伺服器撐得住、Google 自己設定的抓取速度天花板;二是 crawl demand(抓取需求),也就是 Google 覺得你的這些頁面有多值得被抓(見 Google Search Central 的 Crawl budget 指南)。說穿了,爬取預算就像一家餐廳一個晚上能接待多少組客人,而你要做的,是讓 Google 把有限的「座位」留給你最想被看見的頁面。這篇文章會先把這套黑話翻成白話,誠實告訴你哪些網站根本不必為它失眠,再給你七個可以實際動手做的優化策略。
如果你想把這個主題放進更大的 SEO 藍圖,建議把這篇和三個主題一起讀:一是 Google 搜尋引擎的完整運作原理,你會更清楚「爬取」在「爬取 → 索引 → 排名」這條鏈上只是第一步;二是 確認網頁有沒有被索引的方法,因為爬取之後能不能被收錄是兩回事;三是 技術性 SEO 完全指南,爬取預算正是技術 SEO 裡最容易被過度焦慮、也最容易被漏掉的一塊。
「爬取預算」到底在算什麼?先把 Google 那套黑話翻成白話
要懂爬取預算,我們得先回到 Google 怎麼認識你的網站。Google 不會憑空知道你網站上有哪些頁面,它靠的是一支叫做 Googlebot 的程式,一個網址一個網址地去抓(crawl)。抓回來的內容會被分析、決定要不要放進索引庫,最後才有資格參加排名。你可以把 Googlebot 想成一家超大型圖書館裡的採購員,每天在無數個出版商之間跑來跑去,決定哪些書要搬回圖書館。
問題是,這個採購員不是只有你一家要跑,它一次得跑遍整個網路。所以 Google 會根據每個網站的狀況,分配給它一個「今天能花多少時間、抓多少頁」的額度。這個額度,就是爬取預算。
關鍵在於,這個額度不是單一數字,而是兩股力量拔河的結果:
- Crawl capacity limit(檢索容量上限):這是 Google 願意把你的伺服器操到什麼程度而不會把它弄掛。你的網站越快、越穩,Google 敢設的上限就越高;反之,如果你的主機常常回應慢、甚至回 5xx 錯誤,Google 會自動踩煞車,把上限壓低,避免把你打爆。這是一個「保護你伺服器」的機制。
- Crawl demand(抓取需求):這是 Google 覺得你的這些頁面有多「值得」重新抓。一個頁面如果很熱門、常常被更新、有很多外部連結指過來,Google 會更想頻繁地去抓它。需求高,整體分配給你網站的抓取量就會往上推。
換個比喻會更好懂。想像 Google 是一家百貨公司的樓層主管,你的網站是其中一個專櫃。速率上限是「這個專櫃的店員一個小時能接待多少客人而不會手忙腳亂」,取決於你的人力配置與體力;抓取需求是「這個專櫃到底有多吸引人、值得主管派多少客人過來」,取決於你的人氣與口碑。主管最後實際派來的客人數,就是這兩者取其低、再加上他自己的判斷後的結果,這就是你的爬取預算。
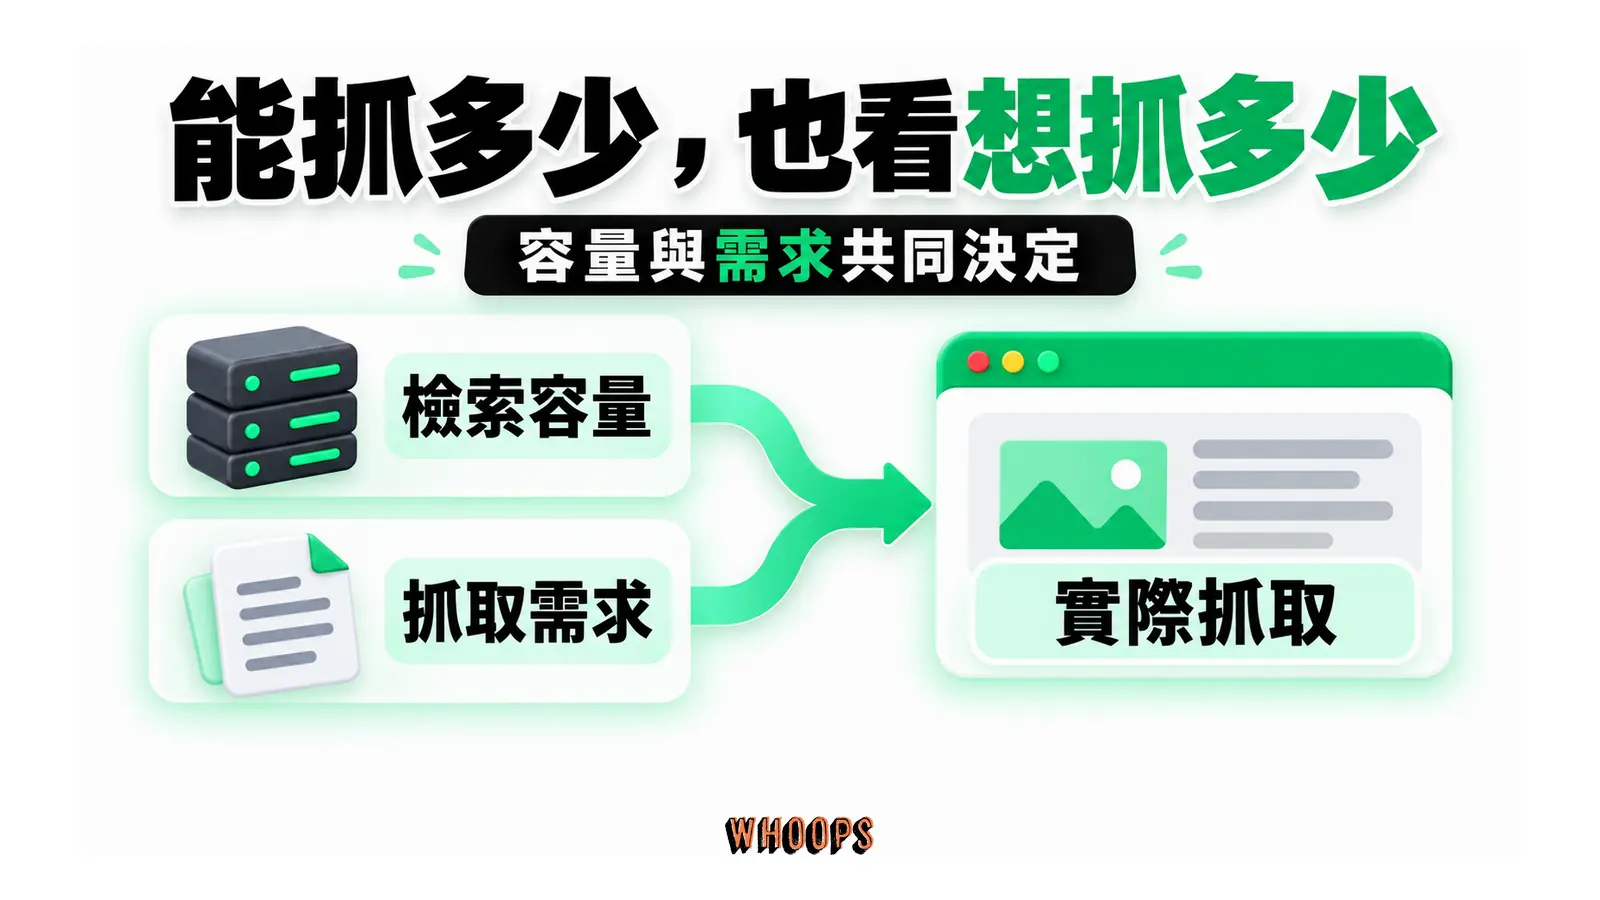
這個兩股力量拔河的觀念很重要,因為它直接決定你該從哪裡下手。你網站慢,那就是速率上限在卡你,要去解速度;你的網站充滿了沒人要看的低價值頁面,那就是需求在拖累你,要去清理內容。接下來的七大策略,就是沿著這兩條線去分的。
一個殘酷的事實:你的網站可能根本不需要為爬取預算失眠
講到這裡,得先潑一盆冷水,這也是實務上常講的一句話:絕大多數的網站,根本不需要擔心爬取預算。這不是主觀看法,Google 自己就講得很白。
Google 目前把爬取預算指南定位給大型且常更新的網站,粗略例子包括每週更新、網址達一百萬以上的站,或每天更新、網址達一萬以上的站;另一個訊號是大量網址在 Search Console 顯示「已發現,目前未建立索引」。這些是分類用估計,不是硬門檻(見 Google Crawling Infrastructure 的 Optimize your crawl budget 指南)。幾十頁官網或幾百篇部落格若新頁能及時被抓,通常先維護 sitemap 與索引報表即可。
那爬取預算到底在什麼情境下才會變成真正的問題?根據 Google 的官方說明與實務上處理大型網站的經驗,真正會被爬取預算卡住的,通常是這幾種情境:
左右捲動檢視完整表格
| 情境 | 為什麼會吃掉爬取預算 | 典型的例子 |
|---|---|---|
| 大型電商,商品加上篩選參數 | 同一個商品因為顏色、尺寸、排序、分頁等參數組合,爆出成千上萬個變體網址 | WooCommerce、Shopify 商店啟用 faceted navigation |
| 內容農場式的大量薄內容 | 成千上萬篇沒有獨特價值的頁面,把爬蟲時間耗在低回報的頁面上 | 自動產出的標籤頁、地區頁、程式拼湊的文章 |
| 論壇或 UGC 站,使用者產生大量頁面 | 個人資料頁、閒置討論串、重複的回文頁充斥 | 討論區、分類廣告、問答平台 |
| 頻繁更新的大型新聞或媒體站 | 每分鐘都有新頁面誕生,爬蟲要不停回頭抓 | 新聞媒體、即時資訊站 |
| 歷史悠久、累積大量過時頁面的老站 | 多年來堆積的舊活動頁、過期促銷、孤兒頁仍在被爬蟲發現 | 改版多次的企業官網、舊版內容未清理 |
如果你的網站落在這幾類,尤其是那種「頁面數字以萬計」的電商或內容站,那麼爬取預算就從理論問題變成實務瓶頸,這篇後面的七個策略就是寫給你的。如果你不在這幾類,你可以把這篇當成常識讀過一次,把精力先放在更會影響排名的事情上,例如 站內 SEO 的內容與技術優化,或是把 E-E-A-T 經驗訊號補起來,那才是大多數網站真正缺的東西。
在這幾種情境裡,特別把電商的 faceted navigation(篩選導覽)挑出來講,因為它是實務上看過最誇張的爬取預算黑洞。想像一個賣服飾的網站,有顏色、尺寸、價格區間、品牌、排序方式這五個篩選器,每個篩選器各有五到十個選項,再加上分頁。排列組合下來,光是同一個商品分類,就能爆出幾萬個網址變體,而其中九成以上對使用者和搜尋引擎都沒有獨特價值。Googlebot 一旦走進這個篩選迷宮,就會把大量時間花在抓這些近乎空白的組合頁上,你真正想被收錄的商品詳情頁反而排不上隊。要讓 Google 把資源花在真正有價值的頁面上,可以從分類頁與產品頁的排名策略開始規劃全站的索引優先順序。
Google 已在 2022 年移除 Search Console 的「網址參數」工具。現在要從網站端控制篩選網址:能合併的重複頁先用一致內部連結與 canonical 收斂;完全不需要 Google 抓取的無限組合,可在測試規則後用 robots.txt 阻擋;要讓已知網址退出索引,則必須讓 Google 能抓到 noindex,不能同時用 robots.txt 擋住。內容站的標籤頁與作者彙整頁也要先決定索引目的,再選工具。
這裡也要講一句公道話。很多人把「爬取預算」和「排名」混為一談,以為提升爬取預算就會提升排名,這是兩件事。爬取預算影響頁面被發現與重新抓取的效率;能否進入索引及取得排名,還要看內容、技術狀態與其他搜尋訊號。Backlinko 的 搜尋結果研究(分析 1,180 萬筆 Google 搜尋結果,2025 年 4 月)觀察到部分頁面與連結特徵和排名的關聯,但這類研究不能單獨證明因果,也不是 Google 公布的排名權重。所以請記得這個優先順序:先讓好內容有被收錄的機會,再來煩惱爬取效率。
怎麼知道自己有沒有「爬取預算不足」的問題?四個診斷訊號
既然爬取預算不是人人都要管,那你怎麼判斷自己到底需不需要動手?與其瞎猜,建議你看四個具體訊號。只要其中兩三個同時出現,就值得你認真花時間在這篇的七個策略上。
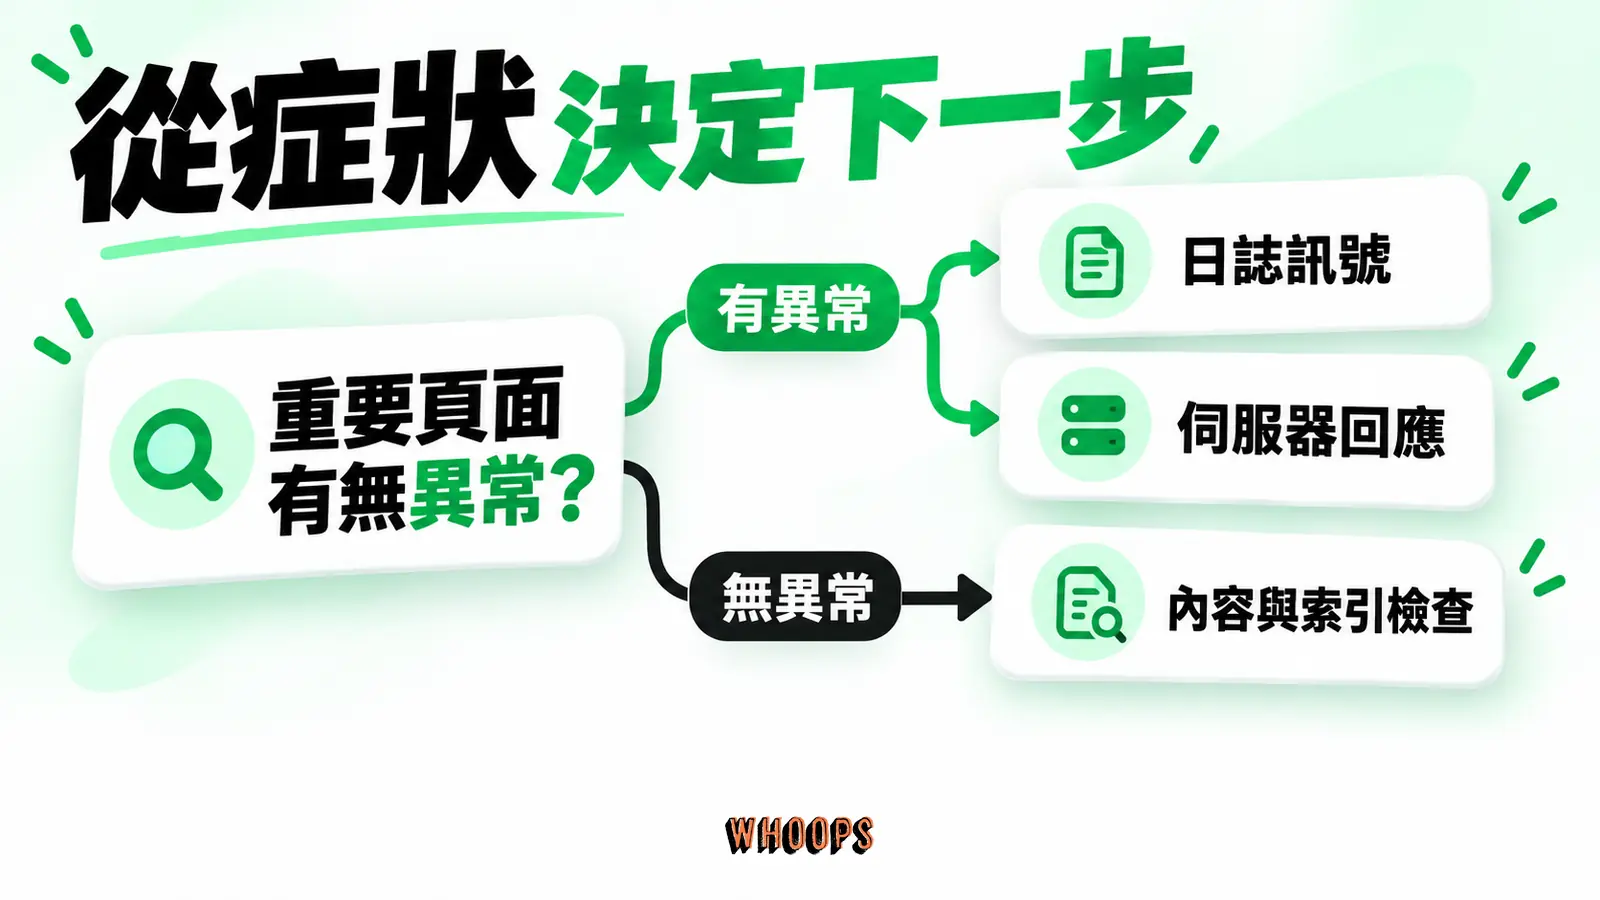
訊號一:Google Search Console 的檢索統計資料長期偏低或異常波動。進入 GSC 的「設定 → 檢索統計資料」,你會看到過去 90 天 Google 發出了多少次檢索請求、下載了多少資料、平均回應時間。一個健康的網站,這條線會隨著你新增內容而穩定起伏;抓取量低也可能是需求較低;必須合併新內容是否及時被發現、主機狀態與紀錄判讀,不能只用網站頁數除以每日請求數診斷。另一個要特別留意的訊號是回應狀態碼:如果這份報表裡出現不少 5xx 伺服器錯誤,或平均回應時間長期偏高,Google 會把你的 crawl rate limit 自動往下壓,這時候你要救的是主機與程式的穩定度,sitemap 先擺一邊。如果你還不熟悉這份報表,可以先看 Google Search Console 完整操作指南 把基本功練起來。
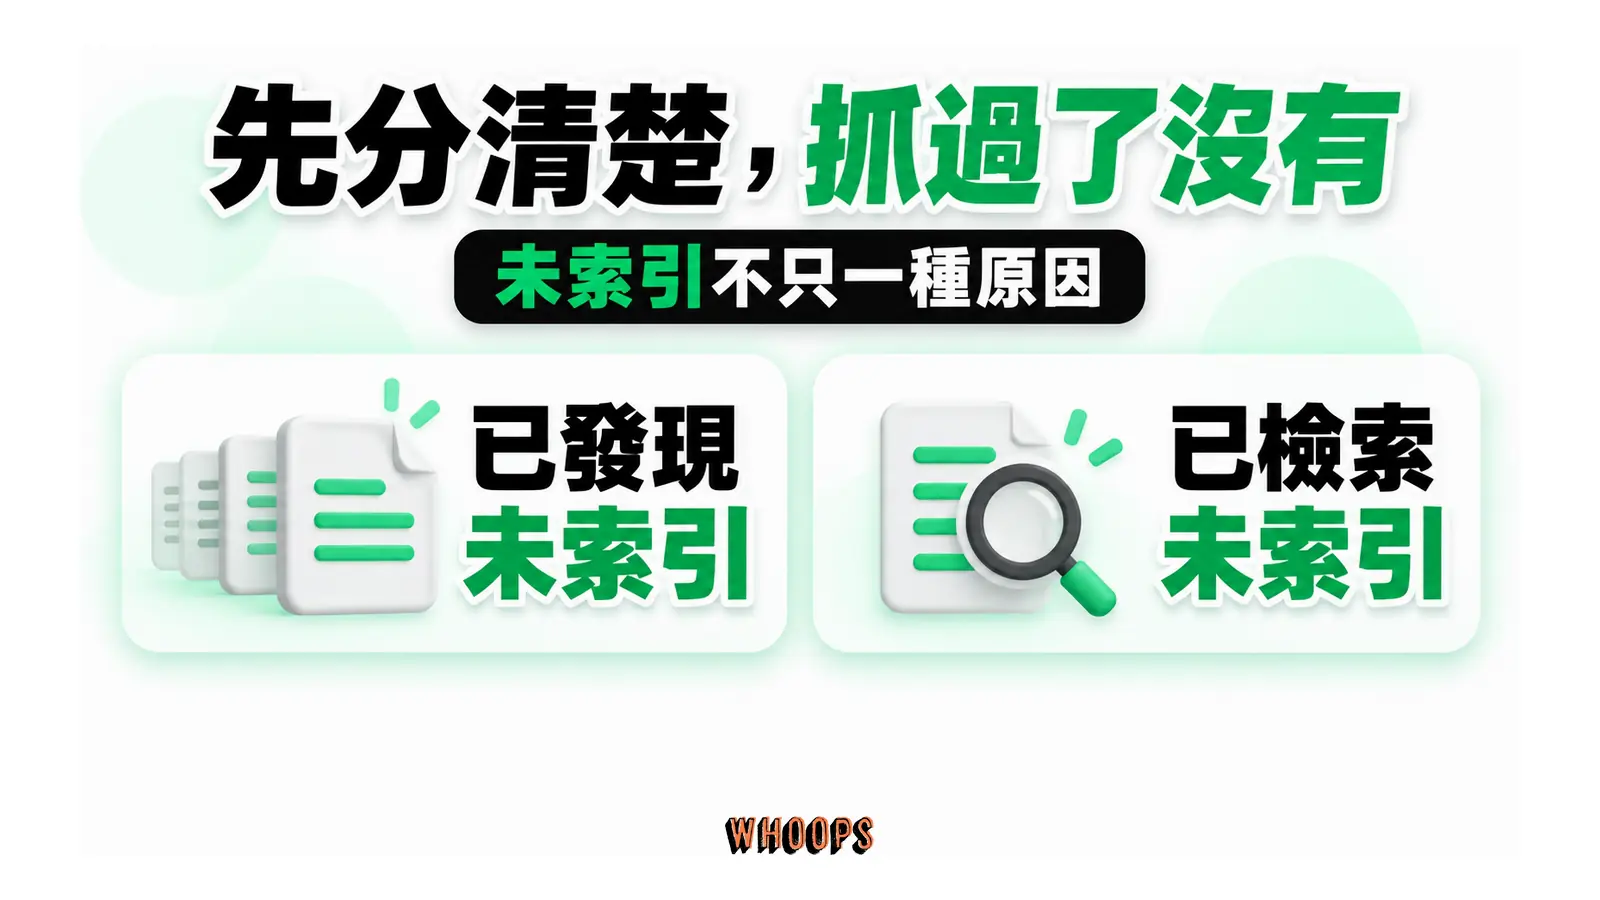
訊號二:重要頁面的索引覆蓋率明顯偏低。「已發現,目前未建立索引」可能與抓取容量或需求有關;「已檢索,目前未建立索引」則表示 Google 已抓取頁面,不能再解釋成「還沒輪到抓」,應優先檢查重複內容、品質與索引適合性。GSC 網頁索引報表有更細的判讀方法。
訊號三:檢索日期嚴重落後。Google 已於 2024 年移除 cache: 搜尋運算子與搜尋結果的快照連結,現在要確認 Google 上次抓你的頁面是什麼時候,最直接的方式是打開 Search Console 的「網址檢查」,它會顯示上次檢索時間。如果你的首頁或分類頁的上次檢索是兩三個月前,但你明明每天都更新,這表示 Google 覺得「這個站不急著回頭抓」,需求訊號偏弱。
訊號四:伺服器 Log 檔顯示大量無效抓取。這是最硬核也最準的訊號。透過 Screaming Frog 這類爬蟲工具 或直接分析 server log,你能看到 Googlebot 到底在抓哪些網址。如果你發現它把八成的心力花在抓參數篩選頁、標籤頁、已被刪除的舊頁,幾乎沒花在你真正在意的商品頁或文章上,那就是標準的爬取預算被浪費的場景。這個訊號一出現,後面七個策略你大概要用到一半以上。
老實說,這四個訊號裡,log 分析是最有含金量的一個,因為它直接告訴你「Google 到底把時間花在哪」。但實務上很多中小網站根本沒有 log 檔可看,這時候就以前三個訊號為主,搭配 GSC 的索引報告交叉判斷,已經足夠讓你決定要不要往下做。如果你真的要進入 log 分析,最基本的方法是請主機商或工程團隊匯出近 30 天的伺服器存取紀錄,先使用 Google 公布的 IP 範圍或反向及正向 DNS 核實爬蟲身分,再篩選請求;User-Agent 可以被冒用,統計它抓了哪些路徑、回傳了什麼狀態碼。這份資料會誠實告訴你哪些頁面被反覆抓、哪些從沒被青睞,是排定後續優先順序最可靠的依據。
七大爬取預算優化策略:沿著「速率」與「需求」兩條線下手
接下來是這篇的重頭戲。把七個策略沿著前面講的兩股力量分成兩組:需求側(讓 Google 更想抓、並把精力導向高價值頁面)與速率側(讓 Google 能抓得更快、更不浪費)。你會發現,多數人只會做其中一兩件事,但這兩條線一起調,效果才會疊加。
策略一(需求側):狠下心砍掉沒人要看的低價值頁面
大型網站若讓爬蟲反覆進入大量無用途的網址組合,確實可能降低整體抓取效率;但 Google 不會保證封鎖一批網址後,把同等額度轉移給其他頁面。先從可驗證的重複、無限空間與已淘汰網址下手,不要把「沒有自然流量」直接當成刪除條件。
具體要做的事,是先盤點程式自動產生的薄內容標籤頁、只為塞關鍵字而生的地方分頁、過期的活動與促銷頁,以及沒有獨特價值的重複文章,再判斷該移除、合併或補強。Ahrefs 的 搜尋流量研究(2023 年 12 月)指出,樣本中有超過九成的網頁拿不到可估算的 Google 自然搜尋流量。零流量不等於低品質或浪費爬取預算,但能作為盤點起點,再配合索引狀態、用途、連結與伺服器紀錄判斷。
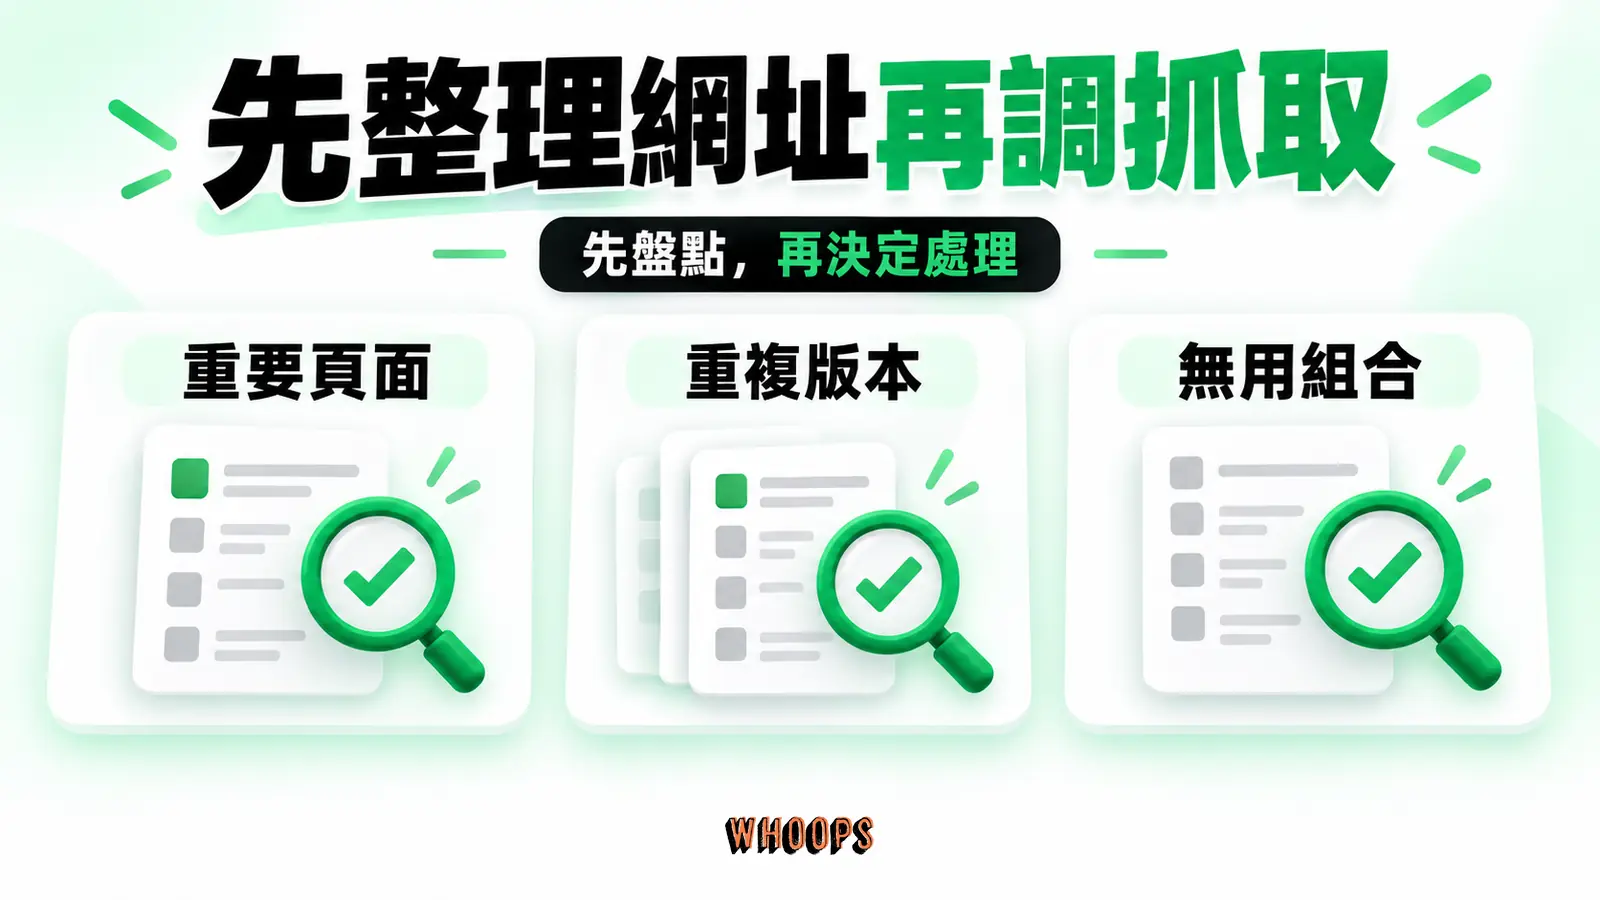
清理的做法是:先在 GSC 或 analytics 裡撈出過去一年自然流量為零的頁面,逐一判斷它們是該刪除、該合併、還是該補強。永久刪除而無替代內容的,可回傳 404 或 410 狀態碼讓 Google 知道這是永久消失;要合併的,用永久重新導向連到真正取代原內容的頁面,不把所有刪除網址導到不相關頁面。這件事的概念和 內容農場 SEO 為什麼會失敗 是同一個邏輯:別再用數量灌水,把精力集中在你真正能寫出獨特經驗的少數頁面上,反而更有機會被看見。
策略二(速率側):用 robots.txt 把「不必被抓」的頁面說清楚
robots.txt 放在網站根目錄,用來告訴遵守規範的爬蟲哪些路徑不要抓。它不是存取控制,也不能保護帳號或敏感資料;這些內容必須靠登入驗證與伺服器權限保護。大型站可用它阻擋已確認不需抓取的無限篩選與站內搜尋網址,但規則要先在測試環境驗證。
但這裡有一個常見的雷:robots.txt 跟 noindex 千萬不要搞混。如果你在 robots.txt 封鎖了一個網址,Googlebot 通常無法抓到頁面上的 noindex 標籤,網址仍可能因其他頁面的連結而出現在索引裡。這個細節在 robots.txt 與 noindex 為什麼不能同時使用 有完整的拆解。簡單的原則是:要限制一般爬取可用 robots.txt;要讓已知網址退出 Google 索引,需允許 Google 抓到 noindex。敏感內容則必須使用登入驗證或伺服器權限,不能靠這兩者保護。想更深入了解這份檔案的寫法,可以參考 robots.txt 完整介紹。
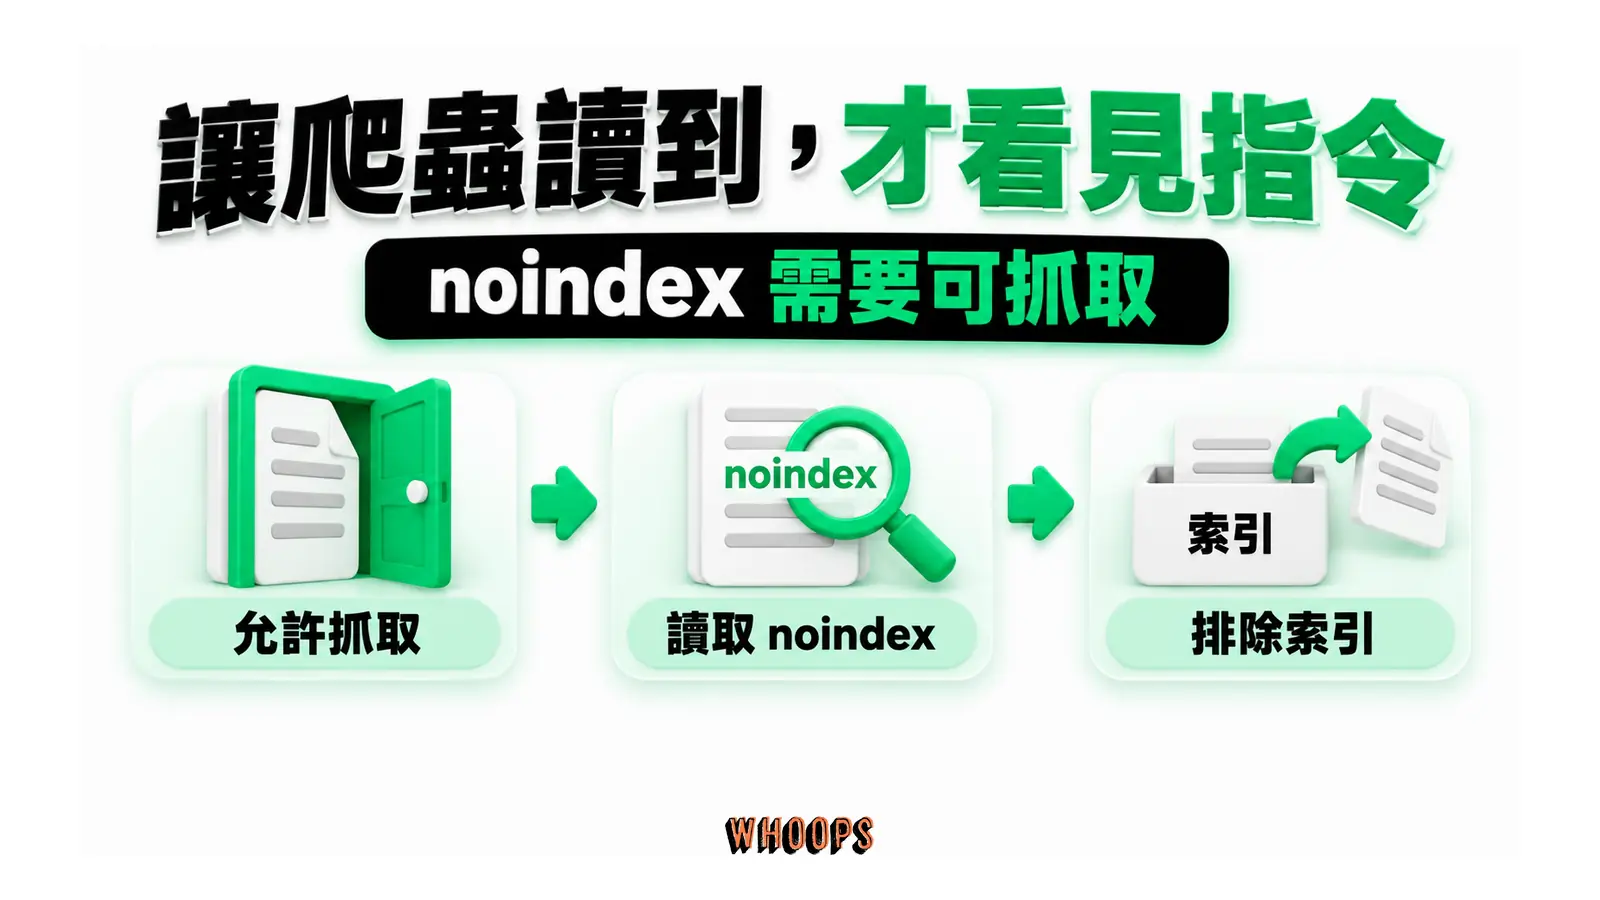
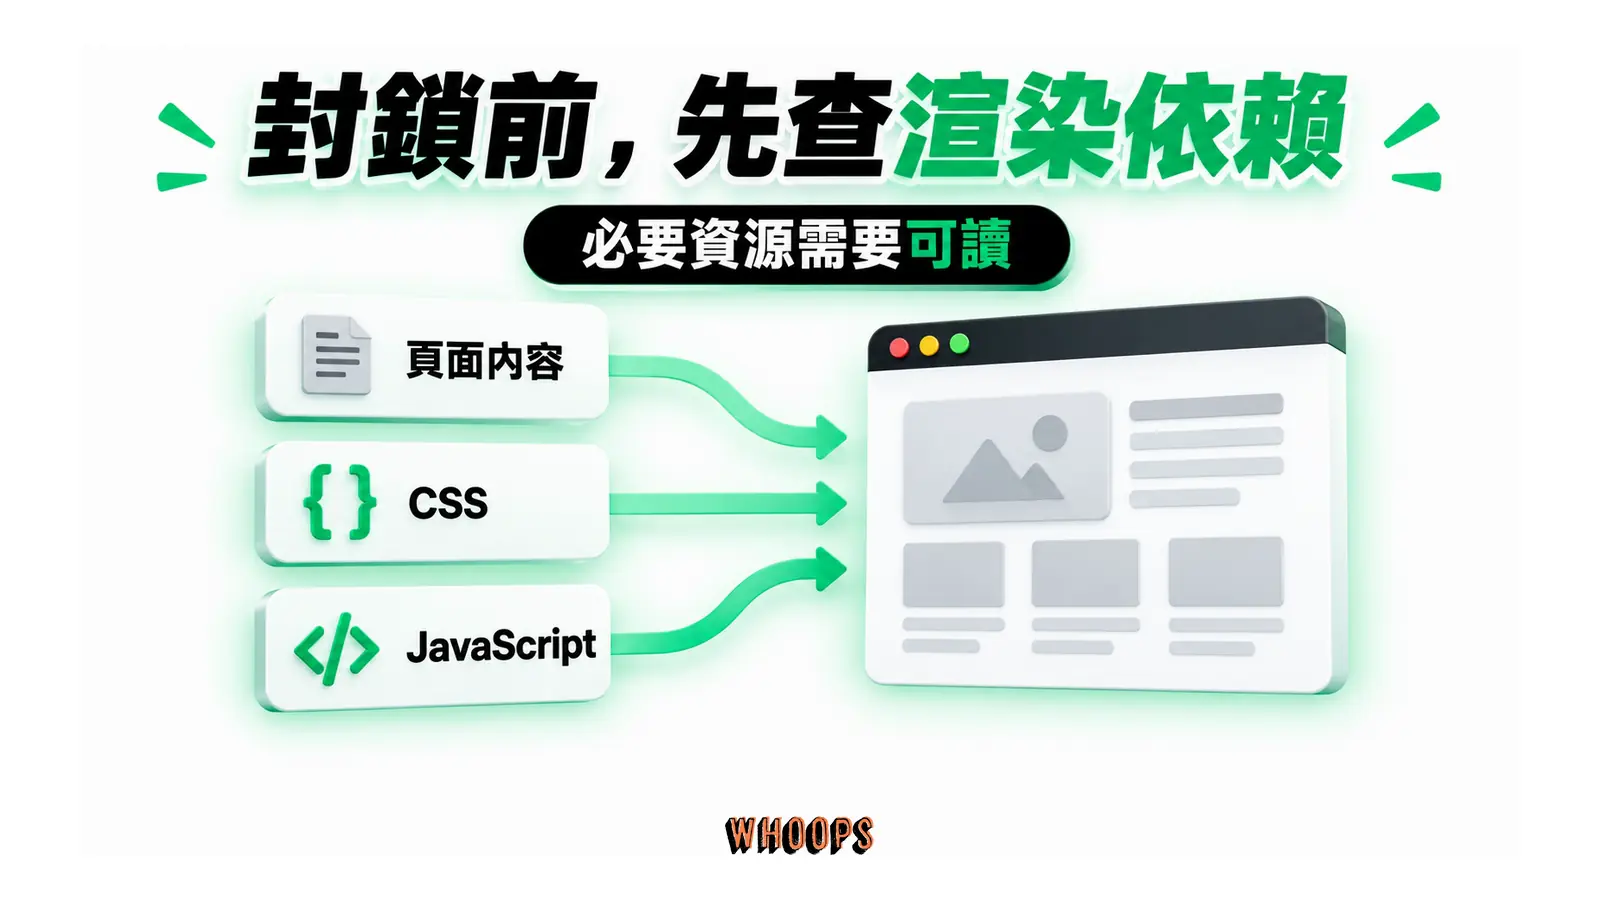
另一個 robots.txt 常見的失誤,是封鎖範圍開得太廣。實務上看過有網站為了「省爬取預算」,把整個分類目錄或 JavaScript、CSS 資源夾全部封掉,結果 Googlebot 連渲染頁面所需的樣式表與腳本都抓不到,反而無法正確理解頁面內容,排名跟著往下掉。封鎖要精準,只針對你確定不需要被索引、也不影響頁面渲染的路徑下手。如果你是用 WordPress 架站,permalink 結構本身就會產生一些預設的查詢參數頁,可以先從 WordPress 固定連結的 SEO 設定 把源頭整理好,再決定哪些要交給 robots.txt 處理。
策略三(速率側):用 canonical 收斂重複內容,別讓爬蟲在鏡像裡打轉
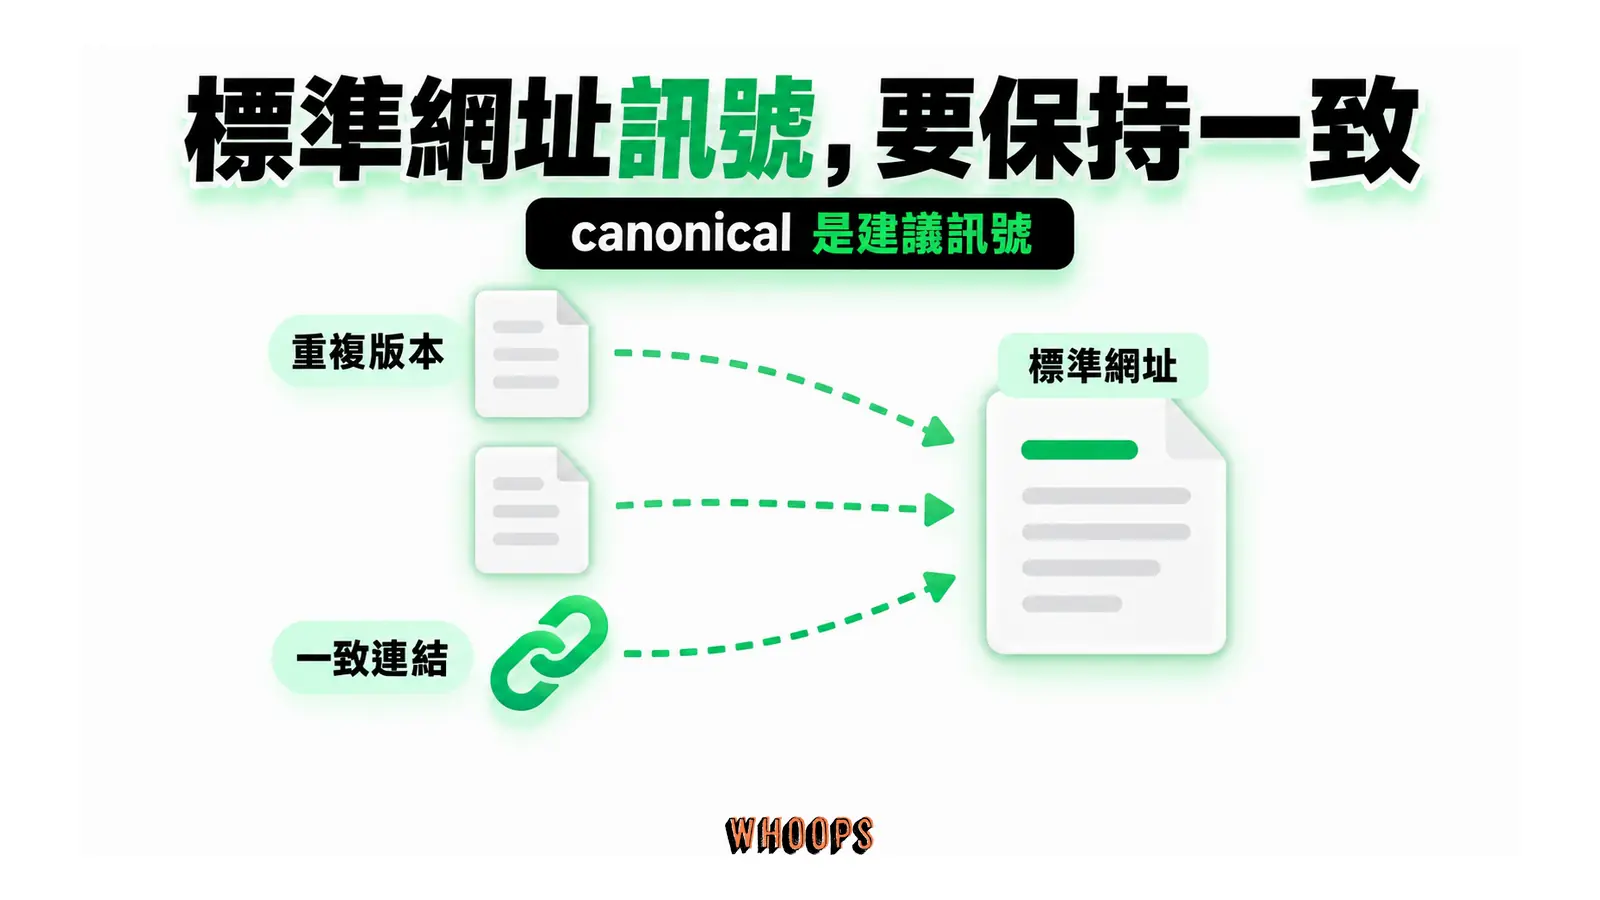
多個近似網址會增加抓取與維護成本,但 Google 通常會自行選擇標準版本並合併相關訊號,不是看到重複網址就必然稀釋排名。站方仍可整理網址與內部連結,減少無用途的變體。
解法是 canonical 標籤。在每一個變體網址的 <head> 裡放上 <link rel="canonical" href="標準網址">,明確告訴 Google「這幾個網址其實是同一篇,請把權重併到這個標準網址上」。這個動作本身也牽動重複內容的 SEO 判定,完整的設定邏輯可以看 Canonical URL 完全指南。如果你的網站重複內容問題是全面性的,也建議一併讀 SEO 重複內容的成因與解法,把源頭堵掉,而不只是靠 canonical 補救。
策略四(需求側):把 XML Sitemap 當成你遞給 Google 的 VIP 名單
XML Sitemap 的主要用途是協助搜尋引擎發現希望被索引的標準網址,並提供可信的最後修改時間。大型網站應讓 sitemap 只包含可索引、回應正常且 canonical 一致的網址;它不會直接傳達排名或抓取優先級,仍須搭配內部連結、伺服器狀態與內容更新。
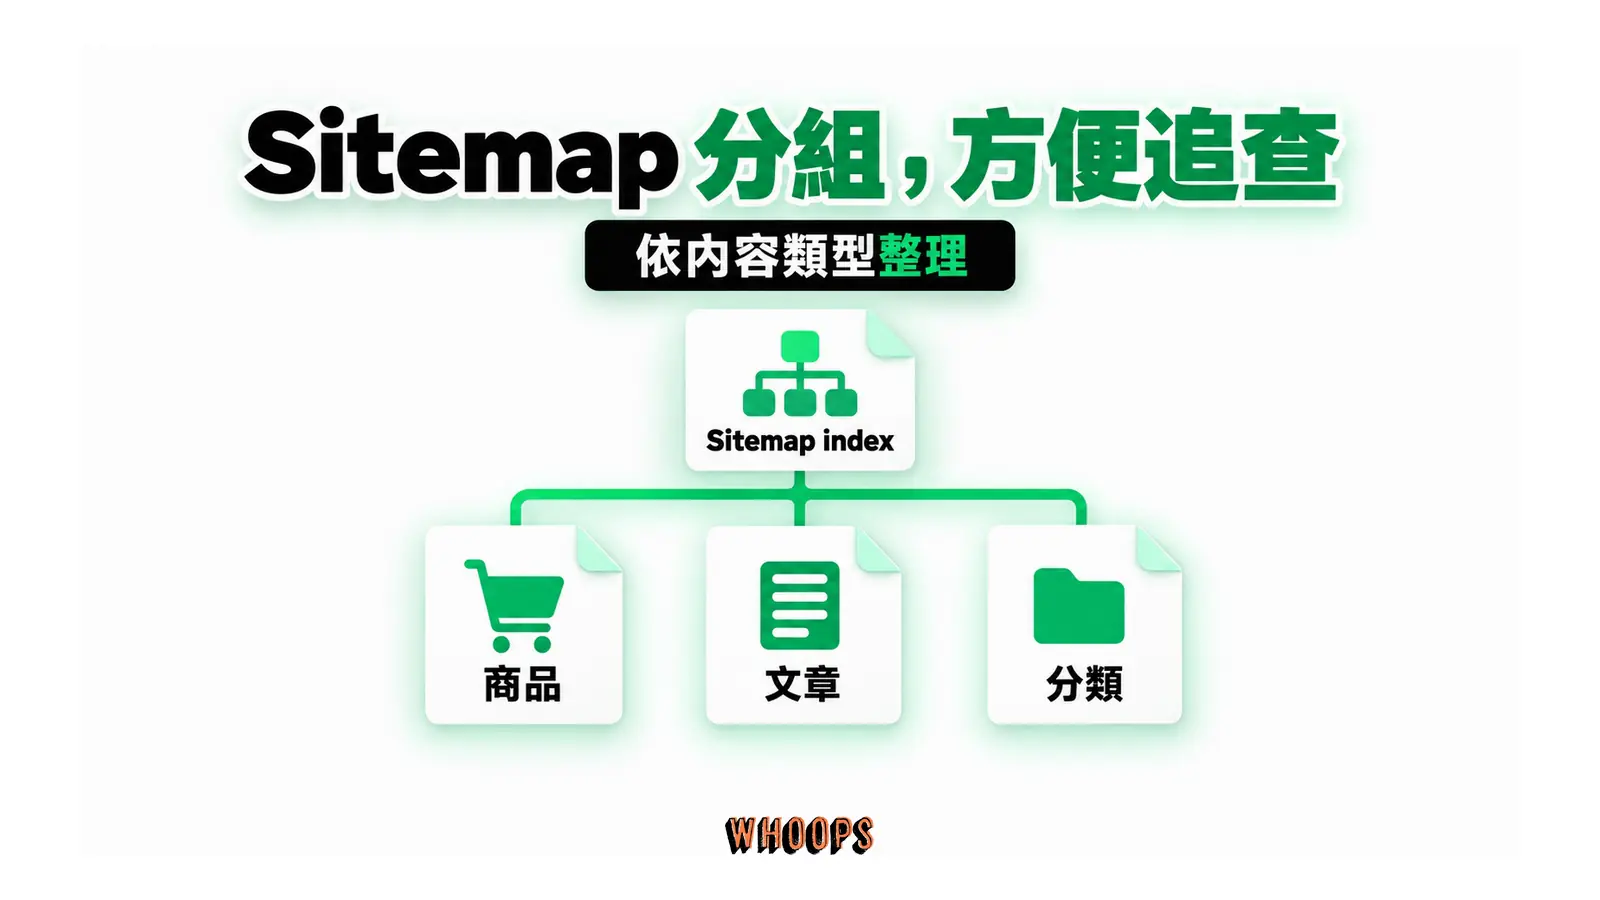
實務上有三個要點。第一,sitemap 裡只放你真的想被索引、回傳 200、且沒有 noindex 的頁面,不要把已被封鎖或重複的網址也塞進去,那會混淆訊號。第二,保持更新頻率和你的內容產出同步,新增的重要頁面要盡快進 sitemap,Google 才會盡早知道。第三,善用 sitemap index 把大型網站拆成多個子 sitemap(例如商品一個、文章一個、分類一個),方便你日後逐區診斷。完整的產生與提交流程,可以照著 Sitemap 產生與提交實作教學 一步步做,背後的概念則在 網站 Sitemap 入門指南 裡有完整說明。
策略五(需求側):用內部連結架構決定「重要頁面離首頁多遠」
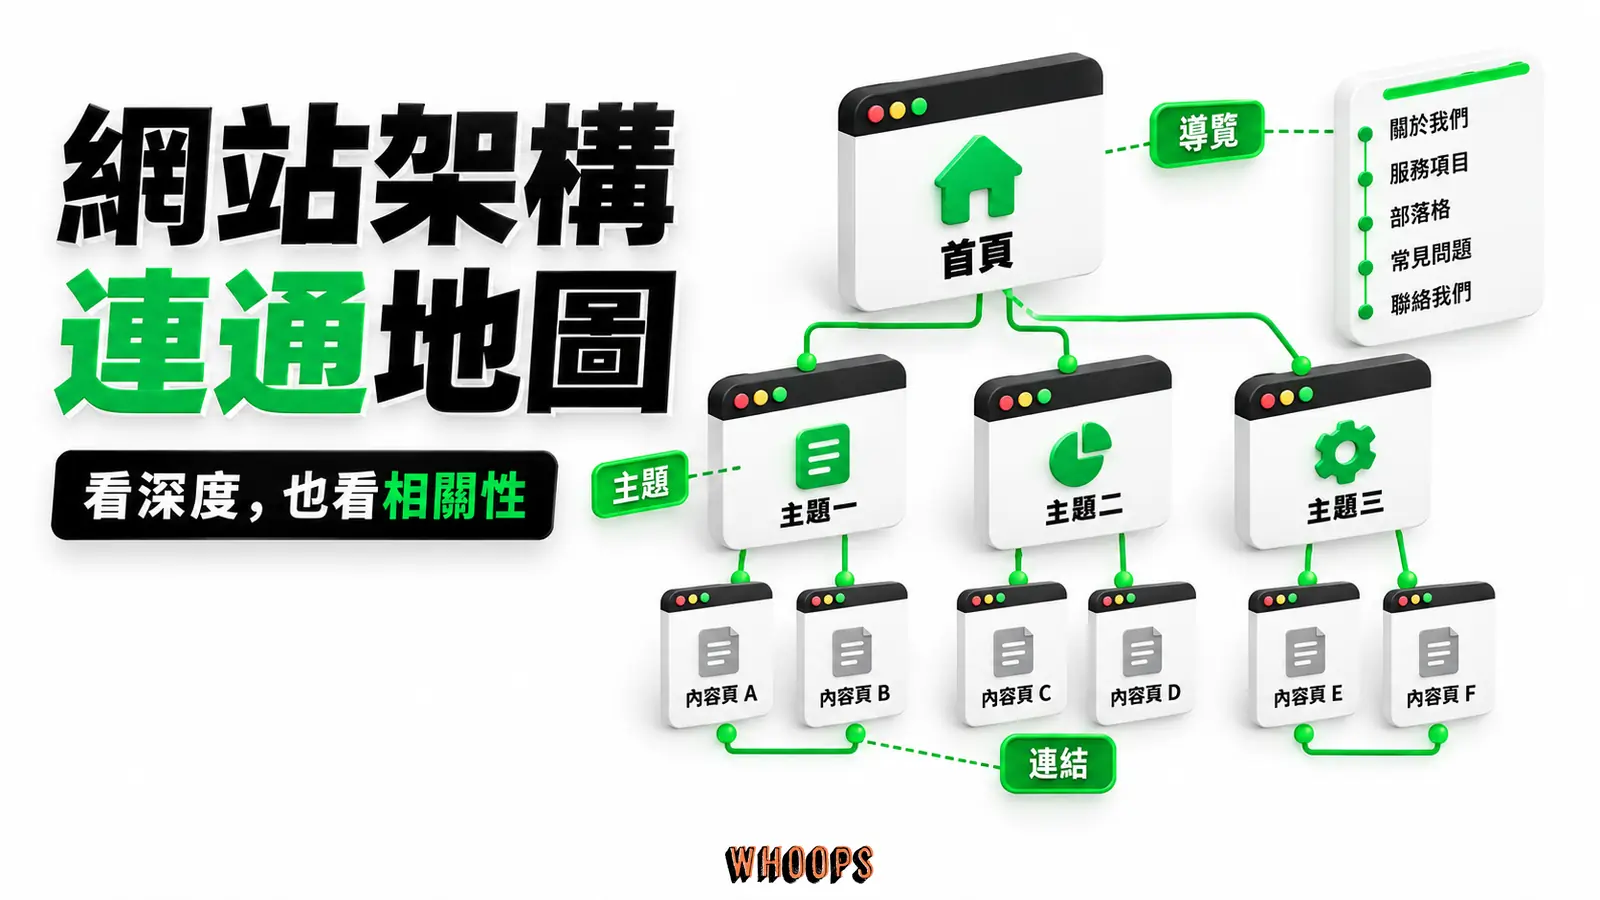
可爬取的內部連結能幫助發現重要頁面。讓常用內容容易從首頁、分類或相關頁面抵達,是合理的導覽目標;Google 沒有通用的兩三次點擊排名門檻,也不能由單一深度值推算抓取頻率。
具體的做法是建立一個扁平(flat)的網站架構:首頁連到主要分類頁,分類頁連到子分類與重點商品頁,再用支柱頁(pillar page)與主題叢集把同主題的內容串起來。這牽涉到整體的 網站架構與 SEO 規劃,也是 站內 SEO 裡影響最深遠的一塊。一個常見的錯誤是把重要商品頁埋在篩選層層之下,或讓它只靠一個孤零零的內部連結支撐;把它拉到離首頁更近、從多個相關頁面收到連結,爬蟲自然會更頻繁地路過它。
策略六(速率側):修正失效入口、軟 404 與冗餘重新導向
內容永久移除、又沒有替代頁面時,404 或 410 是正確回應,無須消滅所有 404。應修正的是仍指向失效內容的站內入口,以及實際顯示找不到內容卻回傳 200 的軟 404。
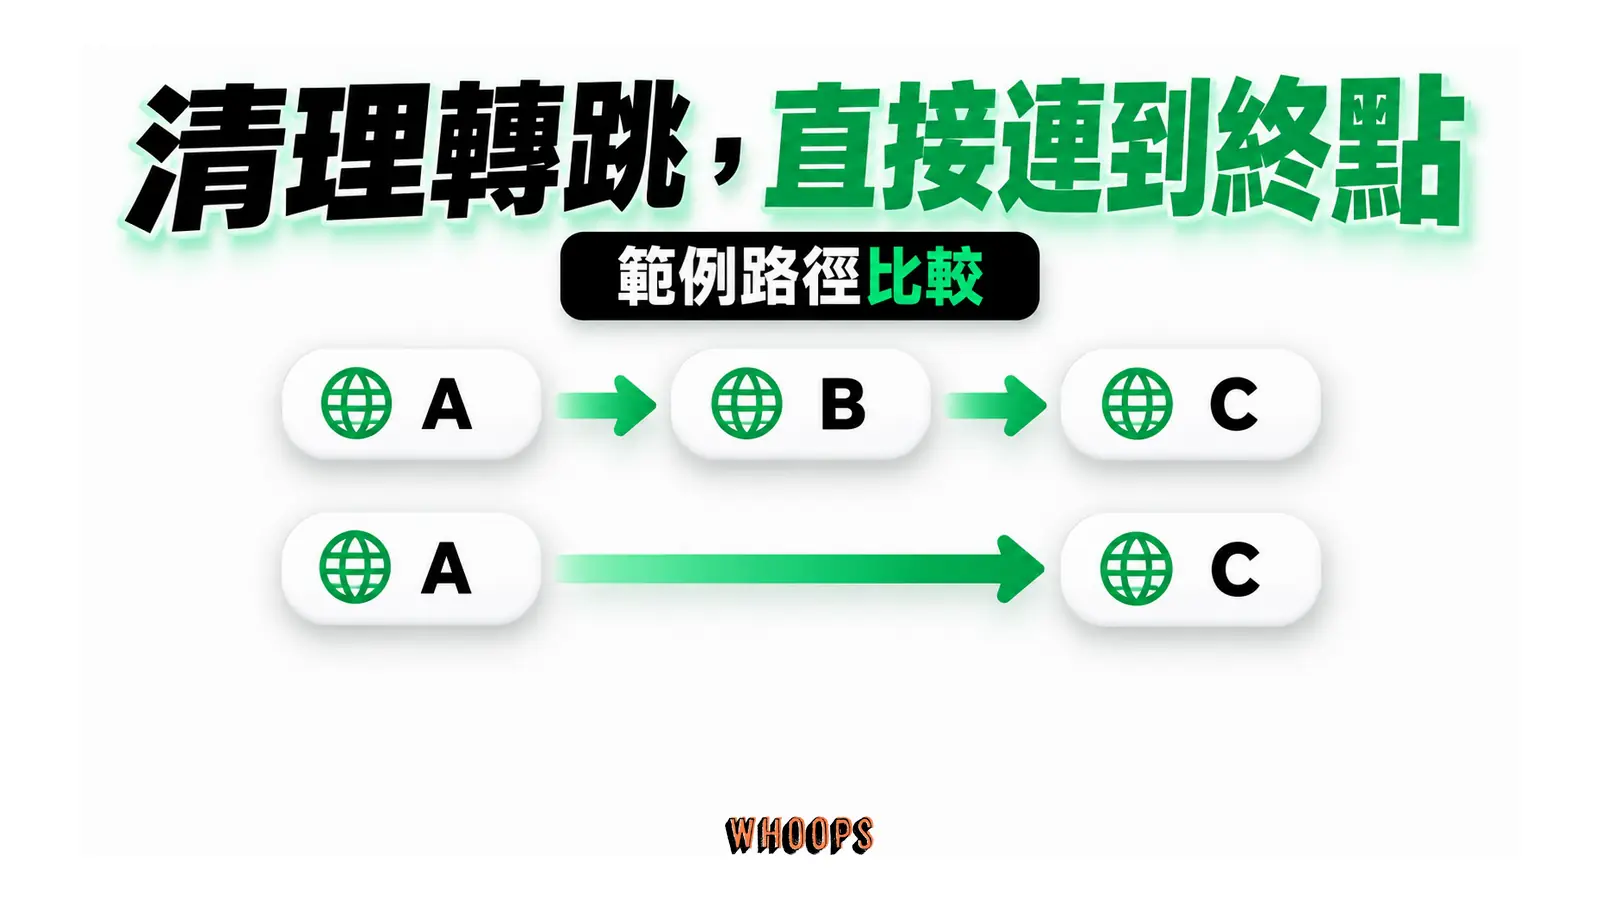
重新導向鏈則是另一個隱形消耗。如果一個網址經過 A → B → C 兩次轉跳才到終點,Googlebot 等於必須處理額外請求。大型網站尤其容易在改版過程中累積出好幾層 redirect chain。處理原則是:定期用爬蟲工具掃出全站的 404 與轉跳鏈,把該修的內部連結直接指向最終網址,能合併的轉跳就合併成一步。怎麼設計一個不會誤導使用者的 404 頁、以及 301 與 302 各自該用在什麼時機,分別可以看 404 頁面設計 與 301 與 302 重新導向指南。
策略七(速率側):把網站變快,等於抬高爬蟲的速率天花板
穩定的伺服器回應與較低延遲可改善檢索容量,但抓取量也取決於需求與 Google 資源。網站變快不等於抓取量或排名必然上升,應先確認瓶頸是否真的在主機容量。
實務上能做的包含:把主機升級或搬到回應更快的環境、用 CDN 加速 縮短全球各地使用者的等待時間、開啟 圖片與資源的 lazy loading、系統性地做 圖片壓縮(圖片往往是最大的頻寬消耗)。這些加起來,會直接反映在 Google 的 Core Web Vitals 指標上,你可以用 Core Web Vitals 與 網頁速度優化 的方法持續追蹤。速度這條線,是少數能同時提升爬取預算、使用者體驗、與排名訊號的投資,千萬別省。
把七個策略走完一遍,你大概會發現它們彼此會互相疊加。為了讓你在動手時有個輕重的依據,把這七招整理成一張對照表,標出每一招主要施力的那條線、實作難度、以及預期的回收速度。你可以把它當成排定優先順位的參考就好,沒有非照著做的道理。
左右捲動檢視完整表格
| 策略 | 主要施力點 | 實作難度 | 驗證重點 |
|---|---|---|---|
| 砍掉低價值頁面(策略一) | 需求側 | 中(需要逐頁判斷) | 重要內容是否更容易被發現 |
| robots.txt 封鎖無效路徑(策略二) | 速率側 | 低 | 不需抓取的路徑是否依規則排除 |
| canonical 收斂重複內容(策略三) | 速率側 | 低至中 | 標準網址是否符合預期 |
| 清乾淨 XML Sitemap(策略四) | 需求側 | 低 | 依實際紀錄確認 |
| 內部連結扁平化(策略五) | 需求側 | 中至高(牽動資訊架構) | 導覽與重要入口是否改善 |
| 修復 404 與轉跳鏈(策略六) | 速率側 | 低 | 依實際紀錄確認 |
| 網站提速(策略七) | 速率側 | 中至高 | 回應時間、錯誤與使用體驗 |
先處理已確認的阻擋、伺服器錯誤與無限網址,再依紀錄決定內容、Sitemap 或導覽的優先順序。刪頁與 robots.txt 封鎖不是所有網站的首選;阻擋網址也不保證將等量預算移給其他頁面。
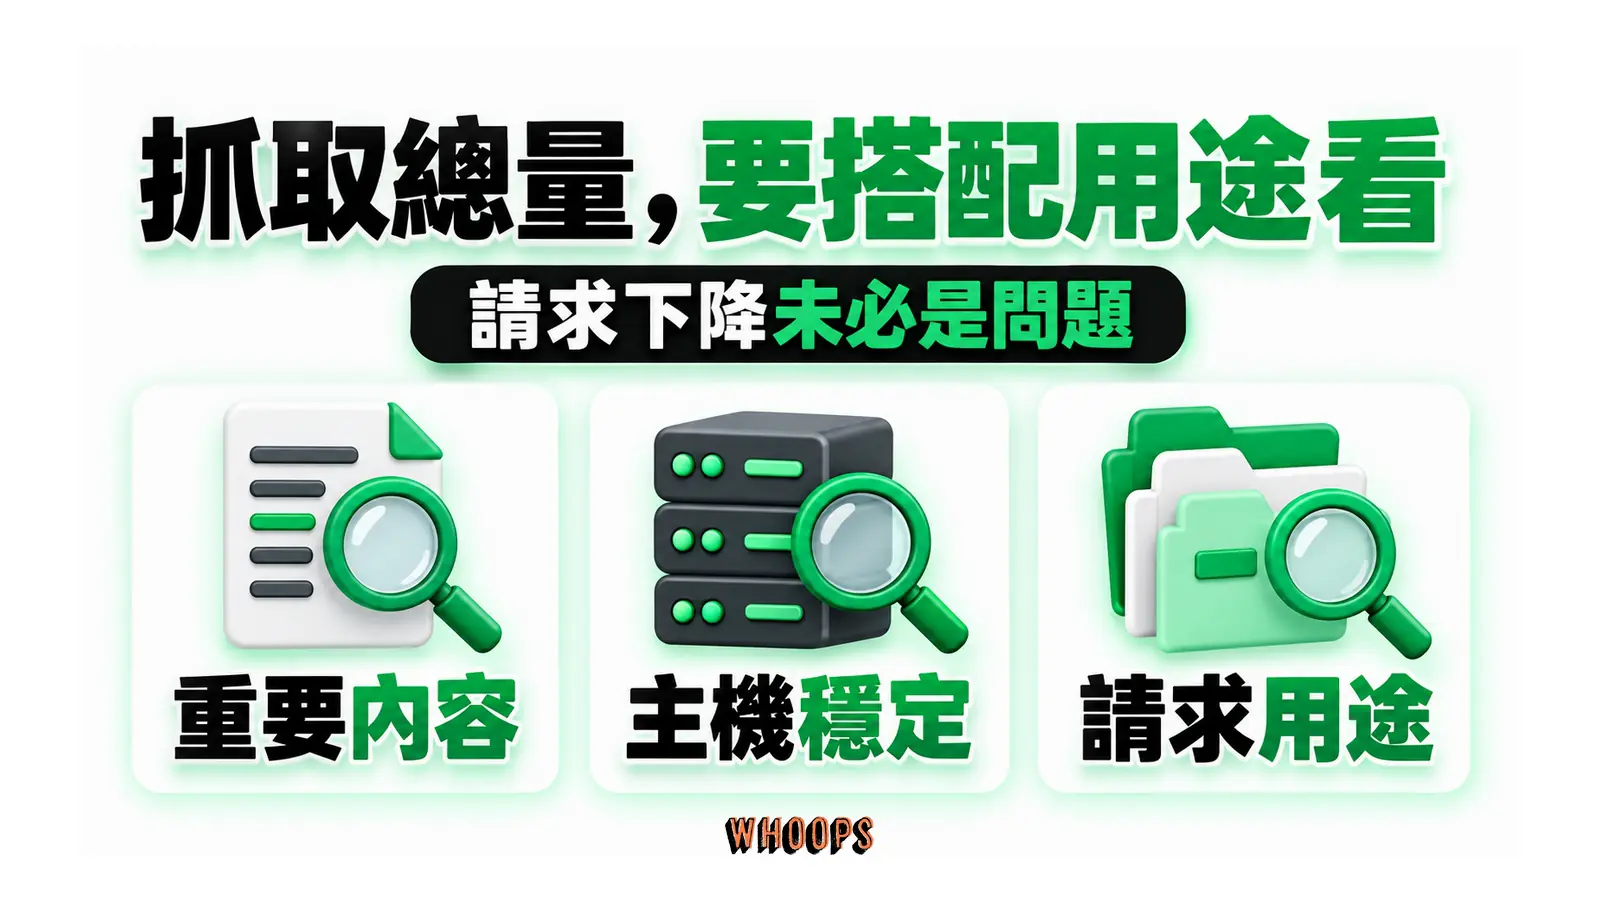
檢索統計應合併三個面向判讀:重要內容是否及時被抓、主機是否穩定,以及請求花在哪些資源與用途。清理重複網址後,總請求數下降也可能是合理結果;301、304 和正確的 404 不一定是錯誤。檔案類型指的是 HTML、圖片、CSS 等,不會直接替你分類商品頁或文章,後者需要站方紀錄或日誌分析。
如果你對 GSC 還不熟,這份報表背後的介面邏輯可以對照 Google Search Console 進階技巧 來看;而當你想針對單一重要網址、確認它目前的檢索與索引狀態,則可以用 網址檢查工具 做更精準的診斷。這一套診斷流程,也是大多數技術性 SEO 健檢會走的基本盤。
這裡還有一個很多人漏掉的細節,特別值得在前端很重的網站提出來:如果你的網站大量仰賴 JavaScript 才能渲染出內容,那麼 Google 處理你的頁面會比一般靜態頁面多一道手續。Googlebot 通常會把回應 200、且未收到 noindex 的頁面排入渲染佇列,不僅限於 JavaScript 網站。等待時間會變動;「已檢索但未索引」不能直接證明頁面正在等渲染。如果你懷疑自己卡在這裡,可以先讀 JavaScript SEO 的運作機制,把關鍵內容盡量放進伺服器端回傳的原始 HTML,降低關鍵內容必須等腳本執行才出現的依賴。把這個觀念和前面的「爬取 → 索引 → 排名」鏈接在一起看(更完整的脈絡可以參考 檢索在搜尋流程裡的位置),你會更明白為什麼有些網站明明被抓得很勤,內容卻始終進不了索引。
三個常見的爬取預算迷思,一次拆掉
下面拆掉三個常見迷思。這些觀念如果沒被導正,會讓你把力氣花錯地方。
左右捲動檢視完整表格
| 常見迷思 | 實際情況 |
|---|---|
| 「提交了 Sitemap,Google 就一定會來抓。」 | Sitemap 只是「建議名單」,不是「保證書」。Google 會綜合判斷頁面的需求、品質與你網站整體的速率上限後決定抓不抓,不是你提交了它就照單全收。 |
| 「用了 noindex,等於保住了爬取預算。」 | 不一定。noindex 只是不讓頁面進索引,但 Googlebot 仍可能去抓這個頁面。要真正停止抓取,得在 robots.txt 封鎖;但兩者別同時用,原因前面策略二講過了。相關細節可以延伸讀 noindex 完整介紹。 |
| 「爬取預算高一點,排名就會好一點。」 | 這是兩件事。爬取預算影響頁面被發現與重新抓取的效率,不會讓低價值頁面因為抓得勤就排得比較前面。 |
這三個迷思的本質都一樣:把「爬取」這個前置動作,誤當成排名保證。釐清這條界線,你才會知道爬取預算優化在你的 SEO 全局裡,到底值不值得投入,以及該排在第幾順位。
在進入行動清單之前,先幫你設一個合理的期待。爬取預算的優化不是一打開開關就立刻見效的事,它更像在調整一台機器的齒輪:你修好一個環節,Google 通常需要幾週到幾個月才會在抓取行為上反映出來。所以與其每天盯著檢索統計資料的數字焦慮,不如給自己一個月的觀察期,每次只動一兩個變數,再回來比對前後差異。這種慢慢校準的節奏,才是大型網站做技術性 SEO 最務實的方式。如果你過去曾在 SEO 上吃過急就章的虧,SEO 常見錯誤 裡有更多值得借鏡的教訓,建議一併看看。
你的下一步行動方案
讀到這裡,別只想著把七個策略背下來,現在就動手做一件具體的事更實在。這裡給你一個可以這個禮拜就跑完的行動清單:
- 先確認自己需不需要管這件事。打開 GSC 的檢索統計資料,看看過去 90 天的抓取量與你的網站規模搭不搭。如果你的頁面不到幾千個、抓取量也正常,就把這篇存起來,回去把心力放在內容與 反向連結 上,別過度優化。
- 盤點低價值頁面。從 analytics 撈出過去一年零流量的頁面,列出清單。該刪的刪、該合併的合併、該補強的補強。這是性價比最高的第一步。
- 檢查 robots.txt 與 noindex 有沒有打架。把你封鎖的網址逐一過一遍,確認沒有「robots.txt 封鎖了,卻又在頁面放 noindex」的矛盾組合。
- 清查重複網址與轉跳鏈。用爬蟲工具掃一次全站,把參數造成的重複頁加上 canonical,把多層 redirect 攤平成一步。
- 把你的 XML Sitemap 清乾淨。只放高優先、可索引、回傳 200 的頁面,移除被封鎖與重複的網址,重新提交。
- 挑一個速度瓶頸,本週修掉它。從 CDN、圖片壓縮、lazy loading 裡挑一項動手,這是長期複利最高的一步。
- 設一個月一次的健檢節奏。每個月回來看一次檢索統計資料,確認抓取量與重要頁面索引覆蓋率在往對的方向走。
爬取預算這件事,最迷人的地方在於它把一個抽象的「Google 怎麼看我網站」的問題,變成了一張你可以實際調整的資源分配表。你不需要一次把七個策略全做完,但只要照著上面這個節奏走,你會慢慢看到 Google 把力氣花在對的頁面上,而那些真正用心寫的內容,也才終於有機會被看見。
也要提醒一句:爬取預算優化最後往往會逼你面對一個更深層的問題,那就是你的網站到底有沒有「值得被收錄的內容」。如果你清完低價值頁面後,發現剩下的頁面其實也談不上有獨特經驗或觀點,那真正的瓶頸往往出在內容本身,爬取預算只是代罪羔羊。這種時候,與其繼續在 robots.txt 與 sitemap 上鑽牛角尖,不如把力氣轉去補強 長尾關鍵字策略 與內容深度,讓每一個被收錄的頁面都值得被收錄。技術面把門打開,內容面把人留住,這兩條腿一起走,才是 SEO 真正能滾出雪球的關鍵。這也是為什麼每當有人問起,被 Google 演算法 波及、或流量莫名下滑時該從哪裡查起,實務上總會建議先回頭確認兩件事:一是技術面有沒有把好內容擋在門外,二是內容面有沒有真的在為真人解決問題。把這兩點想清楚,爬取預算自然會回到它該有的位置,一個重要的支援角色,而不是主角。
如果你在跑這個清單的過程中,發現自己的網站規模已經大到光靠自己難以盤點,或是需要有人陪你一起把網站架構、技術 SEO 與內容策略重新理一遍,這正是 Whoops SEO 平常在幫客戶做的事。需要找人一起理一遍時,Whoops SEO 隨時可以聊聊;不過最重要的,還是你今天願意從清單上挑出第一件事,真的動手做下去。剩下的,時間會證明。