LLM 爬蟲日誌分析:從伺服器日誌看懂 AI 爬蟲
LLM 爬蟲日誌分析怎麼做:從伺服器存取日誌辨識 GPTBot、ClaudeBot 等 AI 爬蟲,區分訓練與檢索用途,再用 robots.txt 放行搜尋、拒絕訓練。
本頁目錄
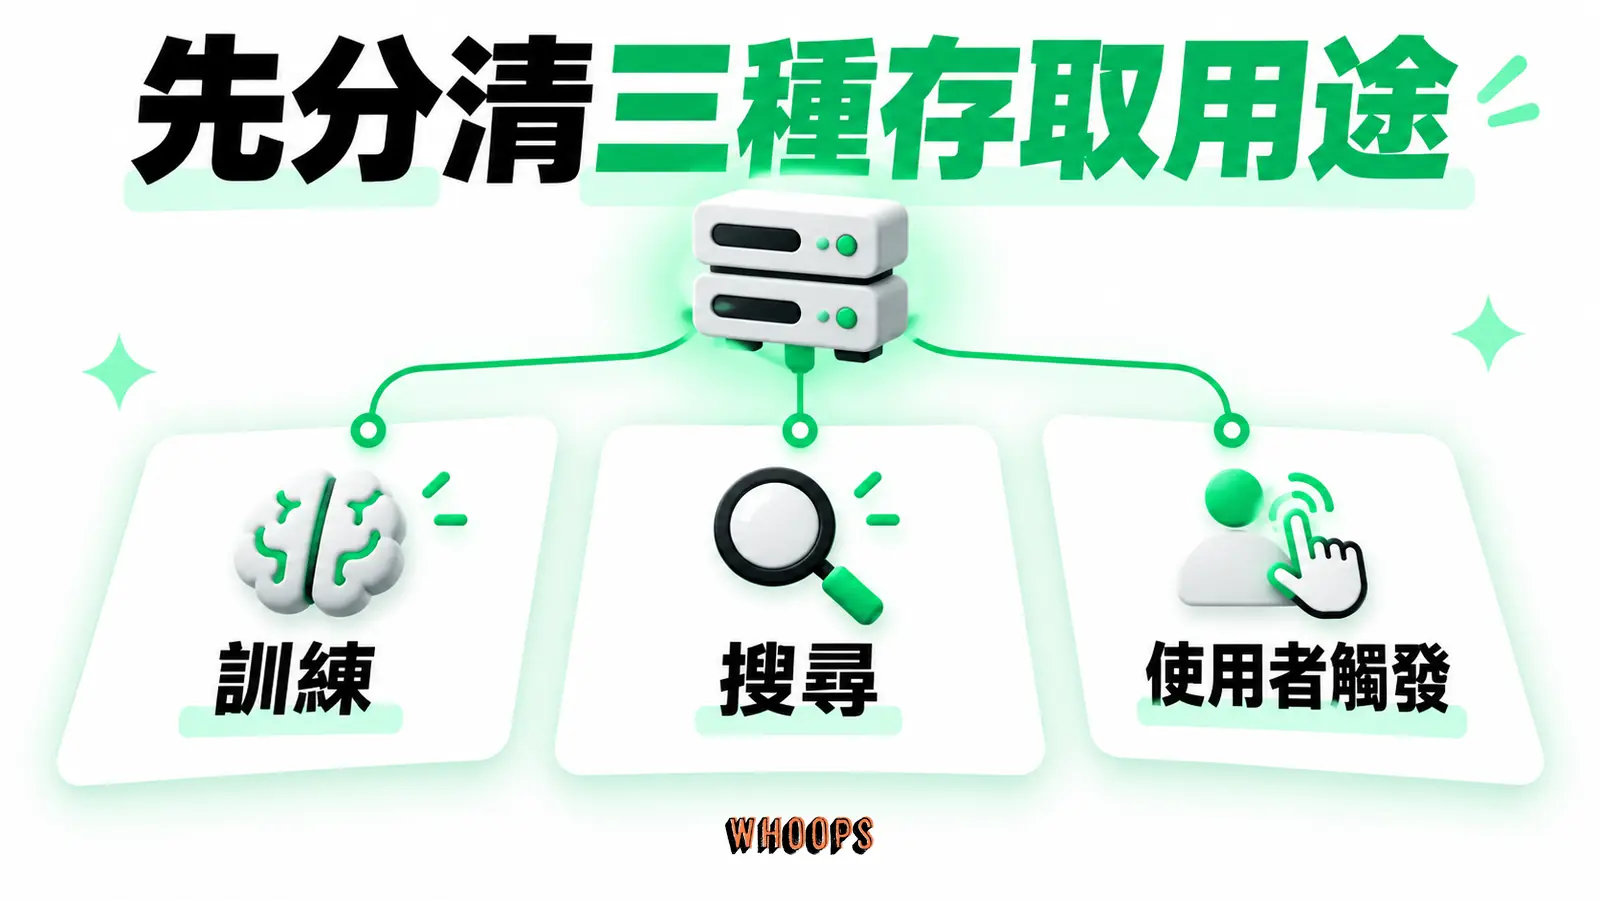
- 先按用途分流:訓練、搜尋與使用者觸發存取
- 主流 AI 爬蟲的 User-Agent 與 robots 速查
- 先取得日誌:不同託管環境能拿到的資料不同
- 先做資料品質檢查,否則趨勢會失真
- 怎麼從伺服器日誌看出 AI 在爬你
- 讀懂 HTTP 狀態碼,不替爬蟲腦補行為
- 別只信 User-Agent:用官方 IP 清單驗證
- 用 robots.txt 控制:允許搜尋、拒絕訓練
- Crawl-delay 誰支援,能不能拿來限速
- 改完 robots.txt,怎麼驗證規則生效
- 看到數字後,固定問四個問題
- 報表至少保留這八組欄位
- 三種常見圖形,應該怎麼判讀
- 四種做法的取捨:從指令到資料倉儲
- 五個落地動作:讓 AI 爬蟲從看不見變成可控
- LLM 爬蟲日誌分析最常被誤判的四件事
- 結語:把接觸、身分與引用分開量
內容站要判斷 ChatGPT、Claude、Perplexity、Gemini 等 AI 服務有沒有來抓頁面,光看前端分析工具通常不夠。AI 爬蟲直接向伺服器送出 HTTP 請求,最完整的線索留在伺服器、CDN 或邊緣服務的存取日誌。日誌能回答的是「哪個爬蟲自稱來過、抓了哪個網址、伺服器回了什麼」,不能直接證明內容已進入模型,也不能保證之後會被引用。
LLM 爬蟲日誌分析(LLM crawler log analysis),就是從存取日誌辨識 GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot、CCBot 等 User-Agent,再統計請求路徑、時間、狀態碼與資料量。做完後,你可以分開管理訓練、搜尋索引與使用者觸發的存取,也能檢查 robots.txt 或 WAF 規則是否符合預期。這份資料補上前端分析看不到的伺服器請求,適合拿來檢查 AI 搜尋與 GEO 的技術面,也提供 GEO 監測最常缺的伺服器端證據。GEO 的整體邏輯,可以對照我們的 GEO 是什麼。
核心重點:不要把所有 AI 流量算成同一類。GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot、CCBot 的用途與控制方式不同;Google-Extended、Applebot-Extended 則是 robots.txt 的用途控制 token,不是能在 HTTP 日誌裡直接找到的獨立爬蟲。User-Agent 也能被偽造,所以報表最好同時核對官方公布的 IP 範圍。
先按用途分流:訓練、搜尋與使用者觸發存取
OpenAI 把自動爬蟲分成 GPTBot 與 OAI-SearchBot。GPTBot 抓到的內容可能用於訓練生成式 AI 基礎模型;OAI-SearchBot 用來讓網站出現在 ChatGPT 搜尋功能。兩個 robots.txt 設定彼此獨立,因此可以放行 OAI-SearchBot,同時封鎖 GPTBot。OpenAI 在 官方爬蟲說明頁也提到,停用 OAI-SearchBot 的網站不會出現在 ChatGPT 搜尋答案中,但仍可能以導覽連結出現。
Anthropic 在 爬蟲說明列出三個用途不同的 bot。ClaudeBot 收集可能用於模型訓練的公開內容;Claude-SearchBot 為搜尋結果建立與改善索引;Claude-User 則在使用者要求 Claude 取用網頁時發出請求。Perplexity 也分成自動建立搜尋索引的 PerplexityBot,以及使用者提問時取用網頁的 Perplexity-User;依 Perplexity 官方文件說明,Perplexity-User 通常不受 robots.txt 限制。
Google-Extended 容易被誤認成一支獨立爬蟲。它其實是 robots.txt 的產品 token,用來控制 Google 已抓取的內容能否供未來的 Gemini 模型訓練,以及 Gemini Apps、Vertex AI 的 Google Search grounding 使用。它沒有獨立 HTTP User-Agent,封鎖後也不影響網站是否進入 Google 搜尋,更不是搜尋排名訊號,這些定位在 Google 的常見爬蟲文件有明確說明。所以,日誌可以看到承載請求的 Google crawler,卻不能靠搜尋「Google-Extended」判定該次資料用途。
這三類存取不能直接互相換算。訓練用爬蟲來過,不代表頁面會出現在當下的 AI 回答;搜尋爬蟲抓到頁面,也只表示該服務有機會處理內容。官方文件描述的是爬取用途與停用效果,沒有提供「抓取幾次就會引用幾次」的換算公式。日誌適合當接觸與技術健康度指標,不適合包裝成引用成效。
主流 AI 爬蟲的 User-Agent 與 robots 速查
辨識的起點是 User-Agent,但比對時不要鎖死版本號。OpenAI 明確提醒 OAI-SearchBot 與 GPTBot 的版本會變動;Common Crawl 也可能調高 CCBot 版號。實作正規表達式時,比對穩定名稱即可,再用 IP 做第二層驗證。
左右捲動檢視完整表格
| 名稱 | 官方用途 | 日誌識別特徵 | robots.txt token |
|---|---|---|---|
| GPTBot | OpenAI 模型訓練 | GPTBot/ | GPTBot |
| OAI-SearchBot | ChatGPT 搜尋 | OAI-SearchBot/ | OAI-SearchBot |
| ClaudeBot | Anthropic 模型訓練 | ClaudeBot | ClaudeBot |
| Claude-SearchBot | Claude 搜尋索引 | Claude-SearchBot | Claude-SearchBot |
| Google-Extended | 控制 Gemini 訓練與 grounding 用途 | 沒有獨立 HTTP UA | Google-Extended |
| PerplexityBot | Perplexity 搜尋索引 | PerplexityBot/ | PerplexityBot |
| CCBot | 建立 Common Crawl 開放網頁資料集 | CCBot/2.0 | CCBot |
| Applebot-Extended | 控制 Applebot 所抓內容的模型訓練用途 | 不是獨立網頁爬蟲 | Applebot-Extended |
PerplexityBot 官方列出的完整 UA 是 Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot),並在 Perplexity 的爬蟲文件聲明會依 PerplexityBot 的 robots.txt 設定管理自動爬取。CCBot 目前列出的 UA 是 CCBot/2.0 (https://commoncrawl.org/faq/),依 Common Crawl 的 FAQ,抓頁前會檢查 robots.txt。
Applebot-Extended 和 Google-Extended 的邏輯相近,都是用途控制,不是獨立抓頁程式。Apple 在 Applebot 支援文件明確寫道,Applebot-Extended 不會爬網頁;它只決定 Apple 如何使用 Applebot 已抓取的內容。封鎖 Applebot-Extended 後,頁面仍可能出現在 Apple 的搜尋功能。想完整理解各家 AI 爬蟲的長期意義,可以對照我們的 LLM/LLMO SEO 指南。
先取得日誌:不同託管環境能拿到的資料不同
自架 Nginx 或 Apache 時,先看實際伺服器設定,不要只猜檔案路徑。Nginx 由 access_log 指令決定位置與格式,預設格式名稱是 combined(見 ngx_http_log_module 文件);Apache 則用 CustomLog 與 LogFormat 設定(見 Apache 的 Log Files 文件)。套件、容器與託管商可能改過路徑,也可能把日誌送進 journald 或集中式日誌服務。
共享主機可能只在控制台提供 Raw Access Logs,保留時間與欄位要看主機商。封閉式網站平台或純靜態託管也不一定開放 origin access log。這種情況要改看 CDN、WAF 或平台自己的請求分析,不能假設下載到的報表和完整伺服器日誌等價。開始統計前,先記下資料涵蓋期間、時區、是否抽樣、是否包含快取命中,以及能否看到原始來源 IP。
截至 2026 年 8 月,Cloudflare 的 AI Crawl Control 已開放所有方案使用。免費方案依 User-Agent 辨識已知 AI 爬蟲,分析視窗最長 24 小時;較完整的 Bot Management detection ID 與可調整分析期間屬 Enterprise Bot Management 能力。介面可依 crawler、operator、hostname、path 與狀態碼查看流量,也能對個別爬蟲設定允許或封鎖,功能細節見 Cloudflare 的 AI Crawl Control 入門文件。方案之間的差異在辨識深度與可回看的期間,而不是能不能使用。
Cloudflare Logpush 的一般 HTTP request logs 仍只在 Enterprise 方案提供,例外是 Workers Paid 可使用 Workers Trace Events Logpush。Logpush 可把批次日誌送到 AWS S3、BigQuery 等外部目的地,但欄位不是「全部自動提供」:可用欄位取決於方案與 dataset,額外的 request/response headers 或 cookies 要逐項設定 Custom Fields,也無法自動轉送所有自訂標頭,這些限制整理自 Cloudflare 的 Logpush、Datasets 與 Custom Fields 文件。建立 job 前,應用 API 查詢該帳戶實際可用欄位,再挑出 ClientIP、ClientRequestURI、ClientRequestUserAgent、EdgeResponseStatus 與時間欄位。
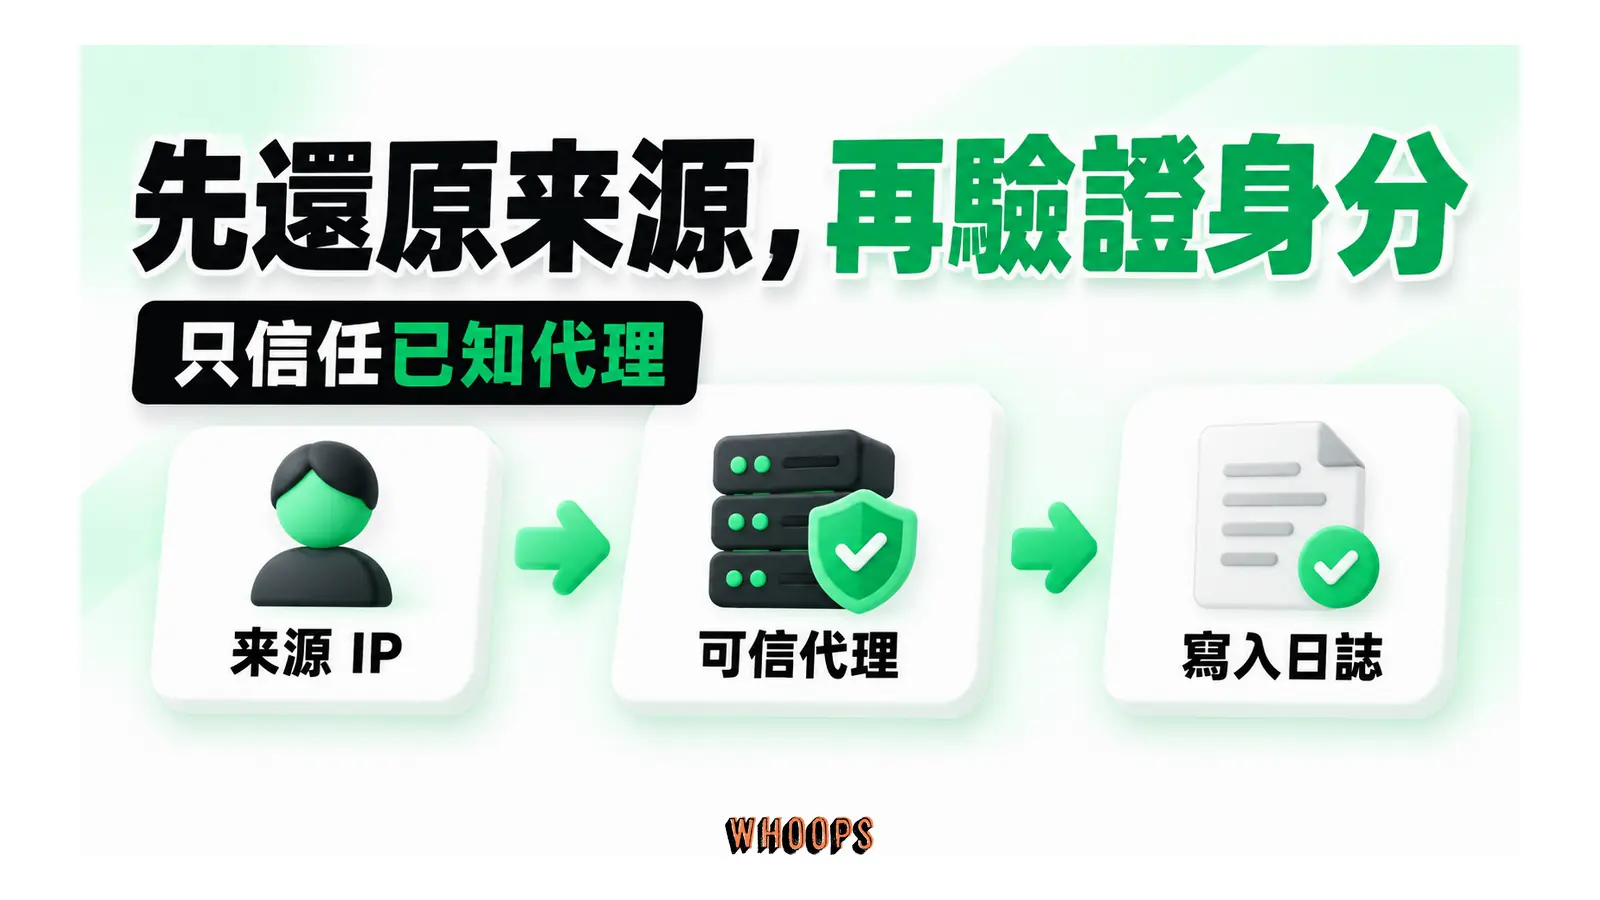
網站若經過 Cloudflare 反向代理,origin 預設可能只記到 Cloudflare IP。Cloudflare 把原始來源 IP 放在 CF-Connecting-IP,要依官方方式設定 Nginx realip module、Apache mod_remoteip 或自訂 log format,才能拿 origin log 做廠商 IP 驗證,設定方法見 Cloudflare 的原始訪客 IP 還原說明。只改讀一個可由外部任意送入的 header 也不夠,還要把可信任 proxy 限定為 Cloudflare 公布的網段。
先做資料品質檢查,否則趨勢會失真
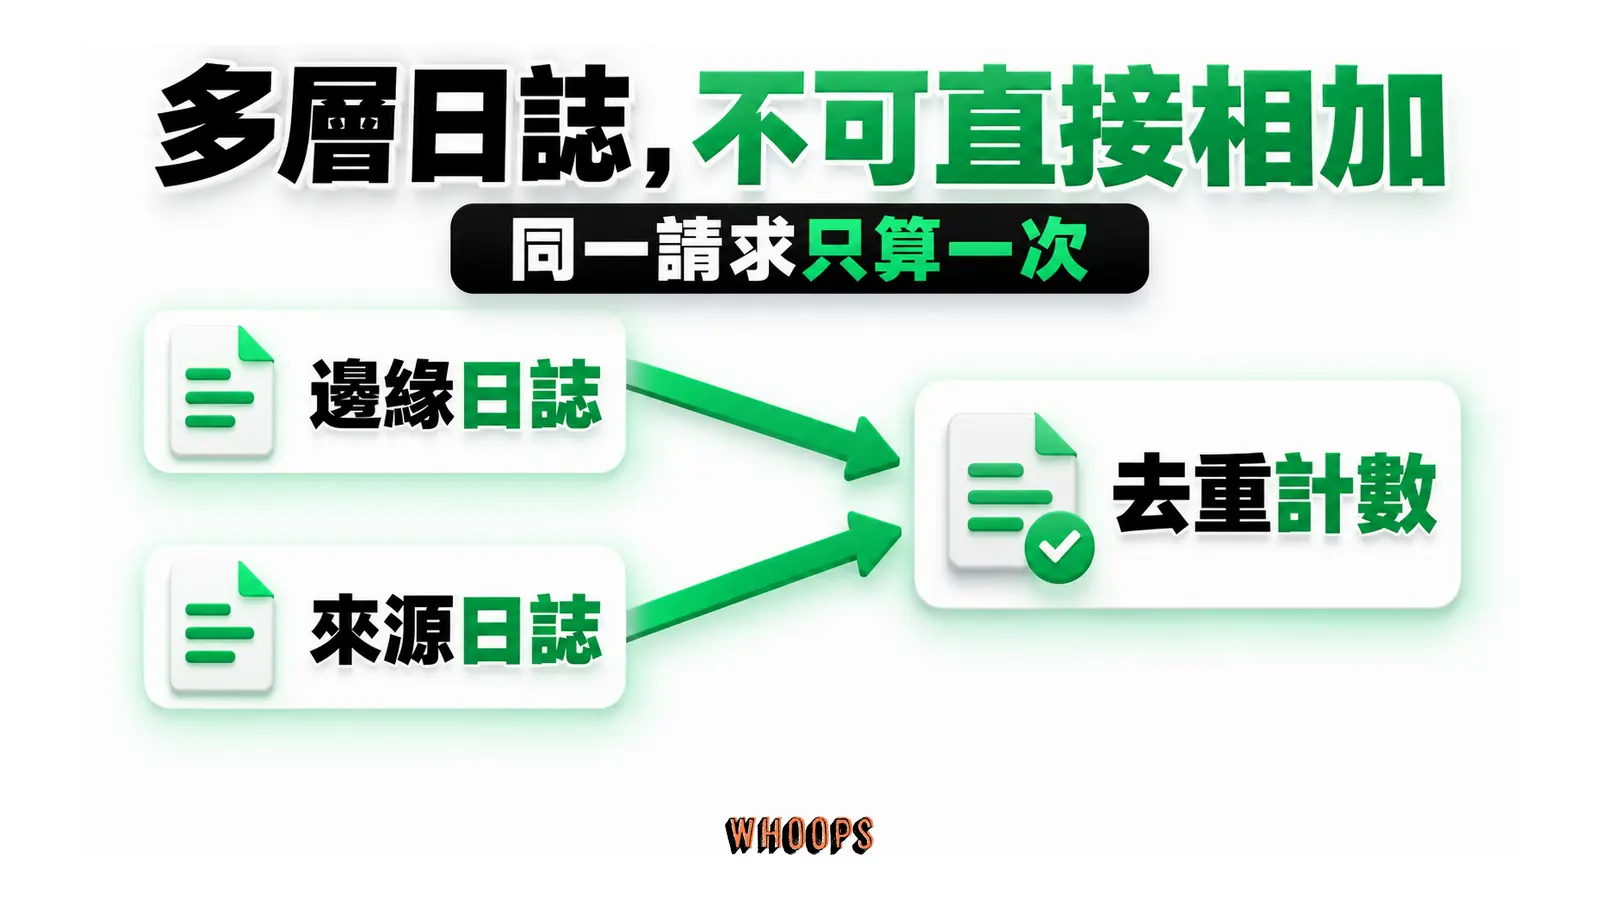
同一個網站可能同時有 CDN edge log、load balancer log、origin access log 與應用程式 log。這些檔案不是越多越好,也不能直接相加。CDN 在邊緣快取命中的請求可能不會抵達 origin;同一筆抵達 origin 的請求又可能在每一層各留一列。要選一層當主要計數來源,其他層用來補欄位或除錯。若確實要合併,應用 request ID、Cloudflare Ray ID、時間、路徑與來源等欄位做去重,不要把同一個 request 算成兩次。
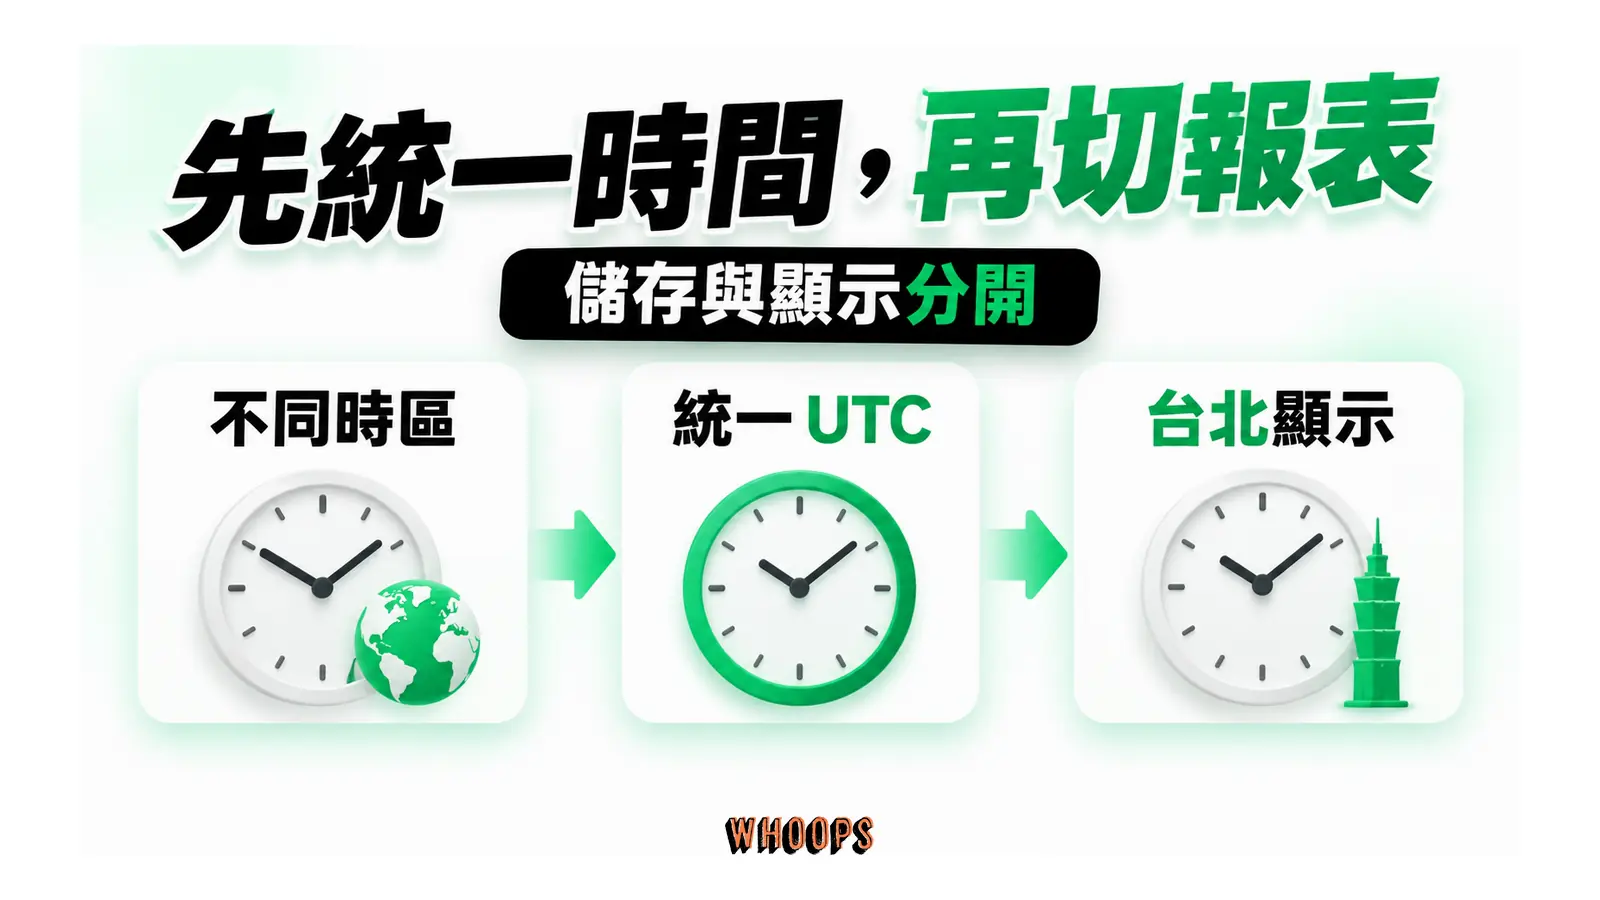
時間也要正規化。Nginx/Apache 常用本地時間或含時區位移的 CLF 時間戳,Cloudflare Logpush 可輸出 Unix time 或 RFC 3339。週報如果直接用不同時區切日,午夜附近的請求會被分到不同日期。匯入時統一轉成 UTC,報表顯示時再換成 Asia/Taipei,並在表頭寫清楚區間是左閉右開,例如「2026-07-01 00:00 至 2026-08-01 00:00」。這能避免月底多算一秒、跨時區少算一天等低階錯誤。
接著檢查缺口。按小時或按日統計全部 request rows,找出突然歸零、檔案異常變小、解析失敗率上升的區段。日誌輪替、上傳失敗、Logpush job 停用、欄位格式改版,都可能讓趨勢看起來像 crawler 突然消失。Cloudflare 在 Logpush 文件特別說明 Logpush 不會回補 job 停用或失敗期間的歷史資料,因此健康通知與缺口標記要和報表一起保存。資料有洞時應標成不完整,不要用前後兩天平均值假裝補齊。
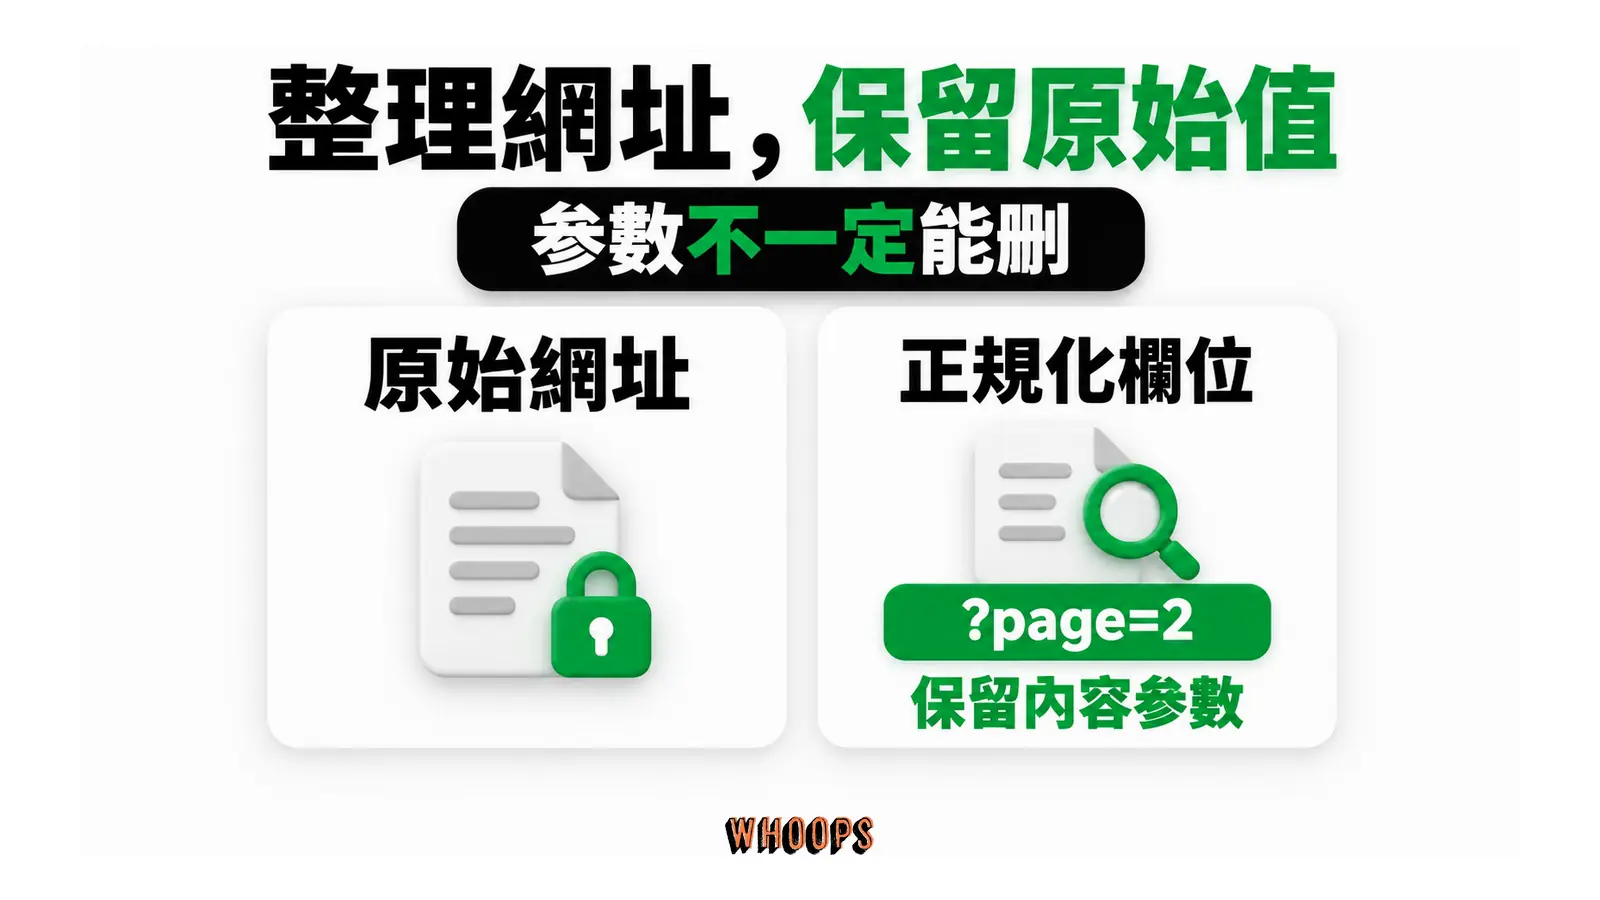
URL 也需要正規化,但不要破壞原始資料。建議保留 raw_url,另建 normalized_path:移除 fragment、統一 host 大小寫、依網站規則處理尾斜線,再把已知追蹤參數放進獨立欄位。查詢參數可能改變內容,不能一律刪除;?page=2、站內搜尋詞與篩選條件都可能代表不同頁面。做「獨立頁面數」時用正規化欄位,查單次異常時回到原始 URL。
UA 驗證的分母也要固定。可以同時保存三個數字:所有請求、UA 命中請求、UA 與官方 IP 都通過的請求。若某天只下載到 User-Agent、沒有可靠來源 IP,那一天可以納入「自稱 crawler」趨勢,不能混進「已驗證 crawler」。官方 IP 清單也要保存下載時間或內容雜湊,否則數月後重跑舊日誌,可能用到不同版本的網段而得到不同結果。
怎麼從伺服器日誌看出 AI 在爬你
Apache 的 Log Files 文件說明 Common Log Format 會記錄來源 IP、時間、請求行、HTTP 狀態碼與回傳位元組,Combined Log Format 再加入 Referer 與 User-Agent;Nginx 內建的 combined 格式也包含這些欄位(見 ngx_http_log_module 文件)。如果自訂格式沒有記 User-Agent,事後無法從同一份檔案補回來,只能先改設定再累積新資料。
以下是一筆虛構的 Combined 格式範例:
192.0.2.10 - - [14/Jul/2026:03:12:45 +0000] "GET /seo-complete-guide HTTP/1.1" 200 8456 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"
由左到右是來源 IP、兩個可能為空的識別欄位、時間戳、請求方法與路徑、HTTP 版本、狀態碼、回傳位元組、Referer 與 User-Agent。這筆紀錄只能證明某個客戶端自稱 GPTBot,向該路徑送出請求並收到 200。要確認是不是 OpenAI,還要核對來源 IP。
最輕量的統計方式是字串比對。grep -i "GPTBot" access.log | wc -l 會算出檔案中自稱 GPTBot 的請求列數。一次統計多個名稱,可以用:
awk -F'"' '{print $6}' access.log \
  | grep -ioE 'GPTBot|OAI-SearchBot|ClaudeBot|Claude-SearchBot|PerplexityBot|CCBot' \
  | sort | uniq -c | sort -rn
這段指令假設輸入真的是標準 Combined 格式,並取第六個雙引號分隔欄位作為 User-Agent。若主機商改過格式,先用幾列樣本確認欄位,不要直接複製。想看 GPTBot 最常抓哪些路徑,可用 grep -i "GPTBot" access.log | awk -F'"' '{print $2}' | awk '{print $2}' | sort | uniq -c | sort -rn | head -20。查詢字串或個資若會出現在 URL,匯出報表前要先遮罩。
不想每次重跑指令,可以用 GoAccess。它是開源、即時的網頁日誌分析器,可解析 Apache、Nginx 等格式,輸出終端、HTML、JSON 或 CSV 報表;User-Agent 明細也能按 host 查看,功能列表見 GoAccess 的手冊頁。不過 GoAccess 不會自動證明 UA 真偽。把篩出的 IP 與官方網段核對,仍是另一個步驟。把 AI 流量納進 GA4 的做法,可以對照我們的 Google Analytics 指南。
讀懂 HTTP 狀態碼,不替爬蟲腦補行為
狀態碼能說明伺服器如何回應該次請求,但不能單靠一個代碼推定某家 AI 之後一定會怎麼做。HTTP 的通用語意可依 RFC 9110、RFC 9111 與 RFC 6585 解讀;爬蟲是否重試、何時重試、會不會調整長期排程,還要看廠商公開文件。
左右捲動檢視完整表格
| 狀態碼 | HTTP 語意 | 日誌判讀方式 |
|---|---|---|
| 200 | 請求成功 | 伺服器回傳成功,但仍要檢查內容型態、回傳大小與是否其實是軟 404。 |
| 301/302 | 永久/暫時轉址 | 記下來源與目的 URL;是否繼續跟隨轉址由客戶端決定,不能只看第一筆就算抓取完成。 |
| 304 | 內容未修改 | 客戶端發出條件式請求,伺服器允許沿用既有回應,通常不重傳正文。 |
| 404 | 找不到資源 | 核對該 URL 從哪裡被發現。來源可能是舊內鏈、外部連結、sitemap 或爬蟲既有清單,不能只憑 404 指定單一原因。 |
| 429 | 請求過多 | 表示伺服器正在限流,可帶 Retry-After 建議等待時間;HTTP 規格沒有保證客戶端一定遵守。 |
| 500/503 | 伺服器錯誤/暫時無法服務 | 500 是未預期的伺服器錯誤;503 表示暫時過載或維護,也可帶 Retry-After。兩者都不能直接推定 AI 會在某個時間重試。 |
OpenAI、Anthropic、Perplexity 目前的公開爬蟲文件都沒有承諾「網站長期頻繁回 429,就會永久或長期降低抓取頻率」。因此不能把這句話當成已證實的廠商行為。能確認的是 429 代表伺服器限流,回應可附 Retry-After;Common Crawl 的 FAQ則明確說明 CCBot 遇到 429 或 5xx 時會使用 adaptive back-off。如果目標是降低特定 AI crawler 的負載,robots.txt、WAF 規則與可觀測的 rate limit 都比猜測長期退避可靠。
狀態碼統計可用 grep -iE "GPTBot|OAI-SearchBot|ClaudeBot|Claude-SearchBot|PerplexityBot" access.log | awk -F'"' '{print $3}' | awk '{print $1}' | sort | uniq -c | sort -rn。200 比例高,表示多數已識別請求拿到成功回應;404 偏高,就整理失效 URL 的來源;429 偏高,檢查限流條件是否把想放行的搜尋爬蟲也擋住;5xx 偏高,先修 origin、proxy 或 CDN 的服務問題。判讀要搭配絕對請求數與日期區間,三筆錯誤中的兩筆和十萬筆中的兩千筆不是同一件事。
別只信 User-Agent:用官方 IP 清單驗證
User-Agent 是客戶端自行送出的字串,任何人都能用 curl 偽裝。不同業者的驗證方式不盡相同;Googlebot 的驗證方法有兩種:少量查核可先做反向 DNS,確認 hostname 屬於 googlebot.com、google.com 或 googleusercontent.com,再做正向 DNS 確認回到原 IP;大量自動驗證則比對 Google 公布的 crawler/fetcher JSON IP 清單,完整做法可參考 Google 的 Verify Googlebot 官方說明。
OpenAI 沒有在爬蟲文件建議用特定反向 DNS 網域驗證,而是分別公布 OAI-SearchBot 與 GPTBot 的 CIDR JSON。分析腳本應依 User-Agent 選對清單,再檢查來源 IP 是否落在網段內;清單內容可查 OpenAI 的 crawlers 總覽(OAI-SearchBot IP ranges、GPTBot IP ranges)。
Anthropic 現在也公布統一的 bot IP JSON;官方說來源 IP 落在清單中,代表 crawler 來自 Anthropic,並提醒只靠封鎖 IP 不等於持久退出,因為 bot 仍需要讀取 robots.txt(見 Anthropic 的 bot IP JSON與 官方的爬蟲封鎖說明)。Perplexity 則在 Perplexity Docs 建議把 UA 字串和各自的官方 IP 清單一起比對,而不是二選一。
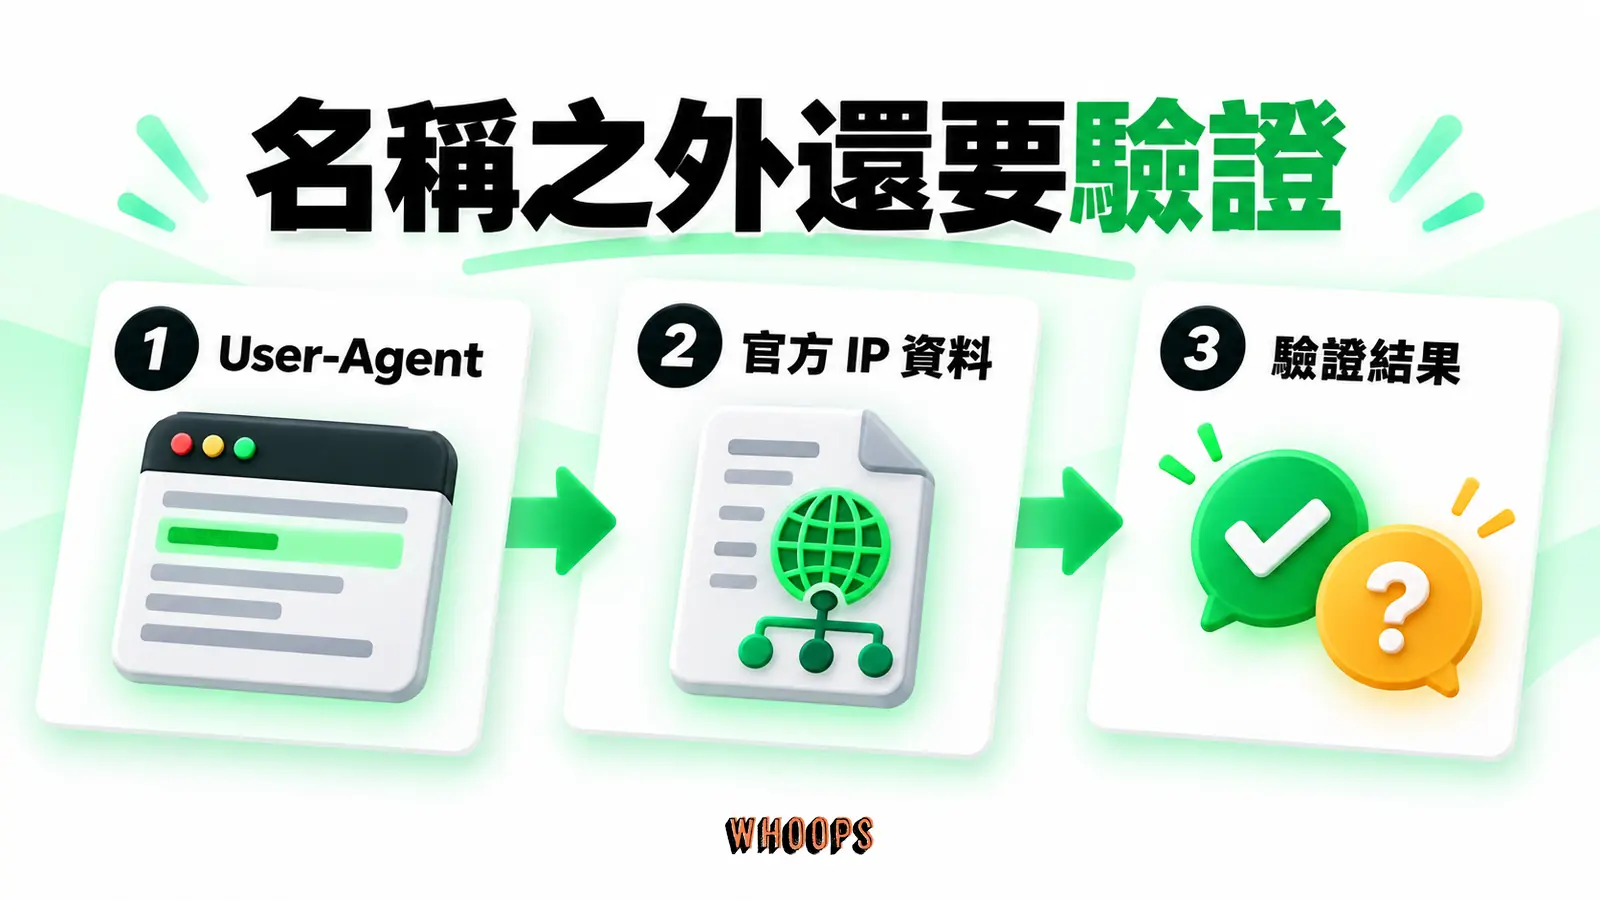
實作時,先產生「自稱某 crawler」的請求清單,再按日期下載對應的官方 JSON,做 CIDR membership check。官方清單會更新,不要把今天的網段永久寫死。報表可分成「UA 命中」「UA 加官方 IP 驗證通過」「未驗證或驗證失敗」三欄。這樣既保留原始觀察,也不會把假冒流量算成廠商官方抓取。
用 robots.txt 控制:允許搜尋、拒絕訓練
robots.txt 可以針對不同 token 設規則。OpenAI 官方明確舉例,可允許 OAI-SearchBot 出現在搜尋結果,同時封鎖 GPTBot,表示內容不應用於 OpenAI 基礎模型訓練;這個例子出自 OpenAI 的 GPTBot 說明頁。Anthropic 的三個 bot 也能分開設定;PerplexityBot 可獨立管理,但使用者觸發的 Perplexity-User 通常忽略 robots.txt。策略要按實際用途選,不要把「AI」三個字當成同一個開關。
以下範例封鎖三個與訓練或開放資料集有關的自動 crawler,並明確放行三個搜尋 crawler。空白的 Disallow: 代表該 group 沒有禁止路徑。套用前仍要核對網站既有 group,避免同名 group 分散後被合併解析而出現意外結果。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Disallow:

User-agent: Claude-SearchBot
Disallow:

User-agent: PerplexityBot
Disallow:
Google-Extended 可另設 Disallow: /,停止 Google 已抓內容用於指定的 Gemini 訓練與 grounding 用途,同時不影響 Google Search 收錄。robots.txt 的限制也要說清楚:RFC 9309 明文指出這些規則不是存取授權,不能取代防火牆或其他安全措施(見 IETF 的 RFC 9309 全文)。robots.txt 的完整觀念,可以對照我們的 robots.txt 指南。至於常被拿來跟 robots.txt 一起討論的 llms.txt,可以接著讀 llms.txt 的實際效果與爭議。
Crawl-delay 誰支援,能不能拿來限速
Crawl-delay 不是 RFC 9309 的標準欄位,各家支援情況不同。Anthropic 明確支援這個 extension,文件範例是 Crawl-delay: 1;Common Crawl 也明確支援,並用 2 秒作為範例;兩份官方頁面都沒有公布秒數上限(Anthropic 的 crawlers 說明、Common Crawl FAQ)。
Google 則在 Search Central 的 robots.txt 不支援規則說明表明不支援 Crawl-delay。OpenAI 與 Perplexity 目前的 crawler 文件沒有聲明支援,也沒有秒數上限可引用,所以不要假設它們會執行。需要可預測的限速時,在 WAF 或伺服器依「已驗證 IP 加 UA」設定 rate limit,並監看 429、成功率與重試流量。只依 UA 限流,容易被偽裝者利用,也可能誤傷共享網路。
改完 robots.txt,怎麼驗證規則生效
Google Search Console 舊版的「robots.txt Tester」已不在目前介面。現行工具是 robots.txt report,可查看 Google 抓到的 robots.txt、最近檢查時間、抓取狀態、解析警告與錯誤,也能要求重新抓取;要測特定 URL 是否被 Google 擋住,使用網址審查工具的即時測試。robots.txt report 只提供給網域層級,或不含路徑的 URL-prefix 資源(詳見 Search Console Help 的 robots.txt report 說明)。
OpenAI 與 Perplexity 都說 robots.txt 更新最多可能約 24 小時才反映到系統。它們沒有提供和 Search Console 相同的官方逐 URL 測試介面。發布後可依序檢查 /robots.txt 是否回 200、Content-Type 與文字內容是否正確、token 拼字有沒有錯,再回日誌觀察 crawler 是否讀取 robots.txt,以及後續被允許或禁止路徑的請求變化。不要要求停用後歷史抓取紀錄消失,robots.txt 管的是後續存取與廠商聲明的用途。
看到數字後,固定問四個問題
一、這是什麼用途?把 GPTBot、ClaudeBot、OAI-SearchBot、Claude-SearchBot、PerplexityBot、CCBot 分開,不把所有請求加成一個「AI 曝光量」。Google-Extended 和 Applebot-Extended也不能從 UA 次數統計,因為它們沒有獨立抓頁 UA。
二、身分驗證過嗎?UA 命中只是候選資料。報表若要用於內部決策或對外溝通,至少要標示官方 IP 驗證率與無法驗證的比例。網站位於 CDN 後方時,先確認原始來源 IP 有正確寫入日誌。
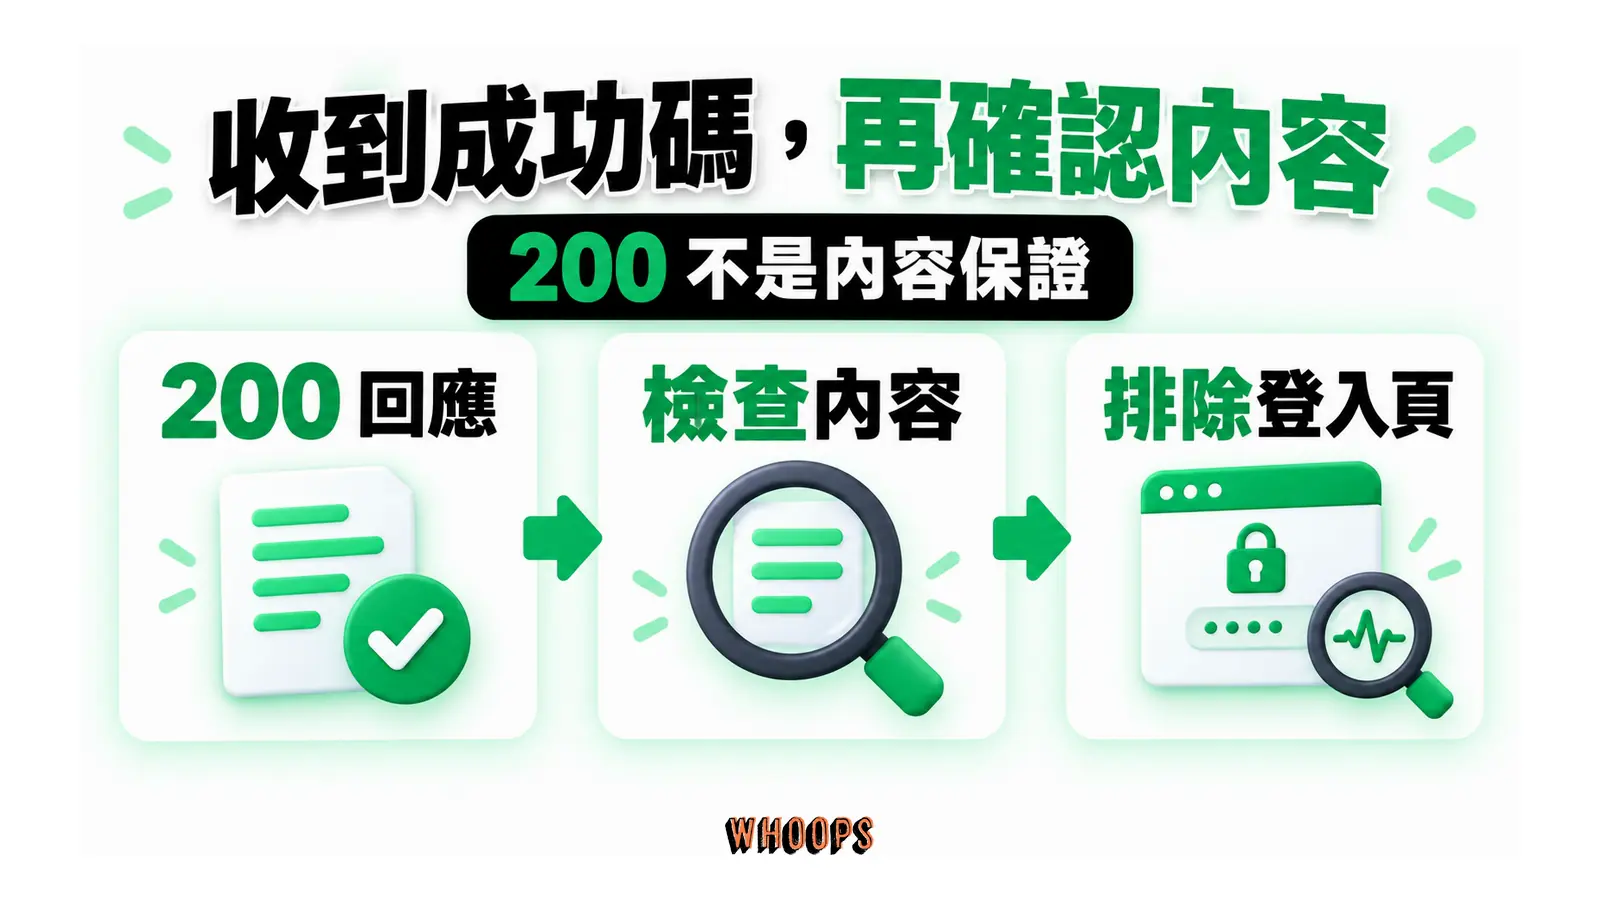
三、抓了什麼,拿到什麼回應?按內容類型、目錄、狀態碼分組。核心文章收到 200、舊 URL 收到 404、資產檔大量收到 304,各自代表不同問題。還要檢查 200 回應的 Content-Type 與位元組,避免把登入頁、驗證頁或軟 404 當成內容成功送達。
四、抓取與引用是否同向變化?把日誌趨勢和固定題組的引用測試並排看,但不要先假定因果。搜尋 crawler 增加而引用沒變,可能涉及內容選擇、查詢需求、索引處理或答案排序;引用增加也可能來自既有索引或使用者觸發 fetch。沒有實驗設計與更多訊號時,只能說兩者同時發生。
報表至少保留這八組欄位
可重跑的報表不只是一張 crawler 排行。原始層至少保留 timestamp、來源 IP、User-Agent、method、host、raw URL、status、response bytes、referer、request ID 與資料來源;衍生層再加入 crawler 名稱、operator、用途、IP 驗證結果、normalized path、內容類型與規則版本。原始層盡量不改值,分類邏輯變更時才能重算,不必回頭猜當初怎麼處理。
管理頁面需要的第一組指標是請求與成功送達:總請求數、已驗證請求數、2xx 數、獨立 URL 數、回傳位元組。第二組是技術問題:3xx、404、429、5xx 的數量與比例,以及最常出錯的路徑。第三組是內容分布:文章、分類頁、標籤頁、API、圖片與其他資產各占多少。分類規則要能回查,例如把 WordPress 的 /wp-json/ 算 API、把副檔名與 Content-Type 一起用來辨識媒體,避免只靠 URL 外觀。
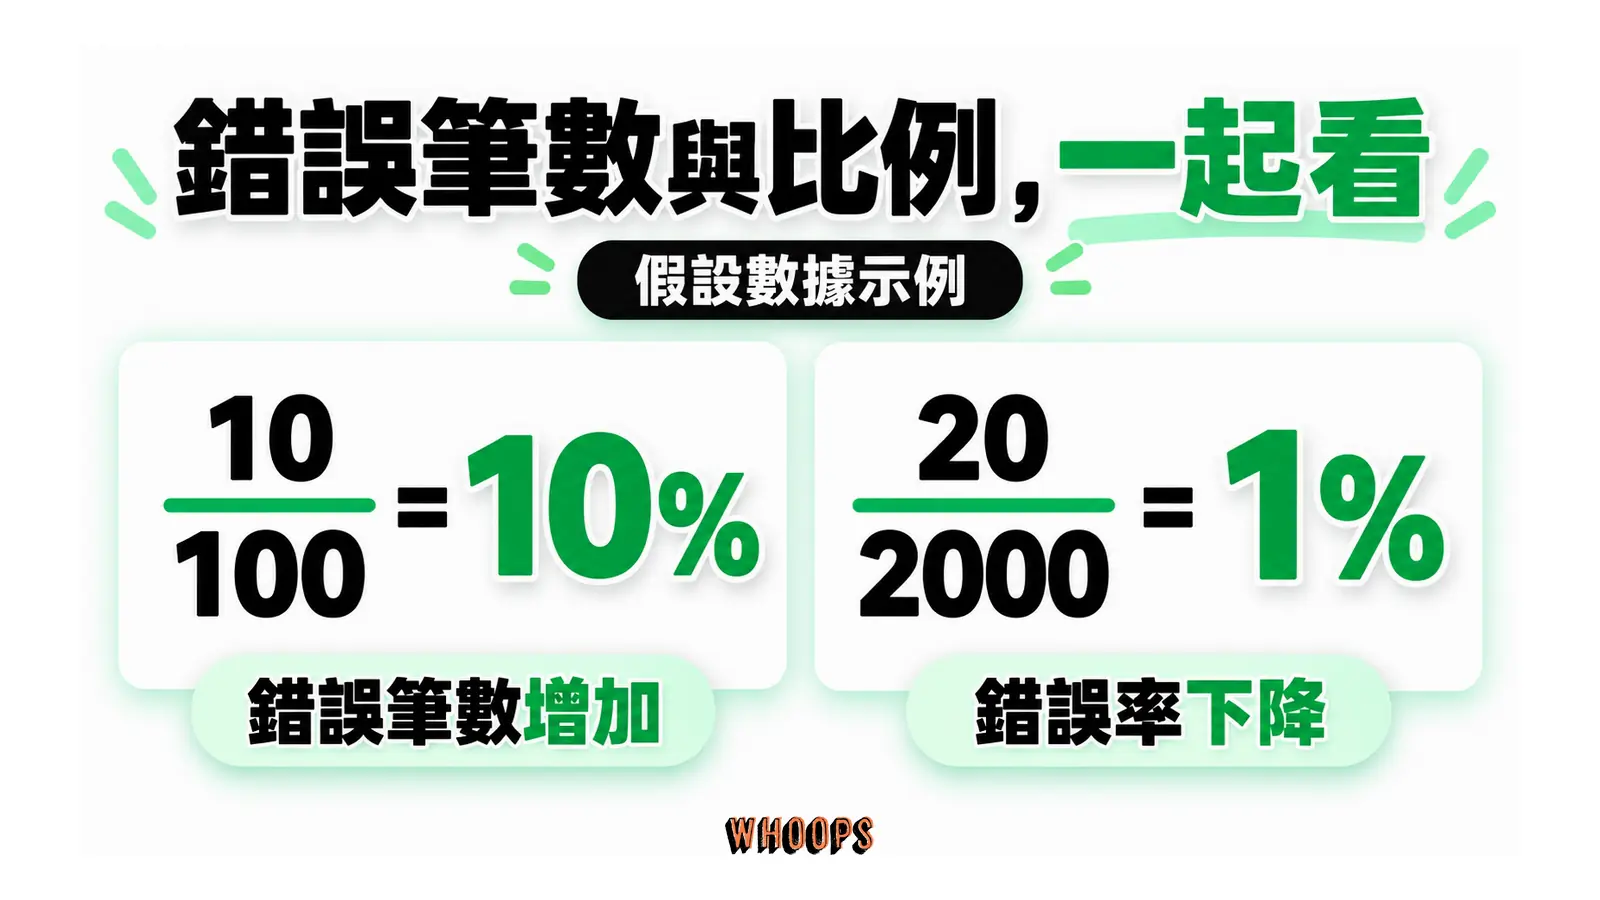
趨勢圖建議同時畫數量與比例。某 crawler 的 404 從 10 筆變成 20 筆,看似翻倍;若總請求同時從 100 筆增至 2,000 筆,錯誤率其實從 10%降到 1%。反過來,總量下降也可能讓錯誤筆數變少,但錯誤率升高。報表應讓讀者同時看到分子、分母與資料完整度,不能只挑最有戲劇性的變化。
robots.txt 與 WAF 也要版本化。每次改動保存發布時間、規則內容、預期影響的 token 與路徑,圖表上標出變更點。看到 GPTBot 流量下降時,才能區分是規則上線、網站故障、資料缺口,還是自然波動。若同一天改了 robots.txt、WAF 與 CDN cache,事後很難判斷哪個設定造成差異;高風險站至少分批上線,低流量站則延長觀察區間。
三種常見圖形,應該怎麼判讀
搜尋 crawler 請求上升,引用測試沒變。能下的結論只有搜尋端存取增加。先看 IP 驗證率、抓取頁面、2xx 比例與 robots.txt 變更,再確認固定題組、測試帳號、地區與日期是否一致。不要直接寫成「AI 看過但不喜歡內容」,日誌沒有提供這種判斷。
UA 命中暴增,官方 IP 驗證率下降。這通常代表新增流量主要來自未驗證來源,報表應拆開顯示,並檢查是不是代理層遺失原始 IP。若 origin 只看到 CDN IP,驗證率下降是量測設定造成的,不代表全是假冒;若來源 IP 完整卻不在官方網段,才把它列為可疑 UA。
robots.txt 上線後,受阻 crawler 仍請求 /robots.txt。這不表示封鎖失效。crawler 必須重新讀規則,才知道網站是否改為允許。判斷時把 robots.txt 請求和內容頁請求分開,觀察被禁止路徑是否停止或下降;若內容頁仍持續成功回 200,再檢查 token、group 合併、檔案位置、快取版本與 WAF 是否真的套用。
四種做法的取捨:從指令到資料倉儲
左右捲動檢視完整表格
| 做法 | 能回答什麼 | 限制 | 適合情境 |
|---|---|---|---|
| grep/awk | 請求量、路徑、狀態碼的快速盤點 | 依賴固定 log format,身分驗證與趨勢要自己寫 | 有 shell 與原始日誌,想先確認有沒有資料 |
| GoAccess | 即時或歷史圖表、常見 HTTP 指標 | 仍要取得原始 log,AI crawler 分類與 IP 驗證需額外處理 | 自架站,希望固定產生本地報表 |
| Cloudflare AI Crawl Control | crawler、operator、path、狀態碼與允許/封鎖 | 免費版依 UA 且只看 24 小時;進階辨識取決方案 | 流量經 Cloudflare,又拿不到 origin log |
| Logpush 加資料倉儲 | 跨週期、跨欄位查詢與自訂驗證 | 一般 HTTP Logpush 需 Enterprise,欄位、儲存與查詢都有成本 | 流量大,需要長期稽核與可重跑報表 |
選工具看問題,不看排場。只是想知道這週有沒有 GPTBot,指令就夠;要每週追路徑與狀態碼,GoAccess 或排程腳本比較省事;拿不到 origin log,但流量經 Cloudflare,先用 AI Crawl Control;需要半年以上趨勢、官方 IP 清單版本化、跨站比較與稽核,再評估 Logpush 與倉儲。資料來源沒釐清前,儀表板做得再漂亮也只是把未知放大。
Cloudflare 在 2026 年調整 AI 爬蟲預設政策、把流量分為三類的來龍去脈,站內有專文拆解。
五個落地動作:讓 AI 爬蟲從看不見變成可控
- 確認資料來源。找出 origin、CDN 或 WAF 的請求日誌,記錄時區、保留期、抽樣方式與欄位。網站經反向代理時,先確認原始來源 IP 有正確保存。
- 建立候選清單與驗證欄。用穩定 token 篩出 GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot、CCBot,再依各家官方 JSON IP 清單標示驗證結果。
- 按用途決定預設規則。若政策是允許 AI 搜尋、拒絕模型訓練,可放行 OAI-SearchBot、Claude-SearchBot、PerplexityBot,封鎖 GPTBot、ClaudeBot,並分別評估 CCBot、Google-Extended 與 Applebot-Extended。不要把範例當法律或商業結論,內容授權政策仍由網站自己決定。
- 用狀態碼與路徑找技術問題。檢查 404 的來源、429 的限流條件與 5xx 的服務故障。需要限速時優先用可觀測的 WAF/server rate limit;只有 Anthropic 與 CCBot 的官方頁面明確支援 Crawl-delay。
- 固定保存趨勢與引用測試。每週或每月用相同區間、相同分類重跑報表,再用固定題組記錄是否被引用。兩者分欄呈現,不把抓取次數直接換算成引用成效。爬取預算的整體邏輯,可以對照 技術 SEO 指南。
LLM 爬蟲日誌分析最常被誤判的四件事
左右捲動檢視完整表格
| 常見誤判 | 較準確的說法 |
|---|---|
| 「被 AI 爬蟲抓到,就等於會出現在 AI 回答裡。」 | 日誌只證明發生請求與回應。訓練、搜尋索引、使用者觸發取用的用途不同;搜尋 crawler 抓到也不保證成為答案引用。 |
| 「不想被訓練,就要封鎖所有 AI。」 | 部分廠商提供分開的 token。可以按政策封鎖訓練用途,同時允許搜尋 crawler,但使用者觸發 fetch 是否遵守 robots.txt 要逐家確認。 |
| 「robots.txt 封鎖後,就絕對不會再收到請求。」 | robots.txt 不是強制存取控制,crawler 仍可能回來檢查規則。需要強制拒絕時用 WAF 或伺服器規則,並保留 robots.txt 表達用途偏好。 |
| 「日誌裡有 GPTBot 字串,就是 OpenAI。」 | UA 可以偽造。OpenAI、Anthropic、Perplexity 都有官方 IP JSON;Google則可用反向加正向 DNS,或官方 IP 清單驗證。 |
結語:把接觸、身分與引用分開量
一份能用的 LLM crawler 報表,至少要有 crawler 名稱、用途、驗證狀態、請求數、主要路徑、狀態碼與時間區間。只做 UA 次數排行,會把假冒流量、不同用途與錯誤回應混在一起;只做引用測試,又看不到技術層是否根本沒抓到內容。
先用現有日誌做出第一版,再依決策需求增加 IP 驗證、趨勢保存或倉儲。robots.txt 負責表達爬取與用途偏好,WAF 負責強制存取規則,引用測試負責觀察答案端結果。三者各自回答不同問題,放在同一張報表對照,才不會把「來過」寫成「採用過」。這個方向也可以對照我們的 AI SEO 完整指南。
如果網站拿不到日誌、不確定 CDN 後方的原始 IP 是否正確,或需要把 robots.txt、WAF 與長期報表整理成可維護流程,Whoops 可協助盤點日誌來源、建立 crawler 驗證與監測規則。先把資料來源和可回答的問題界定清楚,再決定要不要投入更重的工具。
常見問題
被 AI 爬蟲抓到,就等於會出現在 AI 的回答裡嗎?
我不想被 AI 拿去訓練,但想出現在 ChatGPT、Perplexity 的搜尋答案裡,可以嗎?
我沒有伺服器存取日誌,還能看 AI 爬蟲流量嗎?
robots.txt 封鎖了 AI 爬蟲,是不是就絕對不會被爬?
日誌裡出現 GPTBot 字串,就代表 OpenAI 來過嗎?
操作步驟
- 取得一份伺服器存取日誌(或在 Cloudflare 開啟 bot 分析),用 grep 或 GoAccess 把 GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot、CCBot 各算一次抓取數,讓 AI 爬蟲現形。
- 在 robots.txt 設定預設立場:放行檢索爬蟲(OAI-SearchBot、Claude-SearchBot、PerplexityBot)、封鎖訓練爬蟲(GPTBot、ClaudeBot、CCBot),並用 Google-Extended token 控制 Gemini 訓練。
- 看到抓取量波動時,先分訓練 vs 檢索爬蟲,再分抓的是精華頁還是薄頁,不要把訓練爬蟲變多誤讀成即將被大量引用。
- 若訓練爬蟲抓太兇又無價值,用 robots.txt 或 Crawl-delay 限流以顧爬取預算與伺服器資源。
- 定期在 ChatGPT、Perplexity、Claude 對目標主題實測是否被引用,與日誌裡檢索爬蟲的抓取趨勢長期對照,摸出自己網站的相關性。