YAML 教學:語法規則、挪威問題與六大應用場景一次搞懂
YAML 教學完整指南:從 YAML 是什麼、語法規則精要、挪威問題布林陷阱、多行字串與錨點合併鍵,到 Kubernetes、Docker Compose、GitHub Actions、OpenAPI 與 Astro frontmatter 六大應用場景,加上 Python safe_load 資安須知,一次學會讀寫與除錯。
本頁目錄
- YAML 是什麼:資料序列化格式,不是程式語言
- 遞迴縮寫:YAML Ain't Markup Language
- 縮排即結構:少掉大括號與逗號的讀法
- YAML 1.2 是 JSON 的嚴格超集合
- 語法規則精要:五條就夠
- 規則一:區塊鍵值對的冒號後面要空一格
- 規則二:縮排只用空格,全面禁用 Tab
- 規則三:清單用減號,巢狀靠縮排
- 規則四:註解只有單行
- 規則五:型別會自動推斷,引號是保險
- 挪威問題:no、yes、on、off 的布林陷阱
- YAML 1.1 的官方布林對照表
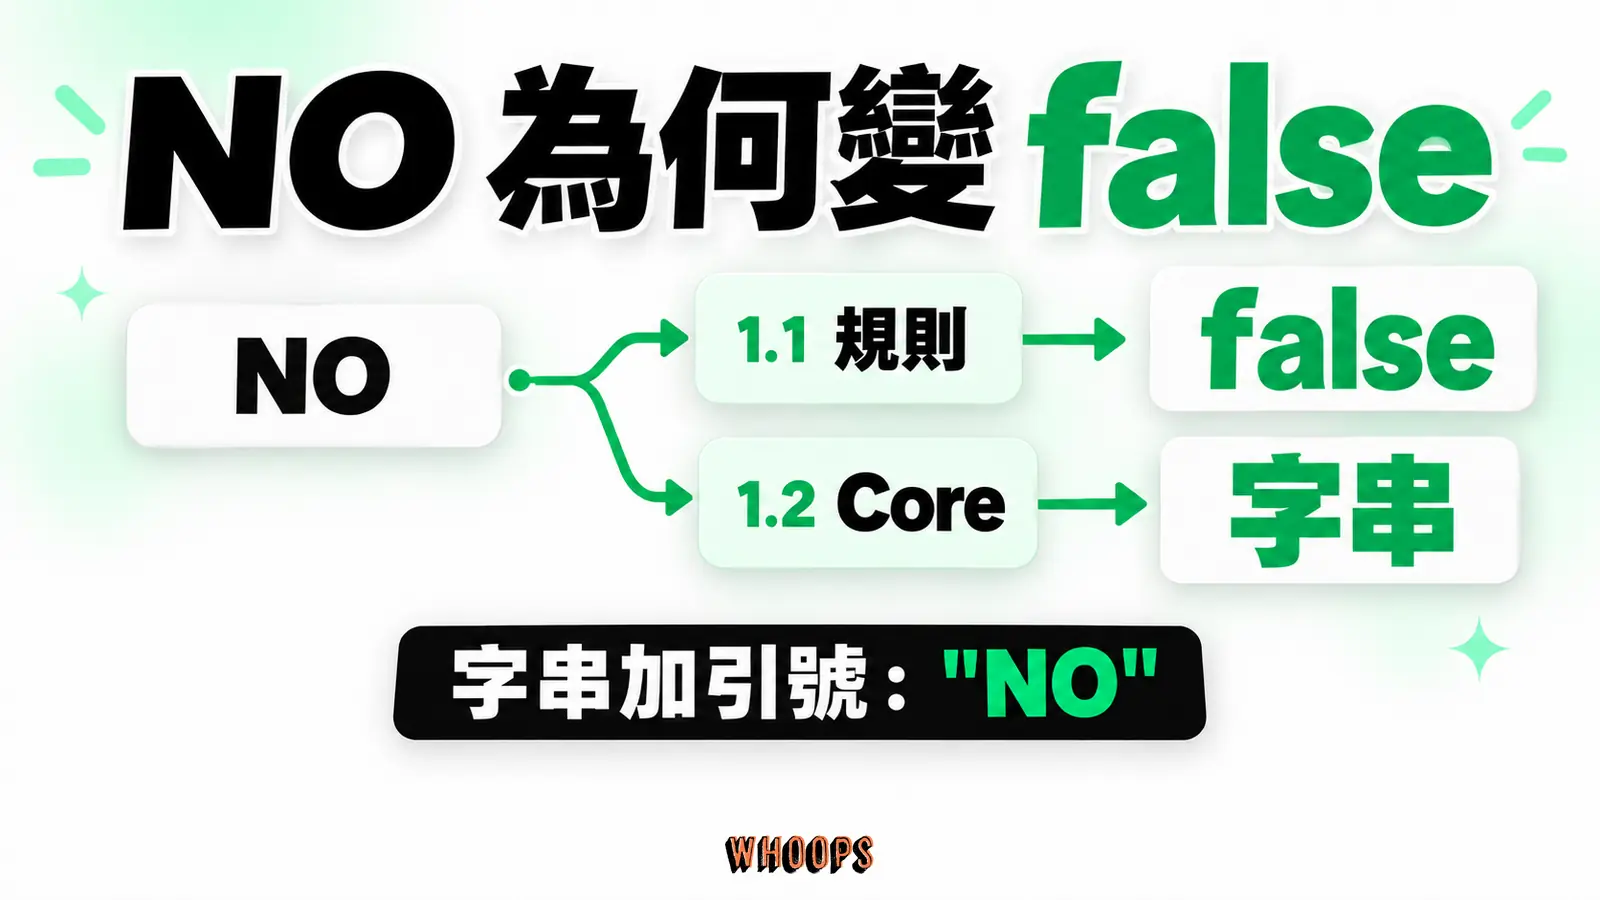
- 國碼 NO 為什麼會變成 false
- 1.2 已經修正,但生態還沒跟上
- 多行字串:豎線與折疊符號的選擇
- chomping 指示器:減號與加號控制結尾換行
- 錨點、別名與合併鍵:YAML 的重複使用機制
- 副檔名:.yaml 還是 .yml
- 六大應用場景:一份設定檔走遍部署、CI、文件與內容
- Kubernetes:manifest 的慣例格式
- Docker Compose:一份 compose.yaml 描述整個應用棧
- GitHub Actions:CI 流程本身就是一份 YAML
- Ansible:以最少語法表達的 playbook
- OpenAPI:API 文件的另一種載體
- 靜態網站 frontmatter:Jekyll、Hugo 與 Astro
- 結構化設定與 AI 可讀性:AI 產品也選了 YAML
- Anthropic 的 SKILL.md:官方文件親自示範
- 明確結構 vs 自然語言:同一套邏輯的三個出口
- Python 讀 YAML 的資安底線:safe_load
- 上線前檢查表:六種事故現場與攔截手法
接手一個新專案,打開資料夾,第一份被你看到的檔案,很可能就是一份副檔名為 .yaml 的設定檔,排在程式碼前面:部署清單、CI 流程、容器編排、API 文件,全都是它。想請同事示範怎麼改,對方丟回來一句「就是縮排而已」;自己動手,卻在存檔之後收到一串看不懂的錯誤。更麻煩的是,明明只是改了一個 yes,系統的行為卻整個變了樣,找了半天才知道問題出在 YAML 對「看起來像布林的字」的處理。
這份教學把 YAML 從定義、語法規則、經典陷阱到實際應用場景一次講完,並且以YAML 1.2.2 官方規格書為主要依據。讀完之後你會知道:為什麼縮排不能用 Tab、為什麼挪威的國碼會讓設定檔出錯(也就是著名的「挪威問題」)、多行字串的豎線與折疊符號差在哪、以及同一份設定怎麼被 Kubernetes、Docker Compose、GitHub Actions 到 AI 工具重複使用。
核心重點:YAML 是一種給人讀、也給機器讀的資料格式,用縮排表達結構。五個規則先記住:冒號後面要空格、縮排只用空格不用 Tab、清單用減號開頭、註解只有單行、字串怕被誤判成布林或數字就加引號。載入別人給的 YAML 檔時,Python 要用 safe_load。把這幾條守住,最常見的幾類 YAML 錯誤都能避開。
這份能力現在已經不是工程師的專利。寫部署與 CI 的後端要懂、管基礎設施的維運要懂、改 API 文件的技術寫手要懂、經營靜態網站或部落格的內容工作者每天都碰得到 frontmatter,就連把工作流程打包給 AI 代理的使用者,設定檔也長同一個樣子。一份格式、六種場景、一套規則,投資報酬率比多數人想像的高。
YAML 是什麼:資料序列化格式,不是程式語言
先處理最常見的誤解:YAML 不是程式語言,它沒有變數、沒有迴圈、也沒有條件判斷。它是一種資料序列化格式,做的事跟 JSON 一樣:把結構化的資料(文字、數字、清單、鍵值對)寫成一份檔案,讓不同的程式、不同的機器之間能互相讀寫。官方規格書對它的定義是一種「對人類友善、跨語言、以 Unicode 為基礎的資料序列化語言」,用途從設定檔、網路訊息到物件持久化與資料稽核都涵蓋。
「序列化」聽起來抽象,換個說法就清楚了:你在程式裡有一個物件,裡面有訂單編號、通路與品項清單;想把它存成檔案、傳給別的服務、或放進版本控制,就需要一種雙方都看得懂的格式。YAML 扮演的就是這個角色,差別只在於它的長相是為「人直接閱讀與編輯」而設計,機器解析的效率排在後面。
把 YAML 放回格式光譜上看,會更理解它的取捨。XML 用成對標籤表達一切,表達力強但視覺噪音大,改一份設定要在開頭與結尾各改一次;JSON 簡潔、解析快,是資料交換的預設選擇,但它不支援註解、多行文字要寫成帶跳脫符號的單行,拿來當「人要反覆編輯的設定檔」很吃力。YAML 補的正是這個缺口:註解、多行字串、縮排層次全都是一等公民,代價是解析器要做更多判斷、規則邊界也比較多,這也是為什麼 YAML 的陷阱清單比 JSON 長得多。
左右捲動檢視完整表格
| 特性 | XML | JSON | YAML |
|---|---|---|---|
| 註解 | 支援 | 不支援 | 支援(單行) |
| 多行字串 | 支援 | 需跳脫符號 | 原生支援 | 與 > |
| 結構表達 | 成對標籤 | 大括號與逗號 | 縮排 |
| 人手編輯 | 費力 | 中等 | 最省力,但對縮排敏感 |
所以「該用哪個格式」的答案通常不需要二選一,重點在分工:程式與程式之間交換資料,JSON 依然穩;要進版本控制、要被人反覆修改、要在 code review 裡被逐行檢視的設定,YAML 的優勢才會發揮。接下來的所有場景,從部署清單到文章 frontmatter,背後都是同一個判準。
遞迴縮寫:YAML Ain't Markup Language
YAML 這四個字母是遞迴縮寫,展開後是「YAML Ain't Markup Language」,翻成中文是「YAML 不是標記語言」。這個名字是刻意取的:標記語言(例如 HTML 或 XML)關心的是「文件怎麼呈現、怎麼標註」,而 YAML 從第一天起就想表達「資料本身的結構」。在 YAML 檔案裡你不會看到成對的標籤,只會看到乾淨的鍵值對與縮排。
它的起源可以從官方規格書的歷史章節讀到:Clark Evans、Oren Ben-Kiki 與 Ingy döt Net 三人在 2001 年前後透過 yaml-core 郵件論壇展開協作設計,歷經約三年,在 2004 年初發表 YAML 1.0 規格。同一份文件也記錄了兩個生態里程碑:第一個 YAML 框架在 2001 年以 Perl 寫成,而 Ruby 是第一個把 YAML 框架直接內建出貨的語言。對現在的使用者來說,這段歷史的重點只有一個:YAML 的設計動機是「讓人直接編輯資料」,這個基因決定了它後來的所有優點與所有陷阱。
縮排即結構:少掉大括號與逗號的讀法
同樣一份資料,用 JSON 寫是這樣:
{"order": {"id": "A-1048", "channel": "web", "items": [{"sku": "TP-200", "qty": 2}]}}用 YAML 寫是這樣:
order:
  id: A-1048
  channel: web
  items:
    - sku: TP-200
      qty: 2
兩者表達的資料完全相同,但第二種你可以在會議上直接唸出來,改一個欄位也不會少一個逗號就整份報錯。這就是 YAML 能攻佔設定檔市場的原因:工程師寫、主管審、偶爾行銷同事也要改一個文案參數,門檻夠低。代價則是所有結構資訊都壓在縮排上,只要多一個空格或少一個空格,意義就變了,這也是後面兩個章節要反覆拆解的主題。
YAML 1.2 是 JSON 的嚴格超集合
JSON 與 YAML 的關係,官方規格講得非常明白:2009 年發表的 YAML 1.2,核心目標就是讓 YAML 成為 JSON 的嚴格超集合(strict superset),也就是說,任何合法的 JSON 文件本身就是合法的 YAML 文件。你完全可以把一段 JSON 原封不動貼進 .yaml 檔案,YAML 1.2 解析器吃得下去;反方向則不成立,YAML 多出來的註解、多行字串與縮排風格 JSON 並不支援。
1.2 版還做了一件影響深遠的事:移除多項有問題的隱式型別建議,這一點等到談挪威問題時再展開。至於你在文件上偶爾看到的 1.2.2,它是 2021 年 10 月 1 日發布的修訂版,官方明言相對 1.2 沒有規範性變更,目的只是修正錯誤與增補清晰度,所以「YAML 1.2」與「YAML 1.2.2」在語言特性上可以視為同一個版本。
語法規則精要:五條就夠
YAML 的語法細節不少,但日常會用到的核心只有五條。把這五條練成反射,面對常見的設定檔就能直接動手。
規則一:區塊鍵值對的冒號後面要空一格
本文使用的區塊(block)鍵值對寫法是「鍵: 值」,冒號後面要跟著至少一個空白字元。規格書的原文其實帶著「通常」(Normally)的語氣:冒號作為值的指示器時,必須以空白與值分隔;例外是 JSON 風格的 flow 寫法:當大括號裡的鍵本身是 JSON 形式(例如引號包住的字串)時,冒號後面可以緊貼著值,所以 {"a":1} 這樣的寫法是合法 YAML。這個限制帶來一個好處:在區塊寫法的純量裡,冒號只要後面不接空白,就可以直接出現在文字中,所以網址與時間戳記不用加引號也沒事。
api_endpoint: https://api.example.com/v1
created_at: 2026-10-19T09:30:00它同時埋了一個新手一定會踩的坑:a:1 不會被解析成鍵 a 等於 1,而是被讀成一個內容為「a:1」的單一字串。規格書甚至特別點名這個「a:1」案例是常見的混淆來源。看到「明明有冒號卻讀不到鍵」的錯誤,先檢查冒號後面是不是少了空白。
規則二:縮排只用空格,全面禁用 Tab
YAML 的結構由縮排決定,而規格書對縮排的規定是:行首的零或多個「空格」字元,並且「為維持可攜性,縮排不得使用 Tab」,理由是不同系統對 Tab 的處理不一致。這在所有常見格式裡幾乎是最嚴格的一條:Python 只禁 Tab 與空格混用,YAML 是直接全面禁止。
YAML 官方 FAQ 的存檔版本把理由講得更白:Tab 被宣告「全面禁止」,因為不同編輯器與工具對 Tab 的處理不同,而縮排對 YAML 解讀太過關鍵,這個問題複雜到官方根本不想嘗試解決。實務上的自保動作有兩個:把編輯器設定成按 Tab 鍵輸入固定數量的空格(通常是兩格),以及讓編輯器把行尾空白與 Tab 顯示出來。「昨天還能跑、今天突然壞」的 YAML 問題,常見的原因之一就是檔案裡混進了 Tab。
規則三:清單用減號,巢狀靠縮排
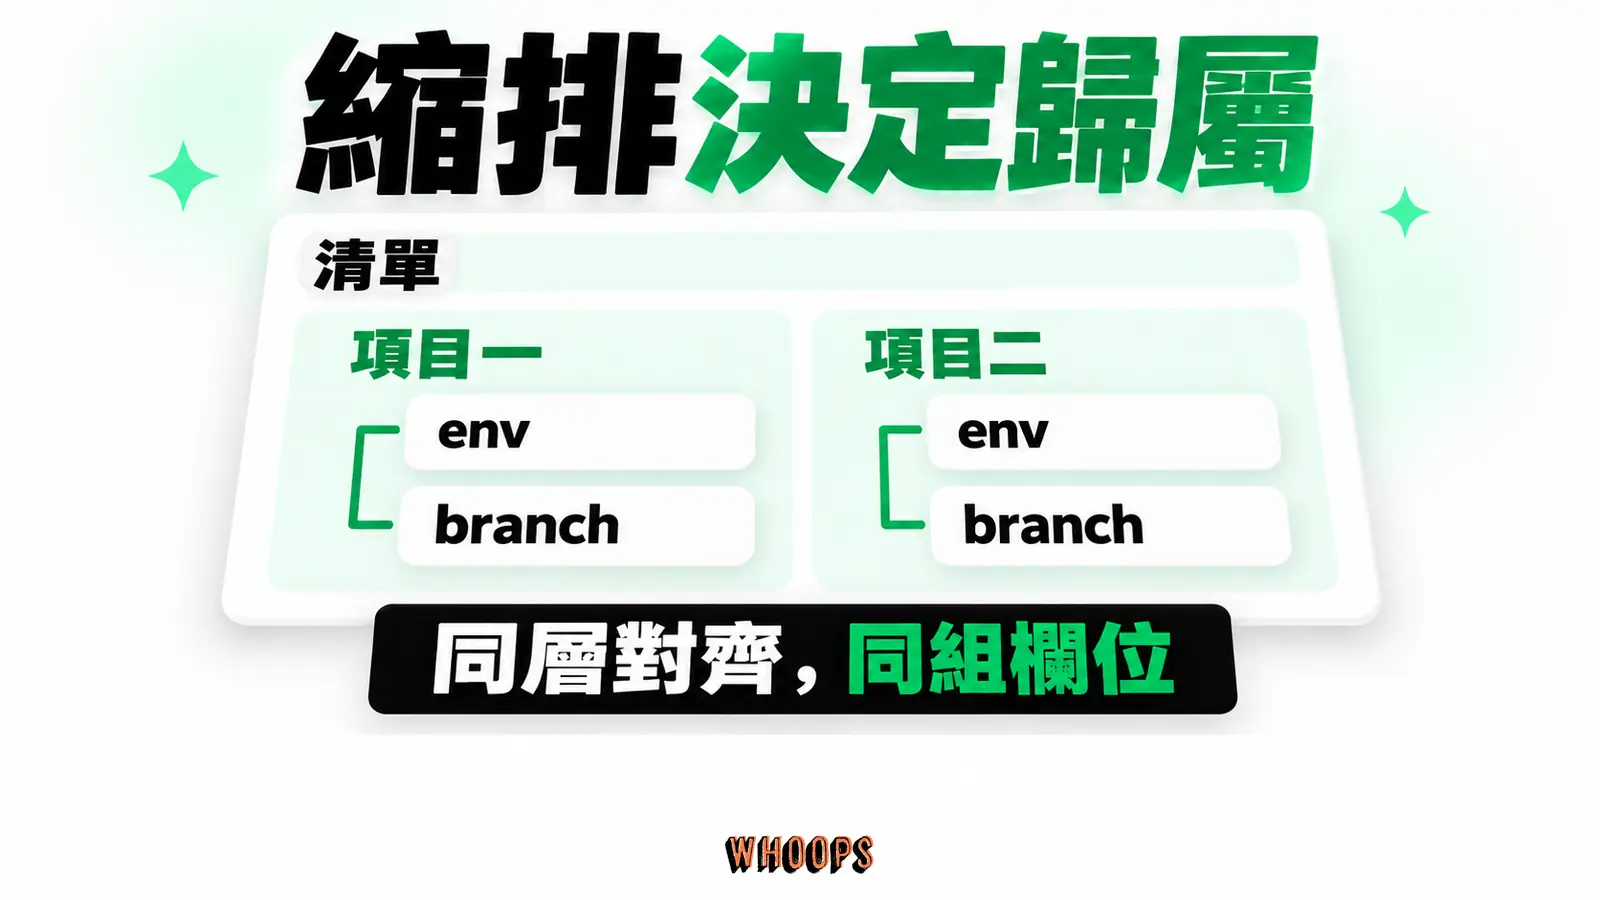
清單(sequence)的每一項以減號加一個空白開頭,同一層的減號必須對齊。要表達「清單裡再包一層鍵值對」,就把內容往右縮排:
deploy:
  targets:
    - env: staging
      branch: develop
    - env: production
      branch: main
判讀技巧只有一句話:往右一格就是往下一層。你不需要算逗號、不需要找括號,只要沿著縮排的層次往內讀。也因為層次全靠縮排表達,團隊最好約定統一的縮排寬度(兩格是主流),並交給編輯器自動維持,不要有人用兩格、有人用四格,那種檔案沒有人能安全地改。
清單與鍵值對混用時有一個新手常見的糊塗點:減號那一行自己就是一個節點,它下面同一層的鍵值對都屬於同一個項目。上面的例子裡 env 與 branch 都縮在減號底下,所以是一組;而這裡的對齊是硬規則:此例中 branch 若未與 env 對齊,多縮或少縮一格都會直接造成 YAML 語法錯誤(env: staging 的值已是純量,底下不容許再掛更深一層的欄位),部署根本不會開始。遇到「清單裡的項目讀不到某個欄位」或「一直報語法錯」,先確認欄位跟減號下第一個鍵是否對齊,常見的毛病就是這裡歪了一格。
規則四:註解只有單行
YAML 的註解由井字號開始,但井字號要能當註解,有位置條件:出現在行首,或與前面的內容之間隔著空白,這一行從井字號到行尾才會被忽略。藏在文字裡的井字號屬於內容——hello#world 會被原樣讀成字串,"hello # world" 這種引號內的井字號也是內容,兩者都不會被當成註解吃掉。YAML 沒有區塊註解:想註解三行就要打三個井字號,想暫時停用一段設定,常見做法是把整段複製到檔案外的草稿,或逐行加上註解。這個限制常讓寫慣其他語言的人不適應,但也讓 YAML 檔案的每一行都保持「要嘛生效、要嘛整行註解」的清楚狀態,審起來反而單純。
# 台灣區部署設定
region: ap-northeast-1   # 暫借東京節點
# replicas: 4            # 週年慶前再打開
規則五:型別會自動推斷,引號是保險
不加引號的值,解析器會試著自動判斷型別:看起來像整數就當整數、像浮點數就當浮點數、空值就是 null。YAML 1.2 的 Core Schema(規格建議處理器預設採用的解析規則集)對布林的判定只認 true、True、TRUE 與 false、False、FALSE。大多數時候這個機制很方便,但它也是 YAML 最著名的陷阱來源:當你的資料「長得像布林、長得像數字、或長得像 null」卻其實是字串時,就必須加引號。
version: "1.10"     # 加引號:這是字串,不是數字
answer: "no"        # 加引號:這是兩個字的字串,不是布林
empty: ""           # 加引號:空字串,與 null 不同
一句話記法:這個值如果印出來應該長得跟現在完全一樣,就加引號。版號、密碼、國碼、開頭是零的編號,全都屬於該加引號的族群。
挪威問題:no、yes、on、off 的布林陷阱
假設電商團隊的設定檔裡有這樣兩行:
store:
  country: NO
  featured: off
在受 YAML 1.1 解析規則影響的工具裡,country 的值不會是字串「NO」,而是布林值 false。挪威的國碼就這樣把你的商店設定搞壞了,這個案例在工程圈被稱為「挪威問題」(Norway Problem),是所有 YAML 教學都繞不開的經典事故。
YAML 1.1 的官方布林對照表
這個問題不是都市傳說,它寫在官方文件裡。YAML 1.1 的布林型別定義(yaml.org 的 bool 型別頁)列出的解析規則包含下列全部寫法:
左右捲動檢視完整表格
| 寫成布林 true | 寫成布林 false |
|---|---|
| y、Y、yes、Yes、YES | n、N、no、No、NO |
| on、On、ON | off、Off、OFF |
| true、True、TRUE | false、False、FALSE |
也就是說,在 1.1 的規則下,no 是 false、yes 是 true、off 是 false、on 是 true,連單獨一個 y 或 n 都算。官方文件自己的範例裡就放了一行 answer: NO,把它解析成布林。規則本身訂得清清楚楚,問題出於它對人類直覺太不友善。
國碼 NO 為什麼會變成 false
機制拆開來看只有三步。第一步,你寫 country: NO,因為沒加引號,解析器不會直接認定它是字串,而是先拿去比對隱式型別規則。第二步,1.1 的布林規則表裡明確列著 NO。第三步,比對命中,資料在進到你的程式之前就被換成了布林 false。你的程式碼從頭到尾沒有出錯,錯的是資料在入口處就被轉換了。
實際受害的不只是挪威。設定檔裡的 yes/no 問答值、開關欄位 on/off、甚至資料表裡的單字欄位,都可能在不同工具上得到不同結果。更麻煩的是它壞得安靜:解析不會報錯,程式照常執行,只是某個判斷永遠走進奇怪分支,這種問題在大型系統裡要抓很久。
除錯時有個實用的思考順序。看到「條件永遠不成立」或「開關永遠打不開」這類症狀,先把 YAML 檔載入後的實際結果印出來看,別盯著檔案原文猜;一旦你印出 country 的值,看到的竟是 false 而非 NO,答案就自己浮出來了。第二個順位才是查工具的版本立場:同一份檔案在不同解析器手上結果不同,幾乎都是 1.1 與 1.2 的隱式型別差異。把「印出來看」養成反射,能省下大量對著檔案發呆的時間。
接手既有專案時,值得花十分鐘做一次存量盤點:把設定檔裡所有沒加引號、又長得像 yes、no、on、off、y、n 的值全部列出來,逐一確認欄位預期的型別:預期是字串就補引號,預期是布林就改用 true 或 false,改完再驗證消費端的行為。這種盤點最好在事故發生前做,因為挪威問題的破壞力來自「上線前完全沒有徵兆」,而補引號的成本只有幾秒鐘。盤點順手把縮排裡的 Tab 一起清掉,兩件事故源一次處理完。
1.2 已經修正,但生態還沒跟上
規格面其實早就處理了。YAML 1.2 的 Core Schema把隱式布林收窄到 true、True、TRUE、false、False、FALSE 六種組合,yes、no、on、off 一律不再是布林,而 Core Schema 正是規格建議處理器預設採用的規則集。
無奈工具鏈還停在舊世界。Python 生態最常用的 PyYAML,在官方網站的自介裡就寫明自己是「完整的 YAML 1.1 解析器」,這正是 Python 讀 no、yes、on、off 會得到布林的直接原因。這不代表 PyYAML 不能用,而是你必須知道手上工具講的是哪一版規則。
防禦工具有三層。第一層是加引號,任何可能被誤判的字串一律引號伺候,這是最直接的做法。第二層是靜態檢查,yamllint 的 truthy 規則文件明文寫著:YAML 1.1 會把 yes、no、on、off 的組合視為 truthy、YAML 1.2 只認 true、True、TRUE 與 false、False、FALSE,讓它在存檔當下就跳出警告。第三層是在文件開頭以 %YAML 1.2 指令明示版本,但要留意,明示版本不保證解析器換一套規則:以 PyYAML 為例,即使檔案開頭寫了 %YAML 1.2,它仍以 1.1 的規則解析,country: NO 照樣變布林;這層防禦要先確認工具實際支援的行為才算數。順帶一提,GitHub Actions 的觸發鍵 on: 正好撞在這條規則上:1.1 解析器會把 on 當布林,所以有些團隊的 lint 設定需要調整,yamllint 也提供 check-keys 選項,停用對 mapping 鍵的這項檢查。
多行字串:豎線與折疊符號的選擇
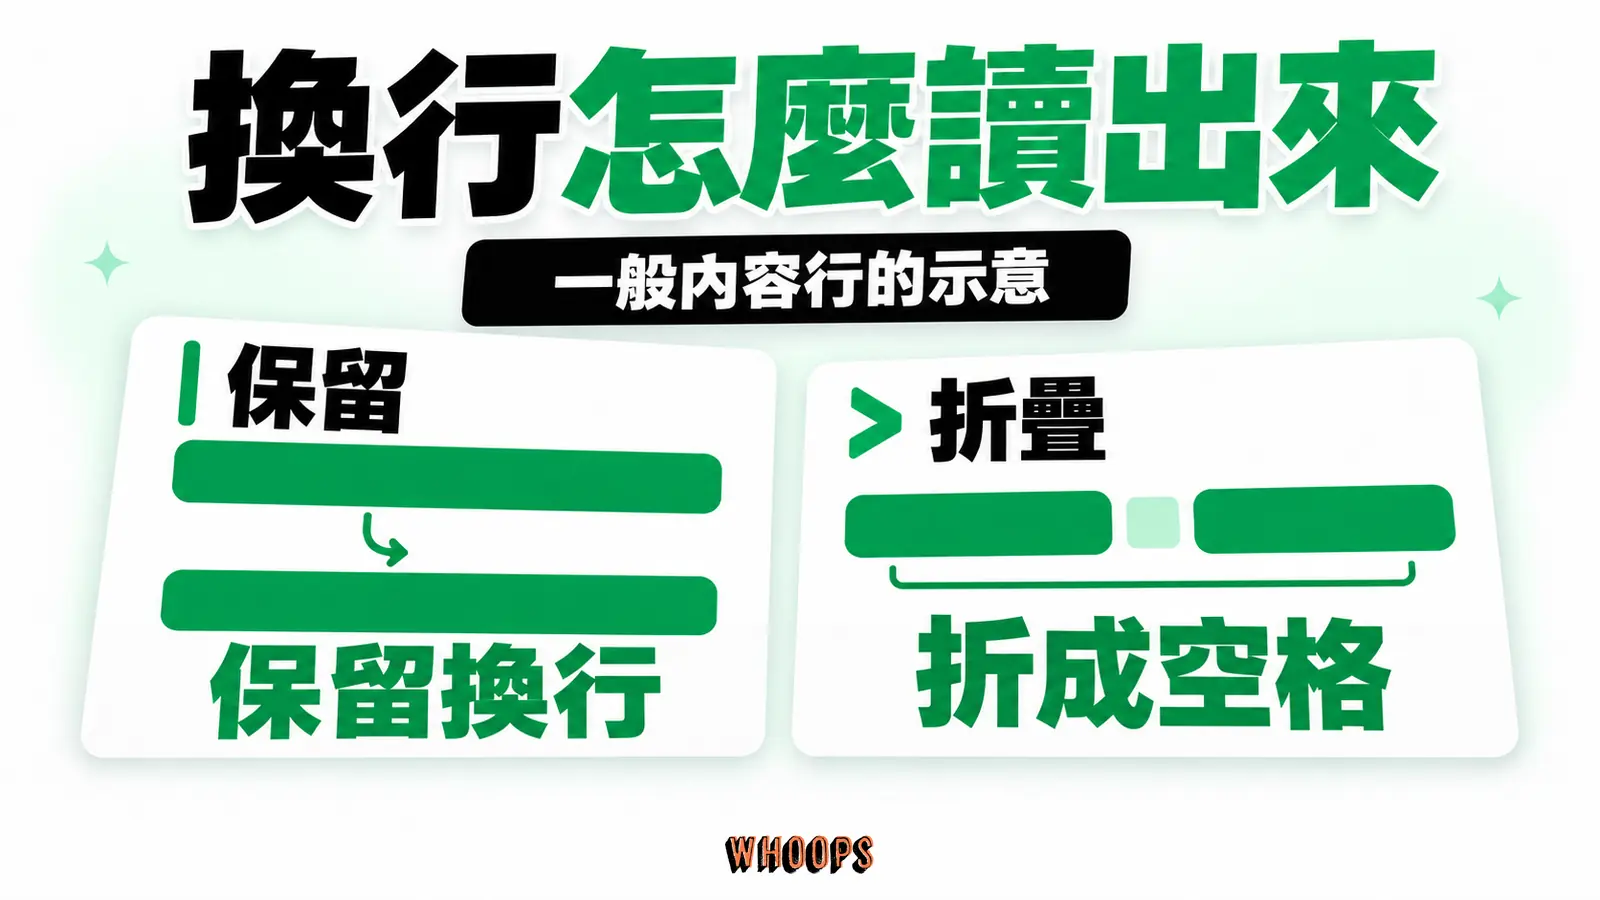
把一段長文字放進設定檔,YAML 給你兩種風格,符號取自它們的長相:豎線 | 是 literal block scalar(字面區塊),大於符號 > 是 folded block scalar(折疊區塊)。官方規格對兩者的定義差別在換行的處理方式。
release_note: |
  修正結帳頁在小螢幕上的按鈕跑版。

  調整物流串接的逾時設定。

summary: >
  這次改版涵蓋結帳流程
  與物流串接兩個區塊,
  共兩項修正。
豎線版本會保留每一個換行,讀出來就是三行文字(中間空一行也會保留);折疊版本的一般規則是相鄰內容行之間的換行折成空格,整段收斂成一行,但空行與更深縮排的行,周圍的換行會保留下來;上面的例子沒有觸發這些保留條件,所以讀出來是一行。選擇原則很好記:內容是程式碼、日誌、指令稿這種「換行本身有意義」的文字,用豎線;內容是自然語言段落,希望 YAML 檔裡方便閱讀但讀出來是連續句子,用折疊。
兩種風格選錯的後果通常不嚴重,但除錯起來很磨人:shell 指令用折疊寫,三行被併成一行,指令照樣執行只是行為奇怪;文案用豎線寫,該折行的段落變成斷成好幾行的短句,前端渲染出來就是排版事故。養成習慣的方法是在 code review 時多問一句「這段文字讀出來換行長什麼樣」,問兩三次之後,選擇就會變成直覺。
chomping 指示器:減號與加號控制結尾換行
多行字串的結尾換行怎麼算,由 chomping 指示器控制,共有三種行為:規格書定義的 CLIP(預設,僅保留一個尾端換行)、STRIP(減號 -,移除所有尾端換行)與 KEEP(加號 +,保留全部尾端換行)。規格的 Example 8.1 正是用 |、>1、|+、>1- 四種標頭示範對應的輸出。
左右捲動檢視完整表格
| 寫法 | 尾端換行行為 | 典型用途 |
|---|---|---|
| | | 保留一個換行(CLIP,預設) | 一般多行文字 |
| |- | 移除所有尾端換行(STRIP) | 產生 shell 指令、金鑰內容 |
| |+ | 保留全部尾端換行(KEEP) | 保留文字結尾的多個空行 |
至於 |-:需要讀出來不含尾端換行的字串時就用它,例如把指令或金鑰內容寫成多行、讀出來不帶多餘換行;該不該去掉尾端換行,依接收端的要求決定,有些接收端本來就預期字串以換行結尾,先確認再選。折疊風格同樣可以加上這些指示器,行為對應相同。
錨點、別名與合併鍵:YAML 的重複使用機制
同一份設定裡同樣的區塊出現第三次時,就該認識 YAML 的重複使用機制。規格的說法是:重複出現的節點先以 & 符號標記為錨點(anchor),之後以 * 符號的別名(alias)引用同一個節點,資料不必複製貼上。
defaults: &db_defaults
  adapter: postgres
  database: shop_default
  pool: 5

production:
  database: shop_prod
  <<: *db_defaults

staging:
  database: shop_stage
  <<: *db_defaults
這裡的 << 是合併鍵(merge key)。它不是 1.2 Core Schema 的一部分,而是 YAML 1.1 型別註冊表裡的 merge 型別:官方型別文件的定義是把一或多個指定 mapping 的鍵值對插入當前 mapping,而且已存在的鍵不會被覆蓋。上面的例子裡,defaults 雖然也帶了 database: shop_default,但 production 自己宣告了 shop_prod,「已存在的鍵不被覆蓋」就作用在這裡,合併進來的預設值蓋不掉它;production 沒設的 adapter 與 pool,才由 defaults 遞補,staging 同理。這個機制不在 1.2 core schema 內,但主流工具仍廣泛支援,使用前確認你的解析器吃不吃它,是基本素養。
錨點與合併鍵的魅力在「改一處、全生效」,風險也在同一處:當合併層數一多,讀檔的人要在腦中展開好幾層間接引用才能知道最終值是什麼,除錯成本快速上升。實務建議是讓錨點停留在「一層引用」的單純用法,被引用的區塊放在檔案開頭集中管理;一旦發現自己開始寫「錨點引用另一個錨點的合併結果」,通常是時候把共用值拆成範本變數,交由部署工具處理,別讓 YAML 檔自己長成一門小語言。
命名也有小學問。錨點名稱最好描述「這組值的角色」,避開「它出現的位置」這類代號,像上面的 db_defaults 一眼就知道是資料庫預設值;命名成 a、base2 這種代號,兩個月後連作者本人都要重新推敲。多環境設定(正式、預發、測試)共用一組基礎值、各自覆蓋少數欄位,是錨點與合併鍵最經典也最安全的應用形態,環境之間的差異一眼就能對照出來,審查時不用來回捲動。
副檔名:.yaml 還是 .yml
兩種副檔名都合法,但建議有明確答案。YAML 官方 FAQ 的存檔版本對「有沒有官方副檔名」的回答是:盡可能使用 .yaml。而工具端多半兩種都收,例如 GitHub Actions 的官方快速入門就明文允許 .yml 或 .yaml 兩種副檔名。
實務做法很簡單:新專案一律用 .yaml,與官方建議一致;接手舊專案時入境隨俗,跟著既有慣例走,不要一半一半。真正該避免的是同一個 repo 裡兩種副檔名混用,那會讓「找設定檔」這件小事永遠多一次猜測。至於網路上流傳的各種副檔名歷史成因說法,在現行官方文件裡找不到依據,不需要寫進你的團隊規範。
六大應用場景:一份設定檔走遍部署、CI、文件與內容
學會語法之後,更重要的是知道 YAML 在真實世界的位置。以下六個場景都有官方文件背書,也代表六種「把結構化資料交給機器」的工作型態。
這六個場景的共同點是載體,而不是執行模型:這些工具以 YAML 表達各自的設定或流程,執行順序、套用方式及版本追蹤由工具與團隊流程決定。其中 Kubernetes 的 manifest 走宣告式路線:你寫的是「最終狀態應該長這樣」的描述,要三個副本就寫數字三,至於怎麼到達,交給叢集;GitHub Actions 的 workflow 與 Ansible 的 playbook 則是流程定義,官方文件明載 steps 依序執行、play 裡的 tasks 由上而下逐項執行,先後順序本身就是語意的一部分。共同的實際好處來自純文字:可以版本控制、可以差異比對;而 YAML 的可讀性剛好讓內容連非作者都看得懂,這是它在這個位置上難以被取代的原因。
Kubernetes:manifest 的慣例格式
Kubernetes 官方文件寫得很直白:按慣例,manifest 以 YAML 撰寫(也可以用 JSON),而 kubectl 之類的工具會把 manifest 內容轉換成 JSON 或其他支援的序列化格式,再透過 API 發出請求。換句話說,你寫 YAML 是給人與版本控制看的,機器在送出請求前自己會轉換。官方文件列出的必填欄位有四組:apiVersion、kind、metadata(其中的 name 等資料用來識別物件)與 spec(描述你要的狀態);其中 apiVersion、kind 與 metadata.name 是辨識一份 manifest 時最常看到的組合,一份完整的 Deployment 大致長這樣:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-front
spec:
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: web
          image: nginx
對新手來說,先記三件事:manifest 描述你要建立的 Kubernetes 物件、apiVersion 與 kind 決定這是什麼資源、metadata.name 是它在叢集裡的身分;spec 的結構則因物件種類而異,照著對應的 API 參考文件寫。manifest 是純文字,所以變更有機會走版本控制與 code review,但「部署歷史就是提交歷史」要成立,前提是團隊真的把清單納入版本控制並以它為部署來源;這是流程帶來的保證,不是格式自動送上的。做到之後,回溯問題時才不需要猜當時誰在主控台按了什麼。
Docker Compose:一份 compose.yaml 描述整個應用棧
Docker Compose 官方文件的定位是:用單一 YAML 設定檔管理應用程式棧的 services、networks 與 volumes,一個指令就能建立並啟動全部服務;這份檔案的正式名稱是 compose.yaml,遵循 Compose Specification 的規則。對小型團隊來說,它是最容易上手的「一份檔案講清楚整個服務拓撲」的練習場:
services:
  web:
    image: nginx
    ports:
      - "8080:80"
GitHub Actions:CI 流程本身就是一份 YAML
想在 GitHub 上做自動化,你寫的不是腳本,是一份設定。GitHub Actions 官方語法文件的第一句話就是:workflow 是可設定的自動化流程,「必須建立 YAML 檔」來定義它;檔案放在儲存庫的 .github/workflows 目錄,副檔名必須是 .yml 或 .yaml。還不熟 Git 與儲存庫操作的人,可以先回頭看GitHub Repo 入門指南再回來寫 workflow。
name: deploy
on:
  push:
    branches: [main]
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - run: echo "Build started"
注意上面那個 on: 鍵。它正好是前面提過的 1.1 布林規則會掃到的字,各家工具對它的處理不一致,這也是 YAML 版本差異最貼身的實例:同一份檔案,官方文件說它是觸發條件,舊解析器覺得它是布林。遇到檢查工具對它跳警告時,你已經知道原因了。
Ansible:以最少語法表達的 playbook
Ansible 官方手冊對 playbook 的描述是「以 YAML 格式表達、語法需求極少」,並建議不熟 YAML 的人先讀官方的語法概覽、在編輯器裝上 YAML 外掛再上手。playbook 最外層清單的每個破折號是一個 play,縮排往下展開主機與任務;play 裡 tasks 清單的每個破折號則是一個 task,由上而下依序執行:
- hosts: web
  tasks:
    - name: Install nginx
      package:
        name: nginx
        state: present
OpenAPI:API 文件的另一種載體
OpenAPI 官方學習文件說明:OpenAPI Description 以一份或多份文字文件撰寫,每份文件代表一個 JSON 物件,可以用 JSON 或 YAML 格式;入口文件慣稱 openapi.json 或 openapi.yaml。同一份規格用 YAML 呈現時,路徑與參數的層次沿縮排展開,讀起來比 JSON 少掉大量引號與逗號,非常適合需要頻繁檢視修改的 API 契約。
靜態網站 frontmatter:Jekyll、Hugo 與 Astro
寫內容的人接觸 YAML 的入口是 frontmatter:檔案最開頭以三條虛線包夾的中繼資料區塊。Jekyll 官方文件規定 front matter 必須是檔案的第一個東西、以三條虛線包夾的合法 YAML,任何含這個區塊的檔案都會被 Jekyll 當特殊檔案處理。Hugo 官方文件則支援 JSON、TOML、YAML 三種序列化格式,並依分隔符判別格式:--- 包夾的是 YAML、+++ 包夾的是 TOML、以大括號包夾的是 JSON,同一個站體裡三種格式可以並存。實務上建議全站統一用一種,編輯器外掛與團隊範本才不會在縮排規則上彼此打架。到 Astro 的內容集合,glob() loader 可以從檔案系統載入 Markdown、MDX、Markdoc、JSON、YAML 或 TOML 檔,.md 內容項目同樣以 --- frontmatter 定義 title 與 slug 等屬性,slug 可以覆蓋自動生成的 id:
---
title: 週年慶 landing page 改版紀錄
slug: anniversary-landing-redesign
---
這就是為什麼行銷與內容工作者也該懂一點 YAML:你每天更新的文章屬性、社群卡片的描述文字、導覽列的項目順序,很多都住在這個小小的三虛線區塊裡,而它的一切規則都跟你同事在寫的部署設定一模一樣。
frontmatter 的欄位名稱由各家 generator 自行定義,同一個概念在不同系統裡可能叫不同名字,搬移內容時要對照目標系統的文件確認,不要假設欄位自動通用。寫作時值得建立的習慣是把 frontmatter 當成「這篇內容的資料庫欄位」看待:標題、描述、網址代稱一一填好、拼寫一致,網站長大之後要重構或搬家的那天,你會感謝當初每篇文章都有乾淨一致的中繼資料。反過來說,frontmatter 亂掉的網站,往往在規模變大後才付出代價。
結構化設定與 AI 可讀性:AI 產品也選了 YAML
近兩年 YAML 多了一批新使用者:AI 工具。這個選擇與 SEO 領域的姐妹篇是同一個思路:結構化資料把頁面資訊交給搜尋引擎、llms.txt 把網站重點交給生成式引擎,而 YAML frontmatter 把「何時該用這個能力」的中繼資料交給 AI——把機器要判讀的資訊放進明確結構,通常比埋在自然語言裡更容易被穩定解析。要強調的是,這是設計上的推論,實際效果仍取決於各工具的實作方式。
Anthropic 的 SKILL.md:官方文件親自示範
最有代表性的官方實例是 Anthropic 的 Agent Skills。官方規範寫明:每個 skill 的 SKILL.md 由兩部分組成,--- 標記之間的 YAML frontmatter(name、description 等欄位,告訴 Claude 何時該用這個 skill),加上其後的 Markdown 內容;skills 的設定就是透過 SKILL.md 頂部的 YAML frontmatter 完成。
值得注意的設計在於分工:frontmatter 提供 name、description 等中繼資料與設定,負責告訴 Claude「何時該用這個 skill」;Markdown 正文則是 Claude 執行 skill 時遵循的指令。兩個部分都會被機器讀取——frontmatter 的結構化欄位便於解析、比對與篩選,正文承載完整的執行指令。想深入這套機制的人,可以接著讀Claude Skills 完整教學。
把這個結構借來自己的專案也成立:任何需要 AI 反覆遵循的規範,都可以拆成「結構化欄位 + 自由文字」兩層。機器要判讀的觸發條件、適用範圍、參數限制放欄位;需要判斷力的流程細節放文字。這個拆法跟工程師寫設定的思路完全一致:確定性的部分交結構,模糊性的部分交文件。前後端協定、內容審核規則、客服回覆的邊界條件,都適用同一套骨架。
明確結構 vs 自然語言:同一套邏輯的三個出口
把這個觀念放到你的工具箱裡,會發現各種「讓 AI 讀得懂」的檔案都在結構化光譜上:AGENTS.md 用 Markdown 段落與標題組織代理指令,走的是彈性路線;MCP 的設定檔用 JSON 表達伺服器連線,走的是嚴格路線;SKILL.md 的 YAML frontmatter 則介於中間:結構化欄位承載「何時該用」的中繼資料,自由文字承載執行時遵循的指令。選擇的判準不是流行,而是「這份資訊要不要被程式可靠地拆解」:要,就往結構端靠;不要,就保留自然語言的彈性。
這也是工程師寫 YAML 的經驗對 AI 時代依然值錢的原因:懂得把模糊需求拆成欄位、列舉與層級的人,無論面對的是部署清單還是 AI 設定,產出的檔案都更不容易出錯。格式會換,拆解能力不會。
Python 讀 YAML 的資安底線:safe_load
最後一個主題是資安,也是最容易省略、後果最重的一段。Python 讀 YAML 的標準套件是 PyYAML,而它有兩個載入函式,命運大不相同。先講結論:任何不是你本人寫的 YAML 檔,一律用 yaml.safe_load。
import yaml

# 不要這樣載入不受信任的檔案
cfg = yaml.load(open("config.yaml"))

# 應該這樣
cfg = yaml.safe_load(open("config.yaml"))
PyYAML 官方文件的警告寫得毫不客氣:對任何來自不受信任來源的資料呼叫 yaml.load 並不安全,yaml.load 與 pickle.load 一樣強大,可能呼叫任意 Python 函式;應改用 yaml.safe_load。差別在於 SafeLoader 只支援標準 YAML tags、不會建構任意 Python 物件。附帶一提,PyYAML 從 6.0 起 Loader 參數改為必填,上面那行裸呼叫的 yaml.load 在現行版本會直接報錯;如今真正危險的寫法,是把 Loader 明確指定成 UnsafeLoader 這類等級,結論不變:不是你本人寫的檔案,一律 safe_load。
攻擊場景不難想像:某個公開 repo 收到一份「好心修正」的設定檔,內容裡藏著指定 Python 物件的 tag,CI 流程用 yaml.load 載入的瞬間,攻擊者的程式碼就在你的 runner 上執行了。官方警告針對的正是「不受信任來源」這個情境,判斷標準應該從嚴:來源不是你,就用 safe_load,沒有例外。順帶記住前面提過的:PyYAML 是完整的 YAML 1.1 解析器,資安與挪威問題兩條防線,在 safe_load 與引號這兩個習慣上一次補齊。
落實到團隊流程有三個動作。程式碼層面,專案裡直接約定只出現 safe_load,把這條寫進程式碼規範。審查層面,code review 看到別人提交的 YAML 相關程式時,掃一眼載入函式的名字,這個檢查只花三秒。供應鏈層面,CI 會載入的外部設定檔來源要列清單,清單外的來源不進 runner。資安習慣的價值在於平時看不見,而 YAML 設定檔恰恰是「人人都能改、人人都以為它只是資料」的檔案,把關的責任自然落在寫載入程式的人身上。
上線前檢查表:六種事故現場與攔截手法
把整份教學收斂成一張檢查清單。以下六個錯誤是 YAML 常見的事故現場,每一項都對應前面章節的機制說明。
- 縮排混入 Tab:編輯器按下去是 Tab 還是空格,眼睛看不出來,解析器分得很清楚。把編輯器設成「Tab 鍵輸入空格」,一次斷根。
- 冒號後面沒有空白:a:1 是字串不是鍵值對,這是規格書點名的經典混淆。看到鍵讀不到,先檢查冒號。
- 該加引號的沒加引號:no、on 這類值在 1.1 工具下會變布林,國碼 NO 是最著名的受害者。判斷標準:值印出來該跟現在完全一樣,就加引號。
- 忽略版本差異:1.2 的 Core Schema 不再把 yes、no、on、off 解析為布林(true、True、TRUE 與 false、False、FALSE 仍是布林),但你手上的工具(例如 PyYAML)可能還在講 1.1。知道工具的版本立場,才知道哪些寫法危險。
- 合併鍵疊床架屋:錨點與 << 用到第二層以上,可讀性就開始崩壞。共用值超過一層時,改用部署工具的變數機制處理。
- 用 yaml.load 載入來路不明的檔案:不受信任的 YAML 一律 safe_load,這是官方警告的等級,不是建議的等級。
驗證方法分兩級。手動級:把檔案丟給 yamllint 跑一次,truthy 與縮排問題會直接列出;它的規則文件同時標明 1.1 與 1.2 的布林差異,等於把最容易踩的雷做成清單。日常級:在編輯器裝 YAML 外掛,Ansible 官方手冊也建議這樣做,存檔當下就有語法回饋,比任何事後檢查都便宜。兩級都做的團隊,有助於在出貨前提早發現部分語法及風格問題。
回到開場那個場景:同事說「就是縮排而已」,現在你知道這句話對了三分之二。縮排是骨架,冒號與引號是關節,載入函式是最後一道閘門。把五個規則練成反射、對 1.1 與 1.2 的差異保持警覺、對不受信任的檔案一律 safe_load,YAML 就會是整個工具鏈裡最安靜可靠的一環:它不搶戲,但部署、CI、文件與 AI 設定全都站在它上面。
常見問題
YAML 是程式語言嗎?
YAML 可以完全取代 JSON 嗎?
.yaml 和 .yml 要用哪一個?
為什麼 YAML 的縮排不能用 Tab?
Python 讀 YAML 一定要用 safe_load 嗎?
什麼是 YAML 的挪威問題?
操作步驟
- 把編輯器設定成按 Tab 鍵輸出固定空格(兩格為主流),並安裝 YAML 語法外掛,讓縮排與 Tab 兩大事故源在存檔當下就被擋下。
- 開新檔統一用 .yaml 副檔名;寫入內容時守住五條:冒號後空一格、縮排只用空格、清單用減號開頭、註解單行井字號、可能被誤判的字串加引號。
- 長得像 no、on、yes、off 或以零開頭的值,先確認欄位預期型別:字串補引號、布林改用 true 或 false,防範 YAML 1.1 工具的布林轉換(挪威問題);交付前用 yamllint 跑一遍,truthy 與縮排問題會直接列出。
- Python 端載入一律寫 yaml.safe_load,把別人提供的檔案全部當不受信任來源處理;code review 時多花三秒確認載入函式的名字。