Googlebot 是什麼?爬蟲與 SEO、GEO 影響全解析
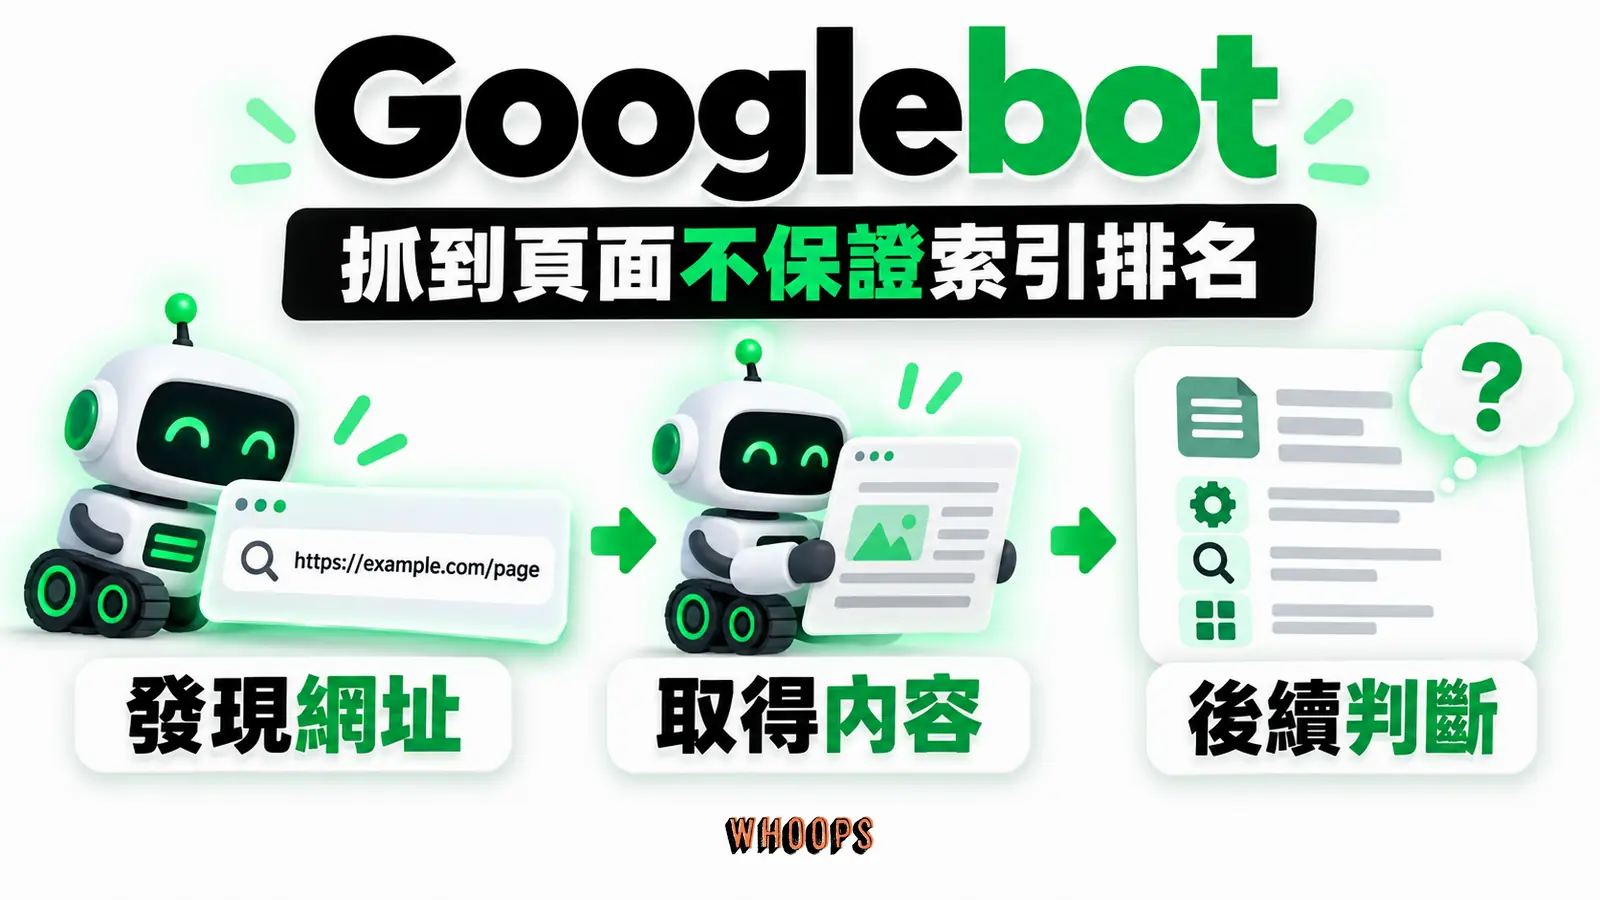
Googlebot 的抓取不等於索引或排名。本文說明手機與桌面爬蟲、轉譯、DNS 與 IP 驗證,以及 Google-Extended、OpenAI、Anthropic 等搜尋、訓練與使用者觸發用途的控制差異。
Googlebot 是 Google Search 用來抓取網頁的爬蟲通稱,主要分為 Smartphone 與 Desktop。抓取、轉譯、索引及提供搜尋結果各有不同工作,抓到不代表一定索引或排名。AI 產品另有搜尋、訓練及使用者觸發的存取方式,應依業者文件分開管理。
本文說明 Googlebot 如何抓取及辨識,並比較不同爬蟲與用途控制權杖。決策應同時考慮搜尋能見度、授權、隱私與伺服器負載,不能只分成「被訓練」或「被看見」兩種結果。
重點先看
- Googlebot 只負責發現與抓取網頁,抓了不等於會索引,索引了不等於會排名。它是一個流程的起點,不是終點。
- 行動優先索引(mobile-first indexing)已是預設,多數網站的抓取與索引以手機版內容為主,主力是 Googlebot Smartphone。
- AI 存取至少要區分訓練、搜尋與使用者觸發。Google-Extended 等又是用途控制權杖,沒有獨立爬蟲。各類用途可能共用抓取資料,不能只看一次請求就推定後續使用。
- Google-Extended 不影響 Google 搜尋。封掉它不會影響你在 Google 搜尋的收錄與排名,它管的是 Gemini 的訓練素材與接地(grounding)用途。
- robots.txt 是按爬蟲分開管的,可以精準放行 Googlebot、同時擋掉特定 AI 訓練爬蟲,這是現在 SEO 與 GEO(生成式引擎優化)最該做的基本功。
Googlebot 是什麼?它在搜尋流程裡的位置
Googlebot 是 Google Search 的網路爬蟲,官方分類屬於通用爬蟲;並非所有 Google 抓取程式都屬於 Googlebot。Google 可從已知頁面的連結、Sitemap 等方式發現網址,再由 Googlebot 取得可存取的內容。這是搜尋流程的抓取階段,後續是否索引與顯示仍由其他系統判斷。
這裡有個最關鍵的觀念:抓取(crawl)不等於索引(index),索引不等於排名(rank)。Google 官方把搜尋流程分成三個階段,Googlebot 只負責第一段。很多人把這三件事壓縮成一句「被 Google 收錄」,於是所有判斷都跟著走偏。
左右捲動檢視完整表格
| 階段 | 誰在做 | 做什麼 | 你能觀察的指標 |
|---|---|---|---|
| 抓取(Crawling) | Googlebot | 發現網址、下載 HTML 與資源 | 伺服器日誌裡的 Googlebot 訪問 |
| 索引(Indexing) | 索引系統 | 解析內容、判斷值不值得收進資料庫 | Search Console 的「已建立索引」數量 |
| 提供搜尋結果(Serving) | 排名系統 | 從索引中檢索、排序並回傳結果(排名在此發生) | 曝光、點擊、平均排名 |
換句話說,Googlebot 來抓你的頁面,只是讓你「取得被收錄的資格」,不保證一定會被收錄,更不保證會排前面。常見情境(示意):某個站長看著伺服器日誌,發現 Googlebot 天天來、一天抓幾千頁,就以為這些頁面統統在索引裡;結果打開 Search Console 的網頁索引報表,才看到一大票「已檢索,但未建立索引」。Googlebot 來訪頻率高,可能反映抓取需求、內容常更新或頁面熱門度(但也可能來自重複網址、網站搬遷等因素,不一定等於品質肯定)。至於最後收不收錄,是索引系統看內容品質、原創性、與其他頁面的重複關係等決定的(而排不排得上、排第幾,是後續提供搜尋結果階段,依相關性與權重決定的),跟來訪次數沒有直接等號。
索引這一關到底在看什麼?大致是幾個方向:內容是不是原創、夠不夠充實、是不是重複或抄襲來的、以及這個網址是不是權威版本。其中「權威版本」這點常被忽略,當同一份內容出現在多個網址(例如帶追蹤參數的網址、或同時有手機版與桌面版網址),Google 會用標準網址(canonical)來判斷哪一個才是主版本,相關機制可參考本站的 標準網址介紹。這意味著一件事:就算 Googlebot 把十個長得差不多的網址都抓回去了,索引系統可能只把其中一個當主版本收錄,其他被歸為替代版本、通常不各自建立主要索引項目。所以「抓取數」跟「索引數」中間,永遠隔著一道品質與去重的篩選,這道篩選才是決定你最終有多少頁面能上場的關鍵。
那 Googlebot 怎麼發現新頁面?主要有三條路。第一條是已知的連結,包括別人連到你的外部連結,以及你自己站內的內部連結。第二條是 Sitemap,也就是你主動提交的網址清單,相當於遞一份目錄給 Google,做法可參考本站的 Sitemap 完整說明。第三條是手動提交,透過 Google Search Console 的網址檢查工具,把單一新網址直接遞給 Google。其中內部連結是最常被低估的一條,因為 Googlebot 基本上是「沿著連結走」,連得到是主要的發現方式,孤兒頁(沒有任何連結指向的頁面)比較不容易被發現(雖然 Sitemap 或外部連結有時也能讓 Google 找到它們)。不同類型的連結在發現頁面與傳遞訊號上各有分工,完整的比較可以參考連結類型功能全解。
Googlebot 怎麼運作:抓取、轉譯、索引三階段
回傳 HTTP 200 的頁面通常進入轉譯佇列,但存在 noindex 等例外;非 200 回應也可能不進行轉譯。原始 HTML 與執行 JavaScript 後的內容都要檢查,不能把「200 就一定完整轉譯」當成保證。
抓取後,Google 可先處理 HTML 中的連結,再由以 Chromium 為基礎的 Web Rendering Service 執行 JavaScript。抓取與轉譯有各自的排程,但等待時間可能很短;不應把「兩波」理解為固定相隔多天或必先索引空殼。
這個「兩波」設計的實際後果,是 JavaScript 網站的 SEO 痛點。如果你的頁面關鍵內容是靠 JavaScript 產生(例如用前端框架在前端渲染、文字是 API 拉回來才填上的),Googlebot 第一次抓的時候看不到,要等到轉譯那一波才會出現。而轉譯資源是有限的、要排隊,等待時間沒有官方保證的範圍,可能很短,也可能拖上一段時間。這意味著依賴 JS 的關鍵內容,可能會晚一些才被 Google 看見、連帶延後內容處理與連結發現(但不代表 Google 一定會先以不完整內容建立索引)。這也是為什麼 JavaScript SEO 會被獨立拿出來談,相關的排查方法可參考本站的 JavaScript SEO 指南。
可用Search Console 網址檢查工具查看已索引版本資訊與線上測試結果,並檢查可取得的轉譯 HTML、資源錯誤及截圖。線上測試是當下測試,不等於目前索引內容,也不能保證後續索引;應確認主要文字與連結實際出現。
至於「Googlebot 多久來一次」「一次會抓多少頁」,這牽涉到爬取預算(crawl budget)這個概念,也就是 Google「能抓且想抓」的網址集合。爬取預算由兩股力量決定:一是 Google 稱為爬取容量上限(crawl capacity limit,又稱 hostload)的抓取能力,跟你伺服器的回應速度與承受能力有關;二是抓取需求(crawl demand),跟你的頁面有多受歡迎、多常更新有關。詳細機制與優化方向,我整理在 爬取預算完整解析,這裡不重複。你只需要記得一個原則:多數小型且更新不頻繁的網站,通常不需要特別優化爬取預算(不過也沒有「當天一定抓完整站」的保證);真正需要斤斤計較的,是 Google 官方點名的幾種情況:百萬級頁面且中度更新、上萬頁且每天快速變動,或大量網址落在「已發現,目前未建立索引」(這是大方向,不是精確門檻)。
Googlebot 的種類與 user agent 字串
Googlebot、圖片、影片及新聞等用途在 robots.txt 中有不同權杖。Googlebot-Image、Googlebot-Video、Googlebot-News 與 Google-InspectionTool 也可匹配 Googlebot;但更具體的匹配群組會優先,不能只看一條通用 Googlebot 規則就判定全部用途。GoogleOther 另有自己的權杖。
左右捲動檢視完整表格
| 爬蟲 | robots.txt 權杖 | 用途 |
|---|---|---|
| Googlebot(通用) | Googlebot |
抓網頁給搜尋索引用 |
| Googlebot-Image | Googlebot-Image、Googlebot |
抓圖片 |
| Googlebot-Video | Googlebot-Video、Googlebot |
抓影片 |
| Googlebot-News | Googlebot-News、Googlebot | 控制 Google News;沒有獨立 HTTP user-agent,使用其他 Googlebot 字串抓取 |
| Google-InspectionTool | Google-InspectionTool、Googlebot | Search Console 網址檢查、Rich Results Test 等測試工具;其規則不直接控制 Google Search |
| GoogleOther | GoogleOther | 供不同 Google 團隊使用的通用爬蟲,例如內部研究與開發;不綁定特定產品 |
Googlebot 規則可以影響多個搜尋用途;但若另有更具體的 Googlebot-Image 等群組,須按匹配與群組合併規則判斷。GoogleOther 也可能受自己的規則或通用 User-agent: * 規則限制,不能假設一定照常抓取。
Googlebot Smartphone 與 Desktop 使用同一個 robots.txt 權杖,不能用 robots.txt 分別針對兩者。以下是官方列出的 user-agent 格式範例;字串可協助辨識宣告的類型,但不是身分驗證。
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
桌面版則是:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1; +http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36
字串裡的 Chrome/W.X.Y.Z 是會持續更新的版本號,不用死記數字;真正穩定、用來辨識與寫規則的是 Googlebot 這個權杖,還有 +http://www.google.com/bot.html 這個標記。不過要提醒:這些 user agent 字串任何人都能偽造,所以字串裡的網址標記不能當成可靠的身分辨識依據,真正的驗證方法下一節會講。
行動優先索引主要使用手機版內容。響應式設計也可能因條件式程式碼、資源封鎖或點擊後才載入而缺少主要內容,不能假設同一網址就沒問題。折疊但已載入 DOM 的內容通常可被處理;依賴使用者點擊、滑動或輸入才取得的內容則需調整與驗證。
怎麼驗證對方是不是真的 Googlebot
這段很實用,因為任何爬蟲都可以在 user agent 字串裡自稱 Googlebot。光看 user agent 就相信對方是 Google,是資安與日誌分析的大忌。惡意爬蟲、內容扒手常常偽裝成 Googlebot 來混水摸魚,闖過那些只認 user agent 的防護。
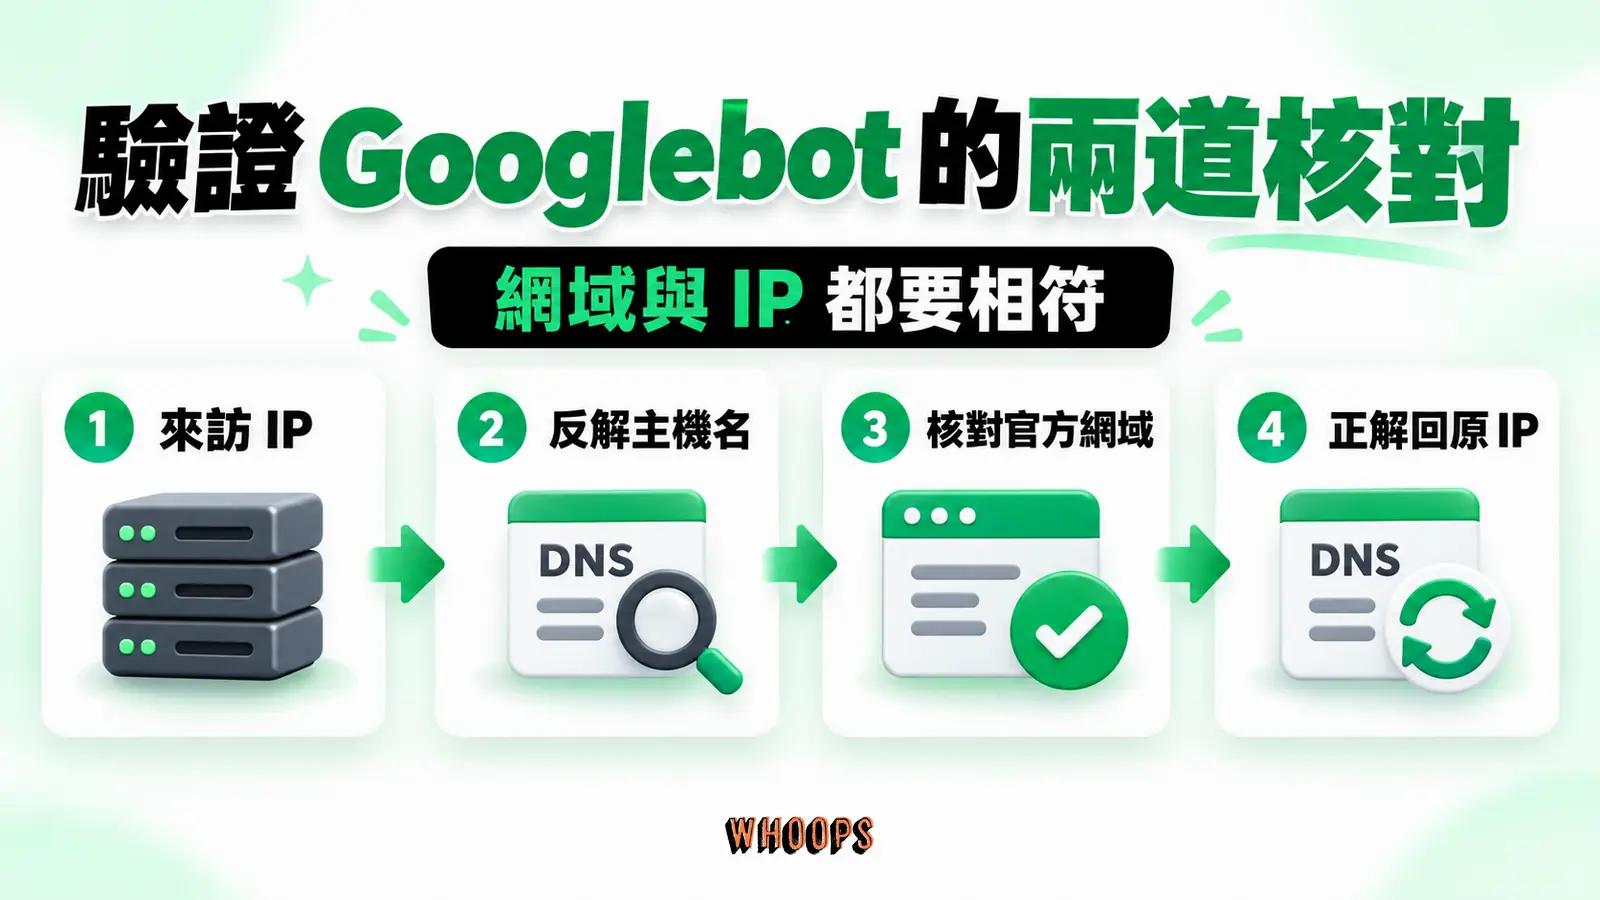
Google 提供兩類驗證方法:少量查詢可用反向 DNS 加正向 DNS;大量請求可將來源 IP 比對官方公布、適用該類爬蟲的 CIDR 範圍。以下先示範 DNS 方法,不代表每次都必須同時使用兩類方法。
- 拿到來訪的 IP 位址,對它做反向 DNS 查詢(reverse DNS),看它解析成什麼主機名稱。
- 依要驗證的請求類別,檢查完整官方主機遮罩。一般 Googlebot 使用 crawl-…googlebot.com 或 geo-crawl-…geo.googlebot.com;google.com、gae.googleusercontent.com 的其他遮罩可能屬特殊爬蟲或使用者觸發服務,不能一律當成搜尋 Googlebot。
- 再對這個主機名稱做正向 DNS 查詢(forward DNS),確認它解析回來的 IP,跟第 1 步那個原始 IP 完全一致。
DNS 方法需要反解、符合該類官方主機格式,且正解結果包含原始來源 IP。可用 host 來源IP 與 host 主機名稱 查詢;一般 Google 來源與 Googlebot 搜尋爬蟲仍須區分。使用 IP 清單方法時,也要選正確類別並定期更新。
大量日誌可依各業者的正式方法驗證,例如比對最新 IP 範圍,再結合 user-agent 與請求路徑分類。不要只因名稱相似或 IP 來自某家雲端主機就當成官方爬蟲。分析流程可參考LLM 爬蟲日誌分析。
Googlebot 不是唯一:AI 爬蟲大軍已經來了
這是現在跟幾年前最大的差別。以前會來抓你網站的,主要就是 Googlebot、Bingbot 這類搜尋引擎爬蟲;現在多了大批 AI 爬蟲,它們分屬不同公司、為了不同目的而來。把它們搞清楚,是做 GEO(生成式引擎優化)的前提,相關的整體概念可參考 GEO 是什麼。
這批 AI 爬蟲為什麼會突然變多?說穿了是生成式 AI 對訓練資料的龐大需求。自從大型語言模型與各種 AI 產品在這幾年爆發,各家業者都需要持續抓取網頁,一來當作訓練模型的素材,二來在產品回答使用者問題時,去網路上抓內容當作引用來源。於是你的伺服器日誌裡,除了老面孔 Googlebot 與 Bingbot,開始擠進 GPTBot、ClaudeBot、PerplexityBot 這些新訪客,在部分站點的觀察裡,AI 爬蟲的請求量相當可觀(不同站點與資料集的分布差異很大,不見得每個站都一樣)。這不是一時現象,而是內容被消費的方式正在擴張:以前你的頁面主要服務「在搜尋結果被點擊」這一種用途,現在還多了一個「在 AI 回答裡被引用」的用途,兩者背後是不同的爬蟲在支撐。
分類時應記錄業者、用途與控制方式。Googlebot 也支援 Google Search 的 AI 功能,因此「傳統搜尋」與「AI」不是互斥分類。下表比較 Googlebot、OAI-SearchBot 與 GPTBot 的主要用途。
左右捲動檢視完整表格
| 比較項目 | Googlebot | OAI-SearchBot | GPTBot |
|---|---|---|---|
| 所屬公司 | OpenAI | OpenAI | |
| 主要目的 | 建立搜尋索引 | ChatGPT 搜尋的探索與呈現 | 模型訓練素材 |
| 影響 Google 搜尋 | 是,核心 | 否 | 否 |
| 影響 AI 答案曝光 | 影響 Google 的 AI 搜尋功能(如 AI Overviews) | 是(ChatGPT 搜尋) | 否 |
| 封鎖它的後果 | 妨礙 Google 抓取內容,影響搜尋功能;URL 仍可能由其他訊號被列出 | 退出 ChatGPT 搜尋答案;網址仍可能作為導覽連結出現 | 表達內容不應用於生成式基礎模型訓練的偏好 |
OAI-SearchBot 與 GPTBot 是獨立設定。OpenAI 也說明,若兩者都允許,可能共用一次抓取結果以減少重複請求。封鎖訓練用途不等於退出 ChatGPT 搜尋,但允許搜尋也不保證引用。
不同產品可透過自動搜尋爬蟲或使用者觸發請求取得內容,抓取本身不保證曝光。Google AI Overviews 使用 Google Search 的基礎要求與控制方式,可參考Google AI Overviews 對 SEO 的影響;不要把每家產品的引用都歸成同一套 GEO 機制。
以下列出已對照官方用途文件的常見權杖,並非完整清單。robots.txt 的 user-agent 匹配不分大小寫,路徑則區分;實作時仍宜沿用官方寫法並確認適用主機。
左右捲動檢視完整表格
| 爬蟲 | 權杖 | 所屬公司 | 主要目的 |
|---|---|---|---|
| GPTBot | GPTBot |
OpenAI | 抓取內容供未來模型訓練 |
| OAI-SearchBot | OAI-SearchBot |
OpenAI | ChatGPT 搜尋的探索與呈現 |
| ChatGPT-User | ChatGPT-User |
OpenAI | 使用者動作觸發的頁面存取 |
| ClaudeBot | ClaudeBot |
Anthropic | 抓取內容供未來模型訓練 |
| PerplexityBot | PerplexityBot |
Perplexity | 搜尋探索與索引(官方稱不用於訓練) |
| Google-Extended | Google-Extended |
Gemini 訓練素材與接地控制 | |
| Claude-SearchBot | Claude-SearchBot | Anthropic | 搜尋與結果品質用途,可獨立控制 |
| CCBot | CCBot |
Common Crawl | 建立公開網路資料集(供研究與訓練等) |
| Claude-User | Claude-User | Anthropic | 使用者要求下取得頁面;官方說明可透過 robots.txt 控制 |
| Applebot-Extended | Applebot-Extended | Apple | 控制 Applebot 內容的生成式基礎模型訓練用途,並非所有 AI 答案用途 |
分類不能只分搜尋與訓練,還要看使用者觸發與用途控制。Google-Extended 沒有獨立 HTTP user-agent;Applebot-Extended 控制訓練偏好,Apple 另以 nosnippet 控制特定一般知識 AI 答案的內容用途。各權杖範圍應看各自官方說明。
OpenAI 用 GPTBot 管理模型訓練偏好、OAI-SearchBot 管理搜尋,ChatGPT-User 則服務某些使用者動作。Anthropic 對應有 ClaudeBot、Claude-SearchBot 與 Claude-User;PerplexityBot 用於搜尋,Perplexity-User 用於使用者請求。Google-Extended 則控制指定 Gemini 訓練與接地用途,不影響 Google Search 的收錄與排名。
網站可以依需求分開決定搜尋、訓練及使用者請求的偏好。全部允許或全部限制都可能有合理情境;應先確認希望提供的服務、內容權利與資源限制,再測試設定效果,不替所有網站預設同一選擇。
robots.txt 怎麼控制:封鎖訓練不等於退出 AI 搜尋
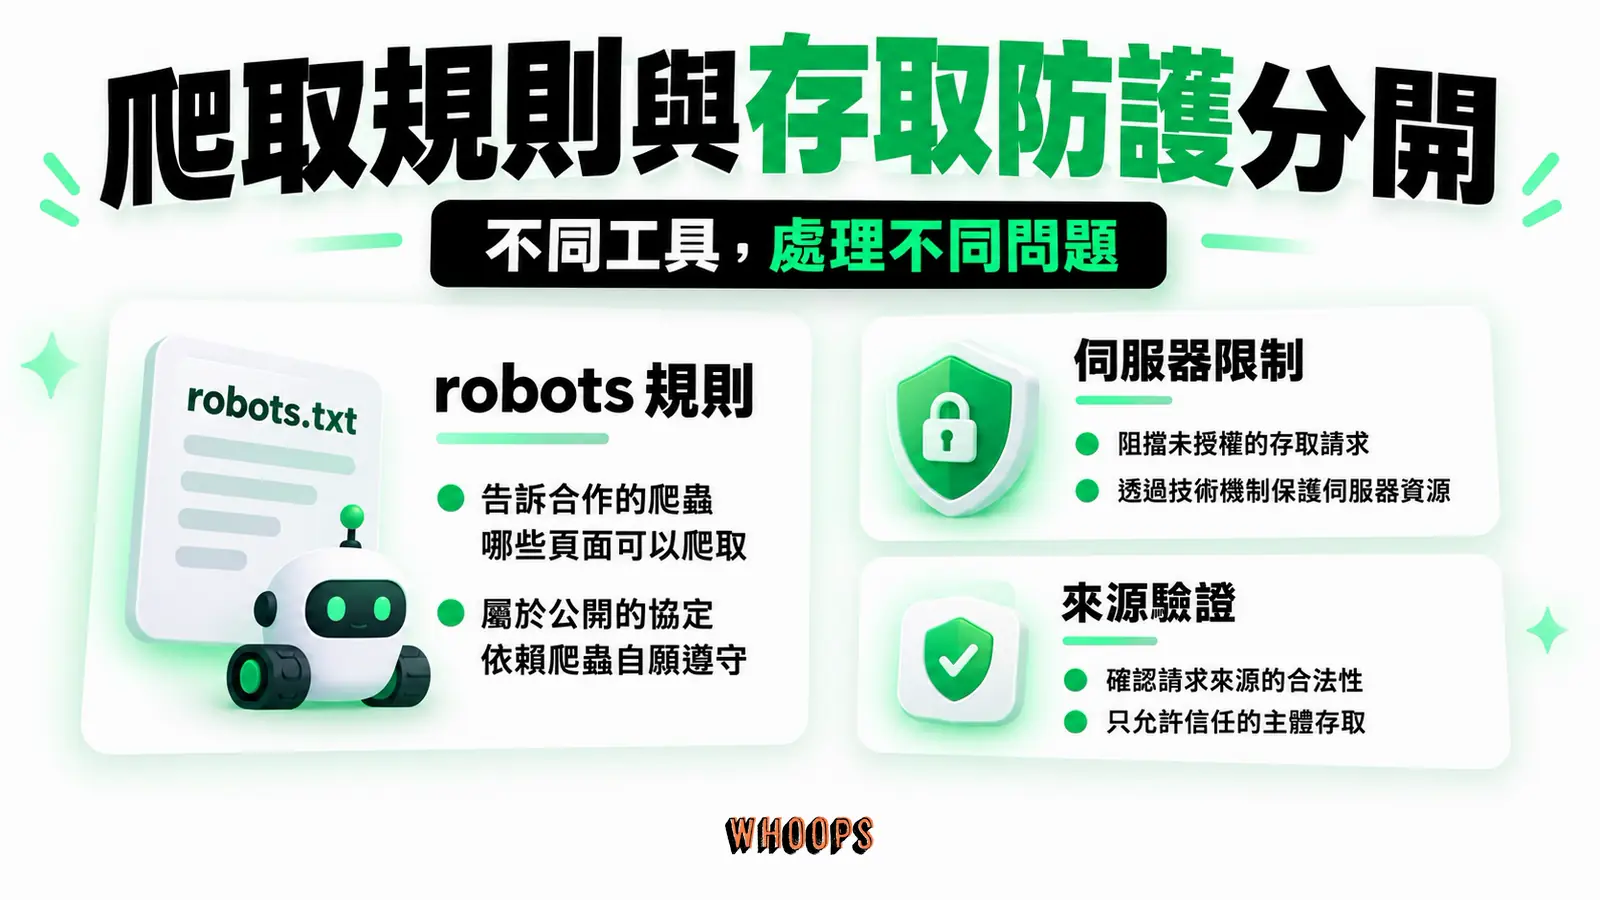
robots.txt 是抓取規則,不是存取安全控制,也不是可靠的移除索引方式。以 Google 為例,選擇最具體的 user-agent 群組;同等匹配群組會合併,與 User-agent: * 不合併。路徑再按最具體匹配判斷。需要防止索引時,須讓 Google 可讀到 noindex;私人資料則使用真正的驗證與授權。詳見robots.txt 介紹及robots.txt 和 noindex 的差別。
先講一個最常被誤解、也最值得記住的事實:Google-Extended 不影響 Google 搜尋的收錄與排名。Google 官方文件寫得很明白,Google-Extended 是一個獨立的產品權杖,讓發布者控制「Google 抓到的內容能不能用來訓練未來的 Gemini 模型」,它管的是 Gemini App 與 Vertex AI 的訓練,以及以 Google 搜尋索引為基礎的接地(grounding)用途。而且它沒有獨立的 HTTP user agent,實際抓取動作是用既有的 Google user agent 做的,robots.txt 裡的 Google-Extended 權杖純粹是控制用途。
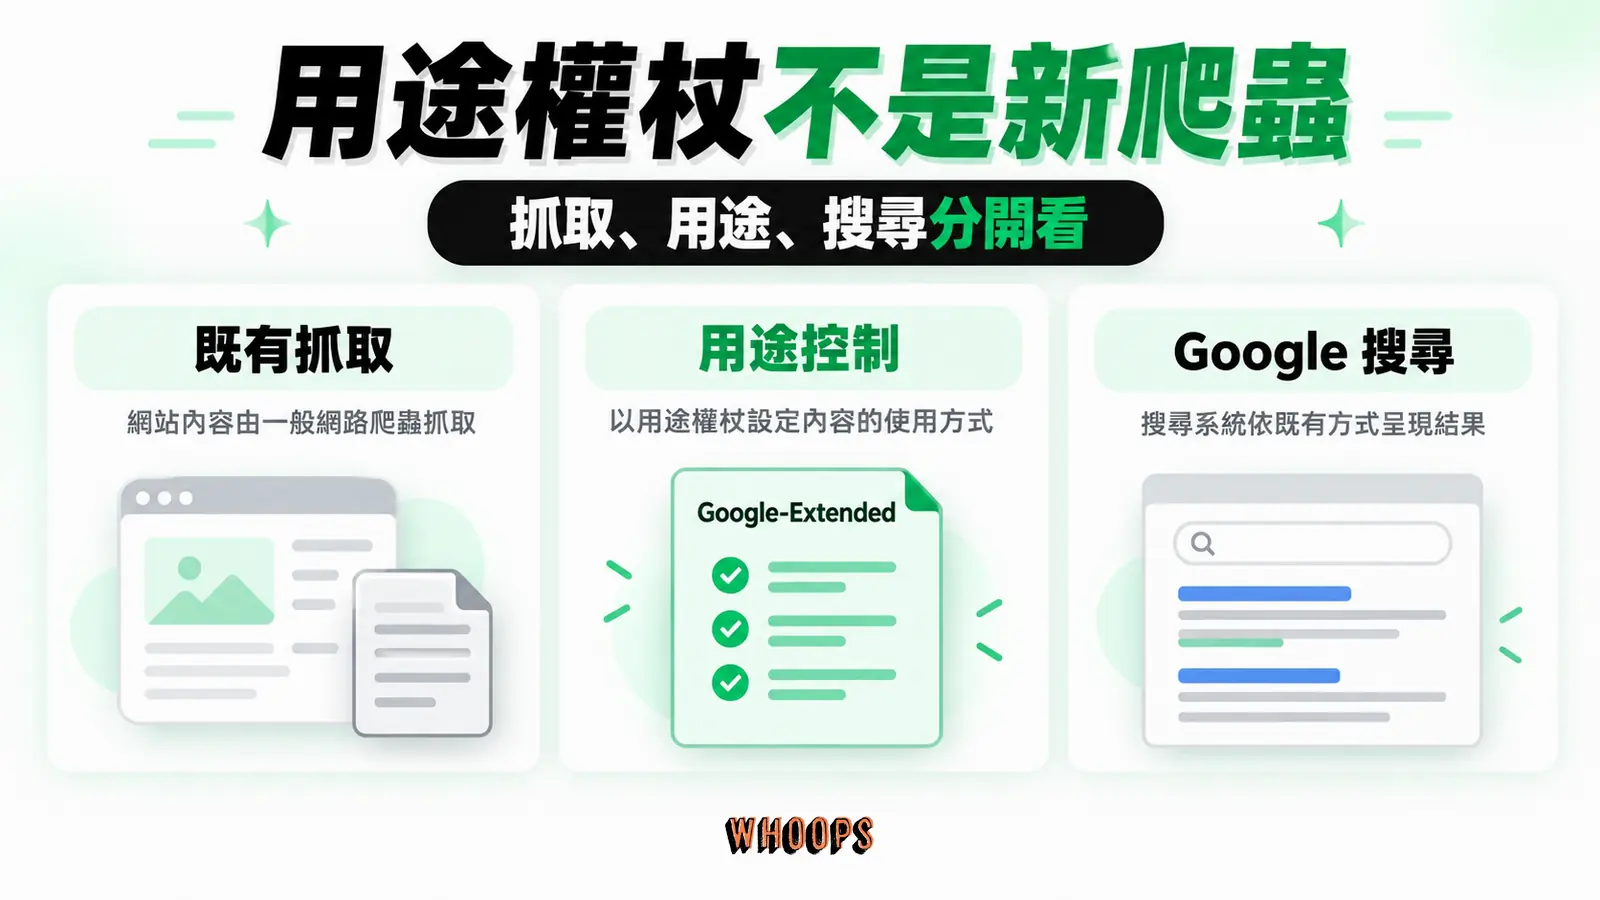
限制 Google-Extended 不影響 Google Search 的收錄資格與排名訊號,但並不保證 Search 一定收錄或排名。它管理的是官方文件列明的未來 Gemini 模型訓練與指定接地用途,不是從已完成模型中移除資料的工具。
可從希望提供的搜尋服務、內容使用偏好與伺服器容量做決策。下表列的是評估方向,不是要求所有網站一律放行。
左右捲動檢視完整表格
| 類別 | 代表爬蟲 | 建議 | 理由 |
|---|---|---|---|
| 搜尋引擎爬蟲 | Googlebot、Bingbot | 希望內容可被搜尋時允許 | 保留抓取入口;私人或不希望公開的內容另設存取控制 |
| AI 搜尋型爬蟲 | OAI-SearchBot、PerplexityBot、Claude-SearchBot | 依搜尋能見度與資源需求決定 | 允許抓取不保證被引用 |
| 訓練與用途控制 | GPTBot、ClaudeBot、Google-Extended、Applebot-Extended | 逐一確認用途後決定 | Google-Extended 包含指定接地用途,不能一概歸為純訓練 |
一個務實的起點配置(示意,實際部署前請用官方權杖清單,並以 Search Console 的 robots.txt 報表與網址檢查工具驗證),概念長這樣:
# Google 搜尋爬蟲:放行
User-agent: Googlebot
Allow: /

# Gemini 訓練素材與接地:不給(不影響 Google 搜尋)
User-agent: Google-Extended
Disallow: /

# OpenAI 模型訓練:不給
User-agent: GPTBot
Disallow: /

# ChatGPT 搜尋:放行(爭取 AI 答案曝光)
User-agent: OAI-SearchBot
Allow: /

User-agent: *
Allow: /
這段只示範分開管理,不能直接取代現有 robots.txt。特定 Googlebot 群組不會繼承通用群組的限制,若原站有不應抓取路徑,必須納入測試與適當規則;使用者觸發存取及未列出的權杖也要另行考量。
要特別小心的是 robots.txt 寫錯的代價很大,而且往往延遲爆發。一條規則歸錯 user-agent 群組、一個 Disallow: / 放錯位置,或規則覆蓋範圍超乎預期,都可能不小心把 Googlebot 一起封掉,傳統搜尋流量會跟著默默下滑(單純的縮排或空白通常不會影響解析,真正危險的是分組與路徑錯誤)。這種問題的麻煩在於它的影響往往延後顯現,你可能過一陣子看數據才發現流量掉了,回頭查才知道是 robots 寫錯。養成一個習慣:上線前先用本地的 robots 解析器或測試工具檢查規則(Search Console 顯示的是已發布的 robots.txt,而且只反映 Googlebot 的視角,無法預檢其他業者的爬蟲),上線後再用 Search Console 確認 Googlebot 能抓重要頁面,並用各家業者公布的 IP 範圍與日誌驗證其他爬蟲。多花這點功夫,能擋掉最致命的那類失誤。
還有一個現實考量常被忽略:封鎖 AI 爬蟲有時候不完全是智財選擇,而是資源選擇。有些 AI 爬蟲抓得又兇又快,一個晚上能對你的伺服器發出成千上萬個請求,吃掉大量頻寬與運算資源,對中小型主機是實實在在的成本負擔。如果你的日誌顯示某個 AI 爬蟲的請求量已經喧賓奪主、卻對你沒有帶來相對應的曝光價值,封掉它就是單純的資源管理,跟要不要被訓練是兩回事。換句話說,robots.txt 的決策不只是「要不要被引用」,還包含「這個爬蟲值不值得我用伺服器資源去招待」,兩個維度可以分開評估。
robots.txt 不是強制存取控制。Google 通用爬蟲自動抓取會遵守;ChatGPT-User 的使用者觸發請求可能不適用,Perplexity-User 官方說明通常忽略,Anthropic 則表示其三類 bot 遵守規則。不要把所有使用者代理套同一政策。真正的安全限制需靠伺服器授權、適當速率控制及 WAF,並驗證來源。
Googlebot 多久來一次?抓取頻率的決定因素
很多人會問:我的網站,Googlebot 到底多久來抓一次?答案沒有固定數字,因為抓取頻率不是 Google 單方面決定的,而是兩股力量拉扯出來的結果。理解這兩股力量,你才知道該從哪裡使力,讓重要的新內容更快被 Google 看到。
第一股是爬取容量上限(crawl capacity limit,又稱 hostload),也就是 Google 願意同時對你的伺服器開多少連線、每秒打多少請求,前提是不能把你壓垮。這跟你的伺服器回應速度直接相關:伺服器回應慢、常 Timeout,Google 會自動放慢以免拖垮你;伺服器又快又穩,才有利於放開手腳多抓(不過提高速度不保證抓取量一定增加,若抓取需求低,Google 仍可能少抓)。所以網站主機的效能、回應時間,不只是使用者體驗問題,也是影響 Googlebot 願不願意常來的技術因素,這部分可併入整體的 技術型 SEO 一起檢視。
第二股是抓取需求(crawl demand),也就是 Google 有多想抓你的頁面。需求高低取決於幾件事:頁面的熱門度與受歡迎程度、特定頁面的重要性、以及內容多常更新(常更新的頁面,Google 比較會提高回訪頻率,怕錯過新版本)。一個長期不更新的頁面,Googlebot 回訪的間隔通常會拉長;相反地,你剛發佈或剛大改的重要頁,如果連結顯眼,比較容易被優先抓到(不過實際頻率沒有保證,熱門度也不等於單純的反向連結數量)。
想讓重要新內容更容易被發現,可從相關導覽與正文連到新頁面、提供 Sitemap,並維持伺服器可用。對少量新頁或重大更新,可使用 Search Console 的網址檢查工具要求重新檢索;Google 明確說明,提交請求不保證立即抓取、索引或出現在搜尋結果,重複要求也不會加快處理。抓取頻率高同樣不代表排名好,仍需分開檢查頁面是否被索引,以及相關查詢的實際曝光。
Googlebot 對 SEO 的實際影響
把前面講的兜起來,Googlebot 對 SEO 的影響可以濃縮成幾個具體的行動方向。核心觀念是:你的工作不是「讓 Googlebot 來」,而是「讓 Googlebot 能順利抓到、而且抓到的內容值得被收錄」。前者是技術面,後者是內容面,兩者都要顧。
第一,提供可發現的入口。從相關導覽與正文連向重要頁面,再提供 Sitemap;連結不是唯一發現方式,也不保證全站必被抓完。內鏈規劃可讀內部連結教學,並用Search Console 網頁索引報表觀察後續狀態。
第二,確保它抓到的內容是完整的。 JavaScript 渲染的站,一定要驗證轉譯後的內容是不是齊全,工具前面提過了。還要記得,不要用 robots.txt 封鎖 Google 理解或轉譯主要內容所需的 CSS 與 JavaScript,Googlebot 需要這些資源才能正確轉譯頁面、判斷版面與互動;至於不影響內容的非關鍵資源,倒是可以視情況控制,兼顧抓取效率。圖片、影片如果希望出現在圖片搜尋、影片搜尋,也要讓對應的 Googlebot-Image、Googlebot-Video 抓得到。
第三,確保它抓到的東西值得收錄。 這已經不是 Googlebot 的事,而是索引系統在看內容品質、原創性、與其他頁面的重複關係(至於跟搜尋意圖契不契合,屬於後續提供搜尋結果階段的事),相關的整體檢視屬於技術型 SEO 的範圍。重複內容、空泛的薄內容、抄襲來的東西,就算 Googlebot 抓回去,也比較可能不被索引、被歸為替代版本,或難以爭取到搜尋曝光。
第四,驗證手機版內容。響應式網站也可能因條件載入、封鎖或資源錯誤缺少內容。檢查文字、連結、圖片及適用的結構化資料,而不是只看是否使用同一份模板。
這裡也要破除一個期待:Googlebot 來得勤,不代表排名會好。抓取頻率高,反映的是 Google 想維持對你站的理解新鮮度,跟排名高低沒有直接等號。老實說,盯著「Googlebot 來幾次」這個數字意義不大,它只是個過程指標;更該盯的是「有多少頁面真的被索引、被排名、拿到曝光」,這些才是結果指標,全部在 Search Console 裡看得到。把注意力放在結果,而不是過程,這是判斷 SEO 健康度時的分界線。
常見誤解一次釐清
左右捲動檢視完整表格
| 常見誤解 | 實際情況 |
|---|---|
| Googlebot 來抓了就一定會被收錄 | 抓取不等於索引,索引系統會再判斷內容值不值得收 |
| 封掉 Google-Extended 會影響 Google 搜尋排名 | 不會,它跟 Google Search 收錄與排名無關(但會放棄 Gemini 訓練與接地用途) |
| 封掉 GPTBot 就等於退出 ChatGPT 搜尋 | 不一定,ChatGPT 搜尋用的是 OAI-SearchBot,兩者是不同爬蟲 |
| 看 user agent 寫著 Googlebot 就一定是 Google | 字串可偽造;使用反向加正向 DNS,或比對適用的官方 IP 範圍驗證來源 |
| 桌面版內容才是排名依據 | 行動優先索引下,Googlebot Smartphone 抓的手機版才是主力 |
| JS 渲染的內容 Googlebot 一定看得到 | 要等轉譯那一波,可能延後被處理,需主動驗證 |
| AI 爬蟲抓得多等於 SEO 變好 | 請求量不代表 Google 排名或 AI 引用;應區分用途並檢查實際搜尋表現 |
| Googlebot 規則只影響一般網頁搜尋 | 也可能影響其他共用權杖的搜尋用途;需一起檢查更具體的群組與實際資源規則 |
結論與行動清單
讓 Google 正常取得主要內容是搜尋處理的基礎,但被 robots.txt 阻擋的 URL 仍可能以其他訊號出現在結果中。應把抓取、索引、訓練偏好與使用者觸發存取分開管理,不用一個「放行 AI」開關概括。
給你三個下週就能執行的下一步:
- 檢查抓取規則與實際回應。以 Google 官方權杖與解析規則核對重要頁面及圖片資源,再用 Search Console 和已驗證日誌檢查。不同業者及圖片、影片用途需另按規則測試,不能只靠一個報表代替全部驗證。
- 看清是誰在抓你的站:從伺服器日誌把爬蟲分類出來,區分 Google 搜尋爬蟲、AI 訓練爬蟲、AI 搜尋爬蟲各佔多少,這是一切後續決策的依據。
- 驗證 JS 渲染內容:挑你流量最大的幾個頁面,用網址檢查工具看 Googlebot 轉譯後實際看到什麼,確認關鍵內容沒有在轉譯那一波缺席。
爬蟲的世界看起來雜,其實規則就那幾條。把它們分對類、管對規則,剩下的就交給內容本身。
常見問題
Googlebot 和 Google-Extended 到底差在哪?
我想被 ChatGPT 引用,但又不想被拿去訓練,辦得到嗎?
怎麼知道哪些爬蟲正在抓我的網站?
我的網站很小,需要管爬取預算嗎?
封鎖 AI 爬蟲會讓我的 Google 搜尋排名變差嗎?
我的頁面一直「已檢索,但未建立索引」,跟 Googlebot 有關嗎?
robots.txt 裡,特定爬蟲規則和通用規則哪個優先?
操作步驟
- 盤點抓取用途區分搜尋、模型訓練、用途控制權杖與使用者觸發請求。
- 驗證請求來源依官方 DNS 或 IP 方法確認來源,不只相信 user-agent。
- 測試規則檢查特定群組、通用群組及重要資源路徑,保留原有必要限制。
- 檢查實際內容用網址檢查與日誌驗證手機版及轉譯後文字、連結與資源,分開追蹤抓取和索引結果。