robots.txt 決策指南:該擋哪些路徑、別擋哪些頁面
robots.txt 管的是爬蟲能抓哪些路徑,不是頁面要不要留在搜尋結果。從規則衝突的裁定順序、修改後的快取時間差,到 noindex 與 canonical 的互動、GPTBot 等 AI 爬蟲的去留判斷,逐一拆解每行設定的後果,收斂出該擋與不能擋的原則。
先擺一個假設場景。某個內容網站的經營者在 Google Search Console 的網頁索引報表裡,看到一排網址掛著「已建立索引,但遭 robots.txt 封鎖」一類的狀態。他記得上個月才把那個目錄寫進 Disallow,預期頁面會慢慢退場;報表卻告訴他,這些網址不但還在索引裡,狀態還特別標註了封鎖的存在。他盯著那行字,第一個念頭是檔案寫壞了。
檔案多半沒有壞。robots.txt 擋的是抓取,不是索引;封鎖生效之後,網址仍可能留在結果頁,這常是機制照規則運作的結果,並非設定失效。爬蟲不再進入頁面,Google 讀不到內容與標記,對這個網址能用的資訊有限,於是常以僅剩網址的條目呈現,標題與摘要未必照舊保留。
快速重點:robots.txt 決定爬蟲能不能抓某個路徑,不直接決定網址要不要留在搜尋結果;被封鎖的網址仍可能出現在結果頁。讓頁面退場交給 noindex,重複網址合併交給 canonical,資料防護交給登入驗證。每次要寫下封鎖之前,先確認那條路徑上沒有等著被讀的訊號、沒有渲染需要的資源。
誤解從哪裡來:把抓取和索引當成同一件事
報表那個狀態,拆開來看是兩件事同時為真:封鎖生效了,爬蟲確實不再進入那個目錄;網址也還在索引裡,因為外部連結與先前的收錄讓它留在那裡。Google 必須能抓取頁面,才能讀到目前的內容與頁面標記;即使無法抓取,仍可能依外部連結等來源把網址列入索引。手上的資訊有限,結果頁上仍可能出現僅剩網址、缺少標題與摘要的條目。
流程順序看清楚,兩個開關的位置就明白了。Google 取得一個網址之後,先向網域請求 /robots.txt,判斷這個網址能不能抓;可以抓,才下載頁面、解析內容與各種標記,走到索引評估。爬取排在索引之前,但控制抓取的開關在這份檔案,控制收錄的判斷在頁面與外部訊號上,兩者各自獨立。整套流程的細節,Google 在搜尋運作方式的官方說明裡有完整交代,Googlebot 的身分與工作方式則補足執行者這一側的背景。
誤解有其來路。這個檔案在許多內容系統與主機後台都找得到,名稱又帶著「控制機器人」的暗示,把「不要被抓」與「不要被收錄」混著講的教學也確實存在。於是不少人第一次接觸它,就帶著總開關的期待:以為一行規則能同時下架頁面、保護資料、節流爬蟲。期待錯了,後面每個判斷都會跟著歪。
兩種控制對應兩種不同的問題。問「要不要讓 Google 收錄這一頁」,答案寫在頁面上,靠 meta 標記與 HTTP 回應傳達;問「要不要讓爬蟲走進這條路徑」,答案才寫在 robots.txt。把門口的檔案拿去回答頁面層的問題,規則寫得再多,讀不到就是沒有。
驗證兩種控制用的證據也不同。收錄狀態看報表:網頁索引報表會標出某個網址在不在索引、被歸在哪種狀態;抓取狀態看檔案與紀錄:robots.txt 的實際內容、伺服器紀錄裡爬蟲的請求頻率,比任何印象都可靠。把兩種證據放上同一張桌面對照,多數誤會會自己解開,剩下的才是真正需要動規則的問題。
官方對這個檔案的定位講得直接:robots.txt 限制的是爬取,不保證被封鎖的網址一定不出現在搜尋結果裡(見 Google 搜尋中心的 robots.txt 簡介)。「封了卻還在」不一定是故障,比較可能是抓取控制與索引判斷本來就分屬兩套機制;排查時仍要確認實際狀態,別急著下結論。想分辨「別來抓」與「別收錄」兩種指令的界線,robots.txt 與 noindex 的分工對照有專文拆解。
之後每一節都會用到同一組檢查:這條路徑上有沒有訊號需要被讀到?是不是渲染需要的資源?兩個問題都過,封鎖才會成為候選選項;成為候選之後,還要依路徑用途與抓取需求逐一決定。
改了為什麼不生效:快取與重新抓取的時間差
修改 robots.txt 不會立即生效,排錯時要先接受這件事。Googlebot 拜訪網域會最先索取 /robots.txt,看完規則才決定哪些網址可以進;抓到的檔案通常快取最多約 24 小時,回應標頭與重新取得的成敗會影響實際長短,不能保證一天內換上新版本(依 Google 的 robots.txt 建立說明)。
所以排查從蒐證開始,一次抓齊三項:伺服器上實際放著的版本(瀏覽器直開網域的 /robots.txt)、Google 手上的版本(Search Console 的 robots.txt 報表,可以請求重新抓取,但不保證立即完成)、個別網址的檢索狀態。三項對齊了,再回頭評估規則本身寫了什麼;急著反覆測試,看到的多半還是舊規則,誤判成改錯了再疊上更多修改,只會讓問題更難查。報表能查到 Google 最近一次抓取的版本與過去約 30 天的歷史紀錄(見 GSC 的 robots.txt 報表說明)。
檔案取不到時,Google 的行為依 HTTP 回應狀態分成幾種劇本,方向並不相同:
左右捲動檢視完整表格
| 伺服器回應 | Google 的對應行為 |
|---|---|
| 200 正常回應 | 解析檔案內容,依規則行事 |
| 404 找不到 | 視同沒有任何規則,整站開放抓取;這不是錯誤狀態,許多小站從未有這份檔案也運作正常 |
| 5xx 或連線失敗 | 起初約 12 小時暫停抓取並重試;持續失敗時,最多約 30 天沿用最近一次成功取得的版本,連版本都沒有就假設沒有抓取限制;再持續下去,依網站整體可用性決定行為 |
兩種「取不到」的方向相反:404 走向全站開放,5xx 走向暫停與沿用舊版(依 Google 的 robots.txt 規格)。改版當天主機不穩、防火牆把請求擋下來,常落在後面那一格,讓 Google 在你不知情時改變抓取行為;檔案被搬離根目錄則看伺服器怎麼回應,可能回 404,也可能直接取不到,落在哪一格由實際的回應狀態決定,不由事發的原因推測。這也是為什麼排查的第一步是確認檔案的回應狀態。養成改版前後各看一次報表的習慣,這類無聲故障的窗口期會縮短。
範圍的邊界順手記下:規則的效力以通訊協定、主機與埠為單位,子網域各自一份檔案,主站寫的封鎖管不到購物車子網域,http 與 https 也各自比對。多語站的語系若分屬不同子網域,任何一個版本的路徑寫錯,影響範圍就只在那一個主機之內。
檔尾補一行 Sitemap: 加上完整網址,是把整理好的網址清單位置告訴爬蟲,協助發現;沒有這行,提交過或被其他頁面提及的 Sitemap 仍然找得到。對剛上線或剛搬家的站,這行的設定成本特別低。格式與提交的觀念讀XML Sitemap 的完整介紹,官方對 Sitemap 指令的說明見 Google 的 Sitemap 文件。
地雷都藏在冒號後面:空白、斜線與萬用字元
最常讓規則整組反轉的,是 Disallow 冒號後面那個位置。冒號後留空的 Disallow: 會被直接忽略,這一行既不封鎖任何路徑,也不會連帶解除同一群組裡的其他規則;只有當群組裡就這麼一條規則時,結果才是不設任何限制。補上斜線寫成 Disallow: /,則是從根目錄起的全站封鎖,但同一群組裡若還有路徑更具體的 Allow 規則,例外仍會被開出來。一個字元的差別,就足以讓一個規則單純的群組在全開與全關之間擺盪,而且兩種都是合法語法,伺服器不會替你擋下任何一種。
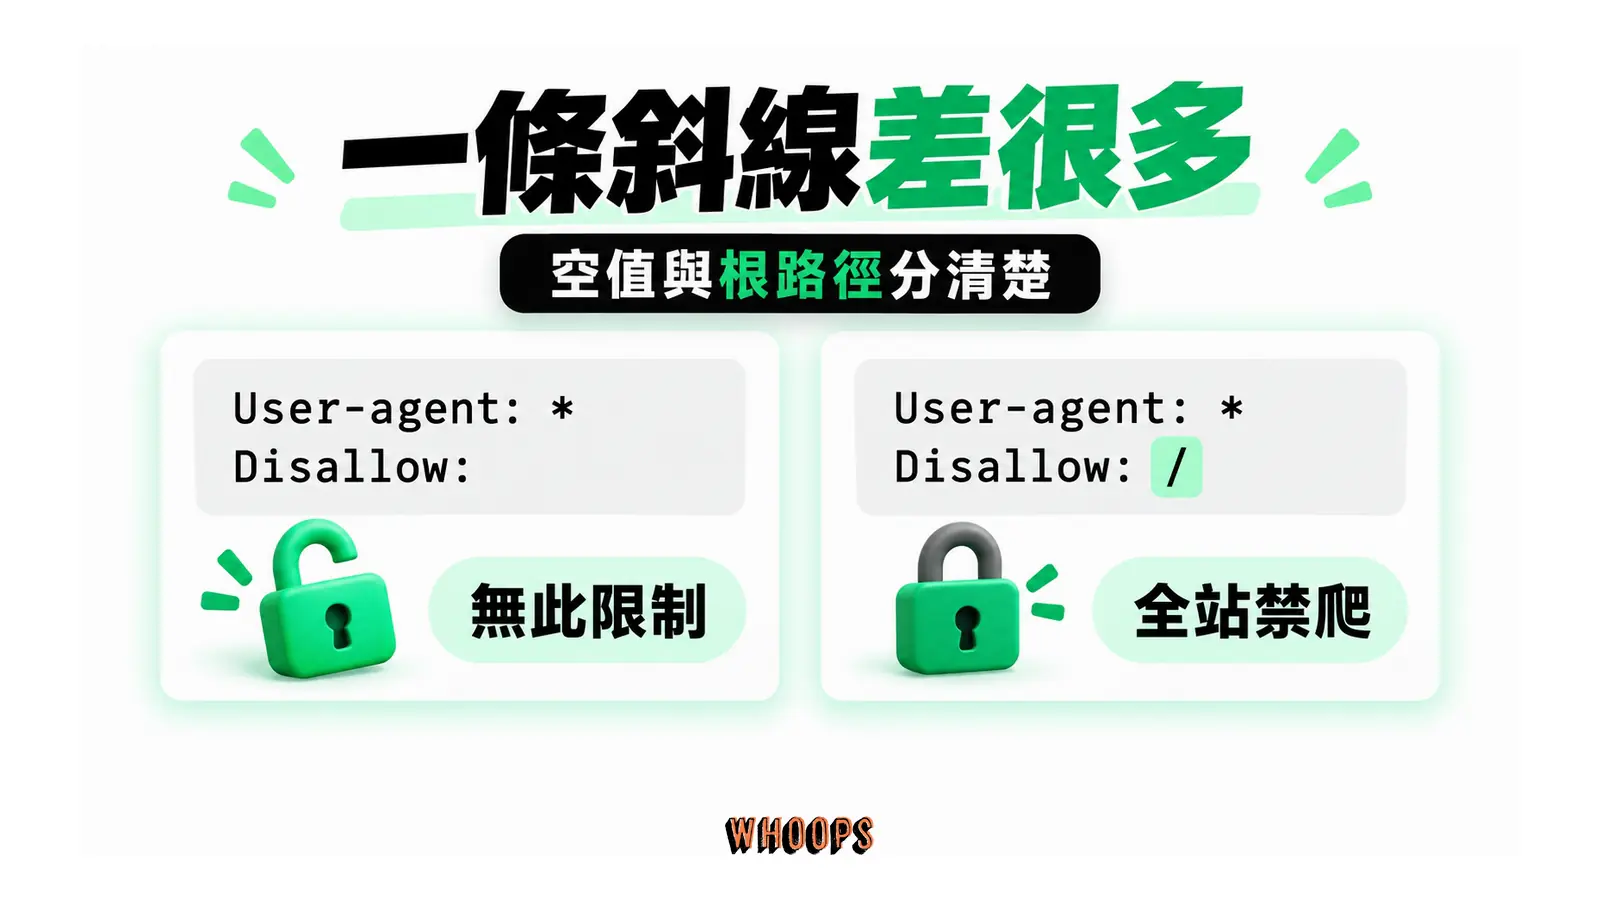
驗證別靠肉眼,拿實際網址測。挑站上一個正常網址,分別對照 Disallow:(冒號後空白)與 Disallow: / 兩種寫法各自放行或攔下它;再挑一條後台路徑重複同樣的動作。上線前把每行冒號後面的內容念出來檢查,搭配這種抽測,是成本最低的防呆。
需要更精準的封鎖就靠兩個萬用字元:* 代表任意字串,$ 代表網址結尾。以收掉排序參數網址為例,/*?sort= 只攔「sort 排在第一個參數」的網址,參數一換位,像 color 在前、sort 在後的網址就不會中;要涵蓋後位的排列,得加上 /*&sort= 兩條並列,再拿幾個實際網址逐一測試,確認攔到的範圍跟你想的一致。別用 /**sort= 這類寫法求省事,它連 resort= 這種字串都會一併命中。$ 負責收尾:以 /*.pdf$ 為例,只攔以 pdf 結尾的網址,不會誤傷路徑中間剛好出現同樣字樣的頁面;驗證方式同樣樸素,拿一個結尾是 .pdf、一個中間含 .pdf 的網址各測一次(依 Google 的 robots.txt 規格)。大型網站用這類規則管理爬取量、把低價值網址擋在抓取佇列之外,優先順序怎麼排,爬取預算的管理方法有完整討論。
內容系統的既有配法可以當起點,逐行驗證之後才採用,照單全收必出事。WordPress 環境常見兩條:/?s= 擋站內搜尋結果、/wp-admin/ 擋後台並視前端功能用 Allow 開回個別處理程式。前者成立的前提是搜尋頁確實沒有收錄價值;後者要看主題與外掛實際用到哪些路徑。同類的評論分頁與標籤聚合網址,該不該封同樣要逐一判斷,別為了求心安一律封掉。指令裡的老面孔 Crawl-delay 別再花心思:Google 不理會它,抓取節奏由 Google 自行決定。
路徑比對分大小寫,規則與網址的字母要完全一致。媒體庫裡相機直接輸出的檔名常是大寫開頭(IMG_20260101.JPG 一類),若規則只寫了小寫的 .jpg$,這些網址就攔不到也放不對;驗證的方法是把大寫檔名的網址實際丟進測試,看結果是否符合預期。網址結構調整之後的另一個斷點,是封鎖規則還停在舊路徑、對新結構毫無作用,這種失效安靜,通常要從檢索統計的異常慢慢察覺。
還有一件小事放在心裡:這份檔案是公開的,任何人都讀得到,路徑寫進去等於公告它的位置。
規則打架時,裁定權在誰手上?
同一份檔案裡,通用群組與指名群組、封鎖與放行互相拉扯是日常。Google 處理這種拉扯有一套明文規範,與排版先後無關:誰寫在愈上面不代表誰說了算,由上而下逐行比對、第一條符合就定案的閱讀習慣,在這裡不適用。
裁定分成三道關卡。第一道認名稱:與造訪者名稱對得上的群組裡,取最具體的那一組辦事;對該爬蟲同樣具體的群組若有好幾組,規則會全部併在一起生效,而 User-agent: * 這類通用群組始終站在外圍,不會被併進任何指名群組。第二道比路徑:把該群組裡所有套得上的規則排開來比,路徑較長、指得較精確的規則勝出。第三道解僵局:allow 與 disallow 對同一個網址的精確度相同時,採限制較少的那一條,結果傾向讓頁面被讀到。
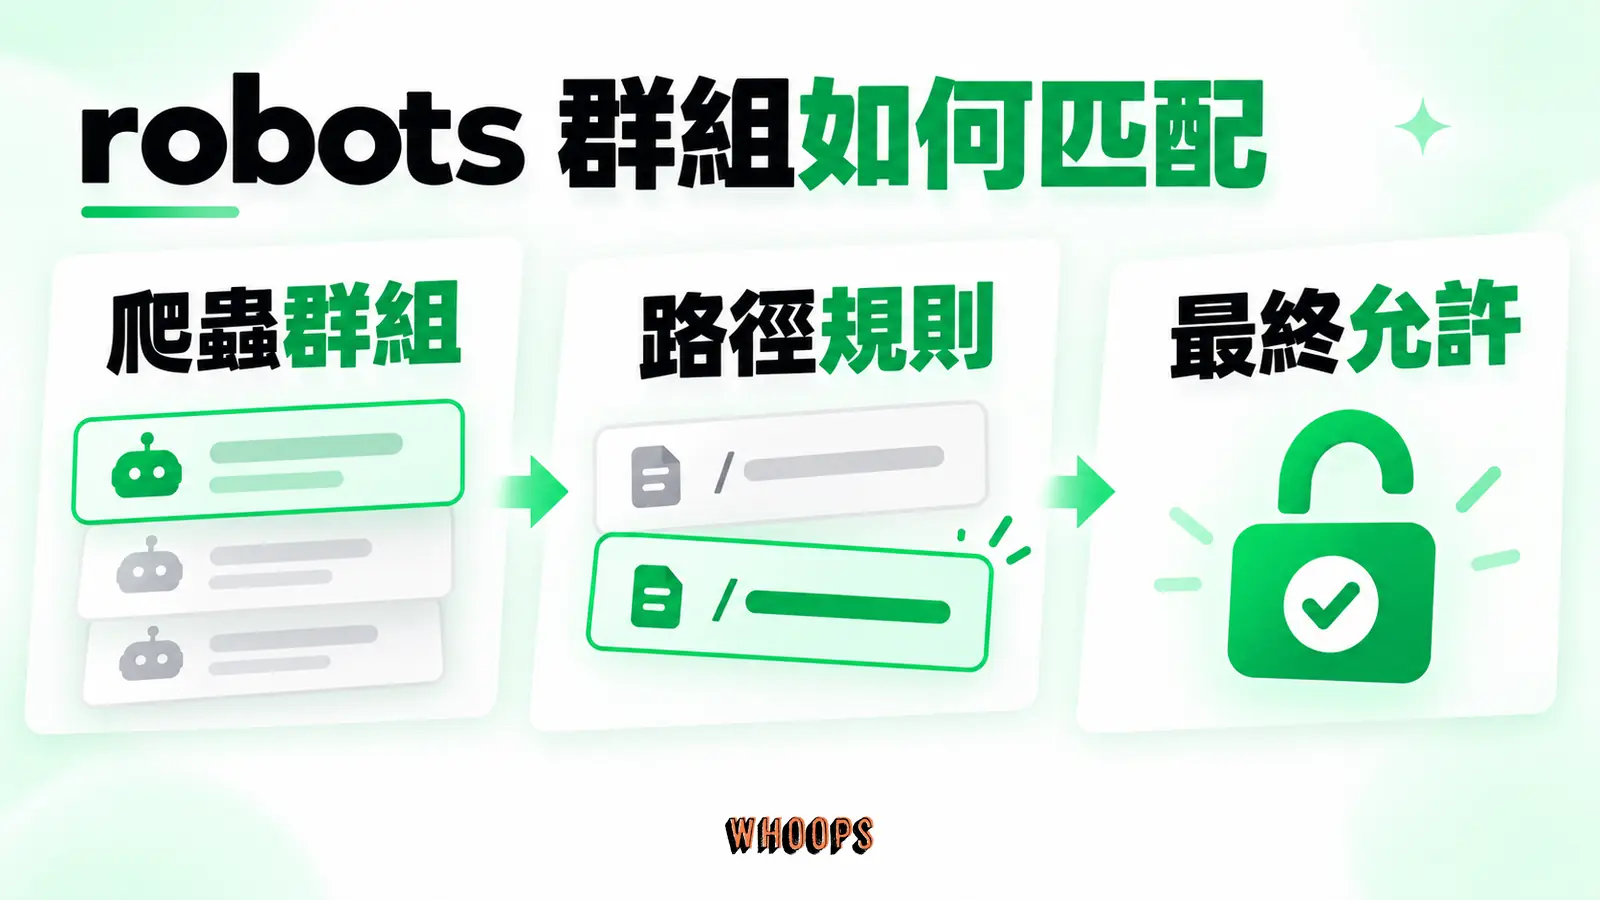
同名群組的合併最容易踩坑。檔案裡先後寫了兩個 User-agent: Googlebot 開頭的群組,一個封 /files/,另一個封 /stats/,讀起來像兩段各管各的,實際上兩組會併成一組,兩條封鎖同時生效;語法上沒有「後段覆蓋前段」的機制,群組之間的空行與註解也不會切割效力。整理檔案時,寧可手動併成一個群組再逐行檢查,也不要讓兩段同名群組各自漂流。
完全相同路徑的平手則是另一種陷阱。同一個群組裡寫了 Disallow: /files/,又寫了 Allow: /files/,兩條精確度相同,裁定採限制較少的那條,整個目錄被放行;「後寫的覆蓋先寫的」這條直覺,協定裡不存在。要開例外,就把路徑寫得比封鎖更精確,例如 Allow: /files/public/ 對上 Disallow: /files/,前者路徑較長,勝出。
同一套機制埋著反直覺的後果:某隻爬蟲一旦在檔案裡有自己的群組,通用群組寫的任何規則對它都不存在。你以為 User-agent: * 擋了全站,對被指名的訪客可能一行約束力都沒有;自以為全站生效的規則,實際上漏了一大塊。哪些規則真的說了算,肉眼逐行猜既慢又不可靠,這也是後面驗證章節存在的原因。
整理檔案有個樸素的原則:一個群組處理一種訪客,一條規則表達一個意圖;群組之間的界線靠註解與空行維持,讀的人卻常常把註解當成效力邊界,誤會就從這裡生。看完一段群組仍說不清它對誰生效、擋了什麼,通常就表示該重寫這一段了。
頁面上的訊號,爬蟲讀不到就不存在
noindex、canonical 這些指令要發揮作用,有共同的操作前提:頁面保持可抓取,讓 Google 讀得到標記。驗收也單純:抽幾個套用指令的網址,用爬蟲模擬進去,確認標記真的讀得到;這一步沒過,指令形同虛設。
寫封鎖之前,把兩個問題依序問過。第一問:這條路徑上有沒有訊號需要被讀到?noindex 等著被讀、canonical 等著被合併、hreflang 等著互相指認、301 等著被追蹤,任何一個成立,封鎖就會妨礙它。第二問:它是不是渲染需要的資源?樣式與腳本被擋,頁面的呈現會跟著變形。兩問都過,封鎖才成為候選;候選不等於結論,還要依路徑用途與抓取需求決定。
套幾個例子走一遍。商品列表頁帶排序參數的變體網址:頁面上沒有 noindex 要送、沒有 canonical 要傳,也不影響渲染,兩問都過,封鎖進入候選,再看這類網址的量體與抓取需求決定要不要擋。等著下架的舊目錄:頁面掛了 noindex 等著被讀,第一問就停住了,這條路徑必須保持可抓取,封鎖連候選都不是。搬家中的舊網址回應 301:轉向本身就是訊號,封鎖等於把搬遷的路切斷。同一份檔案裡,三種路徑得到三種答案,差別只在訊號長在哪裡。
訊號清單比想像長。noindex 是下架訊號,canonical 是合併訊號,hreflang 是版本對應訊號,結構化資料是類型宣告訊號,301 是搬家告知,連頁面標題與內容本身都是評估原料。它們大多掛在頁面上,需要先被下載(301 是伺服器回應,同樣得爬蟲上門才收得到)。從這個角度看,每一行封鎖都建立在「這條路徑上沒有值得讀的東西」的假設上;假設錯了,代價是該送進 Google 的訊號從此送不進去、也更新不了。
noindex 的分工
讓已收錄頁面退場,noindex 是主要工具之一,前提是解除封鎖、讓標記被讀到。Google 重新抓取並處理之後,結果頁才會更新,時間不固定;採用 noindex 的頁面,應該持續保持可抓取;退場之後又收回封鎖,等於把訊號再度切斷。對照另一條路:頁面被 Disallow 擋在門外,標記讀不到,網址就可能以舊面貌留在索引裡。noindex 的運作細節,見noindex 完整介紹。
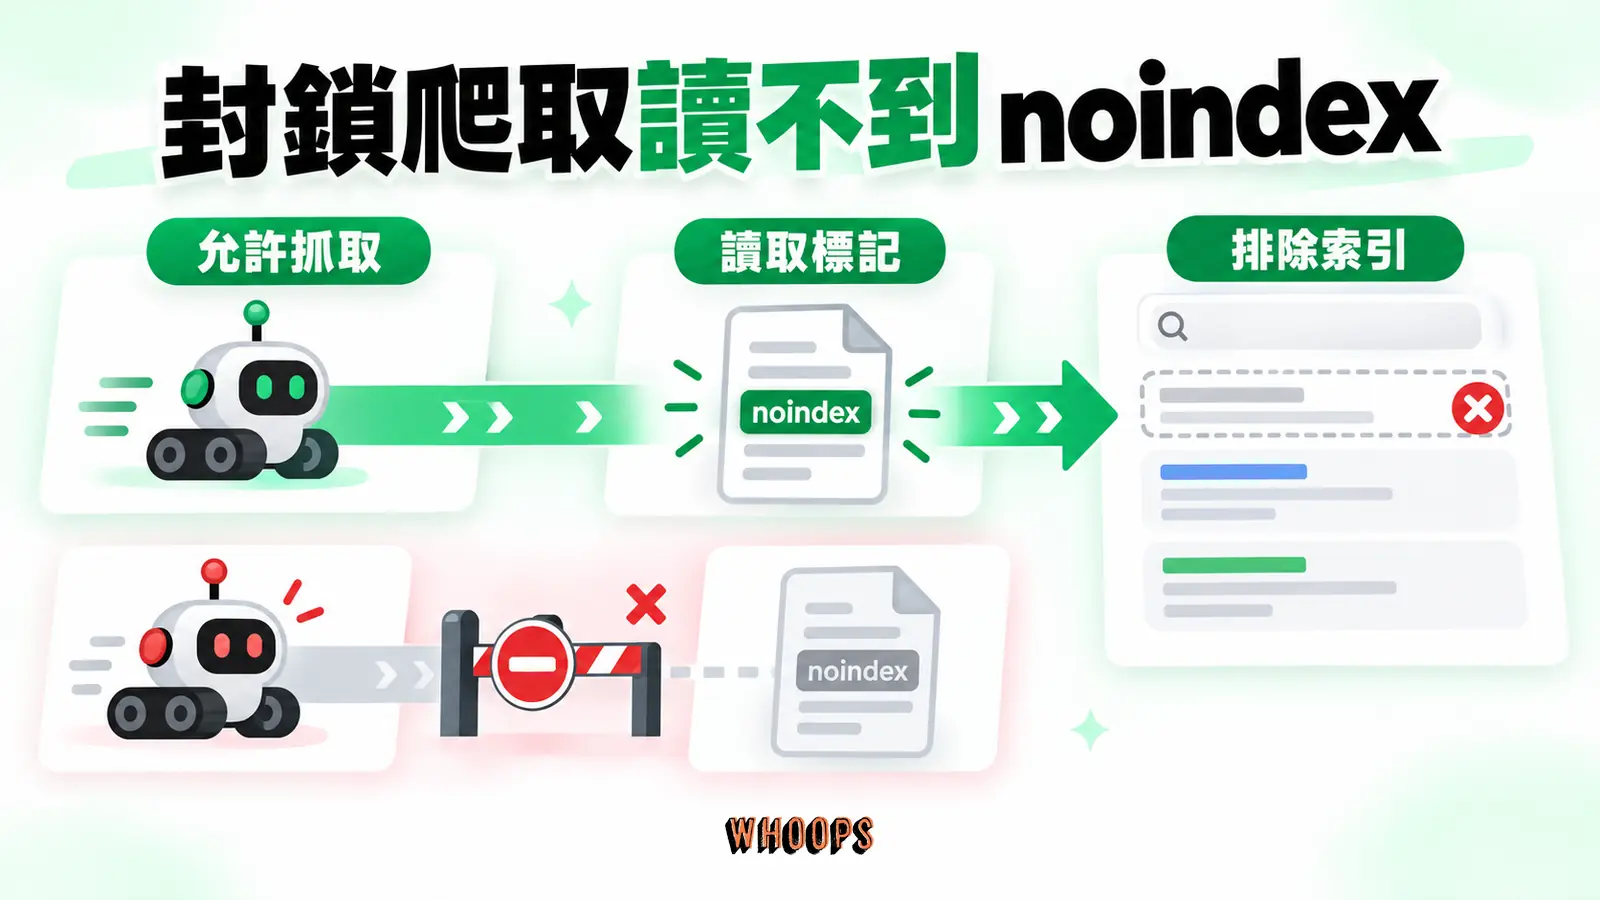
退場手段不只一種,前提各不相同。noindex 需要可抓取;直接刪除內容、或把整段搬進需要登入的區域,控制在伺服器那一層,不依賴爬蟲讀到標記;Search Console 的暫時移除是急件時的緩衝,效期有限,不能當治本。各路線的適用與限制,noindex 以外的移除方法有整理。被封鎖的舊頁只要外部連結還在,僅剩網址的條目就可能一直留著;它不太吃爬取量,卻占著結果版面,呈現方式也不由你決定。
canonical 與重複內容
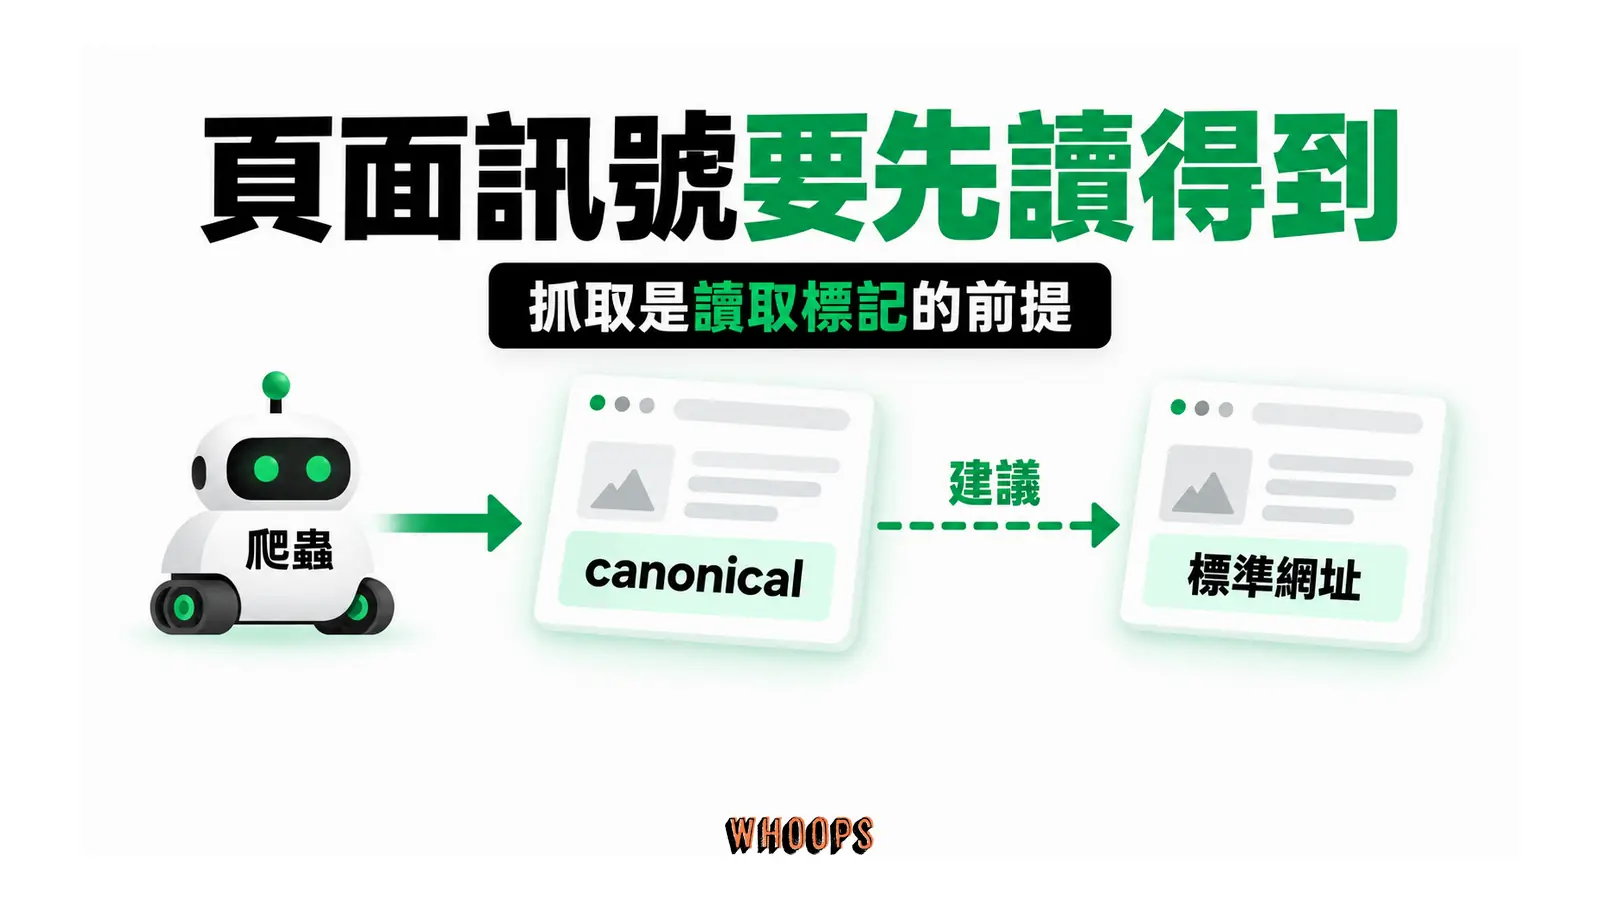
canonical 的實作位置不止一種:HTML 的 link 標記、HTTP 回應標頭、Sitemap 裡的標註,都是向 Google 提供標準網址線索的管道;它們的共通性質是建議,最終判斷在 Google。前提同樣是讀得到:以頁面標記實作的重複網址若被封鎖,Google 沒機會讀到它指向標準版的宣告,合併失去主要依據,重複問題往往原地不動。原則很具體:要送出 canonical 線索的網址,不要出現在封鎖規則裡。機制細節讀canonical 標籤的運作原理,重複內容的整體處理框架見重複內容處理指南。
hreflang 適用同一條原則,但多一層分辨:它可以用頁面標記、HTTP 標頭或 Sitemap 實作;以頁面標記實作的版本,頁面被封鎖就讀不到該版本的對應宣告,可能影響語言版本的辨識與呈現;整組對應關係,也未必因為單一封鎖就消失。結構化資料長在頁面上,同樣以抓取為前提。判斷回到那兩個問題:路徑上有訊號等著被讀,封鎖就不是優先選項;多語系設定的完整框架,由多語系 SEO 與 hreflang 指南獨立成篇拆解。
渲染時代,樣式與腳本擋不得
把 CSS 與 JavaScript 整批 Disallow,代價是 Google 只能看到少了樣式與互動的頁面,對內容與體驗的理解跟著打折,可能連帶壓低頁面被正確評估的條件。
這個習慣有它的年代背景。早年頻寬與流量寶貴,教學範本常建議把 /wp-includes/ 或 *.css、*.js 整批封鎖,理由是這些檔案不會出現在搜尋結果裡。這個算盤在純文字檢索的年代勉強成立,在渲染導向的索引架構下失效:Google 需要像瀏覽器一樣載入並執行頁面,才能判斷版面配置、互動狀態與實際呈現的內容,而渲染需要讀到樣式與腳本。Google 於 2023 年 10 月公告行動優先索引全面完成,檢索器評估的就是行動版頁面。
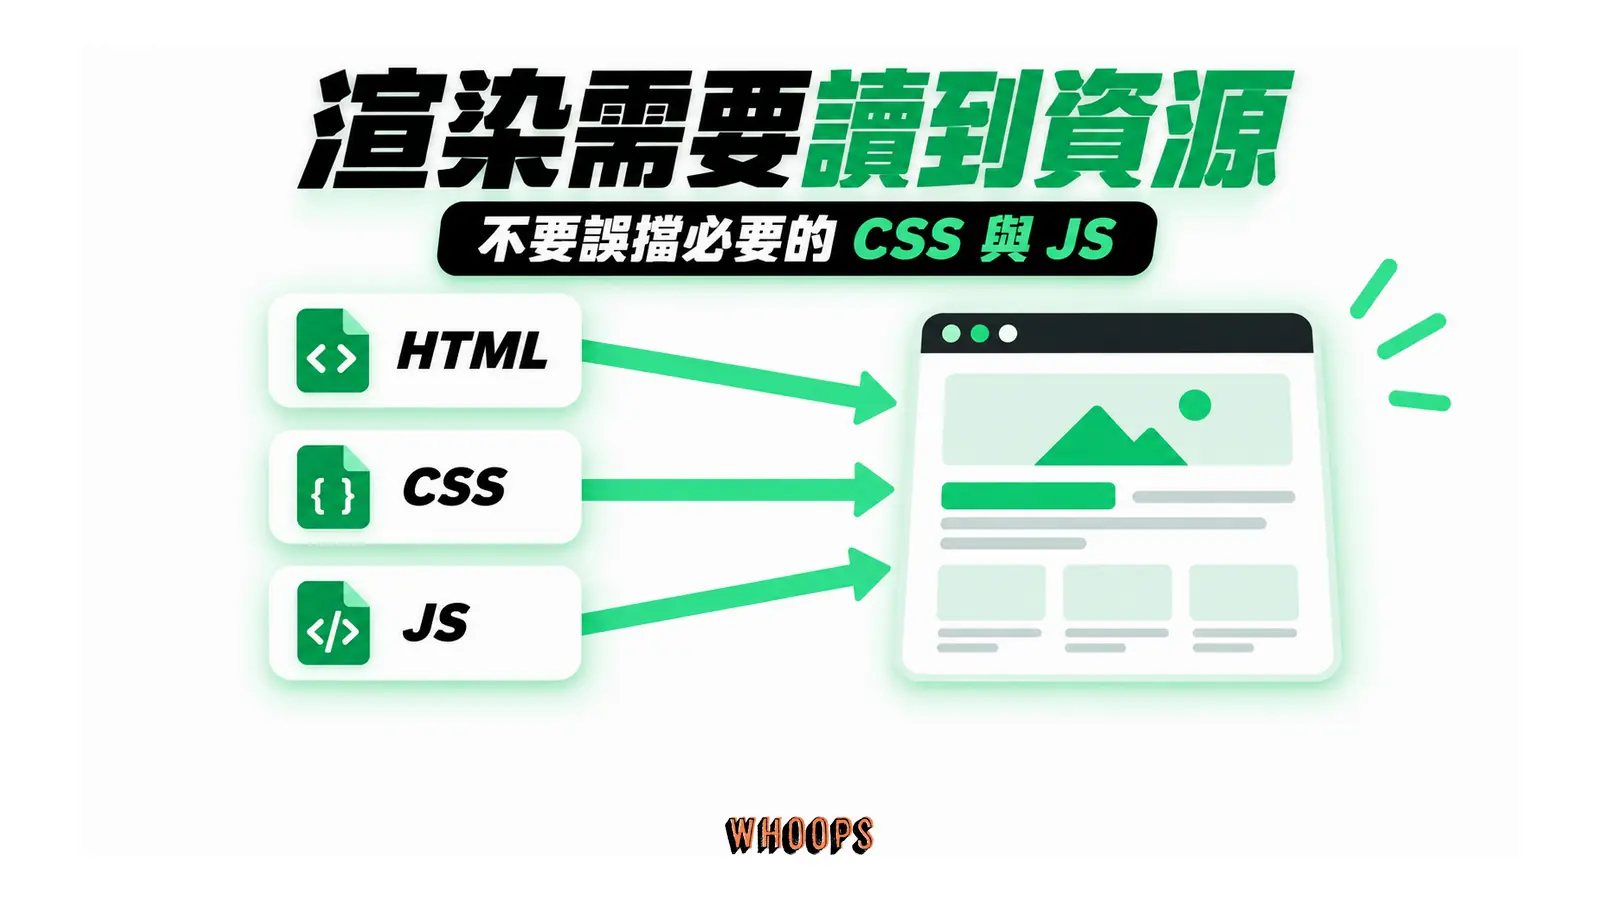
自查的方法很具體。挑一個靠腳本呈現內容的頁面,例如商品價格與圖庫由 JavaScript 載入的產品頁,比較 Google 實際讀到的內容與原始碼的差距,再回頭核對 robots.txt 是否封鎖了資源所在的路徑。常見誤傷點:/wp-includes/、佈景主題與外掛的資料夾、共用腳本的 CDN 路徑。連帶影響比想像廣:靠腳本載入的內容讀不到,靠腳本注入的結構化資料同樣讀不到,豐富結果的資格會跟著出問題;這兩條線索在JavaScript SEO 的處理原則與結構化資料的運用指南有展開。處方一句話:影響內容理解與渲染呈現的 CSS、JS 與圖片留在允許側,確定與呈現無關的靜態資源,才談得上封鎖。檢查的頻率不用高,改版與環境調整之後各排一輪即可;要特別留意的是沿用多年的範本,封鎖清單可能是某段教學的原樣複製,從來沒有人逐行讀過它。
機密頁面的防線,從登出狀態測起
判斷一段內容有沒有被保護,標準只有一個:未登入、未授權的請求,拿不拿得到內容。驗證方法樸素:開無痕視窗、不帶任何 cookie 直接請求那個網址,拿得到,就是不設防,跟 robots.txt 寫了什麼無關。這一步測的是事實,不是感覺,結論比任何推論都可靠。
防線的名單也明確:登入驗證、伺服器層的權限控制、需要授權才能呼叫的範圍。這些機制的驗收標準是未授權者連不上,搜尋引擎列不列出只是次要現象。robots.txt 不在這份名單裡:它影響的是搜尋引擎爬蟲的行為,不是存取權限;會照公告行事的爬蟲受它約束,抄內容、蒐集資料的程式不受。頁面要退場交給 noindex,資料要設防交給驗證,兩件事都不從這份檔案開始。
AI 爬蟲要不要擋?先把三種用途分開
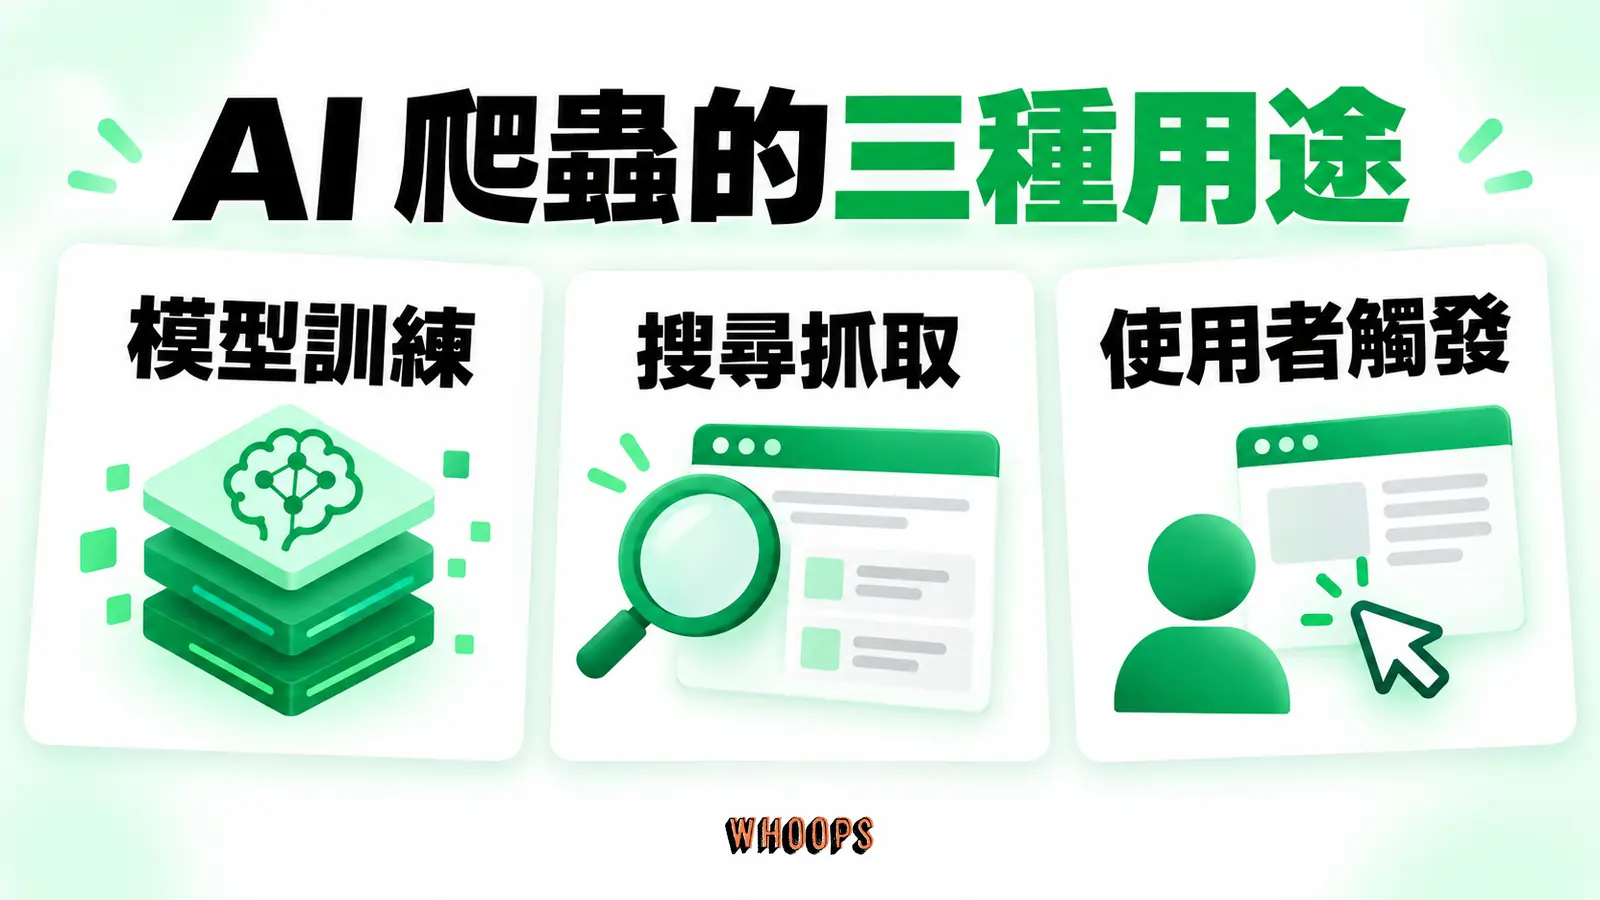
GPTBot、OAI-SearchBot、Google-Extended 這批名稱出現在討論裡時,常被當成同一個問題處理。把它們拆回用途再看,決策會具體得多:訓練採集、搜尋引用、使用者動作觸發,三種行為對內容的意義不同,該擋哪個、擋了會失去什麼,各自獨立判斷。
用途分成三桶。第一桶是訓練採集:GPTBot 抓公開網頁供模型訓練,Common Crawl 的 CCBot 建立公開資料集,內容會間接成為許多模型的原料。第二桶是搜尋引用:OAI-SearchBot 與 PerplexityBot 是搜尋服務的檢索爬蟲,為了讓 AI 答案能引用來源而在背景抓取頁面。第三桶是使用者觸發:ChatGPT-User 代表使用者主動要求讀某個連結時的抓取,行為最接近真人點開網址。三桶分開決定,才不會在擋掉其中一桶時,誤傷了原本想保留的用途。
同一家公司把幾種目的拆成不同名稱,就是為了讓站長分開決定。OpenAI 在GPTBot 的官方說明文件裡,將訓練用與搜尋用的抓取分別命名,規則寫在不同群組,彼此不干涉。兩個前提先記住:封鎖 GPTBot 管的是之後的抓取與使用,已經被抓走、已經進過訓練資料的內容,不在這行規則的追溯範圍;ChatGPT-User 這類使用者主動觸發的請求,官方文件對它如何套用 robots.txt 的說明有所保留,別假設一行封鎖就涵蓋所有 ChatGPT 相關流量。不要內容進訓練資料、卻想保留 AI 搜尋裡的引用機會,這種組合完全做得到。
Google 陣營也有對應的拆分,最常被誤解的是 Google-Extended。它嚴格說來並非真的爬蟲,本質是透過 robots.txt 指定的產品代號:沒有對應的 HTTP User-Agent,卻能讓你單獨控制 Gemini 相關的模型訓練與 grounding 資料用量,不是 Google 搜尋索引的開關;封鎖它,傳統搜尋的收錄與呈現不受影響(見 Google 的檢索器說明)。因為「怕影響排名」而猶豫要不要擋 Google-Extended,前提本身就不成立;該問的是內容要不要參與生成式答案的素材;搜尋表現的那層擔心,前提已經錯置。
決策整理成表格逐列判斷,比先套一套商業模型分類再對號入座更不容易出錯:
左右捲動檢視完整表格
| 用途 | 代表名稱 | 封鎖後的得失 | 怎麼確認效果 |
|---|---|---|---|
| 模型訓練 | GPTBot、CCBot | 對遵循規則的服務,後續抓取與訓練用途被關閉;其他取得管道不在管轄範圍,既有資料不追溯 | 伺服器日誌看該名稱的請求是否停止 |
| AI 搜尋引用 | OAI-SearchBot、PerplexityBot | 失去在對應 AI 搜尋答案中被引用的機會,仍可能以連結形式出現;實際曝光影響視數據而定 | 日誌比對封鎖前後的流量變化 |
| 使用者觸發 | ChatGPT-User | 官方對 robots.txt 適用方式的說明有所保留,效果不確定 | 以實際請求行為觀察 |
| Gemini 訓練與 grounding | Google-Extended | 內容後續不用於 Gemini 訓練與 grounding;經其他管道取得的素材不受影響,傳統搜尋收錄照舊 | 核對檔案規則與官方說明的適用範圍;它沒有獨立 User-Agent,日誌難以驗證 |
執行層面還有兩個配套。CDN 端的預設政策與檔案規則怎麼搭配、會不會互相覆蓋,Cloudflare 對 AI 爬蟲的預設處理解析值得對照讀;規則上線後,各有實際請求的爬蟲是否真的停止,要從伺服器日誌驗證,做法見AI 爬蟲的日誌分析。想替 AI 另闢一條說明路徑,可以一併認識llms.txt 的設計與爭議。
名單與政策持續在變,決策不必一次定終身。把決策理由連同規則一起記下來,回頭更新時手上握著當初的判斷依據,避免憑感覺重擲一次骰子;AI 搜尋能見度的布局,在AI 搜尋時代的版圖變化有深入討論。
測試站與搬家現場:先盤點哪些網址需要被讀到
兩個高風險時刻的共同點,是「需要被讀到的訊號」特別密集:測試站想靠 noindex 擋住索引,搬家靠 301 傳遞轉向。封鎖會切斷這些訊號;與訊號無關的路徑,仍然可以照常設定,重點是先盤點、再動規則。
測試站的目標是整站不進索引,做法分兩條流程。流程一,密碼保護:未授權的訪客連內容都看不到,抓取與索引自然無從發生;驗證方式是開無痕視窗訪問測試網域,確認被要求登入。流程二,環境不允許上密碼時,讓頁面保持可抓取、加上 noindex,這時反而不能寫 Disallow: /:封鎖擋得住抓取,擋不住僅剩網址的條目浮現,還會讓 noindex 讀不到;驗證方式是查看測試頁的原始碼,確認標記在線上。正式站上線前,再逐項確認密碼、noindex 與封鎖規則沒有被設定檔或範本一起帶過去。兩條流程沒有優劣,只有環境條件的不同;能上密碼就用密碼,不能上密碼就把 noindex 的整條鏈路檢查完,最怕的是兩者都只做一半。
就算上線當天發現並刪掉錯誤規則,Google 手上可能還握著快取版本,通常最多約 24 小時,重新取得失敗時更長;窗口內舊規則照常生效,發現得愈晚,窗口愈長,代價也愈大。
換網域的現場,該盤點的不是「舊網域還能不能有任何規則」,而是轉址來源的網址集合:每一條 301 都要被 Google 持續讀到,搬遷的處理才走得下去。把舊網域整個 Disallow: /,等於把轉址公告收進抽屜;比較精確的說法是,轉址來源的網址不該出現在封鎖規則裡,與搬遷無關的路徑仍可依需求設定。傷害的成因通常不複雜:急著關舊站省成本,或沒想清楚先轉址、後收站的順序。附一句務實的限定:轉址做對,也不保證排名結果,它保住的是被正確理解的機會。
過渡期的長短依網站規模與 Google 的處理進度而不同,規模大的站常以週為單位。這段時間舊網域的伺服器紀錄裡看得到 Googlebot 持續造訪,那是好事,代表轉址正在被讀取;過渡期主動提交新網域的 Sitemap,幫 Google 更快認識新結構。完整的搬家盤點,從網址對照到流量監控,整理在網站搬家與改版的 SEO 指南。
驗證時帶著爬蟲名字,別只測預設值
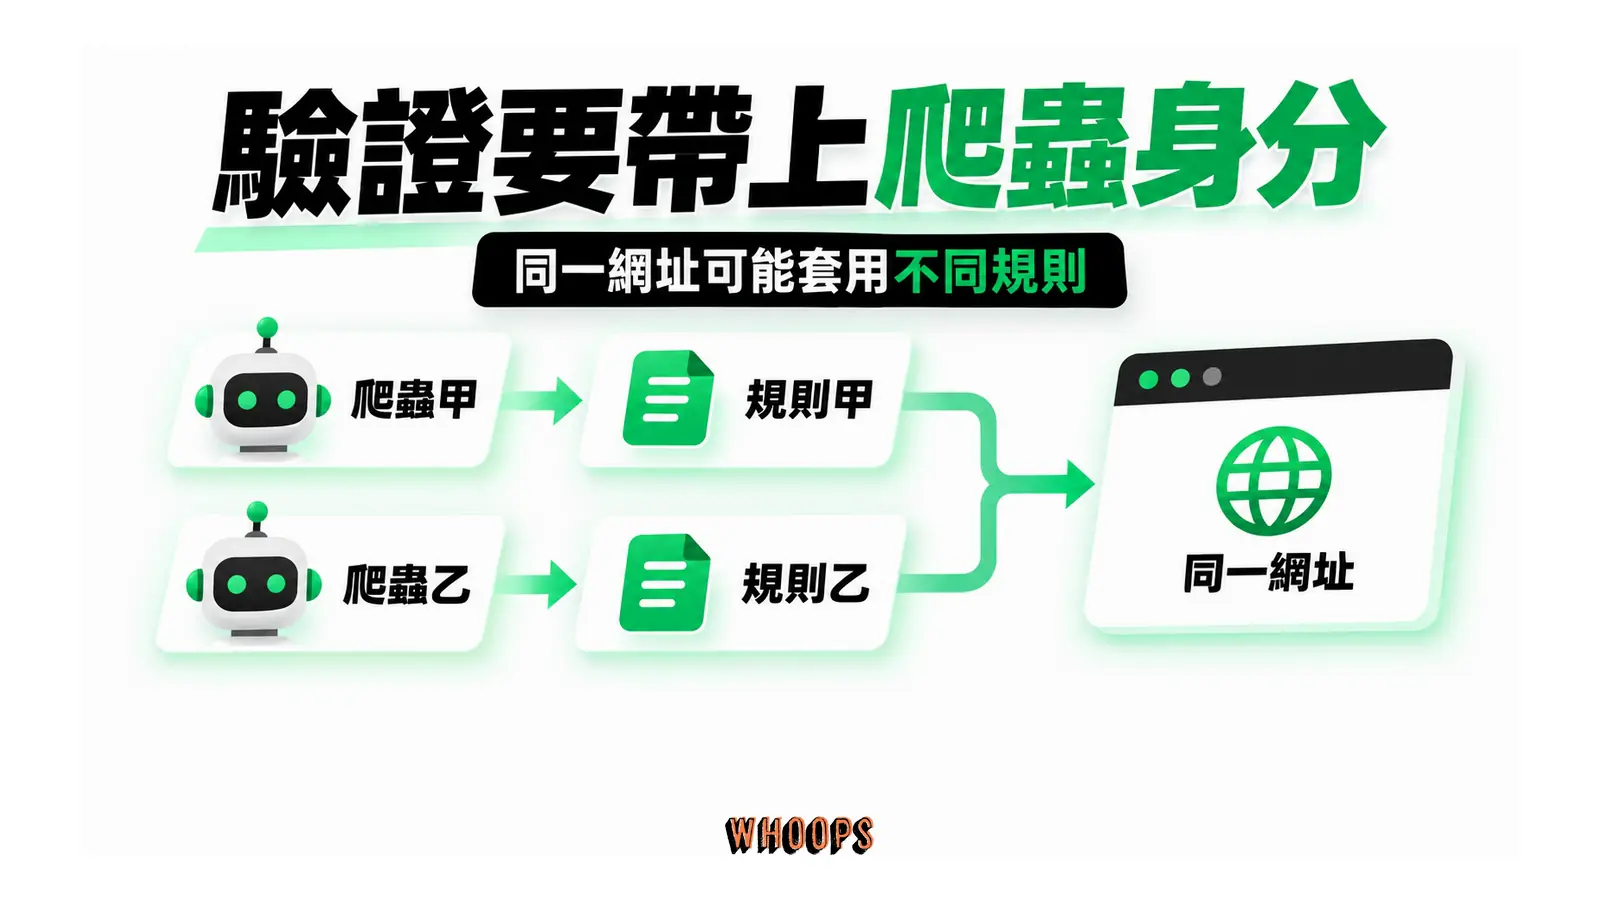
規則的效力因爬蟲而異:檔案裡有指名群組的訪客,完全不看通用群組;同名群組會被合併。只拿預設值跑測試,看到的只是其中一種訪客的視角,特定爬蟲被擋在外的情形就會漏看。
把驗證的單位從「網址」換成「網址加爬蟲」。你最在意的可能是 Googlebot 本尊,可能是圖片搜尋的變種,也可能是某個 AI 爬蟲;逐一指定對象測試,記錄每種爬蟲實際套用的規則,才算驗完。多數第三方測試器與模擬工具都拿單一預設 user-agent 出發,跑完整站看起來漂亮,換一個爬蟲名字,結果可能全變。
驗證本身分三層,各回答一個問題,工具放在對應的位置:
左右捲動檢視完整表格
| 驗證目標 | 做法 | 對應工具 |
|---|---|---|
| 檔案存在且是新版 | 瀏覽器直開網域的 /robots.txt,看回應與內容 | 瀏覽器 |
| Google 手上是哪個版本 | 查看 robots.txt 報表,可請求重新抓取,不保證立即完成 | Google Search Console(舊版測試工具已除役,報表能看、不能模擬) |
| 全站哪些網址被攔 | 切換 user-agent 跑整站模擬 | Screaming Frog 這類爬蟲模擬工具 |
單一網址的檢索狀態用網址檢查工具查看;AI 爬蟲的驗證多半回到日誌,看後續請求的走向。記錄的方式建議固定:每輪驗證記下網址、爬蟲名稱、預期結果、實際結果四個欄位;改版後規則一動,前後對照立刻看得出哪條規則開始誤傷,憑記憶還原一個月前的行為,誰都做不到。重跑的時機也有跡可循:範本或主題更新之後、CDN 或防火牆規則調整之後、網址結構改動之後,這三種變更都可能在你沒注意的角落改變檔案的回應或規則的涵蓋範圍;把重跑時機寫進上線清單,比靠記性可靠。
驗證過關說的是爬蟲進得來,不等於收錄自動發生。收錄與否取決於內容品質、網站整體狀況與內部連結;頁面遲遲沒進索引,問題通常在索引層,判讀方向見網頁索引報表的解讀方法。
收斂成判斷:哪些該擋、哪些該交給別的工具
常見的封鎖候選,是那些沒有訊號要傳、也不該被收錄的路徑:排序參數、站內搜尋結果、後台目錄都常列名其中。候選要逐一驗證,不是照清單全封;需要被讀到訊號的頁面與渲染需要的資源,一律先排除在外。
三個口袋原則帶著走。先排除:noindex、canonical、hreflang 所在的頁面,轉址來源的網址,影響渲染呈現的 CSS、JS 與圖片。交給對口工具:機密保護交給身分驗證,索引移除交給 noindex,重複合併交給 canonical。剩下的候選:依路徑用途與抓取需求逐一決定;求心安式的一律封鎖,往往是問題的起點。
左右捲動檢視完整表格
| 需求 | 對口工具 | 注意事項 |
|---|---|---|
| 不想讓某路徑被爬 | robots.txt 的 Disallow | 先確認無訊號可傳、非渲染資源 |
| 讓已收錄頁面離開索引 | noindex | 頁面必須保持可抓取 |
| 重複網址併入標準版 | canonical 標記 | 被封鎖則訊號讀不到 |
| 機密資料不外流 | 帳號密碼與伺服器權限 | 公開規則擋不住刻意存取 |
| 搬家後的轉址來源網址 | 保持開放 | 讓 301 持續被讀到 |
表格左欄是需求,右欄是工具;對不起來的時候,問題多半出在需求沒想清楚,工具不夠用的情況反而少見。常見的錯配有三種:想下架卻封鎖、想保密卻列出路徑、想導流卻斷了路,三種都源自把 robots.txt 當成第一個伸手去拿的工具。
能力限制一句話講完:robots.txt 只管抓不抓,不管內部連結的權重流動;想把連結力道導向重點頁面,該動的是網站架構與內部連結的安排。
回到開場那張報表。經營者後來做的事很樸素:先在 Search Console 確認 Google 手上的檔案版本,再逐條檢查封鎖規則,把有 noindex 要送的目錄移出封鎖,把真正沒有訊號要傳的站內搜尋路徑留下。規則變少,問題跟著變少;每一行封鎖都經得起「這條路徑上沒有東西需要被讀到」的檢查,這份小檔案就會安分做好它擅長的事。