結構化資料完整指南:從入門觀念到 Schema 實作
結構化資料 Schema 教學:說明 Schema.org 與 JSON-LD、商品和文章等類型的用途、必要欄位、驗證與維護,釐清複合式搜尋結果資格、AI 引用限制及常見政策錯誤。
本頁目錄
- 為什麼要重新定義 Schema 的角色
- 把 Schema 當成可核對的內容描述
- 從三個面向評估 Schema 的用途
- 先看版位再標記:從 SERP 倒推的工作法
- 哪些 Schema 真的換得到 rich result
- 觀念分層:類型、屬性、詞彙與序列化格式
- 用 @id 把單頁標記串成站級實體圖
- 網站改版與網址遷移:保住實體關係
- 為什麼 JSON-LD 是預設選擇
- 把 Schema 寫成可測試的資料契約
- 驗證與維護:被多數人忽略的真實成本
- 常見錯誤機制與反例
- Rich result 消失時的診斷順序
- 不同站點類型的 Schema 優先順序
- 台灣本地站的 Schema 細節:幣別、地址、營業時間與語系
- 結構化資料如何餵養 Google 的知識圖譜
- 點擊率才是結構化資料的實質回報
- 用 Search Console 量化 Schema 的實際報酬
- AI 搜尋中的結構化資料:用途與限制
結構化資料(structured data)使用明確的欄位描述頁面中的文章、產品、組織等資訊。Google 仍將協助理解內容列為它的用途;符合規範的標記也能讓頁面具備適用複合式搜尋結果的資格。本文會從內容類型、必要欄位、驗證與維護說明實作方式,並區分搜尋呈現資格與實際成效。
為什麼要重新定義 Schema 的角色
搜尋系統能理解自然語言,並不代表結構化資料失去描述內容的用途。實作時應先確認頁面在談什麼,再選擇能正確表達這些資訊的類型與屬性。
例如活動時間與評論評分都能寫在網頁文字裡,再以對應屬性表達。兩者應使用相同資料來源,避免頁面顯示的日期或分數與標記不同。
Schema 的實作要同時顧到語意表達、功能資格與資料一致性。
不同搜尋功能有不同的資格條件。不能把 Schema 描述成所有 AI 服務共用的引用介面,也不能推定模型會依某個未公開的「抽取成本」挑選來源。
標記正確之後,仍要觀察 Google 是否實際採用,以及曝光、點擊是否改變;完成設定本身不能替代成效驗證。
本文採用的工作順序是:辨識頁面內容、核對 Google 支援的功能、建立與可見內容一致的標記,再持續驗證。不要為了追求欄位數量而補上不存在的資料。
把 Schema 當成可核對的內容描述
可以把標記想成內容的資料表:欄位要有明確意義,值要能在頁面上核對。這個比喻是實作方法,不能拿來否定搜尋引擎理解內容的用途。
申報單的運作邏輯跟翻譯完全不同,它有幾個固定特徵。欄位是對方開的,不是你自由發揮;Google 各 rich result 類型的 required 與 recommended properties 要分開依現行文件判斷。Product 的必要欄位會依 product snippet 或 merchant listing 情境而異,不是一律同時要求 offers 與 aggregateRating;Article 沒有 required properties,author 與 datePublished 是建議欄位。內容仍必須跟頁面上看得到的資訊一致,送出標記也不等於會被採用。
這個框架解釋了幾件翻譯框架解釋不了的事。為什麼標了 Schema 卻沒拿到版位,因為申報只是入場,對方不一定要用。無效標記通常是失去 rich result 資格或該標記被忽略;只有欺騙性、不可見或違反政策的標記,才可能遭 structured data manual action,而且不會直接降低一般網頁排名。Google 反覆強調標記要與可見內容一致,因為欄位需要能與頁面內容交叉驗證。
從申報的角度切入,你會自然問出更接近成敗核心的問題:這個欄位我頁面上真的有對應內容嗎、我願意為這個聲明背書嗎、這份申報的證據夠不夠扎實。把 Schema 當申報單看待,後面所有該標什麼、怎麼驗證、哪些違反政策的標記可能被處置,都會自然走到對的位置。
從三個面向評估 Schema 的用途
理解內容、搜尋呈現與 AI 功能,是以下討論的三個面向;這是實作上的分類,不代表 Google 公開了一套固定的三層處理流程。
第一個面向是描述內容。以正確類型表達文章、產品或組織,並釐清作者與發布者等關係,可減少資料本身的歧義;不要把標記視為保證索引或去重成功的設定。
第二個面向是搜尋呈現。Article 可協助 Google 理解標題、圖片、日期及作者;標記不等於作者已取得某個 E-E-A-T 分數,也不保證排名或搜尋版位。
第三種情境是生成式摘要與 AI 引用。清楚、可查證且能脫離上下文理解的價格、規格、步驟與問答,通常較容易被各種系統解析;適用的結構化資料可協助搜尋引擎理解頁面內容及判斷部分複合式搜尋結果資格,但不保證被生成式 AI 引用。標記內容必須與頁面可見文字一致,並遵守各類型的官方規範。
左右捲動檢視完整表格
| 評估面向 | 檢查重點 |
|---|---|
| 內容描述 | 類型、實體與屬性是否對應頁面內容 |
| 搜尋呈現 | 支援功能、必要欄位、可見內容與政策是否符合 |
| AI 功能 | 不要把 Schema 當成引用資格或特殊排名公式 |
內容站可依文章資訊評估 Article,商品頁則依實際購買或評論情境評估 Product。優先順序應由內容與功能需求決定,不能把 Article 說成與搜尋呈現無關。
先看版位再標記:從 SERP 倒推的工作法
可從目標查詢觀察搜尋呈現,再回到官方文件確認功能是否仍支援。一次搜尋只是抽樣,不能拿它當成所有使用者都會看到相同版位的證據。
我的建議是反向工作法:先看你的目標查詢在 Google 上實際出現什麼版位,再倒推要標什麼。實際步驟如下。
先記錄目標查詢中的商品、食譜、活動等搜尋呈現,再核對 Google Search Gallery 與各功能文件。確認必要欄位、內容與政策都符合後,用 Rich Results Test 驗證;上線後再查看 Search Console。FAQ 與 HowTo 已退出 Google rich result,不應列為現行可爭取的版位。
觀察 SERP 有助於排定工作順序,頁面是否適合該類型仍以內容和官方規範為準。不能因為競爭頁出現某種版位,就替自己的頁面加上不相符的標記。
以食譜頁為例,先確認 Recipe 所需的 name 與 image,再依真實內容補充料理時間、步驟、營養資訊或評論。沒有評論就不要補造評分,也不能只為了星等而忽略必要欄位。
反向工作法還有一個好處:它會逼你面對「你的內容到底值不值得這個版位」。如果你的食譜頁連料理時間都沒寫、沒有任何讀者評分,那標 Recipe 也拿不到料理時間版位與星等。Schema 是放大器,它放大的是你已經做對的內容,不是無中生有。
哪些 Schema 真的換得到 rich result
Google 支援的搜尋功能會變動,應以現行文件評估投入。Schema.org 中仍存在的類型,不代表 Google 仍提供對應 rich result。
左右捲動檢視完整表格
| Schema type | 對應 rich result | 取得門檻 | 常見誤判 |
|---|---|---|---|
| Product | 評論星等、價格、庫存 | 依 product snippet 或 merchant listing 的規範判斷 | 評論頁也可能適用 product snippet,須符合該情境規範 |
| Recipe | 食譜卡、料理時間、營養資訊 | 真實食譜、有步驟與時間 | 部落格散文式食譜標 Recipe,缺屬性 |
| HowTo | Google 搜尋已停止支援 HowTo rich result | Schema.org 詞彙仍存在,但不再換取 Google HowTo 版位 | 沿用已退場的步驟卡效益評估 |
| FAQPage | Google 搜尋已停止支援 FAQ rich result | Schema.org 詞彙仍存在,但不再換取 Google FAQ 版位 | 沿用 2023 年「政府與健康網站仍可顯示」的舊說法 |
| Event | 事件卡、時間地點 | 真實活動、有日期地點 | 日期與狀態應準確,過期內容不保證仍有搜尋呈現 |
| Article / NewsArticle | Top stories、新聞 | 依文章內容選擇 Article、NewsArticle 或 BlogPosting | Article 標記不是 Top stories 的必要條件 |
| BreadcrumbList | 麵包屑 | 站內導覽結構 | 幾乎所有站都該標,CP 值最高 |
| Organization | 知識面板 | 真實組織資訊;Wikipedia 並非必要條件 | 小站標了不會自動有知識面板 |
| LocalBusiness | 本地商家卡 | 實體店面、有地址營業時間 | 純線上服務標了不符資格 |
| VideoObject | 影片預覽 | 可存取且符合影片索引與 VideoObject 規範的內容 | 標了但頁面沒影片,違反政策 |
從這張表可以讀出幾件事。BreadcrumbList 與 Organization 是多數站可評估的基本款,但仍要對應真實導覽與組織資料。FAQ rich result 已自 2026 年 5 月 7 日停止在 Google 搜尋顯示,HowTo rich result 也已停止支援;保留對應 Schema.org 詞彙是否有其他系統用途,要依實際需求評估,不能再用 Google 版位當投資理由。Product、Recipe、Event、LocalBusiness 對內容真實對應的要求高,標記與可見內容不一致會失去 rich result 資格,欺騙性標記則可能觸發人工處置(見 Google Search Central 的文件更新紀錄)。
簡單講,挑 Schema 不是挑你看起來像哪種,是挑你願意且能夠對著 Google 政策發誓你的內容真的符合的那種。
淘汰清單也比多數舊教學承認的長。除了表中的 HowTo 與 FAQPage,Google 已於 2025 年 9 月 9 日移除五種長尾類型的文件:課程資訊、預估薪資、學習影片(learning video)、特別公告(special announcement)與車輛清單(vehicle listing),理由是這些類型不再顯示於 Google 搜尋結果;練習題(practice problem)也已在 2025 年 11 月列入淘汰,2026 年 1 月起 Search Console 的複合式結果報告與 Rich Results Test 不再支援。承接舊專案看到這些標記時,先查官方更新紀錄確認功能仍在,別照舊範本補寫。
觀念分層:類型、屬性、詞彙與序列化格式
很多人講 Schema 時把四個不同層次的觀念混在一起,越講越亂。把它們分清楚,官方文件才看得懂。
類型(@type)是「這個東西是什麼」。Article、Product、Event、Recipe 都是類型。類型決定了哪些屬性可以用,也決定了 Google 願不願意給你哪種版位。同一個頁面可以有多個類型,但每個類型的政策門檻不同。
屬性(property)是資料欄位,例如價格、品牌、作者與發布日期。先補齊對應 Google 功能的必要欄位,再填入有可靠來源的建議欄位;不要為了消除警告而編造資料。
詞彙(vocabulary)指的是 Schema.org 這套由 Google、Microsoft、Yahoo、Yandex 在 2011 年共同發起的開放詞彙表。Schema.org 是詞彙,不是格式,這是常見的混淆。你可以用任何格式來表達 Schema.org 詞彙,就像同一份食譜可以寫在不同形式的紙上。
序列化格式(format)是你把詞彙用什麼樣的語法寫出來。JSON-LD、Microdata、RDFa 是三種主流格式。它們表達的是同一套 Schema.org 詞彙,差別在寫法與維護成本。
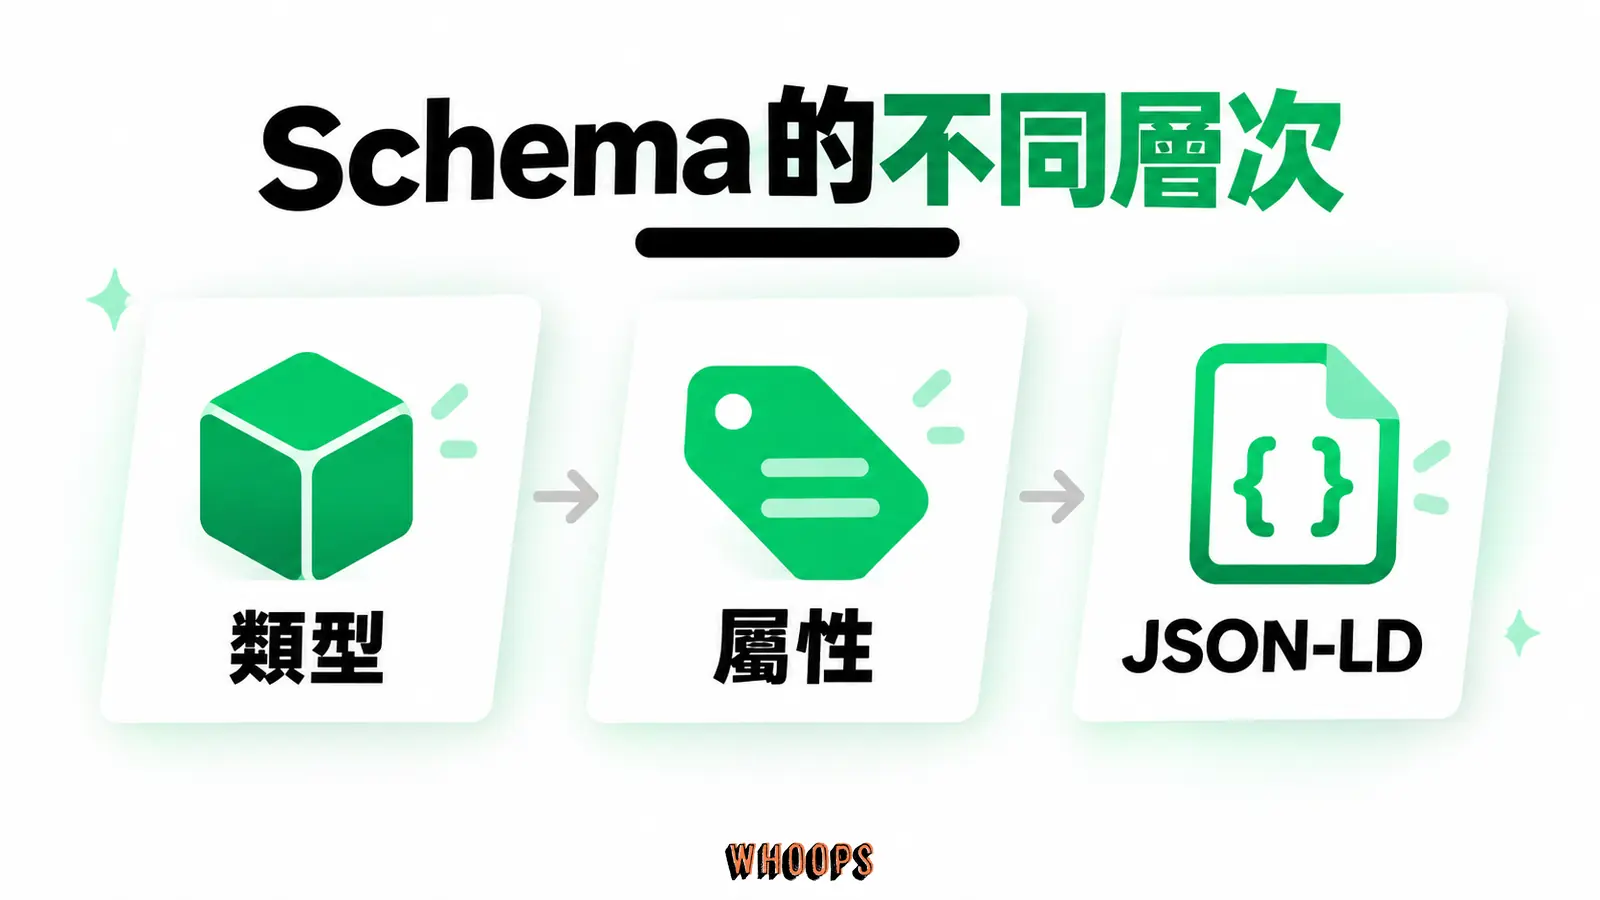
分清楚這四層,你才會理解為什麼「我用了 JSON-LD 為什麼還是沒拿到 rich result」這個問題本身問錯了。JSON-LD 是格式,rich result 取決於類型、屬性、政策合規,跟格式幾乎無關。換格式不會解決你的政策問題,就像換信紙不會改變信的內容。
用 @id 把單頁標記串成站級實體圖
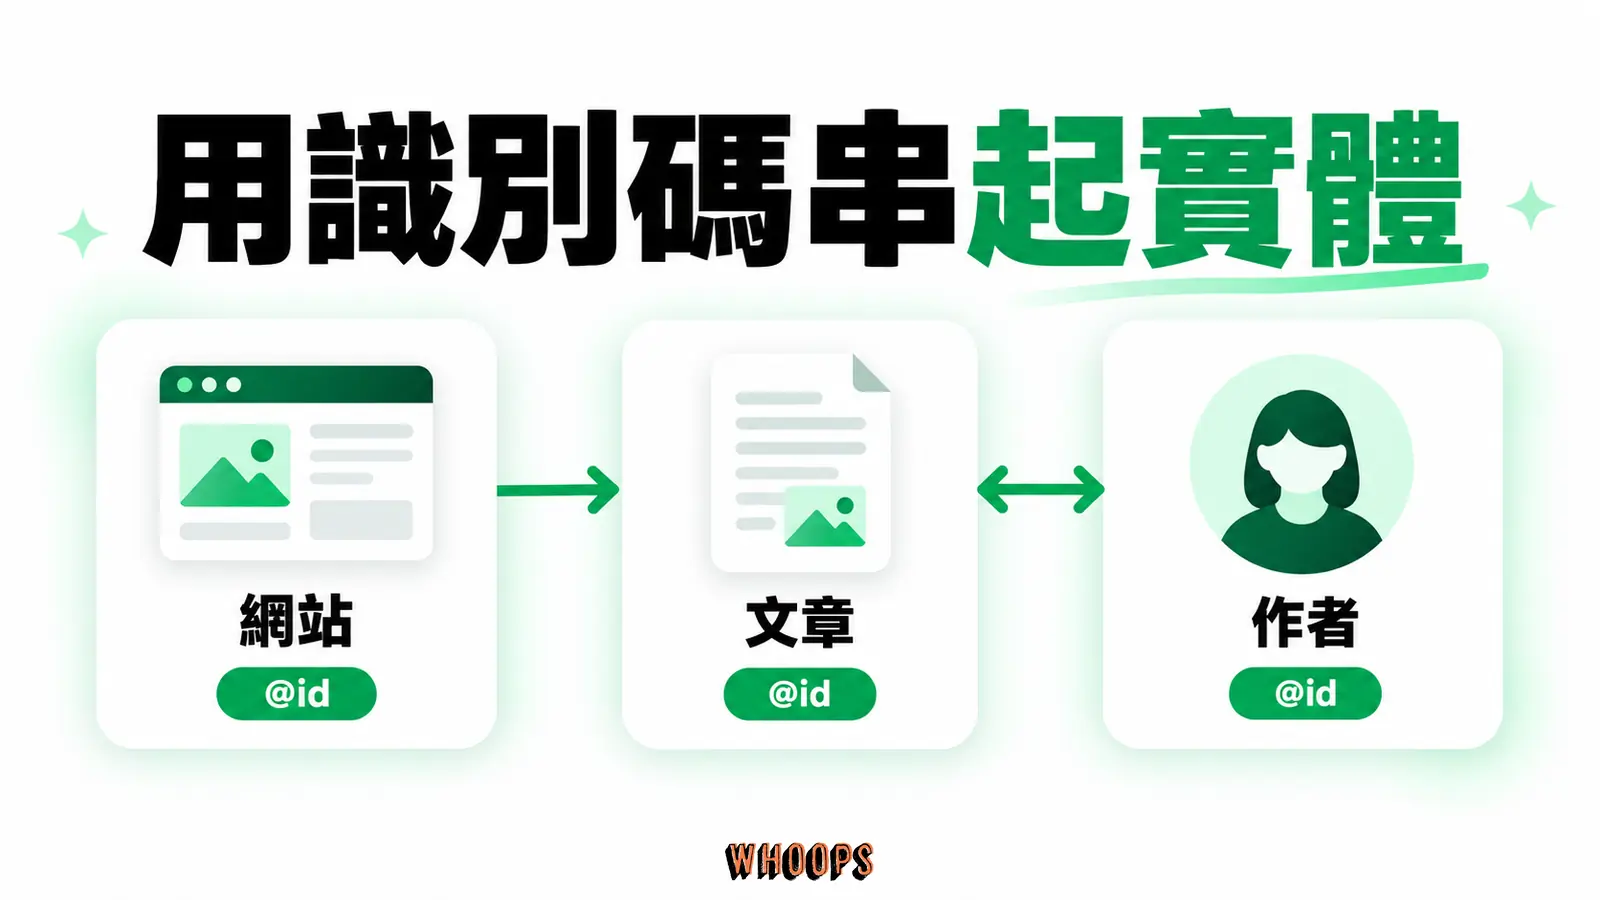
多數人停在每頁一份獨立 JSON-LD 的層次,但 Schema 真正的進階價值在於把全站標記串成一張可被搜尋系統重複引用的實體圖。關鍵欄位是 @id 與 sameAs,而這兩個欄位在入門教學裡幾乎都被略過。
@id 的作用是給每個實體一個穩定的全球識別碼。你的 Organization 標記不該只在首頁出現一次,而該在每個出現的地方用同一個 @id(例如 https://www.your-site.com.tw/#organization)指向同一個實體。Author 同理,同一位作者出現在全站多篇文章裡,每篇的 author 欄位都可用同一個 @id 指向同一個 Person 節點。穩定 @id 可減少同一實體被重複建模的歧義,但不能把它寫成可量化的作者權威累積。
sameAs 用來連到能進一步識別同一組織或人物的頁面,例如官方社群檔案。應確認連結指向同一實體,沒有 Wikipedia 條目也不代表不能使用 Organization。
實作上應盡量維持 @id 穩定,以減少同一實體被重複建模的歧義;若需要變更,應同步更新所有引用。變更 @id 不代表舊實體被殺掉或排名權威歸零。
網站改版與網址遷移:保住實體關係
改網域、URL 規則或 CMS 時,Schema 常在「頁面看起來正常」的情況下斷掉。準備階段先列出舊 URL 到新 URL 的一對一對照,再盤點哪些 URL 同時被用作 canonical、@id、url、mainEntityOfPage、作者頁與組織節點。頁面搬家後要同步更新這些引用,不能只做轉址。新的頁面使用自我參照 canonical,舊 URL 導向對應的新 URL,不要全部導到首頁。
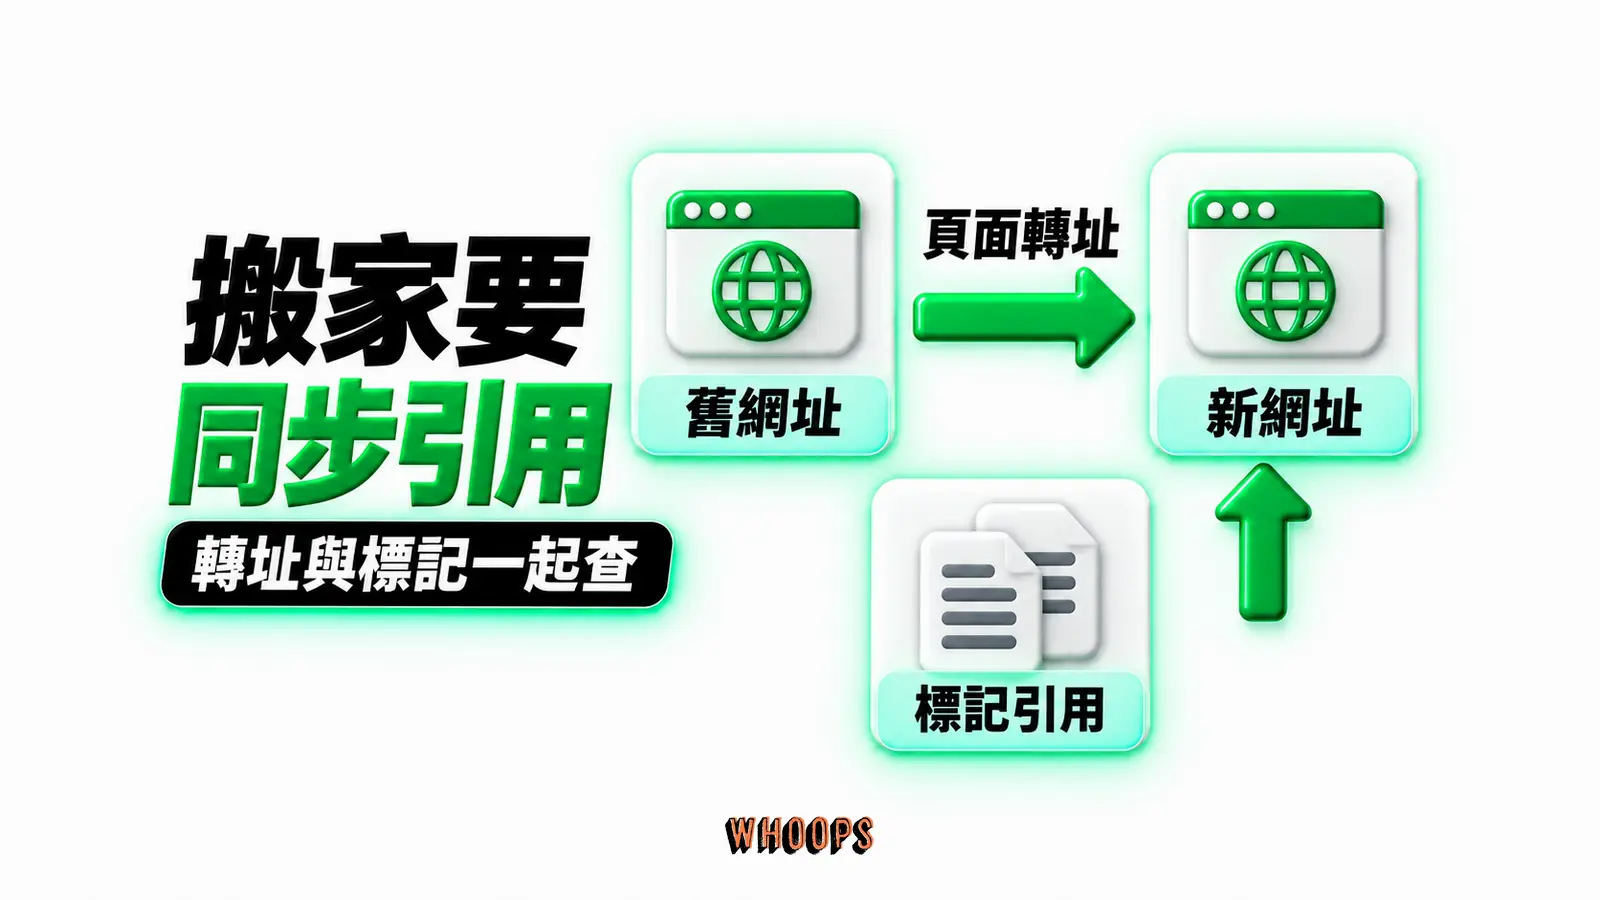
Google 對網站遷移的官方建議包括測試轉址、用 URL Inspection 抽查、提交新 sitemap,並將轉址保留盡可能久,通常至少一年,讓搜尋系統有時間重新檢索並移轉訊號(見 Google 的網站搬遷指南)。這個一年是轉址維護建議,不是排名恢復保證。若 @id 使用舊網域 URL,改版前要決定是否維持可解析的穩定識別碼,或將所有引用一次遷到新值;不要假設只改 @id 就會自動移轉搜尋訊號。
發布不要全站一次切換。先挑少量、可代表主要模板的文章、產品與地點頁,驗證舊 URL、轉址、新 canonical、渲染後 JSON-LD 與可見內容,再擴大。上線後同時看索引、rich result 狀態與有效項目數;有效項目下降但無錯誤增加,常見原因是新模板漏掉標記,不代表資料品質突然變好。改版檢查表要把 HTML、Schema、canonical、sitemap 與內部連結放在一起,才能避免只修其中一層。
為什麼 JSON-LD 是預設選擇
Google 官方對多數情境推薦 JSON-LD,這不是宗教戰,是有具體理由的。
JSON-LD 是獨立的 <script type="application/ld+json"> 區塊,方便由 CMS 或程式維護。它與畫面分離,也可能因此與可見內容不同步;改版後仍要確認標記沒有遺失或引用舊欄位。
Microdata 與 RDFa 將標記寫在 HTML 屬性中。Google 支援這兩種格式,但無論選哪一種,都必須驗證資料與頁面內容一致;格式本身不會保證正確性。
Google 可以在渲染後處理由 JavaScript 產生的 JSON-LD,但這會增加對渲染流程與執行時機的依賴;價格、庫存等快速變動資訊尤其要注意可見內容與標記是否同步。能在伺服器回應中輸出正確標記時,可降低實作複雜度;無論採哪種方式,都應使用 Rich Results Test、URL Inspection 與實際抓取結果驗證。
把 Schema 寫成可測試的資料契約
大量頁面的 Schema 不該靠編輯逐欄手填,而要把每個類型定義成資料契約。契約至少寫清楚主類型、欄位來源、資料型別、是否允許空值、顯示在頁面的對應位置、更新責任與 Google 功能文件版本。以 Product 為例,name 從商品主檔取值,offers.price 與可見售價共用價格服務,availability 由庫存狀態轉換;沒有真實評論時,aggregateRating 整個省略,不輸出零分或樣板值。
測試分成三層。單元測試檢查 JSON 能解析、URL 與日期格式正確、條件欄位只在有資料時輸出;模板測試用幾組固定資料,確認一般商品、售罄商品、無評論商品與變體頁都產生預期節點;發布後測試則抓實際 URL 的渲染結果,比對可見價格、庫存、作者與 JSON-LD。Google 可處理渲染後 DOM 裡的 JavaScript 產生標記,但官方提醒動態 Product 標記可能讓快速變動的價格與庫存檢索較不可靠;測試應以 URL 模式檢查實際渲染內容(見 Google 對以 JavaScript 產生結構化資料的說明)。
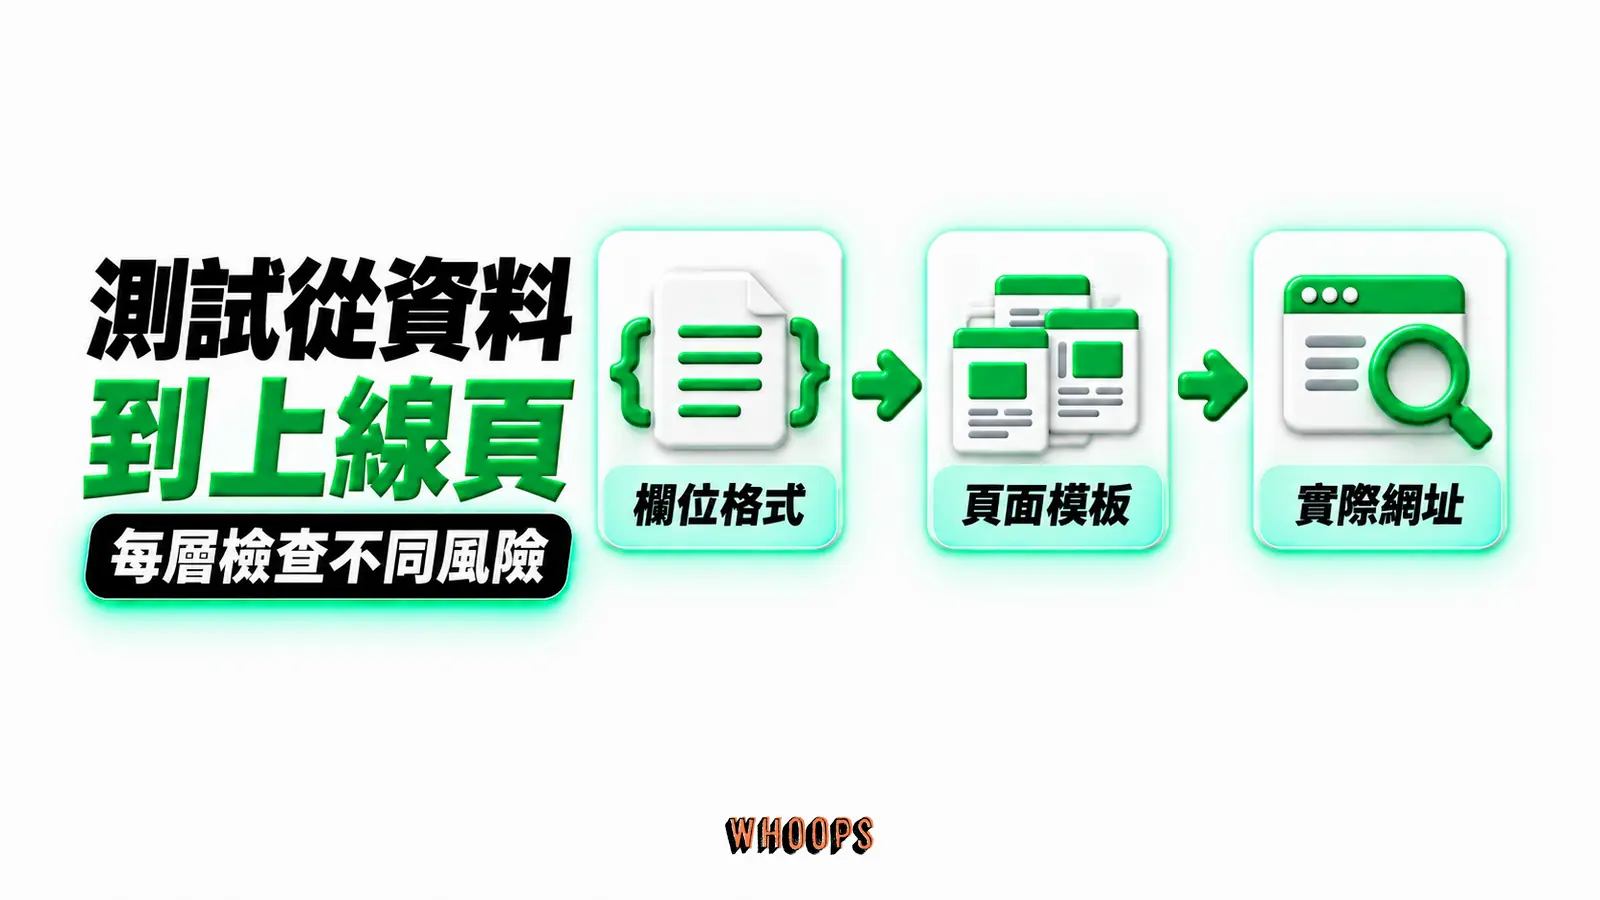
資料契約還要處理政策版本。Schema.org 詞彙、Google rich result 文件與站內可見內容是三個不同層級:詞彙存在,不等於 Google 仍提供對應版位;測試工具通過,也不等於內容符合品質規範。每個主類型指定負責人,在 Google 文件變更、CMS 欄位改名、資料服務改版時重跑契約測試。Google 官方建議開發時用 Rich Results Test,部署後用 rich result status report 監控模板或供應問題(見 官方的結構化資料入門說明)。
這套契約流程也決定 LLM 在 Schema 工作流裡的位置:草稿,不是真相來源。大型語言模型擅長把頁面內容整理成指定 type 的欄位初稿,常見的失敗模式則是欄位名稱、列舉值或整個 type 被自行發明,格式看起來合法、Schema.org 裡其實不存在。所以產出後仍要走同一套驗證:先用 Schema Markup Validator 確認詞彙存在,再用 Rich Results Test 對照 Google 的資格條件,最後人工核對欄位與頁面可見內容一致;政策與一致性錯誤,這兩個工具都測不出來。
驗證與維護:被多數人忽略的真實成本
Schema 的真實成本不在實作,在維護。這句話不是老生常談,是大多數 Schema 專案失敗的原因。
實作 Schema 是一次性投入:寫好模板、套到所有頁面、跑一次 Rich Results Test 驗證、送出。但維護是持續性的,而且錯誤是隱形的。
商品價格變了,Schema 裡的 offers 還是舊的。商品下架了,Schema 還標著 InStock。活動結束了,Schema 還標著未來日期。作者離職了,Schema 還連到舊的 author URL。改版時工程師把 JSON-LD 拿掉了,沒人發現。每一條都會讓 Google 偵測到「標記與可見內容不一致」,輕則取消 rich result 資格,重則被歸類為垃圾標記。問題是這些錯誤不會跳出報錯,你只會看到 rich result 消失,然後花很長時間才追溯到是 Schema 問題。
避免這個問題的根本做法是建立單一真相來源(single source of truth)。Schema 的每個欄位都應該從同一個資料來源自動生成,不要讓人手動填。電商的 Product Schema 應該從商品資料庫直接取,不該由行銷人員在 CMS 裡手填。Article 的 author 應該從作者資料庫取,不該寫死在模板裡。價格、庫存、活動日期這類會變動的欄位,必須由即時資料源驅動,不能放在快取。
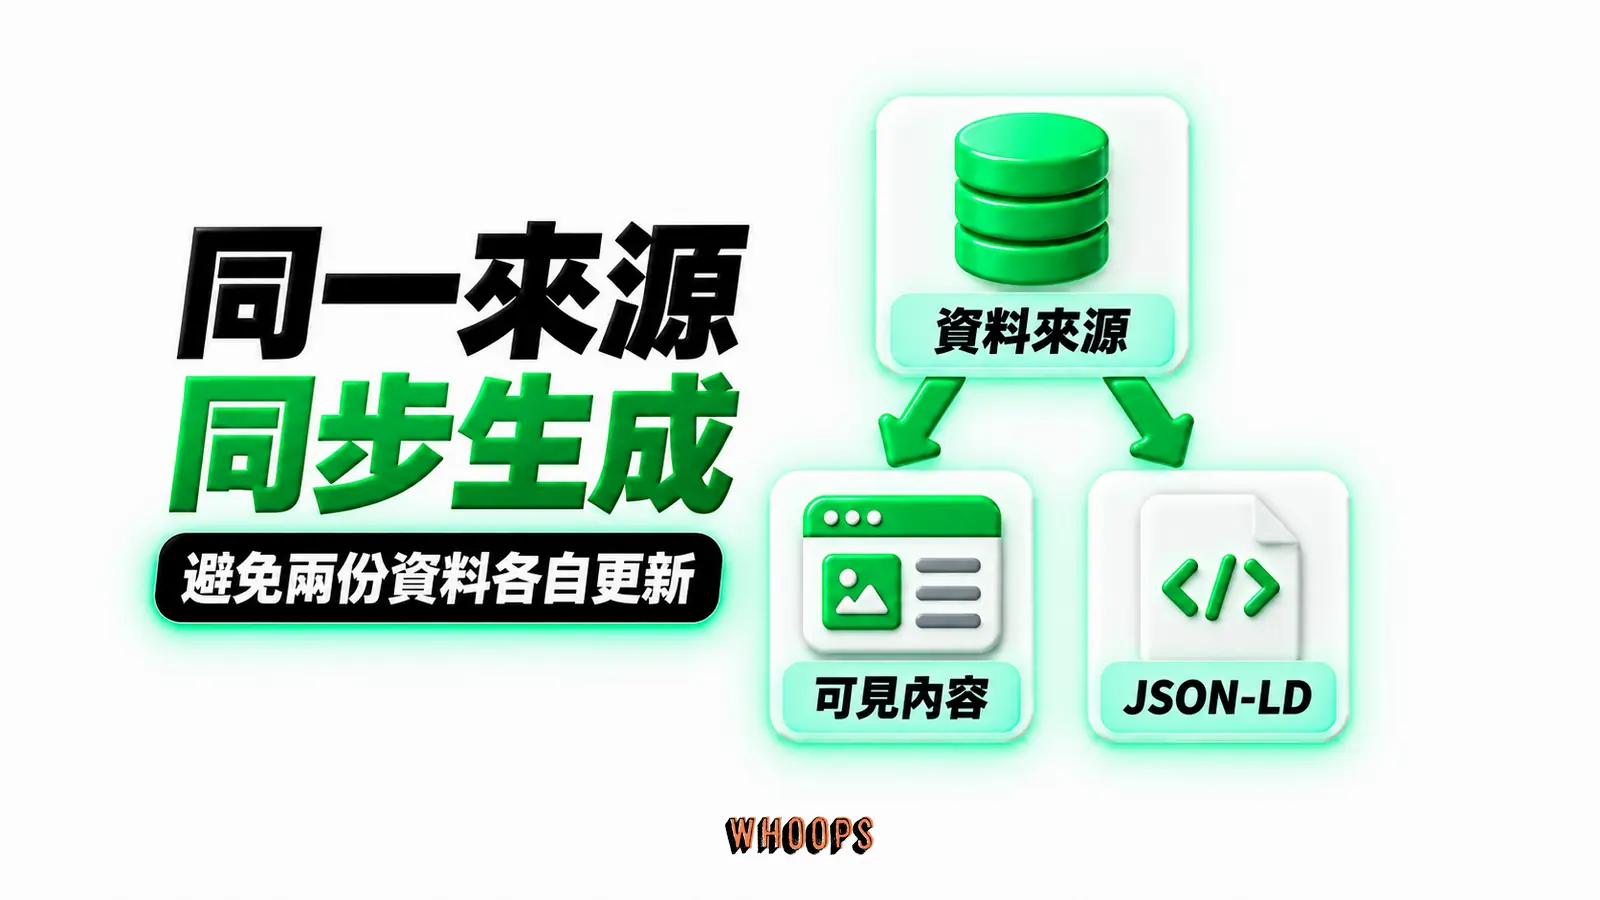
並定期做三件事。每月跑一次 Search Console 的增強項目報告,看有沒有新增錯誤。每季抽樣用 Rich Results Test 測幾個重要頁面,看 Schema 與可見內容是否一致。每次網站改版後,跑全站 Schema 一致性檢查,因為改版是 Schema 出錯的高峰期。
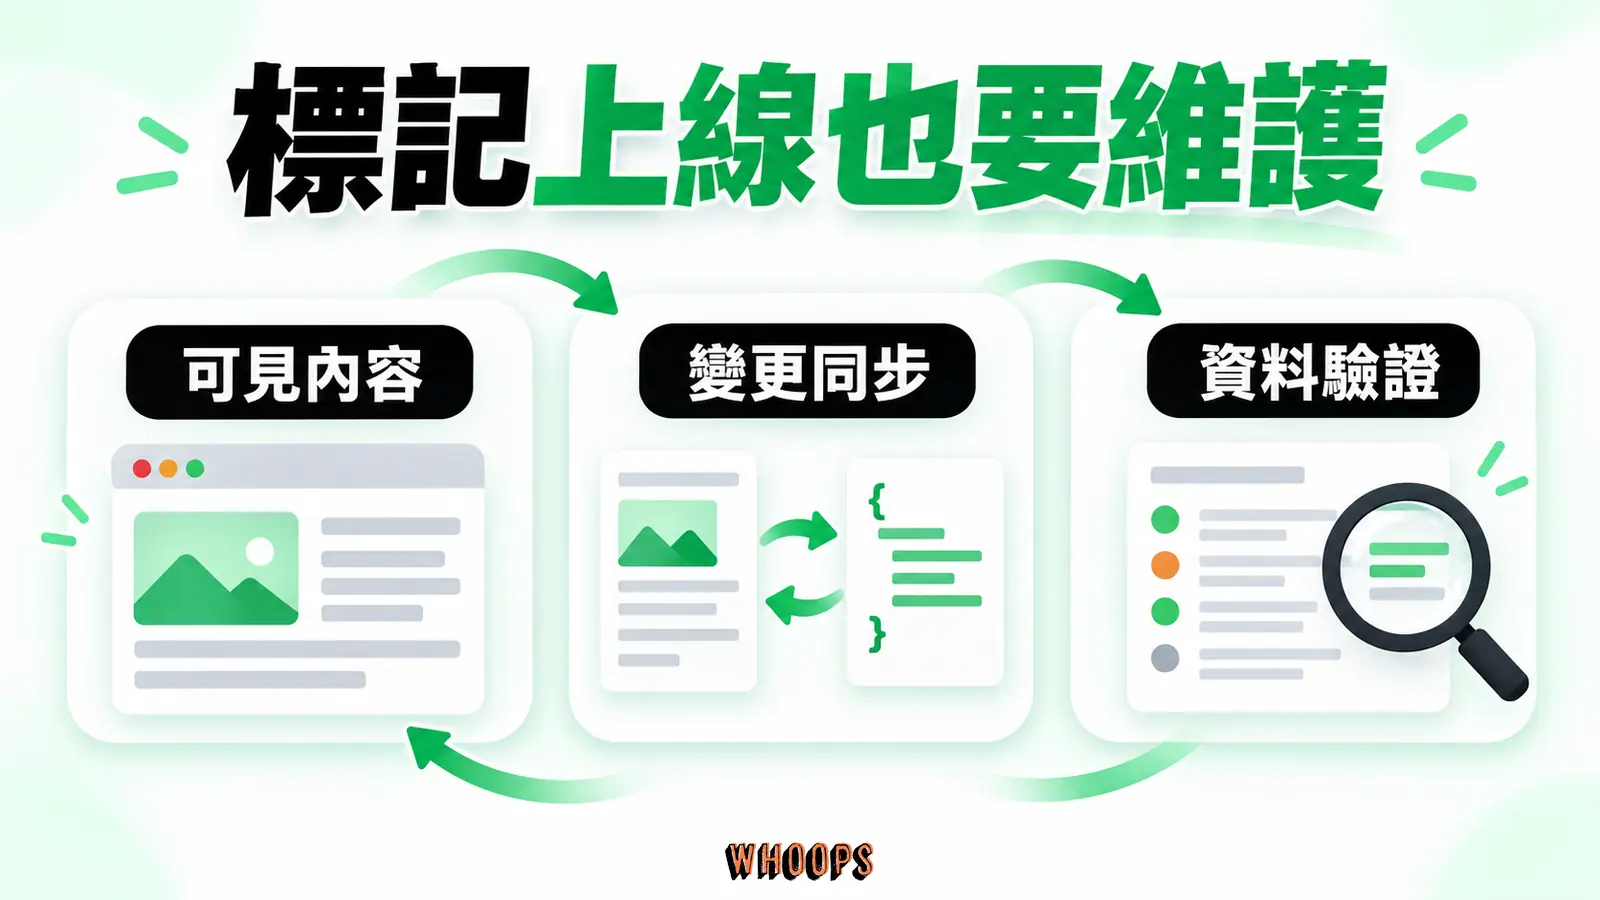
這三件事的成本遠低於你標完 Schema 然後三年不聞不問、最後被 Google 撤銷 rich result 資格的修復成本。很多網站不是輸在沒標 Schema,是輸在標了就忘。
常見錯誤機制與反例
Schema 的錯誤有幾種典型模式,看完就知道你的網站有沒有踩到。
隱形垃圾標記是最容易被 Google 抓到的。你標了 aggregateRating,但頁面上根本沒有讀者評論。Google 會比對標記與可見內容,這類對不起來的標記會被歸類為垃圾。常見於聯盟行銷網站、內容農場、新建電商站急著要星等。
同一頁可以標記多個真實存在的項目,例如食譜、相關影片與麵包屑。重點是各節點描述正確且關係清楚,並補足所需欄位;Google 並沒有一頁只能有一種類型的規則。
標記與可見內容不一致是最常見的維護型錯誤。頁面顯示 NT$1,290,Schema 裡寫 NT$890。這在動態定價的電商很常見,因為 Schema 從快取取,可見內容從即時 API 取,兩邊不同步。這也是為什麼前面強調單一真相來源。
Google 搜尋功能只支援其文件列出的類型與屬性。自行定義的類型不能藉此取得 Google rich result;實作時應核對 Schema.org 詞彙及 Google 的功能規範。
政策要按類型查核。例如 Event 的日期與狀態要準確,LocalBusiness 要符合商家資料要求,Review 也有評論對象與內容規範。不要只看 JSON 語法就推定符合資格。
同一內容若由 CMS、外掛與手動程式重複輸出,應檢查是否存在互相矛盾的值。盡量統一資料來源與維護責任,避免更新一份卻漏掉另一份。
左右捲動檢視完整表格
| 錯誤類型 | 典型成因 | 修正方向 |
|---|---|---|
| 隱形垃圾標記 | 沒有可見內容卻標了評論評分 | 移除標記或補上真實評論機制 |
| 過度標記 | 貪心,什麼 type 都標 | 標記真實項目與關係,補滿各功能必要屬性 |
| 標記與內容不一致 | 動態資料未同步 | 從單一真相來源生成 |
| 用不存在的 type | 自行發明 | 只用 Schema.org 官方 type |
| 政策不符 | 不查政策就標 | 對照 Rich Result Gallery 政策 |
| 重複標記 | CMS 與手動並存 | 統一由一個機制生成 |
這些問題可能是語法、必要欄位、內容一致性或政策問題。測試工具能發現部分技術錯誤,不能取代人工核對;通過測試也不保證搜尋結果會採用。
Rich result 消失時的診斷順序
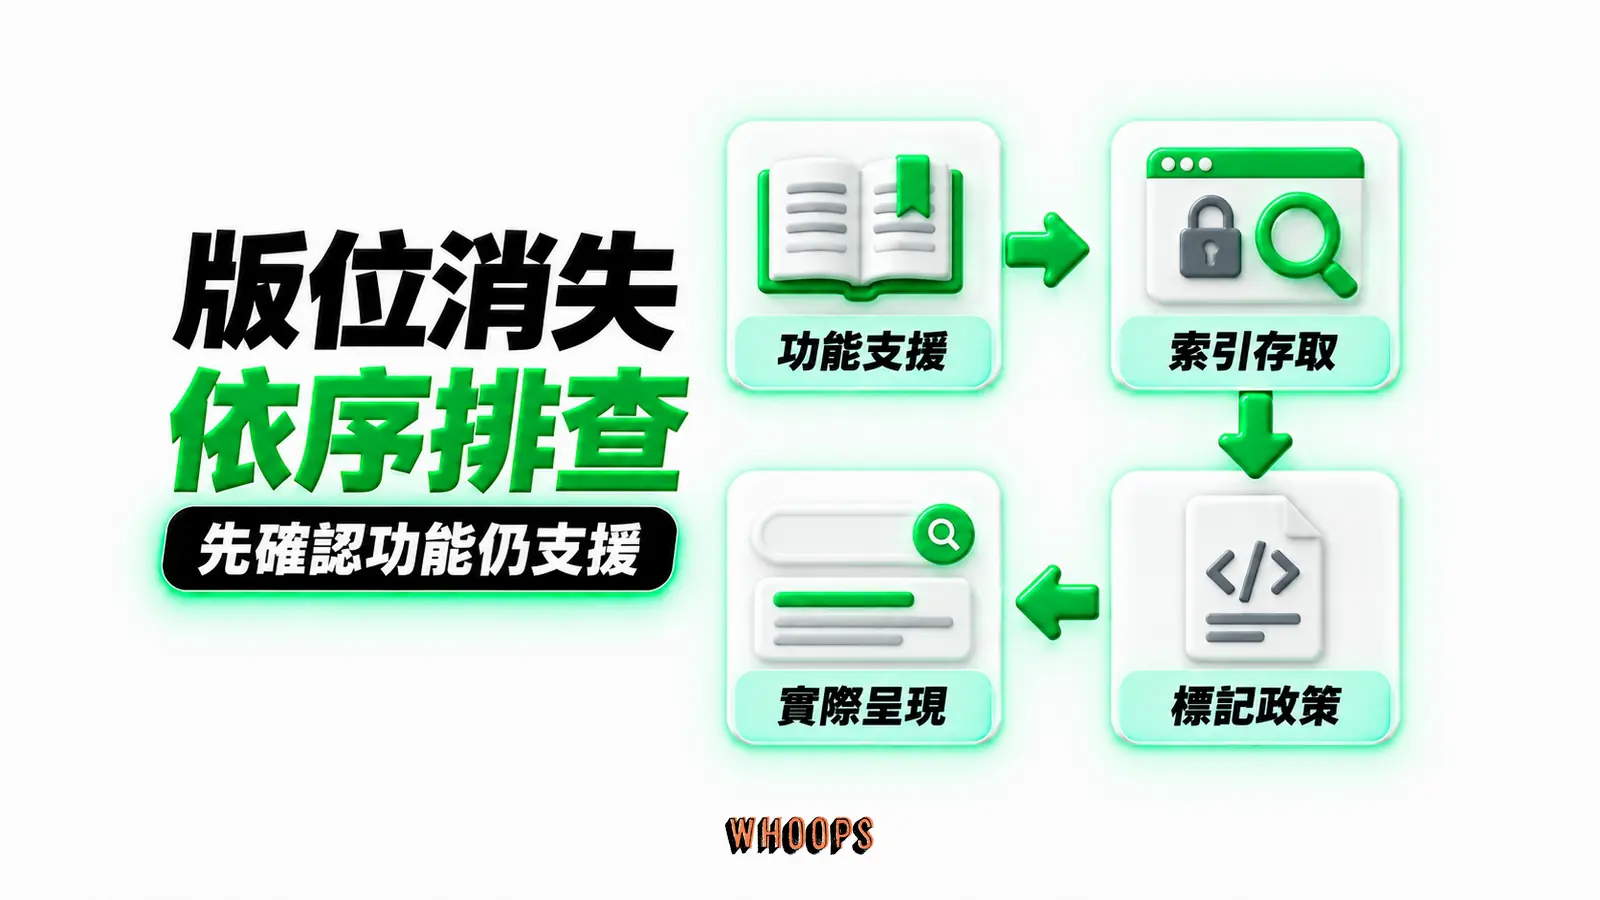
版位消失後先確認功能還存在,不要立刻重寫 JSON-LD。Google 會停止支援部分搜尋功能,FAQ rich result 就在 2026 年 5 月 7 日停止顯示,相關文件其後也被移除。若功能已退場,頁面沒有技術修復可做;保留 Schema.org 標記可能只剩其他系統或內部資料交換用途。功能仍存在時,再查目標頁是否可索引、Google 選的 canonical 是否正確、robots.txt 是否阻擋爬取、noindex 是否排除索引,以及登入限制是否讓 Google 無法存取內容。
接著用 URL Inspection 看 Google 取得的頁面與渲染結果,再用 Rich Results Test 檢查目前版本。測試通過只代表語法與部分資格條件成立,不代表一定顯示。Search Console 的 rich result status report 用來看整批有效、警告與無效項目的變化;Manual Actions report 則確認是否有 structured data 人工處置。Google 說明,這類人工處置會讓頁面失去 rich result 資格,不會直接改變一般網頁搜尋排名(見 Google 的一般結構化資料規範)。
技術與政策都沒問題時,才進入呈現層診斷:標記是否代表頁面主要內容、可見資料是否完整且最新、特定查詢與裝置是否仍出現該版位、排名或 SERP 組成是否改變。抽樣時保留日期、查詢、裝置、國家與截圖,不用單次人工搜尋下結論。修正後讓 Google 重新檢索,觀察有效項目與 Search appearance;不要用反覆送出索引要求取代等待。這個順序能把「功能退場、索引問題、渲染錯誤、政策不符、演算法未採用」分開,避免把所有消失都歸因成 Schema 壞掉。
不同站點類型的 Schema 優先順序
不同類型的網站,Schema 的優先順序完全不同。給你一個按站點類型的判斷框架。
內容站、媒體、部落格可評估 Article(常見建議欄位包括 author、datePublished、publisher、headline)、BreadcrumbList、Organization、Person。FAQ rich result 已在 2026 年 5 月停止顯示,HowTo rich result 也已停止支援,不要再以取得這兩種 Google 版位為理由投入。頁面真的有內嵌影片時,再評估 VideoObject。要把多支影片組織成單一主題頁,VideoObject、ItemList 與編輯評註該怎麼搭配,可以參考YouTube 策展頁的標記做法。
電商的優先級是 Product(含 offers、aggregateRating、brand、sku)、BreadcrumbList、Organization、Review。Product 的 offers 必須與可見價格同步,aggregateRating 必須來自真實評論系統。ItemList 在分類頁可以考慮,幫助 Google 理解一整組產品的關係。
本地商家可依需求標記 LocalBusiness 的地址、電話與營業時間,並與 Google Business Profile 保持一致。商家不能藉自己網站上的自評取得 review snippet 星等;aggregateRating 的適用性須另核對評論規範。個別專業人士與所屬商家是兩個實體,例如房仲可將 Person 與 RealEstateAgent 分別描述並連接,細節見房仲個人品牌與結構化資料的標記方法。
SaaS 與服務站的優先級是 Organization、WebPage(含 breadcrumb)、SoftwareApplication(如果是軟體產品)、Person(作者或團隊頁)。SaaS 站很少有 rich result 機會,但 Organization 與 SoftwareApplication 對知識面板與實體識別有幫助。
論壇與 UGC 的優先級是 QAPage(問答頁)、BreadcrumbList。問答格式對 AI 引用相對友善,但政策門檻高,需要真實的社群問答而不是自問自答。
活動與票務頁可評估 Event,持續維護開始時間、地點、票務與活動狀態。活動取消或改期時,按官方規範更新 eventStatus 及相關日期,不要把仍需保留的歷史紀錄改造成未來活動。
從這個分配可以看出,Organization 與 BreadcrumbList 是跨類型的最大公約數。任何網站如果只做一件事,先做這兩個。它們的實作成本最低、政策風險最小、對索引與實體識別的幫助最穩定。
台灣本地站的 Schema 細節:幣別、地址、營業時間與語系
英文教學直接搬到台灣會踩到一批本地化的坑。這些不是邊角細節,而是會直接讓 rich result 失效或顯示錯亂的硬傷。
價格欄位是最常見的問題。Product 的 offers.priceCurrency 必須填 TWD,不是 NT$ 也不是新台幣;price 填純數字 1290,不能寫 NT$1,290 或 1290元。幣別與數字分屬兩個欄位是 Schema.org 的硬規則,混在一起就解讀失敗。庫存欄位 availability 要用完整的 Schema.org URL(https://schema.org/InStock),不能只寫 InStock 字串。
地址是另一批錯誤來源。LocalBusiness 的 address 必須用 postalAddress 結構,把縣市、區、街道分到 addressRegion、addressLocality、streetAddress 三個欄位,不能整串塞進 streetAddress。台灣地址的書寫順序是從大到小(縣市到門號),與英文相反,但 Schema 欄位不分前後順序,只要分對欄位即可。郵遞區號 postalCode 應依中華郵政現行 3 加 3 六碼資料填寫。
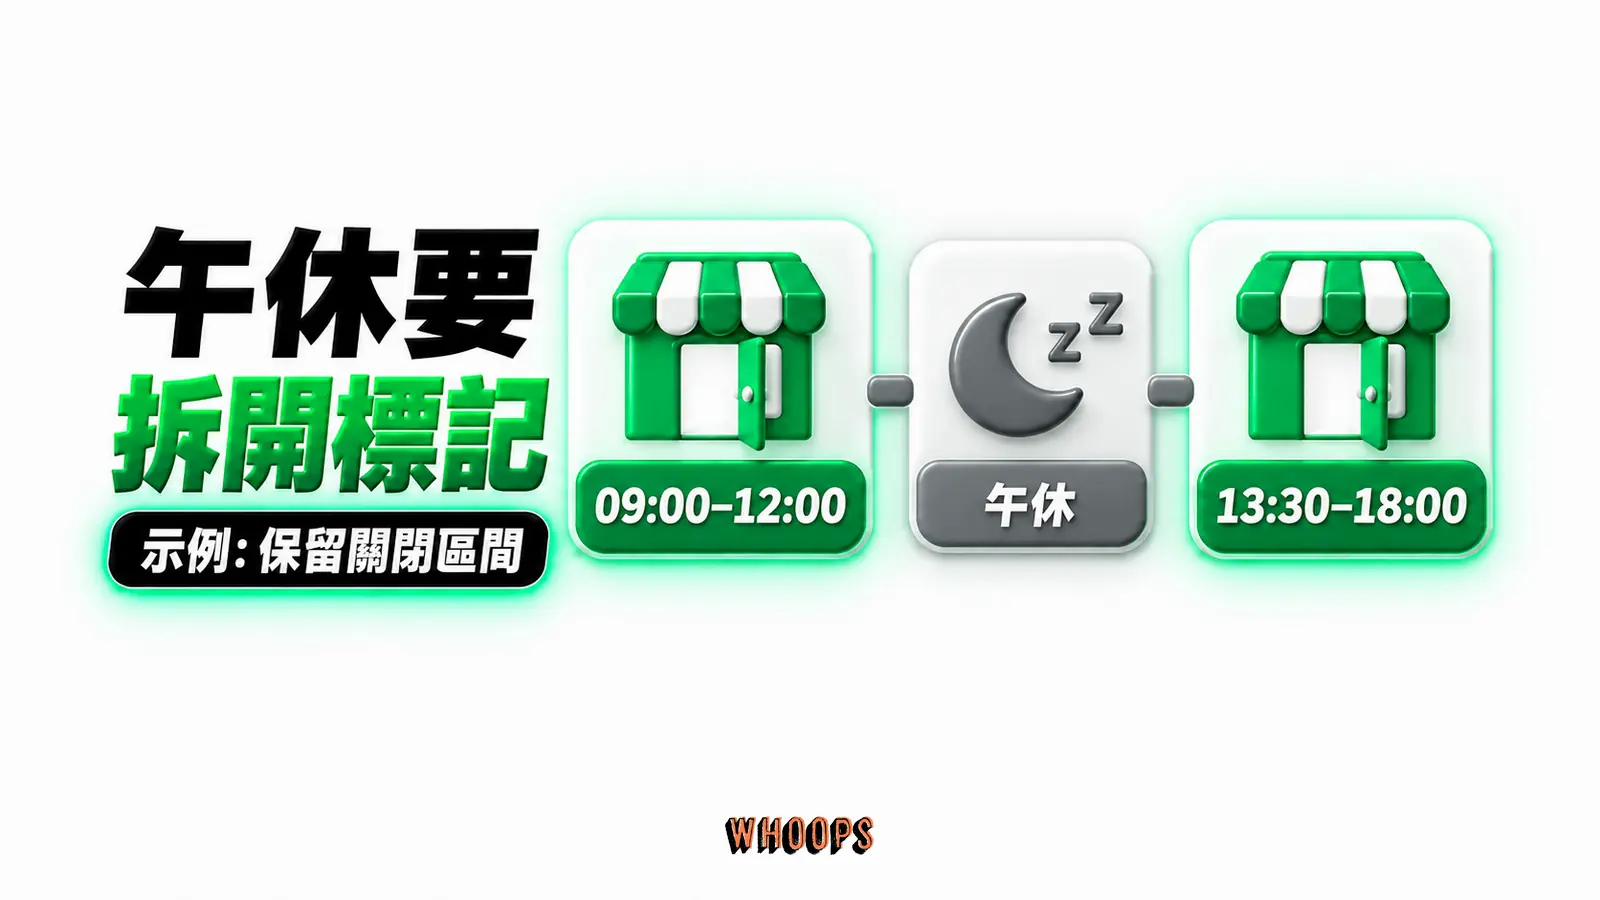
營業時間 openingHoursSpecification 是台灣服務業最容易標錯的欄位,因為多數店家中午有午休、週末營業時間不同。正確做法是把每個時段拆成獨立的 opens 與 closes 區塊,例如平日一個 09:00 到 12:00、另一個 13:30 到 18:00,週末另開一組。整段塞 09:00 到 18:00 會讓 Google 誤判午休時間有營業,本地搜尋帶來的到店體驗會直接受影響。
語系層面,inLanguage 應依實際內容選用合法的 BCP 47 標籤;zh-TW 本身有效,需要明示字體時也可用 zh-Hant-TW,不要宣稱只有一個正確值。統一編號可依用途使用 Organization 的 taxID,或用 identifier 搭配 PropertyValue;Google rich result 未必採用這些欄位。
結構化資料如何餵養 Google 的知識圖譜
前面談的多是 Schema 在 SERP 版位上的作用,但結構化資料還有一條長期、複利型的回報路徑,叫做知識圖譜(Knowledge Graph)。當你搜尋一個品牌名、一家公司、一個公眾人物,結果頁右側有時會跳出一個資訊面板,裡面有 Logo、官方網站連結、社群帳號、成立時間、簡介。那個面板背後的資料庫,就是知識圖譜。
知識圖譜的本質,是 Google 把網路上抓到的各種資訊,整理成一張「實體與實體之間關係」的巨大地圖。某家公司屬於哪個產業、它的創辦人是誰、它在哪些平台有官方帳號、它的 Logo 長什麼樣。Google 用這張圖譜來理解世界,也用它來即時組裝答案。
Organization 可提供組織名稱、官方網址、Logo 與社群檔案等資訊,協助辨識組織,但沒有公開依據可量化知識圖譜有多少資料來自這類標記,也不保證產生知識面板。延伸可讀Entity SEO 的核心概念。
Google 官方的搜尋功能清單可用來核對類型與資格。部分功能要求結構化資料,但不能概括為所有搜尋呈現都必須有標記;例如 Top stories 沒有 Article 標記的必要條件。
點擊率才是結構化資料的實質回報
Schema 既然不是排名的直接開關,那它的報酬到底從哪裡回收?答案是點擊率。豐富結果的真正價值,是在不動排名的前提下,讓更多人心甘情願點你。
用具體場景體會最有感。兩個賣同一支耳機的電商頁面,排名差不多。一個站沒有任何結構化資料,搜尋結果就是乾乾的標題加描述。另一個站標記了 Product Schema,搜尋結果上直接秀出 4.6 顆星評分、特價 2990 元、寫著「庫存中」。同樣在第五名的位置,多數人會點後者,因為它在視覺上更可信、資訊也更完整。
點擊率差異需要實際量測,不能把一般排名 CTR 研究當成 Schema 帶來流量或排名提升的因果證明。可記錄設定前後的查詢、位置、裝置與搜尋呈現,再解讀變化;版位背景可參考SERP 搜尋結果頁全解析。
用 Search Console 量化 Schema 的實際報酬
Schema 既然不是排名開關,要說服團隊或自己繼續投入,就必須能量化它的報酬。很多人標完 Schema 就停在那裡,從來沒回頭量過到底換到了什麼,這也是很多 Schema 專案做完就荒廢的原因,因為沒人講得出它賺回了什麼。
量化的核心工具是 Search Console 的成效報告,搭配增強項目或 rich result report 交叉看。先用 rich result report 驗證標記的資格與錯誤狀態,再到 Performance 的 Search appearance 確認實際曝光;前者不能證明豐富結果真的顯示過。
量測時可採同頁前後比較,並按相近查詢、位置與裝置分層。即使觀察到 CTR 差異,也可能受排名、查詢、裝置、版面與頁面品質影響,因此只能視為觀察性差異,不能用兩組平均直接證明 Schema 的因果溢酬。
Product 的 CTR 變化沒有可通用的固定範圍,應以實際 Search appearance 量測。Article 則只量實際可觀察的搜尋呈現與錯誤狀態;若要評估品牌搜尋或 AI 引用,需另設研究方法,且不可把結果歸因給 Article Schema。
AI 搜尋中的結構化資料:用途與限制
網頁的 Schema.org 標記與模型輸出的 JSON 格式是不同用途,不能從模型支援結構化輸出,推論網頁加 JSON-LD 就更容易被引用。評估 AI 搜尋時,仍應回到服務商公開的存取與內容規範。
本地商家的地址、電話與營業時間應在網站、標記及商家檔案中一致。這有助於維護正確資訊,但不能保證任何 AI 回答都不會誤解;重要資訊仍應讓讀者能點回官網查證。
這也把結構化資料拉進一個更大的新戰場,叫做 GEO(Generative Engine Optimization,生成式引擎優化)。它的核心邏輯跟傳統 SEO 一脈相承:讓你的內容對機器來說最容易正確理解、最容易可信引用,你就更容易成為 AI 答案裡被點名的那一個。想理解 SEO 與 GEO 的差異與機會,可以看GEO 是什麼,延伸閱讀可以看品牌如何在 AI Overviews 勝出與品牌要成為被推薦的答案。
至於「標記做了,AI 引用就會跟著變多」這類假設,站內現在有專文把第三方實測證據與迷思分開整理:結構化資料與 AI 引用的實證檢視攤開幾份追蹤研究與放置測試的原始數字,部署標記前先讀一遍,投資報酬的預期會更踏實。