AI SEO 完整指南:搜尋存取、內容查證與引用追蹤
AI SEO 完整指南:區分模型訓練、網頁檢索與來源引用,整理技術存取、內容查證、結構化資料及成效衡量,附九十天工作排程範例。
本頁目錄
- 先講結論:SEO 的終點改變了,起點卻沒有
- 被引用一次,值多少?算一筆多數人沒算的帳
- 三個會讓你誤判 AI SEO 的迷思
- 拆開 AI 搜尋:模型在「讀」你的網站時,到底發生什麼事
- 第一層:模型「以前」讀過你嗎(訓練階段)
- 第二層:模型「現在」找得到你嗎(檢索階段)
- 第三層:模型「敢不敢」引用你(接地與驗證階段)
- 從「被引用」倒推:召回、選擇、引用三道關卡
- 階段一:召回(Retrieval),先進得了候選池
- 階段二:選擇(Selection),被選得上
- 階段三:引用(Citation),掛得上名字
- 別忽略 Query Fan-out:一個問題會被拆成一堆子問題
- 查詢變長了,你的關鍵字策略卻還停在短詞
- 讓內容更容易理解:chunkable content 的編輯原則
- 小標說清楚,答案盡快出現
- 表格要能獨立看懂
- 控制段落長度,避免跨塊斷裂
- 要不要讓 AI 爬你:robots.txt 與訓練協議的取捨
- 兩個讀者,一套內容:寫給「會點的人」也寫給「會摘要的人」
- 用 E-E-A-T 檢查經驗、來源與責任歸屬
- 把經驗寫成「可被摘錄的證據」
- 讓作者這個人,成為一個可被查證的實體
- 同主題的「厚度」,比單篇的「長度」重要
- 哪些內容特徵有助於查證:四個編輯重點
- 一、明確的數字與來源
- 二、可獨立成立的結論句
- 三、結構清楚的對比與步驟
- 四、新鮮度與時效性
- 實體與結構化資料:整理可核對的品牌資訊
- 結構化資料:你寫給機器的名片
- 一致性:先解決名稱、規格與版本衝突
- 「種子問題」追蹤法:每月一次的可見度健檢
- 十項網站與內容檢查:先確認問題再修正
- 被引用之後:怎麼追蹤 AI 帶來的流量與影響
- 有點擊的:把 AI 來源流量看清楚
- 沒點擊的:用「可見度」取代「流量」當指標
- 當模型把你講錯了:幻覺與補救
- 90 天行動清單:從今天開始的具體步驟
- 第一個月(第 1 到 30 天):打底與健檢
- 第二個月(第 31 到 60 天):把骨架埋進去
- 第三個月(第 61 到 90 天):加厚與驗證
- 把舊地基,用在新建築上
先講結論:SEO 的終點改變了,起點卻沒有
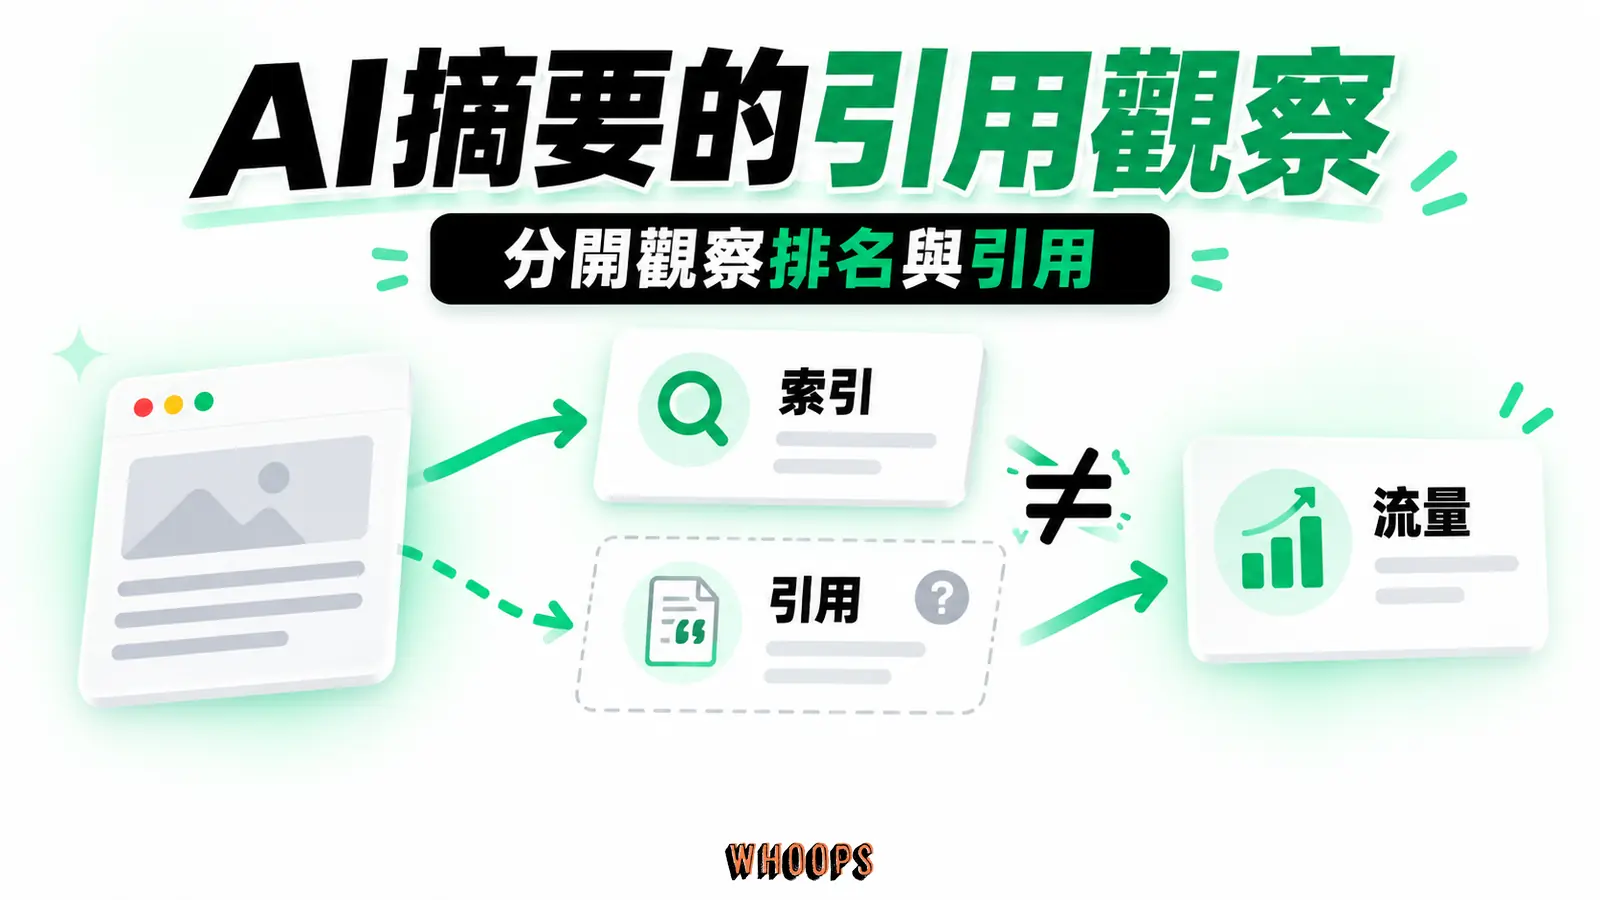
網站自然流量下降時,應同時檢查查詢需求、曝光、排名、點擊率與技術狀態。AI 搜尋介面可能影響使用者如何取得答案,但不能只看到排名持平,就把流量下滑歸因於 AI。
這篇要回答的核心問題只有一個:在 AI 搜尋時代,SEO 到底還做不做、怎麼做,才能不只排在第一頁,還能被 AI 引用與推薦?
答案先講在前面:SEO 仍然要做,但不能再把「排名」直接等同於「流量」。AI 搜尋增加了來源連結、品牌提及與答案曝光等觀測面向;被引用可能有價值,卻不等於影響力,也必須搭配實際進站、轉換與品牌調查判讀。
重點摘述:AI 搜尋仍建立在可抓取、可索引、可靠且對讀者有用的內容上,不需要特殊 AI Schema 或固定寫作格式。站方可以維持名稱與事實一致、清楚交代來源,並把傳統搜尋曝光、AI 支援連結與實際進站分開追蹤。
若只需要執行步驟,可直接看最後的 90 天行動清單;若要理解原因,下面會先拆解完整邏輯。對 SEO 基礎還不熟,可先參考SEO 完整指南;若想按順序練習新規則,免費 SEO 課程的 AI 搜尋單元涵蓋 AI 摘要、AI Mode、查詢擴展與零點擊。
被引用一次,值多少?算一筆多數人沒算的帳
先換個方式想這件事。傳統 SEO 的單位是「一次點擊」。一個人在 SERP(搜尋結果頁)上看到你、點進來、讀完,這是一筆交易:你用排名換到一次注意力。
AI 搜尋的單位換了。變成「一次引用」。一個人問 AI 一個問題,模型把你的內容消化、摘要,直接把答案端到使用者面前,然後附上一個來源標記。很多時候,使用者根本不會點進來。
聽起來像吃虧,對吧?流量被「截胡」了。但帳不是這樣算的。
左右捲動檢視完整表格
| 維度 | 傳統排名點擊 | AI 引用推薦 |
|---|---|---|
| 單次帶來的流量 | 一次造訪 | 可能沒有進站點擊;品牌提及與來源連結需分開記錄 |
| 信任傳遞 | 讀者自己判斷你信不信 | 列為來源不等於替品牌背書,讀者仍需查證 |
| 擴散範圍 | 限於那一次搜尋的人 | 分享與後續影響需另行觀察,不能由一次引用推定 |
| 持續性 | 排名與流量會隨需求、競爭而變 | 引用同樣會隨查詢、產品與時間改變 |
被引用代表內容被列為回答來源之一,不等於模型替品牌背書,也沒有「借走九成權威性」這種可量化效果。使用者是否信任、點擊或採取行動仍受回答品質、品牌熟悉度與任務情境影響。
引用與排名帶來的價值需要用實際資料比較。可追蹤來源曝光、進站與後續轉換,再評估是否值得投入;沒有通用依據可以宣稱一次引用通常比搜尋第一名更有價值。
這幾年行銷人對 AI 帶來的改變感受很深。根據 HubSpot 的年度報告(2026),全球行銷團隊導入 AI 的比例與用途都在快速擴張,從內容產製到搜尋行為分析都是。而 HubSpot 資料庫裡的行銷統計也顯示,使用者越來越習慣在消費決策前先向 AI 詢問推薦與比較,把傳統搜尋流程往後挪。搜尋這一端的位移,不是未來式,是現在進行式。
SparkToro 與 SimilarWeb 的零點擊研究指出,大量 Google 搜尋沒有產生前往開放網頁的點擊。不同資料集對範圍與分類方式可能不同,也不能只靠這份研究量化 AI Overviews 或 AI Mode 增加了多少零點擊。實務上可把 AI 來源曝光列為補充指標,但不能取代自然排名、點擊與轉換。
三個會讓你誤判 AI SEO 的迷思
觀念講完了,但實務上把最常踩的三個認知坑整理出來。這三個迷思的共同點是:它們聽起來都「很有道理」,所以才危險。一個錯的前提,會讓你把力氣全花在錯的地方。
左右捲動檢視完整表格
| 迷思 | 為什麼是錯的 | 正確的做法 |
|---|---|---|
| 「AI SEO 就是寫給 AI 看的內容」 | 模型和使用者讀的是同一份網頁;討好機器而犧牲真人體驗,兩邊都會輸 | 先寫到對真人有用,再把可摘錄性疊上去 |
| 「被引用靠的是字數和關鍵字密度」 | 沒有通用字數或密度公式;為操弄搜尋而堆砌關鍵字可能違反政策 | 把一個概念講透、講一致,比重複一百次有用 |
| 「傳統 SEO 可以先放掉,全力衝 AI」 | Google 生成式搜尋使用其搜尋索引與品質系統;其他產品應分別查核 | 把 AI 優化當作傳統 SEO 的延伸層,不是替代品 |
AI 搜尋工作可以沿用既有的技術、內容與成效管理流程。調整資源前,先核對目標平台的官方要求與目前網站缺口,再訂定可驗收的工作;不要只因名稱改變就停止原本有用的維護。
拆開 AI 搜尋:模型在「讀」你的網站時,到底發生什麼事
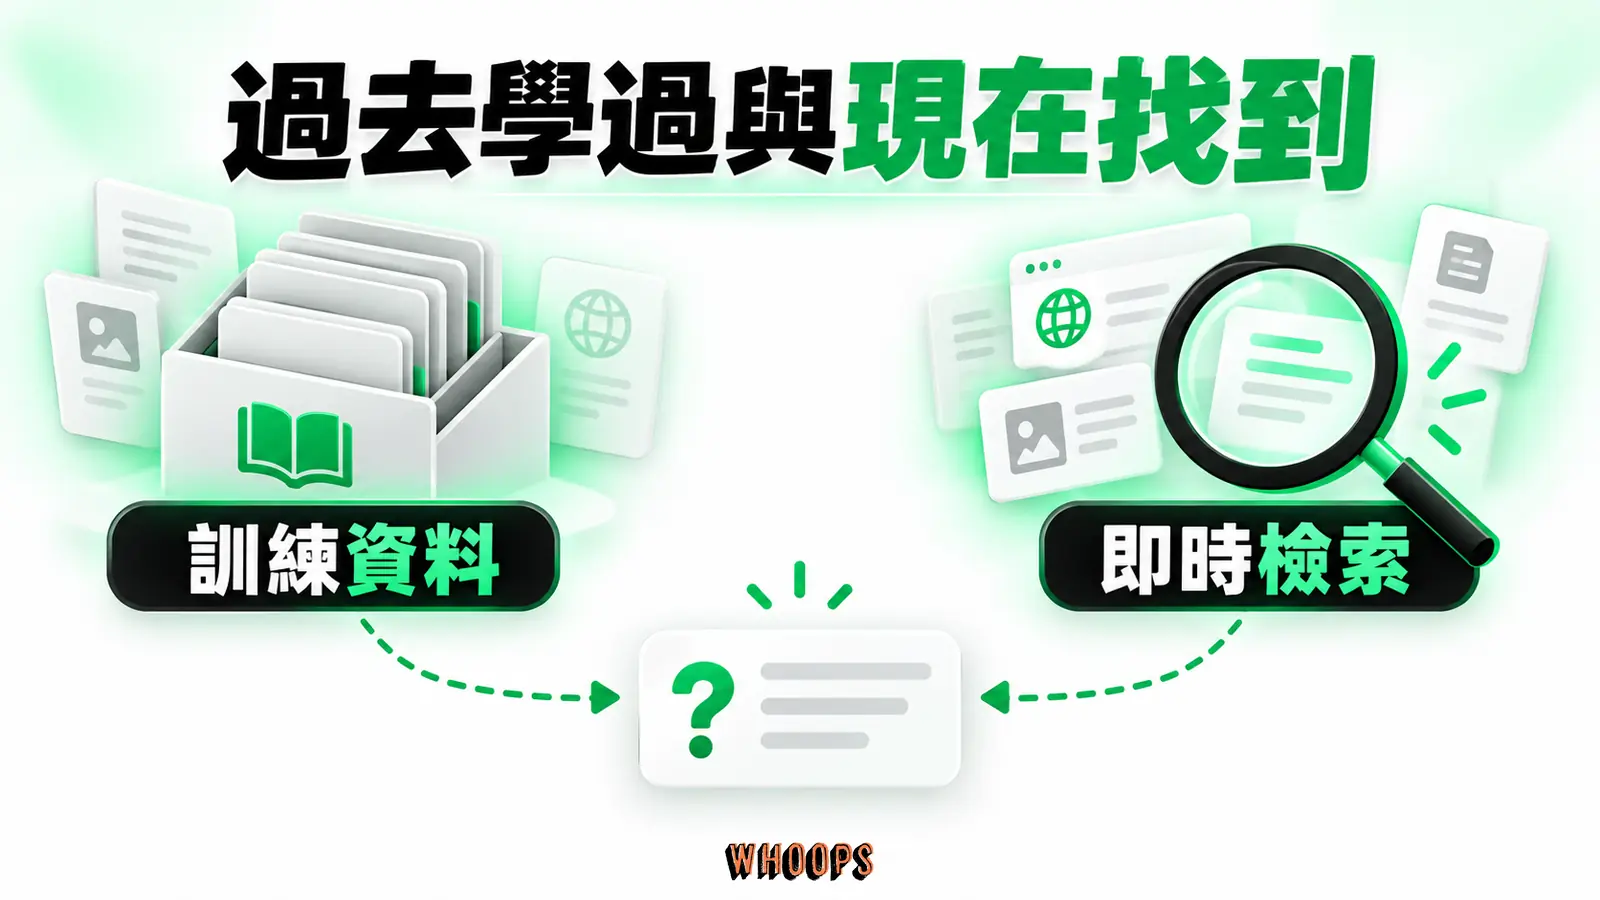
要討論被引用,得先分清楚訓練、即時檢索與回答生成。不同產品使用的索引、模型與引用機制並不相同,外部網站也看不到完整的選源權重;下面的三層是理解流程的模型,不是各平台公開的排名公式。
以下用一個白話的拆解,把它分成三層。
第一層:模型「以前」讀過你嗎(訓練階段)
大型語言模型的基礎知識來自訓練資料,但外部網站通常無法確認自己的內容是否被納入,也無法直接控制模型如何記住品牌或論點。這一層適合用來理解沒有即時檢索時的回答限制,不適合當成可量化的 SEO 操作。
公開資訊應保持正確並依需要維護,但站方不能因此保證內容被納入下一代模型的訓練。訓練用途與搜尋存取是不同決策,應依服務商提供的控制方式分別設定。
第二層:模型「現在」找得到你嗎(檢索階段)
啟用檢索的產品,可以先取得與問題相關的資料,再用它支撐回答。RAG(檢索增強生成)描述這類方法;是否執行網頁搜尋、使用何種索引,以及如何顯示來源,會隨產品與模式不同。
如果產品使用即時網頁檢索,頁面能否被相應的搜尋索引或爬蟲找到,就會影響它是否有機會成為來源;這不代表所有 AI 產品都直接使用 Google 索引。關於檢索增強生成的基本機制,我們另外寫了 RAG 入門。
以 Google 生成式搜尋為例,頁面需要具備索引與摘要資格,並符合其生成式功能設定。可檢查 noindex、爬取限制與 canonical 是否符合原意;使用 JavaScript 本身不等於無法索引,仍要確認實際渲染結果。其他 AI 服務則須另查其規範。
第三層:模型「敢不敢」引用你(接地與驗證階段)
找到不代表會用。模型在接地(grounding)階段,會根據檢索到的資料生成回答並附上來源。說法明確、前後一致、來源可查證,能降低人和機器誤讀的風險,但沒有公開證據能保證某種段落格式一定更容易被引用。
關於接地策略的完整討論,站上另有一篇 AI 接地的 SEO 策略。這裡先記住一個重點:不要為了追求字數犧牲清楚度,也不要把「短句」誤當成 AI 引用的硬門檻。
把這三層疊起來,你會發現一件讓人安心的事:AI 搜尋並沒有推翻 SEO,它只是在傳統 SEO 的每一層上面,又加了一個「機器會怎麼讀」的檢查。你以前做的技術優化、內容品質、外部連結,全都是這三層的地基。覺得這幾個縮寫(AISO、GEO、AEO、LLMO)讓你眼花,可以先把 SEO、AI SEO、GEO、AEO、LLMO 總覽讀一遍,回來看這篇會更順;如果你特別想從 GEO 著手,GEO 核心原則把五道關卡一次講清楚;若想先把 SEO、AEO、GEO 三個表面怎麼分工、資源怎麼分配看清楚,可以另開〈SEO、AEO、GEO 差異與資源分配〉來看。
從「被引用」倒推:召回、選擇、引用三道關卡
以下將檢索、來源選擇與引用呈現分開討論,方便安排觀察工作。這是作者的說明框架;外部報表無法完整揭露模型的內部候選池,也不能從一次未被引用就確定是哪個階段出問題。
階段一:召回(Retrieval),先進得了候選池
模型回答問題前,可能先用檢索系統從索引裡找出相關內容,這一步叫召回。候選數量與選取方式依產品而異,外部網站無法知道固定門檻。能做的仍是讓重要頁面可被發現、可被索引,並在主題上提供真正有用的內容。
階段二:選擇(Selection),被選得上
候選內容不只一份時,系統還要判斷哪些資料適合支撐回答。直接回答問題、交代限制與來源,對讀者本來就比較有用;但 Google 已明確表示,內容不需要為生成式搜尋刻意切成很小的區塊,也沒有「答案一定要放第一段」的公開門檻。
階段三:引用(Citation),掛得上名字
回答生成後,系統可能顯示支撐內容的來源連結。具名作者、第一手證據與一致的品牌資訊有助於讀者判斷可信度,但各平台沒有公開一套可供站長直接計分的「引用權重」。
檢查時可分別記錄頁面能否存取、內容是否適合該問題,以及回答是否顯示來源。這三個觀察面向有助於整理證據,不能當成每個模型固定依序執行、可由站方直接診斷的關卡。
別忽略 Query Fan-out:一個問題會被拆成一堆子問題
Google 的 Query Fan-out 會產生一組相關查詢,以取得補充資訊。內容規劃仍應依讀者任務決定:有些問題適合一篇完整指南,有些需要獨立說明;沒有必須為每個子問題另開一頁的規則。主要為操弄搜尋或 AI 回答而大量製作查詢變體頁面,也可能違反垃圾內容政策。
查詢變長了,你的關鍵字策略卻還停在短詞
前面拆解了模型讀你的三個階段,但模型讀什麼,是由使用者怎麼問決定的。而使用者問問題的方式,這兩年已經悄悄換了一個形態,多數網站的關鍵字策略卻還停在舊的那套。
傳統搜尋是「短詞檢索」。你在關鍵字工具裡看到的那一欄一欄的字,多半是兩到五個詞的短語:SEO 工具、網頁設計、關鍵字研究。使用者在搜尋框裡也是這樣輸入,像在對一個目錄下指令。背後假設是:使用者知道自己要找什麼,只是用最短的詞讓目錄去匹配。
AI 搜尋常以帶脈絡的完整句子互動,例如:「我有一個做跨境電商的網站,主力市場在美國,想找能處理多語言 SEO 與技術健檢的工具,預算有限,有什麼選擇?」其中包含行業、市場、需求組合與預算限制,這些條件可用來發現傳統短關鍵字報表未必呈現的內容缺口。
生成式搜尋讓完整問句與多輪探索更值得納入關鍵字研究,但這不代表短詞只剩導航用途,也不能保證回答長問句就會被引用。較實用的做法,是同時盤點簡短主題詞與帶條件的比較、成本、風險問題,確認內容有沒有覆蓋讀者真正的決策脈絡。相關介面可參考 Google AI Overviews 指南。
整理問句時,除了資訊、交易與導航等意圖,也可以記錄比較條件、個人情境及可能的追問。這是發現內容缺口的編輯方法,不能宣稱這些類型必然最常被 AI 引用。
實作上,可以把現有關鍵字清單裡的高價值詞,逐一改寫成「真人會問 AI 的問句」。例如把「SEO 工具」展開成「免費 SEO 工具有哪些適合新手」或「小公司預算有限,付費 SEO 工具怎麼選」。這不是要丟掉短詞,而是補上它背後可能對應的問題與條件。模型可以協助產生候選問句,但清單仍要用搜尋結果、客服問題與實際受眾資料驗證;可參考Atlas 時期的 ChatGPT SEO 前置流程及現行替代方式。更系統化的方法可搭配關鍵字研究指南。
讓內容更容易理解:chunkable content 的編輯原則
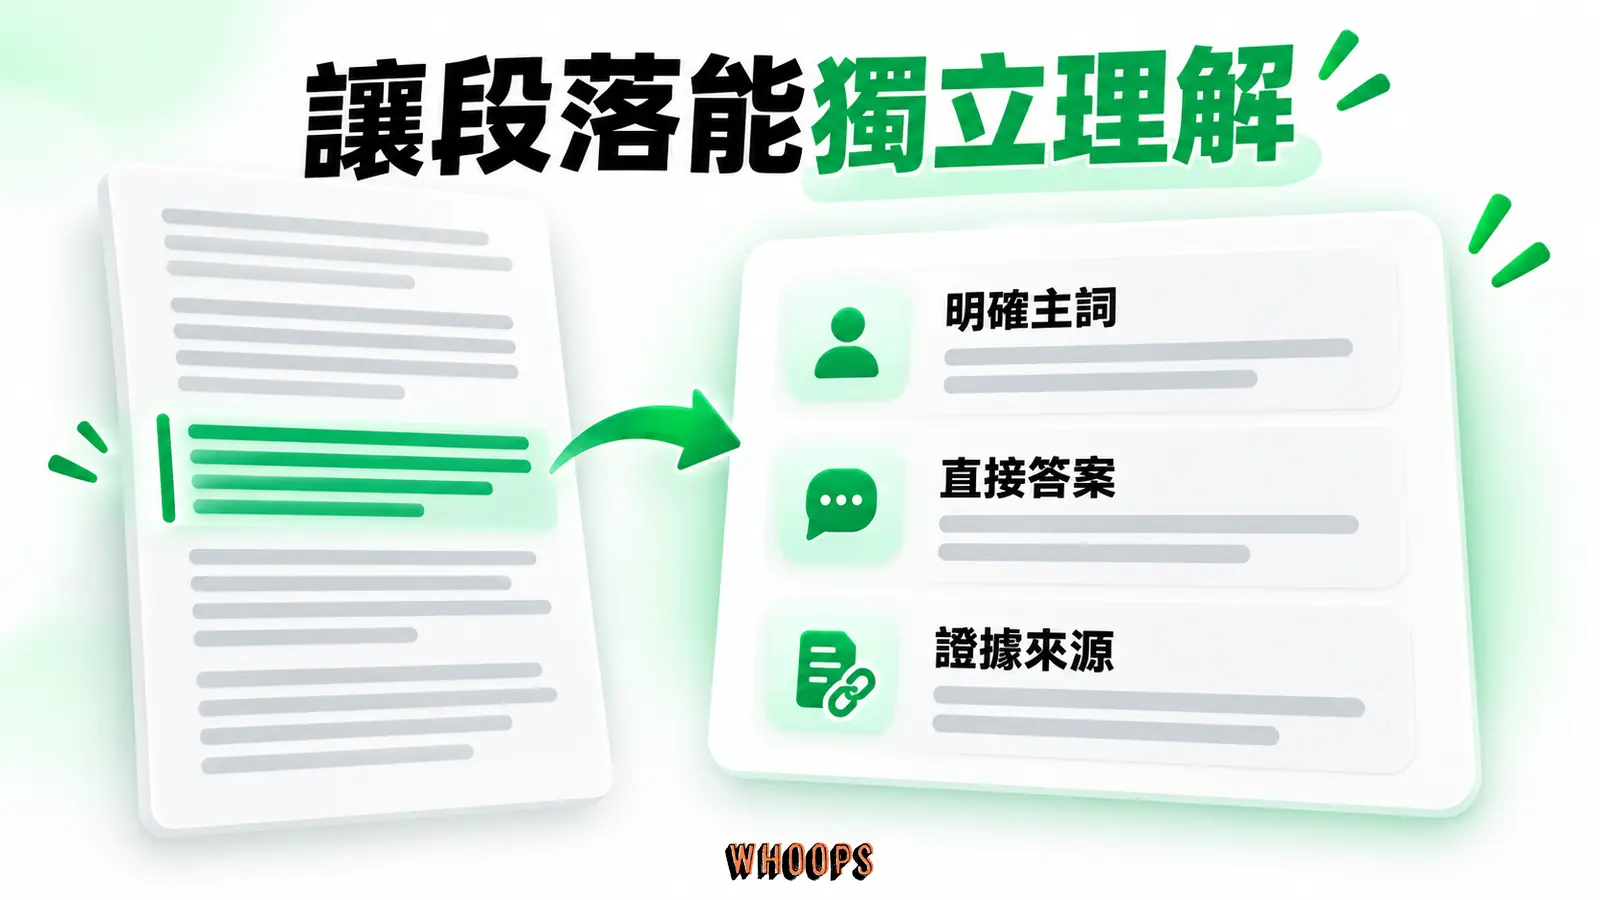
RAG 系統常把文件分成較小的檢索單位(chunk),但不同系統的切分方法並不公開,也不代表網站必須依固定字數改寫。Google 的官方說明也明確表示,不需要為生成式搜尋把內容刻意拆成細碎區塊。
真正值得保留的是編輯原則:條件、否定與結論要寫清楚,標題和段落關係要容易追蹤。這能降低讀者斷章取義的風險,也有利於一般搜尋系統理解內容,但無法替任何模型指定切分邊界。
所謂 chunkable content(可分塊內容),可以當成「每個小節都有清楚功能」的編輯提醒,不是 AI 搜尋的技術規格。寫作仍應以真人讀者的理解與主題需要為準。
小標說清楚,答案盡快出現
H2、H3 應清楚說明小節主題;讀者需要快速答案時,可以在第一段直接回答,再補證據與例外。不必把每個標題都硬改成問句,也不能假設模型一定以標題作為切分邊界。
表格要能獨立看懂
表格若依賴上文才看得懂,讀者容易誤解。標題、欄位名稱與必要註解要交代清楚,表格前可用一句導讀說明它在回答什麼問題。這是可讀性與無障礙的基本要求,不是因為模型「特別愛表格」。
控制段落長度,避免跨塊斷裂
段落長度沒有通用的 AI 門檻,也不該用三百字當硬規則。當一段同時塞了多個論點、條件與例外時,再依語意拆段;如果一段長文仍然連貫,就不必為了模型強行切碎。
這三個原則的目的,是讓標題、段落與表格各自負責清楚的資訊功能,同時保留全文的敘事連貫。內容不需要改造成碎片集合。
要不要讓 AI 爬你:robots.txt 與訓練協議的取捨
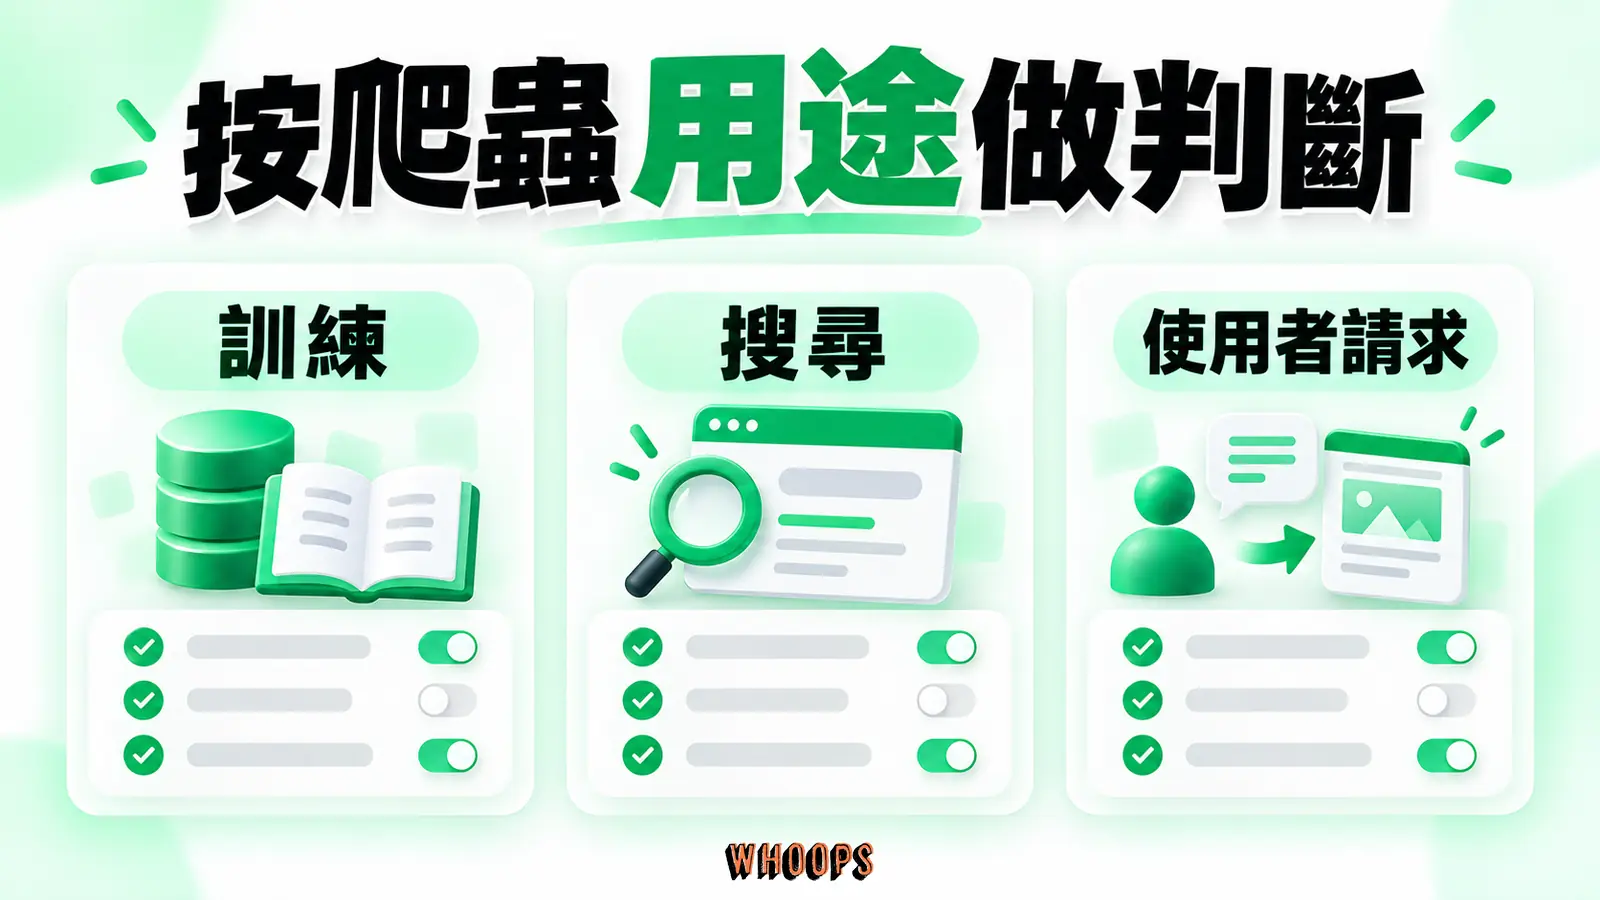
接下來這個決策,是 2024 年以後每個內容站都得認真做一次的功課,而且沒有標準答案:到底要不要讓 AI 爬你。這件事之所以現在變複雜,是因為「被搜尋引擎索引」跟「被模型拿去訓練」已經拆成兩件不同的事,而且各自有不同公司、不同爬蟲在背後運作。
搜尋索引與模型訓練有不同目的,不能說它們以前是同一件事,或曾經只有 Google 爬取網站。現在各服務提供的爬蟲名稱與用途也不同,設定前應查明是在管理搜尋、訓練,還是使用者主動觸發的存取。
主流服務通常會把不同用途拆成不同 User-agent。以 OpenAI 為例,GPTBot 用於模型訓練,OAI-SearchBot 用於搜尋;Anthropic 也分列 ClaudeBot、Claude-SearchBot 等爬蟲。CCBot 是 Common Crawl 的爬蟲,PerplexityBot 則用於 Perplexity 的搜尋產品。依 Google Search Central 的爬蟲與 User-Agent 總覽,Google-Extended 是 Google 提供的獨立控制權杖,不會影響網站在 Google 搜尋中的收錄或排名。實際名稱與用途可能更新,設定前要查各公司官方文件;伺服器日誌則能協助確認網站實際收到哪些請求,做法見〈從伺服器日誌看 AI 爬蟲〉。
Google-Extended 是 robots.txt 的控制權杖,不是日誌中獨立的 HTTP User-agent。它管理 Google 擷取內容供未來 Gemini 模型訓練,以及 Gemini Apps、Vertex AI 指定接地用途的使用;不影響 Google 搜尋收錄或排名。Google 搜尋功能另依其規範管理,實作背景可參考技術 SEO 指南。
OpenAI 與 Anthropic 都在官方文件列出不同用途的 User-agent,可分別設定訓練與搜尋爬蟲,而不是只封一個名稱就涵蓋所有產品。規則應依最新官方清單維護,例如 Anthropic 的 web crawler 文件。
2024 年出現的 llms.txt 是一項自願提案,用純文字整理網站提供給 LLM 的內容,規格定義於 llmstxt.org 的規格文件。它不是 robots.txt 的替代品,Google 搜尋也明確表示不使用 llms.txt 作為生成式搜尋的特殊訊號。Global Privacy Control(GPC)原本處理個資出售或分享的隱私偏好,不能直接當成通用的 AI 訓練拒絕協定。這些機制的適用範圍不同,不能混用。
那到底要不要封?建議按內容型態分開決策,不要一刀切。
- 公開品牌內容、產品頁、知識庫、深度長文:先決定要開放哪些搜尋與訓練用途,再依各服務的 User-agent 分別設定。允許訓練不保證能換到引用或能見度。
- 付費內容、會員專屬、有版權限制的素材:用登入驗證與權限控制保護內容,再視需求設定爬蟲。robots.txt 不是存取控制,不能用來保護付費內容。
- 含個資、客戶資料、內部文件的頁面:必須用身分驗證、網路層限制等存取控制阻擋未授權者,不能只靠 robots.txt。
不要把「AI 爬蟲」當成一個整體。不同公司、用途與控制方式要分開盤點;同時把公開內容的爬取偏好和私密內容的存取控制分成兩件事處理。robots.txt 與訓練用途的設定可以放進後面 90 天清單的技術健檢,但它不取代登入、授權或其他安全措施。
兩個讀者,一套內容:寫給「會點的人」也寫給「會摘要的人」
這是整個 AI SEO 裡最被低估的一個觀念。你的內容現在同時被兩種對象讀,不只一種。
第一種,是會點進來、會感受排版、也會被開頭故事打動的真人。第二種,是可能透過搜尋、檢索與生成流程處理內容的系統。兩邊都需要清楚且一致的資訊;差別在於系統未必能從語氣或情境猜出你省略的條件。
如果產品團隊在官網、登入頁、社群與訪談裡,對同一功能使用不同名稱或互相衝突的描述,讀者與搜尋系統都更難確認哪一版正確。模型可能引用任何可取得版本,不是「永遠抓最舊、重複最多」;因此要建立命名與版本紀錄,並修正公開頁面的過時資訊。
左右捲動檢視完整表格
| 維度 | 寫給真人讀者 | 寫給模型讀者 |
|---|---|---|
| 開頭 | 可以用故事、情境鋪陳 | 盡快交代主題與可核對的結論 |
| 術語 | 可以用比喻化解 | 重要術語保持意思一致,必要時解釋同義名稱 |
| 段落 | 可以感性、可以留白 | 要有明確的主題句,方便對齊 |
| 數字 | 四捨五入時仍需保留合理精度與來源 | 標示數值、條件、日期與來源,未知或估計也要說明 |
每個重要概念應有清楚定義,並保留適用條件與來源。這能讓讀者更容易理解與查核;文章仍可使用故事、例子與推理,不必追求每句都能被逐字摘錄。
實作上,建議先替每個核心主題整理一份「標準事實」:講清楚它是什麼、解決什麼、跟誰有關。官網說明、關於頁與文章若提到同一項產品事實,名稱、版本與限制應一致;各頁仍要依讀者需求改寫,不必複製同一段文字,也沒有三十到六十字的門檻。
以戶外用品電商為例,產品頁若提到材質、適用爐具與保固,就應備妥可核對的規格或條款。其他頁面可以用不同寫法介紹,但事實與版本須一致;檢驗認證也只有在確實取得且適用時才能宣稱。
若不同頁面的材質或保固描述互相矛盾,先核對正確規格並修正過時版本。問題在於讀者無法確認資訊,而不是能直接預測模型會引用哪個版本或競爭者。
用 E-E-A-T 檢查經驗、來源與責任歸屬
AI 能快速產生大量通用內容,但這不代表人工內容必然更有價值。較有區辨力的素材通常來自可驗證的第一手經驗、專有資料、清楚責任歸屬與持續更新;是否能取得搜尋或商業成效,仍要以實際需求與資料驗證。
AI 無法替作者取得真實的 Experience(第一手經驗)。E-E-A-T 裡的 Experience 和 Expertise,有助於讀者與搜尋系統評估內容是否可靠;但沒有公開資料能證明它們是所有模型選擇引用時權重最高的固定過濾器。
AI 搜尋讓來源查證更受關注,但沒有公開資料能證明 E-E-A-T 的演算法權重因此被統一放大。E-E-A-T 是 Google 品質評估概念,不是站方可直接填寫的分數;實務上仍應讓作者、方法、來源與修訂紀錄可查。完整框架可參考 E-E-A-T 指南。
把經驗寫成「可被摘錄的證據」
單憑「做過」「經手過」這類宣稱,本身不是證據。真正有用的是把可公開的經驗交代清楚:處理什麼問題、使用什麼方法、觀察到什麼,以及哪些限制仍然存在。不要為了營造第一手感而捏造產業、客戶或數字;沒有實作證據時,直接引用可查證來源。
例如,「我們擁有豐富的產業經驗」只是公關話術;若真的做過測試,就應交代測試對象、期間、改動與結果,並保留可驗證紀錄。具體不等於可以杜撰匿名案例,資料不能公開時也要刪除可識別指紋,清楚標示限制。
讓作者這個人,成為一個可被查證的實體
作者頁可交代姓名、相關經歷、作品與責任歸屬,讓讀者判斷內容由誰製作。資料必須真實且與主題相關;Google 鼓勵在合理情境提供作者資訊,但不能把作者簡介換算成所有模型的固定權重。
同主題的「厚度」,比單篇的「長度」重要
相關內容可以透過清楚導覽與內部連結協助讀者深入理解。要寫一篇完整指南還是分成多篇,取決於任務與資訊量;篇數或是否有支柱頁,都不保證排名或 AI 引用較好。
哪些內容特徵有助於查證:四個編輯重點
外部測試很難還原模型的選源權重,不能把幾次種子問題結果當成普遍規則。下面四點的價值,在於讓內容更容易閱讀、查證與維護;是否被引用仍受查詢、索引與系統差異影響。更多整理可以看 AI 偏好的內容類型。
一、明確的數字與來源
具體主張應附上可追溯來源,讓讀者能核對內容,也降低轉述時失真。這是可靠寫作的基本要求,但各模型沒有公開「有來源句子一定優先」的固定規則。
二、可獨立成立的結論句
重要結論應有清楚主詞並交代必要條件,避免只有模糊轉折或缺少指涉。這是可讀性的改善;不能聲稱改成自足句型就會立刻提高引用機率。
三、結構清楚的對比與步驟
表格、條列與編號步驟適合呈現比較或流程,但不是每篇長文都必須放表格。資訊關係適合表格時才用,敘事與推理需要上下文時就保留段落,不要為了猜測模型偏好而犧牲閱讀。
四、新鮮度與時效性
回答價格、版本、法規或年度趨勢時,資料日期會直接影響正確性,因此要定期核對原始來源。常青主題不必只為顯示新日期而改寫,也不能把「較新」當成所有模型與查詢的固定偏好。
這四點指向同一件事:讓內容的主張、來源、結構與更新狀態都容易核對。這能提高內容品質,但不能保證任何模型一定引用。
實體與結構化資料:整理可核對的品牌資訊
網站通常無法確認自己的內容是否被納入模型訓練,也不能用 Schema 讓模型必然記住品牌。此處的實體整理,是維護品牌、產品與人物資訊的方法。
實體與關係有助於整理品牌、產品與作者資訊,但外部網站看不到各搜尋或 AI 系統如何建立與使用這些關係。站方能做的是統一名稱、提供可查證資訊,並用符合頁面內容的結構化資料表達;不能保證模型因此更容易召回品牌。
結構化資料:你寫給機器的名片
結構化資料(Schema)用標準格式描述文章、作者、產品或組織等資訊。它不會直接讓排名變好,Google 也明確表示,生成式搜尋不需要特殊 Schema。仍可依頁面內容與 Google 支援的搜尋功能佈建適用類型,且標記必須與可見內容一致。完整實作寫在 結構化資料指南。
結構化資料不是 AI 搜尋的入場券,也沒有證據顯示欄位最多的頁面一定更容易被引用。優先填寫適用、正確且能長期維護的欄位,不要為了完整度標上頁面不存在的內容。
適合哪些 Schema 類型,應由頁面內容與所需搜尋功能決定。組織資訊可評估 Organization,作者則依文章與人物頁的內容描述;所有屬性必須真實且能維護,不應把欄位數量視為模型辨識或引用的保證。
一致性:先解決名稱、規格與版本衝突
品牌名稱、服務與產品資訊應能在官網、社群與報導中互相核對。描述可以依平台調整,但重要事實不應矛盾;目前沒有跨平台公開的信心分數公式可用來預測引用。
一致性不只是文案美學問題。名稱、規格與官方描述若彼此衝突,讀者和搜尋系統都更難判斷哪一版正確。
「種子問題」追蹤法:每月一次的可見度健檢
可依需求設定固定觀察週期,分別記錄品牌提及、來源連結與實際進站。Google 已提供 Search Console 的生成式 AI 成效報表;手動問題樣本可補充觀察,但不能取代平台報表,也不代表全體使用者看到的答案。
做法是每個月固定跑一次:準備一組種子問題(涵蓋你品牌所在領域的核心疑問),丟進不同的 AI 模型,然後看回答裡有沒有出現你的品牌、你的觀點被怎麼轉述、有沒有被張冠李戴。
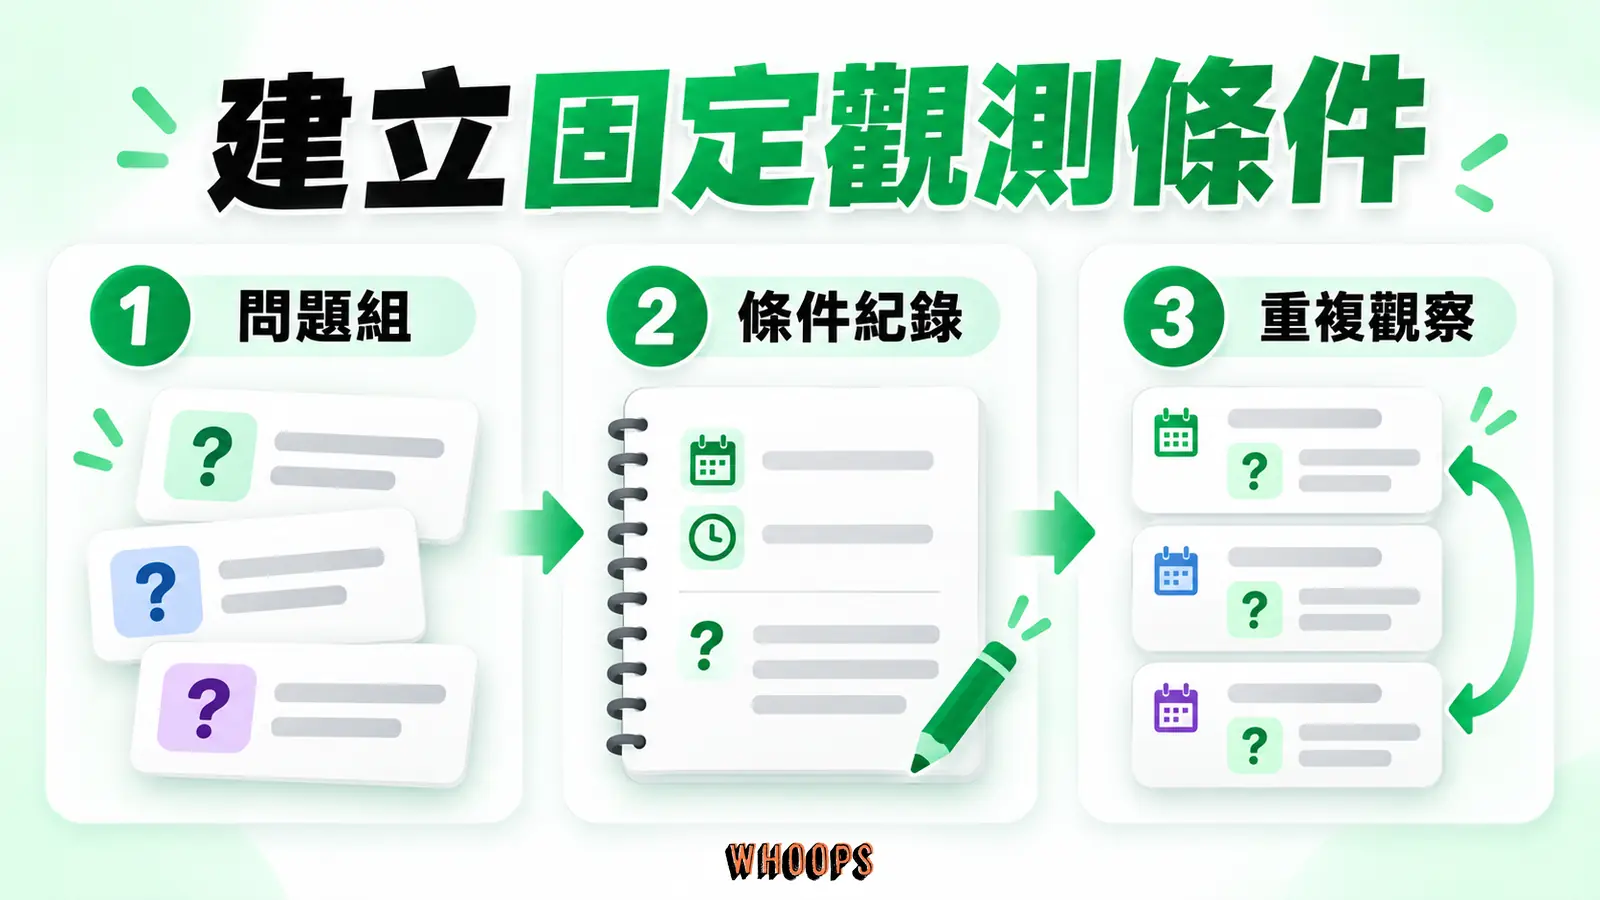
手動問題樣本能保留具體回答與來源,方便複查。測試時應記錄產品、模式、地區與日期;樣本結果有範圍限制,不能宣稱一定比儀表板準確。
- 模型對你的領域,目前引用哪些來源?這些就是你的「引用競爭對手」,未必等於你的搜尋競爭對手。一個在傳統 SERP 上排不贏你的對手,可能在 AI 引用池裡壓著你打。
- 你的品牌被描述得對不對?若描述過時或錯誤,先核對引用來源與網站資訊;不能直接把錯誤歸因於網站一致性。
- 哪些問題,模型根本找不到好答案?可作為選題線索,再用受眾需求與既有資料確認是否值得補充。
固定回答這三個問題,能讓變化有紀錄可比較。更系統化的操作可以看 AI SEO 實戰教學。
十項網站與內容檢查:先確認問題再修正
以下清單涵蓋存取、內容、作者與導覽。先確認問題是否實際存在,再安排修正;出現其中一項並不能直接證明 AI 已跳過網站。
左右捲動檢視完整表格
| 檢查項目 | 需要核對的問題 | 怎麼修 |
|---|---|---|
| 重要內容靠 JS 動態渲染 | 模型檢索時可能只拿到空殼 HTML | 關鍵內容走伺服器端渲染,定期用純文字模式自查 |
| robots.txt 或 meta 擋掉爬蟲 | 爬取限制與 noindex 的作用不同,應核對目標服務是否能存取與使用 | 檢查是否誤擋 AI 檢索器,分清楚索引與訓練的意圖 |
| 答案與條件分散 | 讀者與系統都容易誤解適用範圍 | 把結論、條件與例外放在同一小節 |
| 概念前後用不同名字 | 讀者與系統難以確認是否同一件事 | 統一重要事實,必要時說明同義名稱 |
| 內容互相抄襲或太薄 | 缺少獨立價值,也可能造成版本選擇混亂 | 依需求合併、補強或下架 |
| 結構化資料與正文不一致 | 搜尋系統可能無法正確理解或採用標記 | 只標可見且可驗證的內容 |
| 作者查無此人 | 讀者無法核對作者身份與相關經歷 | 補齊作者頁、經歷、外部指紋 |
| 速度太慢、行動體驗差 | 確認存取是否失敗,以及讀者是否遇到操作困難 | 顧好 Core Web Vitals 與行動友善 |
| 站內結構混亂 | 重要內容是否容易發現與導航 | 整理網站架構與內部連結 |
| 沒有外部佐證 | 模型找不到獨立來源背書 | 經營真實的外部連結與提及 |
這張表其實是傳統技術 SEO 檢查表的延伸版。以前這些事是「為了排名」,現在它們同時「為了被引用」。一份工,兩份回報。也是這個原因,不建議把 AI SEO 跟傳統 SEO 拆成兩個專案、兩個團隊做,那只會讓兩邊重工又互相打架。表上的檢查多半也能交給工具代跑,想用 AI 代理做第一輪技術審計、自己只複核結果,可以參考用 Claude Code 跑技術性 SEO 審計。
被引用之後:怎麼追蹤 AI 帶來的流量與影響
當你開始被 AI 引用,下一個問題就是:怎麼知道它帶來了什麼?這裡有個尷尬的現實:AI 帶來的影響,很難用傳統流量報表完整捕捉。因為很多時候,使用者根本沒點進來。
所以追蹤要分兩層(整體為什麼要監測、要盯哪些訊號,可以先看 AI 搜尋能見度監測)。第一層是「有點擊的」,第二層是「沒點擊但有效果的」。
有點擊的:把 AI 來源流量看清楚
當使用者從 AI 介面點了你的連結過來,這筆流量會出現在分析工具裡,只是常常被歸類成「直接流量」或某個不明來源。你要做的是主動把這些來源標出來。GA4 的設定與 AI 流量追蹤的做法,我們在 GA4 追蹤 AI 流量有詳細步驟,搭配 Search Console 看曝光與點擊的變化,能拼出第一層輪廓。
沒點擊的:用「可見度」取代「流量」當指標
這一層才是 AI 時代真正的新指標。前面講的種子問題追蹤法,量的就是這個:你的品牌、你的論點,在模型的回答裡出現的頻率與正確度。它不會出現在 GA4 裡,但它決定了你在「不點擊的那群人」心裡的位置。
建議把這兩層指標並列來看,不要只盯著流量線。傳統流量下降、AI 引用增加,可能是搜尋介面改變,也可能同時存在排名或技術問題;仍要搭配曝光、查詢類型與轉換判讀,不能直接視為健康位移。
當模型把你講錯了:幻覺與補救
被引用是好事,但這裡有一個沒有人會主動提醒你的風險:模型也會把你講錯。它可能把你的品牌跟別人搞混、把你過時的說法當成現行版本、甚至無中生有捏造一段你從沒寫過的「事實」,然後掛上你的名字當來源。這就是大家說的 AI 幻覺(hallucination)。
這件事之所以棘手,是因為它發生在你看不到的地方。你不會收到通知,使用者也不一定會回來跟你求證。模型把錯的資訊講得很篤定,信任就這樣悄悄被腐蝕。
這裡沒有什麼神奇的解法,但有一套誠實的補救邏輯。完整的機制可以看 AI 幻覺指南,下面講三個建議定期做的動作。
- 前面提過的種子問題測試,本身就是預警系統。每個月跑一次,就是在抓「模型有沒有把我講錯」。發現錯誤描述越早,補救成本越低。
- 把正確版本放在可查證的位置。在官網說明、相關頁面與適用的結構化資料中維持一致,並更新已知的過時資訊。外部網站看不到模型固定的來源優先順序,因此不能保證增加重複次數就能蓋過錯誤版本。
- 主動製造可被引用的「事實錨點」。把容易被講錯的關鍵事實,例如產品規格、服務範圍、價格、創立年份,放在容易查證的位置,交代日期、條件與來源,並修正可控制的過時版本。這不能保證模型不出錯,仍需保留錯誤案例並依產品管道回報。
平時維護可核對的官網資訊,發現錯誤回答時保留查詢、日期與來源,再修正已知的公開錯誤或透過產品管道回報。這是持續的資料維護,不能保證外部模型一定採用修正後的版本。
90 天行動清單:從今天開始的具體步驟
講了這麼多觀念,給你一份可以照著做的清單。把它拆成三個月,每個月一個主題,避免你一次想做太多反而什麼都沒做成。
第一個月(第 1 到 30 天):打底與健檢
- 盤點一致性:把你品牌的核心概念、產品名稱、作者資料,整理成一份「標準答案」清單。找出官網、社群、各頁面裡講法不一致的地方,逐一對齊。
- 做一次可見度殺手自查:照上面那張十項表格,逐項檢查你的網站,把明顯的技術地雷先拆掉。
- 建立你的種子問題清單:列出你領域裡最核心的二十到三十個問題,跑第一次基準測試,記下目前模型怎麼回答、有沒有你。
第二個月(第 31 到 60 天):把骨架埋進去
- 檢查結構化資料:只保留與頁面可見內容相符、搜尋服務目前支援的類型與欄位。FAQ rich result 已於 2026 年 5 月停止顯示(見 Google Search Console Help 的公告),不要把 FAQPage 當成 AI 搜尋捷徑。
- 改寫關鍵文章的結論:挑出已有需求或商業價值的幾篇,讓讀者能迅速找到結論、條件與來源,不設固定前兩段門檻。
- 強化作者實體:補齊作者頁的經歷、外部連結、社群指紋,讓模型查得到「這個人是真的」。
第三個月(第 61 到 90 天):加厚與驗證
- 補內容缺口:拿第二個月種子問題追蹤發現的「模型找不到好答案」的題目,寫成新內容。
- 做主題叢集:把同主題的散落文章串成有支柱頁的矩陣,經營主題權威。
- 跑第二次種子問題測試:跟第一個月的基準比,看引用率與正確度有沒有移動。沒有移動,回頭查是哪一層卡住;有移動,把做對的事固化成流程。
九十天走完,你不會變成 AI 搜尋的第一名(沒有人能保證這種事,凡是保證的都要小心)。但你會擁有一套可重複、可追蹤、會累積的系統。這才是 AI 時代真正該存的資產。
把舊地基,用在新建築上
回到最開始那個問題:AI 搜尋時代,SEO 還做不做?
既有的技術維護、內容品質與來源查核仍然適用。增加對 AI 回答的觀察時,先處理已確認的存取、資訊或導覽問題;Google 不要求另寫一套機器專用內容,也沒有特殊 AI Schema。
規則在變,可靠內容的基本要求沒有消失。把問題回答清楚、交代限制並維持事實一致,能降低讀者與系統誤解的風險;至於是否被引用,仍由各產品、查詢與當下可取得的來源決定。
所以與其焦慮「AI 會不會搶走我的流量」,不如換一個問題問自己:「如果明天有一個從沒聽過我的人,對著 AI 問起我這一行,系統能不能找到正確、可核對的公開資訊?」這個問題一旦認真想下去,你會發現它逼出的動作,剛好就是這篇講的幾件事:把經驗寫誠實、把描述寫一致、把結構寫清楚。
把舊規則的底子打好,新機會來的時候,你才接得住。現在,輪到你把手上那篇最有信心的文章,用一般讀者的心態重讀一遍:結論、條件與來源是否容易找到?光是這一步,就可能找出最值得先修的地方。
如果你覺得這套系統化做法正是你缺的,但自己摸會繞遠路,Whoops SEO 有提供顧問服務,可以把這整套從健檢到落地幫你跑一遍。先從你自己的網站動手,永遠是最誠實的起點。