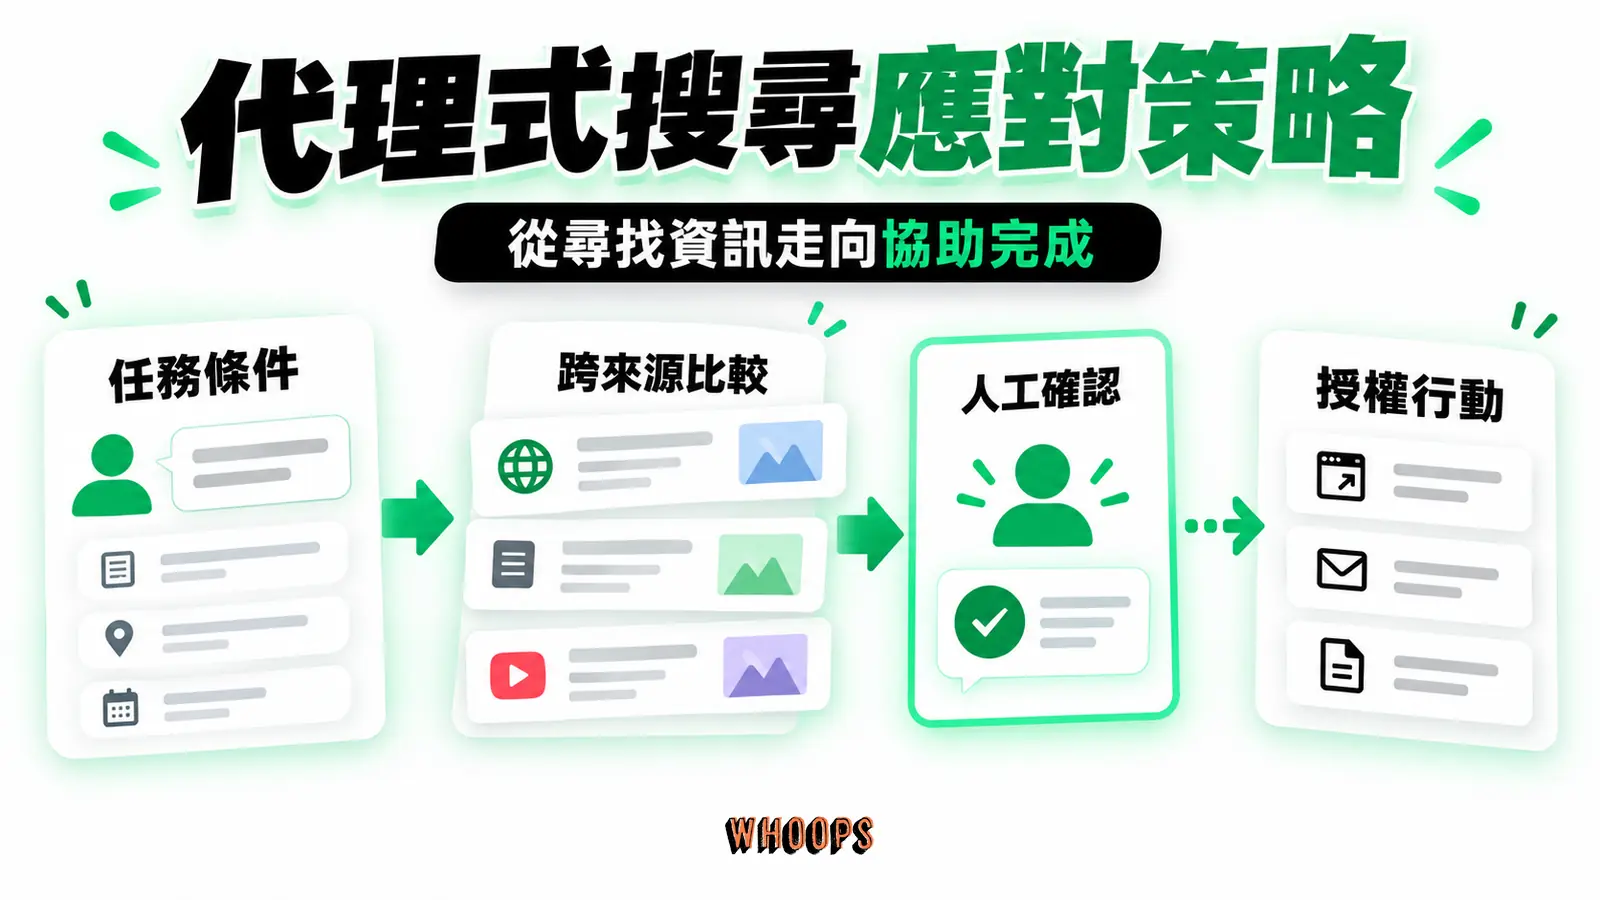
Query Fan-Out 查詢扇出:站方真正能做的三件事
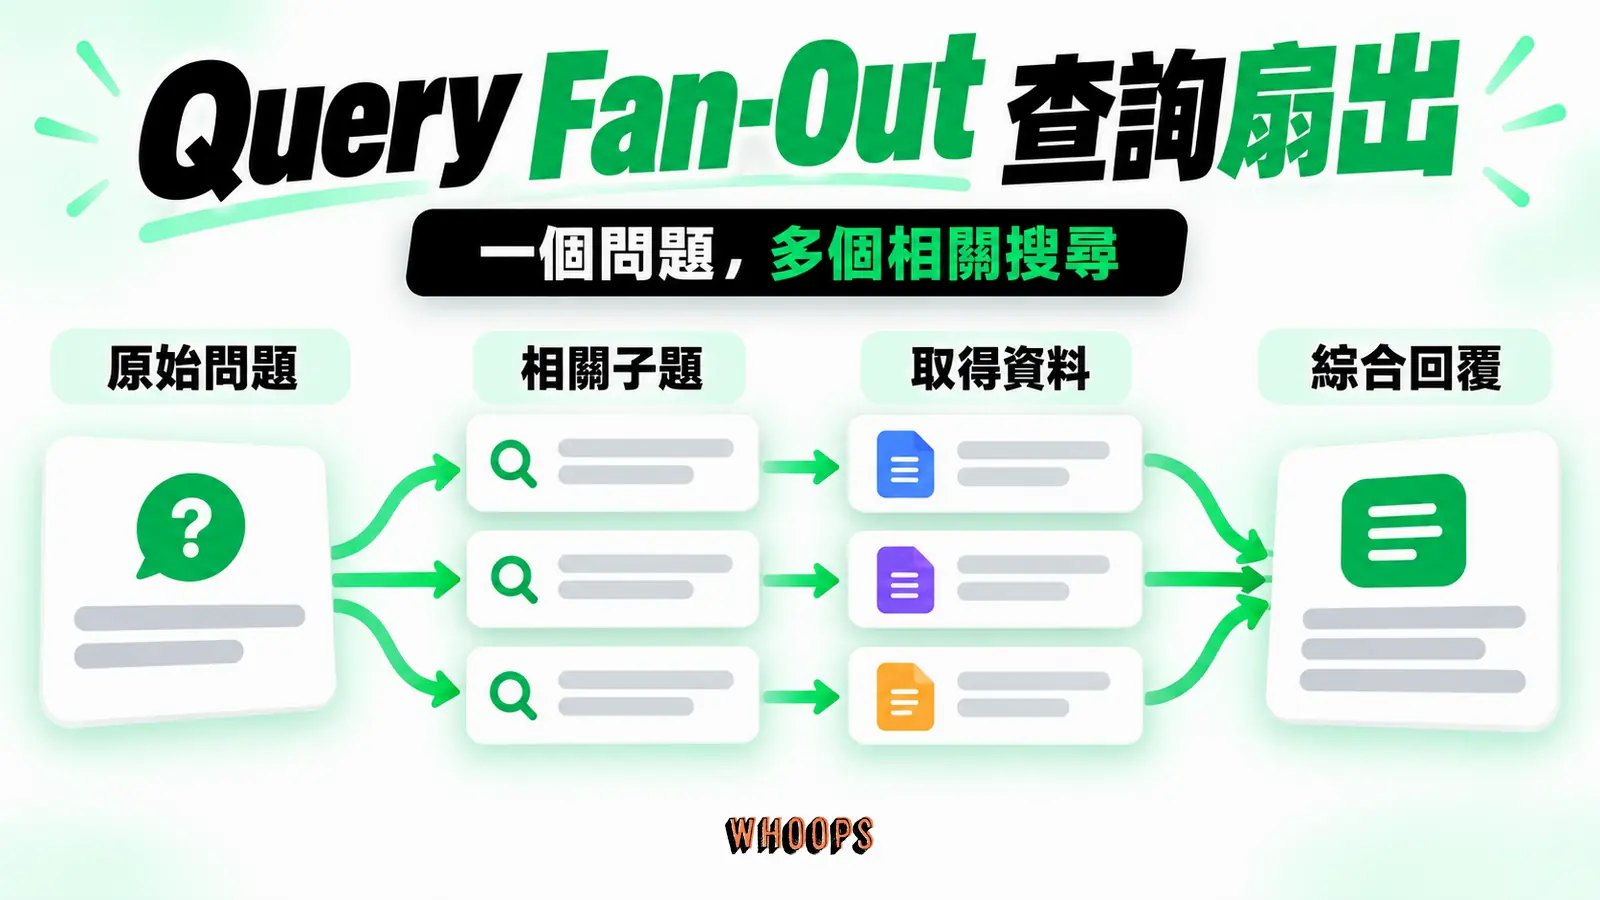
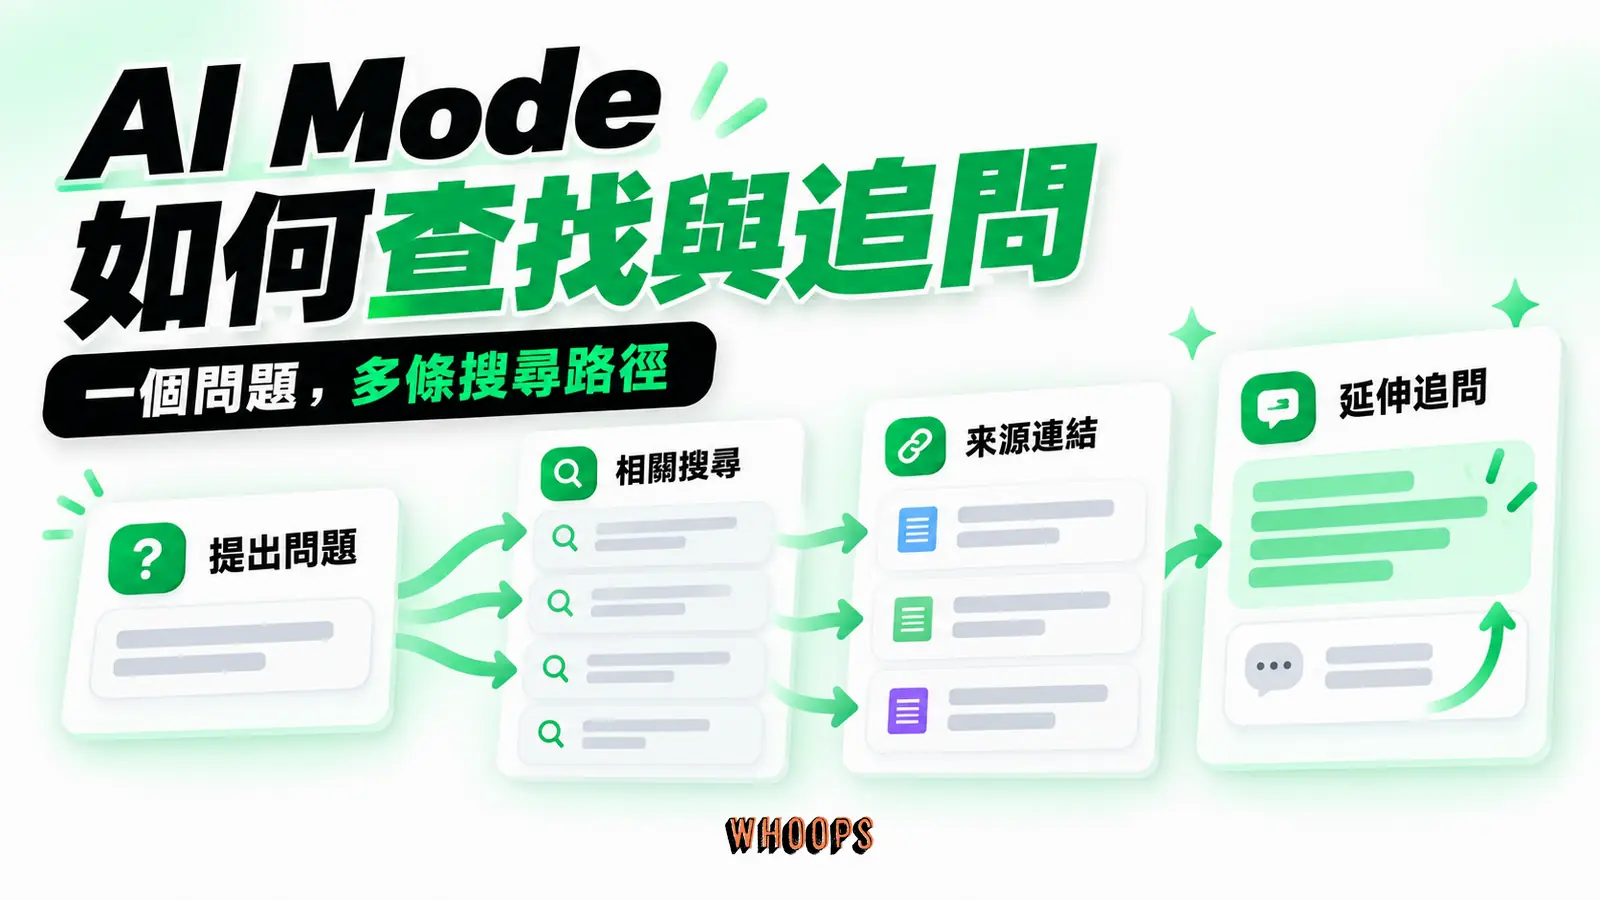
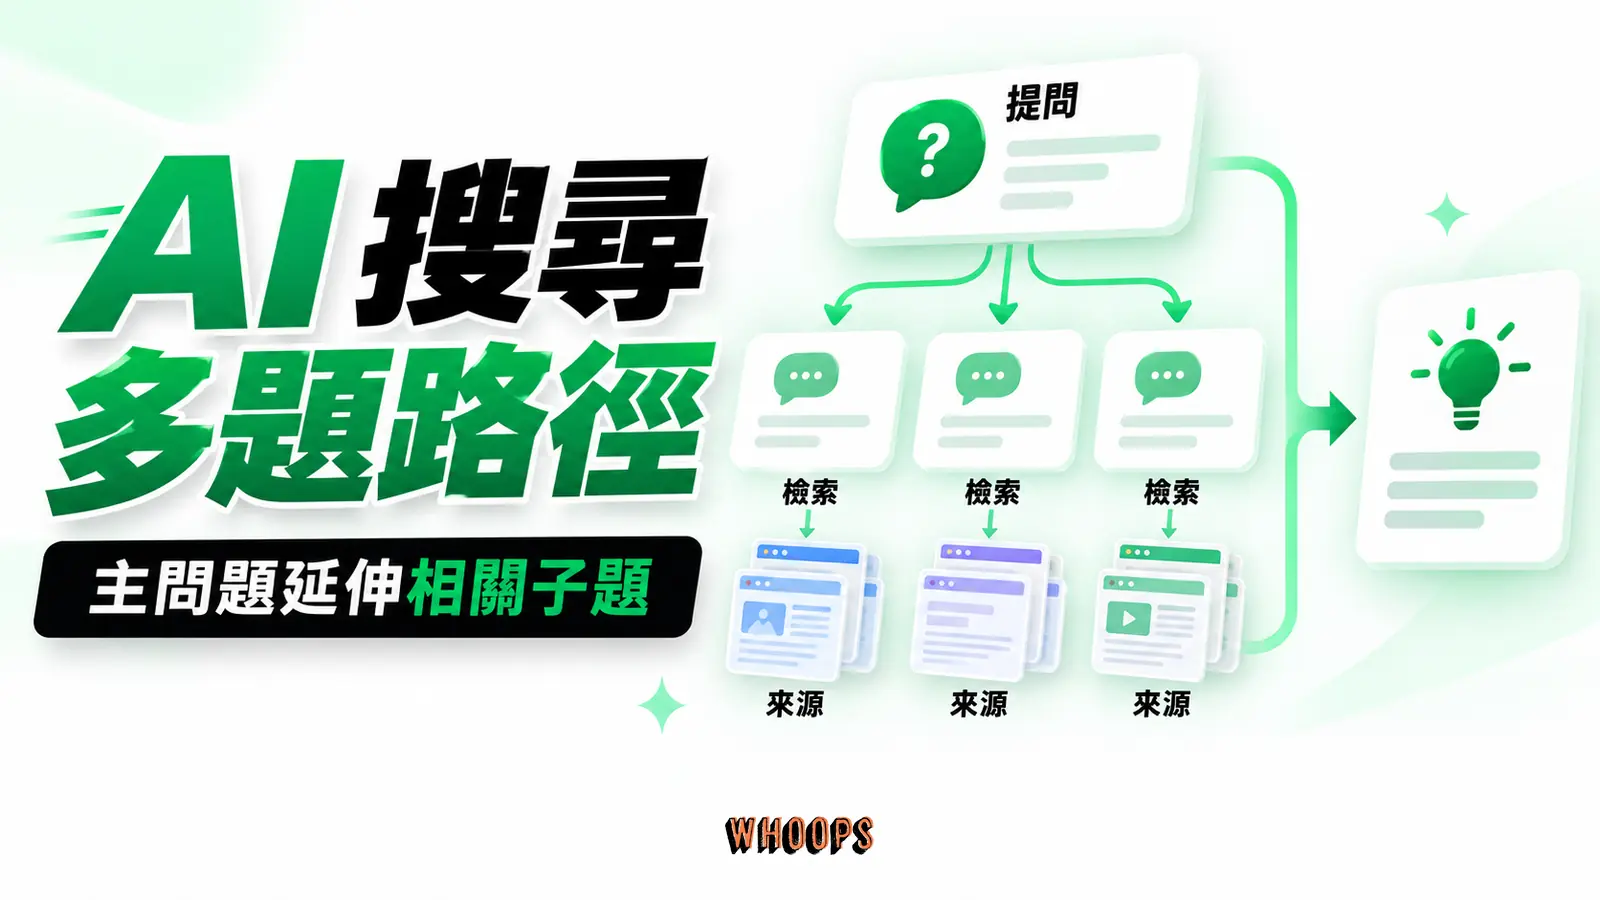
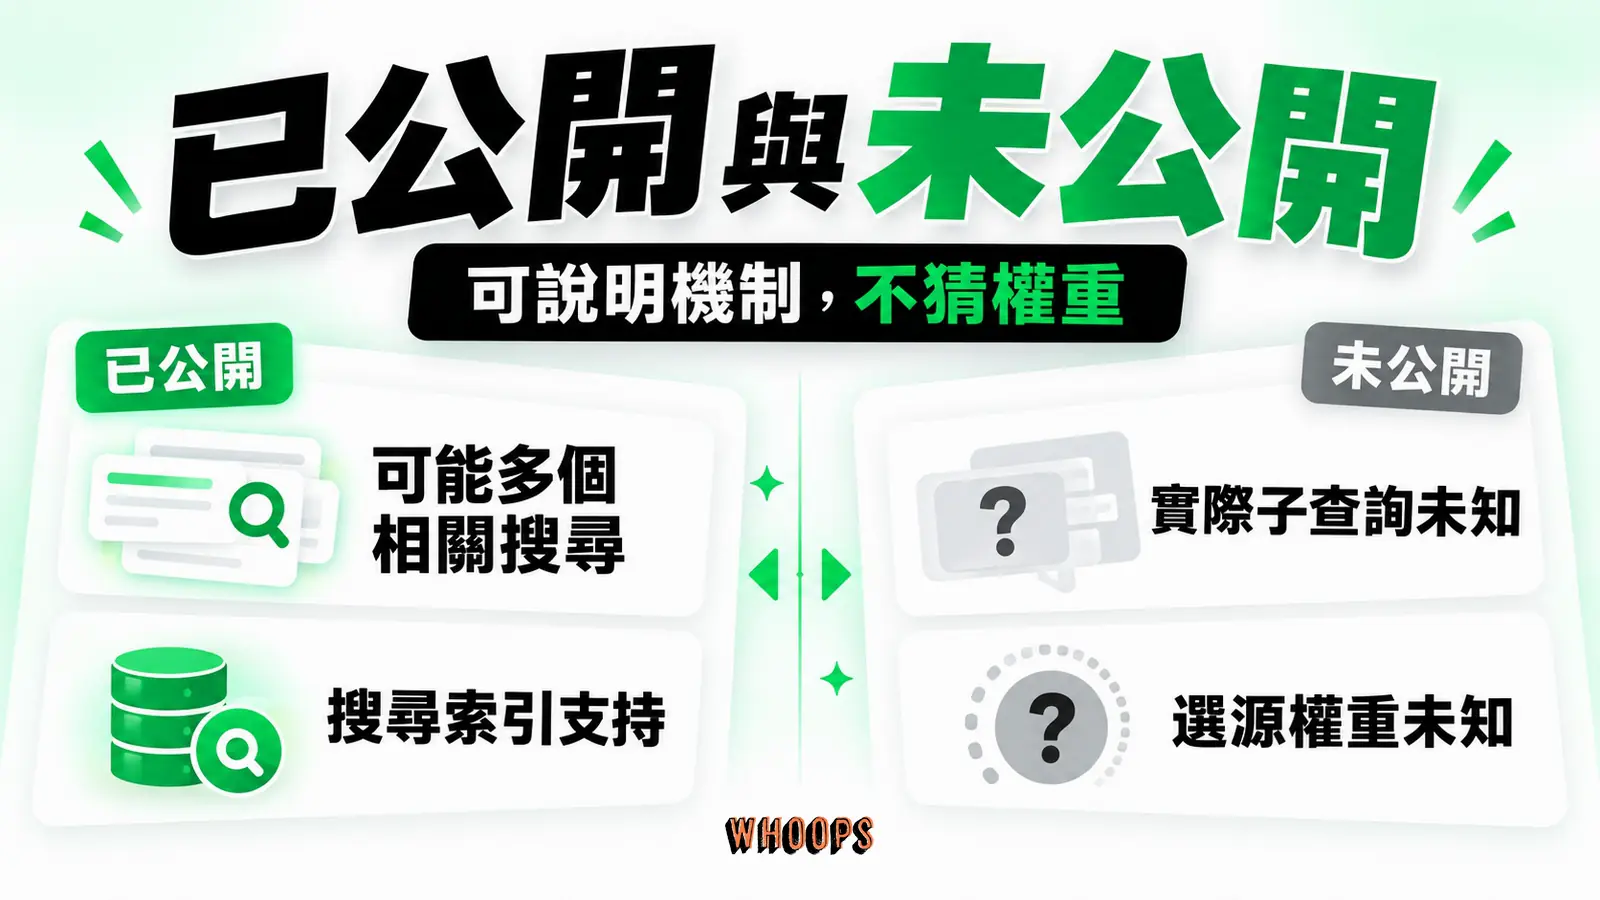
Query Fan-Out(查詢扇出)是 Google 說明 AI Overviews 與 AI Mode 可能使用的檢索方式:一個提問或許會被展開成多支相關查詢、平行檢索、再綜合資料。子查詢內容與選源權重未公開,站方能掌握的是搜尋資格、讀者需求與可靠來源,並依內容邊界決定補本頁或另開新頁。
想像一個場景:週一早上九點,你打開搜尋成效報表,幾個主要查詢的點擊連著幾週下滑;流量來源裡,幾個 AI 平台的進站紀錄慢慢浮現。十分鐘後的會議上,主管問你:聽說 Google 現在會把一個問題拆成很多個查詢再回答,我們的內容是不是該跟著調整?你盯著投影片,發現自己缺的不是一個名詞解釋,而是一條能照著走的判斷路徑。
先把全篇的立場講清楚,因為它不太順耳:Query Fan-Out(查詢扇出)是搜尋端內部的檢索策略,Google 沒有為它留下任何站方可以轉的新旋鈕。它真正改變的,是內容被比對的單位。以前是一頁內容對一個關鍵字;現在是一份材料,對一群你在報表裡聽不見的問題。可控範圍沒有變大,只是界線變清楚了。
快速重點:Query Fan-Out(查詢扇出)指 AI 搜尋把一個問題展開成多支相關查詢、平行檢索再綜合資料。Google 已公開的只有概念,子查詢內容與選源權重未公開;站方可做的是確認搜尋資格、回答讀者需求、提供可靠來源三件事。
先分流症狀:成效變化和查詢扇出有沒有關係
單看任何一個指標,都無法斷定成效變化來自這個機制。可行的做法是把症狀分成三類:點擊減少、曝光轉移、資格異常,各自對到該看的報表,把「猜機制」換成「查可觀測訊號」。名詞不是成因;證據進來之前,不把下滑直接記在某個檢索機制頭上。
三類的檢查順序不同。點擊減少,先看查詢報表:哪些查詢掉了、從什麼時候開始、集中在哪些頁面。曝光轉移,先看網頁報表與 AI 功能相關報表:總曝光是否還在、點擊是否往少數頁面集中,Google 對 AI Overviews 這類搜尋外觀提供了對應的觀測欄位。資格異常,先做索引與檢索檢查:頁面還在不在索引裡、主要內容能不能被正常讀取。每一類都只決定先看什麼,不預設結論。
左右捲動檢視完整表格
| 症狀 | 優先檢查 | 常見誤判 |
|---|---|---|
| 特定查詢的點擊連續減少 | 查詢報表:期間、裝置、涉入頁面 | 直接歸因 AI 功能,跳過同期的內容改版與競爭變化 |
| 總曝光仍在,點擊往少數頁面集中 | 網頁報表與 AI 功能相關報表 | 把曝光重新分配讀成懲罰訊號 |
| 頁面消失或摘要異常 | 索引狀態檢查與檢索統計 | 把技術問題誤判為機制改變 |
這張表的用途是排序,不是下結論。同一段時間裡,網站可能剛好改了版、換了標題、移除了幾個頁面,市場端也可能出現新的競爭內容;把這些可觀測的解釋查完,剩下的不確定性才輪得到「機制變化」來認領。順序反過來,就會變成拿名詞解釋一切,報表看得再勤也導不出行動。
檢查時也要守住比例原則:先看大額變化,再看小額波動。查詢報表裡每天都有正常起伏,把每一條小波動都拿來歸因,只會把診斷淹沒在雜訊裡;聚焦在期間內貢獻最大的幾個查詢與頁面,結論才有分量,行動也才排得出優先序。
還有一個紀律是時間對齊。把變化發生的日期,與網站端的事件對齊:那天是否改了標題、上了新版、調整了連結;再與搜尋端的公開資訊對齊。對得起來的,先當作可解釋的變化處理;對不起來的,保留給不確定性,不要急著命名。
分流之後,行動的性質也不同。資格異常是工程問題,修的是可索引性與可讀取性;點擊減少若排除了競爭與改版因素,多半要回到需求與內容品質;曝光轉移常與呈現方式的變化有關,先確認頁面在新呈現裡的資格,再談內容調整。三種行動的負責人與工具都不同,混在一起處理,容易每件事都只做半套。
即使證據到頭來指向 AI 搜尋的變化,能做的事也沒有變多。AI Mode 對搜尋生態的影響是事實,回應它的方式卻不是找新旋鈕,而是把可控的三件事做完:搜尋資格、需求回答、可靠來源。機制改變的是內容被比對的單位,從一頁對一個詞,變成一份材料對一群聽不見的問題;比對的單位變了,基本功沒變。
一次發問為什麼會變成好幾支查詢
因為問題變複雜了。當一個提問裡同時塞了對象、條件、情境與預算,單次檢索很難每一面都顧到,搜尋 AI 於是可能把複合問題拆成多支相關查詢、平行檢索、再綜合資料。Google 公開的是概念;每次拆出幾支、各查什麼、來源怎麼加權,都沒有公開。要理解 AI Mode 的運作方式,這是檢索階段最值得弄懂的一塊。
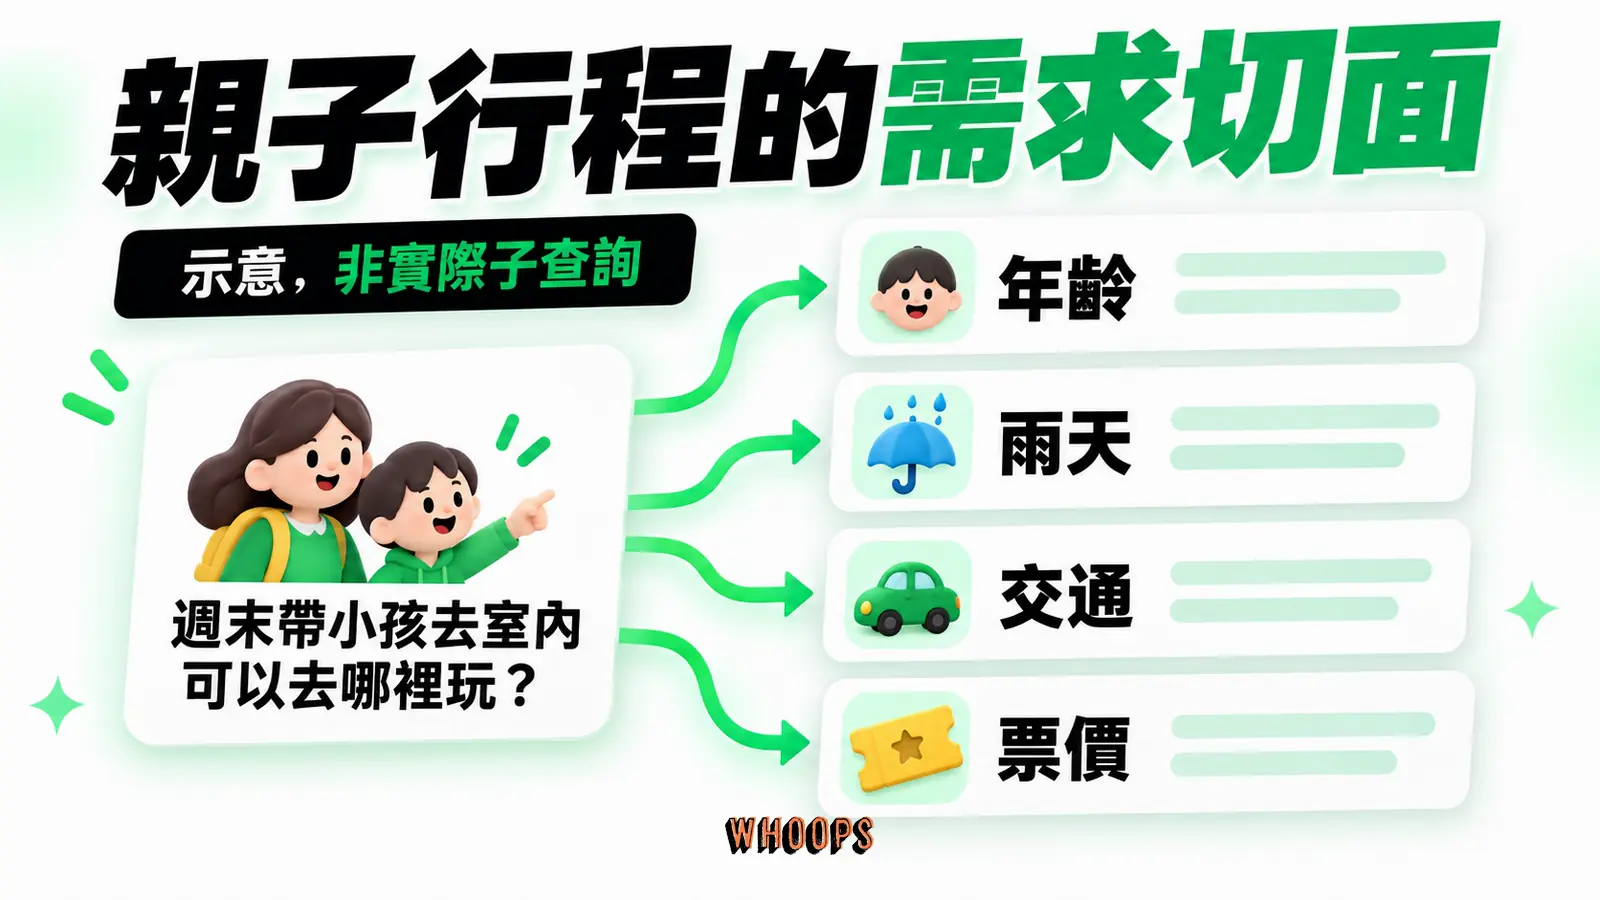
想像一個場景:週末想帶三歲的孩子出門,你在搜尋框打了整句話:「下雨天,台北有沒有適合三歲小孩、可以待上大半天的室內地方,捷運到得了,門票一張五百元以內?」單次檢索面對這句話,很容易顧此失彼:抓得住「親子景點」,抓不住「雨天備案」;找得到景點清單,對不上票價與交通條件。這句話裡至少有四個各自成立的條件:適齡、雨天用得上、交通方式、票價範圍。判斷的把手很簡單:把句子念一次,數數看有幾個條件可以獨立成立。條件越多,問題越接近複合型,對應到搜尋意圖分析裡多種意圖疊在一起的狀況。
把一個問題展開成多支子查詢、各自平行檢索、再綜合成同一份答案,這個機制就是 Query Fan-Out(查詢扇出)。fan 這個詞取的是扇形展開的意象:一次提問從圓心散出好幾道射線,每道射線各自去問一輪,問回來的材料匯回原點,整併成同一份回答。親子行程那句問句裡的年齡、雨天、交通、票價,就是射線可能分頭去探的切面;至於 Google 實際拆出哪些查詢,官方沒有公開。
官方立場可以直接核對。Google Search Central 的 AI 優化指南把 query fan-out 描述為模型產生的並行相關查詢,同頁也說明檢索增強生成與核心搜尋系統在過程裡的角色,並明講網站不需要特殊的 AEO 或 GEO 招式。三件事放在一起讀,結論很清楚:機制在搜尋端內部運作,站方沒有專屬開關可以操作,官方把它歸回「顧好內容與資格」的既有範圍。
用字也值得留意。官方在 AI 功能說明裡的措辭是「可能使用」(may use):遇到一個提問,系統或許會朝多個相關方向各查一輪,再把不同來源的結果揉成同一段回覆,詳見 AI Overviews 與 AI Mode 的官方文件。「可能」二字不是客套:子查詢的數量依問題而異,什麼情況拆、拆多細,都屬於未公開的內部決策。任何宣稱「固定拆幾支」的說法,都超出官方給過的資訊。
對內容的意涵,可以用一個自查題呈現:除了主要關鍵字,這一頁還能回答哪些各自成立的問題?答案只有一個不是錯,那頁的角色就是回答那一問,把它答好即可;答案有好幾個,就要確認每一問都有完整的落點,別讓某一問只收到半截說明。這個自查不需要任何工具,卻比多數「AI 優化檢查表」更貼近機制的實際影響面。
同一個需求,讀者還會用不同的說法問出來。有人打整句話,有人只打「雨天 親子 室內」,有人換個詞問「下雨天帶小孩去哪」。說法不同,條件沒變;寫內容時把不同說法自然帶進敘述,各種問法都讀得通,比對時才不會因為用詞差一截就對不上。這是寫給人的順,也順便服務了比對。
再往檢索那一端想一步:一支子查詢帶回的候選,未必是你為主要關鍵字準備的那一頁。適齡切面可能命中你寫過的年齡段攻略,票價切面可能命中另一頁收費整理;同一個主題裡,被比對的單位是材料,不是你規劃好的單一頁面。這對中小型網站不算壞消息:不必在主查詢上硬拼,把手上的每一份材料寫到能獨立回答一個子需求,被配對到的機會就存在。引用沒有保證,但至少不會在資格這一關就被篩掉。
拍照發問也會拆:視覺查詢的扇出
直接回答:會。fan-out 不是文字查詢的專利。Google 在 2025 年 4 月公開的 AI Mode 多模態搜尋說明把流程寫得具體:拍一張照片或上傳圖片再提問,Lens 先認出圖裡的每個物件,接著 query fan-out 發出的多支查詢會圍繞整張圖與圖中物件展開,再彙整成回答。這段官方描述講清楚的是檢索對象:整張圖與圖中物件都涵蓋在內;實際怎麼拆、怎麼分組,官方沒有公開,不必替它補細節。
用一個示意例子看形狀。拍下自家陽台,問「這樣的環境適合種什麼」,射線可能分頭去查光照條件、地板與欄杆的材質、畫面裡已有植栽的品種。讀者只發問一次,檢索端面對的切面卻比文字提問更多:圖裡每個看得見的東西,都是一個候選的子查詢方向。實際拆哪些、拆幾支,官方同樣沒有公開;例子只是幫你理解形狀,不是官方拆法。
輸入形式還在往外長。2025 年 6 月上線的語音對話搜尋 Search Live,官方也明講用上了 query fan-out,同一篇並預告來回對話時可以把相機畫面也帶進來;AI Mode 本身則在 2025 年 10 月擴及超過 200 個國家與地區。文字、圖片、語音放在一起看,結論很乾淨:發問的形式一直在變,檢索那端用的是同一套扇出策略,被比對的也永遠是你的材料,不是你為某種輸入特別準備的頁面。
站方能做的,落在圖片這一層的材料品質,三件事還是那三件事。資格:圖片要進得了圖片索引、載得出來,這是老地基。判讀:主體清楚的原圖、如實描述的 alt 與檔名、出現在講同一件事的文字旁邊,讓「這張圖是什麼」在檢索端讀得出來,圖片 SEO 的基本功在視覺扇出之後的用途就是這個。配對:一張圖放在回答哪個子需求的段落,就跟那個子需求一起被比對,產品照貼在規格段落旁,比放在純裝飾位置更有機會接上對的切面。想深究 Lens 這端怎麼辨識物件,可以另讀Lens 視覺搜尋的運作方式。
自查題換成視覺版,一樣只有一句:這一頁的每張圖,有沒有把自己回答的子需求說清楚?一張圖配一段講明白「圖裡是什麼、對讀者有什麼用」的文字,就是「每一問都有落點」的圖片版。做到這裡為止;哪些圖被選進答案、用什麼權重,官方沒有公開,不必猜。
分解、檢索、綜合:可以理解的框架,不能診斷的關卡
直接回答:這三個名字可以幫你理解材料在系統裡可能經歷的事,拿來當逐關攻略的檢查點就行不通了。Google 未公開內部順序與權重;站方可做的,是確認搜尋資格、回答讀者需求、提供可靠來源,而無法從外部資料斷定自己是在哪個內部階段落選。
分解,講的是意圖與切面。系統讀懂一個複合問題裡有哪些子需求,實體在這一步有實際作用:一個被理解得清楚的實體,比較容易被配對到對的切面,這也是知識圖譜在搜尋裡的位置。站方的對應動作不是猜拆法,而是把子需求寫清楚,讓每一問都有明確的答案所在。
檢索,講的是候選材料的取得。對象不限於一般網頁索引,還包括結構化資料來源;字面比對的 BM25 仍在底層運作,新機制疊在舊地基上,不是把地基拆掉。檢索的通盤概念,可以另讀檢索(Retrieval)的基礎說明;站方的對應動作是資格與可讀取性,頁面進得了索引、讀得到主要內容,才有後面的事。
綜合,講的是把各支查詢帶回的材料整理成連貫答案,對應接地(Grounding)的工程要求:答案要落在取得的資料上,偏離資料就是幻覺的入口,也是引用失真的起點。站方的對應動作是提供可核對的資料與明確的歸屬,讓材料在被引用時經得起比對。
名稱陷阱只需要一段。查詢擴展(Query Expansion)改的是一個查詢的用詞,補上同義說法,讓同一個問題匹配更多寫法;查詢扇出改的是查詢的數量,一支一支去探不同的子題。兩者的失敗模式也不同:擴展失準是詞不達意,扇出失準是答案缺一塊。記這一句就夠,不必再記更長的對照表。
左右捲動檢視完整表格
| 概念 | 站方可做 | 不可控 |
|---|---|---|
| 分解 | 把主題的子需求寫清楚,實體命名前後一致 | 子查詢的生成方式與數量 |
| 檢索 | 確認頁面可被檢索與讀取,內容對應子需求 | 候選來源的選擇與權重 |
| 綜合 | 提供可核對的資料與明確歸屬 | 哪些來源進入最終答案 |
表格兩欄的對比就是本節的結論:左欄做得完,右欄做不了。把力氣花在右欄,例如猜測內部權重、反推落選階段,產出的是焦慮不是成果;花在左欄,每一項都有明確的完成定義,做完就看得到。
已知的部分到此為止,未知的部分也畫得出來。來源的多樣性,官方只給到「一般網頁索引之外還有結構化資料來源」這個程度,各來源在什麼條件下被用、比重如何,沒有數字;拆解的時機與粗細,也停在「可能使用」的字眼範圍內。想在這些未知上建立操作程序,只是把猜測包裝成步驟,看起來嚴謹,基礎是空的。
分解、檢索、綜合終究是理解框架,不是診斷工具。站方能做的是確認搜尋資格、回答讀者需求、提供可靠來源這三件事;一份內容究竟是在哪個內部階段被放下,外部資料給不出答案,也不必假裝給得出。承認這條邊界,後面的判斷才會乾淨。
ChatGPT 搜尋也做扇出嗎:官方說法的對照
名詞上沒有。OpenAI 的官方文件沒有用「query fan-out」描述自家的搜尋,但把文件攤開,兩家走的是同一個方向:把一次提問變成多次檢索再綜合,差別在於怎麼描述這件事。OpenAI 的開發者文件把網頁搜尋分成三種型態:非推理的快查,把查詢交給搜尋工具、直接回傳熱門結果,不做內部規劃;代理式搜尋(agentic search),推理模型在思考鏈裡自己管理檢索,查一輪、讀結果、再決定要不要繼續,深度與速度隨推理層級調整;深度研究(deep research)則是官方形容常會查用數百個來源、一跑數分鐘的長程任務。文件同時寫明,開發者端接得到 ChatGPT 搜尋所用的那組微調模型與工具,詳見 OpenAI 的網頁搜尋工具說明(2026 年 10 月查證)。
對照可以整理成表,但每一格都只能寫官方給過的字,沒給的就留白。
左右捲動檢視完整表格
| 對照點 | Google 官方說法 | OpenAI 官方說法 |
|---|---|---|
| 機制名稱 | query fan-out(查詢扇出) | 未使用此名詞,以代理式搜尋、深度研究描述 |
| 檢索方式 | 多支相關查詢並行發出,再彙整成回答 | 思考鏈中查、讀、決定是否續查;快查為單次檢索 |
| 規模線索 | 只說「多支」,實際數量未公開 | 深度研究常查用數百個來源,耗時數分鐘 |
| 站方資格介面 | 既有索引與 Googlebot 資格 | OAI-SearchBot,與訓練用 GPTBot 分開設定 |
兩個結構差異值得記住。一是並行與迭代的描述不同:Google 2025 年 3 月的 AI Mode 說明用的字眼是同時對多個子題與資料來源發出查詢,OpenAI 講的則是查一輪、看結果、再決定下一步;兩種描述都沒有公開到能互相否證的程度,不必替它們分高下,更不必替它們補數字。二是資格的介面不同:Google 端跟著既有索引走,OpenAI 端的搜尋檢索走 OAI-SearchBot,官方說明寫明它與訓練用的 GPTBot 是兩組獨立的 robots.txt 設定,異動約 24 小時後生效。想出現在 ChatGPT 搜尋、又不想內容被拿去訓練,兩件事可以分開處理;這是站方少數能直接操作的設定,而且它管的是資格這一關,不是被引用的機率。
對站方,結論收斂得比想像快。檢索端是並行扇出還是迭代續查,材料端的條件都是同一組:內容可被檢索、可被讀取,每一頁能獨立回答一個子需求,資料可核對。差異主要在觀測:Google 有 Search Console 的 AI 報表可以看 AI 外觀的曝光與點擊,ChatGPT 端截至查證時未見對等的站方報表,進站狀況要靠自家分析工具看。「怎麼保證被引用」的公式,兩家都沒有給,這個缺口兩邊一樣大。
名詞對齊之後,決策不必分家。本文後面的四個問題、修補順序與觀察期,套在任何一家的 AI 搜尋上都成立,差別只是報表位置與爬蟲名單。不必為每家學一套新術語;把同一份材料準備到每家都讀得懂,一條路就夠了。
四個問題幫你決定:內容要不要為此調整
答案可以先給:依序過四關,多數情況的結論是聚焦補缺口,不是重寫全站。四個問題分別處理要不要切面思考、本頁守不守得住、缺口放在哪裡、以及憑什麼贏;每一關都有判準,也都有「若是,接下來做什麼」。
第一個問題:讀者的主要問題是複合型嗎?判準就是前一段那個把手,數條件。若主要問題本身單一,例如「查詢扇出是什麼」,頁面顧好這一問就夠,不需要為了湊覆蓋硬加切面;加了不會更完整,只會更稀釋,讀者也比較難判斷這頁到底在回答什麼。判準也可以反過來用:若報表裡進站的多是短詞與單一問法,切面投資的優先度就往後放。
第二個問題:這一頁把自己的主要問題回答完整了嗎?先把頁面承諾寫成一句話,再逐段核對。核對時把自己當第一次來的讀者,別當作者;作者看得懂的省略,讀者常常接不起來。連主問題都答不完的,先補本頁;主體缺一角時,切面規劃得再漂亮都輪不到上場。答得完,才進第三個問題:缺的切面屬於本頁,還是可以獨立成頁?屬於主問題一部分的,補進本頁;可以獨立成立的,另開一頁並互相連結。頁面邊界的判斷細節,下一節展開。
第四個問題:有沒有可核對的第一手資料?第一手資料決定一頁內容的競爭上限。可核對的材料是綜合端接地時最好用的素材,也協助降低AI 幻覺的風險;同主題裡別人沒有的觀察與數據,是資訊增益的來源,而經驗面的事實,正是 E-E-A-T 裡最難被抄走的那一塊。四關都過了再動手,動手的範圍通常比焦慮時想像的小得多。
一個警示:為了猜測的子查詞量產近頁變體,可能踩到搜尋引擎的垃圾內容政策。以「覆蓋更多子查詢」為名大量生產重複、拼湊、沒有增值的頁面,正好落在垃圾內容準則處理的範圍。缺口用補的,不是用灌的。
資源分配也跟著對齊。把內容投入往可累積的主題資產移動,比逐詞微調更划算:一個主題的完整覆蓋、可核對的資料、穩定的維護節奏。HubSpot 的行銷現況報告也呈現行銷團隊把資源往可累積內容移動的方向;這裡引用方向,不引用未經驗證的數字。判斷一項內容投資可不可累積,問三件事:它會不會很快過期、它能不能被更新、它是不是只服務單一查詢。三問都偏負面的投資,在新的比對單位下折舊得最快。
看得見的需求線索,看不見的內部查詢
直接回答:找不到。Google 沒有提供 AI Mode 子查詢的對外紀錄,任何宣稱能還原「Google 幫你拆的查詢」的工具或服務,都超出官方釋出的資訊。看得到的是需求線索,用途是選題,不是逆向工程。
可以用的線索有四類:Autocomplete 的輸入建議、結果頁上的 People Also Ask、關鍵字研究工具挖得到的相關詞與問句,以及自家客服紀錄、留言與站內搜尋。Autocomplete 的官方說明寫得明白:預測來自真實搜尋、熱門趨勢與使用者脈絡,是輸入框的建議機制;PAA 則是結果頁的問答呈現。它們都能協助選題,但都不是 Google 公開的 AI Mode fan-out 子查詢清單;讀者的真實提問是需求證據,不是內部檢索記錄。性質分清楚,用途才會對。
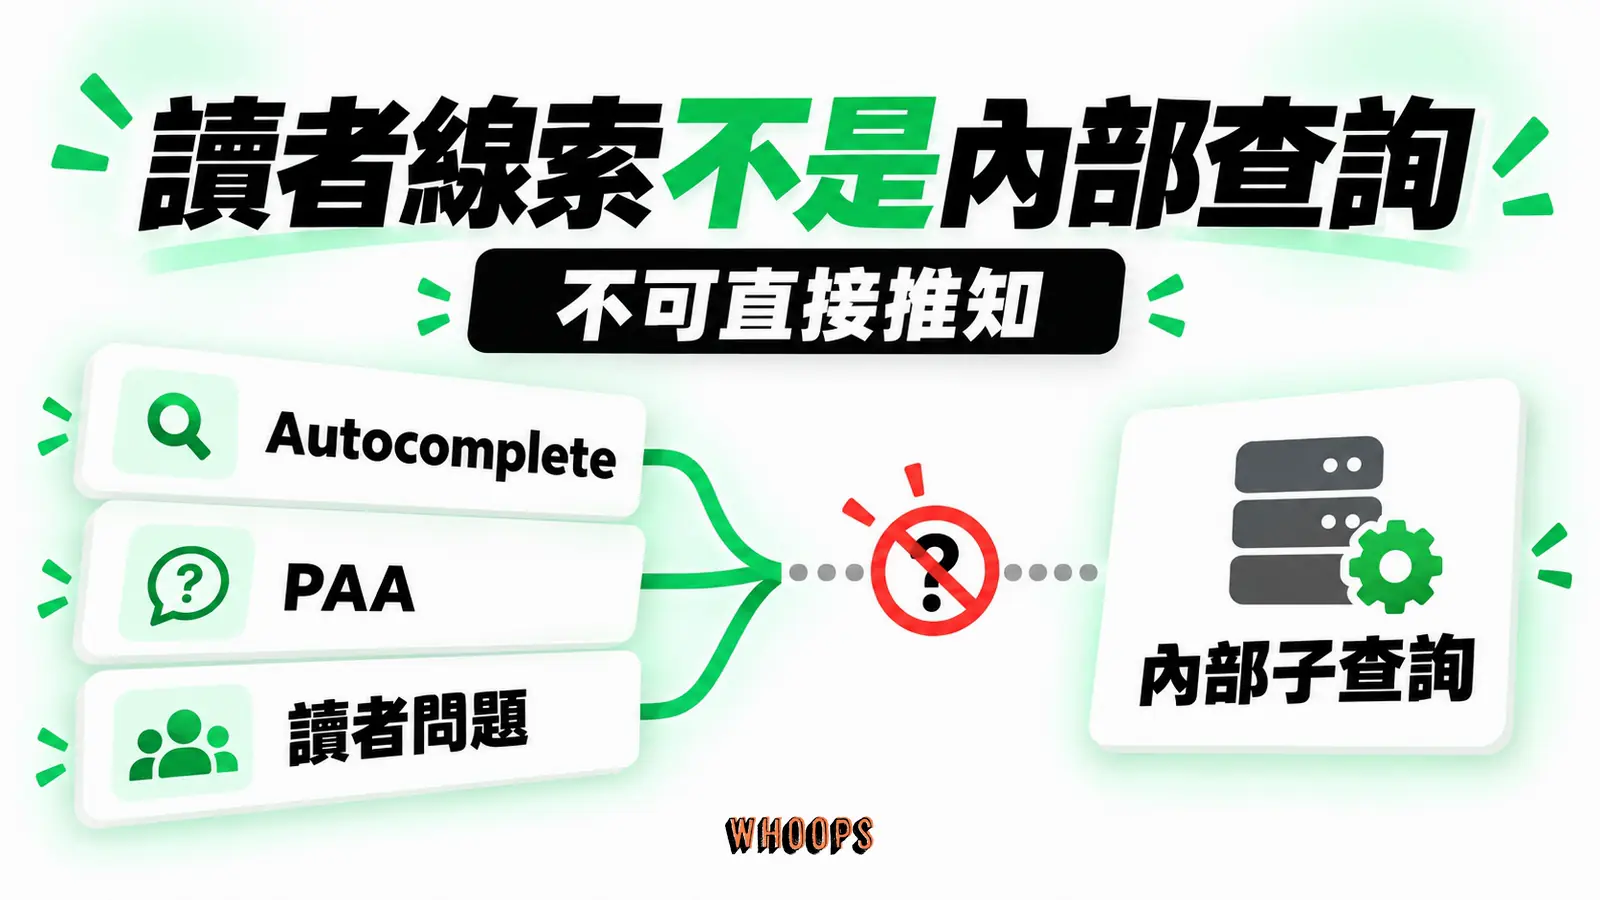
四類線索各有偏向,交叉比對比單一來源可靠。Autocomplete 反映輸入行為的熱度與脈絡,偏熱門詞;PAA 反映結果頁的問答結構,偏已被驗證的需求;關鍵字工具反映查詢量與相關性;客服紀錄與站內搜尋反映既有讀者的疑問,偏向已經認識你的人。新建需求的盲點,要靠前面幾類補上。
實際的操作,是把它們整理成一份讀者連環問題清單:從主問題出發,列出一位確實有這個需求的人下一個會問什麼,每一條標記來源。問句型的長尾關鍵字在此特別有用,一個完整問句通常就是一個子需求的原型。清單格式夠簡單就好:
- 主問題:這個主題的讀者最先要解決的事
- 延伸問題:接下來會連著問的三到五題,標記來源
- 對照欄:每題現在由哪一頁回答,或者沒有人回答
這份清單直接餵給下一節的修補順序。有一件事先講清楚:不要把「幾支接幾支」當 KPI。子查詢看不見,接得住幾支無法定義、無法量測,也無法驗收;能定義的是「這個子需求有沒有被一頁內容好好回答」,這才是打得了勾的項目。
示範一個縮小版。主問題是「中小型電商怎麼開始做 SEO」,連環問題可能長成這樣:「要先修技術還是先寫內容」「多久才看得到變化」「要請外部團隊還是自己做」。三題各自成立,來源分別標上 PAA、客服紀錄、關鍵字工具;對照欄填完現有頁面後,哪裡有缺口、缺口多大,一眼就看得出來。清單的價值在對照之後的決策,不在清單本身的長度。
補在本頁、另開一頁,還是先不動
修補的順序是三步:先盤點主題,再對照缺口,之後逐頁做邊界檢查。前兩步很快,重點在第三步;沒有明確需求訊號的主題,先觀察不動。
第一步,拿一個主題,把主問題與切面寫下來,材料就是上一節的連環問題清單。第二步,拿清單對照現有頁面:哪些問題已經有頁面回答、哪些沒有、已有的頁面彼此連不連得起來。這兩步的產出是一張對照表,不是一疊新文章的題目;多數主題盤完會發現,真正缺的比想像中少。
第三步,逐頁檢查內容邊界。每一篇既有文章都問兩件事:它承諾回答的主要問題是什麼?它答完了沒有?缺的切面若屬於主問題的一部分,補在本頁;若可以獨立成立,另開一頁,再用內部連結把兩頁自然接起來,讓讀者與搜尋引擎都走得通。決定頁面劃分的依據,是讀者需求與內容邊界,不是猜測的子查詢數量;「五支至少接三支」這類說法沒有官方依據,別拿來當驗收標準。
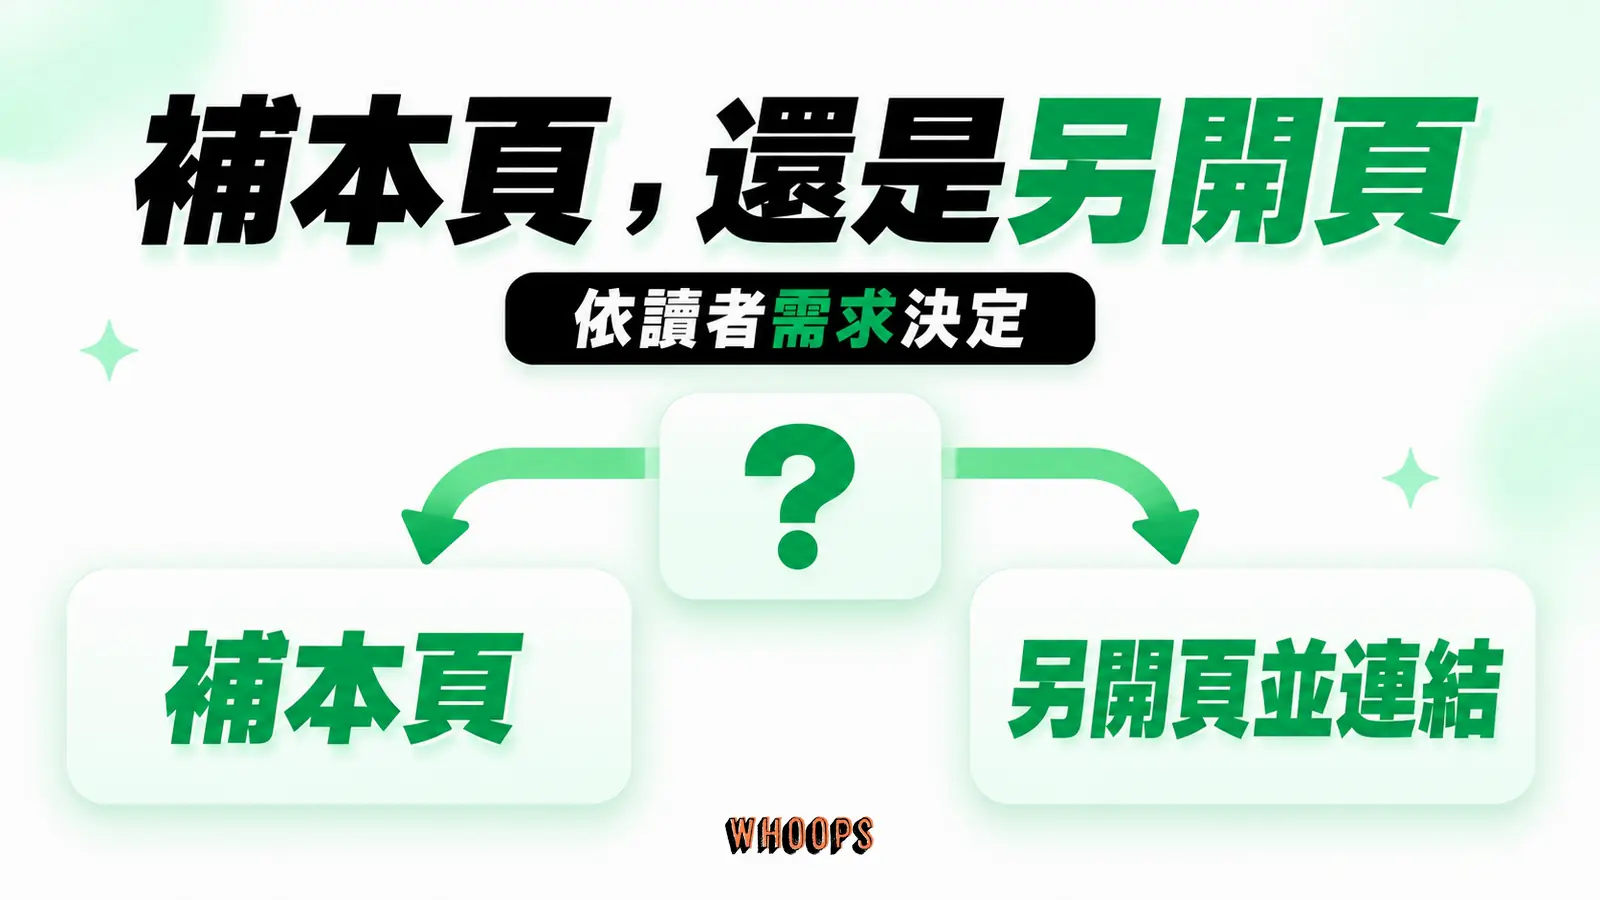
判斷能不能獨立成頁,看三個條件:讀者任務是否不同,查價格與學做法是兩種任務;更新節奏是否不同,價格常改,做法少改;第一手資料是否不同,一頁靠定價與庫存紀錄,一頁靠操作過程的觀察。三個條件一個都沾不上,就併回本頁;沾得上兩個以上,另開頁通常比較好維護,也比較容易各自被完整回答。
補本頁有順序。先補會改變結論的資料:數據、日期、適用條件、價格;再補讀者會問而沒答的段落,一問一段,段首給答案;文字打磨放在收尾。另開新頁時,新頁要有自己的主要問題與第一手材料,不是把本頁切薄了事;切完兩頁都答不好原來的問題,就寧可不要切。
動手修補時,工序比靈感重要。段落自足:一段回答一個問題,開頭先給答案再給理由。命名要能對應到查證:地名、型號、適用條件、價格、資料日期,寫得出處的就留下出處。同一實體前後稱呼一致,別一下全名一下簡稱。要下標記,就只描述頁面真正呈現的欄位,用結構化資料把這些屬性交代清楚;官方並未要求 AI 專用的 Schema,通用標記即足夠。
架構面同理。網站架構與內部連結的目的是讀者導覽與頁面互相可達,不是 AI 引用的入場券;同義詞自然寫進敘述,讓不同說法都讀得通;把詞彙堆成一串清單的做法,在這裡起不了作用。這些原則與 Entity SEO 讓實體被正確理解的做法是同一件事:把誰、什麼、在哪、什麼條件,寫到人和機器都讀得懂。
數字門檻與保證式說法,可以先放掉
市面上流傳的幾種說法,可以一次清掉:子查詢有固定數量、命中幾支算及格、保證被 AI 引用、必須安裝特殊 AI Schema。這些都沒有官方依據;可控的仍然是搜尋資格、內容品質與可發現性。
判斷規則很樸素:只要有人保證某個效果,幾支、幾成、幾週見效,就追問資料來源與量測方法。答得出來源與方法的,再看樣本與期間;答不出來的,當銷售話術處理。官方文件撐不出來的數字,不必替它補位。
術語也順勢對齊。GEO、AEO、LLMO 指的都是讓內容在生成式 AI 的回答場景被正確理解與使用這一族做法,名詞不同、範圍高度重疊,辨異可讀GEO、AEO 與 LLMO 的差異。對齊之後就放掉,別為了三個名字做三套重複的事。
資源上的建議只有一條:把行銷資源從逐詞操作移回讀者任務。能源花在可控處,報酬結構的推測一律標示為推測;自評卡分數、分數拉升幅度、一兩個月見效、特定百分比的流量推論,這類承諾缺乏可驗證的基礎,先放掉不會損失什麼。
同一套紀律也可以拿來檢驗工具。挑 AI 搜尋相關的量測工具時,先看它量的是什麼:查詢排名、引用出現、品牌提及,還是進站流量;定義講不清楚的工具,名詞再新也撐不起結論。工具的價值在讓可觀測的訊號更整齊,不在代替你做判斷。
修補之後怎麼驗證,何時再判斷
驗證要分開看:傳統查詢成效一組,AI 相關數據一組,各自獨立解讀,設固定觀察期,不預設因果。
各報表有各自的用途。Search Console 的查詢報表看傳統成效的走向,以及變化發生在哪些查詢;AI 功能相關報表看 AI 外觀的曝光與點擊;GA4 追蹤 AI 進站看實際抵達網站的流量與行為;微軟端有 Bing AI Performance 報表可以看引用相關資料。四個位置看的東西不同,結論不要互相搬運;每一組數據都記下取得日期與統計口徑,之後的比較才有共同基準。
觀察期與樣本紀律(示意):先固定期間,例如變更後追蹤數週,前後各取一段可比較的同期資料,把季節性與同期的其他改版列進考量;觀察期內不再動同一批頁面,讓資料有機會說完話。實際期間依流量規模調整,這裡不給保證型數字。
歸因有邊界。逐子查詢歸因做不到,子查詢不可見,「沒被引用」也就無法歸因到特定的內部階段;能觀察的是頁面層與查詢層的變化。變化出現時,先記下日期與範圍,再查同期事件,順序保持一致,之後複查才有依據。同樣的紀律適用於其他 AI 搜尋:是否採用 Google 所稱的 fan-out,只有供應商自己的說明算數;官方表態之前,一律以各家的文件與實際輸出為準。
再往後看,介面還在演進。代理式搜尋讓系統走向多步、主動補查,搜尋產品的年度發表也值得定期追蹤,例如 Google I/O 上的搜尋相關公告;品牌在答案場景被提及的情況,可以列入固定觀測。方向記下就好,不做時間表預言。
回到週一早晨的那個問題
主管的問題,可以用一分鐘回答。機制本身:Google 公開了概念,未公開細節,我們沒有新的旋鈕。判斷:四個問題走完,結論多半是聚焦補缺口,不是重寫。驗證:報表分組看、觀察期固定,下次再判斷的時間點現在就排進行事曆。
要照唸的版本,三句話就夠。一、這個機制沒有留給我們新的操作介面,能管的是內容與資格。二、先把點擊、曝光、資格三類症狀查完,證據指向哪裡再談哪裡。三、多數情況的行動是補缺口:主問題補在本頁,獨立子題另開頁並互相連結。
品牌層的變化,可以順著同樣的紀律另行觀察:在答案場景被推薦、被提及,是可追蹤但不可承諾的一塊;想跟進這條線,可以讀品牌成為 AI 推薦答案的觀察方法。
可以承諾的只有流程:資料日期補齊、資格檢查跑完、觀察期設好,之後讓證據決定下一步。排名、流量、引用都不在承諾範圍裡。週一早晨的問題,就答到這裡。