GEO 與 SEO 差在誰做選擇:列表讓人挑,答案替人選
GEO 與 SEO 的差別不在入口長相,而在誰做選擇:搜尋引擎排好頁面讓人挑,生成式引擎拆解來源、組成一段答案替人選,競爭單位從頁面位置縮成論點。從被讀到、被拆解、被核對到被挑走逐層檢查,用 GSC 曝光、Bing 引用、GA4 引薦三本帳分開驗收,避開四種診斷誤判,把資源押在真正卡住的那一層。
月初的行銷會議常出現同一種僵局。一派主張內容要全面改寫給 AI 看,再不改就來不及;另一派咬住基本盤,說連搜尋的基礎都沒站穩,追新名詞只是燒預算。預算只夠先押一邊,決定落在你手上,而兩邊拿出來的都是焦慮,不是證據。
這種爭執難解,通常是心裡的模型先錯了。多數人把 AI 搜尋想成「把結果第一頁念一遍」,念到誰誰就贏。這個模型有自己就能驗證的破綻:拿同一個問題去問不同的 AI,答案與引用的來源清單差異很大;被點名的來源,也常不是排名最前面那批。要真是照排名朗讀,這兩件事不會發生。真正的分岔在「選擇」這個動作的位置:搜尋引擎排好頁面讓人自己挑;生成式引擎把多個來源拆成論點,組成一段答案替人挑。競爭的單位跟著縮小,從搶一個頁面位置,縮成搶一句話。
「GEO 跟 SEO 誰重要」吵不出答案,因為問錯了。問得回答的是「我的網站卡在哪一層」:先估自己的流量風險,再沿一段答案被組出來的過程逐層檢查,看內容有沒有被讀到、被拆解、被核對、被挑走,量測數字分開驗收,資源要押哪邊自然會浮出來。
快速重點:與其爭 GEO 會不會取代 SEO,不如看懂答案怎麼被組出來:搜尋引擎排好頁面讓人自己挑,生成式引擎拆解來源、替人組出一段答案,競爭單位從頁面縮成論點。逐層檢查被讀到、被拆解、被核對、被挑走的表現,曝光、引用、引薦分開驗收,資源順序自然浮現。
先拆掉一個心裡模型:AI 不是把排名念出來
模型的破綻可以自己驗。挑三個核心關鍵字,分別丟給兩三個開了網路搜尋的 AI,記下每次的答案與引用清單,隔週再問一次。你會看到清單在動:同題重問會動,換裝置會動,換帳號也會動。要是答案等於第一頁的朗讀稿,引用清單應該穩定對應排名;實際看到的浮動說明,生成式引擎組答案時有自己的檢索、比對與組裝方式,排名只是原料之一,不是劇本。
把兩種引擎的工作方式並排放,差異更清楚。搜尋引擎的工作到「排出清單」為止:檢索、索引、算相關性,輸出一排頁面,之後的判斷交還給人。生成式引擎多走兩步:把選進來的頁面拆成論點,再組裝成一段連續的答案,中間的比對與取捨發生在機器內部,使用者只看到結果。多出來的兩步,就是後面「被拆解」「被核對」「被挑走」幾節要檢查的對象,也是傳統 SEO 手冊沒有覆蓋的地帶。
GEO 這個詞有明確源頭:2023 年普林斯頓等校研究者發表的生成式引擎優化論文。同一件事在市場上還掛著 AEO、LLMO 等名字,各強調一個角落,指的都是「讓生成式引擎組答案時更有機會用到你」這門功夫,這幾個名字之間的關係站內另有地圖。名稱之爭不影響機制,接下來全部用機制說話。
模型換掉之後,先放一句反直覺的推論,後面會回收:在列表世界,跟第一名一樣好,至少拿銀牌;在答案世界,跟第一名一樣好,可能直接隱形。一個合理的解釋是,生成階段遇到說法一致的內容時傾向合併處理;這是推論而非已證實的機制,細節留到「被核對」那一節再拆。
同一個問題,四種人需要的是四種答案。自然流量在下滑的人,要先確認下滑歸不歸因摘要;被主管要求「AI 上找得到我們」的人,卡點常常在量測還沒接上;詢問量變少的 B2B 團隊,該看的是實體訊號與論點差異;剛起步的新站,順位完全不同,入場券一張都還沒拿。用一套通論回答四種人,只會得到四個都不準的答案,先問卡在哪一層,檢查才有對象。
接下來的動線照一段答案的生產線走。先估摘要對點擊的風險,再依序檢查內容被讀到、被拆解、被核對、被挑走四個環節,收在測量與誤判排除。每一層對應不同的檢查動作與補救方式,「誰重要」的爭論,走到這一步變成可驗證的工程問題。
摘要先接住問句:流量風險有多大,怎麼不靠感覺估
摘要改變的不是排名,是點連結的理由。一段夠用的答案先接住「快速知道」的需求,使用者少了非點不可的急迫,資訊型查詢首當其衝;查規格、比價格、找購買路的查詢,摘要能替代的篇幅有限,交易通常還是回到頁面上完成。風險集中在哪,取決於你的流量結構,而不是新聞標題的恐慌程度。
資訊型查詢裡的吸收程度也不同。定義型的問句,一段摘要常常就是完整答案,點擊的理由最薄;步驟型的問句,摘要給骨架,細節仍會把人送往頁面;比較型的問句,牽涉條件與取捨,摘要多半只能給結論式的起頭。盤點時把這幾種問法分開標,會看到風險不是一整片,而是集中在特定類型的問句上。
點擊端的變化有公開觀察可以參考。Pew Research Center 2025 年 7 月的短讀發現,結果頁上掛著 AI 摘要的那些查詢,使用者按下連結的比例明顯偏低。兩個但書要放在旁邊:這是特定瀏覽樣本上的觀察;觀察到的是相關,不是對每個網站、每種查詢的跌幅保證。研究給方向,自己的站要自己量。
與其對著總流量發慌,不如做一份貼身盤點。挑出最近一季帶進最多造訪的 20 個頁面,逐頁貼上資訊型、交易型、導航型的標籤,再進到實際的搜尋結果,分頭量兩件事:摘要出現的比例,以及有摘要與沒摘要時點擊的差別。兩件事分開記,露出多寡說的是被看見的方式,點擊升降說的是被需要的程度,混進同一個數字就會誤判。量測還要認清浮動的來源:同一組查詢換了帳號、換了裝置或所在地,摘要可能時而出現、時而消失,觸發條件也持續在調,結論一律以自己眼前查到的結果為準。
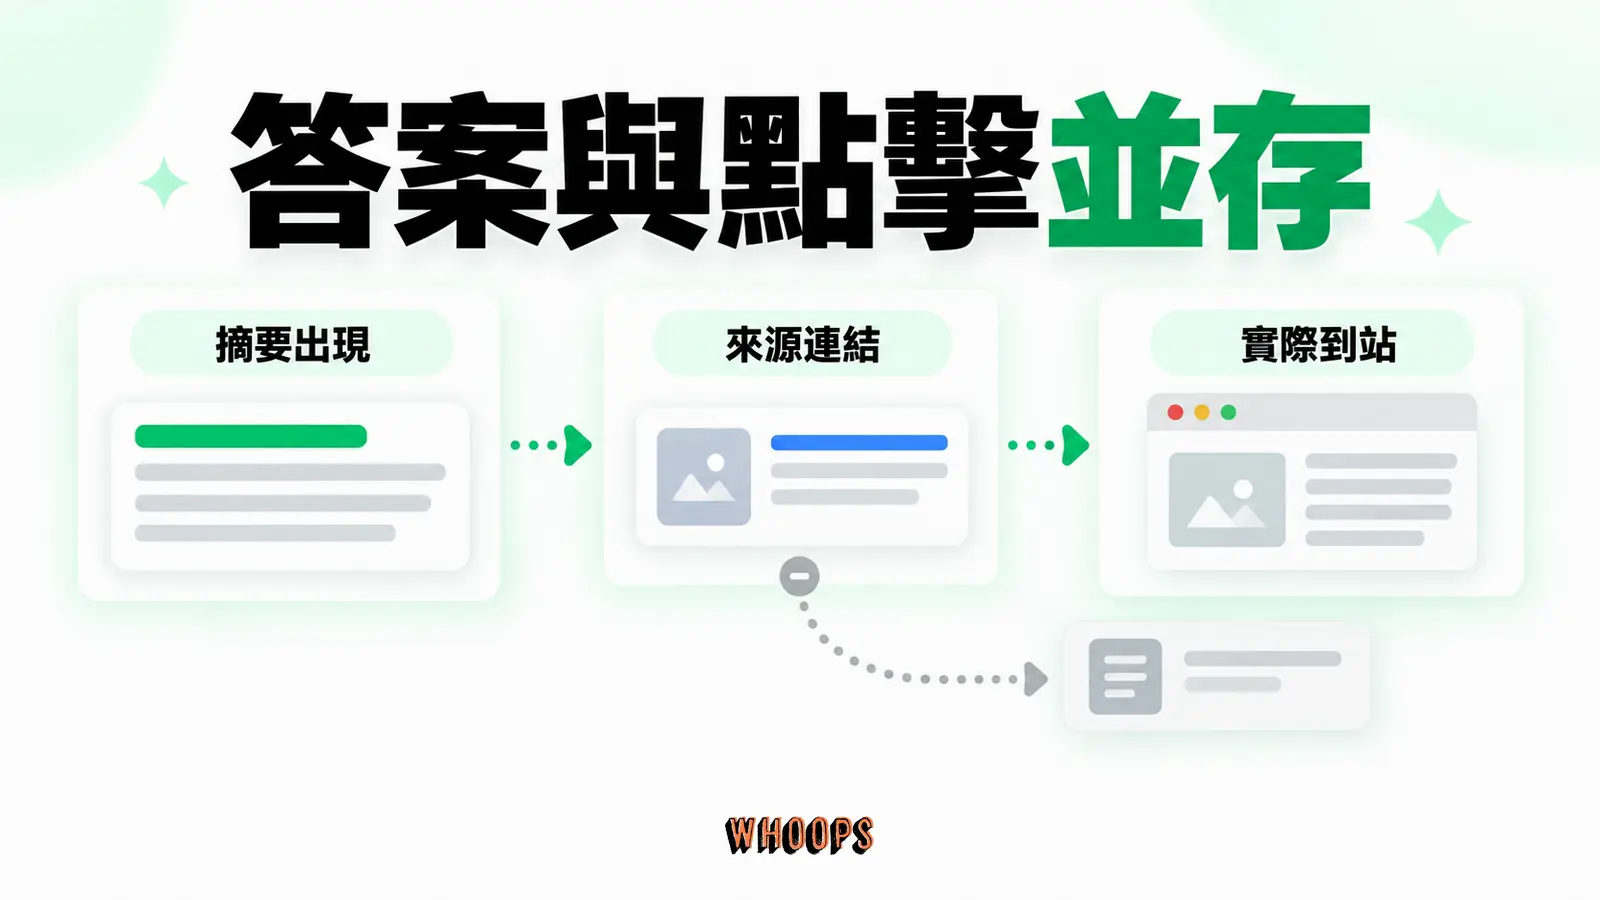
三種意圖怎麼標,用行為判斷,不用猜。查「怎麼挑」「是什麼」的頁面屬資訊型;搜尋裡帶著「價格」「比較」「推薦」而落地在商品或方案頁的屬交易型;搜自己品牌名、直接找官網某頁的屬導航型。同一個站常常三者都有,風險也就分三種速度變化,這正是要先盤點再估風險的原因。
量測要落地,方法比工具重要。建一張表,欄位放頁面、主要查詢、意圖類型、摘要有沒有出現、當週點擊與備註;每週固定時間記一次,裝置與帳號保持一致,中途有變動就寫進備註。至少跑四週再讀趨勢,單週的變化多半是雜訊。這張表同時回答兩個問題:風險是不是真的集中在資訊型頁面,以及被摘要接走的查詢,是不是本來就離成交很遠。
列表世界的稀缺可以當對照組。Backlinko 對四百萬筆結果的點擊率分析估過,第一名平均點擊率約 27.6%,第十名不到 3%;同一頁結果,位置不同,待遇差近十倍。列表世界稀缺的是位置,答案世界稀缺的是句子,哪一句被搬進答案,比整頁排第幾更決定輸贏。這條對照先記著,到「被挑走」一節回收。
品牌心智是另一條還活著的路。HubSpot 的行銷現況報告觀察到,行銷人對「被 AI 提及」的關注明顯上升,業界方向可以參考,不能替代自己站上的因果分析。資訊型內容的價值正在往「建立候選名單的印象」移動:被摘要吸收掉的快速查詢,本來就離成交較遠,留下來的價值是讓人記住名字,下回帶著需求找上門。方向判斷如此,不是保證;三種意圖的風險排序,也要以每頁實際的結果與點擊資料為準。摘要的觸發與運作,站內有專文拆解。
被讀到:可存取這層,規則最舊也省不得
Google 官方的 AI 最佳化指南把定位說得很白:AI Overviews 與 AI Mode 沿用搜尋既有的檢索與索引,內容要出現在生成式功能裡,靠的是那套行之有年的搜尋基礎,不需要 llms.txt、特殊 Markdown 或專用 schema,指南也把 AEO、GEO、LLMO 這些新名字劃回 SEO 的範圍。這段是官方說法,把它當地基:入場券沒有翻新,翻新的是入場之後的比賽方式。
因果鏈很短:沒被索引,連候選池都進不了。可存取、可索引、符合摘要資格,是各平台共通的最低門檻;這層規則累積得最久,文件完整、檢查方法成熟。檢索環節的完整說明站內有專篇,先看與診斷有關的部分就好。
檢查從 Search Console 的索引涵蓋範圍開始,先找「沒被索引」與「遭排除」的頁面,再用網址審查逐一確認原因;robots.txt 的封鎖結果、noindex 標籤、轉址到不存在的網址,修復方式各不相同,混在一起修只會越修越亂。站內連結也要看:重要頁面若只掛在首頁輪播,機器循連結爬行時可能根本走不到。
別家平台不能一體適用。Google 沿用自家搜尋索引,其他 AI 有自己的爬蟲、合作資料與檢索管道,放行與封鎖的對象要逐家核對,不能因為 Google 讀得到,就假設全部讀得到;反過來也一樣。共同點是入場邏輯都樸素:讀得到、讀得懂,才談得上被用。
這層的檢查要產出可修復的障礙清單,不是一疊技術名詞。依序確認:重要頁面有沒有被 noindex 或 robots.txt 誤擋、伺服器回應穩不穩、轉址鏈乾不乾淨、主要內容是不是渲染在原始 HTML 裡。每一項標出嚴重程度與修復動作,修完再往下一層走。這一節只談入場券:做好可存取不等於會被引用,但做不好,連被引用的資格都沒有。
爬蟲這一關:封鎖與放行,比你想的更細
入場券之上還有一個容易誤判的開關:爬蟲控制。協定本身沒有改版,IETF 的 RFC 9309 仍是 robots.txt 排除協議的現行標準;變的是來敲門的 bot 變多、用途變細,一刀切的封鎖決策常常擋錯人。
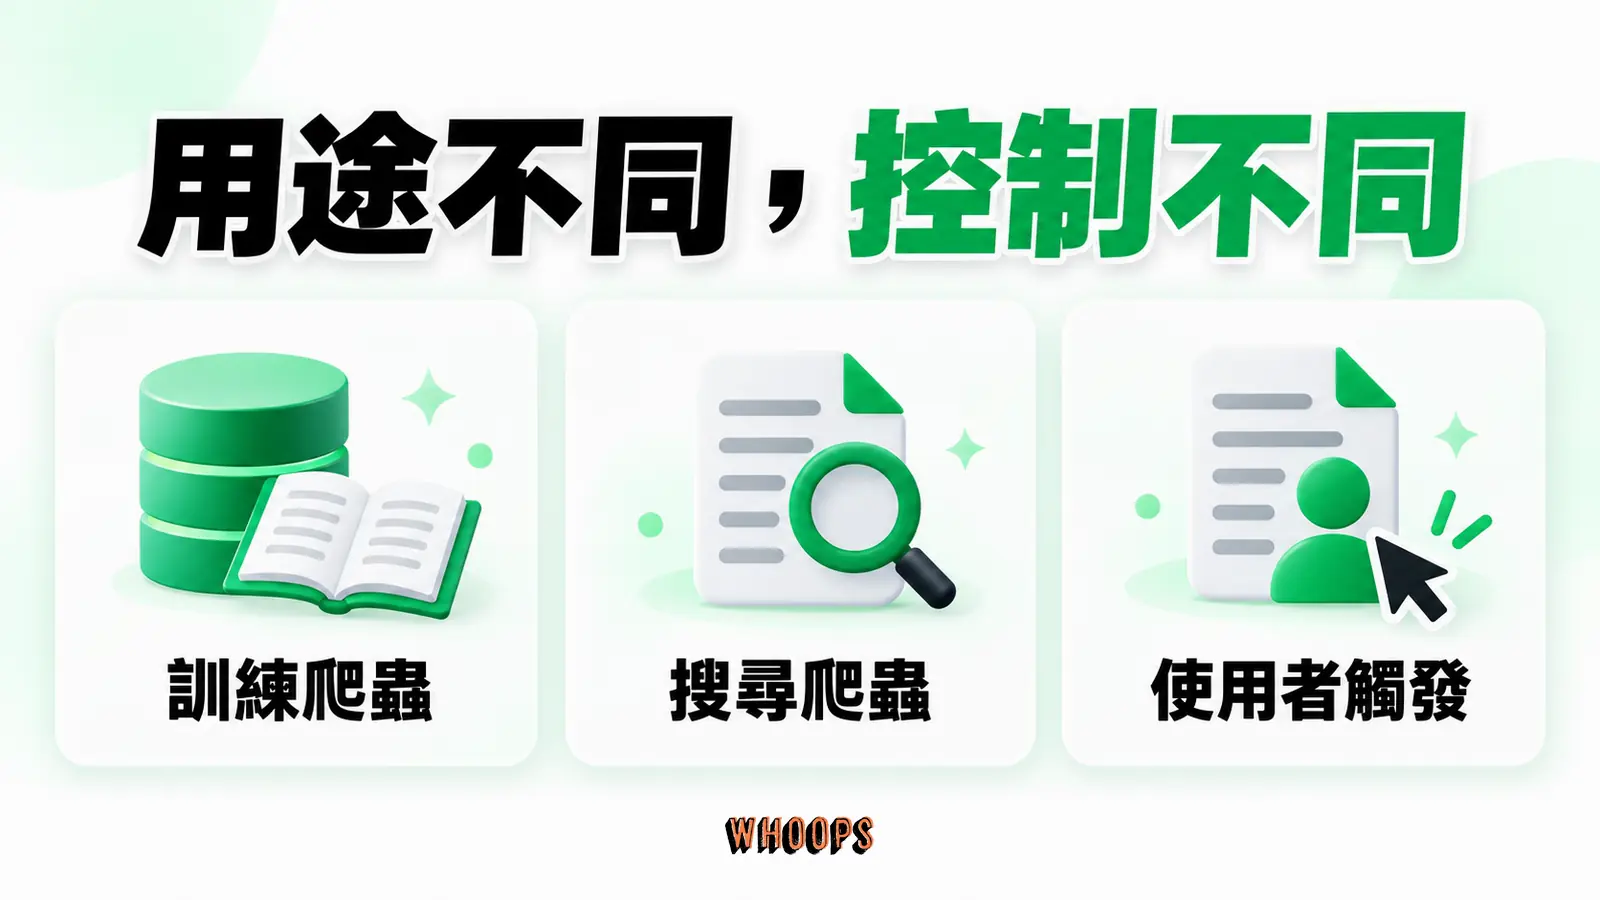
OpenAI 的爬蟲文件就是現成的練習題,至少要分開核對三種身分:GPTBot 用於模型訓練;OAI-SearchBot 用於搜尋;使用者把你的網頁貼進對話時觸發的存取,又是另一種。三種身分對 robots.txt 的適用情形不同:前兩種各有專屬規則可放行或封鎖,使用者觸發的存取則不一定經過 robots.txt,官方文件也提醒這類存取未必受規則約束;想被 AI 搜尋引用,卻擋掉了搜尋用途的 bot,損失就發生在沒注意到的層。底線也要畫清楚:robots.txt 是靠爬蟲自願遵守的排除協議,不是存取控制,真正不能公開的內容要靠登入牆與伺服器權限,這條界線 RFC 9309 寫得明白。
爬蟲預算的脈絡順手併進來。這件事主要困擾大型網站,或網址變體多的站,例如篩選器、分頁與標籤頁把網址撐爆的電商;一般中小型網站把可索引性和站內連結顧穩,就比計較那個抽象數字划算。動 robots.txt 之前把用途分清楚再下手,設定檢查的完整做法站內有整理。
封鎖訓練用途的爬蟲,是獨立的商業決策,與搜尋引用分開考慮。開放,內容可能成為模型的養分,換來的是難以追蹤的長期影響;封鎖,表達的是不願被拿去訓練的意向,不等於內容從此不會被任何管道取用;模型對你的認識會不會因此變薄,官方沒有給保證,能確定的只是少了一條主要的接觸管道。兩邊都沒有免費的選項,重點是別把這個決定跟「想不想被 AI 搜尋引用」綁在一起,那是另一種 bot 的管轄範圍。
被拆解:機器讀的單位,比你寫的小
進得了視野,還要拆得動。先畫好這節的定位:以下談的是編輯上的工作假設,不是平台公布的規則。生成前的檢索與理解,處理的單位看來偏向段落與論點,而非整篇文章;一個能脫離上下文獨立成立的句子,就是比較容易被撿走的零件。鋪陳式的寫法在這個假設下吃虧:結論藏在第三段之後,拆出來的片段常缺主詞或缺答案,機器能取用的材料跟著變少。
差別用一個不具名的小例子看。同一個論點,鋪陳版寫「說到挑寢具,其實要考慮的事情很多,材質、支數、織法都有學問,接下來慢慢說明」;直答版寫「挑寢具先看材質與織法:純棉透氣適合怕熱的人,天絲涼感但保養要求高」。兩句的資訊密度不同,後者的片段抽離上下文仍站得住,被單獨取用的機會大得多。改舊文的檢驗也一樣:圈出每一段,問「有沒有一句話,抽走之後還是完整的答案」。
結論先行也是同一套假設下的判斷,不是文風上的鐵律。若擷取單位真的偏小,越早出現完整答案的段落,越有機會在被截取時保住語意;把重點留到結尾才寫的布局,就等於把最好的零件放在最容易被截掉的位置。
問句對應是拆解層常用的實作手法。從搜尋報表與客服紀錄裡收集真實問法,替每個主力頁面指定一個主問句,頁面的答案句直接回應它;相鄰的次問句收在同頁尾部或獨立成頁,不要全部擠進導言。這裡要誠實畫線:Google 官方指南明說系統理解得了同頁的多個主題,並不要求為了 AI 把內容切小;「一頁對一個問句」是讓力氣集中、量測歸因單純的編輯紀律,不是被引用的資格條件。
結構化資料在這層幫忙解析頁面裡的事實與關係,前提是標記與可見內容一致,掛上機器讀不到的資訊反而製造矛盾;沒有 AI 專用的 schema 門檻,與被讀到一節的官方定位相同。結構化資料的完整指南與可引用結構的展開做法站內都有,重點只有一個:單位縮小之後,句子本身的品質升成第一順位。
被核對:跟第一名一樣好,反而容易隱形
生成階段會參照多個來源,這一步帶出全文最反直覺的推論,先聲明:這一節的因果是推論,官方並未公布這套機制。當十個來源對同一件事的說法幾乎相同,答案很可能只需陳述這個共識,不必點名任何一個;有差異的訊息,例如獨有的數據、別家沒有的實測紀錄、明確的第一手經驗,則比較有機會被標上出處。照這個推論,跟第一名一樣好,在答案世界可能等於隱形:你提供的部分被用掉了,名字沒有被帶到。開頭埋的伏筆在此回收,內容正確是入場條件,被點名還要有別的理由。
經驗是最常被拿出來解釋點名的理由。E-E-A-T 裡的 Experience是 AI 寫不出來的部分:實際拆過、量過、失敗過的紀錄,別的來源複製不走。素材常常已經在手裡,只是沒被當成內容:客服對話裡重複出現的疑問、報價時被問爛的比較、退換貨原因的統計,整理出來都是別家拿不走的原料。落實成工序,就是改舊文時逐段問兩個問題:這段有沒有只有我們能說的內容;這段抽走上下文後還算不算完整答案。兩問都過,句子被搬進答案的勝算會變大,這是提高機會的工序,不是保證。
差異有幾種常見的表現。數據差異:你量過、別人沒量過的數字;工序差異:你踩過的步驟與順序;觀點差異:同樣的事實,你給出不同的判斷條件;範圍差異:別人寫通則,你寫特定情境的限制。四種都不必是驚人的發現,夠明確、夠可查證,就比較容易被從共識裡認出來。
身分是另一塊拼圖。核對發生在「這個來源是誰」的層次,品牌在外部世界被談論的紀錄會進入對帳材料,讓「你」在比對時有個身分可對,實體訊號的經營是獨立的一門功課。邊界也講清楚:外部提及要自然可信,靠引導換來的堆砌外鏈、造假評論,下場通常是整個被剔除。GEO 的原則整理站內已有長文,不逐一重複。
被挑走:一段答案,養不起太多來源
稀缺本身就是這一關的主角。一段答案篇幅有限,掛得住的來源通常只有少數幾個,同題競爭者再多,槽位不會跟著變多;競爭者增加改變的是中選機率,不是獎項數量。順著前面的推論,位置稀缺換成句子稀缺之後,能出線的比較可能是把當下問句解得最乾淨的論點,而不是最完整的頁面;與其在單頁塞滿所有相關知識,把每頁的目標收窄,是讓可被取用的句子變結實的做法之一。
這也解釋了為什麼「內容變多」救不了引用量。同題的新文章加入戰局,爭的是同一批少數槽位,產能開得再大,槽位不動;把產能換成差異化,把同一個論點寫出別家沒有的部分,才有新的中選理由。在稀缺的結構下,質的排序先於量的堆疊。
與列表世界對照,兩種稀缺在此交會:Backlinko 的位置數字前面引過,不再重複,只留概念對照,列表裡搶版面,答案裡搶那句話。誠實的補充是:被引用不等於被點擊,摘要先吸收了資訊需求,剩下的動機才輪到連結。引用次數是露出,不是流量保證,更不是轉換保證。
三本帳:曝光、引用、引薦不能互相換算
開始行動之後,成敗要靠數字回答,而這些數字分屬三種儀器。Search Console 的生成式 AI 報表量曝光,Bing 的 AI Performance 量 Bing 生態裡的引用,GA4 看得到的是可辨識的引薦。三者的定義、涵蓋範圍與採計方式都不同:用曝光推排名、用引用推流量、用點擊率量引用成效,都是把儀器拿錯場合。三本帳只能並列看趨勢,不能互相換算,更不能加總成一個分數。
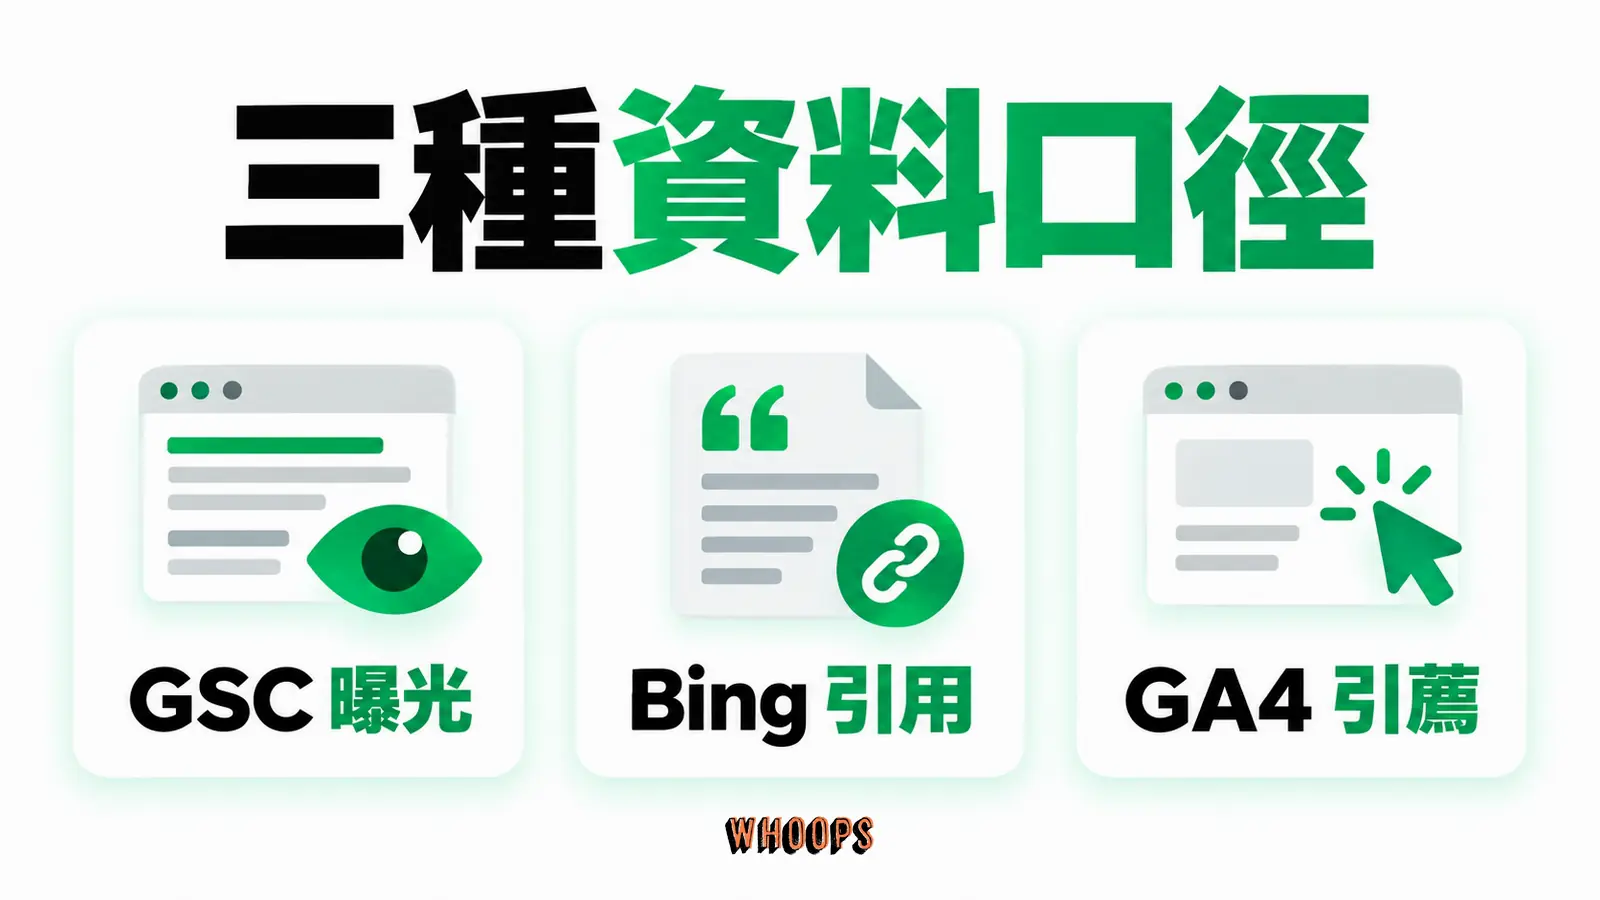
Google 這邊的觀測窗口正在補上。John Mueller 在 2026 年 6 月的 Search Central 影片裡介紹了生成式 AI 報表的初版,同年 8 月這份報表的資料在全球開放,站長第一次能拿到 Google 生態的相關量測。時程以官方公告為準,重點是工具已經存在,而且還在演進,量測不再只能靠手動抽查。
口徑要看清楚再慶祝。Google 對這份報表的說明寫明:它量的是曝光,不是引薦或轉換,數字要與其他平台和 GA4 分開解讀。報表上升代表內容出現在生成式體驗的機會變多;有沒有人因此點進來、有沒有成交,要回到 GA4 與訂單資料才回答得了。曝光是曝光,生意是生意,中間每一步都要另量。
Bing 的窗口開得更早。Bing Webmaster Tools 在 2026 年 2 月把 AI Performance 報表推入公開預覽,提供引用次數等觀察,是目前少數官方的引用量測。口徑限制同時要看:資料涵蓋 Bing、Copilot 與選定的合作整合,不能當成所有 AI 平台的市占或全貌。這份報表的解讀站內有專篇。
等不到官方數字的平台,先用代理指標過渡:固定問題集裡的品牌提及頻率、出現的平台數、答案引用的內容類型。看趨勢不看絕對值,累積三到六個月再下判斷;GA4 切出 AI 引薦的做法站內有逐步說明。
固定問題集是代理指標的骨架。挑十到二十個真實問法,涵蓋核心服務、比較、痛點三類,每月同一時間、同一裝置與帳號逐一提問,記錄品牌出現與否、被引用的是哪一頁。問法一旦固定就不要改,改了就斷了可比性;要測新問法,另開一組並行累積。
機制管不到的地方:報價頁、在地服務與冷門題
機制講完,也要講機制管不到的地方。一個建構情境(非真實客戶):一家寢具電商,產品頁的勝負在規格、價格與結帳動線,AI 答案頂多在「怎麼挑寢具」這類問題裡種印象,不會替你完成結帳。這種站的可引用籌碼在教學內容:挑選、照顧、比較的文章是進入答案的票,產品頁顧轉換,兩種頁面角色不同,不必用同一把尺要求。判斷的粗略原則是問句離交易的距離:離交易越遠的問句,進答案的價值越高;離交易越近的頁面,顧好轉換比顧好引用划算。
另一個建構情境:一家 B2B 服務公司,決策週期長,名單比點擊值錢。資源先押在可被引用的論點與實體訊號,讓潛在客戶在到處查證的階段反覆遇到可信的名字,報價頁顧好詢問體驗。在地服務的瓶頸常在地圖與商家檔案這類在地訊號;極冷門的題目可能查無資料,AI 直接回答不知道。這些都不是答案組裝層能修的問題,資源放錯層,只會白燒。
引用次數少也不必然是失敗。查詢量本來就小的主題、以既有客戶為主的業務,被引用的商業價值本來就有限;把力氣花在轉換與留存,可能是更誠實的答案。判斷的依據回到流量結構與商業模式,不是「別人都在做」。
診斷路上最常見的四種誤判
逐層檢查的過程裡,結論會被四種誤判帶偏,每一種都長得像合理的判斷,拆開看才知道哪裡漏了。
- 流量下滑全歸因摘要。反證檢查:歸因之前,先比對季節性、版位變動、演算法更新與量測口徑有沒有同時發生。找得到別的嫌疑犯,就先別把帳記在摘要頭上。
- 拿點擊率量引用成效。引用是露出,點擊是行為,分母不同。曝光與引用各自的趨勢回答各自的問題,不要互換著用。
- 把單一平台外推到所有 AI。Bing 的引用資料、Google 的曝光報表、某次手動測試,各代表自己的口徑;跨平台結論需要跨平台證據,一份資料撐不起全部。
- 把一次性抽樣當趨勢。單日單次的觀察浮動大,固定問題集、固定條件連續追蹤,趨勢才有意義;要比對改版前後,也要留一組沒動的對照。
誤判改正之後,前面的檢查常常要重跑,因為歸因變了,卡住的那層會跟著變。診斷是循環,不是單次體檢,這也是下一節的工作地圖長成可並行形狀的原因。
卡在哪層修哪層:一張可並行的工作地圖
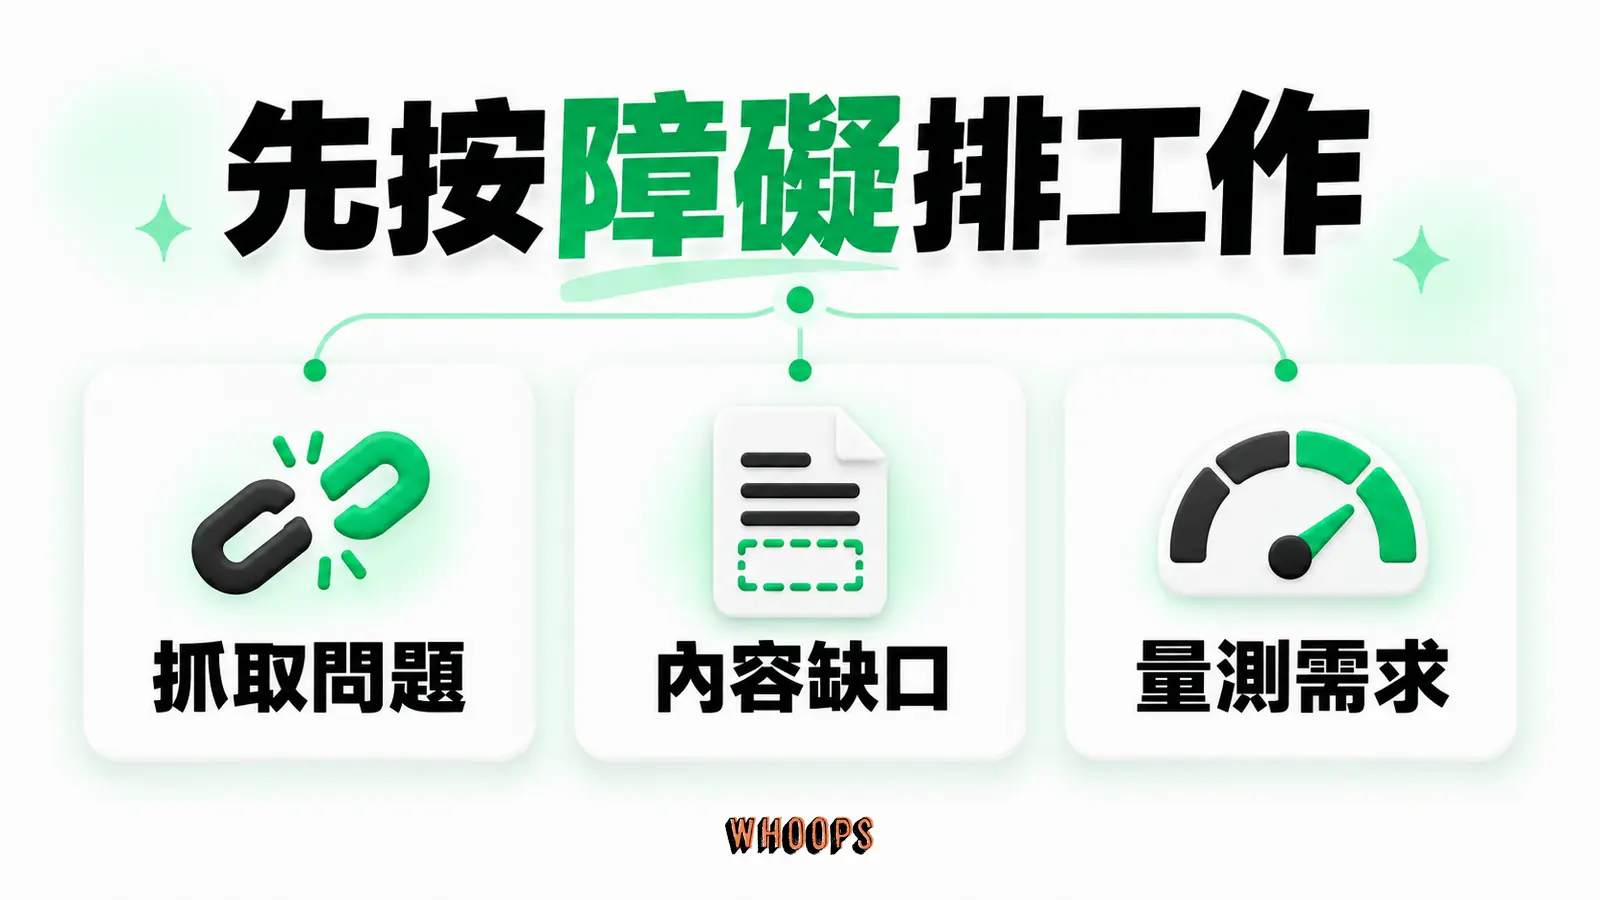
檢查跑完,資源排序的原則只有一句:先判斷網站卡在哪一層,對該層下功夫。讀不到修可存取,拆不動改句子,不被點名補差異與身分,量不到先把儀表接好。這是一份可並行、可調整的工作清單,不是線性必經的關卡;量測校正、暴露盤點、原料修復、籌碼生產四條線可以同時推進,資源多寡決定先後,不決定資格。
左右捲動檢視完整表格
| 卡點 | 檢查動作 | 看哪個數字 |
|---|---|---|
| 讀不到 | 核對索引狀態、robots.txt 誤擋、主要內容是否在原始 HTML | Search Console 的索引涵蓋範圍與檢索統計 |
| 拆不動 | 逐段做可擷取性檢驗,改寫缺主詞或缺答案的段落 | 頁面停留與捲動,搭配內容成效評估 |
| 不被點名 | 盤點獨有資料和第一手經驗,補實體訊號 | 固定問題集的品牌提及與出現紀錄 |
| 量不到 | 接上 Search Console 生成式報表、Bing 報表與 GA4 切分 | 三本帳各自的月趨勢 |
各卡點配一個本週就能做的第一步與驗收訊號。讀不到的站,先修一頁最重要頁面的索引問題,看 Search Console 的狀態變化;拆不動的站,挑三篇主力文章做句子級改寫,看引用行為有沒有動;不被點名的站,寫一頁只有你能寫的內容,看品牌搜尋的方向;量不到的站,把三個儀表接起來,先累積一個月基線。停損也先講好:連續兩個月沒有方向變化就換假設,不要在同一層加碼硬撐。
地基還沒動的站,先補搜尋基本功;要全域觀的,從GEO 概論讀起;兩邊資源怎麼分,完整的分配框架站內另有專文,比例依數據滾動調整,不是固定公式。回到開場那場會議:兩派的爭執可以用各層的證據回答,流量在掉的先看摘要與歸因,被引用少的看差異與身分,什麼都沒量的先把儀表接上。吵完誰重要,資源終究要落在某一層;把值得被撿走的那句話寫出來,是四層裡最便宜、也最常被跳過的起點。