Google 演算法排名下滑,多半不是懲罰,而是重新評估
Google 演算法造成的排名下滑,多數是系統重新評估後的相對位移,真正的懲罰是看得到通知的人工處置。這篇拆解蜂鳥、熊貓、企鵝留下的語意、內容與連結機制,說明 E-E-A-T、Navboost、核心更新與 AI 版面的界線,並附流量下滑當天的判斷順序與自檢清單。
本頁目錄
- 先說結論:讓排名下跌的,多半不是懲罰
- 排名由誰決定:一組系統的分工,不是一條公式
- 退役不等於停止運作
- 從字面到語意:蜂鳥改寫的那一步
- 混合意圖:同一個詞、四種需求
- 品質怎麼被計算:熊貓留下的判讀方式
- 資訊增益:判斷內容有沒有別處沒有的價值
- 連結怎麼被計權:企鵝與兩條處理流程
- 被垃圾連結纏上時
- 信任的框架:E-E-A-T、評分員與實體
- E-E-A-T:四個字母在評什麼
- 實體:讓系統認得你的品牌
- Navboost 能解釋你的排名嗎:點擊資料的界線
- 核心更新在重算什麼:重新評估,不是開罰
- 人工處置長什麼樣:垃圾政策與真正的罰
- AI 概述與 AI Mode:同一套基本功,新的計分板
- 流量下滑那天:用時間軸對案,別用直覺
- 動手修之前:三個自傷動作與一頁自檢清單
快速重點:排名下跌多數是系統重新評估後的相對位移,不是處罰;真正的懲罰叫人工處置,會在 Search Console 留下通知,看得到、查得到。熊貓、企鵝、蜂鳥不必再背成因,換成內容、連結、意圖三個自檢方向。掉落日期跟官方公告重疊只是假設,查證過再動手。
週一早上十點,電商後台的流量報表剛出爐,自然搜尋的曲線比上週同期少了一截,會議裡的第一個問題往往不是「哪一批頁面受影響」,而是「我們是不是被 Google 懲罰了」。這是個構想出來的場景,細節是虛構的,但對話的真實感很高,因為它每天都在發生:曲線一下跌,懲罰就成了第一個被點名的嫌疑犯。
這個直覺多數時候是錯的。Google 真正的罰有名字、有通知、有範圍,叫人工處置,會出現在 Search Console 的手動動作報告裡,註明違反了哪條政策、影響哪些頁面,修正後可以提交重新審查。這種看得到的罰,其實比想像中少見;佔比更大的下跌,是系統重新評估後的相對位移、技術事故,或需求本身的變化。熊貓、企鵝、蜂鳥這三個名字,常常只是被叫來頂罪的。
所以這篇不照動物編年走,也不從 2011 年的新聞開始念。全篇沿四組容易混淆的機制區分往下拆:字面與語意、頁面與網站層級、演算法處理與人工處置、重新評估與懲罰。每一節先講機制怎麼運作,再講界線在哪裡,收在可以查證的位置;讀完你會有一條當天就能跑的判斷順序,和一頁式的自檢清單。
先說結論:讓排名下跌的,多半不是懲罰
先把答案放在最前面。絕大多數的排名下跌,不是懲罰。判斷的起點只有一個問題:Search Console 的手動動作報告裡有沒有通知。有通知,才是人工處置,走政策救濟的流程;沒有通知,下跌多半屬於三種情況之一:系統重新評估後的相對位移、技術事故,或搜尋需求的變化。三種情況的救法完全不同,方向用錯了,後面做的都是白工。
三個高頻誤解,各用一句話拆掉。被懲罰的迷思:多數下跌沒有處置通知,屬於系統重算後的相對位置變化。執刑的迷思:熊貓、企鵝、蜂鳥已整合進核心系統或列為歷史改善,不再單獨發布同名更新。公式的迷思:排名由許多系統分工疊加而成,沒有一條公式可以反推分數。
範圍也先劃清楚。這篇講的是怎麼判斷、機制怎麼運作;確認原因之後的修補步驟、優先順序與復原節奏,是另一篇的範圍,可以直接接著讀排名復原的完整流程。判斷在這裡,修復在那裡,順序不要顛倒。
排名由誰決定:一組系統的分工,不是一條公式
要拆掉「一條公式」的想像,先換一個畫面:排名比較像評審團的集體決定,不像一台計分機。有的評審負責聽懂你問了什麼,有的評審判斷哪份資料相關、有料,有的評審只關心頁面好不好開、好不好用。沒有一位評審能獨自決定名次,名次是整團意見疊出來的結果。官方在 How Search Works 頁面對外說明的也是這個結構:許多系統各自負責一個面向,共同形成搜尋結果。這個結構也決定了診斷的態度:排名變動很少能歸因給單一系統,能問的是哪一類訊號變了,而不是哪個名字動了手。背景想補齊,可以讀Google 搜尋的運作原理。
三個歷史名稱,在評審團裡各有對應的職務。底下這張表把它們換算成今天還能用的三個檢查方向;先說清楚,這是編輯用的對照框架,方便把問題歸位,不是 Google 公布的官方分類。
左右捲動檢視完整表格
| 檢查方向 | 歷史名稱 | 今天的承接方式 | 今天就能問的自檢題 |
|---|---|---|---|
| 內容價值 | 熊貓 Panda(2011) | 核心系統的多項內容訊號 | 這一頁有沒有他處不容易得到的價值 |
| 連結品質 | 企鵝 Penguin(2012) | 核心系統即時降低垃圾連結的效果 | 連結是被推薦來的,還是做出來的 |
| 語意對應 | 蜂鳥 Hummingbird(2013) | 語意理解的持續演進 | 頁面回答的是不是查詢背後那個問題 |
這個對應有官方文件可以對照。Google Search Central 的排名系統說明文件,把系統分成現行與退役兩類,其中寫明 Panda 與 Penguin 已整合進核心排名系統,Hummingbird 列為歷史上的改善。名稱會退役,處理內容、連結與語意的職能沒有消失,只是換了位置繼續運作。
退役不等於停止運作
這也解釋一個新手常卡的點:官方都說併入了,市場上為什麼還在講熊貓、企鵝。因為併入核心之後,那套判斷邏輯仍在核心系統裡持續運作,只是不再單獨發布「某某更新」的公告;名字失去的是發布會,不是效力。行銷圈需要名字來講故事,這可以理解,但把名字當操作對象,就會生出「怎麼討好蜂鳥」這種問錯方向的題目:系統不吃討好,它們消化的是訊號。所以這篇從頭到尾不問「中了哪一個」,只問內容、連結、意圖三個方向裡哪個有問題。個別系統的細節,與逐次更新的完整時間軸,分別由專文和演算法更新歷史專頁承接:時間軸那篇管「發生了什麼」,這篇管「你該怎麼判斷」。查排名變動時需要讀版面,可以搭配搜尋結果頁的判讀。
從字面到語意:蜂鳥改寫的那一步
評審團裡最先上場的,是負責聽懂問題的那位。蜂鳥在 2013 年完成的,就是把「比對字面」升級成「理解意思」:同一個需求,換一套措辭,系統仍然找得到對的頁面。這一步對內容寫作的影響,比任何懲罰傳說都實在。
字面比對的極限,用一個在地例子看最清楚。有人搜「台南哪間牙醫週末有看診」,舊邏輯會去找把「台南」「牙醫」「週末」「看診」幾個詞都湊齊的頁面;語意理解做的則是判斷這個人要找「假日仍開診的台南牙科」,所以頁面上寫「週六日照常看診」,一樣配得上。措辭不同,需求相同,這就是字面比對失效、語意接手的地方。
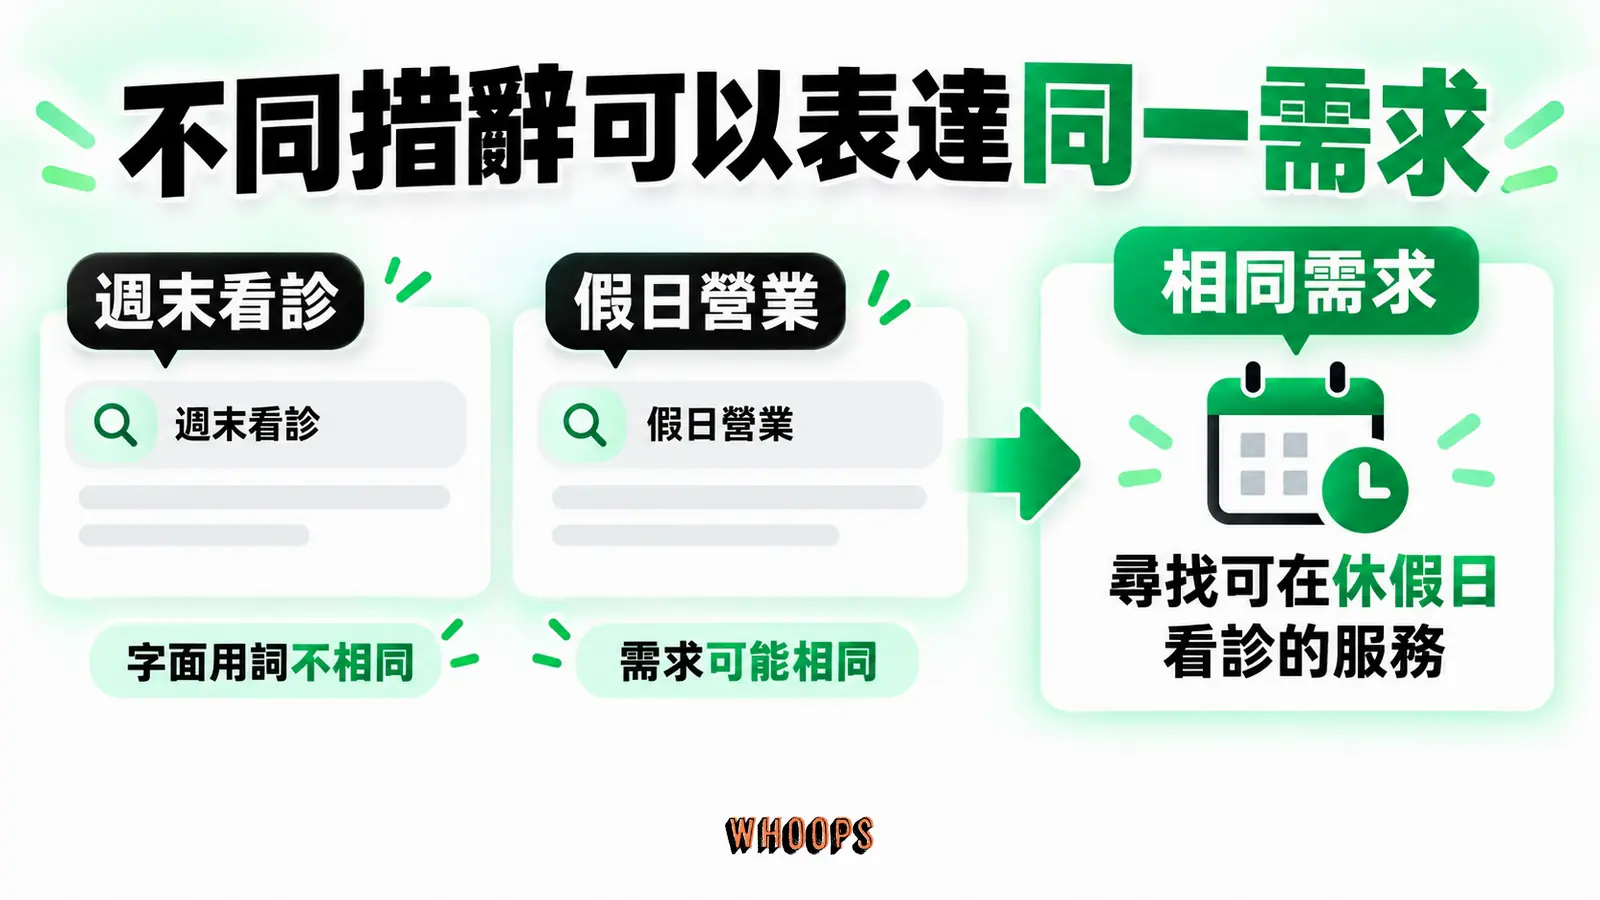
但字面線索仍然要寫。語意理解不是叫你丟掉關鍵字,而是不再需要為了塞進同一個詞,把句子寫得拗口。讀者會怎麼問,你就怎麼寫;同主題自然會出現的相關詞,讓它自然出現。檢查的方法很樸素:把頁面拿給一位沒接觸過這個主題的同事讀,問他這頁在回答什麼問題;他答出來的,就是頁面目前實際傳達的意圖,字面詞有沒有全部命中,之後再說。這也是搜尋意圖觀念的起點:先確認查詢背後的問題,再決定頁面要回答什麼。
混合意圖:同一個詞、四種需求
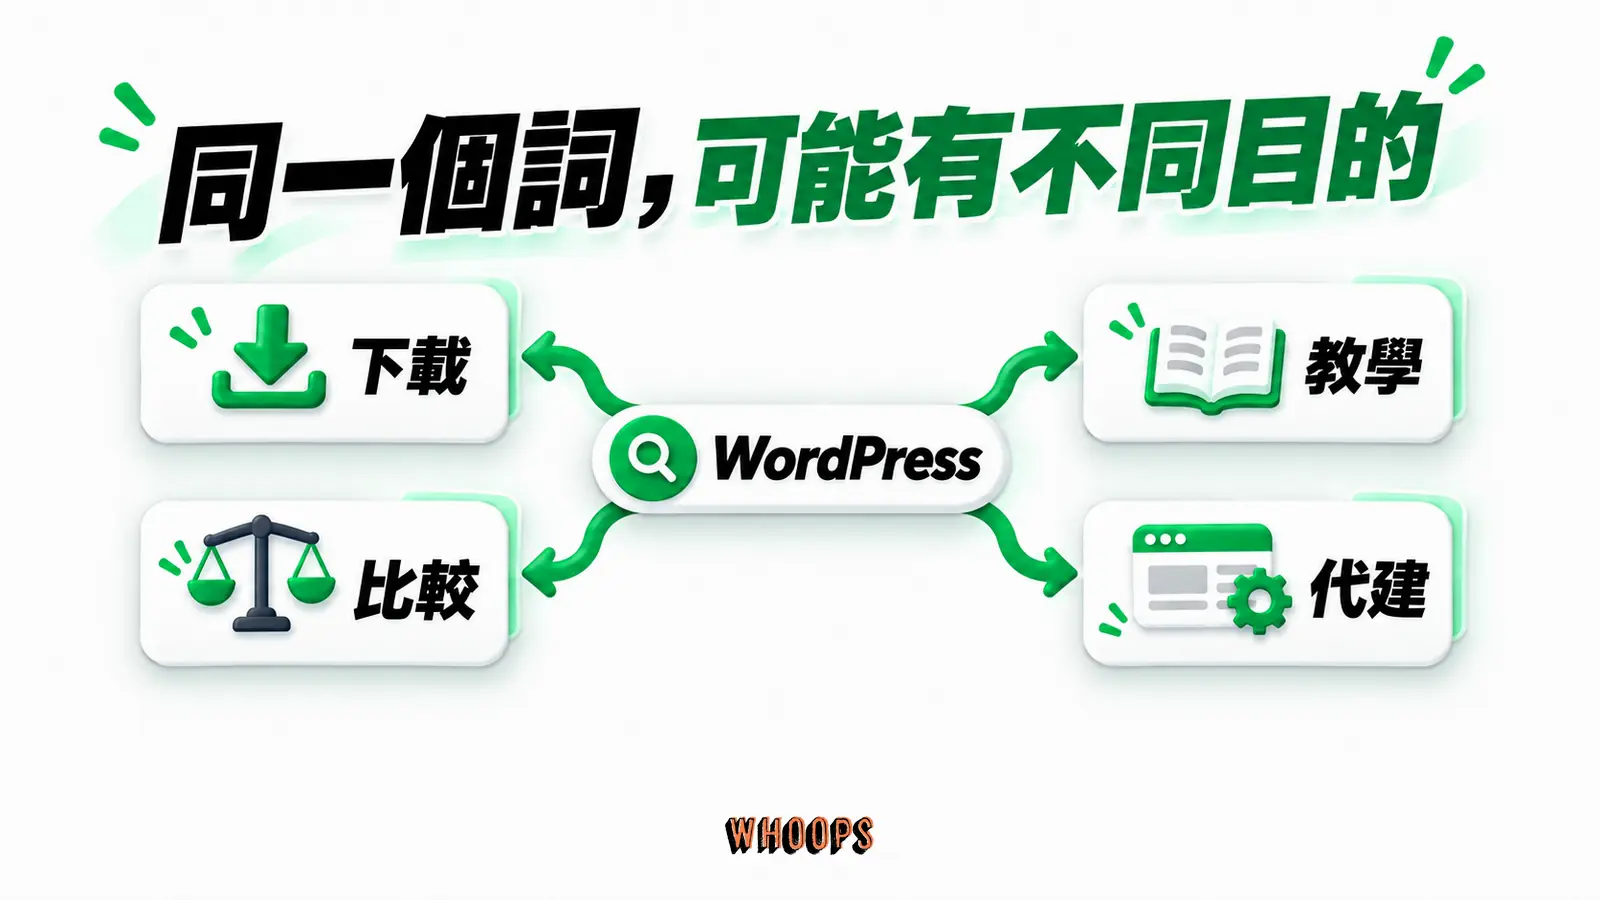
混合意圖是最常見的進階難題。同一個詞,不同人在不同情境下要的東西完全不同:搜「WordPress」的人,有人要找下載點、有人要找教學、有人在比較主題與主機、有人直接想找委託代建的服務。遇到這種詞,與其寫一篇想滿足所有需求的頁面,不如先判斷自己的受眾落在哪個需求,再決定專攻一群,或拆成多頁各自對應。放著不管的結果,往往是自家頁面互相搶同一組查詢,成為關鍵字蠶食的溫床,整併與分流就是為了解這個題。
意圖還有兩個容易被忽略的變形。長尾意圖藏在具體的問法裡:「SEO 要多久才有效」和「SEO 對小商家划算嗎」,是兩種處境的讀者,前者在排預期,後者在排預算,答案的切入點不同,硬塞在同一頁只會兩邊都不夠準。把長尾問法收集起來,按讀者當下要做的決定分組,再決定一組配一頁或一節,內容就會自然對齊。
在地意圖則受地點與情境影響:同一個產品詞,有人在做功課,有人在找附近的店家,搜尋結果會依查詢與位置給出不同版面。判斷的方法不是猜,是把查詢實際搜一次,看結果頁上商家名單、地圖區塊、評論版面的佔比;版面給了多少在地訊號,內容就該準備多少對應的在地資訊。
蜂鳥之後,理解查詢這條線有一串接棒者,各自的定位一句話就夠:
- 蜂鳥(2013):從比對字面轉向理解整句意思,對外說明出現在 Google 的生日活動上,可對照 Search Engine Land 的現場報導。
- RankBrain:靠機器學習判讀陌生查詢與詞語之間的關係,背景可對照 Wikipedia 條目。
- BERT(2019):看得懂句子裡的前後關係與語法,對長句與口語查詢幫助最大,見 官方發布文章。
- MUM:發布時說明可理解文字與圖片,方向是跨形式的理解,見 官方說明。
這條線的實務意義只有一條:看懂搜尋結果頁,是意圖判讀的基本功。相關搜尋、People also ask、AI 概述,是多套系統針對同一個查詢各自給出的畫面,不是哪個單一系統的標準答案;把它們當參考座標而非標準答案,判斷會穩得多。看版面時可以帶一個簡單的紀錄格式:一行查詢、一行版面型態、一行自家內容的對應位置,累積十幾行之後,意圖的分佈會自己浮出來,比任何單次觀察都可靠。要往蜂鳥這條線挖更深,蜂鳥演算法的深入解析有展開的討論。
品質怎麼被計算:熊貓留下的判讀方式
評審團的第二位,看的是內容有沒有料。今天談內容品質,判斷的面向是原創性、深度,以及頁面是為讀者而寫,還是為搜尋引擎而寫;歷史上的熊貓是這個方向最有名的名字,但它今天的身分是核心系統裡的多項訊號,不是一支還在巡邏的稽查隊。這也改變了品質問題的呈現方式:很少看到整站一夜歸零,比較常看到的是個別查詢上的位置一段一段滑落。
回到 2011 年的現場,才知道它為什麼出現:那段時間,薄內容與農場站佔滿了結果頁,頁面靠關鍵字密度與站群互相支撐,使用者點進去什麼都得不到。熊貓做的事情,是讓高品質、原創的內容更容易被看見,把劣質內容擠出視線;那個年代留下的教訓到今天都適用:當內容的生產成本遠低於它宣稱的價值,搜尋系統遲早會找到辨認的方法。這段歷史可以對照 Search Engine Journal 的熊貓整理。當年的完整脈絡與判定細節,寫在熊貓演算法的來龍去脈與內容農場的辨識與避險裡。
這裡要先拆一個常見誤會。歷史上的熊貓曾以網站層級的品質判斷聞名,今天的排名系統卻主要在頁面層級運作,兼用部分網站層級訊號;網站裡少數幾頁內容薄弱,不代表全站每一頁都會跟著往下掉。也不存在一個可以查詢的「網站品質分」,讓你看到整站被打了幾分。
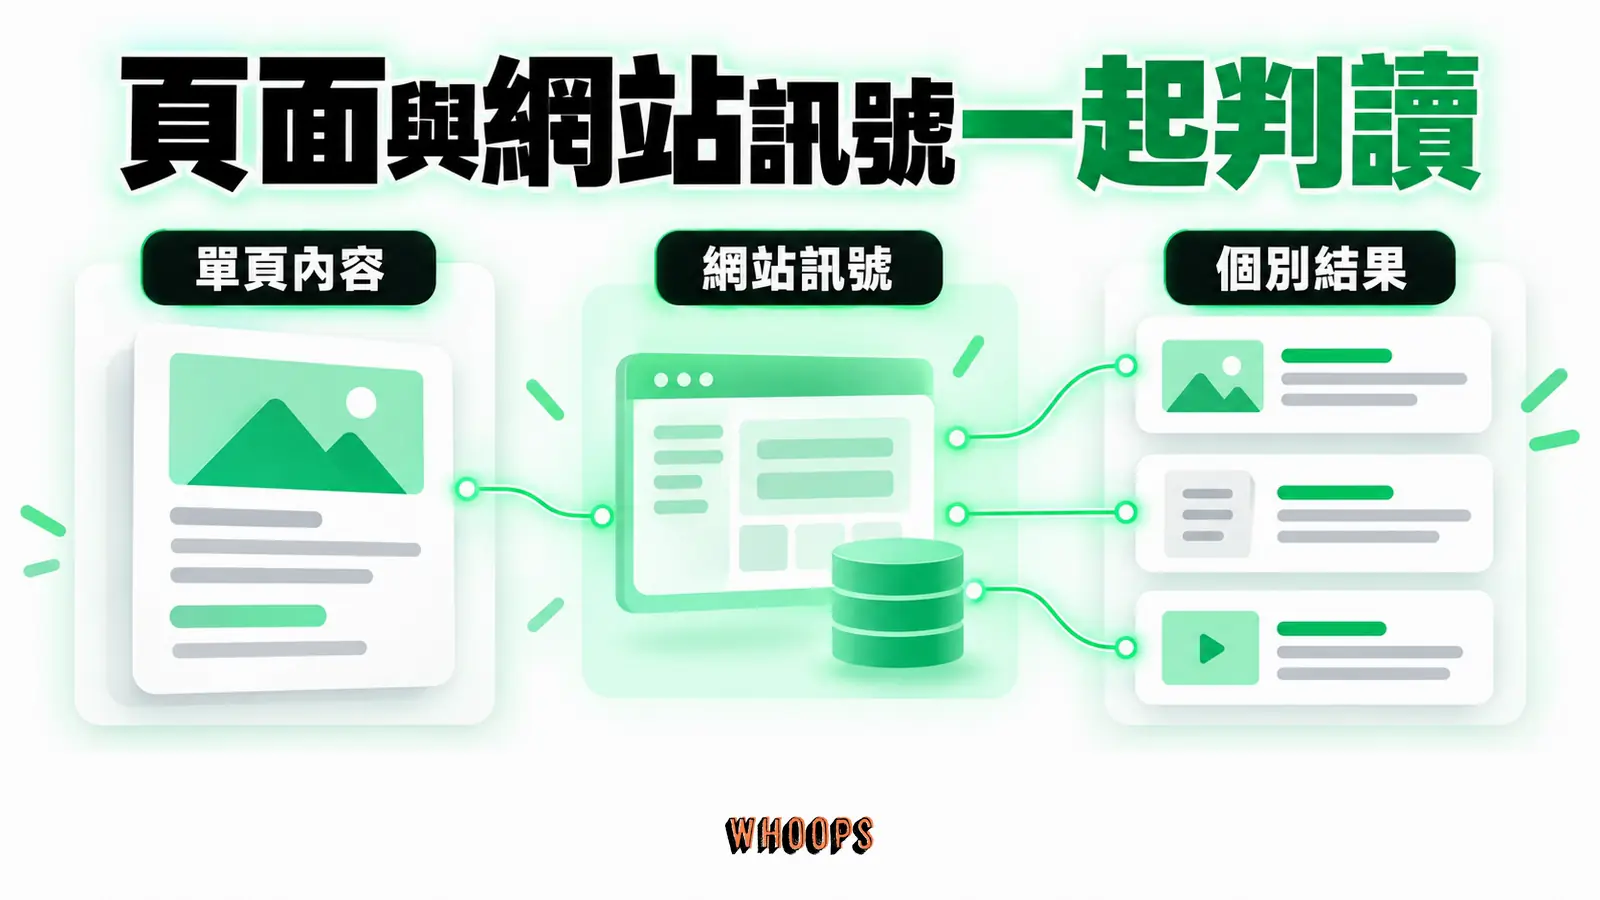
所以「砍內容」不是固定處方。面對一批弱頁面,先把每一頁放進四個選項裡:值得補的,改善它,判斷線索是這頁回答的問題仍有人搜,只是深度或證據不夠;主題重疊的,整併成一頁,把各自最好的段落合起來,順手處理頁面互搶查詢的問題,前面提過的蠶食就是這裡的病灶;有存在理由但不值得排名的,例如服務已結束、只剩存檔價值的舊活動頁,設為不索引;連存在理由都沒有的,移除。先分類再動刀,順序反了就會誤殺,把還在帶轉換的頁面一起清掉。
資訊增益:判斷內容有沒有別處沒有的價值
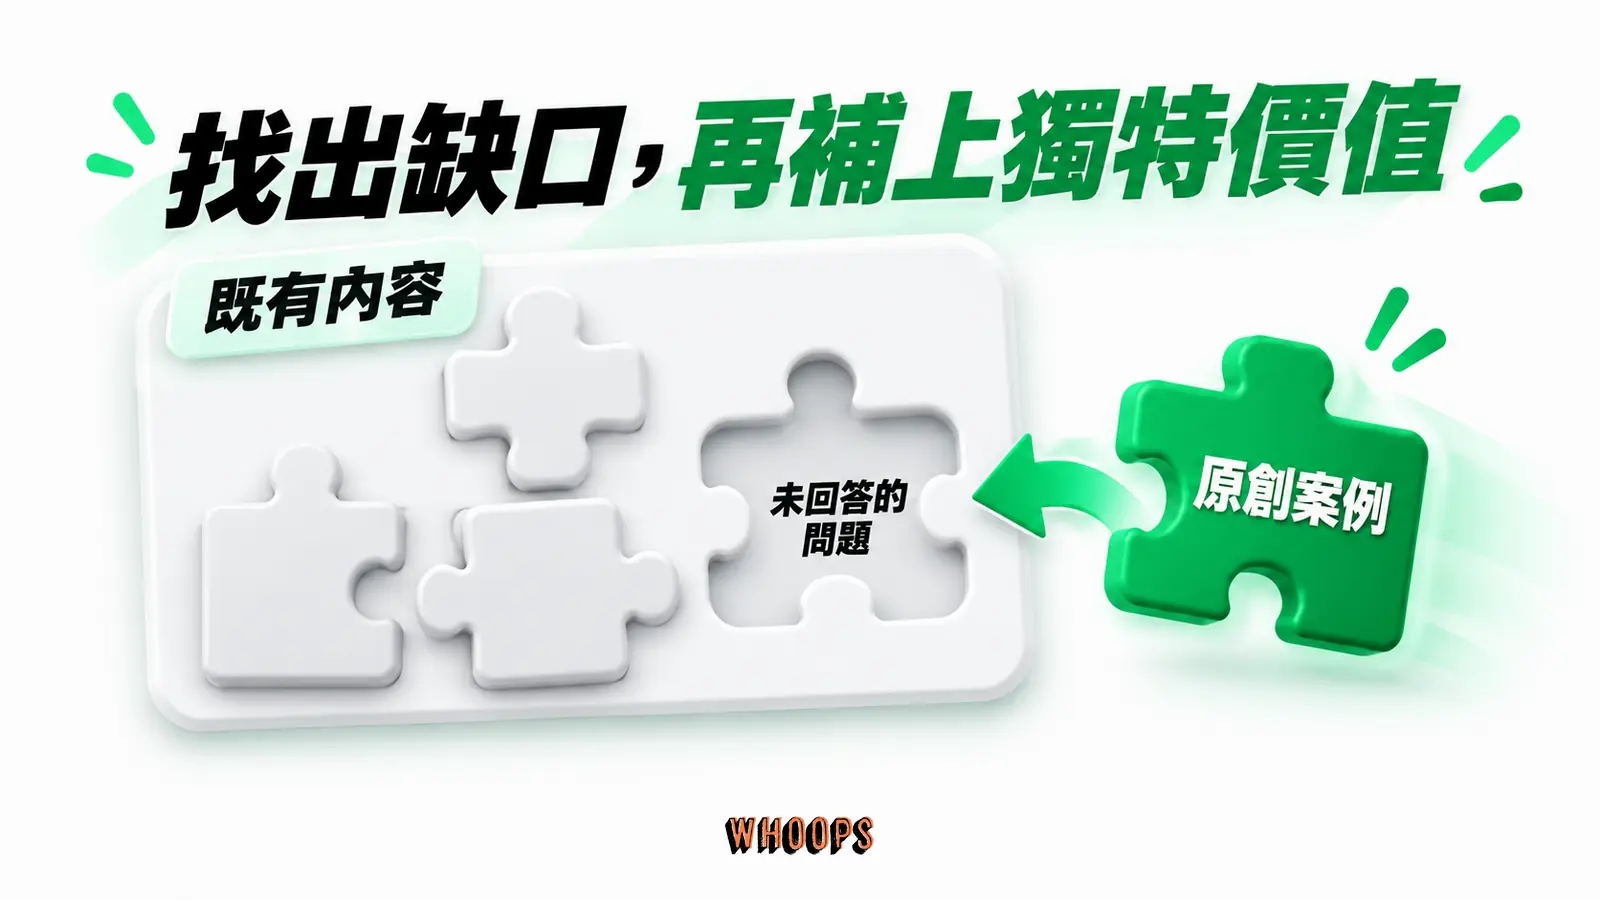
品質聽起來抽象,有一個具體的檢查法:資訊增益。先講清楚,這是編輯用的檢查角度,不是公開的排名因子。三個角度可以用:角度獨特性,別人都在寫概論,你有案例與步驟;資訊密度,同樣一段字,有多少是填充句、多少是可執行的資訊;補位完整度,同主題的內容都停在 A 和 B,你把 C 補上了,而補位是最容易操作的一個,把排名靠前內容的小節攤開,對照使用者會問的完整問題清單,缺的那塊一目瞭然。深入的討論在資訊增益專文。
實際操作有一個樸素的方法:把目標查詢打進搜尋框,把前排內容的小節標題掃過一遍,自問哪個問題他們都沒有回答、但使用者真的想知道。那個沒被回答的問題,常常就是可以切入的位置。
連結怎麼被計權:企鵝與兩條處理流程
評審團的第三位,看的是推薦的真假。連結在搜尋系統裡的原始意義是推薦:別的網站覺得你的內容值得引用,於是連過來。企鵝處理的是假推薦,也就是為了排名而製造出來的連結;它今天的身分與熊貓一樣,已併入核心系統,細節在企鵝演算法的演進。
回到那個年代:付費買連結、目錄站與部落格留言批量塞連結,是常見的操作。這些手法與黑帽 SEO 的界線直接相關,而界線本身不難畫:關鍵不是手法名稱,是連結存在的理由。為了真實推薦而存在,和為了操弄排名而製造,兩者的長相差很多。
操弄的長相可以描述:大量連結反覆用同一個商業關鍵字當錨點;論壇與目錄站出現成批連結,來源與內容無關;短期內連結數量以不自然的速度增加。反過來說,錨點比例不能單獨定罪,自然引用也可能恰好集中;判斷的核心始終是同一個問題:這些連結是不是為了操弄排名而建的。看到可疑的模式,先問三件事:誰連的、為什麼連、什麼時候出現;答得出「因為內容被引用」的,多半沒事,答不出來或答案牽涉交換與付費的,才進入處理清單。
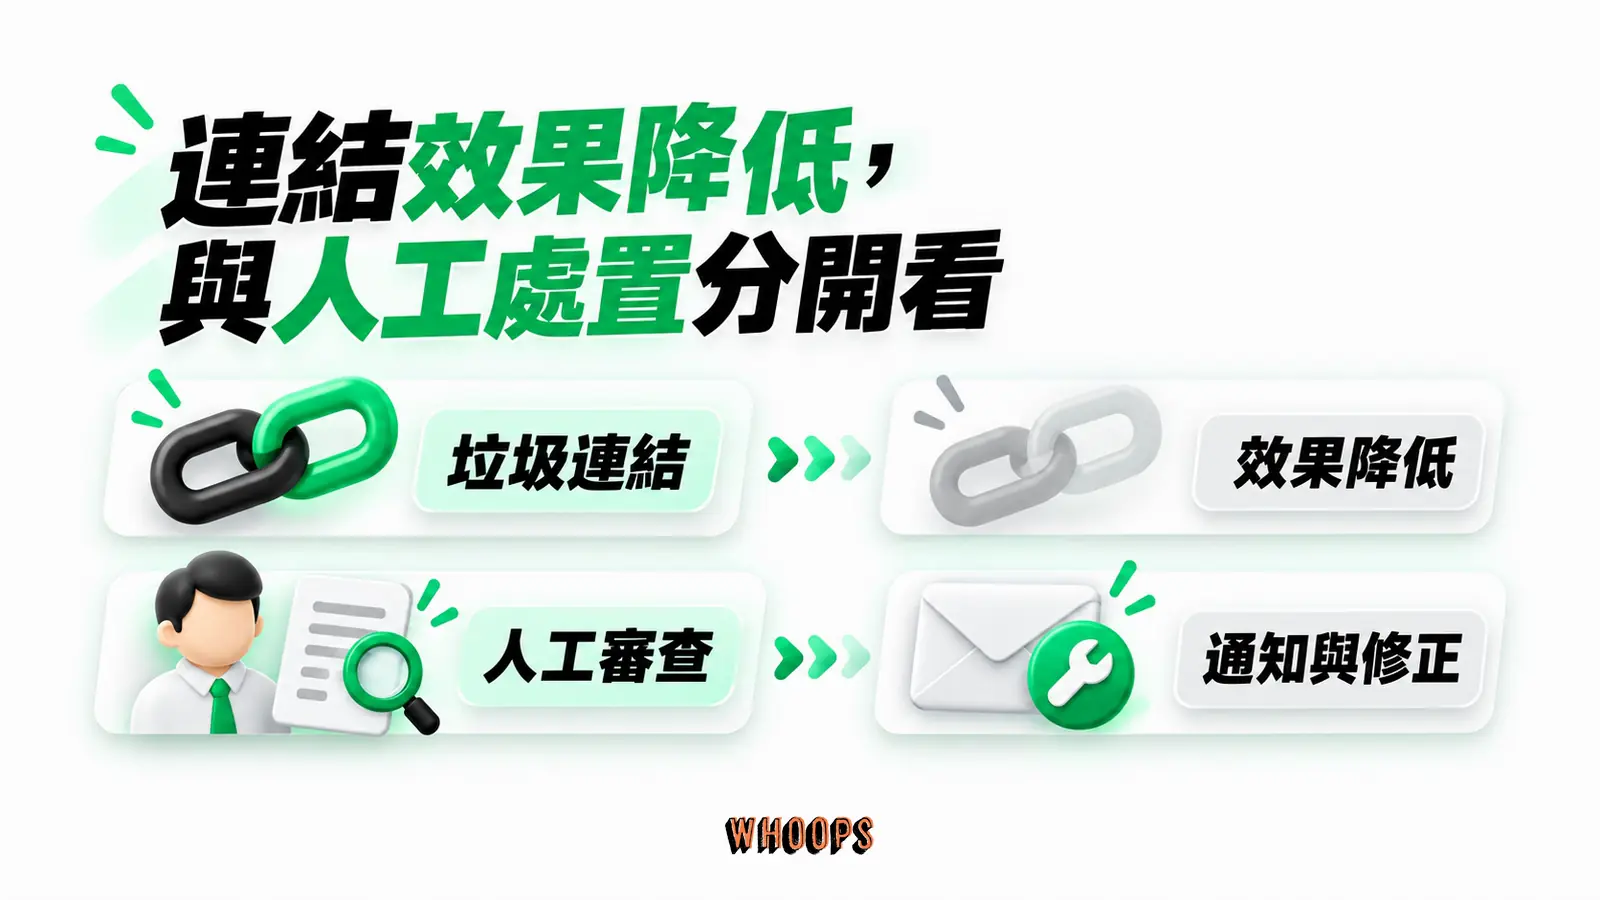
2016 年 9 月 23 日的官方公告把後續畫清楚了:企鵝併入核心排名系統,資料持續重新整理,處理方式改為逐條削弱垃圾連結的效力,而不是拿同一個結果套遍整個網站。連結垃圾的演算法處理從此即時運作,與人工處置是兩條不同的流程,公告見 Google Search Central Blog。
左右捲動檢視完整表格
| 對照項 | 演算法處理 | 人工處置 |
|---|---|---|
| 通知 | 沒有通知,變化隨系統重算出現 | Search Console 手動動作報告列明政策與範圍 |
| 生效方式 | 即時且持續,精細到連結層級 | 人工審查判定,影響範圍明確 |
| 因應方式 | 停止操弄、清理問題,等系統重算 | 修正違規項目後提交重新審查 |
「三十天保證幫你堆出指定條數外鏈」的提案,用這個框架就能判讀:能在期限內承諾數量的連結,多半是製造出來的,而製造出來的連結正是被降效的對象。連結數量本身不能判斷風險,來源與取得方式才能;篩選提案用同樣三問就夠:連結會出現在什麼樣的頁面、那些頁面的讀者是誰、取得的理由是什麼,三問都模糊的提案,價格再漂亮都不值得簽。
被垃圾連結纏上時
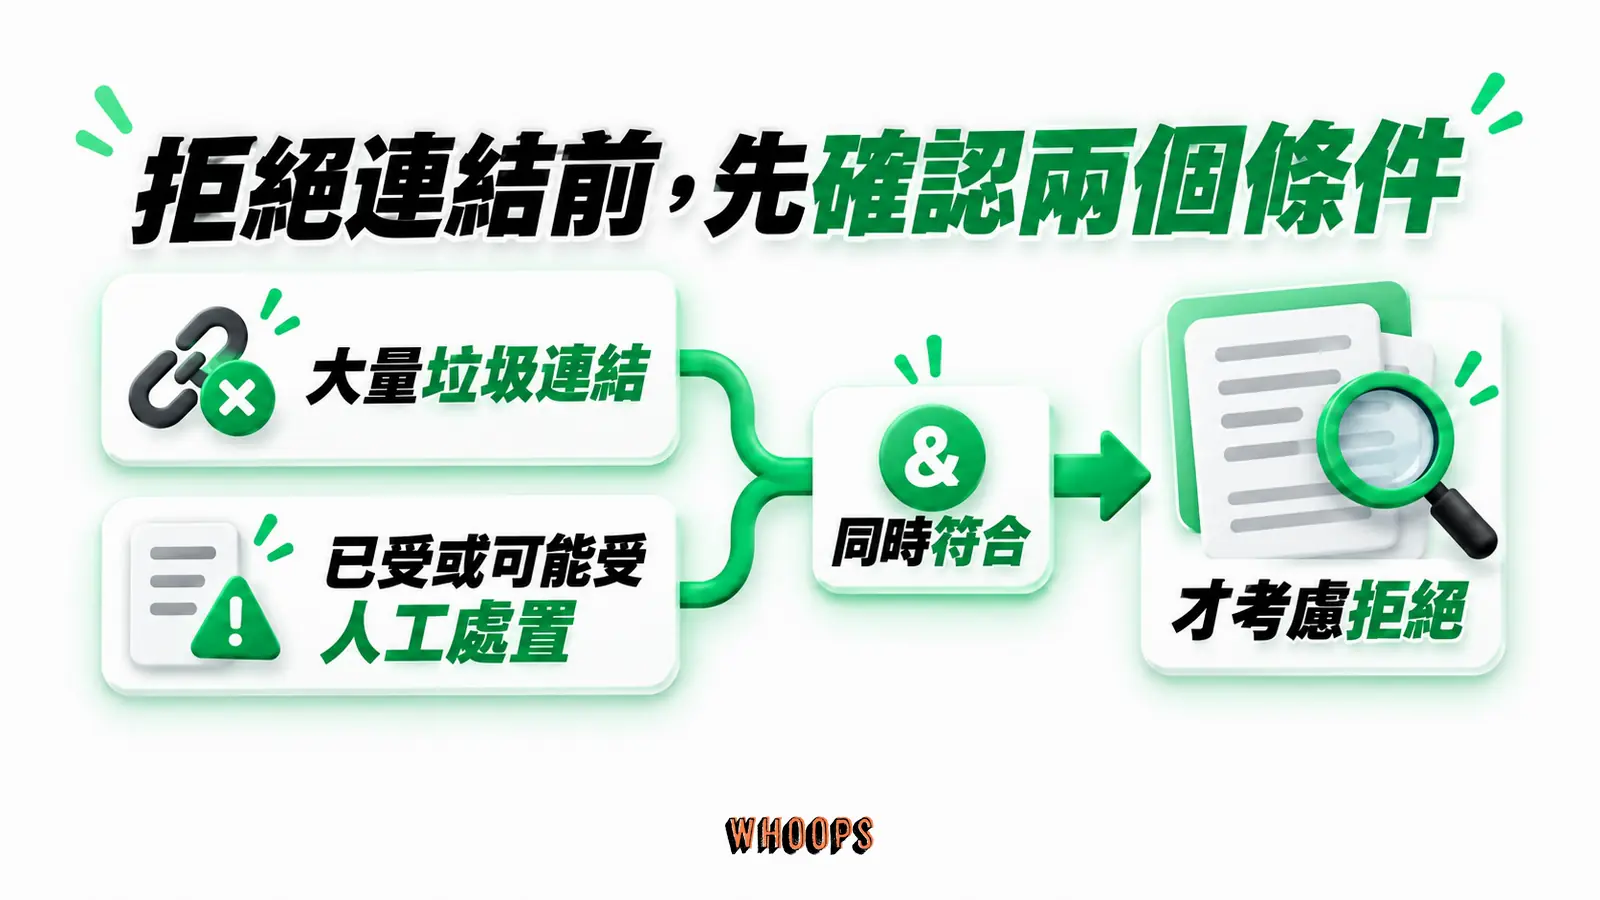
發現一大批垃圾反向連結指向自己,先別急著送拒絕清單。拒絕連結工具有明確的使用前提:被大批垃圾連結、人為連結或低品質連結指著,而且已經或很可能引發人工處置,這時才輪得到它,工具頁是 Disavow links;一般來路不明的連結,官方說明是不必主動處理。
若自己曾參與連結操弄,順序是先盡力移除,剩下移除不了的再送拒絕清單;沒有垃圾連結規模、也沒有處置證據就把清單送出去,反而可能誤傷對自己有益的正常連結。健康的連結該怎麼累積,反向連結的建立方法與站外 SEO有完整的展開。
信任的框架:E-E-A-T、評分員與實體
品質與推薦之外,還有一組觀念在解釋系統怎麼看「可信」。它不是排名開關,而是評估框架;把它當開關操作,是最常見的一種浪費。這一節把兩件常被綁在一起講的事拆開:E-E-A-T 是給評分員的評估框架,實體是系統理解人事物的方式,兩者都不是分數。
E-E-A-T:四個字母在評什麼
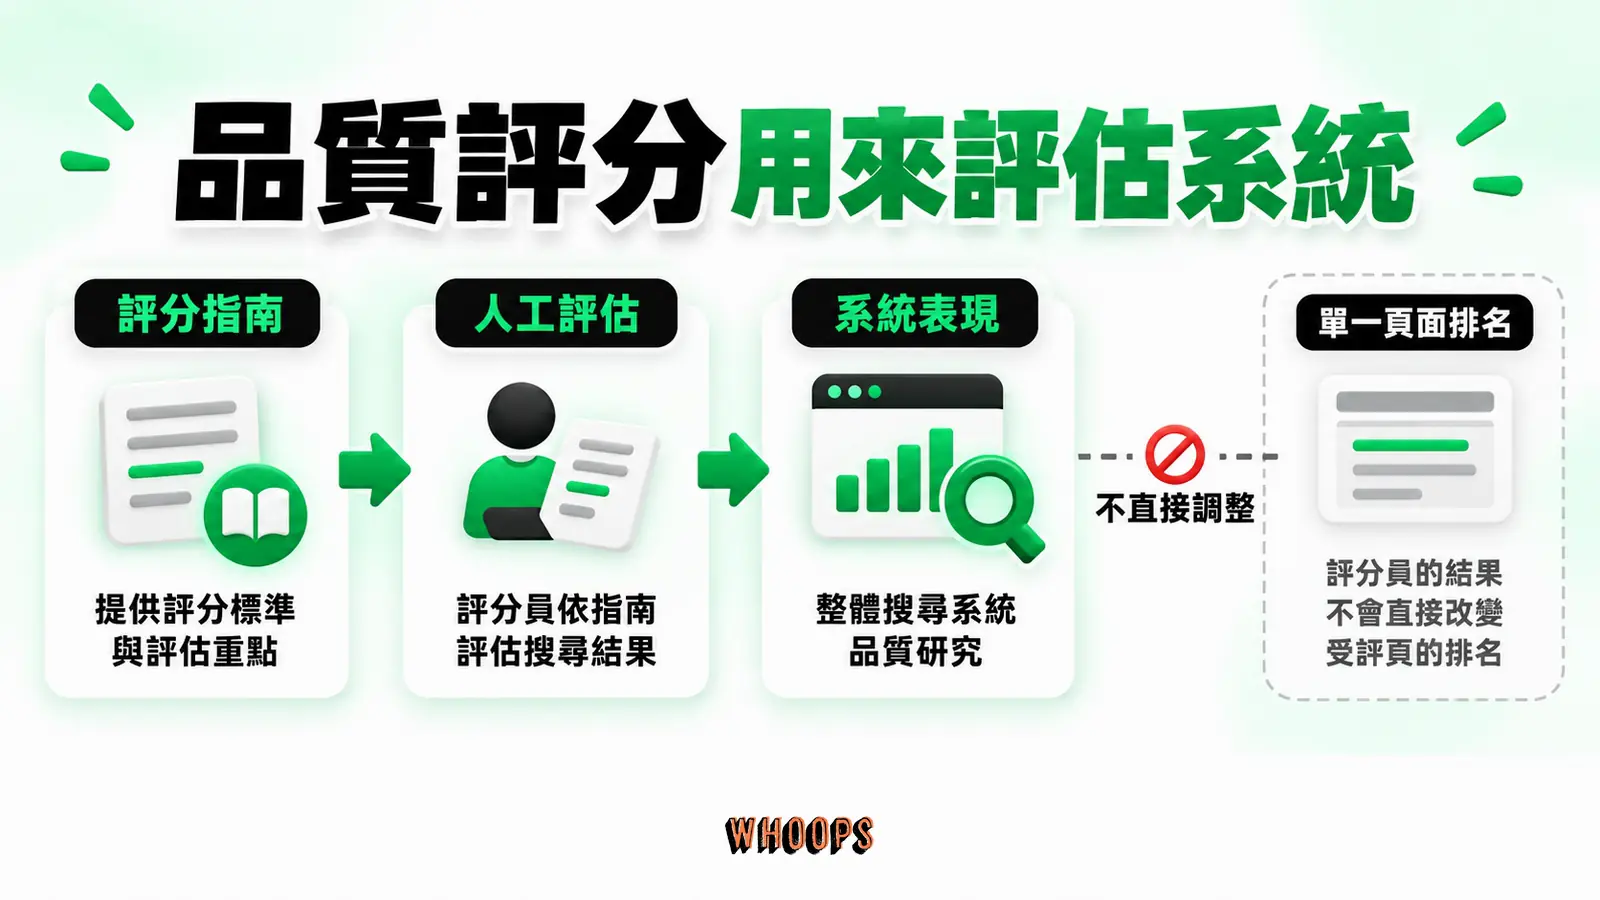
這個評估框架由四個字母組成:體驗、專業、權威、信任,其中信任是核心,前三項再好,頁面不可信任時整體評價仍然偏低。要緊的是它的用途:評分員依品質評估指南為抽樣頁面評分,結果用來評估搜尋系統的整體表現,不會回寫成某一頁的排名分數,Search Console 裡也查不到這個分數。
E-A-T 會變成 E-E-A-T,是 2022 年 12 月的事:官方在評估指南的更新公告裡補上的那個 E,談的是第一手體驗:寫耳機的人是不是真的用過,寫維修的人是不是真的拆過。體驗的證據有長相可循:實際使用的照片與過程、踩過的坑、條件與限制的描述,這些是拼湊來的內容模仿不來的細節;不需要每一篇都掛作者實測,但涉及選購、維修、操作的主題,讀者感覺得出寫的人有沒有碰過那個東西。完整的框架拆解在E-E-A-T 的完整拆解。
YMYL 主題的標準更高。醫療、法律、財務這類錯誤資訊可能傷害重大福祉的主題,信任的要求更嚴;但高標準不等於只有大機構能排名,可信的第一手經驗,放在對的情境裡同樣有價值。沒有正式資格時的誠實寫法是:不假裝資格,不給只有專業人士該給的建議,依頁面目的提供讀者用來評估可信度的線索,例如作者資料、來源與更新時間。判斷自己是否踩進 YMYL,問的不是主題名稱,是讀者照做之後、資訊錯了會怎樣:影響的是一時的購買決定,還是健康、財務與安全的長久後果。
實體:讓系統認得你的品牌
實體是另一個維度的可信。Google 自 2012 年起以 Knowledge Graph 理解人、地、事物與其關係,官方介紹文章寫得明白,這也是實體 SEO觀念的基礎。不過,不是每個被系統認得的實體,都查得到公開 ID;把排名折算成實體出現次數,方向就歪了。同一個品牌在不同平台使用的名稱、簡稱、舊名,都是系統要比對的線索,換名字的成本比多數人想像的高。
實體層面能做的一件實事,是讓對外資訊保持一致。品牌名稱、官方網站、社群帳號與聯絡資訊如果各寫各的,搜尋系統要比對多個來源才能確認它們指向同一個主體;資訊準確一致,歧義就少。這也是在地商家重視 NAP(名稱、地址、電話)一致的原因;檢查的方法很土,開一個表格,把官網、社群與各清單上的名稱、地址、電話抄下來逐欄對照,不一致的逐筆修正,一次清完。
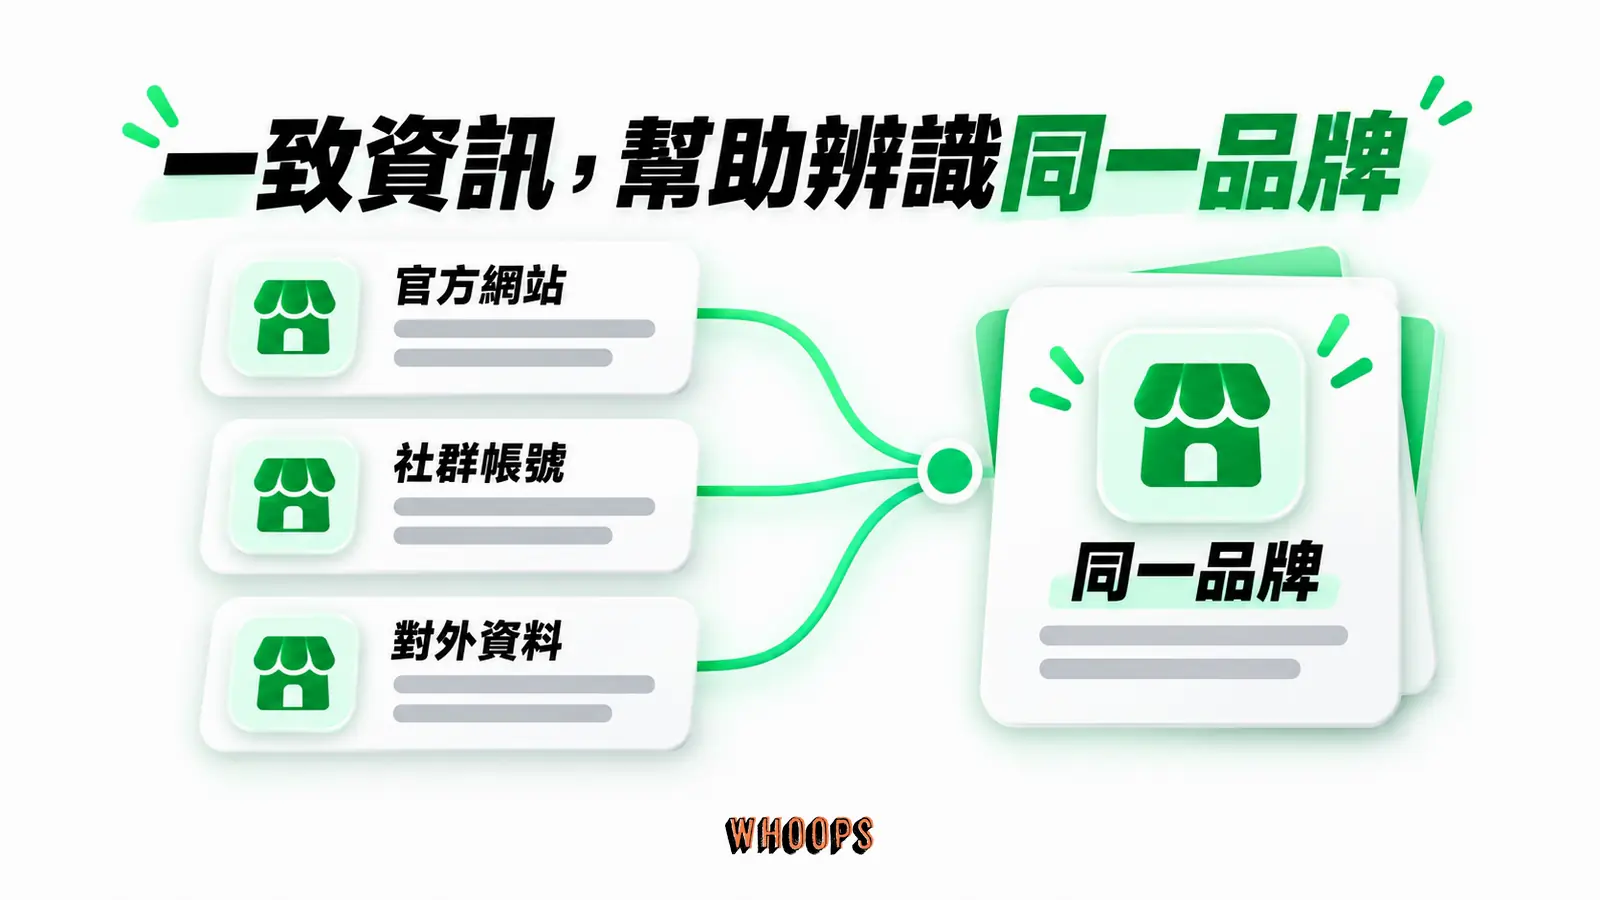
邊界也要說清楚:實體 SEO 不是堆疊名稱,或在每一頁貼同一組 sameAs。結構化資料是給系統的線索,不是門票;標記超出實情是風險,不是加分,濫用的具體後果留到自檢那節一起講。
Navboost 能解釋你的排名嗎:點擊資料的界線
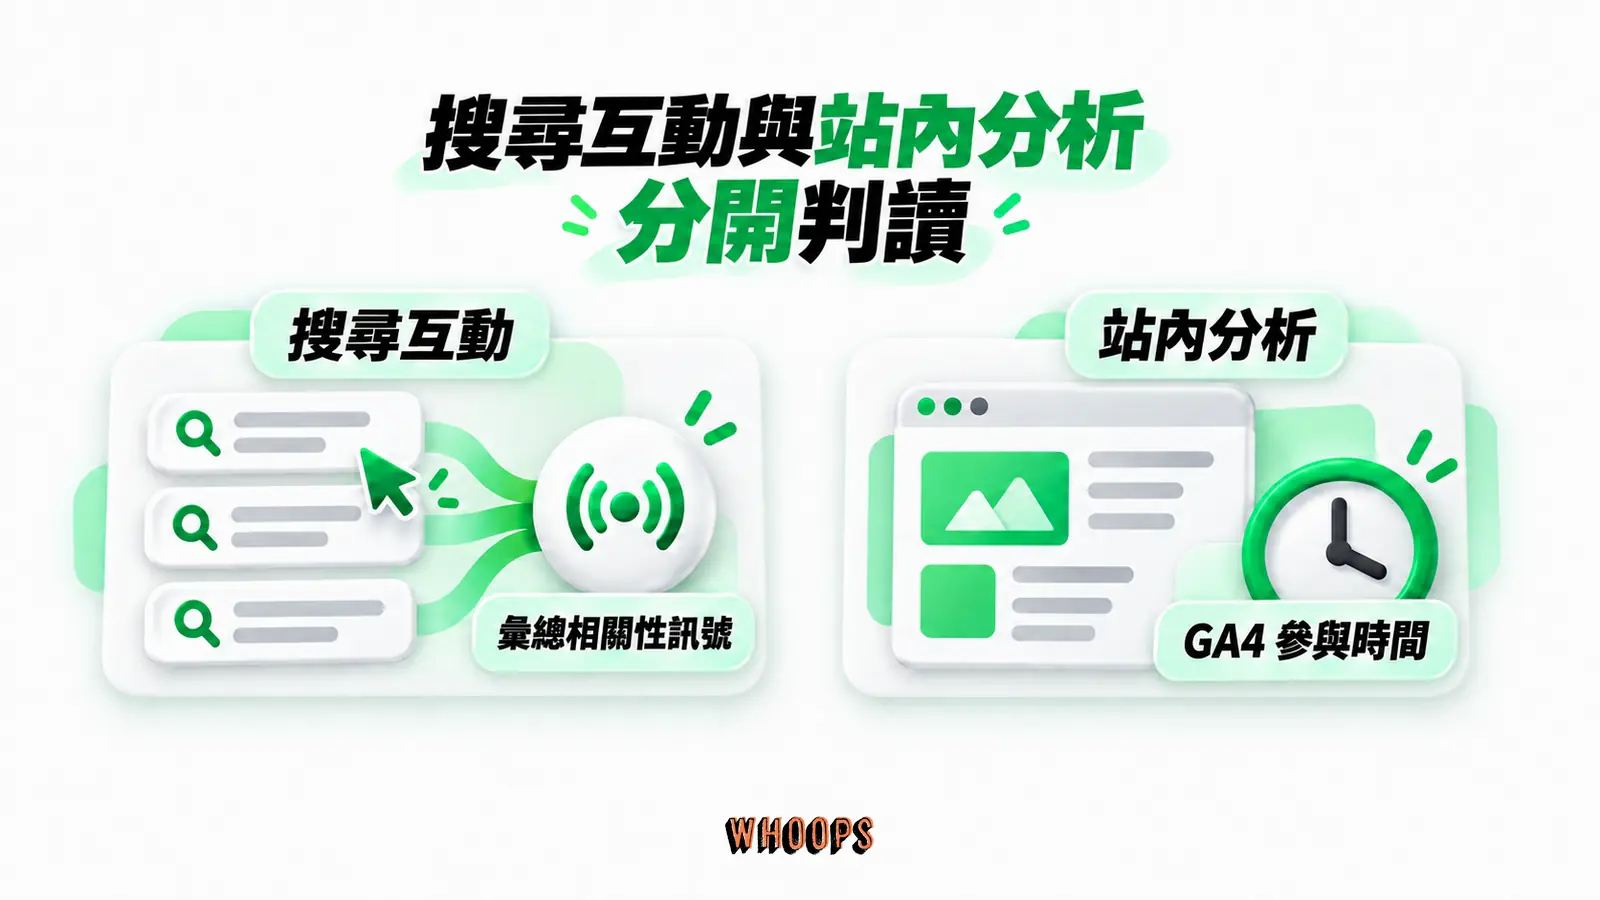
點擊與互動資料有沒有進入排名?有,而且有法庭紀錄。2023 年美國司法部的反壟斷訴訟中,Google Search 副總裁的證詞確認,搜尋系統確實會用到彙總後的點擊資料,Navboost 是相關系統的名稱之一,案件背景見 Wikipedia 的案件條目。資料是彙總後的點擊,可依地區與裝置區分;至於怎麼加權、多快反映,公開資料裡沒有答案。這套資料站長拿不到,原因很簡單:它是搜尋結果頁上的行為紀錄,不是你網站上的;GA4 看得到訪客進站後做了什麼,看不到他們在結果頁上點了誰、跳回來之後又點了誰。
判斷的界線在這裡:搜尋互動訊號與站內分析是兩套資料。用 Navboost 解釋兩個頁面的排名差異,公開資料撐不起這個結論,站長也無法從 GA4 的停留時間或跳出率,反推出搜尋系統對自己頁面的判定;「待得越久名次升、彈回去就降」這條公式,不存在於任何可查證的公開文件裡。想靠製造點擊改善排名,同樣沒有證據支持是可靠策略。另一個常見的過度推論,是把某次改版後的名次變化歸功於互動數字;同期通常還改了內容、速度與連結,單一歸因撐不起結論。
頁面體驗是同一個邏輯下的小訊號。Core Web Vitals 的 LCP、INP、CLS 會被排名系統使用,但通過門檻不保證上升、未通過未必下滑,官方在 2020 年 5 月的頁面體驗評估說明裡,把它定位成眾多訊號之一;行動優先是索引方式,不是加分層,見 2023 年 10 月的正式公告。指標細節可以看Core Web Vitals專文;實務上優先修的,是真正拖住使用者的速度與穩定性問題。
站內真正可控的,是標題不設餌、開頭直接給答案、正文對齊意圖。這些是站內 SEO裡最舊的建議,也是面對未公開訊號時最誠實的位置:與其猜測單一訊號的權重,把可治理的部分治理好,而標題不騙、開頭直給的回報也不限於訊號端,它直接減少錯誤預期的點擊,把真正想讀的人留到段落裡,這件事在轉換端就看得到。
核心更新在重算什麼:重新評估,不是開罰
沒作弊、內容也沒走樣,流量卻突然少一截,這種情況常被第一時間歸給核心更新,但先別急著畫上等號;技術事故、量測問題與需求變化同樣在嫌疑名單上,後面檢傷那節會給排除的順序。若查證後確認與核心更新的時點相關,機制是這樣的:核心更新是對搜尋系統的廣泛調整,系統重新評估內容的相對價值後重排結果,有些頁面下滑,是因為別的內容這次被評為更相關。它不針對特定網站,也不附帶處分。「相對」是關鍵字:你的頁面什麼都沒變,但同一批查詢裡,別人把內容補強了,位置就換人坐;這也解釋了為什麼下滑常成群出現,又常在幾個月後自然回來一部分。
把核心更新想成一場重新比稿就好懂了:同一批稿件重交一次,標準調整後名次重新排列,落後的稿件不代表作弊,只是這次有別的內容被評為更相關。官方在 2019 年的核心更新說明裡講得直白:名次滑落未必等於網站違規,也不一定是人工處置。
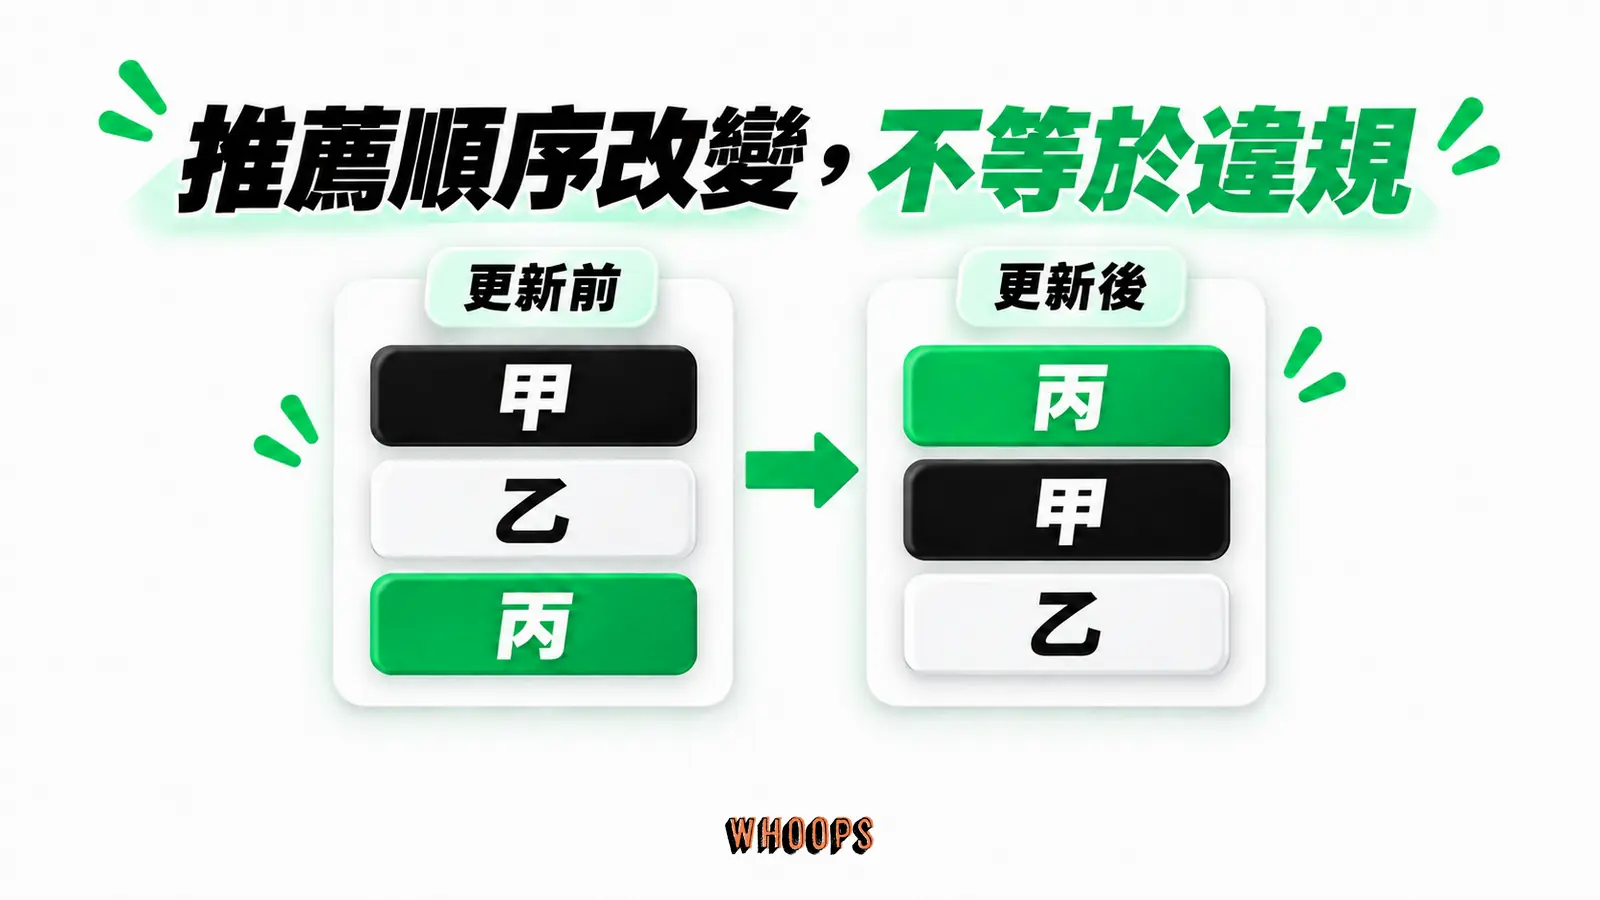
恢復的節奏要誠實講:改善可能數天到數月才反映,也可能要等下一次核心更新才明顯,而且沒有恢復保證。把每一次更新都當成危機處理,不如把力氣放在確認受影響的查詢與頁面、修正真正的問題;等待期間能做的是把改善做扎實,把受影響查詢的前排內容讀一遍,誠實標出自己缺的那塊,補上,記錄日期,下一波重算時至少知道手上有什麼。遭遇衝擊時的資源分配,演算法衝擊下的應對思路有展開。
時間軸在這裡收斂成三句話:近年核心更新持續推出;垃圾政策在 2024 年之後增加了幾項濫用類型;AI 功能改變了部分查詢的版面。逐筆日期與各次更新的範圍,前面提過的更新歷史專頁有完整紀錄,年度的節奏觀察看年度 SEO 觀察;這裡不重抄名單,因為判斷靠的是日期對案的方法,不是名單記憶。
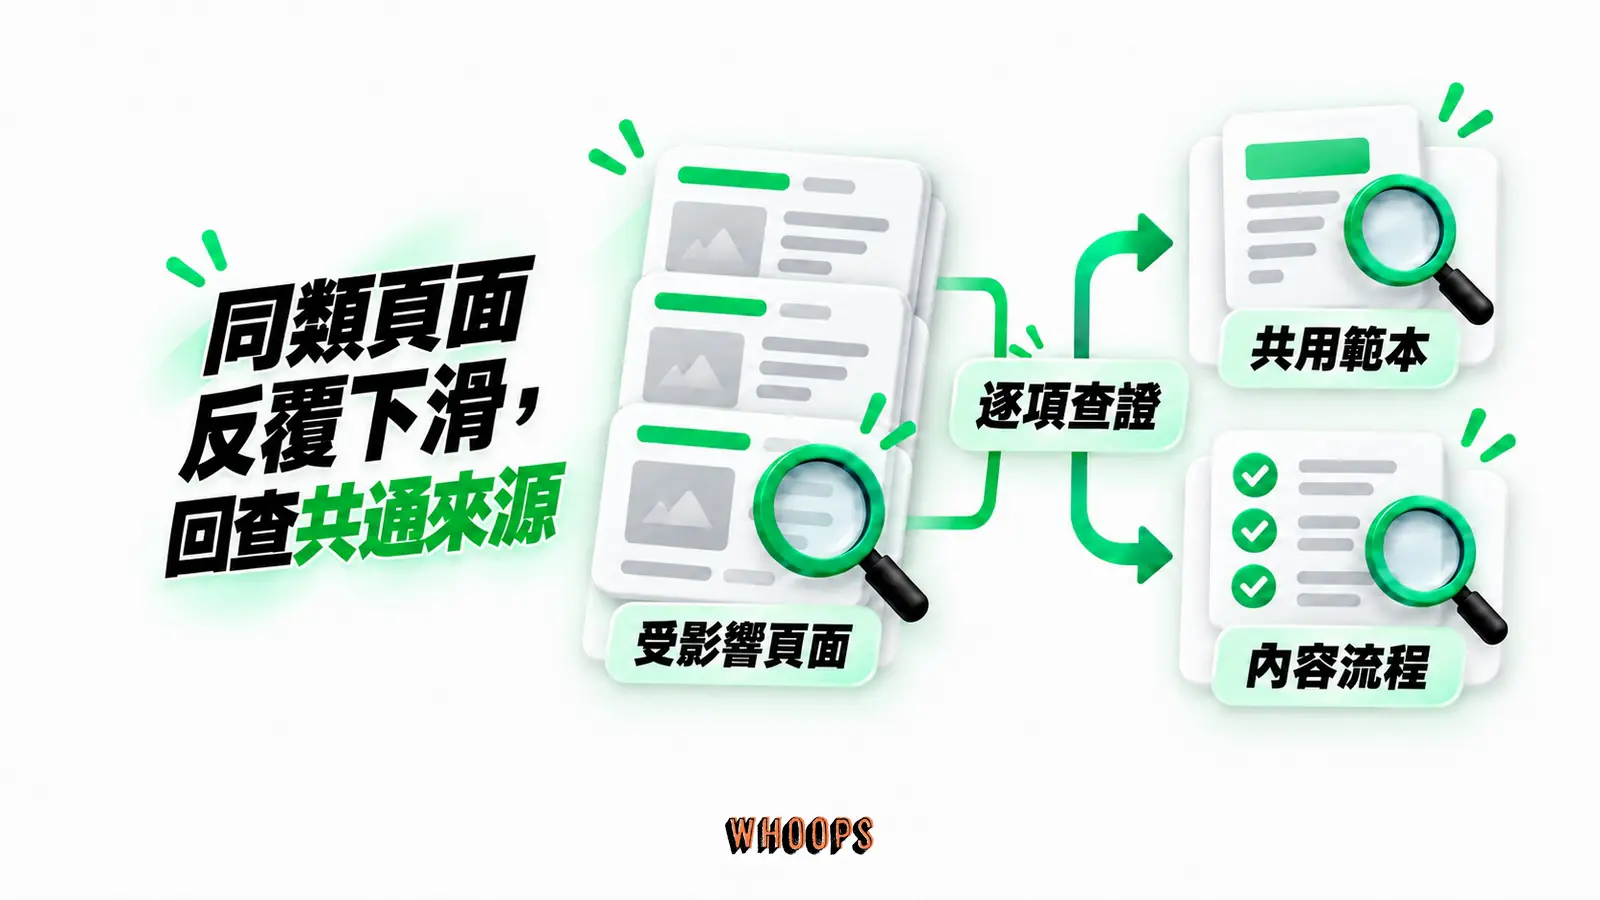
診斷的紀律是把三個層次分開查:查詢層,看下滑集中在哪些查詢、這些查詢的結果版面變了什麼;頁面群組層,看受害的是哪一批頁面、它們共用範本或生產流程的哪個部分;全站層,看檢索、索引與技術狀態有沒有全面性的問題。三層各有結論之後再下判斷,不用連坐想像。到這裡,開場那組「重新評估與懲罰」的區分完成了前半段論證:重新評估是相對位移,沒有通知、沒有處分;剩下的一半,是把真正的罰長什麼樣講清楚。
人工處置長什麼樣:垃圾政策與真正的罰
真正的罰有明確的長相。人工處置出現在 Search Console 的手動動作報告,註明違反的政策與影響範圍,修正後可以提交重新審查,審查要附上修正的說明與證據,處理時間通常以週計,結果會回報;影響範圍如果是「部分結果」,代表只有違規的頁面受影響,不必把全站都當成災區。它的依據是垃圾政策:連結垃圾、規模化內容濫用、站點聲譽濫用、過期網域濫用。
政策的更新有官方紀錄。2024 年 3 月的核心更新公告,同期列入三項垃圾政策:過期網域濫用、規模化內容濫用、站點聲譽濫用,見 官方公告。其中站點聲譽濫用的特性是人工審查加手動處分,認定與救濟的細節在站點聲譽濫用政策解析。
規模化內容濫用常被講成「禁 AI 內容」,這是簡化過頭。政策針對的是以操弄排名為主要目的、大量產出的內容,不管它是 AI、人工還是混合產出;用 AI 加速整理、對讀者有真實價值的內容,和用任何方式灌出來的無價值頁面,在政策面前是兩回事;判斷的問題只有一個,這批內容被生產出來,是為了回答真實的問題,還是為了佔查詢的位子。
跟企鵝那節的對照表合起來看,四組區分剩下的一組到此收束:演算法處理沒有通知、即時、持續;人工處置有通知、可申訴、修正後重審。政策處理的是操弄意圖與規模,不是單一篇品質普通的文章;一篇內容不夠好,得到的是排名不理想,不是處分。
AI 概述與 AI Mode:同一套基本功,新的計分板
AI 概述與 AI Mode 上線後,排名觀念要整套重學嗎?不用。官方立場一貫:AI 功能沿用既有的搜尋基礎與垃圾政策,變的是呈現位置與衡量方式。時間線兩句講完:AI Overviews 於 2024 年 5 月在美國推出,見當時的官方公告;AI Mode 之後登場,見官方更新說明。生成式回應出現在哪些查詢、引用多少來源,都不固定。
新版面帶來的第一個改變,是問題型查詢的答案直接出現在結果頁上,部分查詢因此少了點擊;這不是懲罰,是呈現方式的變化。對內容端來說,能爭的是兩種位置:被採納為回答的來源,以及回答沒有完全解決時剩下的那一趟點擊。兩種位置回到同一個問題:內容有沒有給出讀者要的答案。
衡量方式跟著多了一層。傳統 SEO 看曝光、點擊與轉換,AI 版面還要看內容有沒有成為回答的支援連結;被列入能帶來品牌曝光,但那是內容被採納為來源的結果,不是 Google 對品牌做出的權威認可,成效仍然要看實際資料。
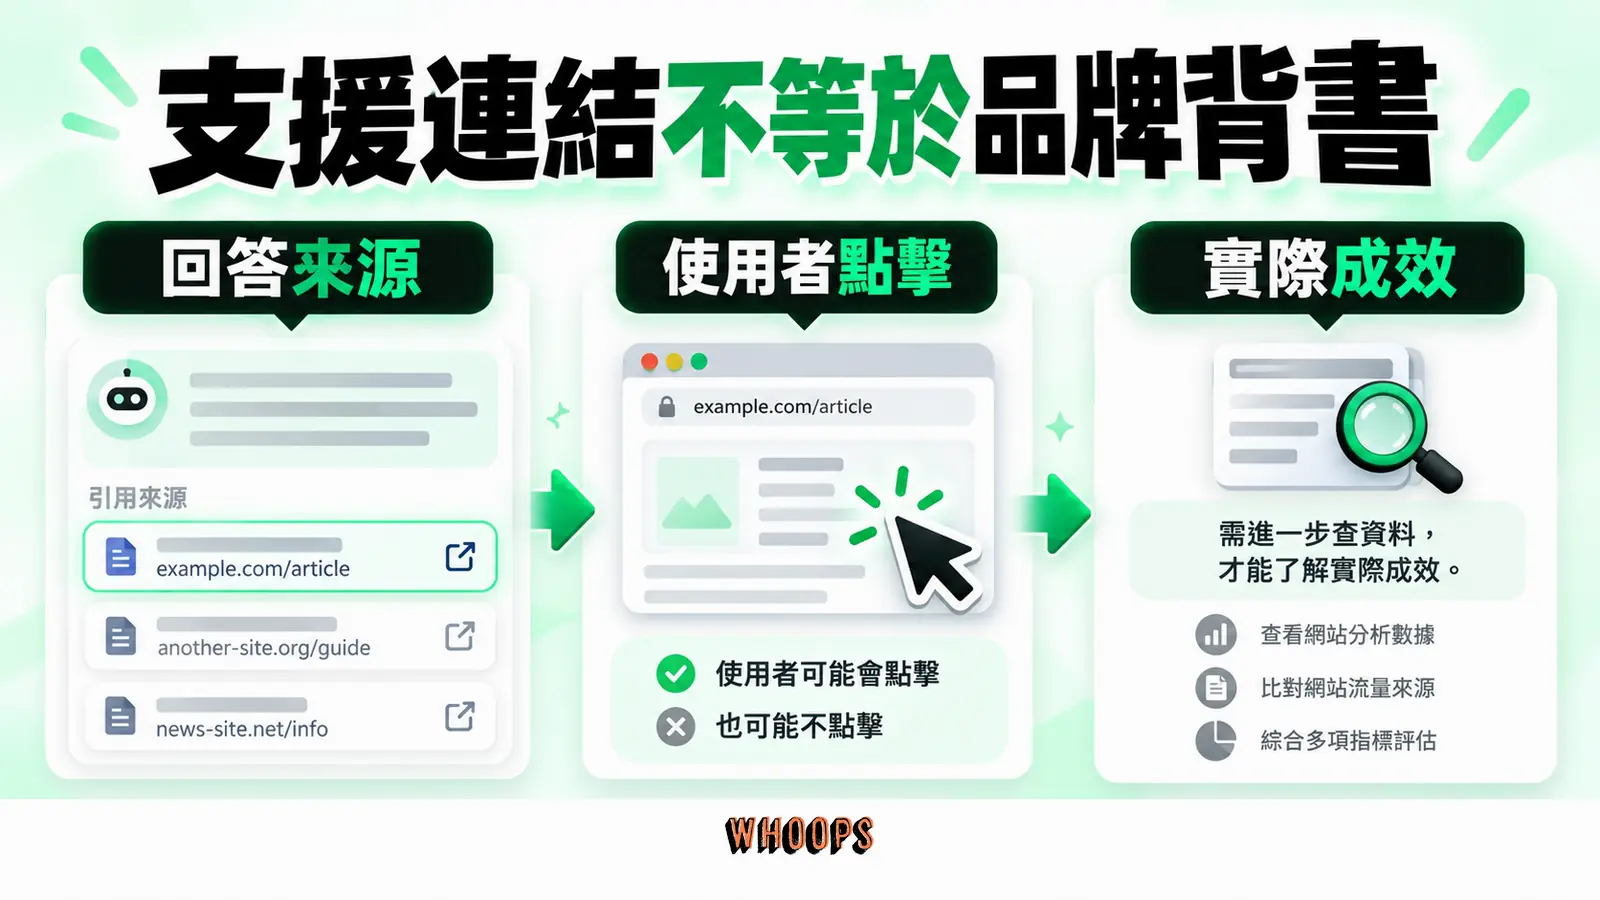
觀察支援連結,沒有神奇工具,方法很土:固定一組自己的代表查詢,定期看 AI 回答引用了誰、自己在不在其中,用表格記錄變化,走勢比單次出現有參考價值。曝光與點擊仍以 Search Console 的整體資料與站內轉換為準,工具欄位隨官方更新調整,判讀時以當時的官方說明為準。
面對新版面,官方給的建議意外地樸素。Google Search Central 的 AI 功能說明文件寫得直接:AI 搜尋功能沿用既有的 SEO 基礎與垃圾政策,沒有特殊的結構化資料要求,也沒有所謂 chunking(內容切塊)的規格要遵守。
同一基調也出現在 Google Search Central 於 Q2 2025 發布的官方影片裡:與其為 AI 功能另學一套規則,索引資格、內容價值與既有規範,仍然是官方指的方向。
所以反誇大的錨點要釘牢:獨家資料、在地資訊與實測結果能提高內容價值,但不保證被引用;不存在「被引用公式」,也沒有保證寫法。市場上「保證進 AI 概述」的服務,用同一個問題檢驗就知道成色:它能控制的其實是什麼?答案通常是發布量與格式,而這兩件事官方都說了不是門票。版面對策與觀念更新的展開,在AI 概述的 SEO 對策;更大的圖像在AI 時代的 SEO 全景。
流量下滑那天:用時間軸對案,別用直覺
曲線下墜的那一天,正確的第一步不是查「中了誰」,而是做檢傷分類:先判斷這是哪一種劇本,再決定往哪個方向查。四種劇本的訊號長相各不相同:技術事故、核心更新重排、垃圾政策或人工處置、需求與版面變化。順序之所以重要,是因為錯誤歸因的成本很高:把技術事故當懲罰處理,會去砍內容、清連結,忙了三個月,真正的問題一頁都沒修到。
檢傷的做法,是照順序問四個問題:
- 整站連首頁一起掉,而且索引報表出現錯誤:先當技術事故查,看檢索與索引狀態、伺服器穩定度。
- 同業差不多時間一起掉:對照官方 Dashboard 的公告日期,偏向產業級或系統級變動。
- Search Console 出現手動動作通知:走政策救濟流程,修正後申請重新審查。
- 曝光沒有掉、點擊率下滑:查搜尋版面與查詢組合的變化,多半不是內容品質問題。
四個問題都答「沒有」的情況也存在:曲線緩慢往下、找不到單一轉折日、查詢分佈慢慢改變,這種多半是需求與競爭的長期變化,處方是內容與產品的持續更新,不是急救。
第一現場是Google Search Console的索引與成效報表。先排除量測問題:檢測有沒有被擋、頁面是否誤設 noindex、canonical 指向有沒有跑掉、追蹤碼是否完好。一個原則可以先立著:在日期對上官方公告、或在報表看到明確錯誤之前,不下「被演算法打到」的結論。看報表時先固定比較期間,再確認下滑集中在哪些查詢與頁面;把數字按查詢、頁面、裝置切開,常會發現「整站掉了」其實是「某一批查詢掉了」。
對案的基準是官方 Search Status Dashboard:2026 年 9 月 24 日起展開的全球垃圾內容更新,公告寫明可能持續約兩週;2025 至 2026 年間的核心更新與垃圾內容更新,逐筆日期以 Dashboard 為準,比來路不明的更新清單可靠。
日期對上公告,到這裡都還只是假設。時間重疊不能證明因果,接著要查索引與檢索狀態、追蹤碼是否完好、下滑前站內改了什麼,以及查詢需求本身有沒有波動;這幾件事都查過,原因的範圍才會縮小到可以動手的程度。技術事故的排除流程,技術 SEO 健檢有逐項的清單。
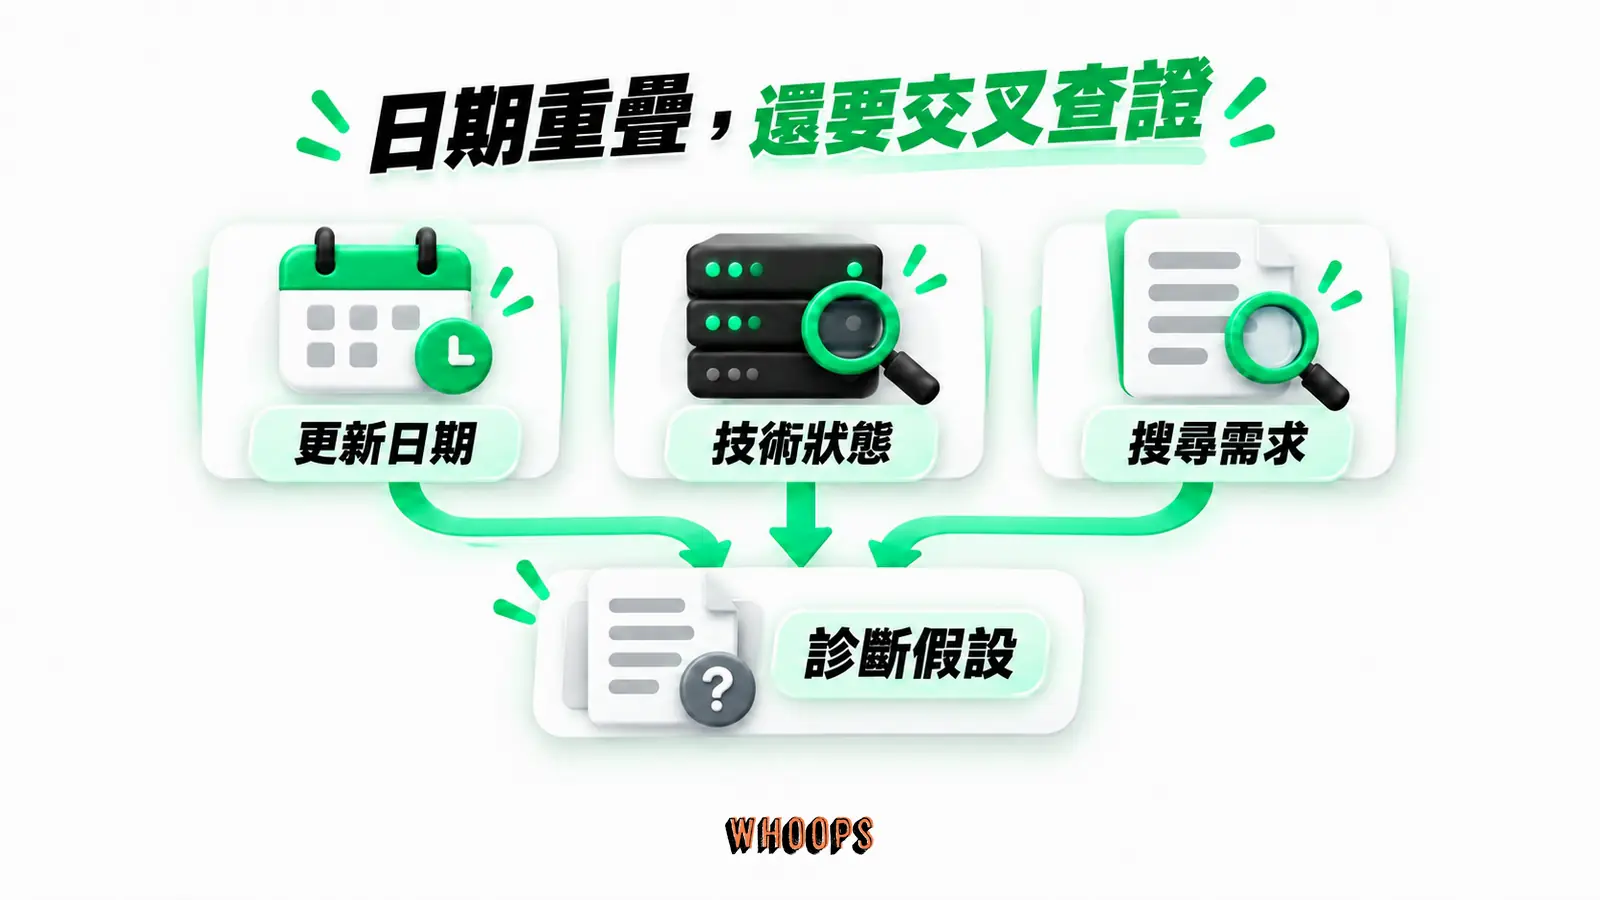
判讀的紀律補兩句:同業同時下滑,偏向產業級變動,先別急著改站;單一批頁面下滑,先查那批頁面的共用範本與意圖對應,而不是逐頁亂槍打鳥。版面的變化也值得記一筆:結果頁上多了 AI 回答、商家名單或影片區塊,可點的連結變少,點擊率自然受影響;曝光持平而點擊下滑時,先看版面,再懷疑內容。
動手修之前:三個自傷動作與一頁自檢清單
診斷完成,動手之前還有一關:避開看起來像優化、其實在自傷的動作。三種最常見。
誤用拒絕連結工具。沒有大宗垃圾連結、也沒有處置證據,就定期送拒絕清單當保養,可能把對自己有益的正常連結一起拒絕掉。這個工具是救濟手段,不是例行維護,使用前提在企鵝那節已經講過。
每次更新就大改站。核心更新一發布就猜「這次重視什麼訊號」,然後全站改標題、改結構,等於把網站的長期穩定性拿去賠一場猜測。更新的因應是對案查證,不是立刻變陣;常見的錯誤踩法,常見 SEO 錯誤整理過一輪。
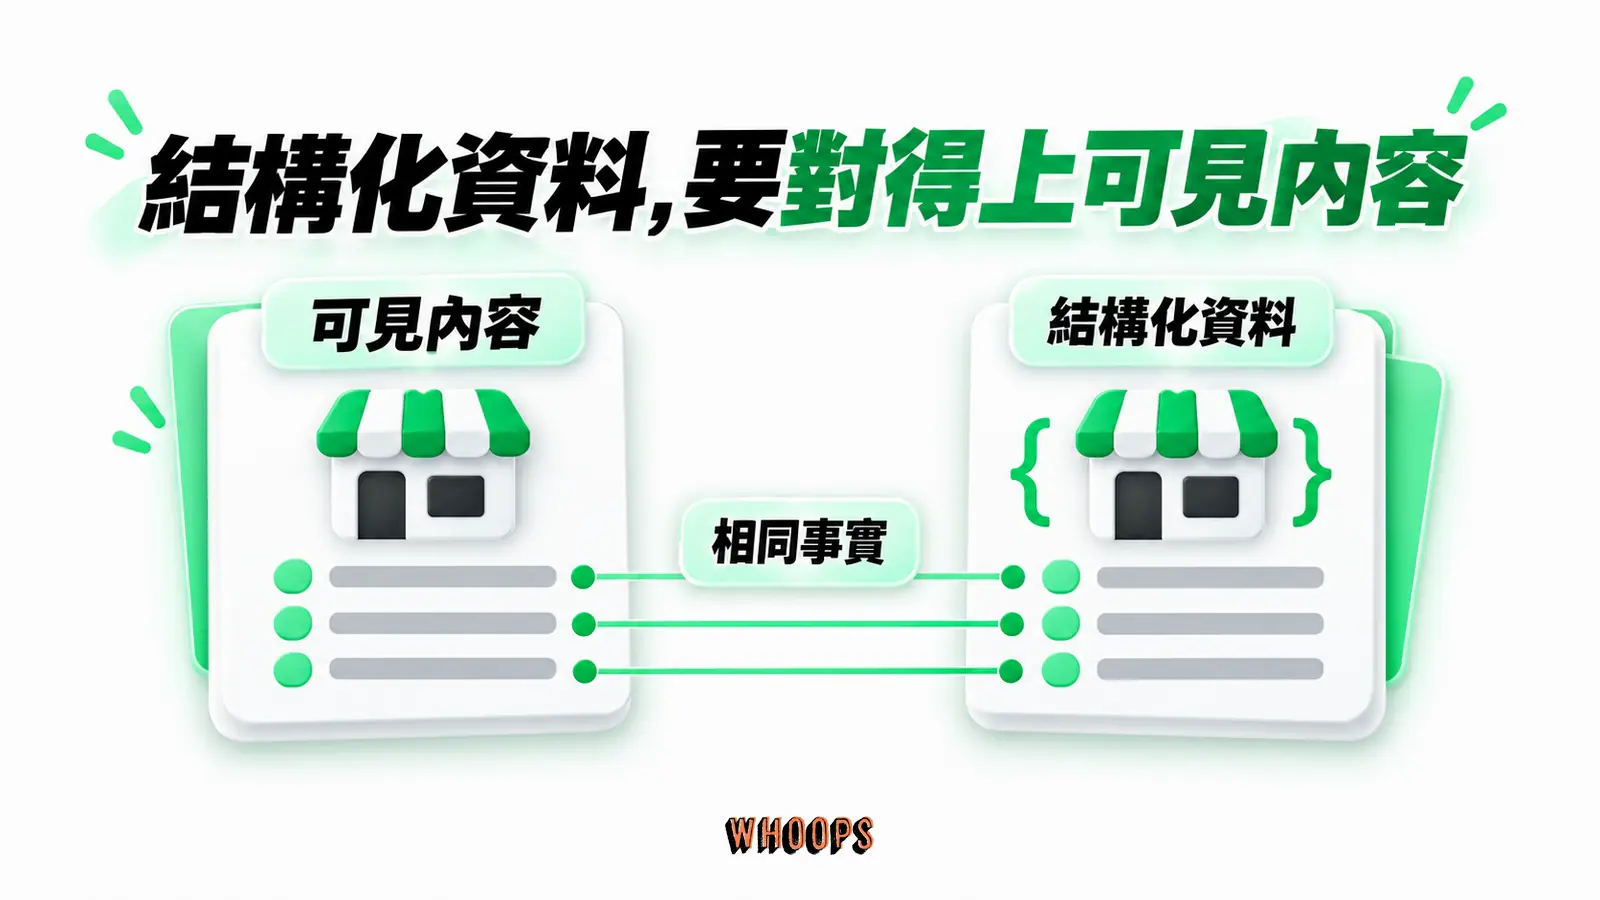
結構化資料標記超出實情。標記的內容與頁面可見內容不符,或網站沒有真實評分卻標上 AggregateRating,輕則被取消複合式搜尋結果的資格,嚴重時收到結構化資料的人工處置。標記是線索,超出實情的部分是風險,不是加分;站點聲譽濫用的教訓,也在同一條線上。
同類頁面反覆下滑,比單頁修補更值得回頭找共通原因:共用範本、量產流程、連結取得方式、意圖錯置,都是會讓一群頁面一起出事的條件。逐項查證這些共同條件,通常比對每一頁單獨下手更有生產力。
收攏成一頁式清單,六個檢查點各配一個可驗證的動作,跑一輪大概就是一個下午。清單的用途是定位,不是治療;六項跑完,問題通常會收斂到一兩個方向,修復計畫就從那裡開始:
- 查索引狀態:確認目標頁面仍被收錄、canonical 指向自己、沒有誤設 noindex。
- 抽樣問單頁價值:挑代表頁面,問這頁有沒有別處拿不到的價值,答不出來的先標記。
- 看連結來源與錨點:檢查反向連結有沒有一大批來自低品質網域、錨點幾乎全是同一個商業關鍵字。
- 比對意圖:拿主要查詢實際搜一次,看排名靠前內容回答的需求,與自己的頁面是不是同一種。
- 檢查作者與聯絡資訊:作者資料、經歷與聯絡方式,是否能幫讀者做出可信度的判斷。
- 核對 NAP 與標記:名稱、地址、電話在官網與各清單是否一致;結構化資料只標記頁面可見且真實的內容。
確認原因之後的修補順序,接著讀流量復原的完整做法,把診斷結果換成排好優先順序的修復計畫。
修改之前,不預設它一定帶來排名變化;修補照流程走,不抄捷徑;修完之後持續觀測資料,而不是宣稱治癒。排名系統會繼續演進,判斷的方法,比任何一次更新的答案都活得久。