文章出稿前怎麼自檢?寫作檢查表的五個關卡
出稿前的自我審查不靠重讀靠檢查表:結構、內容、語言、一致性、讀者五個關卡各司其職,配冷卻、朗讀與雙人校對的節奏安排,附二十五題可直接抄走的檢查表,把憑感覺出稿換成逐項可驗證的把關。
- 寫作檢查表
- 出稿前檢查
- 自我審查
- 文章校對
- 校對方法
- 朗讀校對
- 檢查表設計
- 錯字檢查
- 孵化效應
- 知識的詛咒
- 可讀性
- 白話寫作
- 一致性檢查
- 檢查清單
約 27 分鐘閱讀作者:Whoops 編輯團隊
出稿前的自我審查,不等於再把稿子從頭到尾讀一次。讀一遍靠的是印象,印象正是錯誤最好的掩護。有效的自檢靠一張固定的檢查表:把稿件拆成結構、內容、語言、一致性、讀者五個關卡,每過一關才準走下一關,由大到小,先確認文章對不對,再計較句子順不順。答案只有通過與不通過,沒有「差不多」。
趕稿時的出稿流程常是這樣的:寫完末段,往回捲到開頭,眼睛掃過去,感覺沒什麼大問題,按下發布。這個流程的名字叫「掃視」,它在專業出版領域有明確的定義,據維基百科的校對條目,掃視指的是不逐字閱讀的檢查方式。寫作者對自己稿件的記憶太熟,掃過去的時候大腦會自動補上缺漏的字與漏掉的段落,於是檢查形同虛設。檢查表的功能,就是逼你把「感覺沒問題」換成二十五個必須逐一回答的問題。
這份指南先講清楚兩件事:檢查表憑什麼有效(它背後有航空的實務紀錄與外科的實證數據),以及自己的錯為什麼自己看不見(認知科學對此有直接解釋)。接著把五個關卡逐一展開:結構檢查看讀者會不會迷路,內容檢查看每個宣稱禁不禁得起點開,語言檢查看句子讀起來順不順,一致性檢查看同一個概念有沒有用同一個名字,讀者檢查看你預設的背景知識讀者身上有沒有。之後是檢查的節奏怎麼安排、檢查表本身會怎麼失效,收在一份二十五題、可以直接抄走的出稿檢查表。
適合的讀者四種:獨立寫作的內容創作者、要對稿件品質負責的編輯、經營部落格或電子報的知識工作者,以及任何曾經在發文十分鐘後被讀者提醒「第三段有個錯字」的人。檢查表與寫作技巧是兩回事:技巧決定文章的天花板,檢查表守住地板。寫作技巧的累積可以參考文案寫作的完整攻略,出稿前的把關,交給這五個關卡。
出稿品質為什麼需要一張檢查表
檢查表不是寫作圈的發明,它是在人命關天的行業裡被磨出來的工具。據檢查表條目的整理,航空界普遍相信,檢查表誕生於 1935 年 10 月 30 日波音 B-17 原型機 Model 299 的墜機事故之後:原型機墜毀後,業界把關鍵步驟寫成一張表的說法廣被接受,表格接住的是記憶接不住的部分。同一條目也誠實記下了但書:牛津英語詞典顯示 check-list 一詞早在 1853 年就出現過,1935 年的故事或許只是這個詞最出名的註腳。無論起源如何,檢查表自此走進駕駛艙的日常程序。
檢查表效果最有名的量化證據來自外科。2009 年 1 月刊登於《新英格蘭醫學期刊》的一項研究,在八個城市的八家醫院導入一份十九項的手術安全檢查表,據研究摘要記載,這份檢查表的設計目的是改善團隊溝通與照護的一致性,導入後病人的死亡率從 1.5% 降到 0.8%,住院期間併發症發生率從 11.0% 降到 7.0%,研究者的措辭始終謹慎:檢查表的導入,伴隨兩項比率的下降一同出現。外科醫師阿圖.葛文德把這套邏輯寫成了《The Checklist Manifesto》,據維基百科的介紹,書在 2009 年 12 月出版,講的正是檢查表如何在各種專業現場把「本來就會做的事」變成「每次都做到的事」。
寫作出錯不會鬧出人命,但兩個行業的病根相同:記憶與注意力在重複任務裡天生不可靠。維基百科對檢查表的定義直指核心:檢查表是一種作業輔助,用來補償人類記憶與注意力的先天限制,降低重複任務的失敗率。你昨天記得檢查連結,今天趕稿就會忘,這不是態度問題,是認知結構問題。指望「這次小心一點」等於指望記憶自己變可靠,航空史說明了這條路走不通。
還有一個常見的誤解要先拆除:檢查表是檢查用的,不是教學用的。同一條維基百科條目特別點出,檢查表與操作手冊的差別,在於它不提供怎麼做的細節,它預設使用者本來就會做每一個步驟,只負責提醒你別漏掉。所以出稿檢查表上該寫的是「數字都有出處嗎」,不是「如何幫數字找出出處」。要是你發現自己的檢查表越寫越像教學文,那份檢查表就已經失效了一半,因為執行的時候你會停下來讀書,檢查的節奏就斷了。
條目裡還有兩個特性,直接對應寫作者的處境。其一,檢查表的價值在操作者承受壓力或注意力減退時最明顯,疲勞與分心正是它被設計來補償的狀態。截稿日的倒數計時、連趕三篇的疲勞、明天就要上線的壓力,恰好是記憶與注意力最不可靠的時刻,也恰好是「憑感覺出稿」最容易出事的時刻。檢查表在這種時刻接管判斷的下限。其二,檢查表自帶紀錄功能,勾完的檢查表就是一份「當時查過什麼」的憑證。文章上線之後被指出問題,你回頭看檢查表就能定位:是檢查表漏了這一項,還是有這一項而你漏勾了。前者回頭修題目,後者補紀律,兩種修法完全不同,沒有紀錄就永遠分不出來。
自己的錯為什麼自己看不見
把檢查交給檢查表之前,得先接受一個不舒服的事實:你的大腦在抓自己錯誤這件事上,天生裝了濾鏡。英國雪菲爾大學的心理學家湯姆.斯塔福德研究錯字多年,2014 年 8 月他在一篇線上訪談報導裡給出了一段解釋:寫作是非常高層的任務,大腦為了把心力留給「組織意思」,會把「字母變單字、單字變句子」這類底層工作打包成自動化程序。用他的原話說,我們並不捕捉每一個細節,我們接收感官資訊,把它與預期混合,然後萃取出意思。
這個機制在校對自己的稿子時,就成了致命傷。你腦中裝著你想傳達的意思,眼睛看到稿面,兩個版本互相競爭,而腦內版本通常比稿面更完整。於是漏字被補上、斷句被撫平、缺整段的洞被意思填滿。這不是眼的問題,是大腦在高效地欺騙你。脈絡影響閱讀的證據更早:據維基百科的詞優效應條目,實驗心理學家卡特爾在 1886 年發現,讀沒有關連的字詞所花的時間,約是讀有意義句子的兩倍,字母也一樣,孤立的字母認得慢,包在單字裡的字母認得快。這個實驗量的是閱讀速度,證明脈絡會加快辨識,沒有直接測錯字,但與斯塔福德筆下的預期機制同一方向。讀者的大腦熱愛預期,一句話只要大致符合語感,哪怕其中一個字打成了同音字或鄰近字,大腦也照樣讀通。錯字在你眼皮底下隱形,靠的就是這套預期系統。
看不懂的地方被腦內版本撫平,看得懂的地方被預設讀者也懂,後者叫知識的詛咒。據維基百科的條目,這個詞在 1989 年由三位經濟學家提出,定義是一種認知偏誤:擁有專業知識的人,會不自覺地假設別人也擁有同樣的知識。寫作者的版本更尖銳,你查過的資料、你腦補的脈絡、你昨天才想通的因果,讀者身上一樣都沒有。稿件在你眼裡是完整的,因為缺的零件都在你腦子裡。
兩個濾鏡疊起來,結論就出來了:出稿前的自檢如果只是「認真再讀一遍」,等於戴著同一副濾鏡把同一個畫面再看一次。要突破濾鏡,得換工具或換條件:把讀的順序打亂、把稿子變陌生、隔一段時間再碰、或者換一雙沒有預期的眼睛。後面第三關與檢查節奏兩節,就是把這幾個動作安排進流程的地方。
兩個濾鏡也提示了檢查由大到小的理由。預期濾鏡作用在「意思」上,你越知道一段在講什麼,越看不見那段缺了什麼,所以結構與內容這種意思層的問題,適合用地圖式的讀法與逐條列舉的對帳,而非通讀。知識的詛咒作用在「背景」上,它靠的不是精神狀態,得靠刻意切換成讀者視角才鬆得動,所以讀者關需要單獨、清醒地走。至於錯字與格式,機械掃描加朗讀就有機會穿透,放在體力已消耗大半的後段剛好。五關的順序是編輯上的安排,對應的是各類問題需要的檢查姿態。
檢查表怎麼設計才有效
檢查表本身也有設計好壞,設計錯了比沒有更糟,因為它會給你「已經檢查過了」的錯覺。維基百科的條目收了一條來自實務的原則:檢查表應該易讀,只包含必要的檢查項目,並且在合理可行的範圍內越短越好。對應到出稿檢查,三個設計準則。第一,一項一個可驗證的問題。「內容通順嗎」不可驗證,通順沒有判準,「每個數字都找得到出處嗎」可驗證,答案有通過與不通過。第二,只留必要的項目。昨天錯過的、代價高的、容易漏的才進表,這個月都沒出錯的項目可以移出。第三,越短越好。檢查表是用來執行的,用來展示勤勞的檢查表沒幾次就會被跳著看。
五個關卡的先後順序也是設計的一部分:由大到小。結構錯了,句子再漂亮都要重寫,所以結構先查。語言的問題最顯眼卻最不重要,所以放在後面。一致性與讀者預設屬於細節層,但它們傷害的是讀者的信任,排在語言之後、發布之前。五關的分工如下表。
| 關卡 | 檢查對象 | 核心問題 | 不通過時的動作 |
|---|---|---|---|
| 第一關:結構 | 骨架與順序 | 只讀小標題,看得出全文在回答什麼嗎 | 調整段落順序、補齊或刪除小標題 |
| 第二關:內容 | 事實與宣稱 | 每個數字與斷言禁得起點開來源嗎 | 補出處、降級措辭或刪除宣稱 |
| 第三關:語言 | 句子與段落 | 朗讀時會卡住或喘不過氣嗎 | 拆句、換字、改變句子長短配置 |
| 第四關:一致性 | 用語與格式 | 同一個概念自始至終用同一個名字嗎 | 統一術語、修正錯字與格式 |
| 第五關:讀者 | 預設與意圖 | 讀者缺的背景,文中補齊了嗎 | 加解釋、改例子、收斂目標讀者 |
執行的方式只有一條紀律:一次走一關,走完才換。五關混著查,注意力會被最顯眼的錯字吸走,輪到結構時眼睛已經疲勞,於是真正致命的順序問題反而漏網。一關一過還有另一個好處,修改的因果乾淨。第二關改完的事實,不會在第三關被順手改掉,出了問題回頭找起來有跡可循。
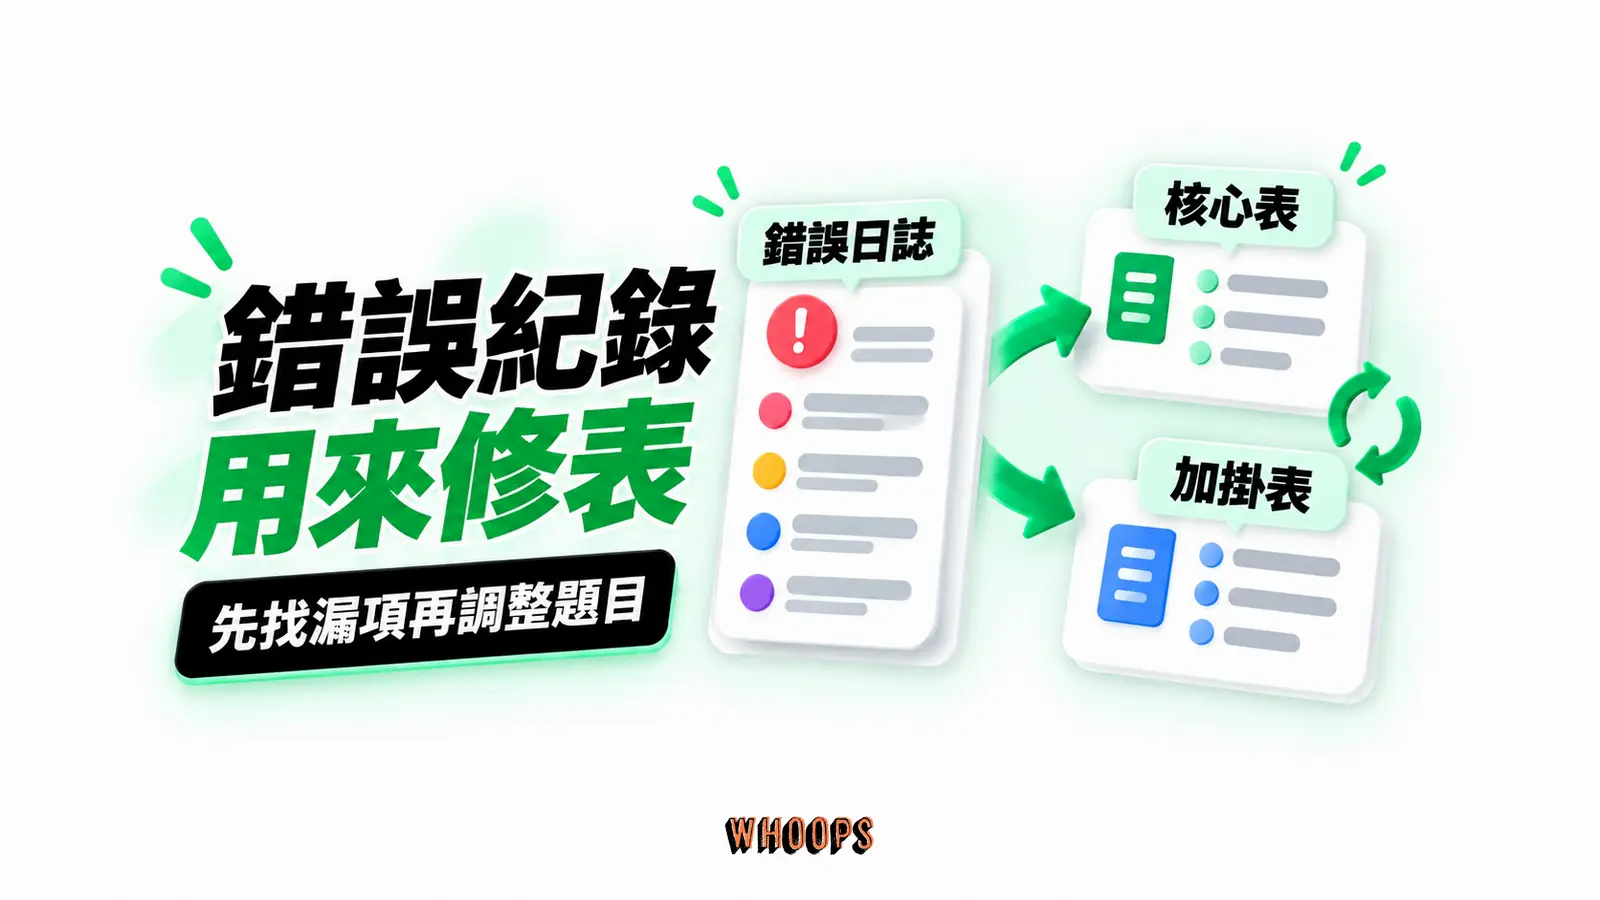
題目從哪裡來,決定檢查表的品質。抄別人的範本只是起點,真正有效的題目來自你自己的錯誤紀錄:準備一個錯誤日誌,每被讀者抓到一個漏網的錯,就回頭問兩個問題,這個錯屬於哪一關,那一關有沒有對應的題目。沒有就視必要性補一題或換掉舊題,有卻沒抓到,就把題目改得更銳利一點。三個月後,你的檢查表會長得跟任何範本都不一樣,因為它專門對付你擅長犯的錯。範本檢查表是別人錯誤史的摘要,自己的檢查表才是自己的防線。
第一關:結構檢查,讀者會不會迷路
結構檢查的工具是一份只看骨架的讀法:把全文的小標題按順序抄下來,單獨讀。這串標題應該像一張地圖,讀者還沒進內文,就知道全文回答了哪些問題、以什麼順序回答。抄下來之後問五個問題。標題承諾的內容,正文兌現了嗎,標題寫了五個方法,正文就得恰好五個,多一個少一個都是兌現失敗。開頭三段之內,主題直答了嗎,網頁讀者決定去留的時間極短,鋪陳太長的開頭等於把答案藏在讀者已經離開的地方。小標題的順序,是讀者問題出現的順序嗎,寫作者的順序常是資料整理的順序,讀者的順序是困惑發生的順序,兩者經常不同。
段落層面同樣五問裡的兩問在這關處理。一段一個重點,任何一段同時在講兩件事,就拆成兩段,硬撐著不拆,兩個重點都會被稀釋。長度配重也得看:最重要的論點占的篇幅,有沒有反被次要的例子壓過,篇幅是讀者判斷重要性的訊號,配重錯了,讀者會把力氣花在你不想強調的地方。流程型長文的段落鋪排另有專門的寫法,資訊型文章的流程寫作有更細的拆解,這裡處理的是各文類通用的骨架檢查。
結構關不通過時別急著改字,先動刀移塊。段落搬移、小標題重寫、開頭三段重寫,都是這關的正當修法。順序對了再修語言,才不會發生「句子磨得發亮,然後整段刪掉」的白工。
這一關有個省力的訣竅:把小標題清單貼給一位沒讀過全文的人,請他只看清單猜全文要講什麼。他猜的方向與你的企圖相差越遠,結構的問題越大。沒有適合的人選,就隔一天再看同一份清單,冷卻之後你自己的預期會褪色,標題傳達不了的訊息會自己浮出來。地圖測試不通過的稿件有個共同點:作者本人能把清單講通,因為缺的邏輯都在他腦內,這正是前面濾鏡一節說的效應在結構層的翻版。
第二關:內容檢查,宣稱禁得起點開嗎
內容檢查的對象是每一個可以為真或為假的句子。操作方式:把稿子裡所有數字、統計、引述、日期圈出來,逐一回答「這個說法,我從哪裡知道」。答案必須具體到一個可打開的來源:一份報告、一個官方頁面、一本書的一章。凡是答不出來的宣稱,只有三條路,找到出處、把措辭降級成你扛得動的版本,或者刪掉。數字查證是繞不過去的硬關,因為讀者對數字的印象特別深,錯一個百分比,整篇文章的可信度一起賠上。
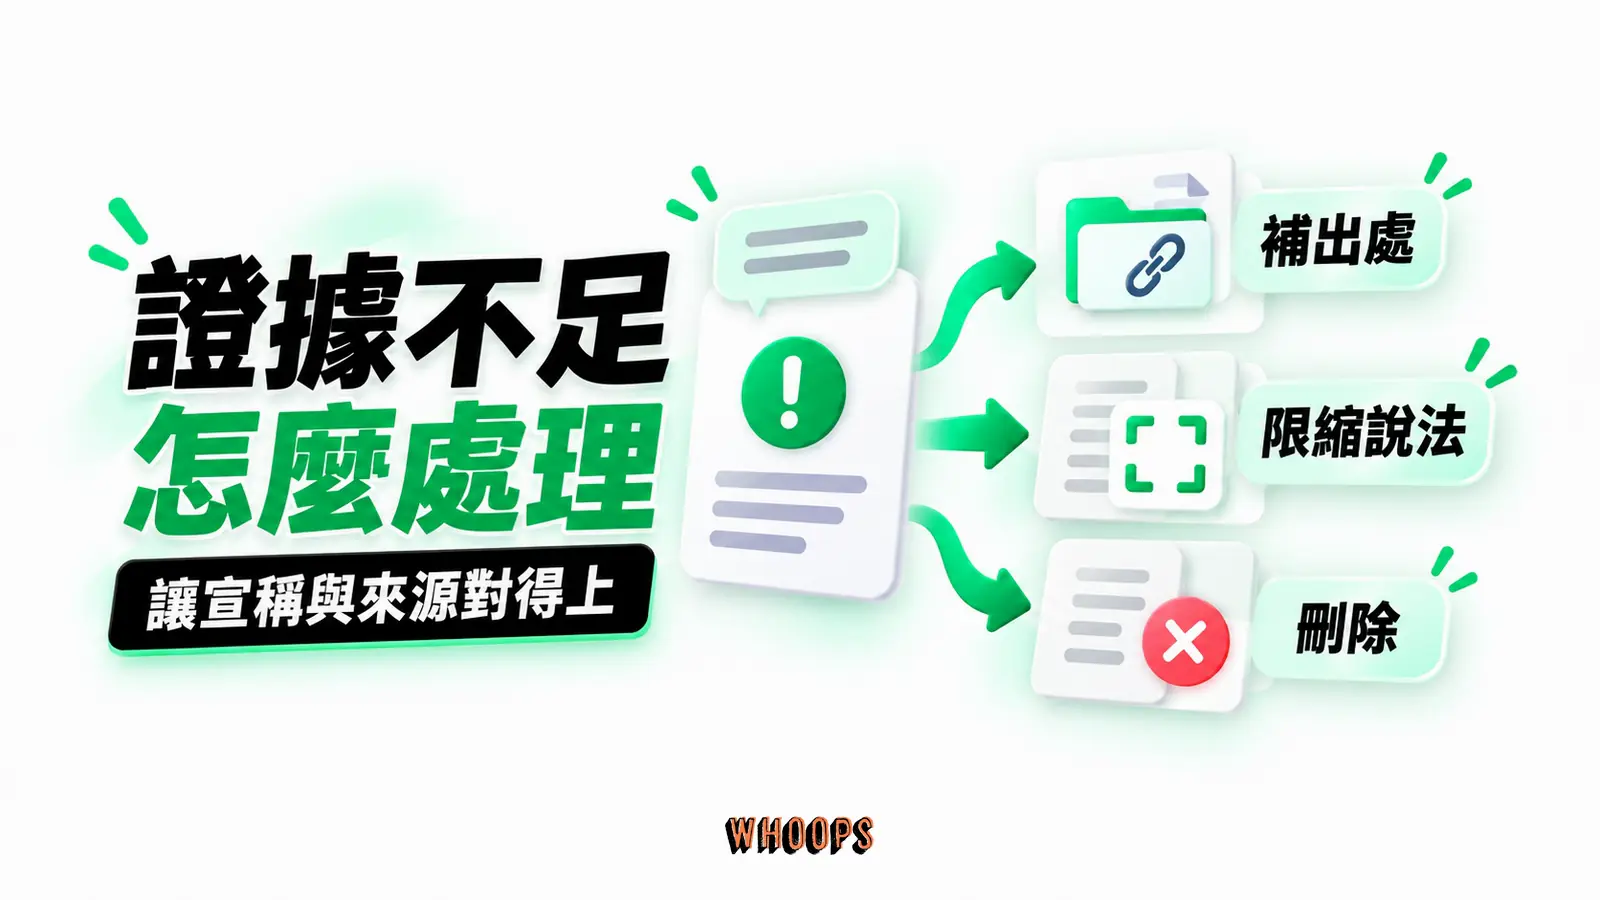
全稱與最高級的措辭在這關過濾。「一定」「保證」「所有人都」「業界第一」這類字眼,每出現一次就問一次:證據等級撐得住嗎。多數時候撐不住,改成範圍限縮的版本一樣有力,而且不必替你扛它扛不動的責任。來源本身也要檢查三件事:連結還活著嗎,連到的頁面講的真是你要支持的那件事嗎,來源的日期標出來了嗎。第三點最常被漏,兩年前的市占數字寫成現在式,讀者查證的那一刻,信任直接歸零。
內部連結也在這關檢查:每一條連到的頁面存在嗎,錨點文字與目標頁的內容相符嗎,同一個頁面連第二次了嗎。內鏈是給讀者的路標,路標指向不存在的路,比不放路標更糟。動筆前的素材功夫決定了這關的難度,素材調查做得紮實的稿件,圈出來的宣稱幾乎都帶得出出處,動筆前的調查與素材整理講的就是這段上游工程。這關通過的標準很簡單:稿子裡沒有一個宣稱,是你不敢讓讀者點開來源核對的。
措辭降級有三種具體做法,比直接刪掉更常派得上用場。範圍限縮:把「所有」換成「我查過的這十份個案裡的」。出處隨行:把斷言改成轉述,寫明是哪個單位在哪一年的說法,責任就回到出處身上。強度分級:「證明」「保證」降為「顯示」「傾向」,讀者損失的確定性,用你保住的可信度補回來有餘。這三招的共同點是把宣稱修到與證據等級相符,而證據等級是你在這一關逐條盤點出來的,降級不是退讓,是把帳算清楚。
第三關:語言檢查,讀起來順不順
語言檢查有一個被實驗支持的核心工具:朗讀。2022 年刊登於《Journal of Applied Research in Memory and Cognition》的兩個實驗,讓受試者分別以靜讀、朗讀、難讀字體三種方式校對短文,據論文的實驗紀錄,相較於靜讀,朗讀同時改善了錯字類與文法用字類兩種錯誤的偵測率。實驗還測了流傳已久的替代方案:換上難讀的字體。結果字體組的錯字偵測不升反降,文法與用字錯誤也沒有進步。同一份研究裡有個耐人尋味的細節,受試者事前並不預期朗讀有用,甚至預期難讀的字體有害,實驗結果卻顯示朗讀有效。換句話說,哪個工具真的有效,直覺猜不中,實驗數據才答得出。
朗讀為什麼有效,一個合理的解釋與前面濾鏡一節的機制相接:念出聲的時候,句子必須逐字經過嘴巴,自動補全未必來得及插手,卡住的地方、喘不過氣的長句、讀不出來的斷句,會在嘴上現形。朗讀時盯三個訊號:會卡,表示句構有問題。會喘,表示句子太長。會念錯,表示稿面與你想的字不一樣,而那個「你想的字」極可能就是錯字本身。句子太長的判準不必背數字,一句話要換氣才念得完,就值得拆成兩句。句長的各種都市傳說,例如一句絕不能超過二十字,早有人逐條查證過,寫作鐵律的查證把證據攤開了,結論比傳言溫和:官方指引的建議形態是平均十五至二十字、超過二十五字才檢查能否拆開,在那裡同樣被定位為輔助線而非逐句鐵律。
英文世界對句長有更硬的工具。可讀性研究先驅魯道夫.弗萊什在 1948 年提出了閱讀容易度公式,後來又與心理學家金凱德為美國海軍發展出年級分級公式,據可讀性公式條目的整理,兩套公式的核心變數相同:句長與字長。條目並列了兩個分數例子:《讀者文摘》約 65 分,《時代》雜誌約 52 分。必須說清楚界線:這套分數為英文校準,計算依賴音節數,中文文本沒有可直接套用的版本,硬算分數沒有意義。可以移轉的是原則:句長是閱讀負擔的主要來源之一,把長句的比例壓下來,方向就對了。
抽象與具體的檢查也在這關。把稿子裡的抽象名詞圈出來,特別是動詞化的名詞與三個字以上的概念詞,逐一問:能不能換成一個讀者看得見畫面的說法。「優化使用者體驗」看不見畫面,「把結帳按鈕從三個減成一個」看得見。句子層面的節奏感,長短句怎麼配、停頓落在哪,屬於更細的手藝,文案節奏的練法與自檢有一份專門的清單,這裡的語言關只守底線:念得出、念得順、看得見畫面。
錯誤分類給了這關一個有用的分工框架:錯誤分成錯字類的表面錯誤與文法用字類的情境錯誤,前者單看該字就錯,後者要理解整句才看得出錯。拼字檢查工具對前者有幫助,對後者幫助有限,道理在檢查原理:情境錯誤往往每個字都拼對,逐字比對沒有可抓的錯。同音字是中文裡最典型的情境錯誤:「產品在促銷」與「產品再促銷」都拼得對,意思天差地遠,逐字比對的工具自然攔不下。所以這關的標準流程是工具先跑一輪抓表面,人工朗讀補大部分情境,同音字這類讀音相同的例外,交給下一關的逐字掃描收尾。
第四關:一致性檢查,同一個東西用同一個名字
一致性檢查處理的是散落全文、單看每句都對、合起來就打架的細節。頭號項目是術語:同一個概念,全文必須用同一個名字。稿子前半叫「訂閱制」、後半叫「訂閱方案」,讀者會當成兩個東西,理解成本憑空翻倍。檢查的方法是做一張對照表:列出全文的關鍵概念,各自數一數出現了幾種講法,超過一種就選定一個,全文替換。人名、產品名、公司名的每一個字都要前後一致,翻譯名的寫法尤其容易漂移。
錯別字與同音字在這關集中清剿。中文的同音錯誤朗讀抓不到,「在」與「再」、「需」與「須」、「紀錄」與「記錄」,念出來完全一樣,只能靠眼睛逐字掃。搜尋時用同音字搭配詞類判斷,比整篇重讀有效率。標點與格式的規則也要一次定清楚:數字用半形還是全形、百分比怎麼寫、年份要不要加「年」字、中英文之間空不空格、專有名詞的英文名首字母大小寫。這些規則選哪一版不重要,重要在全文同一版。簡體字混入是繁體稿件最傷的一種不一致,機器轉換的殘留、簡體資料抄錄的痕跡,讀者一眼就會看見,逐字掃的時候別放過字形可疑的字。
還有一項容易漏:稱謂與人稱。全文對讀者的稱呼是「你」就一直是「你」,對自家的稱呼是「我們」就一直是「我們」,敘事人稱在中途換軌,讀者說不出哪裡怪,但就是會覺得文章變了口氣。一致性關不通過的稿件有個共同外貌:每個句子單獨看都沒問題,合起來像三個人寫的。修法機械而枯燥,照對照表逐項替換,這正是檢查表擅長的工作。
這一關靠通讀幾乎查不出東西,因為不一致的兩個用法往往相隔甚遠,通讀到後面早就忘了前面的用法。有效的做法是靠搜尋,不靠記性:把對照表上每一個關鍵概念連同它的常見變體逐一丟進文稿搜尋,數出現次數。同一概念兩種講法各有十次,就挑定一種,搜尋取代另一種,然後重數一次確認歸零。人名與翻譯名同理,中文名、全名、暱稱各搜一遍,出現幾種寫法一目了然。把這關交給搜尋框,比交給眼睛可靠得多。
第五關:讀者檢查,預設知識會不會太多
第五關把濾鏡整個翻過來看:不再問稿件寫得好不好,改問讀者帶著什麼進來。知識的詛咒在寫作端的具體症狀有三種:縮寫與術語第一次出現沒有解釋、例子來自你自己的行業共識、推論跳過了你查了三天才想通的那一步。檢查的方法是把稿子裡每一個專業詞圈出來問:目標讀者認得嗎,不認得的,第一次出現的位置就要給一句解釋或一個例子。英文維基百科對知識的詛咒的定義寫得直白:擁有專業知識的人,會假設他人共享那份知識。寫作者是最重的患者,因為你的稿子越熟,讀者離你越遠。
白話不是降低水準,它是有立法背書的溝通標準。美國在 2010 年 10 月 13 日由總統簽署了《Plain Writing Act》,據白話寫作立法的條目,這部法律要求聯邦政府機關在發布或大幅修改受該法規範的文件時使用白話英文,還要訓練員工怎麼寫。政府文件與網路文章讀者不同,原則相通:讀者的時間不該花在解碼你的句子。實用的判準是,讀者有沒有任何一句需要讀第二遍,需要複讀的句子,多半是寫得太難,不是讀者太笨。
兩個收尾的問題完成第五關。行動對齊:讀者讀完,做得出你期望的下一個動作嗎,期望訂閱,訂閱的理由與入口給了嗎,期望照做,步驟的起點站在讀者找得到的地方嗎。讀者單一:這份稿子自始至終寫給同一種人嗎,同時寫給新手與老手的稿子,通常表示兩種人都沒被寫到,新手在第二段迷路,老手在第五段覺得囉嗦。搜尋場景的讀者意圖怎麼對齊,SEO 文章的寫作方法有專門的整理,這一關守的是更根本的底線:稿子是寫給讀者的,不是寫給你知道讀者不知道的那些東西的。
「需要複讀的句子」值得單獨展開,因為它是這一關最誠實的訊號。讀者不會告訴你哪句讀了兩遍,但複讀發生的地方,就是稿子的難度與讀者的能力出現落差的地方。自查的方法是把整份稿子慢讀一次,手上拿筆,凡是讀完一句需要往回看的,畫一筆。畫記集中的段落,問題通常不在單句,在銜接:前後兩句的因果或轉折沒接上,讀者才需要回頭找線索。修法先補銜接詞與過渡句,再考慮拆句子。作者端的複讀點修得越少,自己能抓的難度落差就越少,剩下的落差,交給目標讀者試讀回報。
檢查的節奏:冷卻、朗讀與換一雙眼睛
五個關卡排在什麼時間軸上,決定它們的成色。第一條紀律是冷卻:寫完與檢查之間,隔出一段完整的空檔。心理學對「把問題擱置一段時間」做過系統性檢驗,2009 年發表於《Psychological Bulletin》的整合分析回顧了相關實證研究,據論文摘要,研究者確認了孵化效應整體為正,並發現準備期越長、擱置的效果越明顯,而用高認知負荷的活動填滿擱置期,效果會變小。必須誠實畫出界線:這些實驗的對象是一般的問題解決任務,直接證據不在寫作校對上,但方向與出稿冷卻完全同向。實務的安排很簡單,寫完就停,去做負荷低的事,散步、整理桌面、處理雜務,隔一個晚上再回來走五關。
第二個安排是錯開五關的時間點。結構與內容兩關適合在冷卻後的第一輪走,因為它們需要清醒的判斷力。語言與一致性兩關可以放在第二輪,甚至換到另一個時段,這兩關機械性高,疲勞的殺傷相對小。讀者關留在末尾單獨走一次,因為它需要的心智狀態特別:假裝你是第一次讀到這個主題的人。這也是為什麼五關不建議一口氣跑完:連跑至此注意力多半已經下滑,而讀者關是最需要想像力的一關。
第三個安排是引進第二雙眼睛。專業出版發展出的雙人校對法是這樣的:一人照著原稿逐字朗讀,速度均勻,不加字不減字,另一人核對排好版或改過版的稿面,凡是念出的與稿面對不上的地方就做記號,比對的兩側是兩個版本,這正是它抓得住排版與改稿階段錯漏的原因。這個方法的分工設計正對著預期濾鏡而來:朗讀者的眼睛被聲音占住,跟讀者的判斷少受自己記憶的干擾,預期濾鏡被拆到兩個人身上。一個人的替代版本同樣有據可查,維基百科的校對條目記載,單人可以先把自己朗讀原稿的聲音錄下來,之後一邊聽錄音、一邊讀另一個版本,用耳朵當那第二雙眼睛。若手上只有同一份稿,朗讀自檢依舊有語言關的實驗支持,只是版本對稿與單稿自檢是兩回事。找不到人、又懶得錄音,最低成本的版本是把稿子傳給任何一位目標讀者,只問一個問題:哪一段你讀了兩遍。那一段,就是你與讀者之間的濾鏡差。
朗讀與錄音回聽還有一個常被忽略的細節:它們抓的不只是錯字。念不出來的句子,多半是句構打了結。念到某段聲音自動變小、開始趕場,那段的資訊密度對讀者來說多半過載。念的時候不小心跳行,跳過的那行有機會與前一行語感雷同,讀者掃讀時同樣會跳過。聲音把稿面文字拉成無法快轉的時間序列,大半的不順會隨之現形,而這是靜讀難以做到的事,也是語言關把朗讀放在核心位置的原因。
檢查表的三種失效模式
檢查表用久了會壞,壞法有三種,先認得出來才防得住。第一種叫自動導航:檢查表太熟,眼睛在項目上滑過,打勾的手比思考快。症狀是檢查時間越用越短,而錯字率沒有下降。解法是強制降速,把「逐項打勾」改成「逐項寫下答案」,數字有出處嗎,出處是哪個,寫下來的那一秒,自動導航就斷了。這正是開頭提到的掃視:眼睛不逐字看,字裡行間的錯就少了被看見的機會。
第二種失效是項目模糊。檢查表上出現「再順一次」「確認品質」這類沒有判準的項目,執行時只能靠感覺,感覺正是被檢查的對象,等於讓嫌犯審自己。修法回到設計準則:一項一個可驗證的問題,驗證不了就拆成可以驗證的幾項,或者刪掉。第三種失效是檢查表膨脹。每出一次錯就加一項,半年後檢查表長到五十題,執行者開始跳關,跳關的檢查表保護力不如一開始的二十題。維基百科收的那條原則值得抄在檢查表頂端:能短則短。膨脹的解法是雙表制,一張每次出稿必跑的核心表,一張低頻項目的加掛表,出稿只跑核心,特殊稿型才掛加掛。
還要認清檢查表的邊界:它守地板,不抬天花板。觀點平庸的稿子五關全過還是平庸,因為五關查的是「有沒有漏、有沒有錯、有沒有讀者」,不是「觀點夠不夠新、論證夠不夠深」。選題錯了,檢查表更是無能為力,題目沒有人要讀,零錯字也救不了。選題與曝光的判斷發生在動筆之前,出稿檢查表把守的是出口。把三件事的順序放對:選題決定值不值得寫,寫作決定寫得多好,檢查表決定差錯出不出得了門。
一份可以直接抄走的出稿檢查表
以下二十五題按五關排列,每關五題,一次走一關,逐題寫下答案再前進。抄走的時候記得雙表原則:定期回頭檢視你的檢查表,把連續幾回沒抓到東西的題目移到加掛表,上回漏出去的錯誤先記進錯誤日誌,再決定修訂、替換還是補成新題目。檢查表是活的文件,它的品質由最新的錯誤決定。
- 結構一:只讀小標題,能看出全文在回答哪些問題嗎,順序是讀者困惑的順序嗎。
- 結構二:標題承諾的數量與內容,正文恰好兌現了嗎。
- 結構三:開頭三段之內,直接回答了主題嗎。
- 結構四:每一段只有一個重點嗎。
- 結構五:最重要論點的篇幅,壓過次要的例子了嗎。
- 內容一:每個數字與統計,都答得出「從哪裡知道」嗎。
- 內容二:全稱與最高級的措辭,證據等級撐得住嗎。
- 內容三:每一條外部連結存在,且內容支持你的引述嗎。
- 內容四:資料的時間點,對讀者標清楚了嗎。
- 內容五:內部連結的頁面存在,錨點與目標頁相符,且每頁只連一次嗎。
- 語言一:拼字檢查工具先掃過一輪表面錯誤了嗎。
- 語言二:全文朗讀過一次,沒有卡住或喘不過氣的句子嗎。
- 語言三:需要換氣才念得完的長句,都拆過了嗎。
- 語言四:抽象名詞換成看得見畫面的說法了嗎。
- 語言五:長短句有變化,不是整段同一個節奏嗎。
- 一致一:每個關鍵概念,全文只用同一個名字嗎。
- 一致二:人名、產品名、公司名的寫法前後一致嗎。
- 一致三:數字、百分比、年份、標點的格式全文同一版嗎。
- 一致四:同音字與簡體字,都逐字掃清了嗎。
- 一致五:對讀者的稱謂與敘事人稱,自始至終同一個嗎。
- 讀者一:每個術語與縮寫,第一次出現就有解釋或例子嗎。
- 讀者二:有沒有任何一句,目標讀者試讀後需要讀第二遍。
- 讀者三:讀完之後,讀者做得出你期望的下一個動作嗎。
- 讀者四:整份稿子自始至終,寫給同一種讀者嗎。
- 讀者五:例子的背景,目標讀者不用另查資料就看得懂嗎。
二十五題走完,出稿。會不會還有漏網的錯,會,檢查表把失誤率壓低,沒有歸零的版本。漏出去的錯,先進錯誤日誌再決定去留:照前面膨脹失效一節的紀律,該換掉舊題就換掉,該補成新題才補,目標是讓同一類失誤不容易再出門第二次,這份檢查表跟著你的寫作生涯一起長。這正是 1935 年以來,駕駛艙與手術室教給所有行業的那件事。