Muse Wonder 是什麼?Wonder Full 差別、四大能力與 API 價格指南
Meta 於 2026 年 10 月 12 日發布 Muse Wonder 與 Wonder Full 前沿模型。這篇拆解兩款差別、Active Memory 等四大能力、AA 智慧指數 56 分的真實位置、API 價格與 Muse Code 訂閱成本,以及台灣可用性與 benchmaxxing 批判,幫你判斷要不要現在行動。
Meta 在 2026 年 10 月 12 日一口氣發布兩款新模型:Muse Wonder 與 Muse Wonder Full。官方給它們的定位寫得很白:專為個人與專業代理任務打造的前沿模型,處理一筆保險理賠、讀懂一份租約、把一個 App 從需求做到能動,都在設計目標裡。放在更大的脈絡看,這是 Meta Superintelligence Labs 歷經十四個月 AI 全面重整後交出的第一張前沿成績單:獨立評測機構 Artificial Analysis 給 Wonder Full 打出 56 分,只落後 58 分的 Claude Opus 5.5,把 GPT-6 Astra 與 Gemini 4 Argon 的 53 分拋在後面。一家模型競賽節奏曾被外界質疑多年的公司,用六週一個世代的節奏把分數從 48 推到 56,這件事本身就值得每一個正在選模型的人看懂。
先給可以直接行動的地圖。開發者今天就能在 Meta Model API 用到 Muse Wonder,牌價每百萬 token 輸入 4 美元、快取輸入 0.20 美元、輸出 20 美元,模型代號 muse-wonder-1.0;Muse Wonder Full 不走 API 計費,綁在 Muse Code 訂閱裡,從每月 50 美元的 Power Usage 方案起可用。兩款都支援 100 萬 token 上下文,輸入通道涵蓋文字、圖片、影片與音訊。一般使用者這邊,官方的說法是 Wonder 即將驅動更多 Muse 個人代理的體驗,而且是訂閱戶優先;Muse App 目前只開放美國與加拿大,台灣連產品都還沒等到,模型進場的時間表自然也沒有。
這篇指南跟站上的〈Meta Muse 是什麼〉做明確分工:那一篇走產品軸,講你手機裡那個會替你寄信、購物、排行程的助理;這一篇走模型軸,講驅動這一切的引擎。文章會把六件事講清楚:Wonder 世代在 Meta 模型階梯上的位置、兩款模型的分工、四大能力的官方定義與評測方式、AA 智慧指數的分數軸與解讀限制、API 與訂閱的成本結構,以及開放情況與台灣可用性。後段的批判軸不迴避爭議:benchmaxxing 質疑、漲了四倍的牌價、知識廣度的弱項,與非開源的現實,四個檢查點都攤開來講。
查證基礎先交代。事實以 Meta 官方新聞室公告、Meta 研究部落格、Muse Wonder Model Card、dev.meta.ai 開發者頁,加上 Artificial Analysis 的評測文章為本,查證時間為 2026 年 10 月 14 日;引用基準數字時一律標明是 max 推理力檔位下的結果。前沿模型兩個月一代的節奏下,任何數字都可能被下個版本翻頁,付費與導入決策請以官方頁面當天顯示為準,文內的價格與能力描述出自官方文件的記載,不是本站的實機測試紀錄。
Wonder 世代是什麼:十四個月重整後的第一張成績單
把時間軸拉長,才看得出這次發布的分量。Meta Superintelligence Labs 在官方研究部落格裡自己寫明:十四個月前,公司展開了 AI 能力的地面重建,從第一性原理重起技術棧,一路推進到今天的前沿位置。Wonder 系列就在 Meta 自家的 gigawatt 級 Prometheus 資料中心完成訓練,延續初代 Muse Spark 揭櫫的可預測、可複製的擴展方法,在預訓練與強化學習兩端同時加碼。官方替這條路線取的名字是 personal superintelligence,個人超級智慧:模型能力一路往上疊,最終要服務的是每一個人的日常工作與生活。這個敘事直接解釋了 Wonder 的能力設計為什麼繞著「代理」轉,也解釋了後面會講到的 Active Memory 為什麼被擺在這麼前面。
分數的階梯看得更具體。用 Artificial Analysis 的智慧指數當尺標,Meta 的模型世代是這樣爬上來的:初代 Muse Spark 31 分、Spark 1.1 與 1.2 在 xhigh 檔位各得 34 與 40、Spark 1.3 的 max 檔位得 48,然後是這次的 Wonder 52 與 Wonder Full 56。從 Spark 1.3 到 Wonder Full 只隔六週,總分漲 8 分,而且是十項指數評測全面進步,沒有靠單一項目偏科。這個爬坡速度放在產業裡比更有感:同一段時間,OpenAI 從 GPT-6 Astra 走到 GPT-6.1 Sol,分數在 52、53 之間徘徊,Meta 則一次把差距拉開。對長期觀察這個產業的人來說,Wonder 世代真正的訊號在這裡:模型競賽的領先集團從三家變成四家,而且新進者手握 Meta 生態系這個別人沒有的分發管道。
左右捲動檢視完整表格
| Meta 模型世代 | AA 智慧指數 | 計分檔位 | 上下文 | 取得方式 |
|---|---|---|---|---|
| Muse Spark(初代) | 31 | 頁面未標檔位 | 262k | AA 階梯上的起點 |
| Spark 1.1/1.2 | 34/40 | xhigh | 1M | 代理能力逐步補強 |
| Spark 1.3 | 48 | max | 1M | 九月 Muse 代理的當家模型,仍在 API 販售 |
| Muse Wonder | 52 | max | 1M | Meta Model API+Muse Code |
| Muse Wonder Full | 56 | max | 1M | 限 Muse Code 訂閱(每月 50 美元起) |
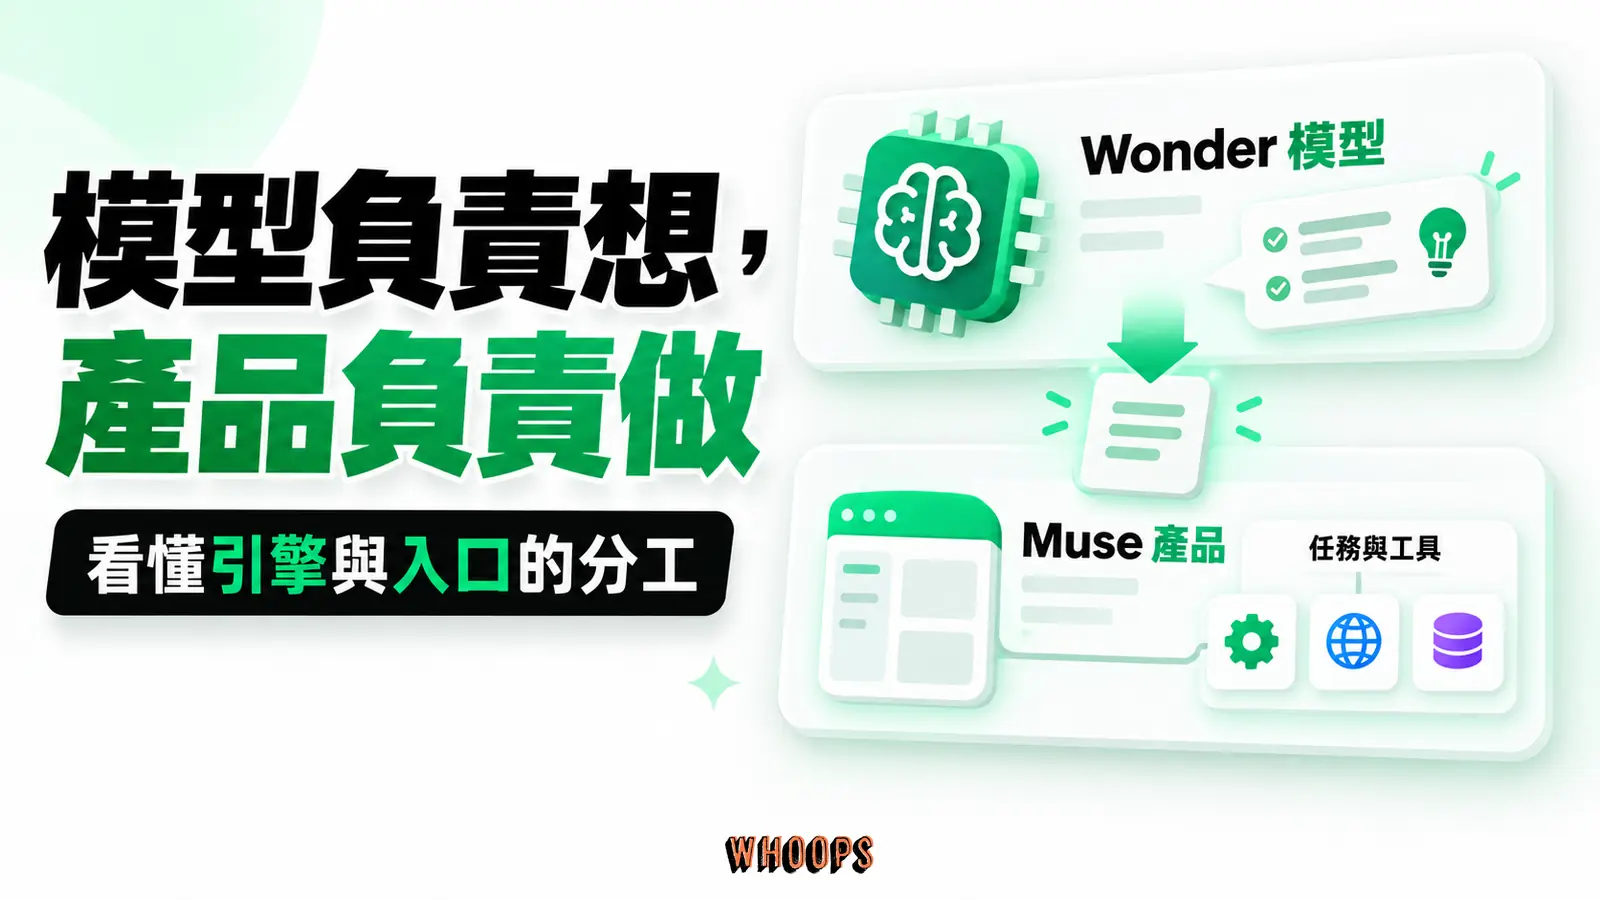
跟九月上市的個人代理 Muse 擺在一起,層次差異是理解整個 Meta AI 佈局的鑰匙。Muse 是產品:App、WhatsApp、網頁那些入口,替你做事的那位助理;Wonder 是模型:產品底下負責思考的引擎。官方公告說得直白,Wonder 建立在 Muse Spark 打下的基礎上,而 Wonder 接下來會驅動更多 Muse 的體驗,訂閱戶先拿到。換句話說,你在 Muse 裡感受到的每一次變聰明,源頭都是這種模型世代的更替,產品的升級節奏從此跟著模型的發布節奏走。Muse 產品本身的功能拆解、方案價格與台灣限制,站上的Muse 完整解析講得很全,這裡不重複;「模型負責想、Secure VM 專屬虛擬機負責做」的那套代理架構,也屬於產品軸的內容,想深入了解的人從那篇接著讀。
戰略面的轉向也值得記一筆,因為它影響的不只 Meta 一家。過去幾年,Meta 以 Llama 系列的開放權重餵大了整個開源模型生態,自架與微調路線因此蓬勃;這一次的 Wonder 世代,官方只字未提權重開放,供應全面收攏到 API 與訂閱。搭配人工智慧實驗室重金整併的背景,解讀起來是一條清晰的路線:開放權重做生態與人才漏斗,前沿閉源做營收與體驗護城河。對使用者的含義很實際,模型市場從「誰都能下載」走向「誰訂閱誰先用」,先進能力的分發權回到平台手上,這也是為什麼這一代的觀察重點,從跑分轉移到了取得管道與計價結構。
兩款模型怎麼分工:Wonder、Wonder Full 與還在架上的 Spark 1.3
同場發布兩款,定位差異要一次分清楚。Muse Wonder 是這一代的汎用前沿款:牌價可負擔、API 直接可得,官方模型頁給它的描述是把前沿編碼、長時程代理與進階電腦操作三者結合,會規劃長任務、把工作派給子代理、出錯後自我恢復。Muse Wonder Full 則是全系列最強變體,官方給它的形容是「迄今最先進的模型」,在代理與編碼基準上登頂,包括獨立第三方執行的 DeepSWE 與 SWE-Marathon;代價是取得管道單一,只有 Muse Code 訂閱一條路,沒有 per-token 牌價可以估算。一句話記住分工:Wonder 走 API 與 Muse Code 廣泛供應,實際可用資格以官方帳號頁為準,Wonder Full 留給願意月付訂閱換最強能力的重度使用者。
前代 Spark 1.3 並沒有下架。dev.meta.ai 的模型清單上,它與 Spark 1.2、Spark 1.1 一起持續販售,輸入牌價 1.25 美元,大約只有 Wonder 的三分之一。這給了務實的開發者一條省錢路徑:代理工作流裡大量低難度、高次數的呼叫留在 Spark 1.3,真正需要長記憶、長專注的難題才升到 Wonder 或 Wonder Full。模型選型從來是分層調度的事情,把最貴的模型留給它真正不可取代的那一段,這個原則在 Wonder 世代只會更重要,因為後面的成本段落會看到,這代的價差比前幾代都陡。
還有一個容易被忽略的解讀細節:兩款模型的公開分數都綁在 max 推理力檔位上。Artificial Analysis 的評測口徑如此,Meta 官方 Model Card 的比較表也是以 max effort 生成結果。這代表帳面分數代表的是這代模型的實力天花板,平常使用時如果你的工作流把推理力設在中低檔位省成本,實際體感會低於榜單數字,拿天花板分數去估算平均成本效益,誤差可能不小。
四大能力拆解:記憶、專注、專業與編碼
官方研究部落格把 Wonder 的能力切成四個軸,每個軸都有對應的評測方式。這四軸也是判斷「自己的工作負載適合與否」最快的檢查表:任務如果落在其中一兩個軸上,升級會有感;四個軸都不沾,總分再高也與你無關。逐軸拆開。
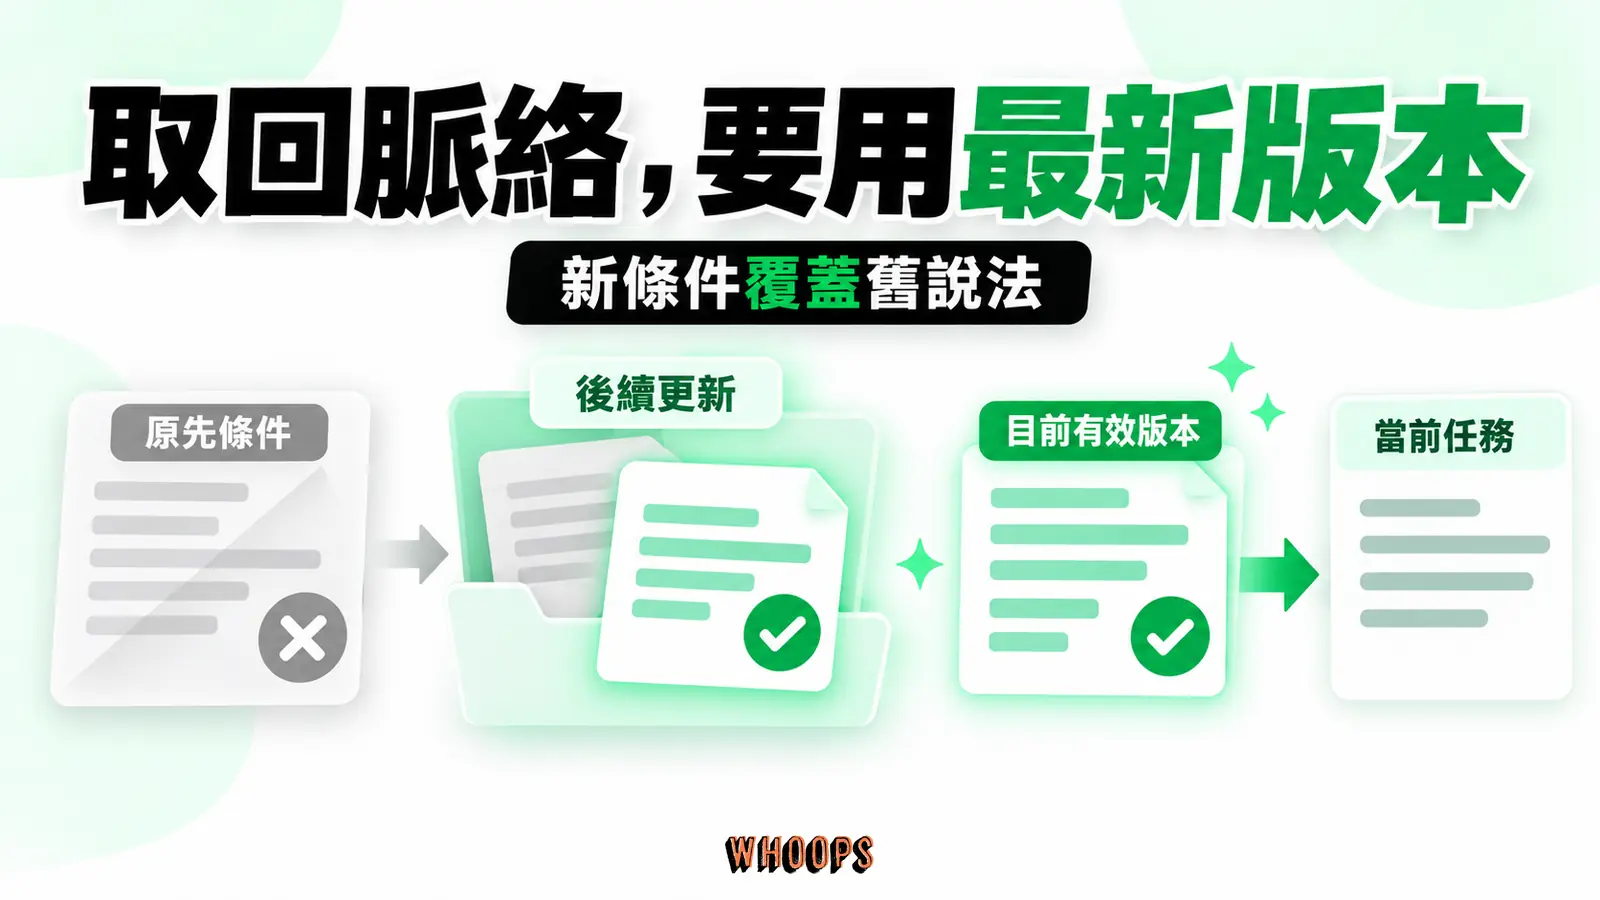
第一軸 Active Memory,主動記憶。官方定義是把與你有關的重要脈絡跨對話保存,並在當前任務需要時主動取回:你的旅遊偏好、工作限制、長期目標,講過一次就記得,不必每次重新自我介紹。評測用的 MemoryBench 值得細看,因為它測的正是記憶最容易壞掉的兩種情境。Model Card 說明,這個內部基準會在 64K 到 100K token 的多輪長對話裡埋入個別事實,同時塞進干擾對話,以及「後來更新、覆蓋先前說法」的注入訊息,再由 LLM 評審依加權評分標準檢查模型找回的到底是不是現在有效的那個版本。記得住舊資訊只是及格線,記得住「哪一版才是最新的」才是代理場景真正要的能力,因為真實助理工作中,需求改口、條件追加、先前結論被推翻,是每天都會發生的事。
第二軸 Active Focus,主動專注。定義是面對有難度的目標持續推進:嘗試替代路徑、消化阻礙、從錯誤中恢復,過程中該問就問,重要的動作前先回來確認。對應的評測一條是測應對阻礙的 FocusBench,一條是測長時程執行的 SWE-Marathon,後者專門考數小時級的軟體工程馬拉松,看模型能不能在超長任務裡維持紀律不脫軌。保險申請、跨平台文件處理這類做到一半一定會卡住的工作,吃的就是這個能力;也是聊天模型與代理模型最本質的分野,聊天可以停,代理停了任務就死在那裡。
第三軸 Domain Expertise,專業領域知識。涵蓋法律、金融與健康三個高門檻領域,模型要能讀原始文件、遵循詳細指示、產出可用的專業工作草稿。對應的基準一個是 Harvey LAB-AA,從案卷文件生成法律工作產品;一個是 Vals Finance Agent V2,評估需要爬梳財報與市場資訊的金融分析師任務。要注意官方的定位是輔助專業工作:產出是草稿與分析,審核權留在人身上,健康領域的內容尤其該帶著這個前提使用,這在後面批判軸還會回到。
第四軸 Frontier Coding,前沿編碼。追蹤需求、跨檔案修改、反覆測試修訂的長時間開發循環,官方說兩款模型都在多樣化的長時程任務上訓練過,以維持整個開發過程的推進力。展示面上,官方放出從客製化圖片生成可遊玩 3D 廚房遊戲的錄影,把視覺理解、程式生成到互動應用一條龍走完;同批展示還有三個更生活化的例子:在瀏覽器裡跨應用整合個人偏好與體能狀況規劃跑步訓練計畫、讀個人 Instagram 照片後設計並實際下訂客製周邊、按一長串複雜配對條件排出婚禮座位表。三個展示的共同點值得注意:它們示範的都是「用你的個人脈絡把一件事做完」,不是問答,這正是 Meta 對個人超級智慧這個詞的具體化。
左右捲動檢視完整表格
| 能力軸 | 官方定義(口語版) | 對應評測 |
|---|---|---|
| Active Memory 主動記憶 | 跨對話保存重要脈絡,依當前任務主動取回最新版本 | MemoryBench(64K-100K 多輪+干擾+事實更新) |
| Active Focus 主動專注 | 卡住換路徑、出錯能恢復、重要行動前先確認 | FocusBench、SWE-Marathon |
| Domain Expertise 專業知識 | 法律、金融、健康文件的解讀與專業草稿 | Harvey LAB-AA、Vals Finance Agent V2 |
| Frontier Coding 前沿編碼 | 跨檔案修改與長時間開發循環的推進 | DeepSWE 1.1、SWE-Marathon、ProgramBench |
四個軸對應到知識工作者與行銷人的日常,可以更具體一點。記憶軸的受益場景是長期專案:經營一個內容頻道,受眾設定、品牌用語、禁用詞、上次檢討的結論,這些背景資訊傳統上每次都要重貼一次提示詞,有主動記憶的模型則是把「這個頻道怎麼做事」累積成可調用的脈絡。專注軸對應的正是行銷人最熟悉的報告生產線:從多個資料來源撈數字、遇到某個儀表板權限不通要繞路、格式對不齊要重跑,這種做到一半一定卡的流程,就是 FocusBench 想量的東西。專業軸對中小企業主尤其有用:供應商合約的條款初步整理、財報的比率計算與異常標記、體檢報告的名詞解釋,都在官方列舉的範圍裡,定位是替你把第一輪粗讀做掉,關鍵判斷仍要回到專業人士。編碼軸看似與非工程師無關,實際上恰恰相反:不寫程式的人用自然語言做出能動的小工具,門檻比任何時候都低,官方那個從一張圖片變出 3D 遊戲的展示,賣點就在這裡。
AA 智慧指數怎麼看:56 分的真實位置
第三方分數是最常被引用、也最容易誤讀的部分,先把口徑釘住。Artificial Analysis 在 2026 年 10 月 12 日的評測文章給出的數字,全部是 Intelligence Index v4.3、max 推理力檔位下的結果:Muse Wonder 52 分、Muse Wonder Full 56 分、前代 Spark 1.3 為 48 分。同一把尺上,Claude Opus 5.5 以 58 分居冠,Gemini 4 Argon 與 GPT-6 Astra 都是 53 分,GPT-6.1 Sol 為 52 分;AA 的模型頁另標 Wonder Full 在 690 個模型裡排第 4。讀這組數字要帶著兩個習慣:其一,分數綁定推理力檔位與模型變體,Opus 5.5 的 58 是 max 搭配預設 fallback 的版本測出來的;其二,AA 的指數版本會演進,模型頁現在顯示的已經是 v4.3.2,不同版本、不同檔位的分數不適合直接互比。拿舊聞裡的數字對新頁面上的數字,常常就差了一個版本,這是站內做 AA 交叉比對一直提醒的慣例。
左右捲動檢視完整表格
| 模型(max 檔位) | AA 智慧指數 | 每任務成本 | 備註 |
|---|---|---|---|
| Claude Opus 5.5 | 58 | 5.98 美元 | 指數冠軍,含 fallback 變體 |
| Muse Wonder Full | 56 | 訂閱制無牌價 | 690 個模型中排第 4 |
| Gemini 4 Argon | 53 | 1.99 美元 | 幻覺率 15% 全場最低 |
| GPT-6 Astra | 53 | 3.26 美元 | 輸出僅 2.7 萬 token,效率最好 |
| GPT-6.1 Sol | 52 | 0.72 美元 | 成本殺手 |
| Muse Wonder | 52 | 4.52 美元 | 輸入用量偏高是成本主因 |
| Muse Spark 1.3 | 48 | 1.60 美元 | 前代,仍在 API 販售 |
單項成績比總分更有資訊量,挑四個有故事的講。進步幅度最大的是 Terminal-Bench 4.0,終端機代理編碼,從 Spark 1.3 的 33% 跳到 Wonder Full 的 57%,與 Gemini 4 Argon 同級,直接翻了近一倍;這也是這代模型「代理能力補課」最直觀的證據,前代最弱的長時程終端操作一次拉到第一集團。知識工作軸的 GDPval-AA v2.1 漲了 176 Elo 到 1857 分排名第二,但 AA 誠實標註這個成績落在 Opus 5.5(1866)與 Sonnet 5.5(1838)的信賴區間內,榜首之爭在統計上還沒分出勝負,這種 Elo 區間重疊的讀法要學起來,很多行銷文案會把區間重疊講成碾壓。GDP.pdf 與 CritPt 兩項以 33% 排第一,科學推理的 SciCode 63% 排第三,十項評測裡有六項站上前三。對開發者更有感的是 AA 的 Coding Agents Index:Wonder Full 在 Muse Code 環境拿 68 分,與 Claude Code with Sonnet 5.5 並列,高於 Opus 5.5 的 66,而前代 Spark 1.3 只有 54,一個產品內換一代模型,編碼代理分數跳 14 分。
這些基準名稱對多數人是黑話,用一組白話翻譯幫助判讀。GDPval 與 GDP.pdf 量的是知識工作:給模型真實的商業與經濟分析題目,看產出品質;AutomationBench 量的是端到端業務流程,Wonder 在這項從 58% 進步到 68%,Wonder Full 到 71% 排第三,翻譯過來就是「多步驟、要呼叫工具的辦公室任務」;Terminal-Bench 量的是在命令列環境裡自己除錯推進;Coding Agents Index 量的是放進真實編碼代理產品後的綜合表現。判斷基準與自身工作的相關性,比記住總分重要得多:如果你的日常是文件與資料處理,看 GDPval 與 AutomationBench 那一組;如果是工程與自動化,Terminal-Bench 與 Coding Agents Index 才是對口的數字。
兩個誠實的但書要跟著分數走。第一個關於幻覺:Wonder Full 的幻覺率從 33% 降到 23%,在 45 分以上的模型裡排第二低,只輸 Gemini 4 Argon 的 15%,Wonder 的 27% 排第三;低幻覺對引用文件、生成報告的場景是實質利多,模型說錯的機率結構性地下降了。第二個關於知識:廣度仍是明顯弱項,AA-Omniscience 知識測驗 Wonder Full 只有 30 分、Wonder 25 分,與 Spark 1.3 同級,落後 Opus 5.5 的 46 分一大截。翻成白話:這代模型很會用你餵給它的資料做事,但腦內百科沒有同步升級,事實性問題的查證紀律不能因為總分高就鬆掉。
成本結構:牌價漲四倍之後,帳要怎麼算
能力上去了,價格也上去了。Wonder 的 API 牌價是每百萬 token 輸入 4 美元、快取輸入 0.20 美元、輸出 20 美元,對比 Spark 1.3 的 1.25/0.15/4.25 美元,輸入漲 3.2 倍、輸出漲 4.7 倍。放在市場裡看,這組牌價與 Claude Opus 5.5 完全相同,是 Sonnet 5.5、Gemini 4 Argon、GPT-6.1 Sol(2/10 美元)的兩倍,比 GPT-6 Astra 與 Claude Fable 5.1(10/50 美元)低 60%。貴或便宜取決於跟誰比:對標 Opus 是打平,對標 Google 是兩倍,這個錨點先設好,後面的帳才不會算歪。
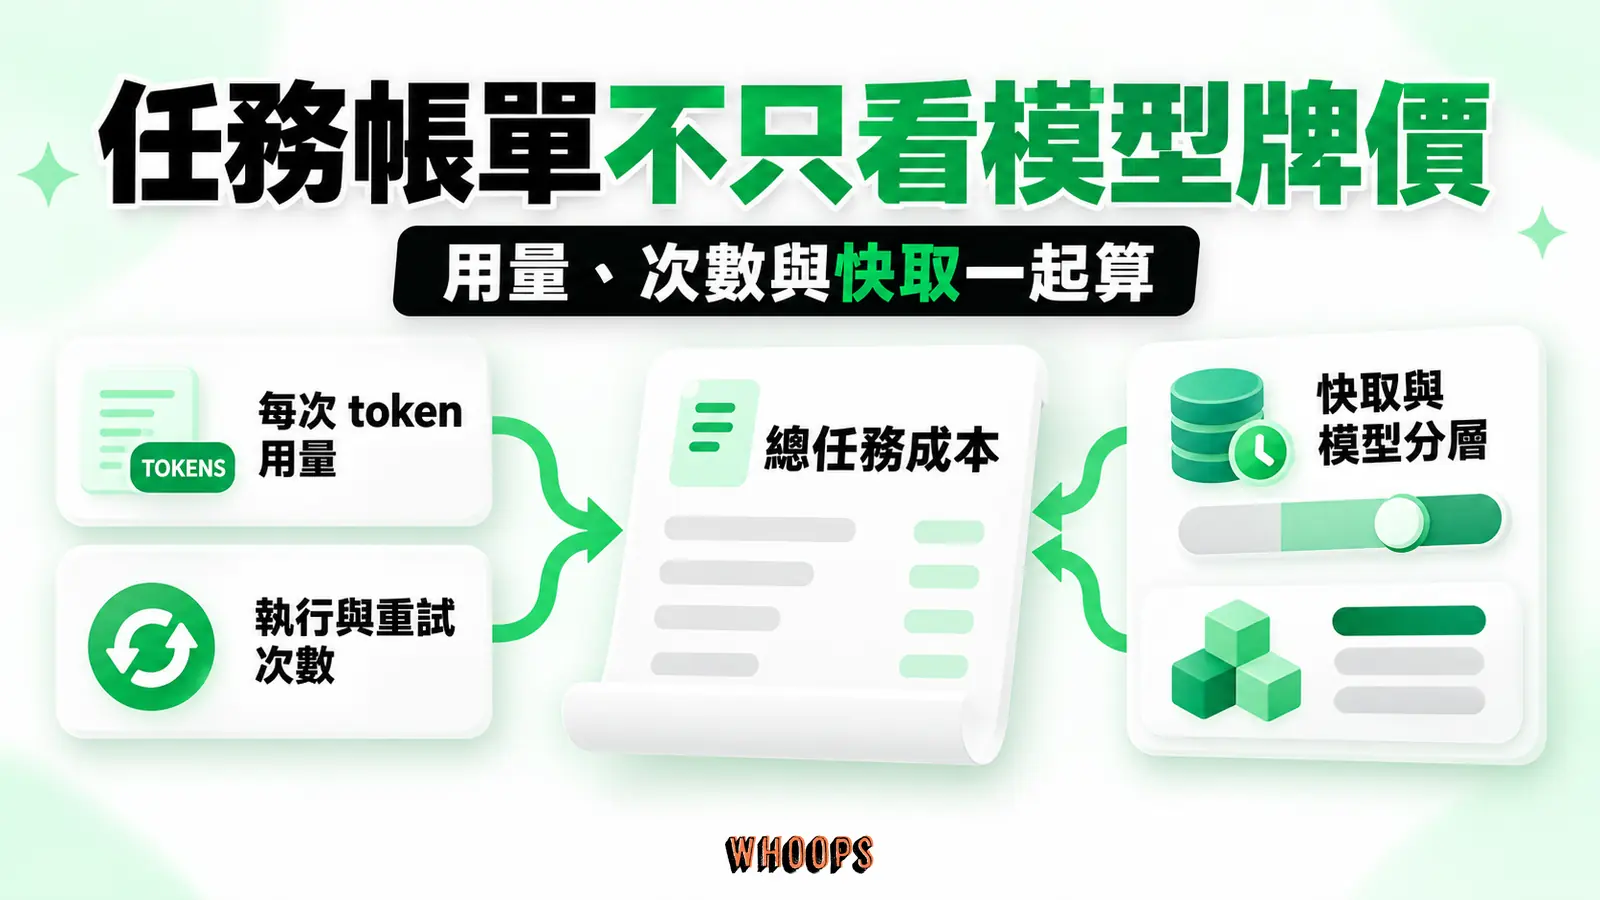
真正影響帳單的是 token 用量結構。AA 量出來,Wonder 每個指數任務吃 769 萬輸入 token,比 Spark 1.3 的 603 萬多 28%,輸入成本占每任務成本的 76%;輸出倒是收斂了,約 5.4 萬 token,比前代少 10%。兩相加總,Wonder 每任務成本 4.52 美元,是 Spark 1.3(1.60 美元)的 2.8 倍。對照組拉出來:Opus 5.5 每任務 5.98 美元、Fable 5.1 為 7.63、Astra 3.26、Argon 1.99、Sol 0.72。「Wonder 比 Opus 便宜」與「Wonder 比自家前代貴快三倍」兩句話同時成立,採購前要想清楚自己的比較基準是哪一個;換代的成本衝擊,往往藏在這種同牌橫向比較的盲點裡。
工程上有兩個省錢槓桿可用。第一個是快取:Wonder 的快取輸入牌價只要 0.20 美元,AA 的成本拆解顯示,Wonder 每任務的輸入成本裡有 1.92 美元是快取寫入、1.44 美元是快取命中,真正未快取的輸入只花 0.07 美元。代理工作流裡,系統提示、工具定義、知識庫文件這類每次都會重複送進去的固定前綴,做好快取策略後成本結構會完全不同,這也是為什麼官方把快取輸入價壓到正價的二十分之一。第二個是分層:把 Spark 1.3 留在批次與簡單呼叫上,Wonder 只接難任務,原則前面講過,這裡補一個算術:每 100 萬輸入 token,留在 Spark 1.3 就比走 Wonder 省 2.75 美元,總節省再乘上實際輸入量,量大之後非常可觀。至於 Wonder Full,它沒有 per-token 價格,成本就是訂閱費本身,每月 50 或 200 美元,划不划算取決於你的用量強度能不能把額度吃滿,這種定價結構下,重度使用者受益、輕度使用者吃虧,是訂閱制的標準邏輯。
拉一個月的帳試算給你看量級。假設一個小型工作流每天跑 10 個長文件分析任務,每個任務的用量結構接近 AA 量到的水準(輸入 769 萬 token、輸出 5.4 萬 token),全走 Wonder 的月成本大約是 4.52 美元乘上 300 個任務,落在 1,350 美元上下;同樣的量若一半能落到 Spark 1.3(每任務約 1.60 美元),月成本降到 920 美元左右,一個月省下超過四百美元。這個試算的用途不在精確,而在提醒兩件事:第一,代理工作流的成本是由任務次數乘上單任務用量決定的,模型牌價只是三個變數之一;第二,分層調度與快取策略對帳單的影響,可以比等一個月的新模型發布更大。實際導入前,先用一週的真實流量算出自己的單任務成本,再拿 AA 的數字當交叉驗證,誤差通常會比想像大,因為每個工作流的提示詞長度與工具回傳量差很多。
開放地圖:API、Muse Code,與還沒到的 Muse App
取得管道照官方口徑整理成三層。第一層是 Meta Model API:自助、直售,官方快速上手文件明說可以把現有 OpenAI SDK 相容的用戶端直接指過來,第一個請求五分鐘內能通;模型清單上也列了 OpenRouter 作為接入選項,已經在其他工具鏈裡用 OpenRouter 的團隊,把 Wonder 排進現有工作流的改動量很小。官方還配了一批現成的模式文件,從多代理協作、子代理扇出到電腦操作、GitHub 自動化機器人與搜尋接地,代理工作流的主流骨架都有範例可抄。
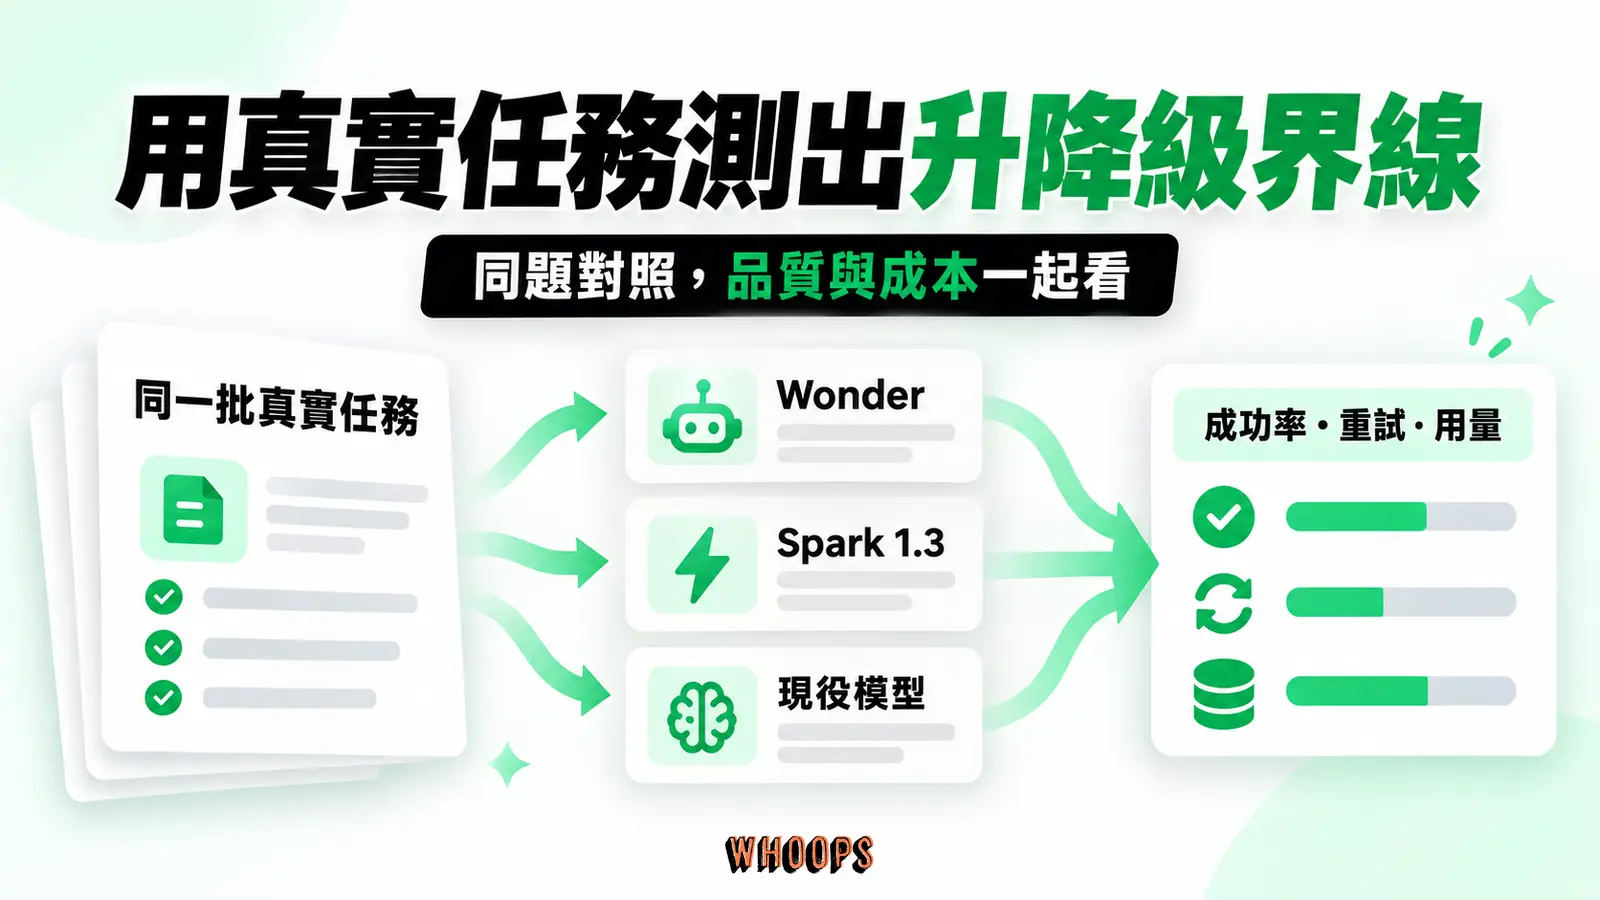
開發者的起手式可以照一個順序走,省掉亂槍打鳥的時間。第一步先跑通最小請求:把現有 OpenAI 相容用戶端的端點與模型代號換成 muse-wonder-1.0,確認計費與帳號狀態正常。第二步做快取前綴實驗:把系統提示與工具定義固定下來送兩輪,對照有無快取的帳單差異,這個差異會主導你最終的架構決策。第三步丟真實任務做三向對照:同一批任務給 Wonder、Spark 1.3 與現役主力各跑一輪,記錄成功率、重試次數與 token 消耗,三個指標一起看;單看成功率會漏掉成本,單看成本會漏掉品質。第四步才考慮把它接進常駐流程,而且初期保留隨時退回前代的開關,新模型上線頭幾週的行為差異,往往要在真實流量裡才會現形。
第二層是 Muse Code,Meta 自家的終端機多代理編碼產品,官方定位就寫著由 Muse Wonder 與 Wonder Full 驅動。訂閱分級裡,Wonder Full 從 Power Usage(每月 50 美元)起可用,這一級的用量是最低階 Everyday 方案的 20 倍;Maximum Usage(每月 200 美元)到 80 倍。做個對照,終端機編碼代理在 2026 年已經是紅海,Cursor 與 Claude Code 都在同一個賽道上,Muse Code 的差異化籌碼是背後直接掛著 Meta 自家模型梯隊,模型與工具的耦合比第三方接 API 來得深,Coding Agents Index 那個 68 分就是在 Muse Code 環境裡量出來的。
第三層是一般使用者的 Muse App,這層現在的狀態是已宣布、未兌現。官方說法是 Wonder 即將驅動更多 Muse 的體驗,訂閱戶優先,也會用於互動成果的生成與需要更高推理力的流程,未來還會以 Wonder 為基底發展專用模型,讓不同類型的代理任務交給更合適的模型處理;時間表沒有給。對照 Muse 產品九月才在美國上線、目前限美加,一般使用者的等待期要拉得更長。這裡的決策含義值得點出來:訂閱 Muse 的人形同買了 Wonder 世代的前排座位,官方把模型紅利先發給付費用戶的策略已經寫在公告裡,「要不要等模型進場再訂」這個問題的答案,從單純的產品喜好變成了模型時程的判斷。
台灣的可用性現實分兩條線講。產品線:Muse App 尚未開放台灣,官方沒有公布任何區域擴張時程,這與九月以來的狀態一致,Wonder 何時隨產品進來自然也無從談起;想理解 Meta 的 AI 服務在台灣目前摸得到的部分,Threads 上的 @meta.ai 是離一般人最近的一角,標記召喚、私訊問答都做得到,但它與 Muse、與 Wonder 是不同層的服務,能力差距很大。開發者線:Meta Model API 已上線,台灣開發者能否註冊、付費與使用,以 dev.meta.ai 帳號頁當天顯示為準,本文不做超越官方頁面的承諾;對台灣的工程團隊來說,先在 API 層累積 Wonder 的實測經驗,等產品線開放時轉移成本最低,這是最務實的路徑。
批判軸:分數之外的四個檢查點
只抄官方新聞稿的文章對讀者沒有幫助,這段把四個必須帶著的檢查點攤開,每個都附上你可以在哪裡自己驗證。
檢查點一,benchmaxxing 質疑。發布當天社群就出現尖銳批評:BridgeMind 在 Reddit 的實測宣稱「從未見過如此明顯針對基準測試優化的模型」,附的證據是模型在特定視覺建構測試裡交出與榜單嚴重不符的成品;Hacker News 的討論串裡也有開發者直言 Wonder 沒比 Spark 1.3 好多少,而且最想驗證的 Wonder Full 因為綁訂閱根本測不到。Meta 這次沒有閃躲,研究部落格直接用 benchmaxxing 與 big model smell 這兩個社群詞開了一節,提出目標內任務對目標外任務的分析,主張 Wonder Full 在訓練未針對的任務上表現高於 Spark 1.3 趨勢線的預測,並歸因於更強的基座模型。官方反證與社群質疑可以同時成立,實務結論只有一條:用自己的真實任務抽測,別只看榜單,尤其當你的工作負載剛好落在訓練熱區外圍的時候。Model Card 裡的 ExploitGym 細節順手印證了計分方法論的影響:模型總共捕獲 92 面 flag,官方複核(GPT-cyber 驗證器加 Gemini 3.1 Pro 獨立確認)後只有 21 面走預定漏洞、71 面走非預定路徑,而公開排行只採計前者。同一個模型,計分口徑不同,名次可以差好幾倍,這個例子拿來理解所有基準爭議都適用。
檢查點二,成本與額度。API 端的漲幅前面算過了,2.8 倍的每任務成本是第三方量出來的事實;訂閱端,社群早期回饋集中在用量限制與額度消耗速度上,Reddit 討論串裡有人抱怨 Wonder Full 的用量上限給得摳。這類說法屬於發布初期的個別經驗,還沒有系統性驗證,但方向與 AA 量到的輸入用量偏高一致,不是空穴來風;重度使用者第一個月盯緊用量儀表板,把高消耗的任務類型標記出來,是必要的自保動作。
檢查點三,知識廣度。Omniscience 30 分的弱項前面提過,這裡補使用層的翻譯:低幻覺率加上窄知識面,意味著模型對你餵給它的資料很忠實,但對它自己以為知道的常識會出錯,而且出錯時口氣篤定。文件摘要、依資料推理、草稿生成是這代的安全區;開放性知識問答、冷門事實、跨領域常識,查證習慣不能省。挑模型的時候,先想清楚自己的任務是「餵資料給它處理」還是「問它腦內的東西」,前者 Wonder 是利多,後者 Opus 5.5 的 46 分知識面仍是更穩的選擇。
檢查點四,非開源。AA 模型頁對 Wonder 系列的權重標註是 Not available,Meta 也沒有宣布任何開放時程。從 Llama 時代以開放權重推進整個產業聞名的 Meta,到如今最強模型只經 API 與訂閱供應,這個轉向對依賴自架、微調、資料不出門的團隊是實質限制:想拿 Wonder 做本地客製化,現階段沒有路。安全框架倒是把該公開的公開了:Model Card 依 Meta Superintelligence Scaling Framework 交代,未緩解前不排除化學生物領域觸及高風險門檻,因此部署時加上安全後訓練與系統級分類器,最終所有領域的殘餘風險評為中度或以下,內部治理流程審查過才上線。對照官方同時宣稱保留防禦性網安能力(CyberGym 88.4%、ExploitBench 58.9% 的成績就是量這個),安全敘事算是給得完整,但權重不開放這件事本身,就是評估供應商鎖定風險時最重要的一格。
與其他前沿模型、代理產品的相對位置
把 Wonder 放回選型地圖,三組對比給結論。跟 Claude Opus 5.5 比:Wonder Full 的分數 56 對 58、知識廣度 30 對 46,帳面都還差一口氣;但換 API 可得的 Muse Wonder 上場,52 分配上每任務 4.52 美元的成本,對上 Opus 的 58 分與 5.98 美元,代理與編碼任務比重高的工作流就有對照測試的價值,已經深植 Claude 生態的團隊不必立刻遷移,Opus 的知識面與工具生態仍是天花板,Opus 5.5 的定位與切換時機站上有專文可對照。跟 GPT-6 Astra 比:分數 56 對 53,Wonder 帳面領先,但 Astra 每任務 3.26 美元、輸出只用 2.7 萬 token,效率紀律好得多,任務量大、單任務難度中等的場景 Astra 的總成本可能反而低,GPT-6 世代的實力與方案同樣有專文。跟 Gemini 陣營比:Gemini 4 Argon 53 分、每任務 1.99 美元、幻覺率 15% 全場最低,成本敏感的知識工作首選;要留意 Google 體系裡同名的 Gemini Spark 是代理產品,與 Wonder 這個模型層不同軸,拿它們直接比是常見的範疇錯置。
代理產品的地圖也要分層看。Wonder 是模型,Muse、Grok Bot、ChatGPT Dots 是產品,而模型會流動:Wonder 要進 Muse,Grok Bot 那邊官方也預告過未來會依任務屬性調度後端模型,等於各家代理產品的體驗差距會隨模型換代重新洗牌。2026 年下半年三家常駐代理先後到位,選擇的第一軸從來是入口生態與資格門檻,誰先在你的地區開放、誰的訂閱你本來就付著、誰連得上你用的工具;常駐代理的橫向比較把 Dots、Muse、Grok Bot 的分界整理在同一張表裡,Dots 的交辦實戰與 Grok Bot 的訂閱改制各有專文。模型世代的競爭反而可以慢慢看:六週一代的節奏下,今天的落後者很可能就是六週後的領先者,綁死單一模型供應商的操作,在這個市場裡風險越來越高。
誰該現在行動,誰該再等一輪
三種人現在就有事可做。第一種,正在打造代理或編碼工作流的開發者:API 的最低測試門檻低到可以忽略,把真實任務丟給 Wonder、Spark 1.3 與你現役的主力模型做三向對照,一週內就會知道升降級的界線畫在哪裡,重點測長時程與文件密集任務,那是這代進步最大的地方。第二種,已經在評估 Muse 訂閱的人:Wonder 進 Muse 是訂閱戶優先,這個官方策略已經明確,訂閱時點的取捨可以開始算了,台灣用戶的變數是產品端還沒開放,時間軸比別的市場長。第三種,團隊的技術決策者:把 Wonder 加進模型的觀察清單與季度評測排程,終端代理、知識工作與自動化流程基準是這代最明顯的進步,文件密集的專業工作流最可能先受益。
兩種人可以再等。預算緊、任務輕的使用者,Spark 1.3 還在架上且便宜得多,輕量任務用它綽綽有餘,Wonder 未來會不會降價、前代何時調整,等官方頁面更新再評估也不遲。需要開源權重、本地部署、深度客製的團隊,官方沒有給任何開放承諾,等下去沒有時間表,把力氣放在現有開源梯隊與自有工具鏈上更實際。前沿模型市場六週一代,今天的 56 分很快就會變成歷史表格裡的一列數字;但主動記憶與主動專注成為一等公民、代理基準成為主戰場、模型紅利先發給訂閱戶,這三個方向訊號才是 Wonder 世代真正值得記下來的東西,後續每一代的評估框架,都會從這裡長出來。
往後追蹤這條線,四個訊號比任何新聞標題都值得盯。訊號一,Wonder 進 Muse App 的實際時間與分批範圍,那是模型能力變成一般使用者體驗的時刻,也是訂閱價值兌現的時刻。訊號二,AA 下一個指數版本對這批模型的覆測結果,Wonder Full 與 Opus 5.5 之間那兩分的差距,在不同版本下可能放大也可能翻轉。訊號三,Meta 是否改口開放權重,這一格決定自架與微調生態能不能回頭擁抱這個系列。訊號四,Spark 1.3 的去留與牌價,它是整個分層調度策略的基石,前代何時下架或降價,直接改寫所有工作流的成本試算。把這四格填上日期,你對 Meta 模型線的理解就會一直保持在最新狀態,而不會被下一次發布會的新名詞牽著走。