Gemini 4 Argon 是什麼?跑分查證、API 價格與開放時程
Gemini 4 Argon 是 Google 2026 年 9 月 30 日發表的旗艦模型,本文以官方公告與獨立評測查證定位、跑分、幻覺率 15%、首發價與 Fairwind 優先的開放條件。
本頁目錄
- Gemini 4 Argon 是什麼:七個月空窗後的世代跳級
- 定位:給長時程工作流的旗艦模型
- 世代座標:從 3.1 Pro 到 Argon 之間發生了什麼
- Gemini 3.5 Pro 去哪了:一段需要小心引用的歷史
- 一百萬輸出 token 在實務上意味什麼
- 官方跑分怎麼讀:先分清誰測的、測什麼
- 兩種數字要分開讀
- 官方成績單:軟體工程與企業知識工作
- 內部實績:三個可以把規格翻成場景的案例
- 獨立榜單:53 分追平 Astra,但要把代價一起讀
- Intelligence Index 的分數與它的測量條件
- 幻覺率 15% 的確切意義,與它換掉了什麼
- 每任務 1.99 美元怎麼算出來的
- API 價格拆解:三組費率、兩個時間點、一個還沒上架的定價頁
- 首發價、正式價與查證現況
- 兩個算例:標準請求與快取命中
- 方案入口:現在誰用得到,接下來換誰
- Fairwind:用治理換早期存取
- 台灣現在碰得到嗎:三個入口的現況
- agent 安全機制:四道防線與一個雙軌設計
- 誰該等 Argon,誰該留在 Astra 或 Opus 5.5
Gemini 4 Argon 是 Google 在 2026 年 9 月 30 日發表的旗艦模型,官方定位寫得具體:真實世界的軟體工程、法律與金融這類企業知識工作,以及資安防禦,而且強調它能撐完整段長時間、多步驟的工作流程。它有一個會直接影響你有沒有興趣的現實條件:截至 2026 年 10 月 9 日,一般用戶還用不到。首波只開放給 Fairwind 計畫裡經過審核的資安團隊,官方說後續開放的起點是付費 API 用戶與 Google AI Ultra 訂閱者,兩者先後未定,也沒有給出任何日期。
重點先看
Gemini 4 Argon 於 2026 年 9 月 30 日發表,是 Google 七個多月來第一個 Flash 級以上的自研模型;上一個非 Flash 旗艦是 Gemini 3.1 Pro Preview。
獨立評測機構 Artificial Analysis 給它 53 分,與 GPT-6 Astra 平手;幻覺率 15% 是同分群模型中最低,但答案準確率 50% 低於 Astra 的 63%,少猜錯與答得準是兩件不同的事。
API 首發價是每百萬輸入 2 美元、輸出 10 美元,快取輸入打 95% 折扣;首發期結束後改為 4 與 20 美元,結束日期官方尚未公布。
開放順序:Fairwind 資安計畫優先;後續開放的起點是付費 API 用戶與 Google AI Ultra 訂閱者,兩者的先後與日期都未公布;10 月 9 日查證時,官方 API 定價頁還沒列出 Argon。
現在就能做的動作:把一組固定任務與 token 記帳方式準備好,等付費 API 開放當天,就能算出自己工作流的每任務成本。
費用骨架先記三組數字。首發價是每百萬輸入 token 2 美元、輸出 10 美元,快取輸入是輸入價的 5%,等於每百萬 0.10 美元;公告腳註寫明首發期結束後調為輸入 4 美元、輸出 20 美元。對照兩家對手的牌價,這個定價有一個清楚的位置:首發價與 OpenAI 的 GPT-6 Sol(牌價每百萬輸入 2 美元、輸出 10 美元)完全同價,正式價與 Anthropic 的 Claude Opus 5.5 完全同價。Artificial Analysis 的算法更進一步:折扣期間 Argon 每項評測任務的成本是 1.99 美元,約為 GPT-6 Astra 的六成。
這篇解析做四件事:把 Argon 放回 Gemini 世代更新的時間軸,說明 Google 的旗艦路線這半年發生了什麼;把官方跑分與獨立榜單分成兩組解讀,特別是「幻覺率 15%」這個數字到底量到什麼;拆解 API 費率與三種取得入口;整理 agent 安全機制,並給出與 GPT-6 Astra、Claude Opus 5.5 的選擇判準。查證基礎先交代:事實以 Google 官方發布公告、Fairwind 計畫頁、Gemini API 定價頁與 Artificial Analysis 的評測為本,查證時間為 2026 年 10 月 9 日;站上沒有 Argon 的實機測試紀錄,所有評測數字的出處與測量條件都會寫清楚,付費或導入前請以官方頁面當天顯示的內容為準。
Gemini 4 Argon 是什麼:七個月空窗後的世代跳級
定位:給長時程工作流的旗艦模型
官方在2026 年 9 月 30 日的發布公告裡,給 Argon 的定位是「真實世界軟體工程、法律與金融等企業知識工作、以及資安防禦」的前沿模型,公告署名者是 Google DeepMind 的 SVP 兼 Google 首席 AI 架構師 Koray Kavukcuoglu。另一句更關鍵的描述是長時程工作流:模型要能持續進行深度推理,把讀資料、操作工具、寫程式、驗證結果串成同一條執行軌跡,目標情境是長時間、多步驟的工作,不是一問一答的聊天。
公告也寫明 Argon 已經在 Google 內部上線,工程師把它用在從日常除錯到大規模程式碼搬遷與演算法設計的日常工作上。廠商說模型「根本改變了我們工作的方式」這類宣傳語要打折聽,但內部先行再對外發布這個順序本身是事實,後文的內部實績會給你具體案例自己判斷。
查資料時先記一個小陷阱:Argon 是化學元素氬的英文拼法,也是幾個無關產品的名稱,單獨搜尋這個詞會混進大量噪音。用全名 Gemini 4 Argon 當查詢詞,再把來源限定在 Google 官方網域、Artificial Analysis 這類獨立評測機構與主流科技媒體,噪音會少一大半。中文資料目前還很稀薄,多數第一手內容是英文的,本篇的引文與數字都標了出處,方便你回頭核對原文。
如果你需要先補齊 Gemini 家族的背景,Gemini 3 完整指南把上一代的模型分工、入口與方案講得很全;Argon 的定位繼承那套「知識工作與生態整合」的路線,再把長時程與資安兩個屬性拉到最前面。
世代座標:從 3.1 Pro 到 Argon 之間發生了什麼
Artificial Analysis 在發布當天的評測裡給了一個精確的座標:Argon 是 Google 七個多月來第一個 Flash 級以上的自研模型,上一個非 Flash 旗艦是 Gemini 3.1 Pro Preview。中間這段時間,Google 的能見度由 3.8 Flash 家族撐著,包括後文會提到的資安特化版 3.8 Flash Cyber。換句話說,GPT-6 Astra 在九月發表、Claude Opus 5.5 同月接棒的這段期間,Google 一直沒有對位的旗艦產品,Argon 補的就是這個空位。
管理層的變動讓這次發表多了被檢視的理由。CNBC 在 10 月 2 日的分析回顧:Demis Hassabis 八月卸任 DeepMind 執行長後,接手的 Koray Kavukcuoglu 背負的是一場追趕,2026 年大半年的前沿進展由 OpenAI 與 Anthropic 輪流推動,Argon 是新領導層的第一張成績單。同篇報導裡兩位產業分析師的評語值得記住:Futurum Group 的 Nick Patience 判斷 Argon 讓 Google「重新有競爭力」,但還談不上領先;IDC 的 Tim Law 則把強項指向法律推理、金融與企業知識工作的長時間任務。
把「追平」和「領先」分開,是讀這一代模型所有報導的基本功,後面的榜單段會用具體數字回到這件事。
Gemini 3.5 Pro 去哪了:一段需要小心引用的歷史
網路上流傳的整理文常直接寫「Gemini 3.5 Pro 已取消」,這句話的證據結構值得攤開。時間軸是這樣:第三方報導指出 3.5 Pro 原定 2026 年 6 月全面供應,六月下旬第三方報導指出它仍停留在有限的 Vertex AI 預覽階段;七月有分析認為卡在 token 效率與推理表現未達標;進入九月後,開始出現「資源轉向 Gemini 4」的說法。但截至目前,Google 官方從未發布任何取消公告,第三方彙整到的官方說法是模型仍與夥伴測試中、準備好就會廣泛提供,沒有日期。
本站 10 月 9 日核對 Gemini API 定價頁的結果可以補上官方側的間接證據:定價頁目前最高階的 Pro 級模型是 3.1 Pro Preview,往上是 3.8 Flash 家族,3.5 Pro 從未出現在任何一版定價頁上。對採購與技術選型的實際含義是:模型路線圖隨時會改,合約與時程別綁在特定版本號上;引用「已取消」三個字時,註明這是第三方報導的推論,官方立場是沉默。
一百萬輸出 token 在實務上意味什麼
Argon 最有記憶點的規格是輸出上限:從前代的 64K 提高到 100 萬 token,官方稱居業界領先水準。輸入端的 context window 同樣是 100 萬 token。數字本身好記,實務意義要展開:輸出上限決定模型能在單一執行軌跡裡「想多長、寫多長」,對要連續產出推理過程、工具呼叫紀錄與長段程式碼的 agent 任務,更大的輸出空間代表任務被迫中斷、拆成多個回合再拼接的情況會變少。
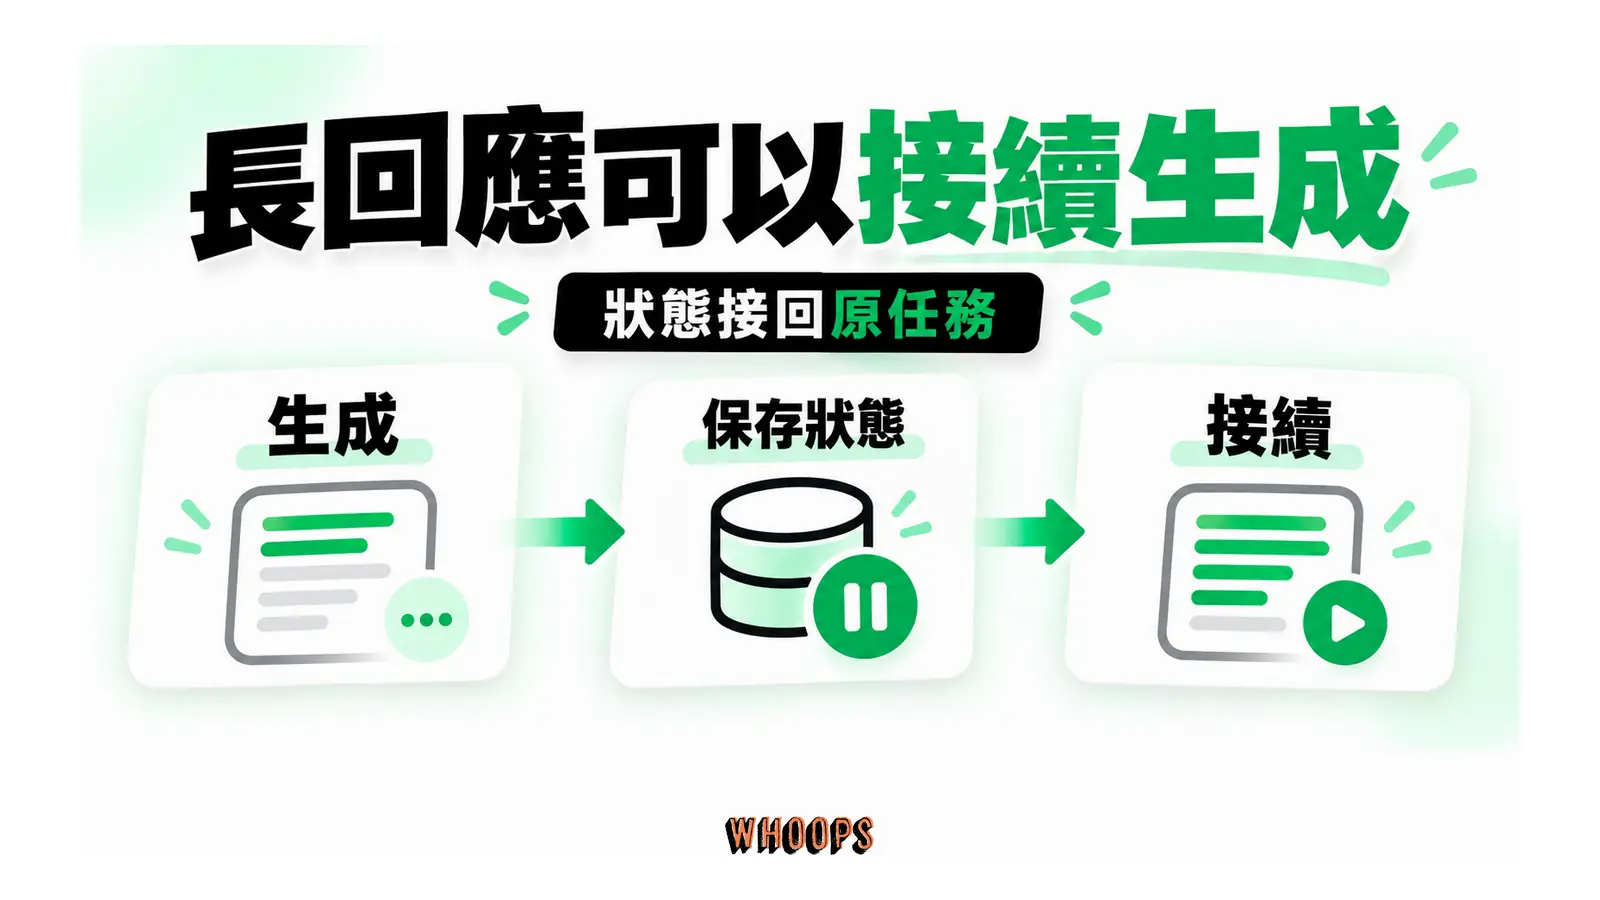
要真的把百萬輸出用滿,還需要一個工程配套。Artificial Analysis 實測時用上 Google 的新 API 功能 Long Decode Continuation:長回應會暫停並保存狀態,由後續呼叫接著生成,讓推理跑到百萬輸出而不觸發請求逾時。這個功能對要設計長任務架構的團隊是新的基礎元件,串接細節以官方文件為準。
冷靜的另一半也要講:輸出 token 是按量表費的項目,而 Argon 的平均輸出量並不小,Artificial Analysis 量到它在評測任務上平均每題輸出 62K token,是 GPT-6 Astra 的 27K 的兩倍多。上限拉高是能力,帳單會誠實反映你用掉多少,費用段的算例會把這件事算給你看。
官方跑分怎麼讀:先分清誰測的、測什麼
兩種數字要分開讀
關於 Argon 的能力,現在流通兩組數字。一組出自 Google 官方公告,測量條件由 Google 自己設定,比較對手由 Google 自己挑選;另一組出自獨立評測機構 Artificial Analysis,用同一套評測流程跑所有模型,可以跨模型比較,但樣本與加權是它自己定的。兩組都有引用價值,混在一起就會出現同一個模型一下領先一下落後的矛盾。讀任何一個分數前先問三個問題:測的是什麼任務、誰測的、什麼時候測的。
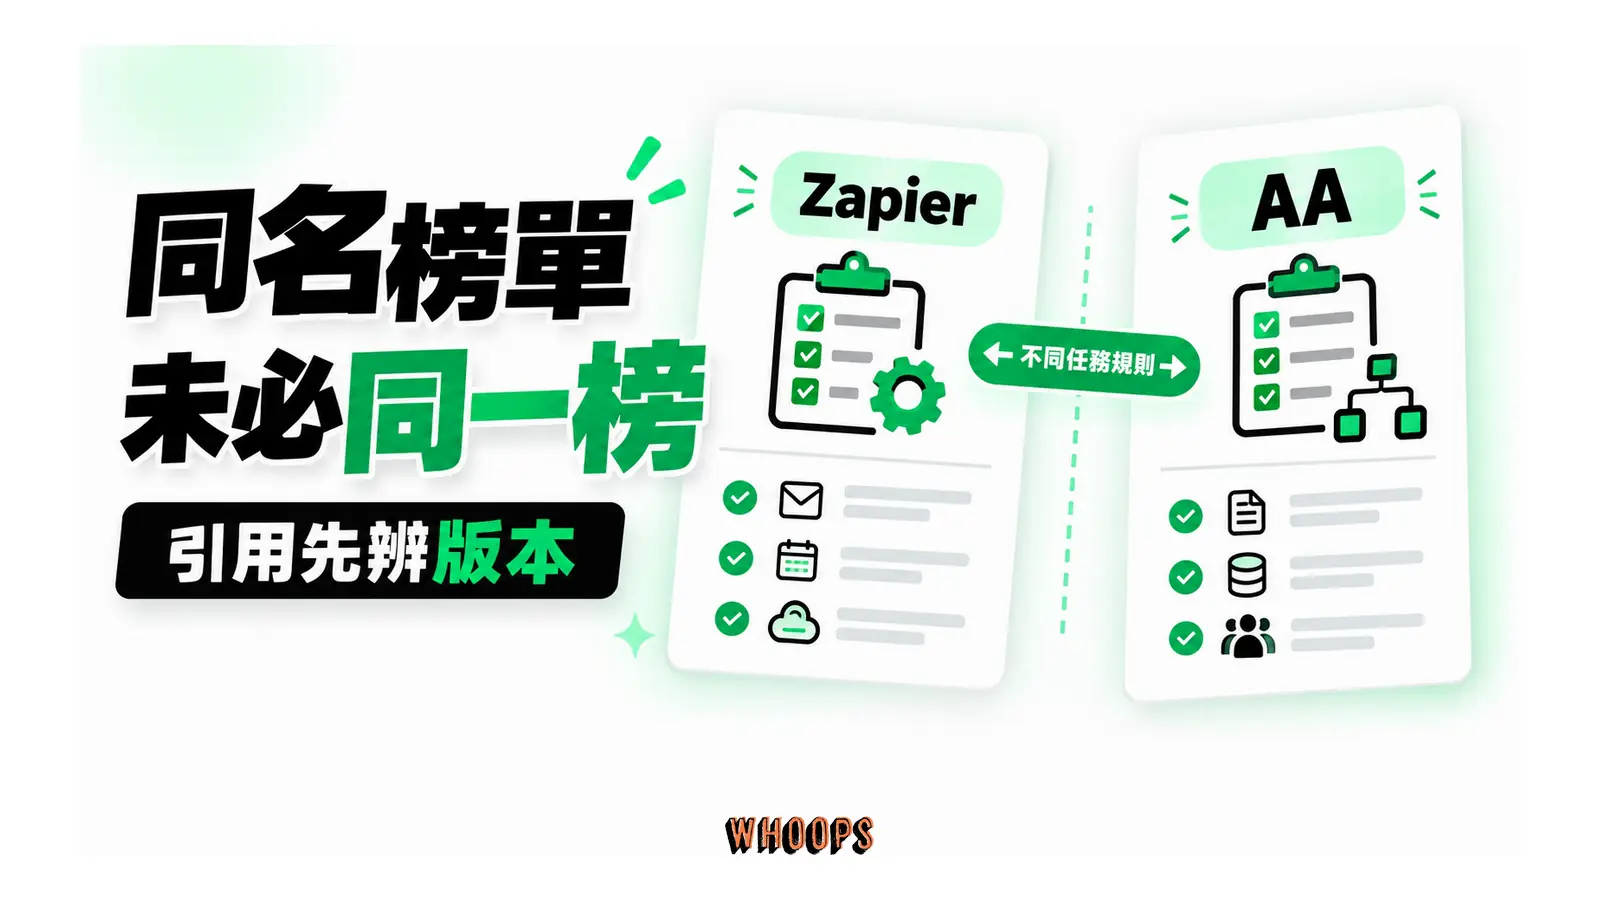
還有一個容易忽略的陷阱:名字相近的榜單未必是同一張榜。Argon 在兩個 AutomationBench 上都有成績,一個是 Zapier 維護的版本,一個是 Artificial Analysis 自己的 AA 版本,數字差了超過 25 個百分點,兩者都對,引用時標清楚就好。
引用任何發布期的數字,建議固定做三步檢查:先開當下的官方頁面確認數字還在,再找一個獨立來源交叉比對,把查核日期一併寫進自己的筆記。這個習慣其來有自,上一個旗艦模型 GPT-6 Astra 發布時,官方公告的多項評測數字曾在上線後數小時內被修改,首日轉述與隔週整理文出現不同分數的狀況反覆發生。榜單的角色是入圍名單,把你自己的任務集當決賽,模型在你領域的表現才會現形。
官方成績單:軟體工程與企業知識工作
軟體工程是主打戰場。DeepSWE v1.1 衡量真實世界的長時程工程任務,官方給 Argon 的成績是 77.9%,並稱這締造了該基準的新紀錄。這個分數的任務通過定義與失敗分布,要等基準文件或獨立複測才能確認,引用時保留這層不確定性。
企業知識工作這一側的證據更分散但方向一致。官方稱 Argon 在 Vals Index 領先,這個指標按美國 GDP 權重加總金融、程式、法律與稅務工作的經濟影響;同系列的 Vals Finance Agent v2(多步驟金融研究)與 Harvey 的法律代理基準,官方都宣稱領先。自動化整體表現上,Zapier 的 AutomationBench 量端到端商業流程執行,Argon 以 51.3% 排第一。這幾項都是官方自報數字,獨立複測要等模型廣泛開放後才會有。
多模態理解有一個突出的數字:長影片理解基準 LVBench 上 91.7%,官方稱這創下該基準的新紀錄。官方同時列出圖表分析、從長影片辨認細節、依多份文件採取行動三種工作情境,對要把大量視聽素材納入研究流程的團隊,這是比聊天分數更實用的能力項。
內部實績:三個可以把規格翻成場景的案例
公告裡最值得細讀的是三個內部案例,因為它們展示了 Google 認為這類模型該部署在哪裡。第一個在量子運算研究:研究人員用 Argon 優化量子演算法子程式的時空資源,也就是 qubit 數與閘數的乘積,其中一個案例在幾分鐘內把公開發表的最佳基線再改進 40%。
第二個在資料中心維運:一組 Argon 代理分析整個機群的遙測資料,自動找出並套用記憶體優化,實際釋出超過 300 TiB 記憶體,官方估計全部部署後的總節省在 500 TiB 到 1 PiB 之間。第三個在程式碼搬遷:Argon 代理負責把 C 與 C++ 程式碼庫改寫成 Rust,規模從 re2、libgav1 這類核心函式庫的數萬行,到 Fuchsia Zircon 作業系統核心的 80 萬行以上。libgav1 的細節最完整:代理讀過一個既有的 Rust 移植版後,用多輪效能導向實驗置換其中 3.2 萬行 SIMD 程式碼,產生編譯器能自動向量化的安全 Rust,最終解碼器比原 Rust 版快 2.7 倍,影片輸出完全一致。
這三個案例都是 Google 自報的單點成果,不是可外推的平均值,而且官方也講明這類大規模改寫都要經過自動與人工審計、模擬測試和審查後才會進入生產環境。對一般企業的啟示不在數字本身,而在工作形態:模型的角色是「長時間跑著的工程協作者,產出必須過審計這一關」,這個形態正是長時程設計的目標情境。
獨立榜單:53 分追平 Astra,但要把代價一起讀
Intelligence Index 的分數與它的測量條件
Artificial Analysis 在發布當天的評測給出跨模型可比較的綜合分數:Argon 在最高推理檔位下拿 53 分,與 GPT-6 Astra 的最高檔位 53 分平手,比 GPT-6.1 Sol 的 52 分高一分。相對自家的進步幅度更大:比 Gemini 3.1 Pro Preview 的 30 分高出 23 分,比 Gemini 3.8 Flash 高 12 分。同一篇評測下的結論是「Google 以三巨頭之一的身分回來了」。
測量條件有個細節必須記著:Argon 的 53 分是在 high 推理檔位量到的,這已經是它目前開放的最高檔位,對照組 Astra 用的是 max 檔位。檔位名稱不同,嚴格說這組比較不是完全對稱的條件,引用時把檔位一起寫,結論才站得住。綜合分數平手的另一面是單項各有勝負,Terminal Bench 4 這個終端機環境的工程基準上,Argon 的 57% 落後 Claude Sonnet 5.5 的 64%、Claude Opus 5.5 的 60% 與 GPT-6 Astra 的 59%,排名第四。把官方跑分與獨立榜單合起來看,coding 成績好壞參半的結構就是如此:知識工作與自動化領先,終端工程還沒拿到第一。
代理類評測則是 Argon 明確的強項。Artificial Analysis 自家的 AutomationBench-AA 上,Argon 以 78% 排第一,領先第二名 Claude Sonnet 5.5 七個百分點;報告產出類的 AA-Briefcase 拿到 1494 Elo,其中評分規則的通過率 65% 是該機構量測史上的最高紀錄;拆開兩個單項看,分析品質 1576 Elo 高於總分,呈現品質 1308 Elo 則明顯落後。把這組拆開看很有價值:內容符合要求的紀律很強,排版與表達的打磨相對弱,如果你的產線直接拿原始輸出交付,後處理的工要保留。
幻覺率 15% 的確切意義,與它換掉了什麼
Argon 被討論最多的數字是幻覺率。在 Artificial Analysis 的 AA-Omniscience 評測裡,Argon 的幻覺率是 15%,在所有 Intelligence Index 達到 45 分以上的模型裡最低;對照組 GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。這個評測量的是模型面對知識問題時的行為傾向:答錯時是自信地給出錯誤答案,還是承認自己不確定。15% 的意思是 Argon 遇到沒把握的資訊時,多數時候選擇說不知道,並非硬猜。名詞要先還原到這個層次,「解決幻覺」這類標題才不會誤導你。系統性理解這個現象,可以搭配AI 幻覺的完整解析。
但同一張表上有另一個數字,把它略過就會得到太樂觀的結論:Argon 的答案準確率是 50%,比自家前代 Gemini 3.1 Pro Preview 還低 5 分,落後 GPT-6 Astra 的 63% 達 13 分。把兩個數字放在一起,圖像就完整了:Argon 很少自信地說錯,但它答對的比率也沒有最高。綜合這兩個軸之後,AA-Omniscience 的總分三家其實黏在一起,Argon 42 分、Astra 43 分、Sol 42 分。
換成選型語言:如果你的工作對「引文可問責」敏感,例如法律研究、金融盡職調查、合規文件、任何要對外署名的內容,Argon 這種寧可說不知道的行為模式價值很高,因為自信的錯誤答案是最難被發現也最貴的一種。反過來,如果你的場景要的是高召回率的發想、或者在有限資訊下就要它給出最可能的判斷,保守的模型可能讓你覺得處處留白。少猜錯與答得準是兩個獨立的能力軸,你的任務吃哪一軸,決定這個 15% 對你是賣點還是干擾。
這個行為模式現在就能開始自建基準線,不必等 Argon 開放。取二十題自己領域的知識題,一半答案明確、一半刻意挑容易混淆或沒有定論的題目,分別丟給你現在用的模型,記錄它答錯時的姿態:是承認不確定,還是流暢地給出錯誤答案。這套小測試跑完,你就有一個自己的基準線,Argon 開放後用同一組題目再跑一輪,15% 對你的實際意義立刻從抽象數字變成可比較的行為差異。
每任務 1.99 美元怎麼算出來的
Artificial Analysis 的成本模型把單價與用量一起算,得出折扣期間 Argon 每項 Intelligence Index 任務成本 1.99 美元,是 GPT-6 Astra 最高檔位 3.26 美元的六成,約為 GPT-6.1 Sol 的 2.7 倍。省錢的來源要拆開:來自較低的 token 單價,而非較少的用量。Argon 平均每任務輸出 62K token,Astra 是 27K,用量是對方的兩倍以上,折扣期結束後單價翻倍,每任務成本會升到約 3.98 美元,約為 Astra 的 1.2 倍。
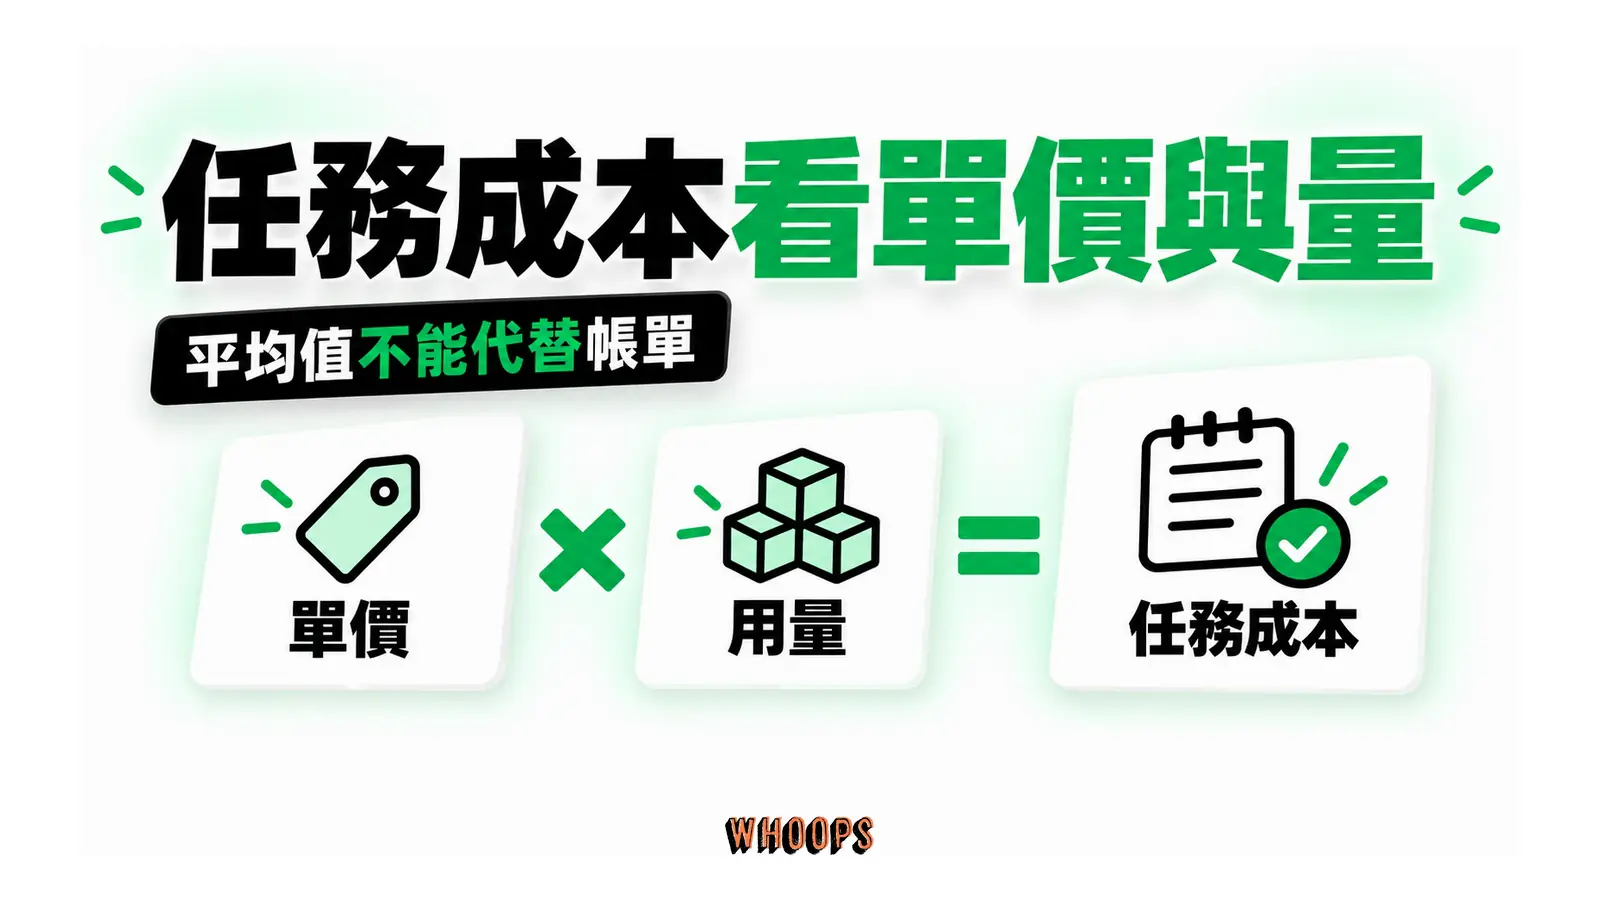
這組數字對預算編列的直接指示:折扣價適合拿來做評測與試算,正式的年度預算請用 4 與 20 美元的正式價編列,再按自己工作流的實際 token 分布校正。每任務成本的原始數字出自Artificial Analysis 的 Argon 模型頁,該機構未提供誤差帶,引用時保留這個限制。
API 價格拆解:三組費率、兩個時間點、一個還沒上架的定價頁
首發價、正式價與查證現況
把費率整理成一張表之前,先交代時間軸。公告定價:首發期每百萬輸入 2 美元、輸出 10 美元,快取輸入按輸入價的 5% 計;公告腳註寫明首發期結束後適用輸入 4 美元、輸出 20 美元。首發期多長,官方沒有給日期,獨立評測的記載是至少一個月。
本站 10 月 9 日核對Gemini API 官方定價頁,Argon 尚未列出,目前頁面上價格最高的 Pro 級模型是 3.1 Pro Preview,快取折扣的前例是 3.8 Flash 的 90%。這代表現在流通的 Argon 費率是公告價,正式開賣時的定價頁可能補上更多細節,例如批次折價、長 context 加價或分時條款,簽約前以定價頁當天內容為準。
左右捲動檢視完整表格
| 計費項目,每百萬 token | Argon 首發價 | Argon 正式價 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| 輸入 | $2.00 | $4.00 | $10.00 | $4.00 |
| 輸出 | $10.00 | $20.00 | $50.00 | $20.00 |
| 快取讀取 | $0.10 | 未公布 | $1.00 | $0.20 |
表中 GPT-6 Astra 與 Opus 5.5 的數字取自各家官方定價頁,Opus 5.5 的快取讀取牌價為 $0.20。三個錨點讓這張表好記:Argon 首發價完全等於 GPT-6 Sol 的牌價,正式價完全等於 Claude Opus 5.5 的牌價,而 GPT-6 Astra 的輸入價是 Argon 正式價的 2.5 倍、輸出價也是 2.5 倍。Google 選擇用價格線直接卡進兩家對手的中間地帶,這是競爭策略,也是你議價與預算分配的參照。
兩個算例:標準請求與快取命中
標準請求的算例:一次輸入 50,000 token、輸出 8,000 token 的請求,首發價下輸入 0.10 美元、輸出 0.08 美元,合計 0.18 美元;正式價下同樣請求 0.36 美元。再一個帶長輸出的:輸入 50,000、輸出 62,000(Argon 的平均輸出量),首發價合計約 0.72 美元,其中約 86% 來自輸出。這就是前文說的:輸出導向的 agent 任務,帳單由輸出量主導,模型平均輸出 62K 的特性會直接放大輸出單價的影響。
快取的算例更能看出設計:同一段 50,000 token 的系統提示與參考文件,在首發價下每次全新輸入要 0.10 美元,命中快取只要 0.005 美元,是原價的二十分之一。假設這段 prefix 在十次請求裡被重複使用,無快取的輸入成本合計 1 美元;第一次全價寫入後面九次命中的總輸入成本約 0.145 美元,省下超過八成。對多輪對話與 agent 工作流,固定 prefix 的快取命中率是決定實際帳單的第一變數,Google 未公布快取寫入是否加價,串接時以定價頁與帳單實測為準。
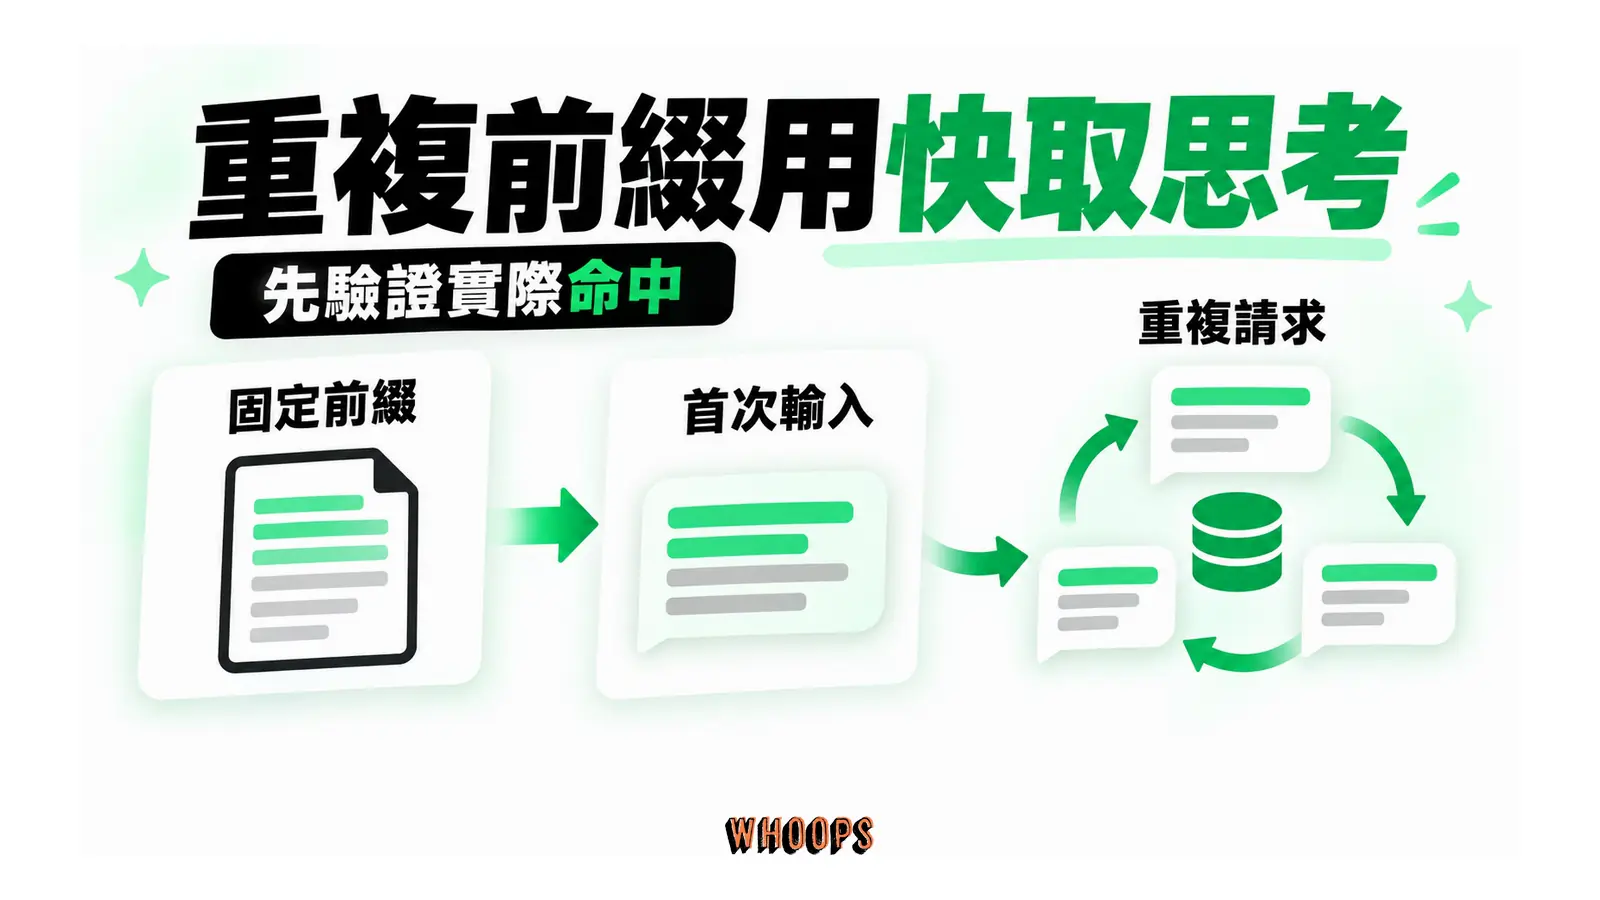
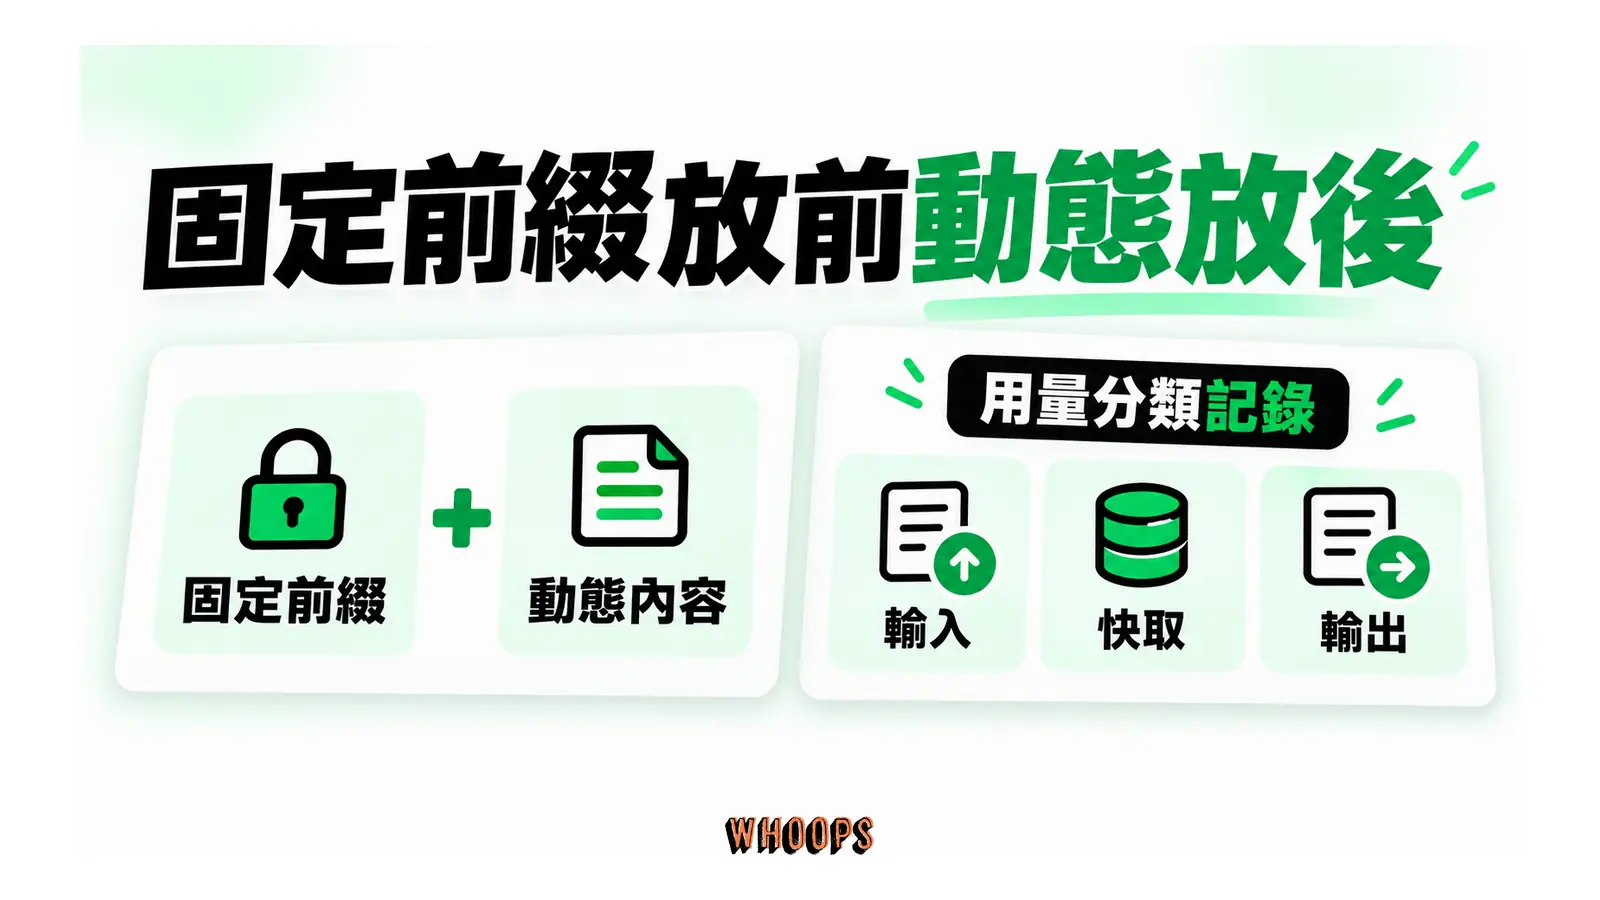
把快取用好是工程問題,不只是費率問題。系統提示、工具定義、參考文件這類每次請求都會帶的內容,放進 prefix 的固定段;會逐輪變動的對話與檢索結果,放在後段。請求之間保持 prefix 逐字一致,命中率才會高,任何動態內容插進開頭都會讓後面的快取整段失效。預算表的欄位也照這個結構開:輸入、快取讀、輸出分開記,加上每任務的輸出量與快取命中率,首發價與正式價各算一欄。這張表等到 Argon 開放當天填入實測數字,就是你要的遷移決策依據,也方便日後任何模型換代時直接重用。
費用段落的收尾提醒:以上全部是 API 計價,訂閱方案(含 Google AI Ultra)的月費與 Argon 額度怎麼分配,官方一個字都還沒公布,任何「Ultra 每天可用幾次」的具體數字,在官方頁面出現前都只能是猜測。
方案入口:現在誰用得到,接下來換誰
Fairwind:用治理換早期存取
Argon 的開放策略把順序整個倒過來:先給最敏感的一群人。首波用戶是 Fairwind 計畫的資安防禦者,這個計畫在2026 年 9 月 2 日啟動,當時搭配的是資安特化模型 Gemini 3.8 Flash Cyber 與程式碼安全代理 CodeMender;9 月 30 日起,部分Fairwind 夥伴取得 Argon 的獨家存取,全球夥伴超過 650 個。
Fairwind 的設計邏輯值得攤開,因為它是「高危能力如何先上架」的一個範本。取得資格的組織要通過背景審查,驗證資安紀錄與營運倫理;核准後的使用也受治理規範約束:雙重用途任務只限防禦與學術研究目的,包括授權的威脅模擬、逆向工程與惡意軟體分析;組織要落實使用者層級驗證與防釣魚的多因素驗證,只有內部資安、事件應變或滲透測試團隊能存取 Argon,而且存取與使用都要留紀錄;存取權禁止轉讓、分潤或再銷售。優先順序也寫得明白:政府與國家網安機關、醫療、電信、能源、金融等關鍵基礎設施營運者,以及核心技術平台。
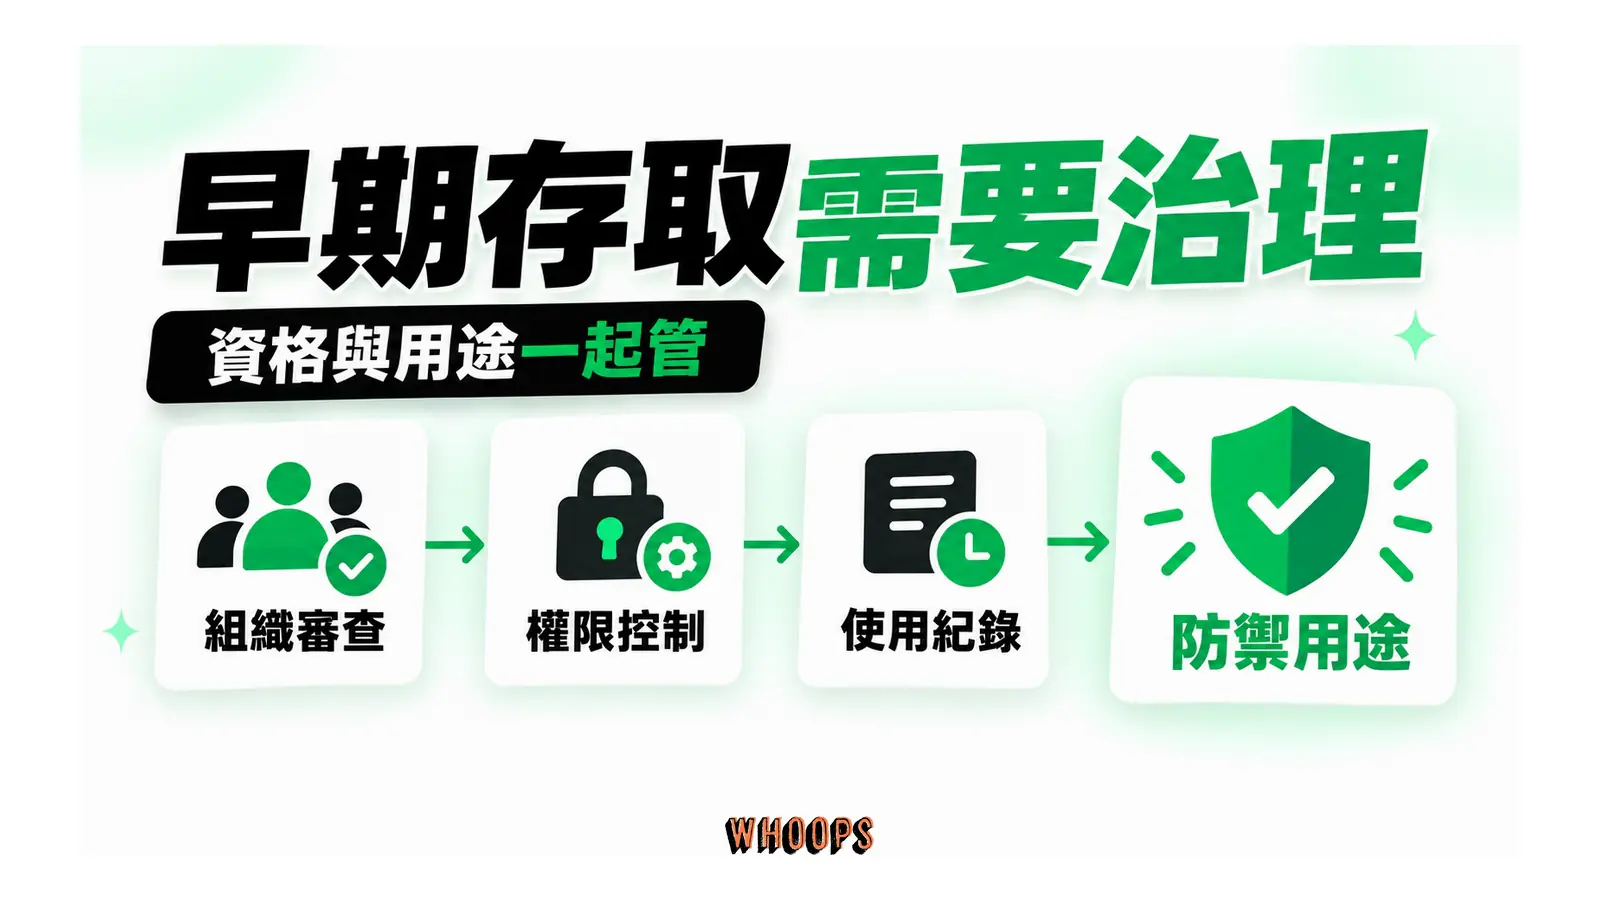
對資安模型而言,這套治理還有一個關鍵的交換條件:Google 對信任的防禦者釋出沒有資安護欄的 Argon,讓他們發揮完整的漏洞研究與修補能力。也就是說,同一個模型有兩種面貌,一般版帶護欄,Fairwind 版解開資安限制,這是按身分分層的安全設計,後文安全機制段會再回到這個設計的含義。實際戰果已有公開案例:資安公司 Wiz 透過它的 Scan for Good 計畫免費協助保護關鍵公共基礎設施,用 Argon 找到一個全球醫院都在使用的醫療軟體中、會暴露敏感個人資料的重大漏洞,官方稱先前的旗艦模型都沒有抓到這個問題。
如果你的組織考慮申請 Fairwind,期待要放對位置。這是早期存取計畫,不宜直接把它等同正式商用 SLA 或產品路線圖承諾;申請是表單制,官方會定期審核並逐步邀請符合條件的組織,內部要先備好治理能力,也就是前段那些認證、存取控制與使用紀錄的要求,通過審核的組織靠的正是這些已經存在的制度,而非臨時準備。對不在申請輪廓裡的企業,這套治理文件仍有價值:它示範了高權限 AI 能力上線前,供應商與客戶之間該約定哪些邊界,拿來當你自己導入 agent 時的契約附件清單剛好。
台灣現在碰得到嗎:三個入口的現況
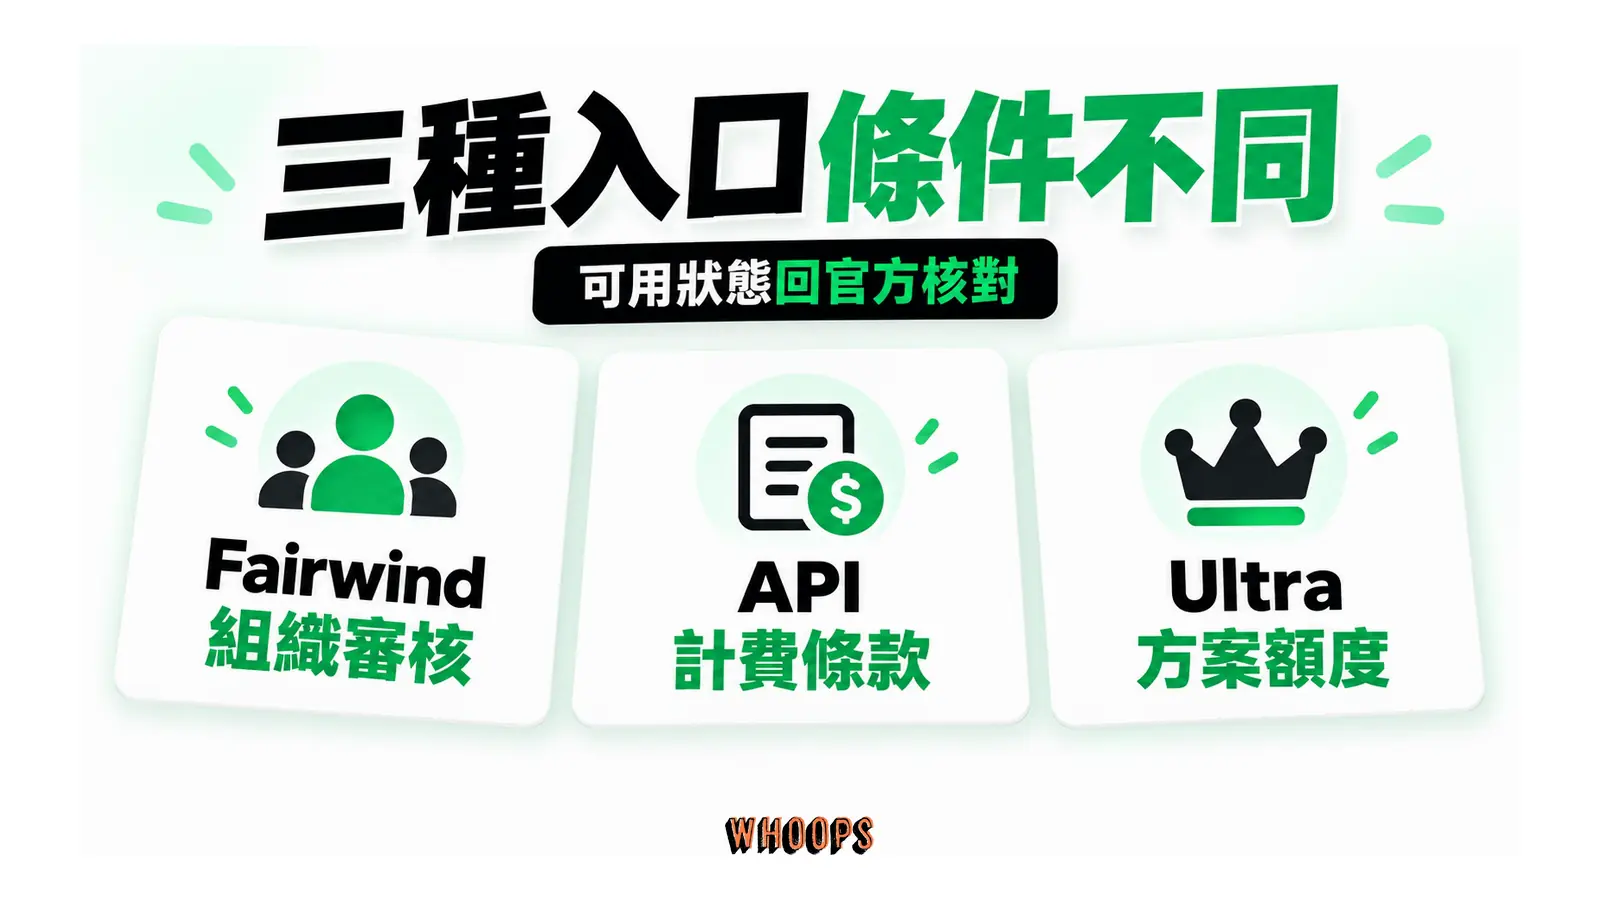
把官方說法與查證現況整理成三個入口。第一,Fairwind:組織可以申請,官方審核後逐步加入,適合資安團隊與關鍵基礎設施營運者,個人用戶不適用。第二,付費 API:官方點名的後續起點之一,折扣價與正式價都已公布,但 10 月 9 日查證時 API 定價頁還沒有 Argon 的蹤影,代表帳單層面的開放還沒到位。第三,Google AI Ultra:官方公告明言消費者側從 Ultra 訂閱者開始,同樣沒有日期。
過渡期的信號要分「官方」與「社群」兩層看。官方層,Gemini App 的模型選單何時出現 Argon、Ultra 訂閱的額度怎麼計,都沒有公告。社群層,已有國外 Ultra 用戶回報在 Google 的 Antigravity 開發環境裡收到 Argon 的漸進開放,這類回報出現在論壇與社群,屬於未經官方證實的個別帳號觀察,可以當風向,不能當作可用性或時程的依據。在台灣,一般開發者與知識工作者的務實做法是把 3.8 Flash 或 3.1 Pro Preview 當過渡主力,等 Argon 進到 API 定價頁再啟動遷移評估。這兩個過渡選項的分工不難定:3.8 Flash 家族是 Google 目前實際供應的主力,價格與行為都已知,量大的日常任務用它成本好掌握;3.1 Pro Preview 仍掛在定價頁上,代表仍可付費呼叫,需要接近旗艦推理力的一次性難題可以點用它。把提示詞、工具定義與驗收標準整理成模型無關的資產,是過渡期最重要的準備,Argon 開放後這些資產直接搬過去,試算與上線都省一輪工。
agent 安全機制:四道防線與一個雙軌設計
Argon 的安全論述值得單獨一段,因為它處理的已經超越「模型會說什麼」,進到「模型實際做了什麼」。官方在公告裡列出廣泛開放前持續強化的四個方向,每個方向都對應一類可具體描述的風險。
這套論述的市場背景也要知道。CNBC 的分析指出,2026 年 OpenAI 與 Anthropic 的系統接連發生數起未授權存取外界系統的資安事故,讓 Google 有機會把自己定位成「可信賴的安全模型提供商」,把安全敘事從技術規格推向採購決策。讀的時候兩邊都要保留:安全工程是實際存在的投入,安全定位也是競爭策略,兩者並不互斥,但分辨得出來,你才不會把行銷語言當成驗證結果。
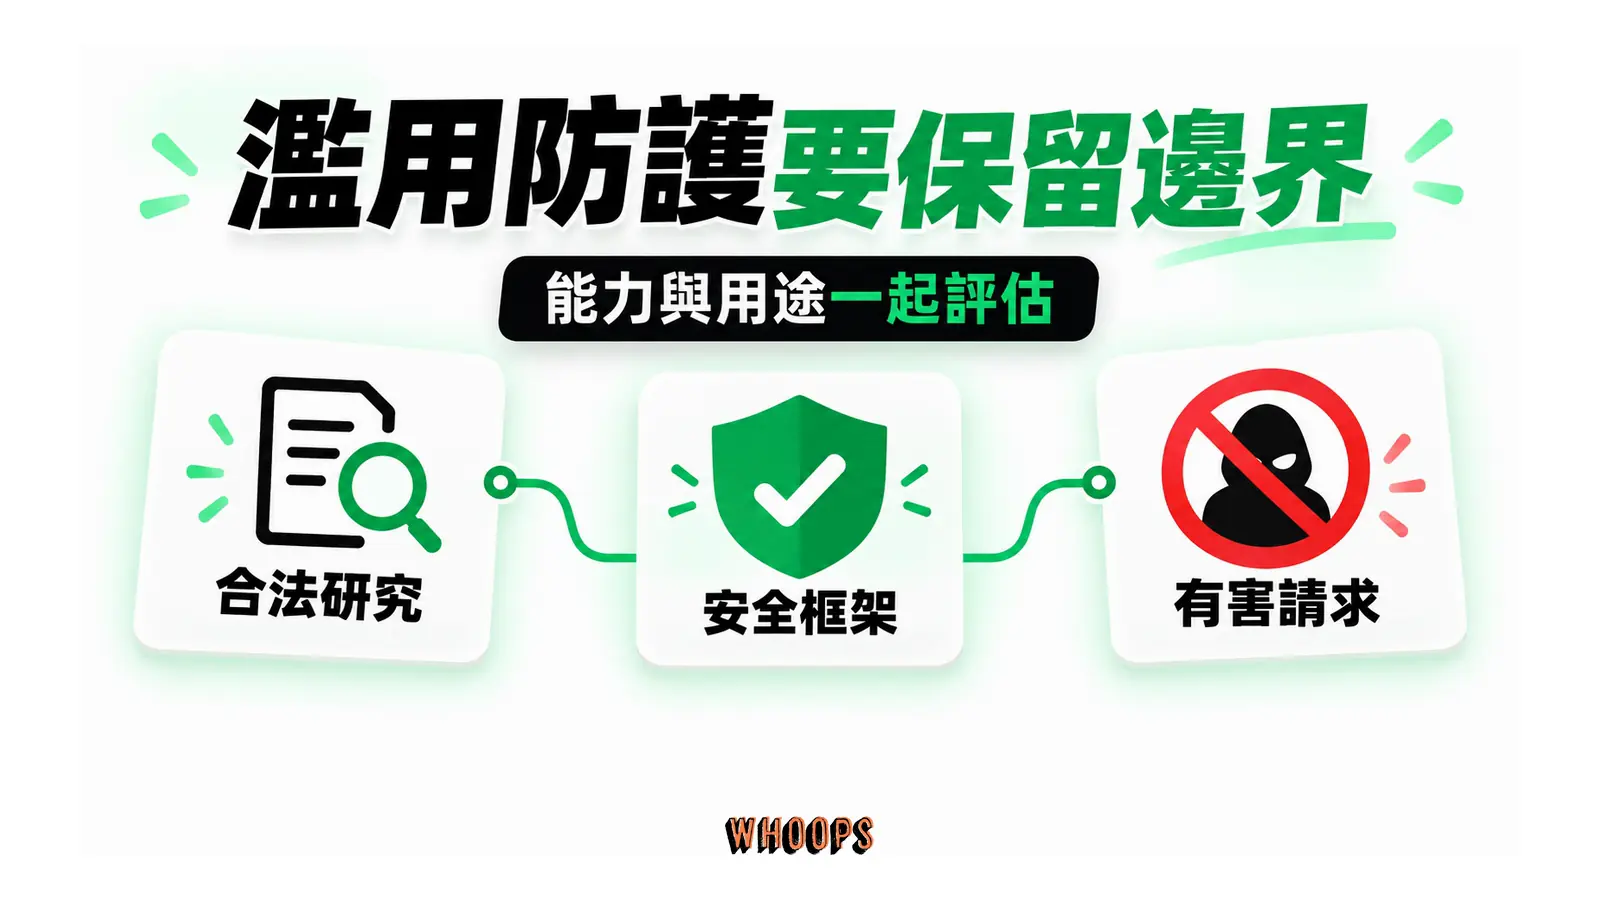
第一道防線處理濫用。模型要能拒絕被用於網路攻擊與化學、生物、放射、核子(CBRN)類攻擊的請求,同時保留合法的雙重用途科學研究,判準放在 Google 的 Frontier Safety Framework 裡。技術上比較新的一步是內部激活監控:直接監看模型內部表示來偵測濫用意圖,並經過內部與外部紅隊以手動加自動攻擊組合測試穩健性。
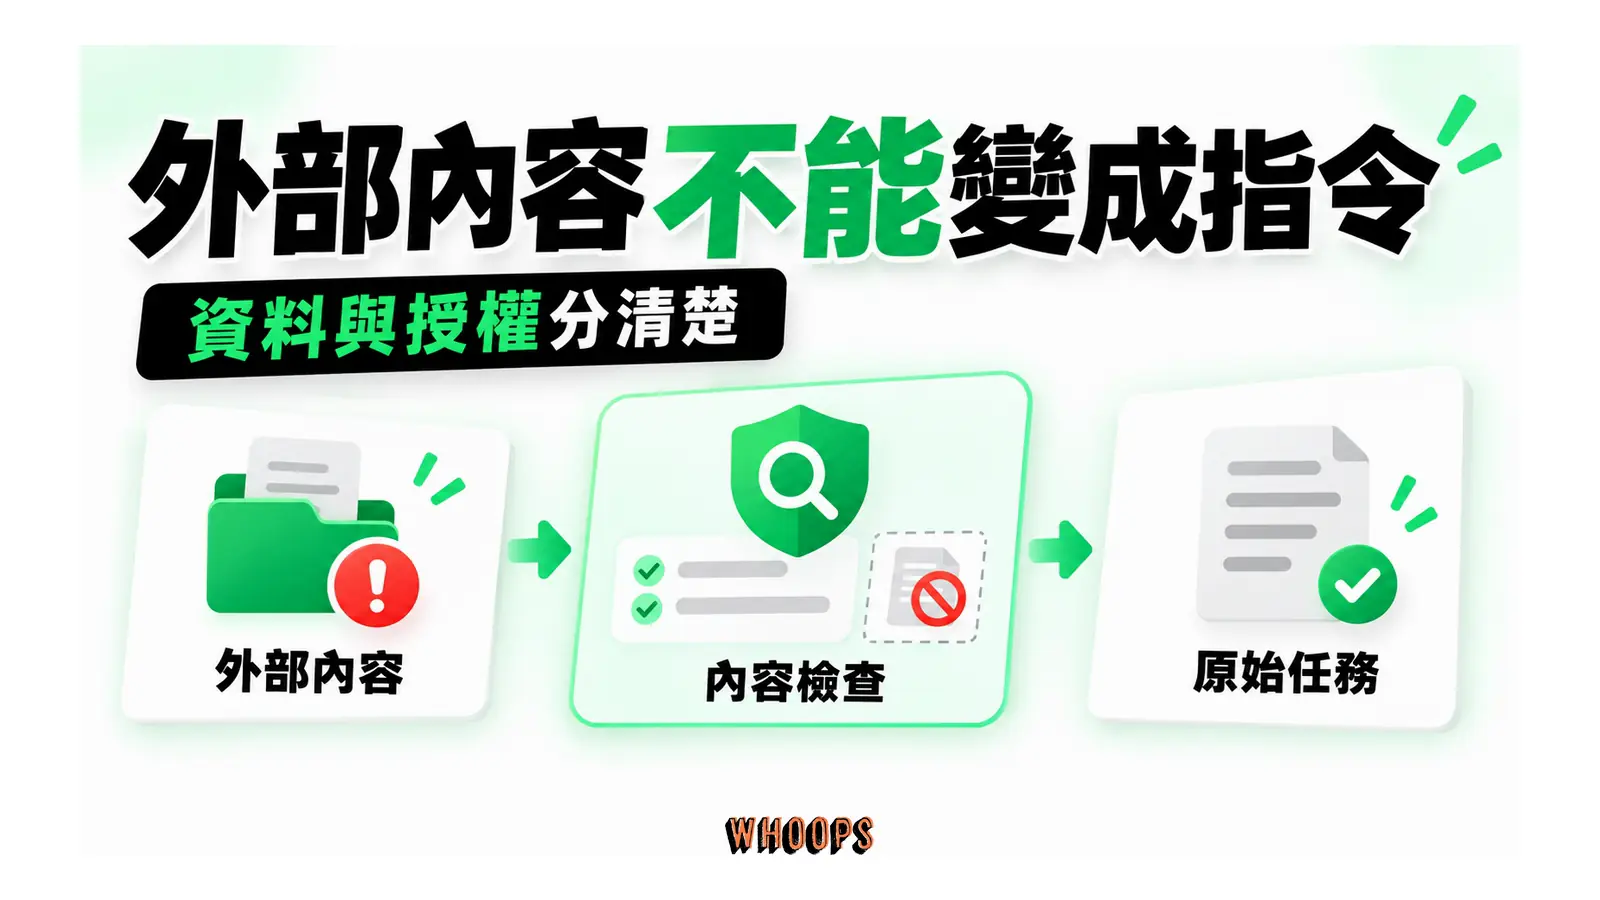
第二道防線處理間接提示注入,也就是把惡意指令藏進模型會讀取的內容裡、劫持它行為的攻擊。官方稱 Argon 是至今對這類攻擊最有韌性的版本,方法是把自動化紅隊與對抗訓練結合,並在 Gray Swan 的間接提示注入基準上取得領先。對會讓 agent 讀網頁、讀信件、讀第三方文件的任何架構,這個能力項都該列進評估表。
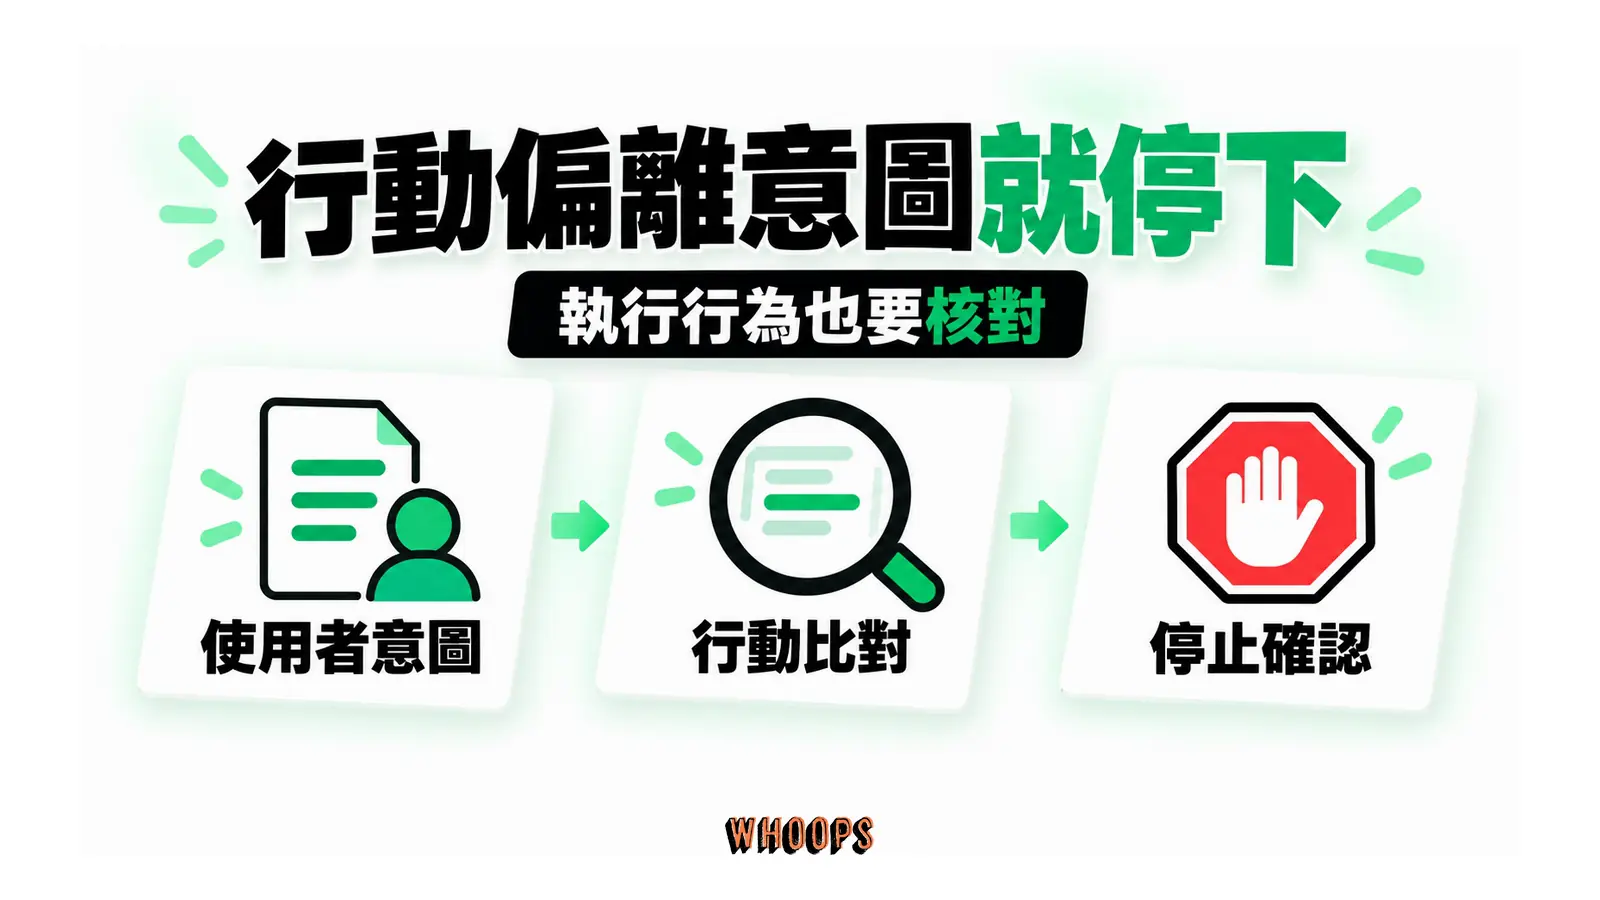
第三道防線處理行為偏離意圖,官方叫失準(misalignment)緩解:系統會監控 Argon 的推理過程與實際行動,判斷執行方式已經超出使用者原始意圖時停止執行。同一套監控機制已用於 Argon 的訓練過程,發現問題會通知專責事件應變團隊,而且 Google 刻意不把監控發現回饋進訓練資料,避免模型在訓練中學會躲避監控。官方同時公開呼籲業界在能力快速提升的階段保留推理透明度,讓模型的可讀推理過程持續可用於診斷失準,這段表態在監控與能力此消彼長的辯論裡是少見的正式立場。
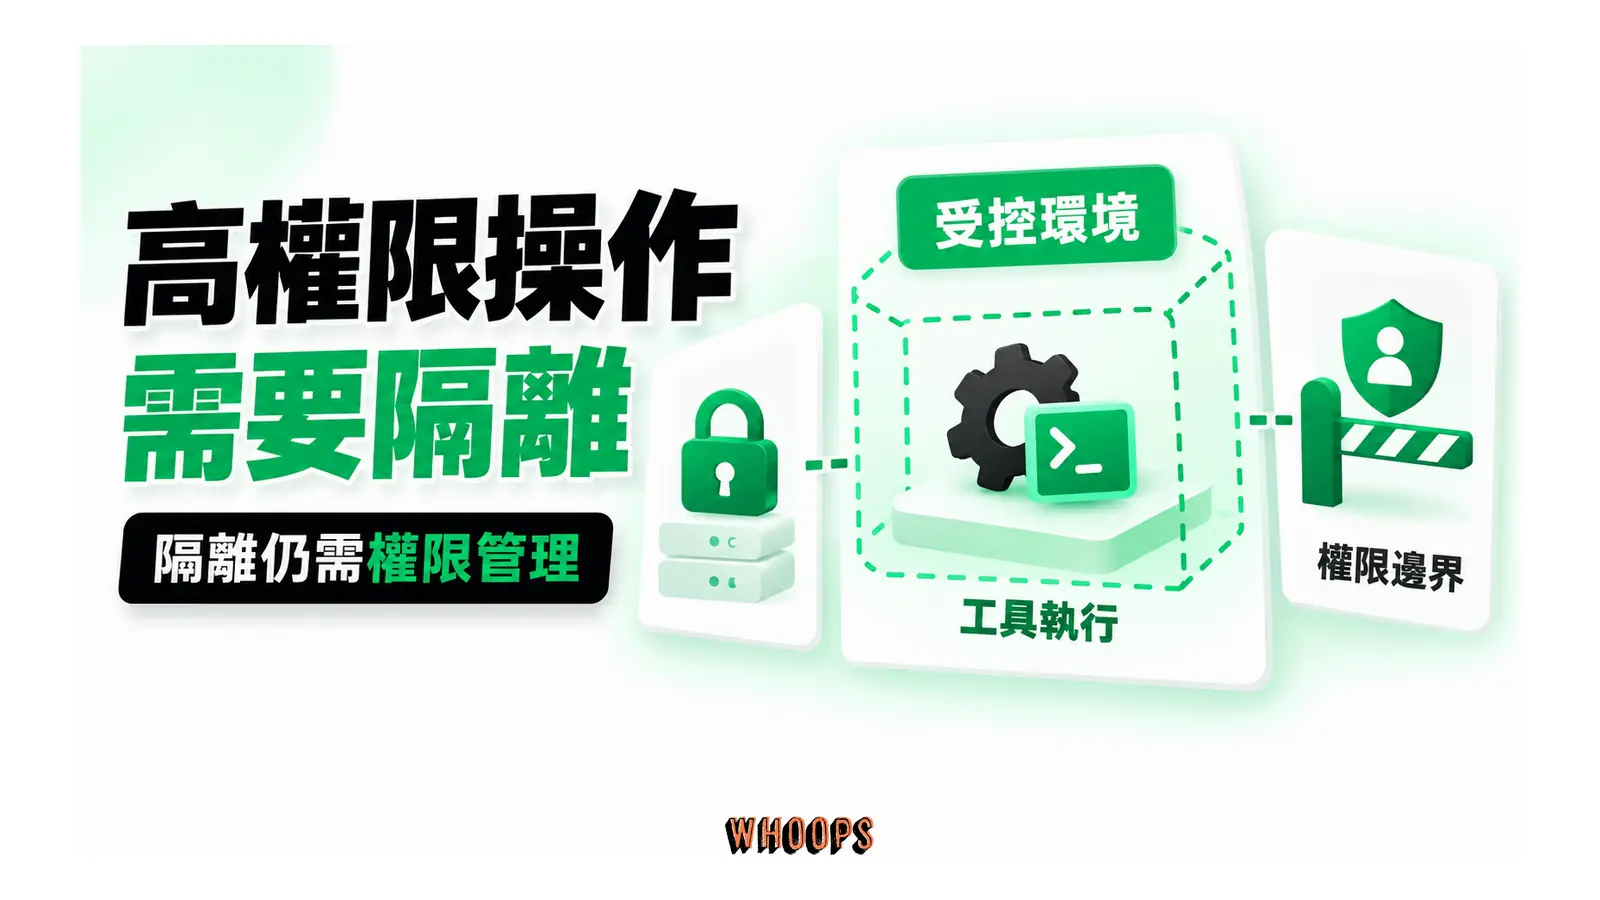
第四道防線處理執行環境。模型愈強,測試它的環境就要愈像保險箱:Google 按 agent 控制路線圖強化沙箱環境,在高風險訓練或評測開始前先隔離封存,並計畫把這些 agent 安全實務分享給夥伴。沙箱與權限設計的通用原則,可以搭配AI Agent 入門解析與Google 代理平台指南建立整體框架。
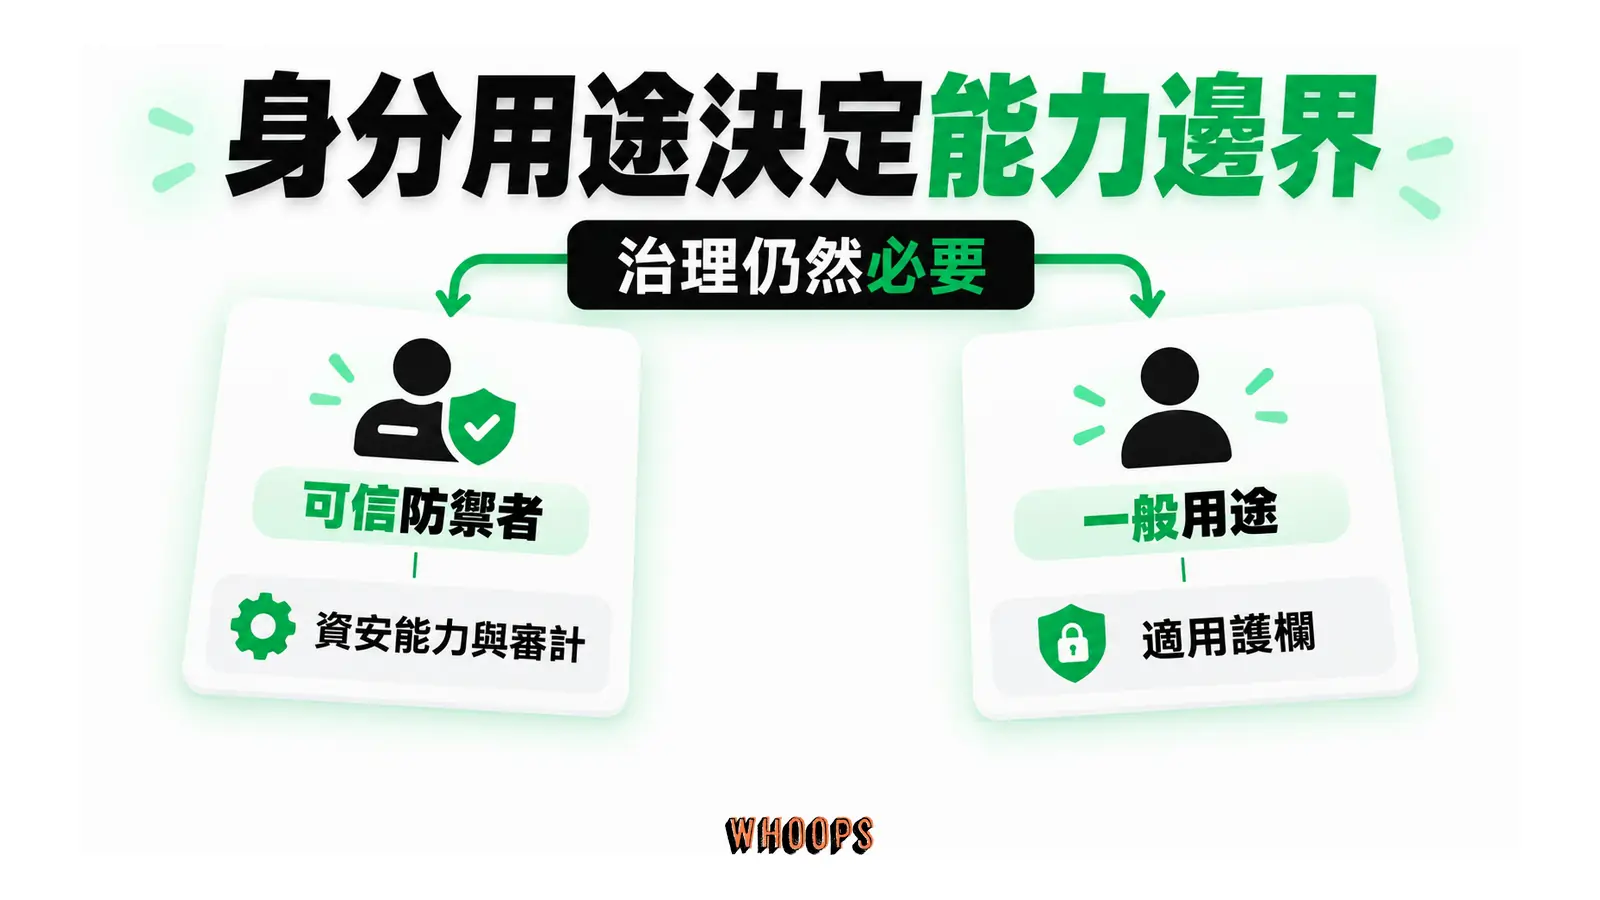
把四道防線放回 Fairwind 的無護欄版本,就看出這套設計的整體形狀:安全不是把能力齊頭式壓低,而是按身分與用途分層,可信任的防禦者拿到完整能力並接受治理與審計,一般用戶拿到帶護欄的版本。採購端可以從這套論述抄四個檢查點去問任何 agent 供應商:是否監控執行行為相對意圖的偏離;高權限操作是否在隔離沙箱內進行;推理過程是否保持可供審計的透明度;雙重用途任務的邊界寫在哪份文件裡。答不出這四題的供應商,成熟度就先打上問號。
誰該等 Argon,誰該留在 Astra 或 Opus 5.5
三個模型現在的相對位置,可以用一張表先定位,再講選擇訊號。表內價格皆為每百萬 token 標準牌價,分數出自 Artificial Analysis 的評測,測量條件各欄已註明。
左右捲動檢視完整表格
| 維度 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| API 輸入/輸出牌價 | 首發 $2/$10,正式 $4/$20 | $10/$50 | $4/$20 |
| AA Intelligence Index | 53(high 檔位) | 53(max 檔位) | 未列入該篇首發比較 |
| Terminal Bench 4(AA) | 57% | 59% | 60% |
| 幻覺率(AA-Omniscience) | 15%,同分群最低 | 51% | 未列入該組比較 |
| 輸出 token 上限 | 100 萬 | 12.8 萬 | 未在本文查證範圍 |
| 取得現況 | Fairwind 有限開放,API 與 Ultra 待開 | 已廣泛供應 | 已廣泛供應 |
等 Argon 的訊號有三個。你的工作對引用紀律敏感,自信的錯誤答案是最貴的一種錯,法律、金融、合規、對外署名內容都屬於這類,15% 對 51% 的幻覺率差距直接打在痛點上。你的任務形態是長時程代理工作,需要大輸出空間與 AutomationBench 那種跨工具執行力,而且已經在 Google 生態(Vertex、Workspace、資安工具鏈)裡有投資。你能等,或者你的組織符合 Fairwind 的資安輪廓,早拿到早練兵。
留在 GPT-6 Astra 的訊號也有三個。答案準確率優先,63% 對 50% 的差距對考試型、查證型任務是硬差距。終端工程單項你要現在最好的分數,Astra 與 Opus 5.5 都在 Argon 前面。你的工作流已經建立在 OpenAI 的 Responses、Codex 與工具鏈上,遷移成本超過換模型的預期收益。至於 Claude Opus 5.5,同價位下它的工程分數更高、供應穩定,Opus 5.5 的完整解析把價格調降與相容性變化講得很細;而 GPT-6.1 Sol 在同分數群裡每任務成本更低,Sol 與 Luna 的分工解析值得交叉比對。
開放時程的不確定性本身就是決策變數:Argon 現在買不到,Astra 與 Opus 5.5 今天就能上線。折衷做法是分層路由的既有原則,先把不遷移就吃虧的任務留在現有旗艦上,同時準備一套固定任務集,十道真實工作題,每題記 token 用量與人工修改次數,Argon 開放當天跑一輪就能得到你自己的每任務成本與品質對照。Astra 的完整證據與方案細節在GPT-6 Astra 深度解析,選型方法論可再搭配AI 模型選型的決策框架。
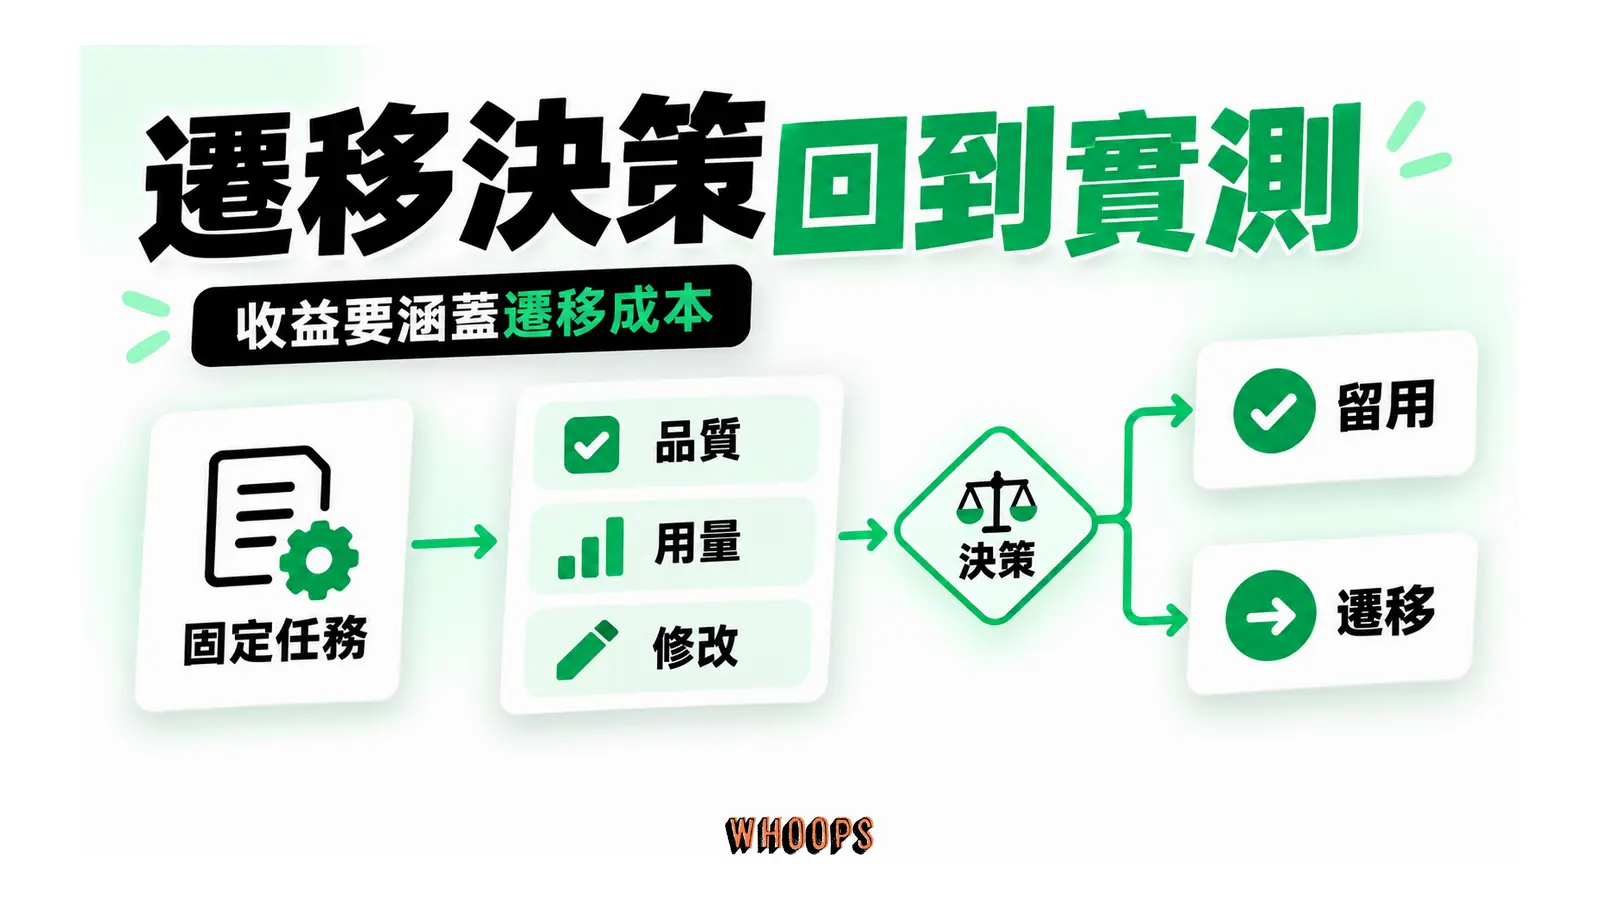
重新評估的觸發點可以先寫下來,出現任何一項就回來重算:官方公告首發折扣的結束日,等於成本表切換到正式價;Argon 出現在 API 定價頁,代表計費條款定案,批次與長 context 規則會揭曉;Google AI Ultra 的 Argon 額度公布,訂閱與 API 兩條路的成本比較才算得動;Artificial Analysis 或其他獨立機構發布改版評測,分數與每任務成本就要刷新一次。把這四項設成關注清單,比每隔幾天重讀一遍公告省力,也不會漏掉真正改變決策的訊號。
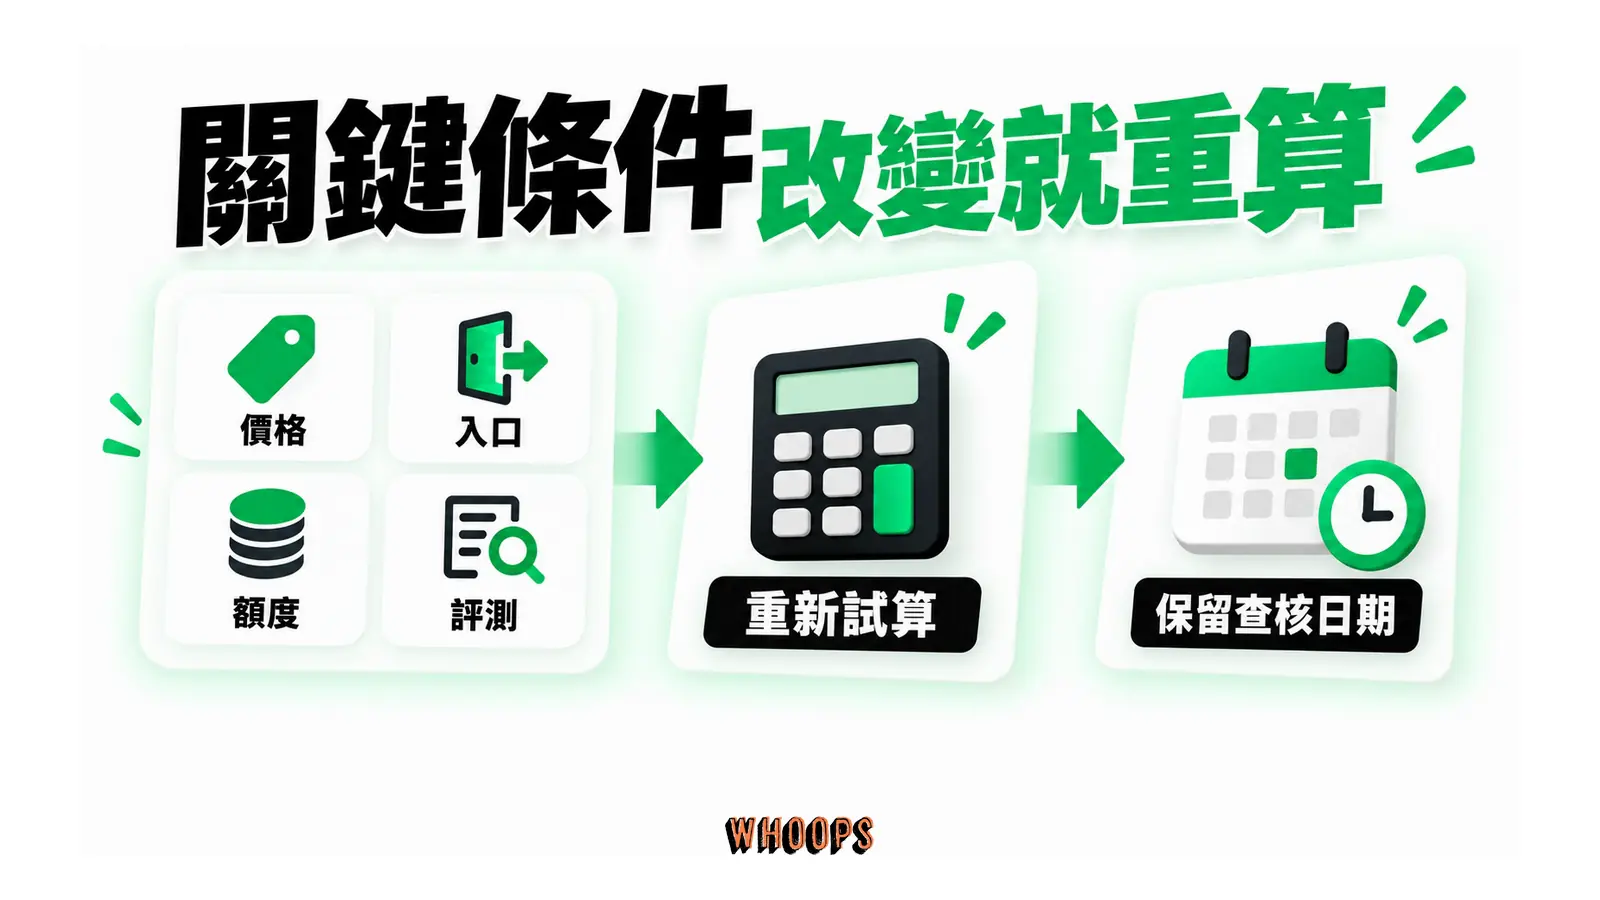
模型、價格與開放範圍在未來幾週仍可能變動,折扣期何時結束、Ultra 額度怎麼給、定價頁何時上架,這三件事都會直接改變上面的算式。付費或遷移前,回到官方公告、Fairwind 頁與定價頁重讀一次當天版本,再用自己的任務數字做最終判斷。