向量搜尋入門:Embedding、相似度與 RAG
一次搞懂 AI 向量搜尋:從向量、Embedding、相似度計算,到向量資料庫與 RAG 的完整流程,並比較它和傳統關鍵字搜尋的差異與適合情境,附發展脈絡、混合檢索與切段策略。
本頁目錄
- 為什麼光比對關鍵字已經不夠用:向量搜尋要解決的老問題
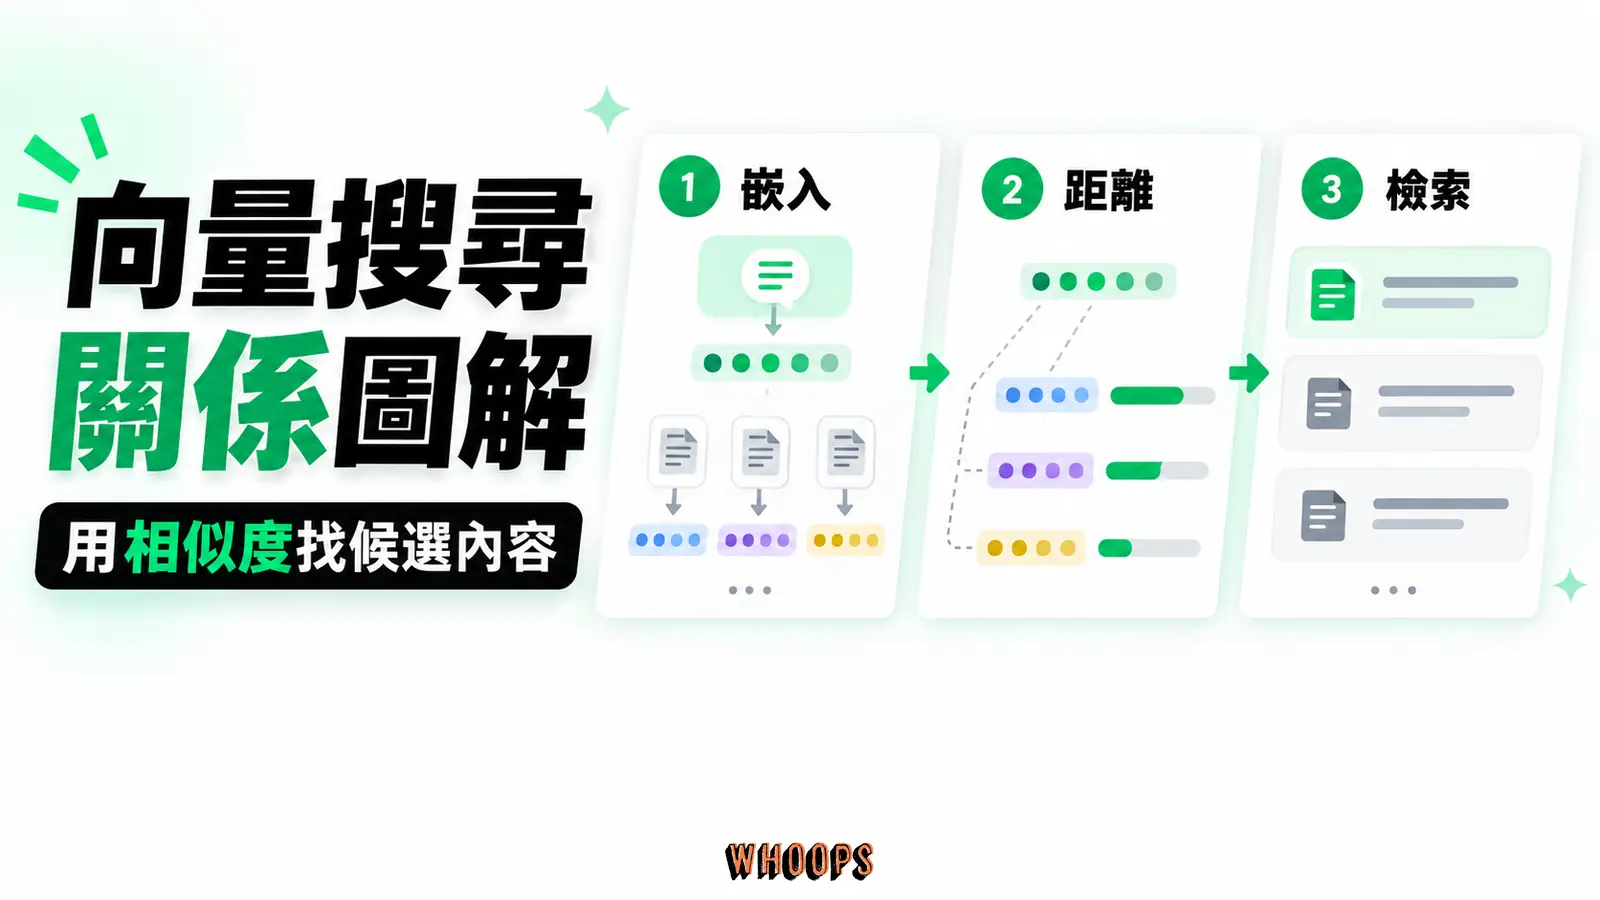
- 拆開向量搜尋的三段流水線:嵌入、測距、找鄰居
- 第一段:把一段文字壓成一串數字(embedding)
- 第二段:用「距離」量化兩段話有多像
- 第三段:在幾千萬個點裡快速找最近鄰(ANN 與 HNSW)
- 一張表讀懂向量搜尋跟關鍵字搜尋到底差在哪
- 向量搜尋走過的這幾年:從詞向量到段落檢索
- 誰靠向量搜尋吃飯:RAG、推薦系統,還有 Google 自己
- 別神化它:向量搜尋三個會讓你栽跟頭的限制
- 何時值得使用混合檢索
- 文件切塊如何影響向量檢索品質
- 回到 SEO / GEO:向量相似度是候選檢索的一個環節
- 三個你可以今天就動手玩的向量搜尋工具
- 三個最常見的誤解,一次清掉
- 我會這樣建議你踏出認識向量搜尋的第一步
你搜尋「冷氣不冷」,可能找到標題使用「空調製冷效果差」的頁面。字詞正規化、同義詞、語意模型與其他排序方法都可能參與其中,不能只看結果就判定它使用向量搜尋。向量搜尋值得理解的地方,是它能以學到的數值表示,找出字面不同但可能相關的內容。
一句話講完:向量搜尋是一種用數學上的「距離」來衡量兩段內容意思有多接近的檢索方法。它先把每段文字轉成一串數字(叫做向量、或 embedding),再在這個數字構成的空間裡,把「距離最近」的內容當成最相關的答案。這篇文章我會帶你把它拆成三段流水線,講清楚它跟傳統關鍵字搜尋的差別,並誠實告訴你它做不好的地方在哪裡,以及為什麼這件事跟你能不能被 AI 搜尋引用息息相關。
如果你完全沒碰過檢索這個領域,建議先把兩個概念墊在底下再讀這篇:一個是 BM25 這類關鍵字檢索是怎麼算相關性,另一個是 TF-IDF 怎麼幫一個詞打權重。向量搜尋的價值,是建立在「傳統關鍵字檢索做不好的那些事」上面,先知道舊方法,你才會懂新方法在補哪個洞。
為什麼光比對關鍵字已經不夠用:向量搜尋要解決的老問題
傳統的檢索(BM25、TF-IDF 這一家族)核心邏輯很直白:你查的字,有沒有出現在文件裡,出現幾次,在少見的文件裡出現就更珍貴。這套邏輯在絕大多數「字面對得上」的查詢上非常強,速度快、可解釋、穩定。問題是它有一個天生盲點:它僅認得「字」,不認得「意思」。
若沒有同義詞、查詢擴展或其他語言處理,純字詞匹配可能漏掉同義改寫、口語與跨語言查詢。不過關鍵字檢索不要求整句逐字命中,也能配置同義詞分析器;向量檢索是否改善結果,還要看所用模型是否支持相關語言與任務。
這個盲點其實不算 bug;傳統關鍵字檢索主要依賴字詞匹配,本來就不擅長處理所有語意變化。向量搜尋補上的正是這個維度。說穿了,它要做的事僅有一件:讓電腦在「字面對不上、但意思相近」的時候,仍能把兩邊配在一起。
如果你想把這一環放回整個搜尋流程看,候選檢索可放在索引之後、精細重排序之前理解;但檢索本身也會排序,細節可以看我整理的 Retrieval 在搜尋流程裡的位置。向量搜尋就是這一環裡,跟關鍵字檢索並列的另一半方法。
拆開向量搜尋的三段流水線:嵌入、測距、找鄰居
向量搜尋聽起來很玄,拆開來其實就是三個動作串起來的流水線。我用最白話的方式各講一遍,你會發現每一步都不難,難的僅是那個「把文字變數字」的模型是怎麼訓練出來的。
第一段:把一段文字壓成一串數字(embedding)
第一步是嵌入(embedding)。你把一段文字(一個詞、一句話、一整篇文章都行)丟進一個事先訓練好的模型,模型吐出一串固定長度的浮點數。這串數字常見的長度是 384、768 或 1536 個數字,看你用哪個模型,各家的維度規格可參考 OpenAI 的 Embeddings 文件。這串數字就是那段文字在電腦眼裡的「身份證」,學名叫向量(vector)。
關鍵在於它帶出了一個性質:模型會把意思相近的文字,對應到空間裡位置相近的向量。「我很開心」跟「我心情很好」雖然字面差很多,但它們的向量會落在很近的位置;「我很開心」跟「天氣很冷」的向量則會隔得很遠。這個「相近=意思相近」的性質,是整個向量搜尋能成立的根。Google 的機器學習課程對這個概念有很清楚的入門說明:embedding 就是把離散的、抽象的概念,對應到一個連續的、可以用距離衡量的幾何空間。
這個空間是模型在訓練過程中「自己學出來」的。背後主要是一種叫做對比學習(contrastive learning)的訓練方式:模型會看到成對的範例,意思相近的兩句,就把它們的向量拉近;無關的兩句,就推開。經過幾百萬、幾千萬對這樣的拉扯,模型慢慢把每段文字擺到一個位置,讓相近的聚在一起、無關的分開。這個學出來的空間結構,才是向量搜尋真正的引擎,模型品質好不好,比的也就是這個空間學得夠不夠細。Reimers 等人提出的 Sentence-BERT,就是把這個想法搬到「句子層級」的代表作,它用一個雙塔(siamese)架構讓 BERT 能有效率地為整個句子產生向量,讓語意搜尋變得實用,論文出處是 2019 年的 Sentence-BERT。
向量維度會影響儲存與計算成本,但不同模型的維度不能當成品質排名。較高維模型未必更適合你的語言或資料;應比較實際檢索表現、延遲、記憶體與成本,再決定模型及維度。
第二段:用「距離」量化兩段話有多像
有了向量,第二步是算兩個向量之間的距離。最常用的三種方式是餘弦相似度(cosine similarity)、點積(dot product)、歐氏距離(L2 distance)。檢索場景裡最常見的是餘弦相似度,它量的是兩個向量「指向的方向有多接近」,跟兩點之間的絕對距離沒有直接關係,方向越一致就代表意思越像,值域從 -1 到 1,越接近 1 越相似。
用一個比喻:把每段文字想像成星空裡的一顆星星,embedding 決定它在天空中的位置,餘弦相似度量的則是「從原點看過去,這兩顆星是不是落在差不多方向」。你輸入的查詢也會被轉成一顆星,搜尋做的事就是在整片星空裡,找出跟查詢那顆星方向最接近的幾顆。
這三種距離算法各有適用場景,我用一個小表整理給你:
左右捲動檢視完整表格
| 算法 | 衡量的是 | 常見適用情境 |
|---|---|---|
| 餘弦相似度 | 兩個向量的方向夾角 | 文本語意相似,最常用 |
| 點積(dot product) | 方向加上長度 | 向量已正規化時,結果等同餘弦 |
| 歐氏距離(L2) | 兩點間的直線距離 | 在意絕對長度差異的場景 |
只有向量都已做單位長度正規化時,點積才等於餘弦相似度;在這個條件下,L2 距離也會給出相同的最近鄰順序。模型不一定預設正規化,使用前應核對模型及索引的距離設定。
第三段:在幾千萬個點裡快速找最近鄰(ANN 與 HNSW)
第三步是真正的工程難關。理論上,要找出最像的內容,你若把查詢向量跟資料庫裡每一個向量都算一次距離,取最近的幾個就好,這叫精確最近鄰(exact nearest neighbor)。問題是,當你的資料庫有一千萬筆內容時,每次查詢都要比對一千萬次,根本快不起來。
精確與近似最近鄰搜尋都有實際用途。pgvector 預設使用精確搜尋,資料量或過濾後候選較少時可能已足夠;ANN 則以部分召回率換取速度,應用自己的資料測量取捨。reranker 只能重排已取回的候選,無法補回完全沒進入候選的文件。
ANN 演算法裡常見的一個是 HNSW(Hierarchical Navigable Small World)。它的想法可以用台灣的高速公路系統來比喻:你從墾丁開車到台北,不會走省道一個一個縣市慢慢磨,而會先上國道,接近目的地再下交流道。HNSW 把向量建成多層圖,上層提供長距離連結,下層用來精細定位,查詢時逐層縮小範圍,想法出自 Malkov 在 2016 年的 HNSW 論文。它能減少要比較的候選數,但實際延遲仍取決於資料量、索引參數、硬體與召回率要求。FAISS 則把多種向量索引方法整理成現成工具。
一張表讀懂向量搜尋跟關鍵字搜尋到底差在哪
把兩邊擺在一起比,你會更清楚這兩者是互補關係,誰也取代不了誰。我用一個對照表把六個維度列出來:
左右捲動檢視完整表格
| 維度 | 關鍵字檢索(BM25 / TF-IDF) | 向量搜尋(dense retrieval) |
|---|---|---|
| 比對的單位 | 字詞是否出現、出現幾次 | 整段話在語意空間裡的位置 |
| 擅長的查詢 | 精確名詞、專有名詞、產品型號 | 口語長句、同義改寫、跨語言 |
| 弱點 | 沒有同義詞或查詢展開時,字面不同可能漏配 | 專有名詞容易配錯、可解釋性低 |
| 計算成本 | 低(倒排索引,極快) | 依資料量與模型而定,可採精確或 ANN 搜尋 |
| 可解釋性 | 高(哪個詞命中一清二楚) | 低(模型給的分數很難用人話解釋) |
| 需不需要訓練 | 不用(統計公式即可) | 需要嵌入模型,但可直接使用預訓練模型 |
看這張表你應該注意到一件事:向量搜尋在「可解釋性」這一格是輸的。當它把一個查詢配到某篇文章,你很難用一句話講清楚「為什麼是這篇」,因為分數是 768 維空間裡算出來的餘弦值,沒有一個你能指著說「就是這個詞命中」的證據。這個特性後面會回來咬人,先記在心裡。
向量搜尋走過的這幾年:從詞向量到段落檢索
向量搜尋不是這兩年才冒出來的東西,它背後有一條十幾年的發展線,搞清楚這條線,你會更知道現在用的工具為什麼長這個樣子。
最早被大規模使用的,是詞向量(word vector)。研究人員發現一個更聰明的做法:不靠人工定義每個詞的屬性,改讓模型從大量文本裡自己學會每個詞的「位置」。一個經典的例子是:把詞向量拿來做加減,「國王」減去「男人」加上「女人」,會落在「女王」附近。這說明模型真的學到了某種語意關係,而不僅是統計字頻。這一步證明了「用數字位置表達意思」是可行的。
把詞向量平均可當句子表示的基準方法,但會遺失部分語序與上下文。Sentence-BERT(Reimers 與 Gurevych,2019)使用 siamese 或 triplet 結構產生可比較的句向量,改善語意相似度任務的計算效率。它不是第一個句子表示方法,也不能保證所有否定或轉折都判斷正確;實際檢索仍須用相關與不相關樣本驗證。
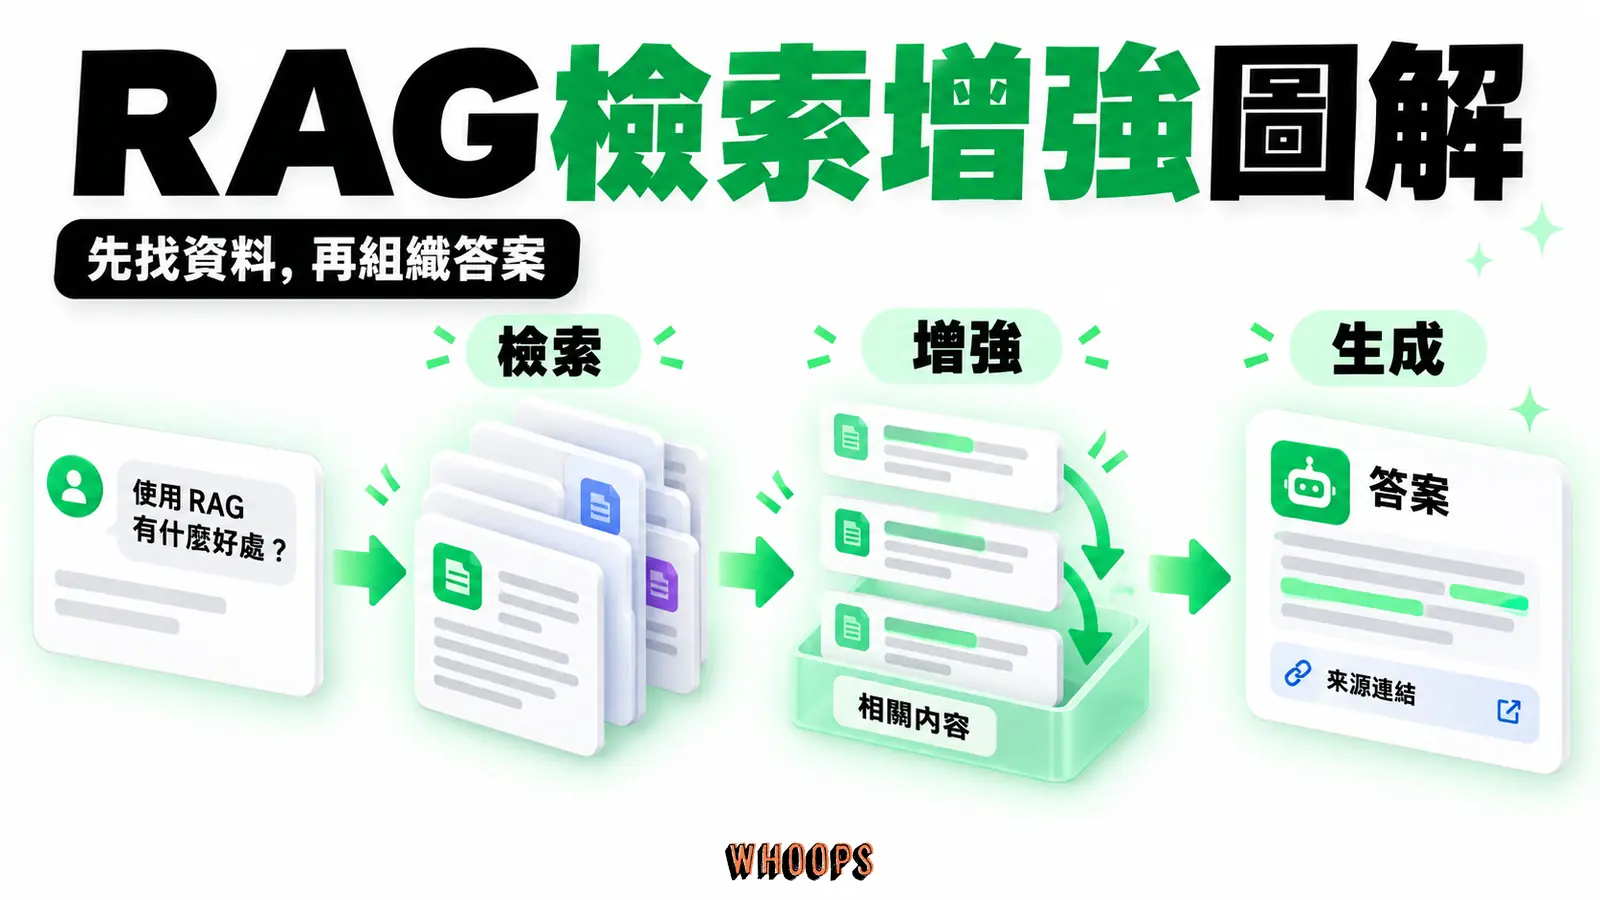
再下一步,是把向量檢索跟「問答」這個任務綁在一起訓練。Dense Passage Retrieval 用一個問題編碼器、一個段落編碼器,直接拿真實的問答資料訓練模型「什麼樣的問題該配什麼樣的段落」,讓檢索不再僅看像不像,還會看「能不能回答」,這是 Karpukhin 等人 2020 年提出的 Dense Passage Retrieval。到了 RAG,這套檢索又被接上生成模型,變成現在大家熟悉的「先撈資料、再回答」的 AI 架構,原始論文是 Lewis 等人 2020 年的 Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks。
這條發展線還帶出了另一個觀念:檢索品質好不好,不能憑感覺,要用基準測試(benchmark)來量化。像 BEIR 這類基準,就是把一批模型丟到不同領域、不同任務上打分數,讓「哪個模型在什麼情境下贏」變成可以比較的數字,而不僅是誰的故事講得漂亮,這套方法出自 Thakur 等人 2021 年的 BEIR 評測。這份實證精神,也是你在挑選任何檢索工具時該帶上的態度:用你自己的資料測,用數字說話。
理解這條線,你會明白一件事:你今天用的 embedding 模型,從來都不是什麼通用魔法,它其實是一個「被某種任務調教過」的工具。它擅長什麼、不擅長什麼,很大程度取決於它當初是被訓練來做什麼。這也是為什麼換一個模型,檢索效果可能會整個翻盤,挑模型永遠要用你自己的資料實測,排行榜僅能當參考,不能照單全收。
誰靠向量搜尋吃飯:RAG、推薦系統,還有 Google 自己
向量搜尋不是學術玩具,它已經是現在絕大多數 AI 產品的骨幹。最主要的四個應用場景:
第一個,是 RAG(檢索增強生成)。企業內部知識庫或其他問答系統,可以先檢索相關文件片段,再把片段連同問題交給模型生成答案。檢索可能使用向量、關鍵字或混合方法。RAG 能提供較新或可追溯的上下文,但檢索錯誤、來源品質與生成偏差仍可能造成錯誤,不能把「有來源」當成正確保證。這套架構由 Lewis 等人在 2020 年的 RAG 論文系統化提出。想深入這一塊,可以看 RAG 白話理解與 AI 幻覺。
第二個,是推薦系統。你覺得 Spotify 推的歌、Netflix 推的片、電商推的商品「怎麼這麼準」,背後常常就是商品的向量跟你的向量算距離。把「喜歡這件衣服的人」跟「這件衣服」對到相近的向量空間裡,最近鄰就是推薦清單。
第三個,是企業內部搜尋與客服機器人。幾萬份合約、幾萬張客服工單,用關鍵字搜常常搜不到(因為員工跟客戶講話的方式跟文件裡寫的不一樣),改用向量搜尋可以靠語意把對的文件撈出來。
第四個,是搜尋與生成式問答系統。這類產品需要先找出候選來源,再組織答案;實際使用的檢索、排序與生成組合多半是專有系統,不能從外部斷言全都以同一套向量流程運作。向量檢索是可能採用的元件之一,也常與關鍵字檢索、排序模型及查詢擴展搭配。Karpukhin 等人的 Dense Passage Retrieval 研究證明,密集向量檢索可用於開放領域問答。至於內容是否被 Google AI Overviews 引用,沒有可保證的向量門檻或特殊 Schema。
別神化它:向量搜尋三個會讓你栽跟頭的限制
規劃 RAG 與內部搜尋時,常見問題不是向量搜尋完全不能用,而是把它期待成萬用解法。動手前要先看清楚三個限制。
限制一:它在看不懂的領域會突然變笨。embedding 模型是在某些語料上訓練的,當你把它搬到一個它沒見過的領域(比方說金融、醫療、法律這種高度專業、行話滿天飛的領域),它的向量會失準,把意思其實很不一樣的兩段話擺得很近。這個現象有個專門的詞,叫 out-of-domain,跨領域泛化一直是向量檢索最難治的病。Thakur 等人做的 BEIR 評測,就是把一堆向量檢索模型丟到十八個它們沒特別訓練過的領域去測,結果很殘酷:很多在訓練領域嚇嚇叫的模型,一換領域表現就掉下來,有些甚至被最陽春的 BM25 打敗,這是 Thakur 等人的 BEIR 評測得出的結果。換句話說,BM25 是一個出乎意料地難超越的基準線。
限制二:它對專有名詞、型號、數字很不靈光。向量擅長抓「語意」,但「iPhone 15 Pro」跟「iPhone 14 Pro」在語意上超級像(都是 iPhone、都是 Pro),向量距離會很近,可是對使用者來說這是兩台不一樣的手機。這類需要精確命中字面的查詢,反而是關鍵字檢索的強項。
限制三:它幾乎是一個黑盒子。前面提過,當向量搜尋回傳某個結果,你很難跟使用者或主管解釋「為什麼是這篇」。在需要審計、需要給出理由的場景(比方說為什麼推薦這支基金、為什麼這份合約被標為高風險),這個不可解釋性是個真實的麻煩。
跨領域、精確型號與解釋性都是需要評測的面向,並不代表每套系統都會失敗或都必須採混合檢索。可以先建立字詞與向量的基線,再確認融合是否帶來足以抵銷成本的改善。
何時值得使用混合檢索
當查詢同時涉及精確術語與語意改寫,可以比較字詞、向量及混合檢索的候選品質。混合檢索的一種做法,是分別取得字詞與向量候選,再以 RRF 等方法整合;也有其他融合與重排序方式。RRF 依各清單中的名次計分,是否適合仍須依語料、查詢與評測結果判斷。
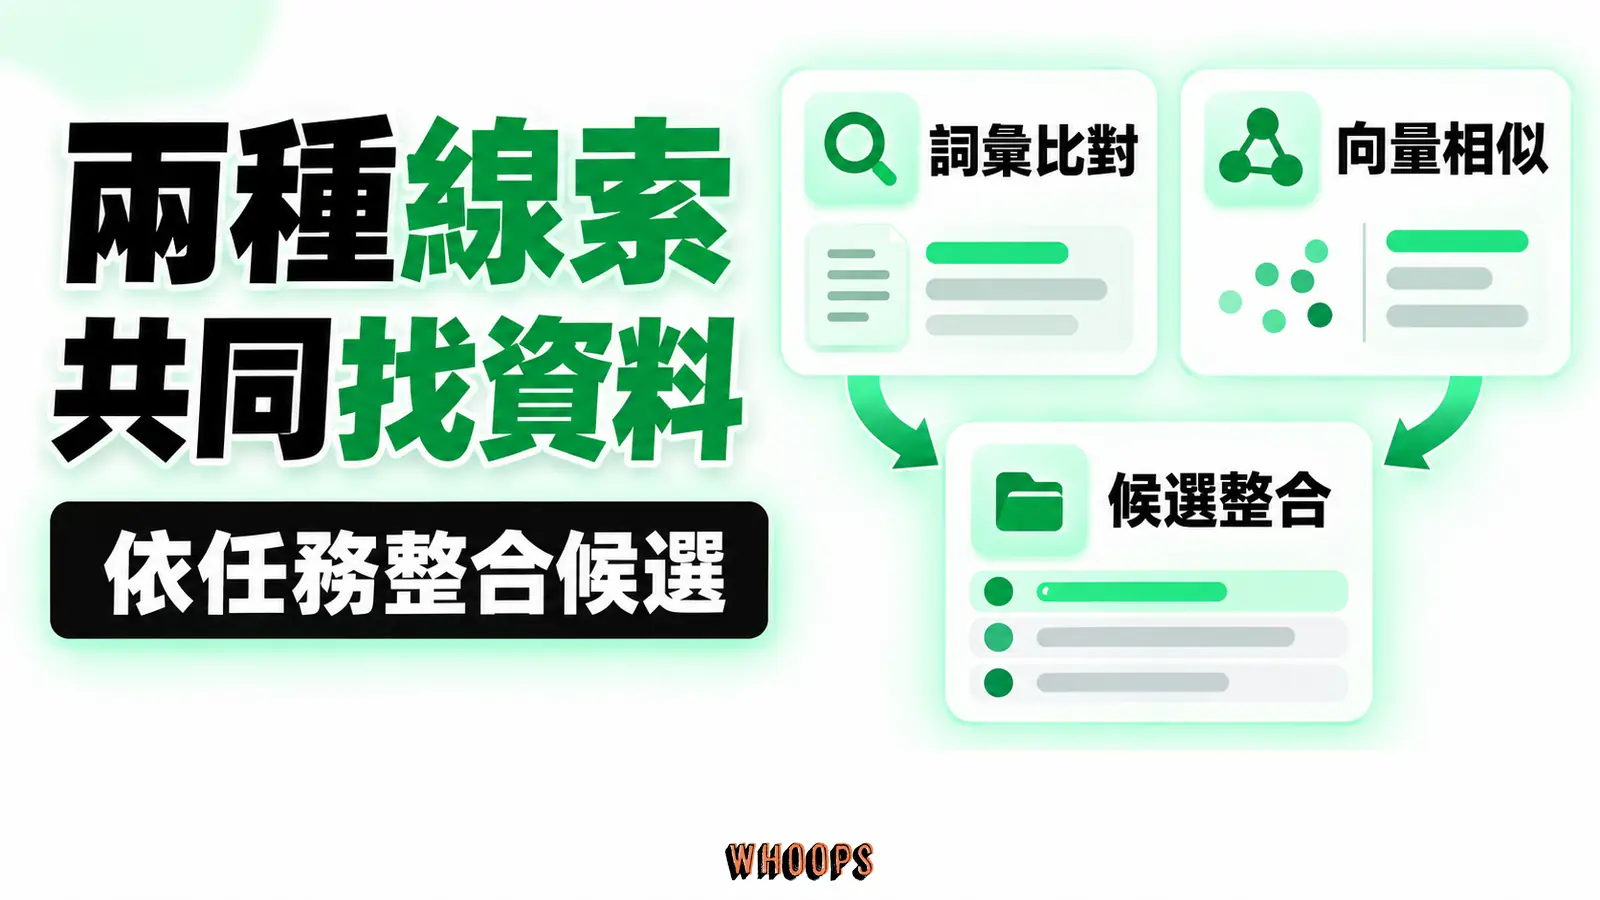
混合檢索有機會互補字詞和語意方法的盲點,但效果不是必然。BEIR 顯示不同檢索方法在各資料集上的表現有差異,不能把它解讀成所有場景都已證明「BM25 加向量最穩」。
成熟的工程管線通常還會再多掛一層 reranker。混合檢索先快速撈回幾十到幾百個候選(這一步求快,所以用 ANN),然後用一個更強、更慢的模型(往往是 cross-encoder)對這些候選逐一精算分數,重新排序,最終僅回傳前幾名。這個「先粗篩、再精排」的兩段式架構,可以用考試改卷來比喻:第一階段像初審,閱卷老師快速翻過幾百份考卷,憑印象先挑出幾十份「看起來有寫到重點的」;第二階段像複審,對這幾十份逐題細看、給精確的分數。最終交出去的,是複審後排名最前面那幾名。你會發現,向量搜尋在整套流程裡其實僅負責第一階段的「粗篩」,把它當成全部,是很多人對它最常見的誤解。
文件切塊如何影響向量檢索品質
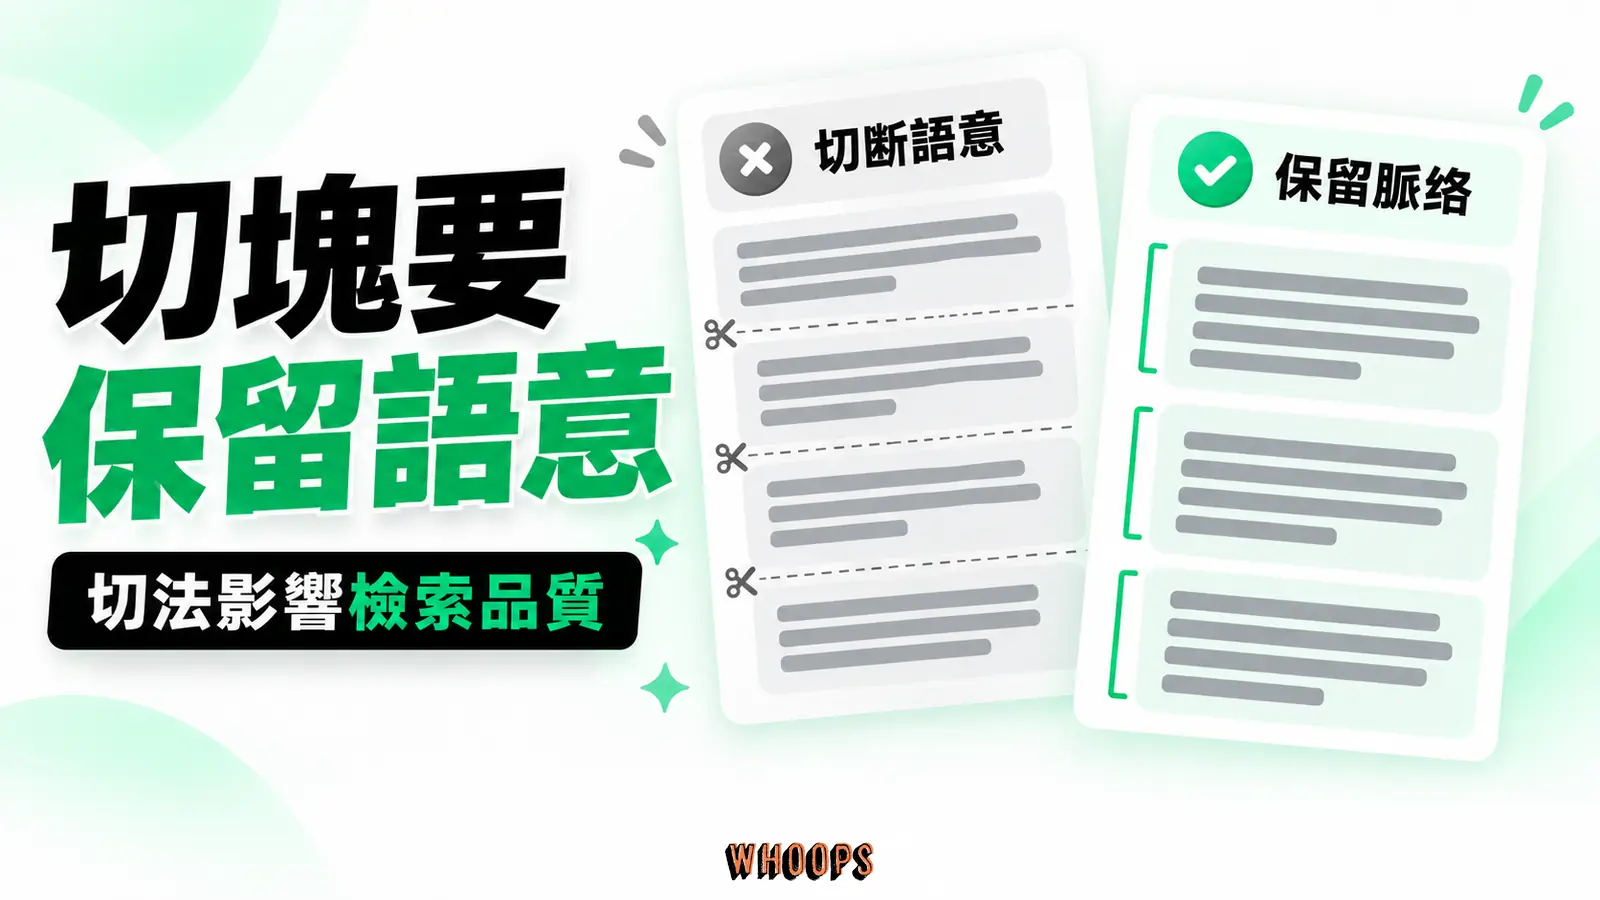
很多人以為向量搜尋的成敗全看模型好不好,實作過你就會知道,怎麼把一個長文件切成可檢索的小單位(這個動作叫 chunking),重要性常常不亞於模型選擇。
單一向量模型會把一段輸入壓縮成固定維度的表示,過長或混合多個主題時可能不利於匹配特定問題,也可能超過輸入上限。但向量不等於整篇文字的字面平均,多向量與長上下文模型也有不同設計;切塊大小應依所用模型與評測決定。
實務上常見的做法是「固定大小加重疊」:例如先選定一組以 token 或字數計量的大小與重疊量,再透過測試調整;數百字加少量重疊只是可試的起點,確保橫跨兩個單位的訊息不會被硬生生切斷。更進階的做法是「依結構切」,順著標題、段落、條列這些文件的天然邊界來分塊,讓每個單位在語意上是完整的。再講究一點,還會在每個小單位前面補一段「上下文摘要」(例如它屬於哪個標題底下),讓向量帶著一點出身脈絡。
還有一個很實用的進階手法,叫「小切大回」。檢索時用切得很小、很精準的單位去比對,確保撈回來的片段跟問題高度相關;但真正餵給模型生成答案時,把這個小單位周圍更大的上下文一起帶上去,讓模型看得到來龍去脈。一句話講:用小塊求準,用大塊求全。這個手法正好解掉了「切小了沒上下文、切大了不精準」的兩難,是現在成熟 RAG 系統很常見的設計。
調整 RAG 時,不要僅盯著換模型;chunking 策略也可能明顯改變檢索品質。向量搜尋是系統工程,模型僅佔其中一環,資料準備、切分、索引、過濾與 reranker 都要分別評測。
回到 SEO / GEO:向量相似度是候選檢索的一個環節
講到這裡,你可能會問:這些聽起來都是工程師的事,跟我做內容、做 SEO 有什麼關係?關係在於,部分生成式搜尋或站內檢索流程可能使用向量相似度挑選候選內容;但能否被檢索或引用,仍取決於可索引性、來源品質、時效、排序與生成規則等多項因素。
把整件事串起來看:生成式搜尋通常要先取得候選來源,再排序與生成答案;向量相似度可能參與其中,但不會是唯一規則。關鍵字匹配、頁面可索引性、來源品質、時效與其他排序系統都可能影響候選集合。想理解搜尋流程的骨架,可以先看 Google 搜尋引擎運作原理。
這對內容經營者有三個很實際的啟示。
啟示一:語意涵蓋比關鍵字密度更重要。在關鍵字時代,你會去算某個詞出現幾次、密度多少。在向量時代,更重要的是你的文章有沒有用讀者真正會用的各種說法,把同一個概念講完整。「冷氣不冷」「空調不冷」「冷氣吹不出冷風」可能指向同一需求,不必為了涵蓋同義詞而逐一重複。這其實就是另一個角度的 搜尋意圖 經營:應把問題、條件與答案交代清楚,不能保證增加各種說法就能提高向量相似度。
啟示二:結構清晰、資訊密度高的內容,在檢索這關更吃香。因為 reranker 階段會做更精細的段落級比對,把一個問題的核心答案講清楚、講在顯眼的位置,比用一堆空話把文章撐長更有用。這跟我常講的一句話一致:寫五千字每一句都有料,比寫八千字空洞的長文好太多了。
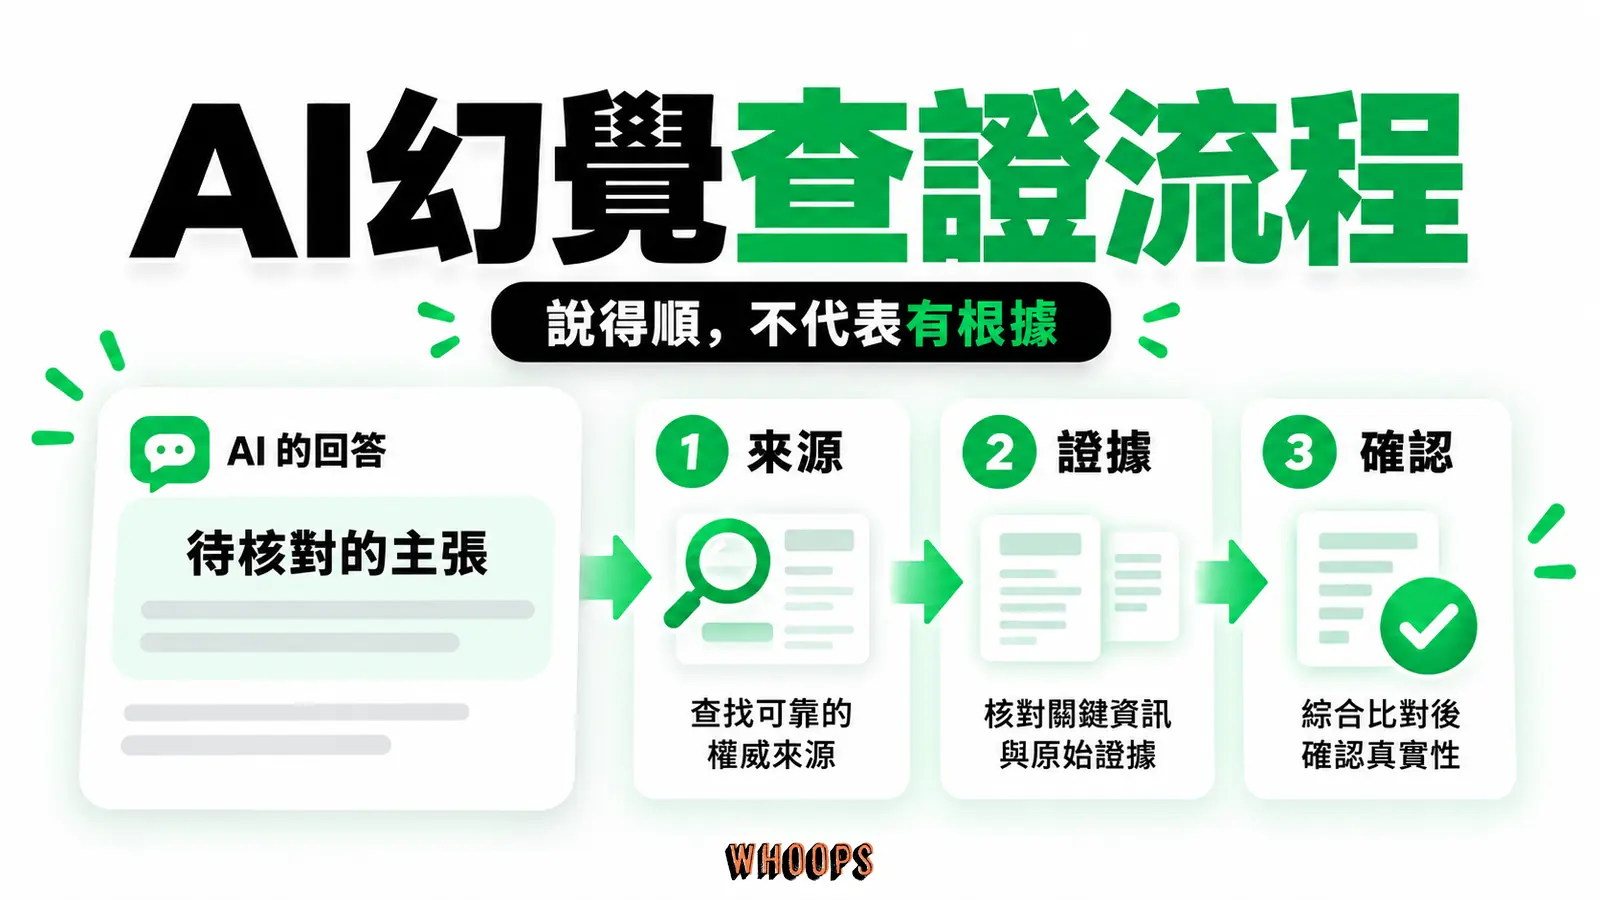
啟示三:可檢查性與來源品質仍重要。候選內容是否被引用,不會單靠向量相似度決定。清楚的來源、可驗證的聲稱、內容時效與頁面可存取性,都有助於系統與讀者判斷。這也是 Grounding(接地)與 GEO(生成引擎優化)常討論的範圍,但沒有任何做法能保證被引用。
把這三個啟示疊在一起,你會看到一個清楚的結論:在向量時代,內容工作的重心,從「命中某個詞」往「完整覆蓋某個意圖」移動了。這對認真的內容經營者其實是好消息,因為它獎勵的,正是過去白帽 SEO 一直在提倡的那件事:把一個主題真的搞懂、真的講透。
換個角度想,內容不僅要在字面上對得上查詢,也要把讀者真正關心的問題講清楚。這不代表你要去算向量或刻意塞入同義詞;更實際的做法,是用自然語言涵蓋同一主題的不同問題、條件與限制。主題叢集(Topic Cluster)仍可用來整理相關內容,但它不會自動形成所謂的「嵌入領地」。
對內容經營者而言,較穩妥的方向仍是把問題講清楚、標明可驗證來源,並避免用關鍵字堆砌空洞篇幅。檢索與生成系統如何挑選來源會持續改變,沒有單一寫法能保證曝光。
三個你可以今天就動手玩的向量搜尋工具
看完原理,最好的吸收方式是動手做一次。底下三個工具由淺到深,挑一個開始就好。
- sentence-transformers(Python 套件)。這是入門最友善的一條路。裝好之後,用三行程式碼就能把一批句子轉成向量、算出彼此的餘弦相似度。它支援多種預訓練嵌入模型,你可以親眼看到「我很開心」跟「我心情很好」的相似度,遠高於「我很開心」跟「天氣很冷」。小型模型與少量句子可先用 CPU 測試,資源需求依模型而異。
- FAISS(Meta 開源的向量檢索庫)。資料量增長後,可以用 ANN 索引加速,FAISS 提供多種索引與壓縮方法。延遲與召回率取決於索引選擇、參數、硬體及資料規模,需用自己的資料做基準測試。
- 向量資料庫與擴充。可比較託管服務、自行部署的向量資料庫及 PostgreSQL 的 pgvector。pgvector 是資料庫擴充,不是獨立託管服務,也不會自動替所有資料產生 embedding;模型呼叫、權限、混合檢索及維運功能須逐項核對。
我的建議是:就算你最終要用雲端方案,也至少先用 sentence-transformers 跑一次「文字變向量、向量算距離」的最小迴圈。你會對「向量搜尋到底在做什麼」有根深蒂固的體感,這份體感會跟著你讀所有後續的進階資料。
如果你是行銷人或內容人,完全沒碰過程式也別退縮。現在有不少免寫程式的工具,若把你的文件餵進去,它就幫你建好向量索引、給你一個可以問答的介面。用什麼工具不是最關鍵的,真正要緊的是你親自走過一次「內容變向量、向量被檢索」的完整流程,那份體驗會重新塑造你對內容價值的直覺。不少這類工具圍繞筆記軟體而生,想從自己的筆記庫開始,可以看Obsidian 筆記入門。
三個最常見的誤解,一次清掉
這篇文章收尾前,我把身邊行銷人、內容人最常對向量搜尋產生的三個誤解一次講清楚。
左右捲動檢視完整表格
| 常見的誤解 | 實際的情況 |
|---|---|
| 向量搜尋出現之後,關鍵字檢索就過時了 | 沒有。BM25 依然是極強的基準線,實務上多半是混合檢索,兩者並存 |
| 若用向量搜尋,搜尋品質就一定變好 | 不一定。換領域、遇到專有名詞時反而可能變差,BEIR 評測已證實 |
| 向量搜尋會取代 SEO,所以 SEO 不用做了 | 不會。它改變的是檢索機制,但「把一個主題講到最完整、最可信」的核心完全沒變 |
這三個誤解的共同點,都是把向量搜尋當成萬靈丹或終結者。它兩者都不是。它就是一個很會抓語意相似度的檢索方法,擅長解決某一批傳統方法解不好的問題,就這樣。
我會這樣建議你踏出認識向量搜尋的第一步
把這篇當起點,我會建議你照這個順序往下走,一步一步把這個領域摸起來。
- 先把對照組弄懂。回頭讀一遍 BM25 跟 TF-IDF,把「關鍵字檢索怎麼算相關性」吃進去。沒有這個對照,你不會真的懂向量搜尋補了什麼洞。
- 動手跑一次最小迴圈。用 sentence-transformers 把十來句話轉成向量、算相似度,親眼看到「意思相近的句子距離比較近」。這一步的體感,比你看十篇文章都管用。
- 把檢索放回它該在的位置。回頭看一次檢索在整個搜尋流程的位置,區分候選檢索與後續重排序,理解檢索本身也可能包含排序,向量搜尋僅是這一環裡的方法之一。
- 往上接到 AI 搜尋。接著閱讀 RAG 與 AI Overviews 對 SEO 的影響,理解向量檢索可能如何與關鍵字、排序與生成流程搭配,並避免把它誤當成引用的唯一決定因素。
- 回頭檢查你自己的內容。挑你網站上流量最高的一篇文章,用一般讀者的心情重新讀一遍:它有沒有回答讀者會問的不同情境與限制?補齊缺口比刻意堆同義詞更實用。
向量搜尋不是 SEO 的終結,而是 SEO 的進化。規則變了,但本質沒變:搜尋引擎的服務對象始終是人,它僅是多了一個更聰明的方法,去找到那個真的把一件事講清楚的人。你要做的,還是成為那個人。
說到底,向量搜尋教會我們一件事:當機器開始看得懂意思,它要找的就是真正懂那件事的人,光會塞關鍵字已經不夠用了。這是一個把內容經營拉回本質的訊號。你不必懂向量背後的數學,但你要懂這個方向:誰能把一個主題講到機器跟人都信賴,誰就會在這一輪搜尋典範轉移裡被留下來。
變化是唯一的不變。把這套新的檢索邏輯摸懂,你才能在 AI 搜尋的時代繼續被看見。