AI Agent 指令減肥:模型升級後的提示詞重審,該刪、該改、該留
模型升級後,為舊模型寫的防呆指令會從幫忙變成妨礙。本文以 OpenAI 與 Anthropic 官方建議為底,整理指令減肥工作流:三類盤點、去 SOP 化三段式、CLAUDE.md 與 AGENTS.md 重審,加上 A/B 驗證清單。
模型升級之後,最該跟著升級的其實是指示檔。過去一年為了讓舊模型穩定做完事而寫下的提醒、規則與逐步流程,在新模型上往往不再必要,有些還會直接妨礙工作:該自主完成的步驟一直停下來問、該結束的任務反覆跑測試、每次動手前都被逼著讀一疊與眼前任務不相干的文件。OpenAI 在 2026 年 9 月 11 日發布的開發者文章明白建議:換用 GPT-6 Astra 這一代模型時,重新檢視 AGENTS.md、skills 與任務提示詞,避免 context 膨脹;Claude Code 官方最佳實踐文件也反覆強調同一件事,指示檔要短,膨脹的指示檔會讓真正重要的規則被淹沒。把兩份官方建議整理成可操作的流程,就是這篇指南要交付的東西:一個「指令減肥」工作流,把累積的指令攤開,分成該刪、該改寫、該保留三類,把步驟清單改寫成目標與完成條件,再用固定任務集驗證減肥前後的行為差異。
先講一個會改變做法的條件:指令減肥的前提是模型真的變了,而且你有行為證據。判斷每一條指令的軸線只有一條,它是在補模型的短處,還是在描述你的世界?前者會隨模型升級過期,後者不會。「記得跑測試」補的是舊模型會跳過測試的短處;「不得直接部署到正式環境」描述的是你的世界裡不可逆的後果。刪錯類別的代價並不對稱:把領域知識當冗餘刪掉,模型會犯它原本不會犯的錯;把安全邊界當防呆刪掉,風險直接外露。所以這套流程把順序設計成先分類、再動刀,每一刀都要說得出理由,而且每一刀都留退路。
流程適用的載具涵蓋 Claude Code 的 CLAUDE.md 與 Skills、Codex 的 AGENTS.md,再加上 ChatGPT 的自訂指示,工具名稱不同,原理相同。文末有完整的升級後檢查清單,包含觸發時機、掃描方法與 A/B 驗證。文中引述的 OpenAI 與 Anthropic 官方文件,均以 2026 年 10 月查閱的版本為準。
為什麼模型升級後,舊指令反而開始妨礙工作
指令是為當時的模型寫的。回想這些規則當初為什麼出現:舊模型會跳過測試,所以你寫「記得執行測試」;舊模型曾經自作主張改了不該改的檔案,所以你寫「執行前一律先詢問」;舊模型讀懂含糊指示的成功率不穩,所以你把流程拆成一步一步的食譜,配上好幾個範例。每一條指令都在補一個具體的能力缺口,寫下它們的當下都是對的。模型升級之後,缺口補上了,這些規則的藥效還在,只是治病的對象消失了,副作用開始變成主戲。更麻煩的是,指令有累積傾向:每次模型出包就加一條規則,每次換專案就補一段說明,一年下來,指示檔變成一座博物館,每個展品都對應一個已經不存在的問題。
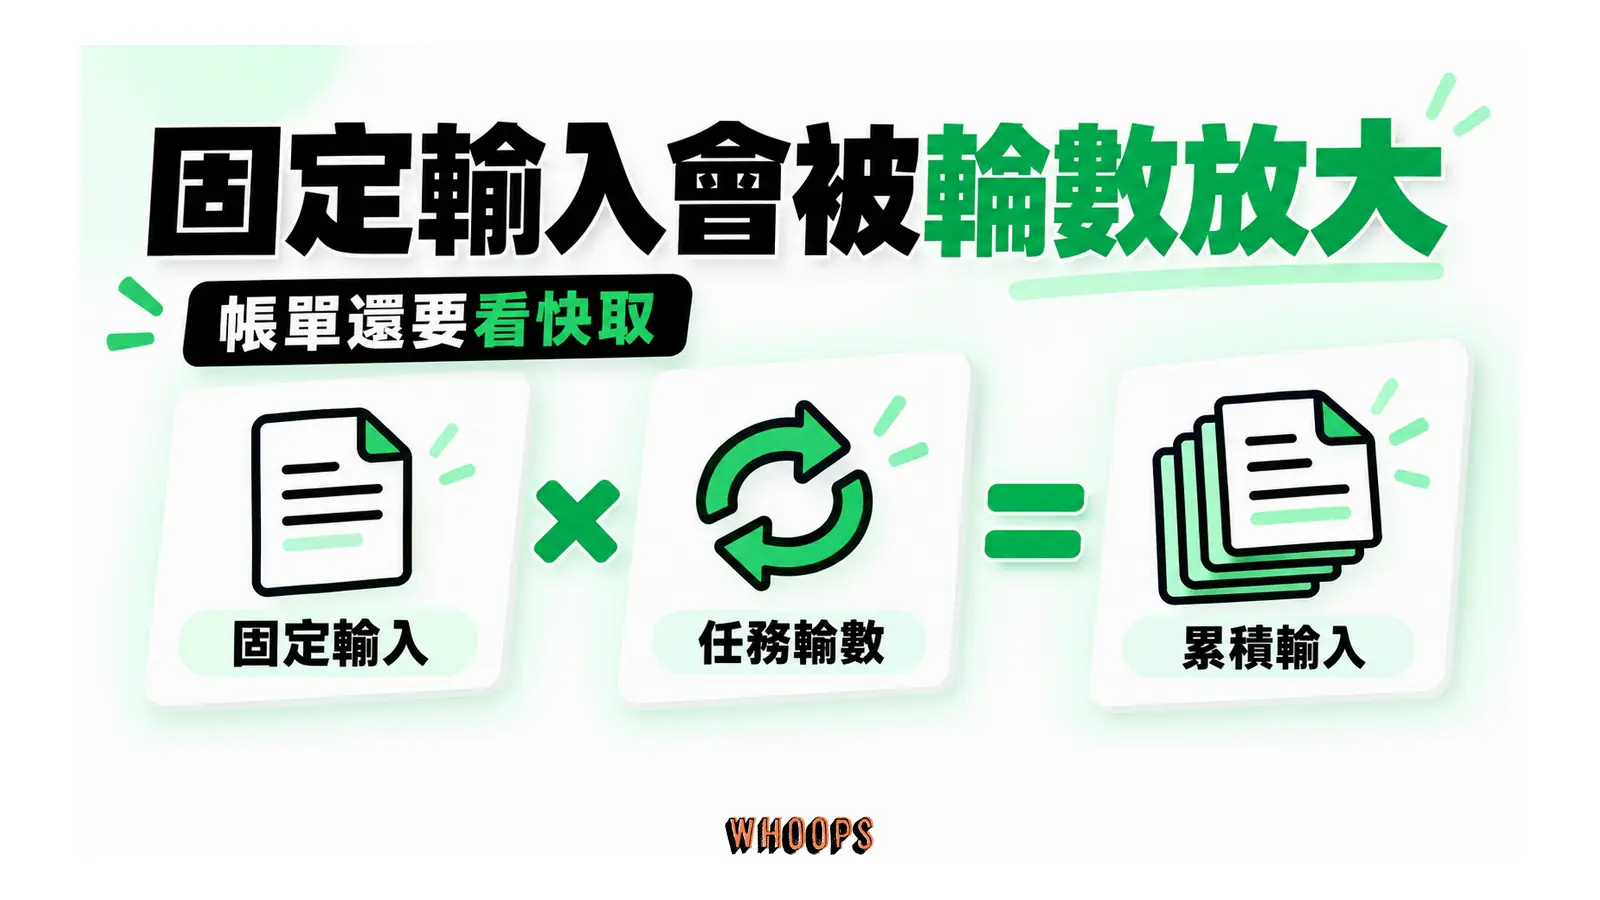
第一個害處直接反映在帳單上。CLAUDE.md 在 Claude Code 的每一場對話開頭載入,AGENTS.md 在 Codex 的每次儲存庫任務生效,skill 的名稱與描述常駐在模型的 context 裡。這些都是固定輸入:不管眼前任務改一個錯字還是重構半個系統,內容每一輪都重送一次。舉個示意計算:一份約 3,000 token 的指示檔,在一個跑 40 輪的任務裡就是 12 萬 token 級的輸入量,這還沒算 skill 描述與其他常駐內容。提示詞快取能壓低這筆成本,但快取靠前綴比對命中,你一編輯指示檔,變更點之後的快取就無法命中,而且快取折扣不等於免費。乘數效應先記住就好:指示檔的長度,會被任務輪數放大,帳要怎麼細算,後面成本一節會接手。
第二個害處更隱性:context 是有限資源,塞進越多與眼前任務無關的內容,真正重要的指令越容易被擠到邊緣,也越早觸發對話壓縮,把細節摘掉。這正是上下文工程要處理的問題:模型的注意力與容量都有限,內容的價值密度決定結果。OpenAI 在前述文章裡點出兩個具體機制。其一,skill 裝得太多的時候,Codex 會開始截短這些描述以騰出空間,而許多描述本身就寫得太長,模型看得到的資訊變少,挑錯 skill 的機率上升;描述之間互相矛盾、或過度誇大適用時機,也會讓模型載入對眼前任務毫無幫助的指示。其二,skill 被寫成鉅細靡遺的行程表或食譜,對舊模型是保險,對這一代模型反而可能妨礙:模型已經更能處理含糊與細微的指示,過度具體的綁縛限制了它的解題路徑。
第三個害處最容易被忽略,因為它看起來像模型變乖了。OpenAI 的觀察是:GPT-6 Astra 本身會主動跑測試、檢查自己的工作,留下舊提醒反而會造成不必要的重複測試;它對邊界的反應也更敏銳,如果你過去因為某個舊模型越權行事而寫下「未經確認不得繼續」這類重話,新模型可能把這句話執行得太徹底,在你其實樂意讓它繼續的地方提前停工。症狀看起來是退步:一直來問、做到一半就停、同樣的測試跑三遍。病因卻常常是你自己的指示檔。反方向也成立:如果它在需要你判斷的點位停得太晚,那是完成條件沒寫清楚的問題,後面去 SOP 化一節會一併處理。
當然,指令不會因為模型升級就集體過期。多數指示仍然有效,真正需要動手的是那批日期感最重的:為特定模型的行為寫的防呆、為特定弱點寫的流程、為特定專案階段寫的臨時規則。這也是為什麼減肥的第一步永遠不是刪,是盤點。
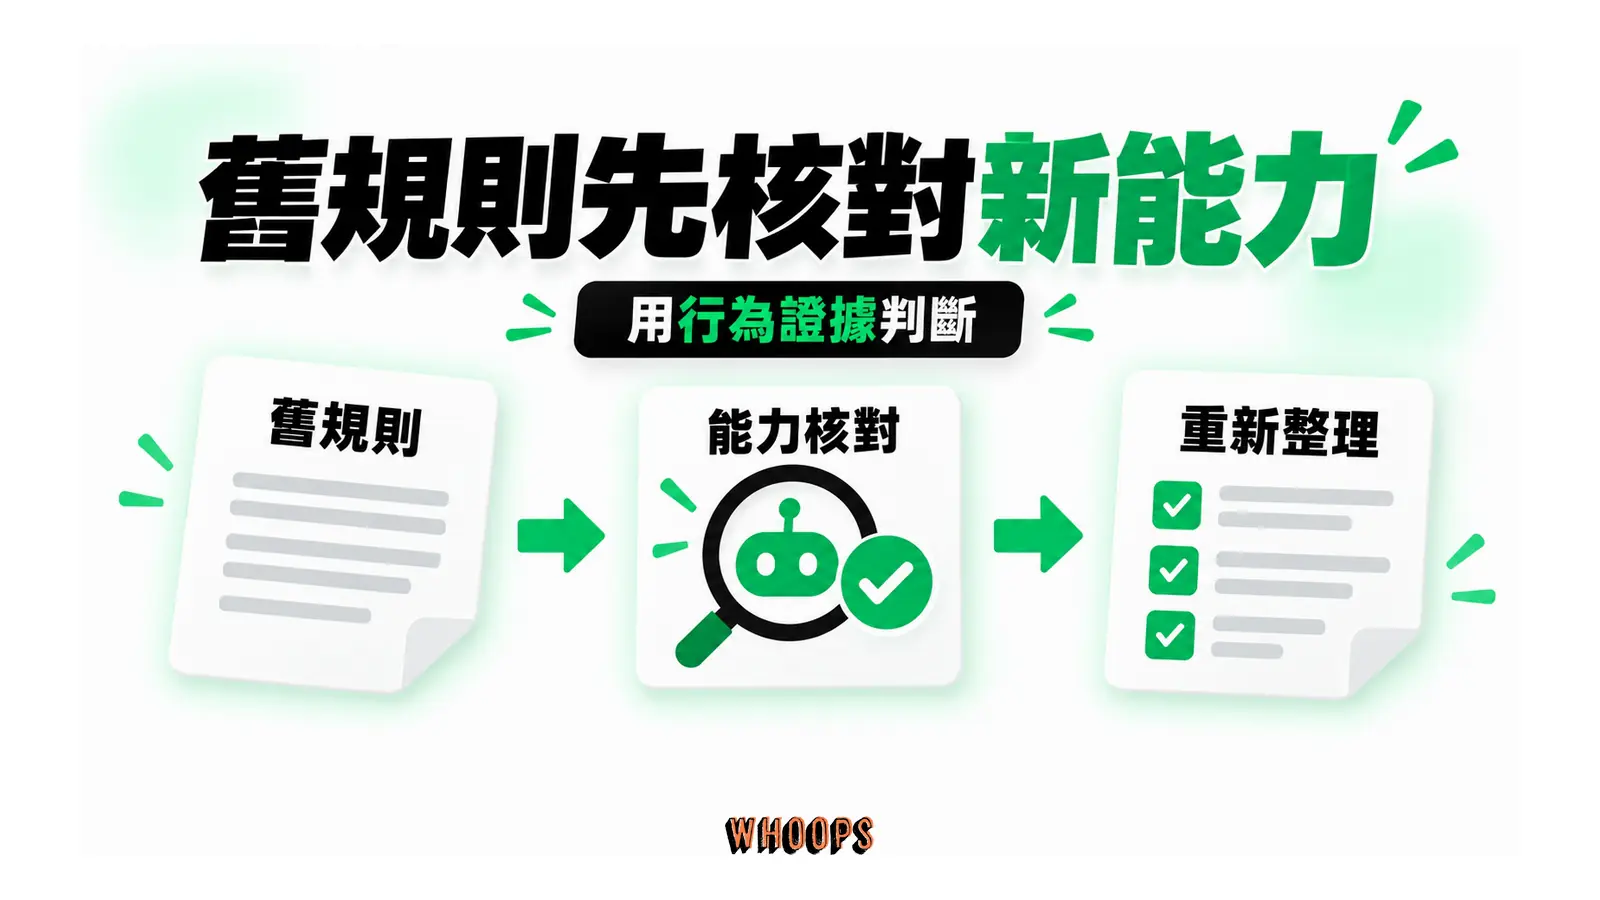
把「模型變了」講得再具體一點,因為它是整個流程的地基。可用的證據有三層。官方文件:OpenAI 專為 GPT-6 Astra 寫了前述建議,提示詞原則跟著模型世代更新,這件事本身就是模型行為已經改變的官方證詞。工具內觀察:同樣的任務在升級前後,中斷次數、追加指令的頻率、測試行為有沒有系統性差異。固定基準:幾個你熟悉到能盲評的任務,丟給新模型跑一次,看它預設停在哪裡、哪些事不再需要你提醒。三層證據指向同一個方向,減肥才有底氣;只有傳聞與焦慮,先別動刀。同時提防反向的衝動:看到官方建議就把指示檔砍到剩三行,行為當場退化,再把一切怪給新模型。減肥是手術,按圖譜下刀,圖譜就是下一節的三類盤點。
盤點三類:該刪的防呆、該改寫的邊界、該保留的知識
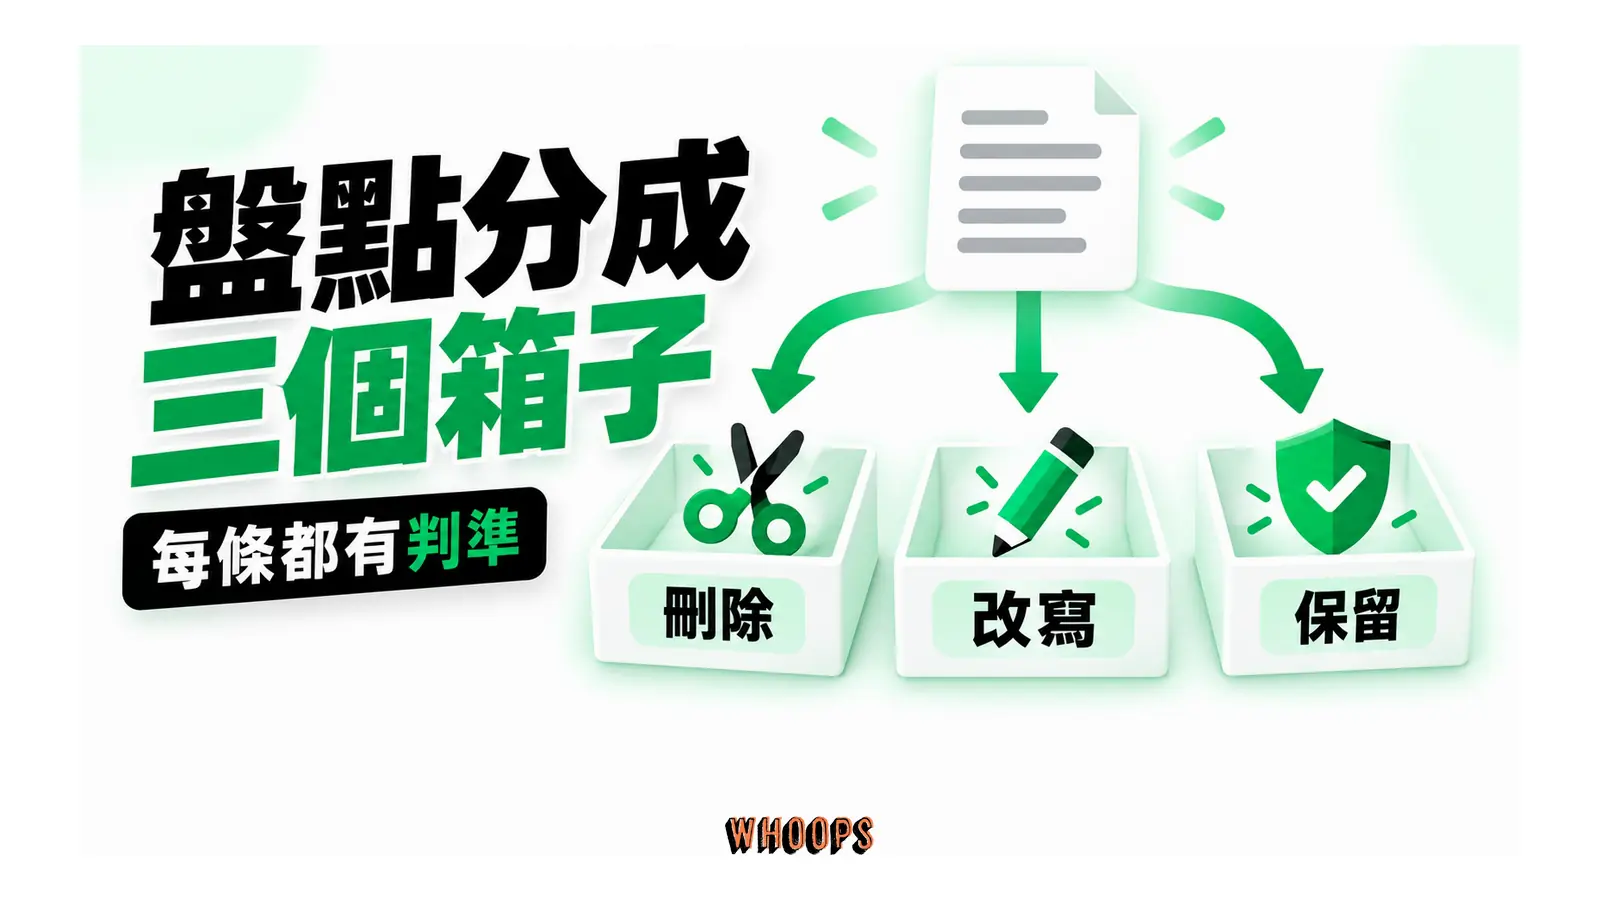
盤點的動作很樸素:把 CLAUDE.md、AGENTS.md、每個 skill 的描述與本文、常用的任務提示詞全部攤開,逐條問「這條指令在補模型的短處,還是在描述我的世界」,然後放進三個箱子。以下是三個箱子的判準、常見內容物,以及容易判斷錯誤的地方。
該刪:模型已經會做的事,不要再教一次
第一箱放能力提醒類的指令:「記得執行測試」「檢查執行結果」「確認實作是否正確」。這些是為會跳過測試的舊模型寫的,新模型多數已內建這個習慣,OpenAI 明說同樣的提醒會帶來不必要的測試與操作。刪除的判準不是模型宣稱它會,是你觀察到它在沒有提醒時也真的做了,這一點後面 A/B 驗證會用上。同一箱還有三種常見室友:可推斷知識,模型讀你的儲存庫就知道的事,例如專案結構、用了什麼框架,Anthropic 的建議清單把「可以靠讀程式碼得知的任何事」列為不該放進指示檔的項目;自明之理,像「寫乾淨的程式碼」「做好 SEO」這類沒有可操作內容的口號,對行為沒有約束力,只占空間;稀釋重點的強調,Anthropic 的文件有個很準的觀察,如果你在許多行都加強調,等於沒有一行被強調,把「重要」留給真正不能出錯的那幾行。
範例也常屬於第一箱。為舊模型準備的輸出範例曾經是把格式教會的最快方法,於是指示檔裡塞了三個五個樣本,每個都占行數。新模型對格式遵循的能力大幅上升,一段明確的格式描述常常比三個範例更省空間也更穩定。判斷方法一樣回到行為:拿掉範例跑幾次,格式仍然穩定,範例就退役;格式開始飄,先檢查你的格式描述寫清楚了沒,再考慮加回一個範例。範例的價值在於承載文字描述講不完的細節,當描述能講完,範例就只剩重量。
刪的時候留一個復原點:指示檔納入版本控制,刪掉的規則寫進提交訊息。觀察一兩週,行為沒有變差,這條就算真正退役;行為變差,你隨時知道少了什麼。
該改寫:把「一律先問」換成可自主的安全範圍
第二箱需要的手藝最多。兩種指令最常見:人工確認規則,與固定閱讀清單,兩種都有明確的改寫方向。
「執行前一律先詢問」「未取得確認不得繼續」的問題出在「一律」兩個字:它把高風險與低風險綁在同一個開關上。OpenAI 給的方向是把可以放心讓模型自己完成的範圍講清楚,官方範例是本地測試:測試環境用拋棄式資料、沒有正式環境的存取權,所以跑測試、修掉這次修改造成的失敗、重跑相關測試,都不需要逐步批准。整理成可套用的句式:
〔環境事實:這裡為什麼安全〕。
〔可自主的動作清單〕可以直接做,不需要逐步確認;
涉及〔高風險清單〕時,先停下來問。
句式的前半段是環境事實,這是成敗關鍵:你是在描述一個模型驗證得起的世界,靠語氣授權靠不住。「本地測試碰不到正式環境」是可以核對的事實,模型行動前能自己確認;「我相信你不會出事」是願望,出了事不構成邊界。高風險清單則要具體到動作層級:部署、資料庫遷移、刪除資料、發送對外訊息、建立計費資源,每一項都比「危險操作」四個字有用。改寫完做個反向檢查:把這段話拿給不看上下文的同事讀,對方能不能說出哪些事會發生、哪些事一定先問,答不出來就再改。
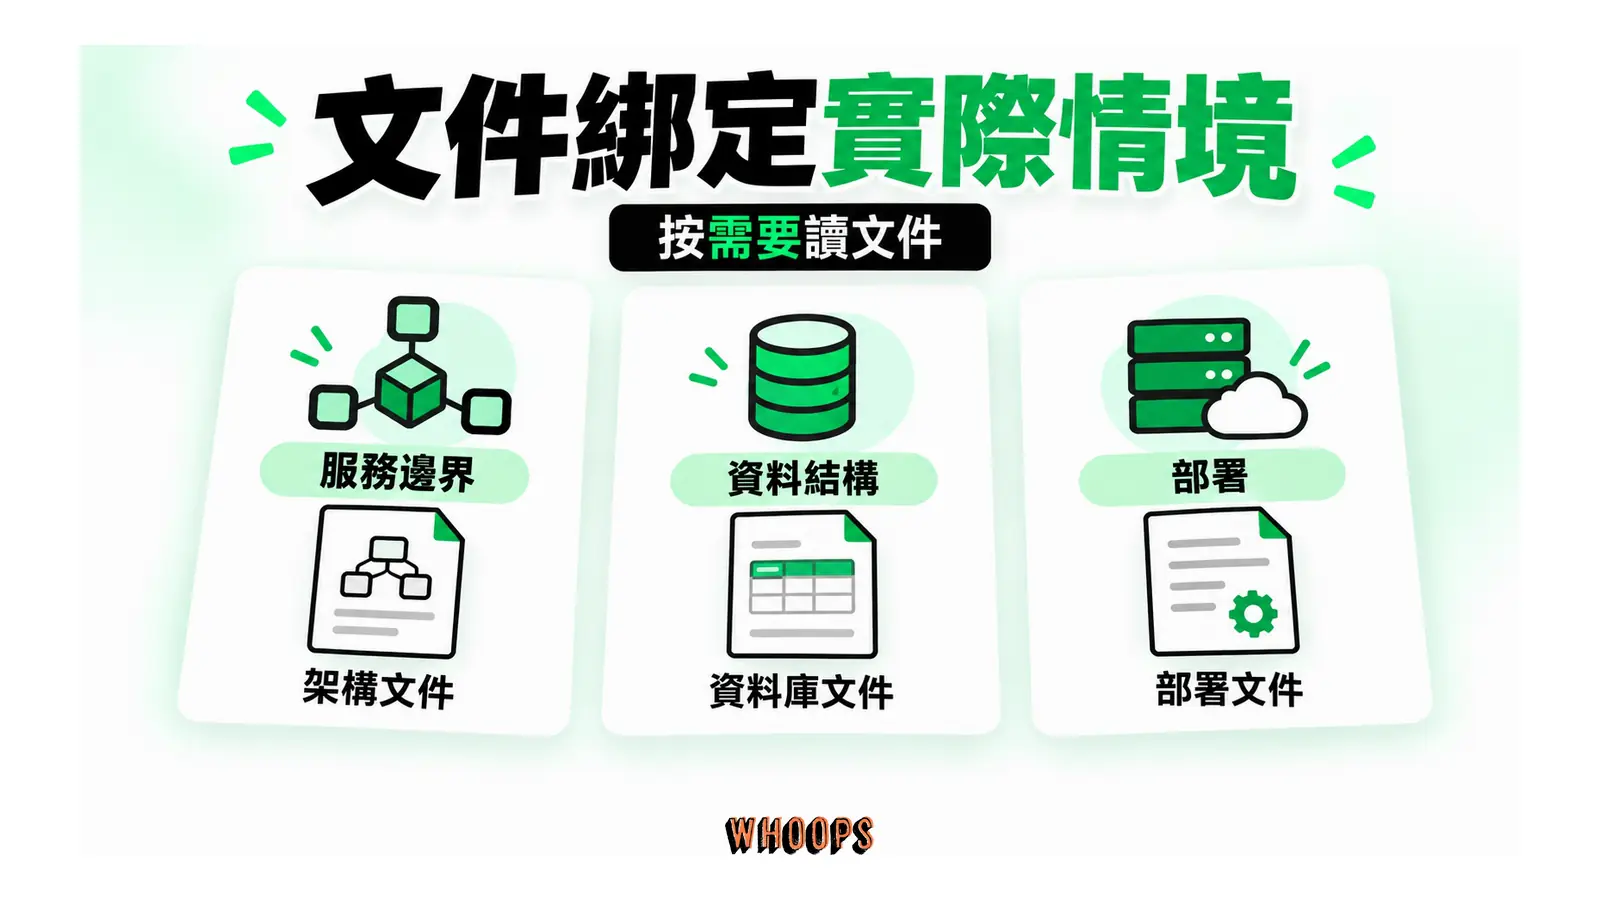
「每次修改前,都得先把 architecture.md 與 database.md、deployment.md 全部讀一遍」這種固定閱讀清單,OpenAI 評得很直白:改一個錯字也要先讀三份文件,是燒 context 又拖慢工作的好方法。改寫方向是把文件與情境綁定:涉及服務邊界時對照 architecture.md,動資料庫結構時查 database.md,準備部署時翻 deployment.md。模型自己會判斷眼前任務落在哪個情境,你要做的是把對應關係寫清楚。這條規則的另一半責任在你身上:文件本身要維持更新,過期的文件比沒有文件更誤事,OpenAI 在同一篇文章裡也提醒了這點。
還有一種改寫對象藏在你看順眼的句子裡:模糊的行為規則。「小心處理時間欄位」「注意效能」這類句子,對任何世代的模型都是猜謎,模型只能用泛用的謹慎回應你。改寫方式是換成可驗收的敘述:「時間欄位一律存 UTC,顯示層才轉時區」「列表頁查詢不得超過兩張表 join」。判準跟去 SOP 化剛好互為鏡像:步驟要鬆,規則要緊;怎麼做讓模型自己決定,做對做錯則要有明確的判準。
該保留:完成條件、硬邊界與領域知識
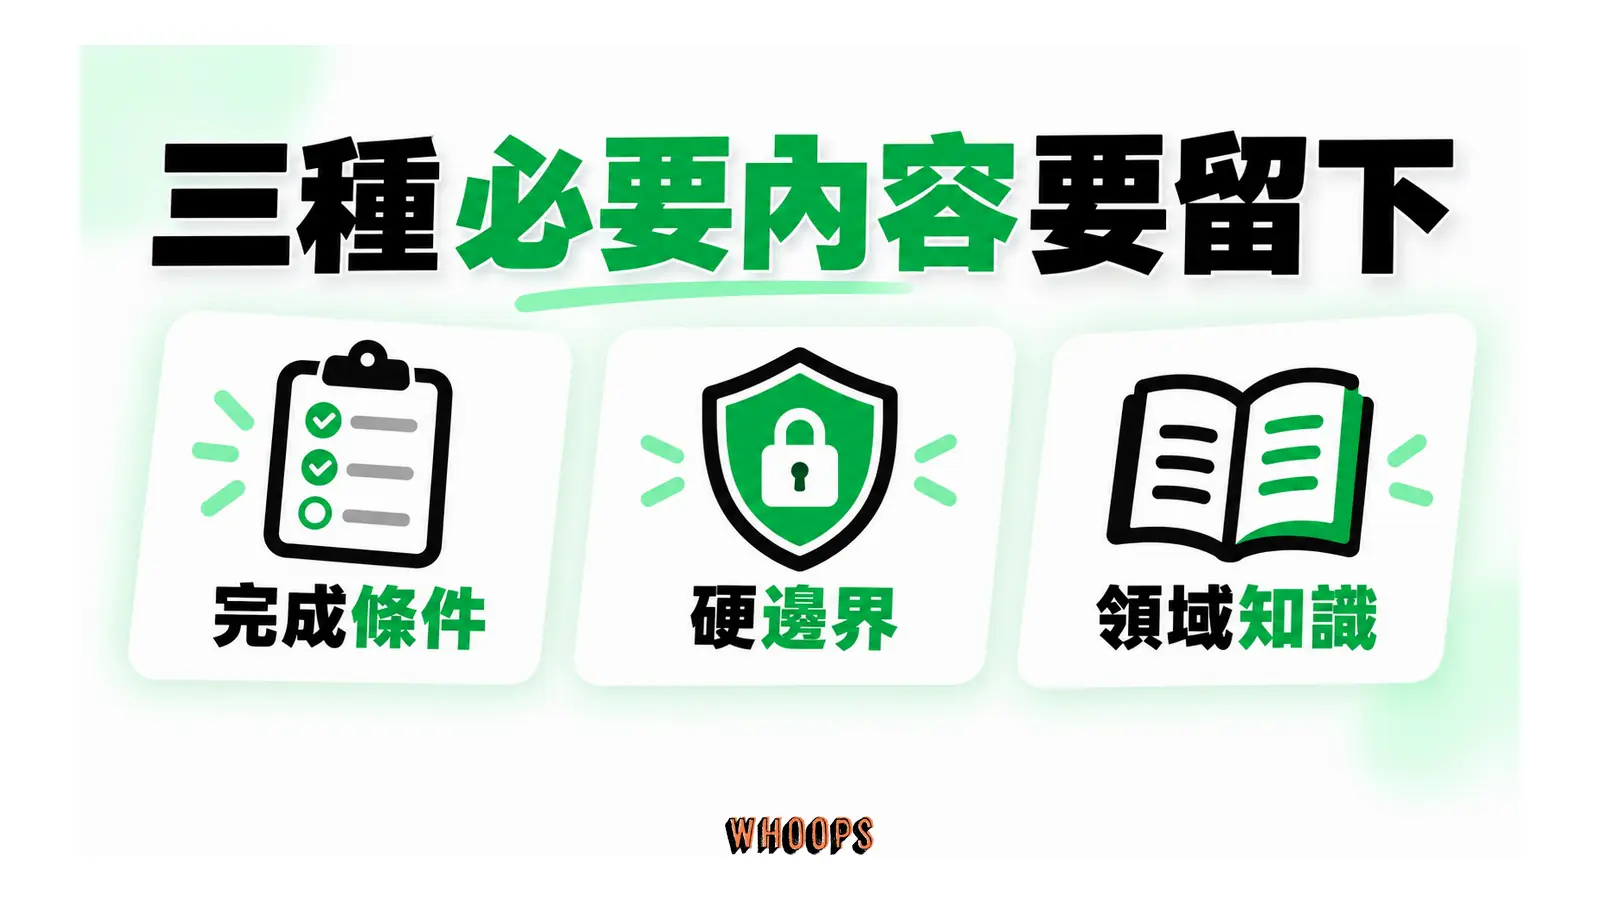
第三箱是減肥時一句都不能省的。完成條件,描述任務做到什麼程度才算完成、用什麼方式驗收;越新的模型越需要這條,因為它決定模型在哪裡停。硬邊界,防的是後果而非能力:安全、法規、生產環境、不可逆操作的限制,不管模型多強,你都不希望它直接把套件發布上線,這類規則沒有保存期限。更穩的強化手段是換機制:對「每次都要發生、零例外」的要求,Claude Code 的 hooks 是比文字更可靠的選擇,Anthropic 的文件明確區分了建議性的指示與保證執行的 hooks,文字給判斷,機制給底線。領域知識,模型無法從儲存庫推斷的事實與慣例:發票與統編的規則、產業用語的禁忌、某個內部系統的坑、你偏好的部署節奏。這些是你的指示檔裡最難被取代的部分,也是別人複製不走的部分。
三類的判準整理成一張表,盤點時對著放:
左右捲動檢視完整表格
| 類別 | 典型內容 | 判準 | 動作 |
|---|---|---|---|
| 該刪 | 測試提醒、可從程式碼推斷的知識、口號、氾濫的強調 | 補的是模型曾經的短處,現在已內建或可推斷 | 刪除,提交訊息留紀錄,觀察一兩週 |
| 該改寫 | 一律先問、固定閱讀清單、模糊的完成描述 | 方向對但粒度錯,把開關換成範圍 | 改寫成環境事實+可自主清單+高風險清單,或情境綁定 |
| 該保留 | 完成條件、硬邊界、領域知識、猜不到的指令 | 描述的是你的世界,與模型能力無關 | 保留,必要時換更強的機制(權限、hooks) |
盤點走完,通常會發現真正該刪的是少數,多數指令要嘛保留、要嘛改寫,實際比例以你的 A/B 行為驗證為準。這個比例本身就是安慰劑解毒劑:指令減肥的目的從來不是把檔案清空,是讓剩下的每一行都有存在的理由。
去 SOP 化:把步驟清單改成目標、限制與完成條件
盤點處理單條指令,去 SOP 化處理整份文件的形態。許多 skill 與工作流程文件被寫成食譜:第一步做這個、第二步讀那個、第三步檢查什麼,一步一步排到結尾。這種寫法對舊模型是必要的柵欄,對這一代模型卻常常變成軌道:模型已經更能判斷中間步驟,你釘死的路徑反而排除了更好的走法,而且路徑一長,任何一步的假設過期,整份文件就跟著失準。OpenAI 給的方向有兩條:少寫鉅細靡遺的行程表,並且在開工前先把完成狀態定義清楚。把這個方向整理成可以直接套用的格式,本文建議三段式:目標、限制、完成條件。
整理成三段式,每一段都有明確的功能:
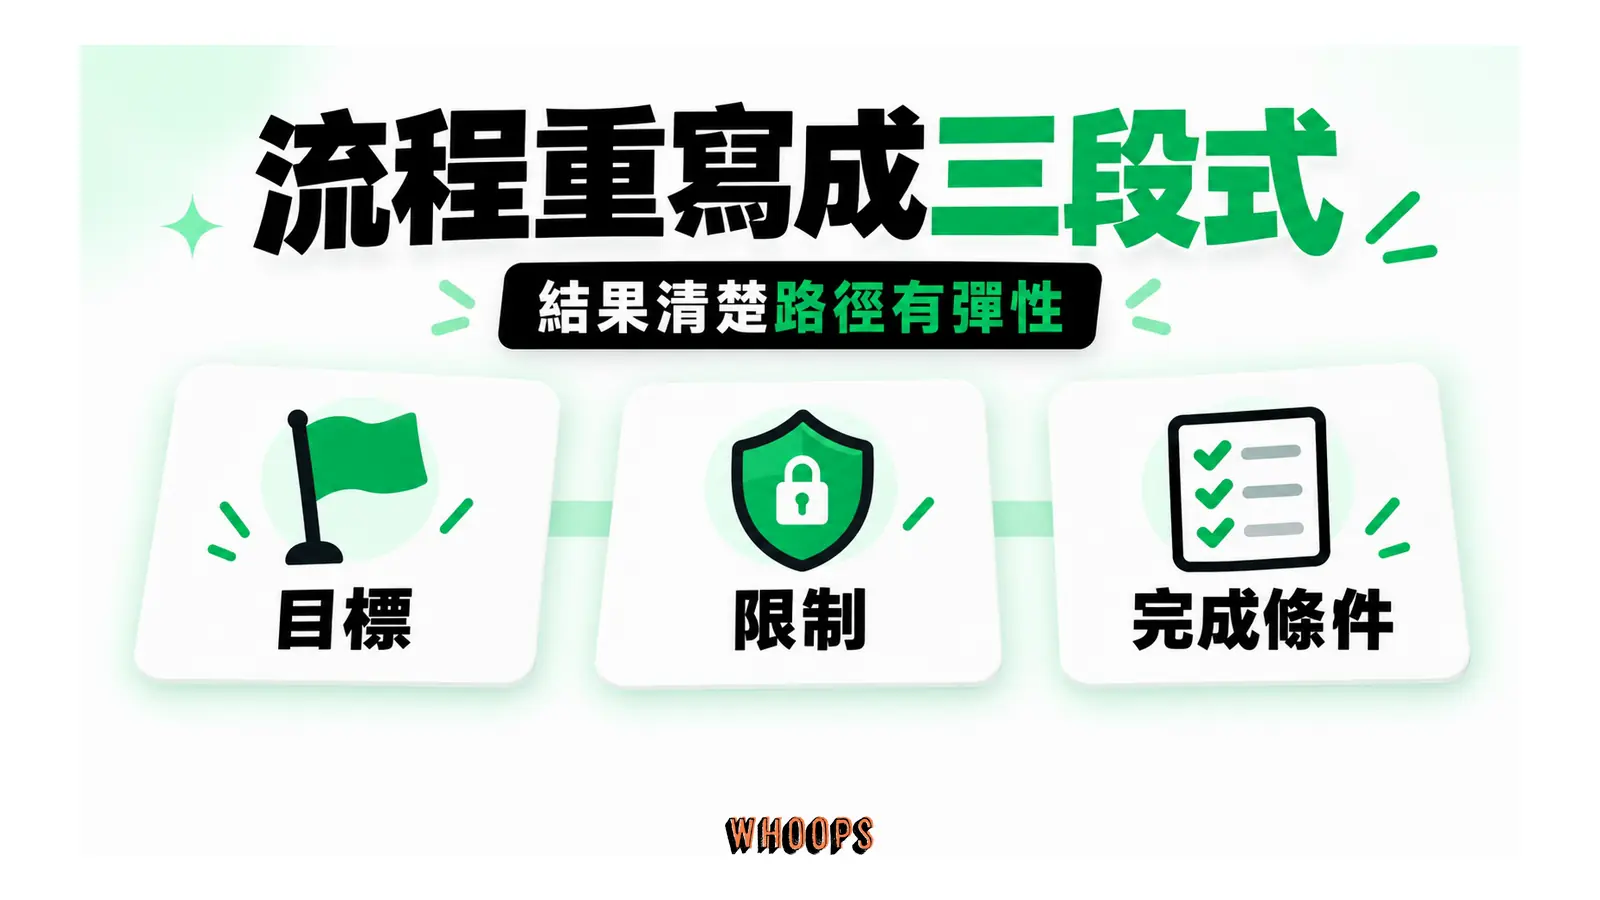
- 目標:任務完成時,世界應該長什麼樣子。寫成可觀察的狀態,例如「建置通過且新頁面出現在輸出裡」,而「把品質做好」不算目標,算心情。
- 限制:不能碰什麼、必須用什麼、預算與邊界在哪。這一段承接盤點出來的硬邊界,是三段裡最不能省的。
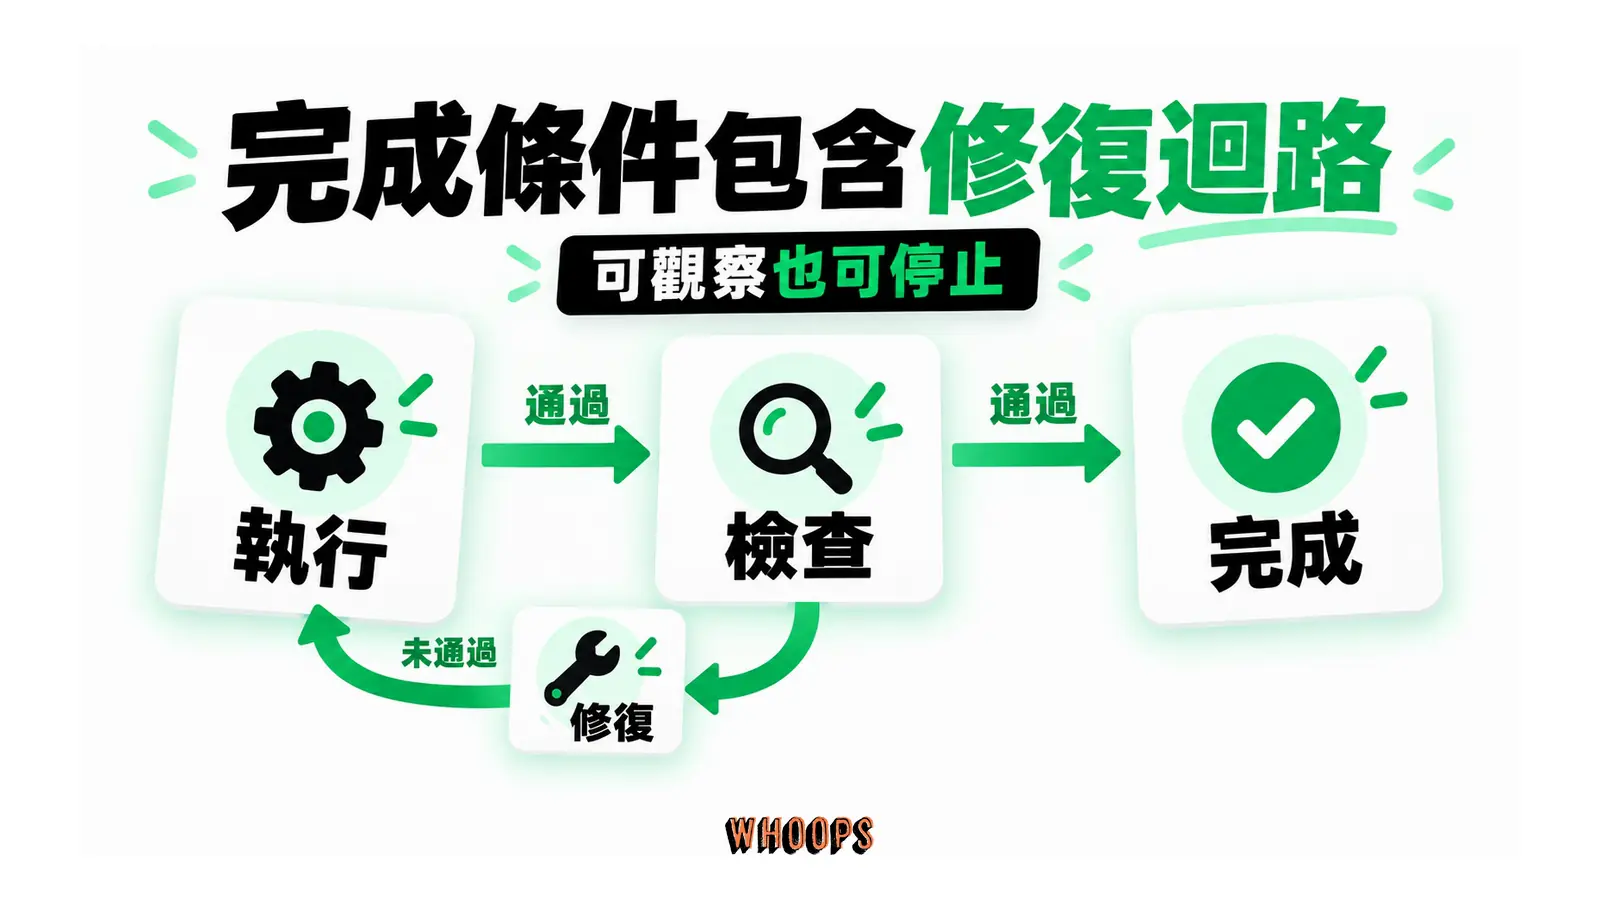
- 完成條件:怎麼驗收、出現什麼信號可以停。包含修復迴路:「修到全部通過再回報」,把 iterate 的權利交給模型。
用一份內容發布流程的 skill 當例子,看改寫前後的差異。食譜版的長相通常如此(示意):
1. 檢查文章內文沒有 h1
2. 檢查所有內部連結都指向存在的頁面
3. 執行建置
4. 檢查建置輸出有沒有錯誤
5. 有錯就修,修完再建置一次
6. 確認頁數比前次多一頁
7. 回報結果
三段式改寫後:
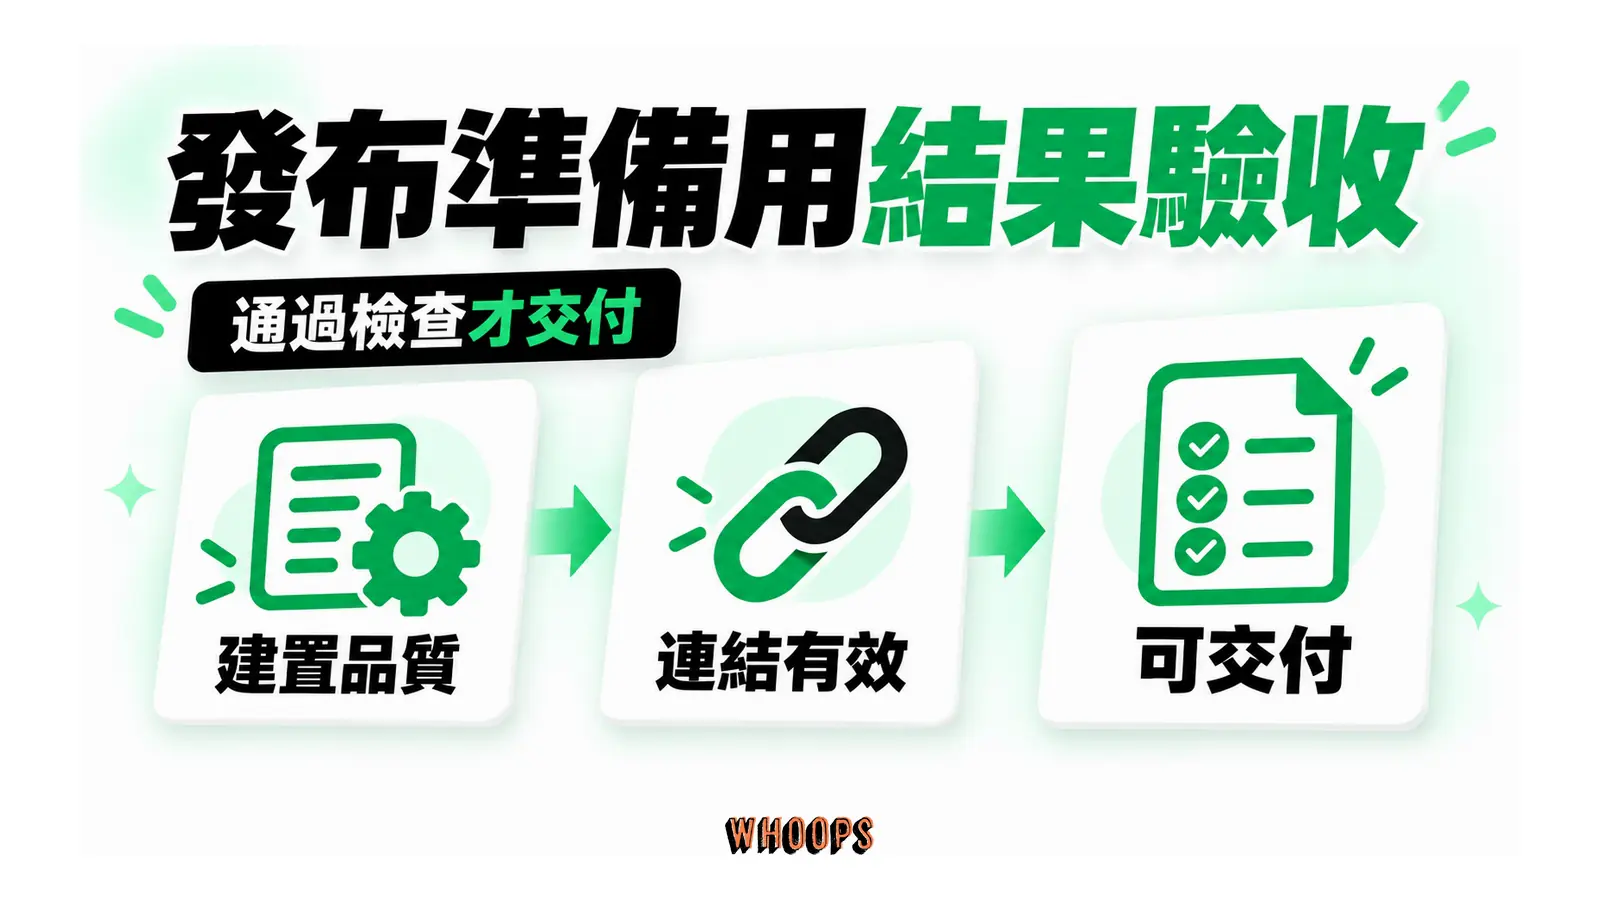
目標:新文章達到可部署狀態。
限制:不得修改既有文章;不得變更共用版型;不得略過建置。
完成條件:建置與品質閘門全數通過、總頁數較前次增加、
內部連結全部有效;任何缺陷修到零再回報。
資訊量沒有變少,變少的是順序的綁縛。食譜版把「跑建置」釘在第三步,模型遇到「建置發現內文有 h1」時只能照步驟走下去;三段式把偵測、修復、重跑整個迴路包進完成條件,模型自己安排順序,你在意的結果被釘死,路徑留白。這正是新模型擅長發揮的空間。
完成條件的寫法值得多花兩分鐘。它要可觀察,信號是看得到的:閘門通過、頁數增加、測試全綠;要可停止,模型讀完知道自己什麼時候能停;要包含修復迴路,把「如果出錯請處理」換成「修到通過為止」。OpenAI 對 Astra 世代的觀察是它傾向早停:做出第一版就回來等你,即使還有明顯的收尾工作。把「實際執行、檢查結果、修正問題、直到功能正常運作」寫進完成條件,就是對早停傾向的直接解法。反向的誠實檢查也做一下:如果你的流程確實需要在第一版停下來人工審核,那就明說「完成第一版後停止,等待審核」,這是合法的完成條件。OpenAI 的提醒只在於,要求第一版後停下來的敘述會把模型拉向更早的停止點,確認那是你真正要的決策點再寫。
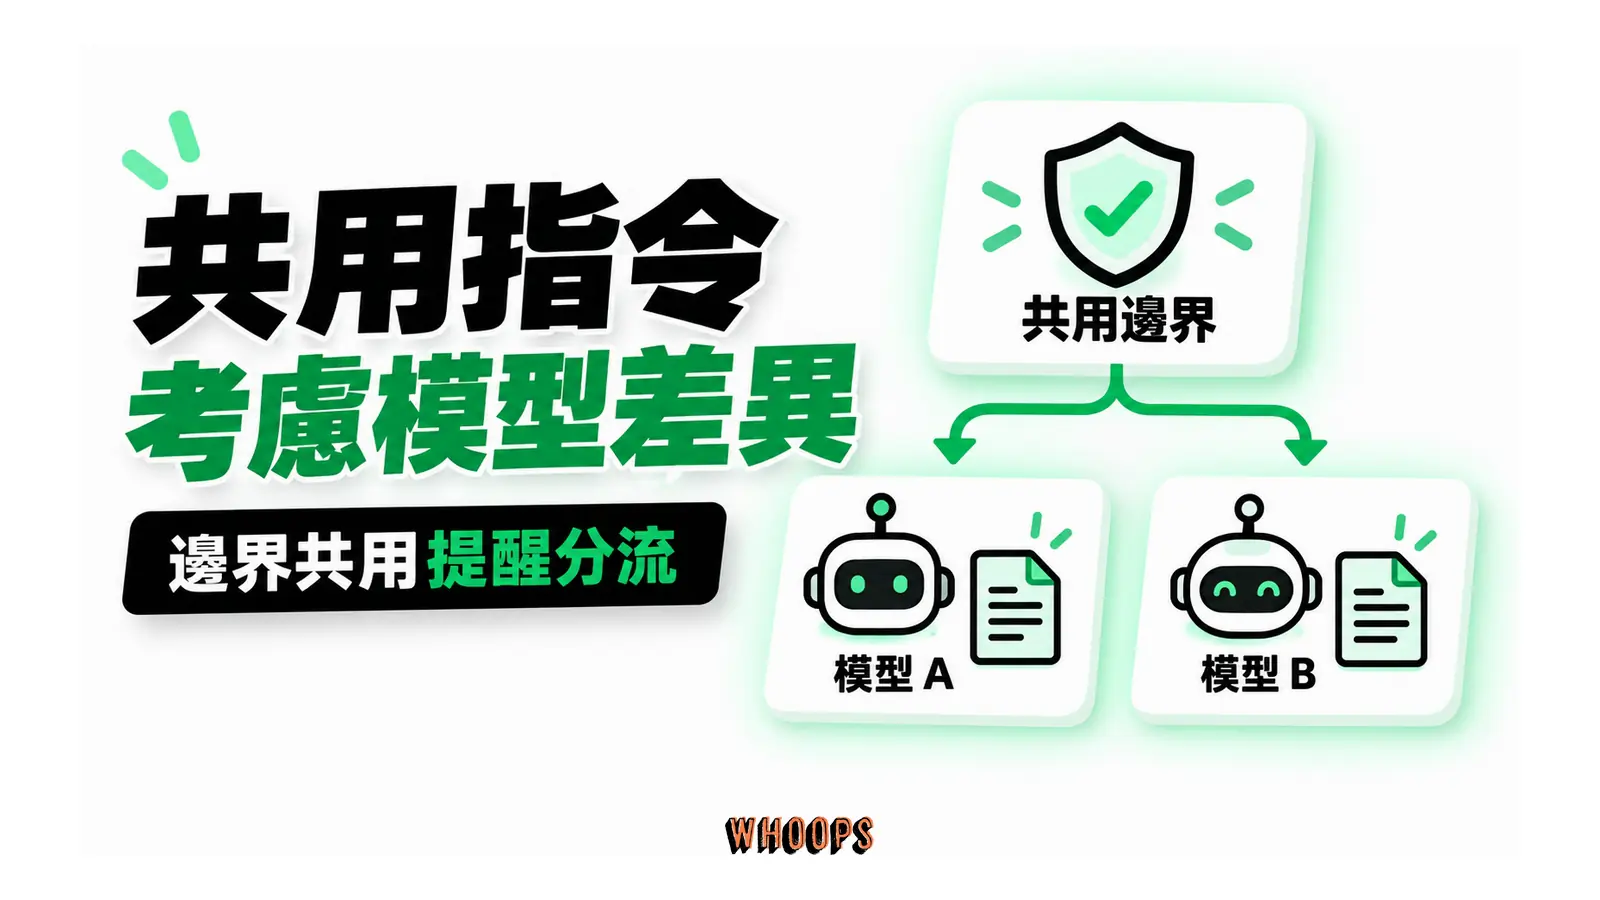
還有一個多人協作下的特殊考量:儲存庫裡的 skill 與 AGENTS.md,讀者包含其他貢獻者的 agent,而那些 agent 可能用著不同世代的模型。OpenAI 點名了這個問題:對 Sol 或 Luna 有幫助的指引,可能過度約束 GPT-6 Astra。所以改寫時心裡要有一份讀者名單,你的指示檔會被哪些模型讀到?團隊同時跑新舊模型時,可以在硬邊界之外對「為某代模型寫的防呆」加註適用範圍,或乾脆按模型分流檔案,避免一套規則伺候所有世代。
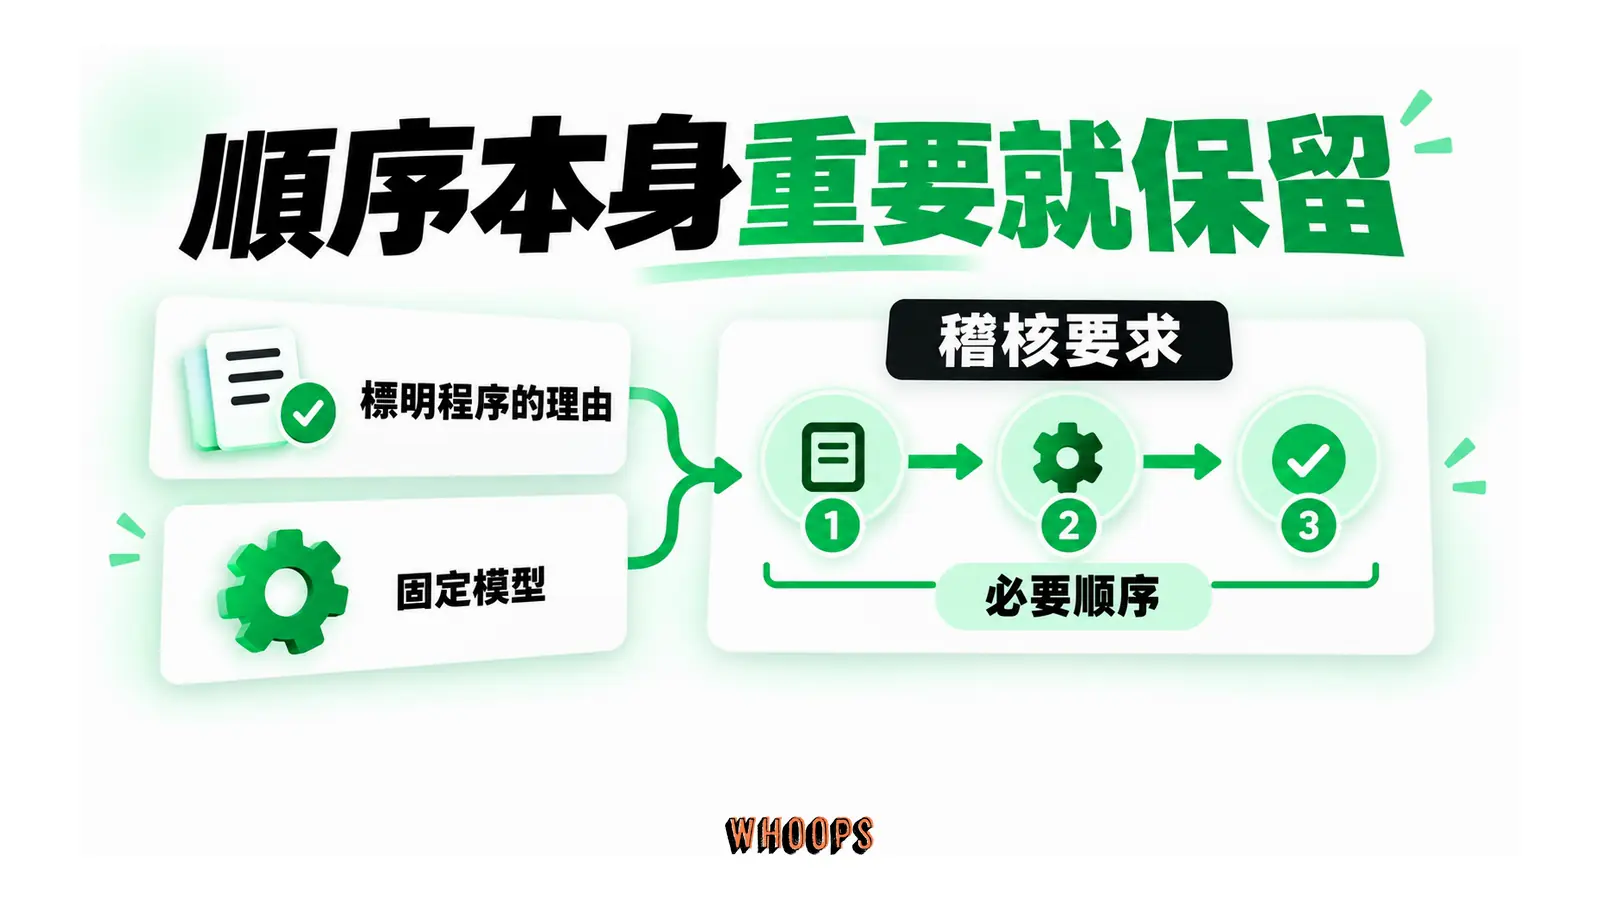
去 SOP 化也有邊界,兩種情況下逐步流程仍然是正確形態。法遵與稽核場景:每一步都要留下可查核的紀錄,順序本身就是產品的一部分,把它交給模型自由發揮等於放棄稽核軌跡。釘住模型的場景:你的任務跑在被固定的舊模型、或因成本考量選定的小模型上,它的中間步驟判斷還不到能放手的程度,食譜就是它的柵欄。判斷方法回到三類盤點的軸線:這份 SOP 在補模型的短處,還是在滿足你的世界對流程的要求?後者保留並標明理由,前者排隊等下一次升級。
Claude Code 使用者:CLAUDE.md 與 Skills 的重審方法
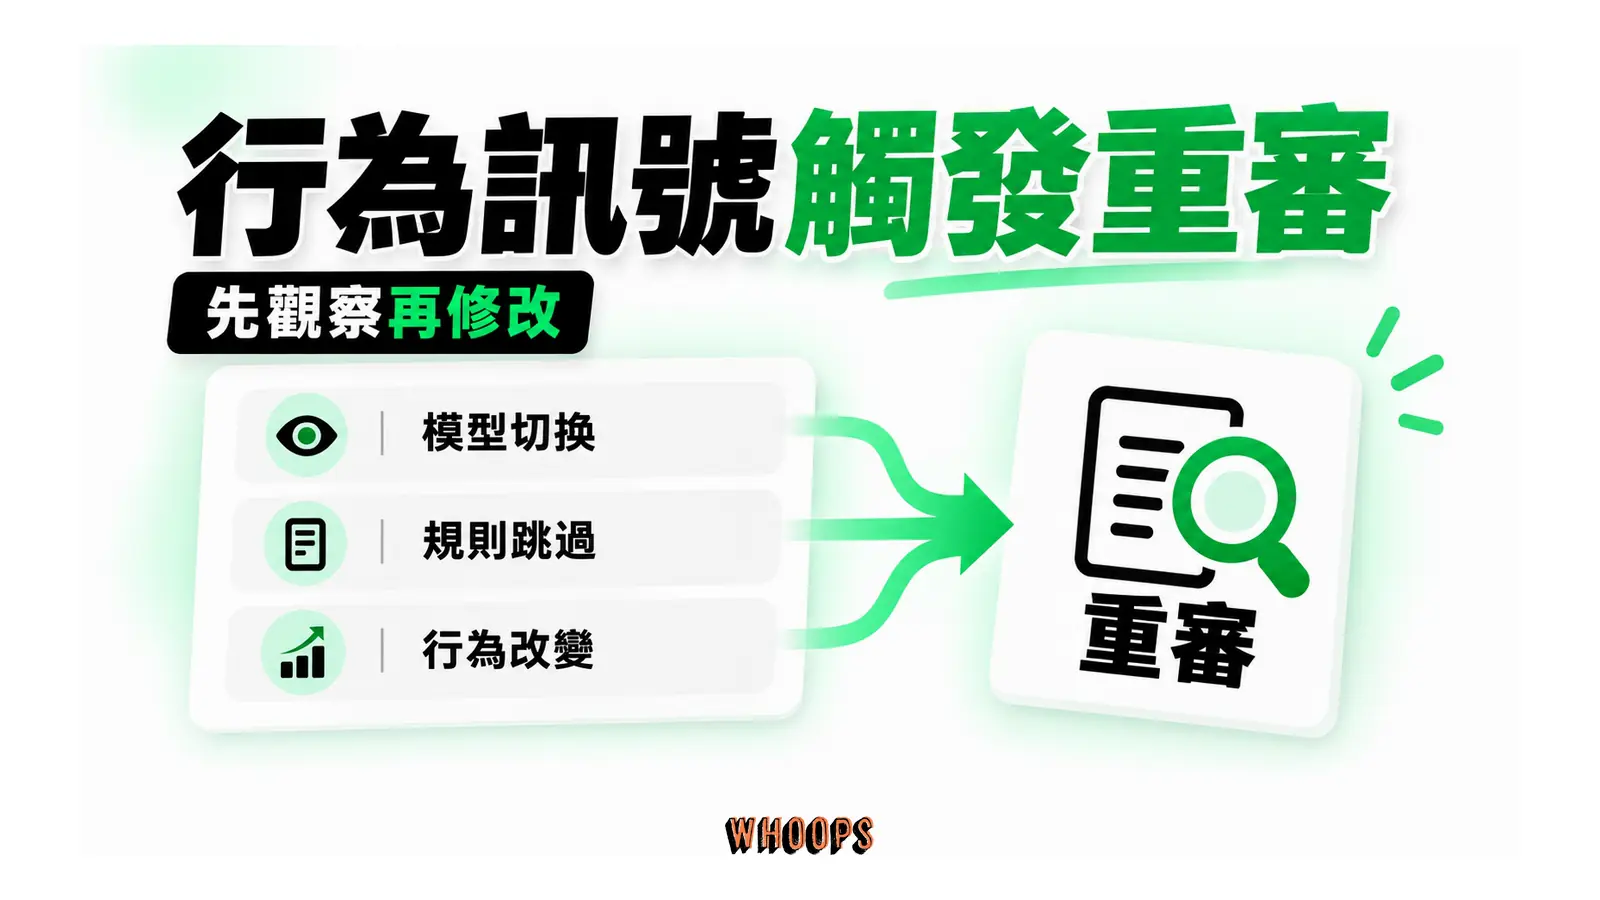
把通用流程落到 Claude Code,重審對象有兩個:CLAUDE.md 與 Skills。先講時機,官方文件的診斷訊號比日曆可靠。第一個訊號是模型切換:Claude Code 換了預設模型、或你主動改用新一代模型時,指示檔的假設就跟著需要重檢。第二個訊號是規則被跳過:Claude 明知有規則還是做了不該做的事,Anthropic 的診斷是檔案可能太長、規則在雜訊裡被淹沒。第三個訊號是反問已答的問題:Claude 拿 CLAUDE.md 已經寫過的事來問你,通常是那條敘述的措辭含糊,模型無法把它對應到當前情境。第四個訊號是行為改變:早停、過度測試、頻繁確認,這些在指令減肥的脈絡下都該先懷疑指示檔,再懷疑模型。
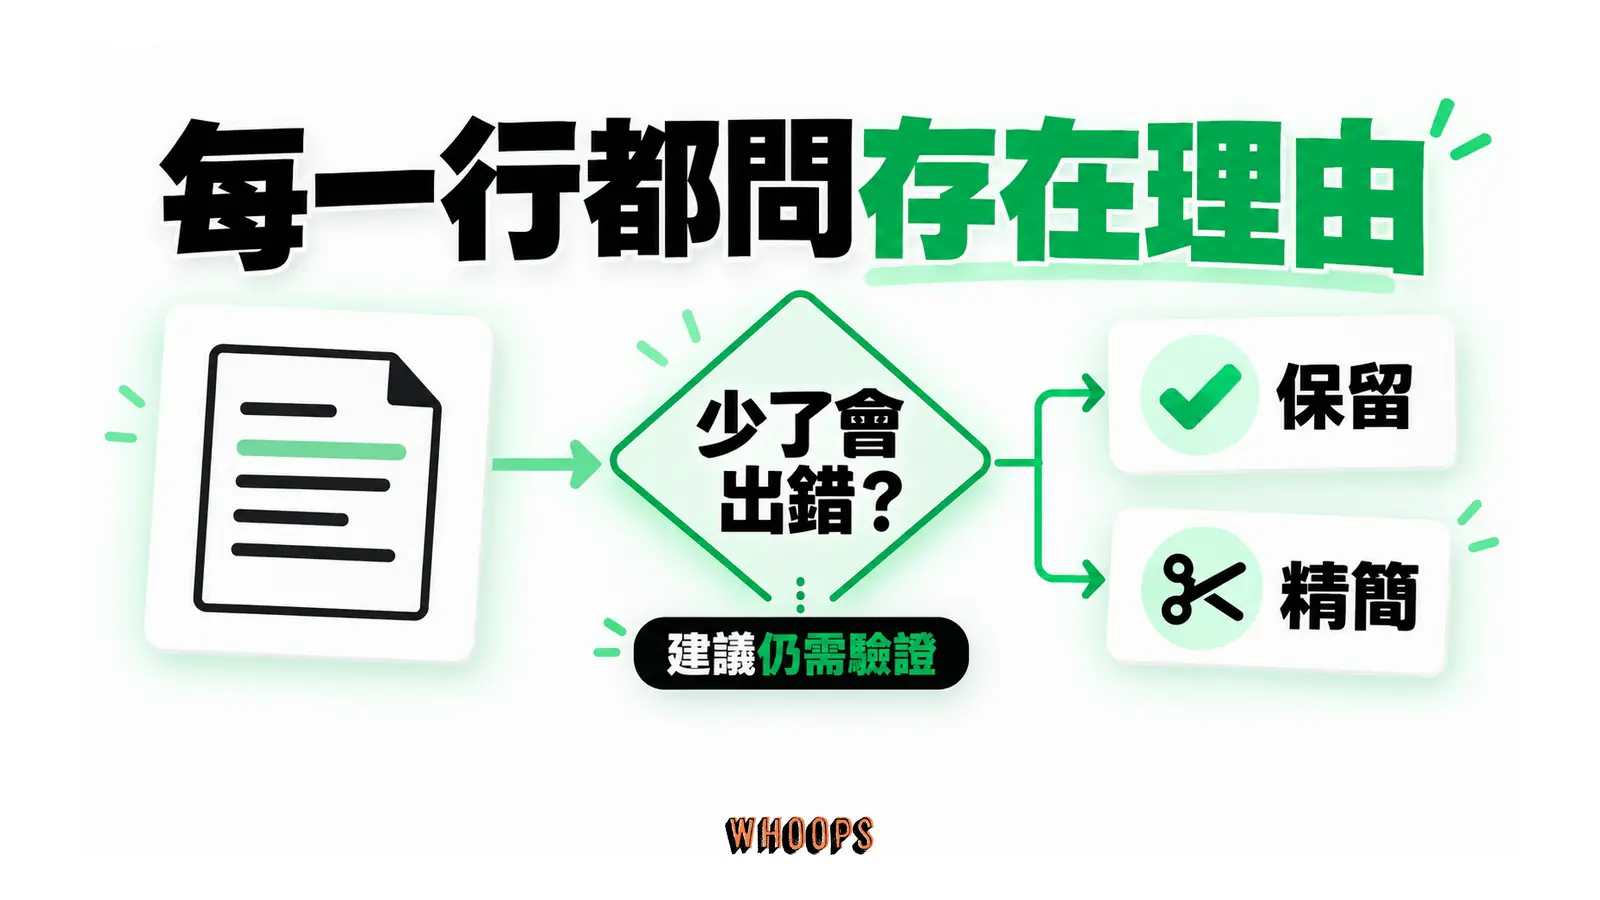
重審的方法,Anthropic 給了一條可以直接抄的逐行檢查法:對 CLAUDE.md 的每一行問「刪掉這一行,Claude 會開始犯錯嗎」,答案是不會,就刪。官方也給了量尺:每個 CLAUDE.md 以 200 行以內為目標,更長的檔案吃 context、降低遵循度。兩個官方工具搭配用:跑 /context 確認檔案真的被載入、內容如預期出現在對話裡;跑 /doctor,Claude 會提出它認為可以直接從程式碼推導、因而值得刪除的內容,拿這份建議當盤點的起點,裁決仍然在你。兩個常見的修正招式:某條規則被反覆跳過時,只給那一行加強調語氣,不要全檔加,強調一多就通通失效;「每次都要發生、零例外」的要求,從文字搬進 hooks,讓機制取代叮嚀。CLAUDE.md 的載入特性也決定內容邊界:它每場對話都會讀,所以只放每個任務都適用的規則;偶爾才用的領域知識與工作流程,Anthropic 建議移進 skills,讓模型按需載入,不占日常對話的空間。
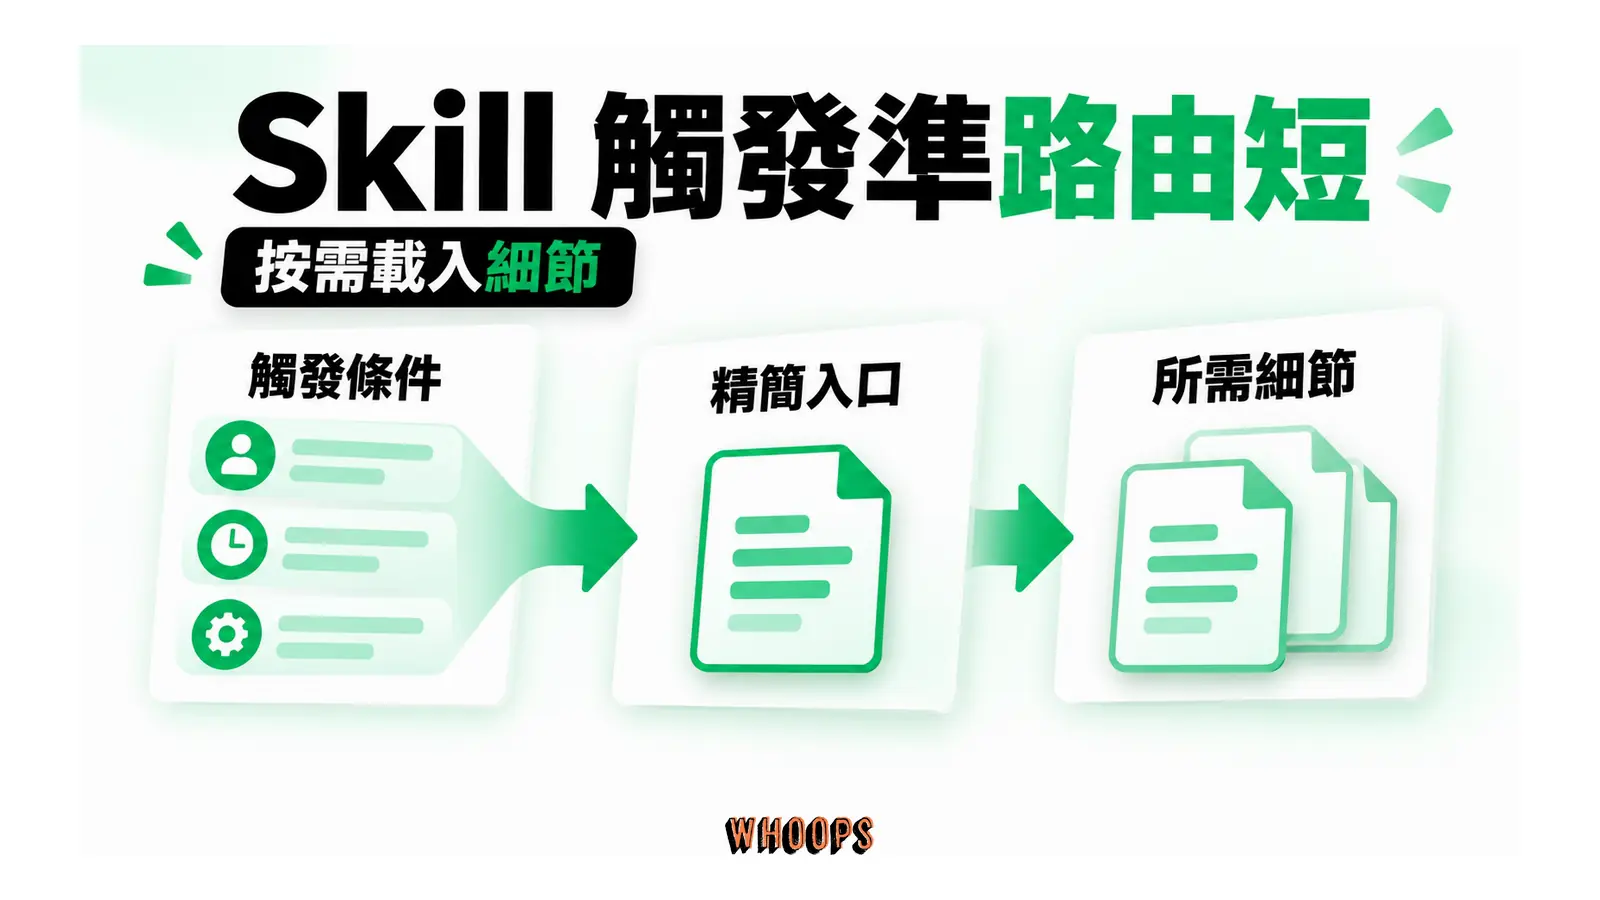
Skills 的重審動作有兩層。表層是描述欄:把它當廣告標語重寫,什麼情況用、什麼情況不用,一句話講完。OpenAI 的範例可以直接感受差異:「處理資料庫、查詢與資料模型時使用」會讓模型碰到任何資料庫相關的事就載入這個 skill;「新增或修改遷移、審查這次遷移的上線時使用」把觸發條件收窄到真正的適用情境。描述越精準,誤載入越少,context 越乾淨。裡層是 SKILL.md 本文:照前節的三段式重寫,多工作流程的 skill 把主文件縮成入口與路由,細節拆到個別文件與腳本,讓模型判斷這次任務需要讀哪部分。SKILL.md 的結構、漸進式揭露的機制與 description 的觸發寫法,站上的Claude Skills 完整指南有完整教學,這裡只補升級後的重審視角:每個 skill 都值得問一次,這份文件的哪些部分是在教模型已經會的事。
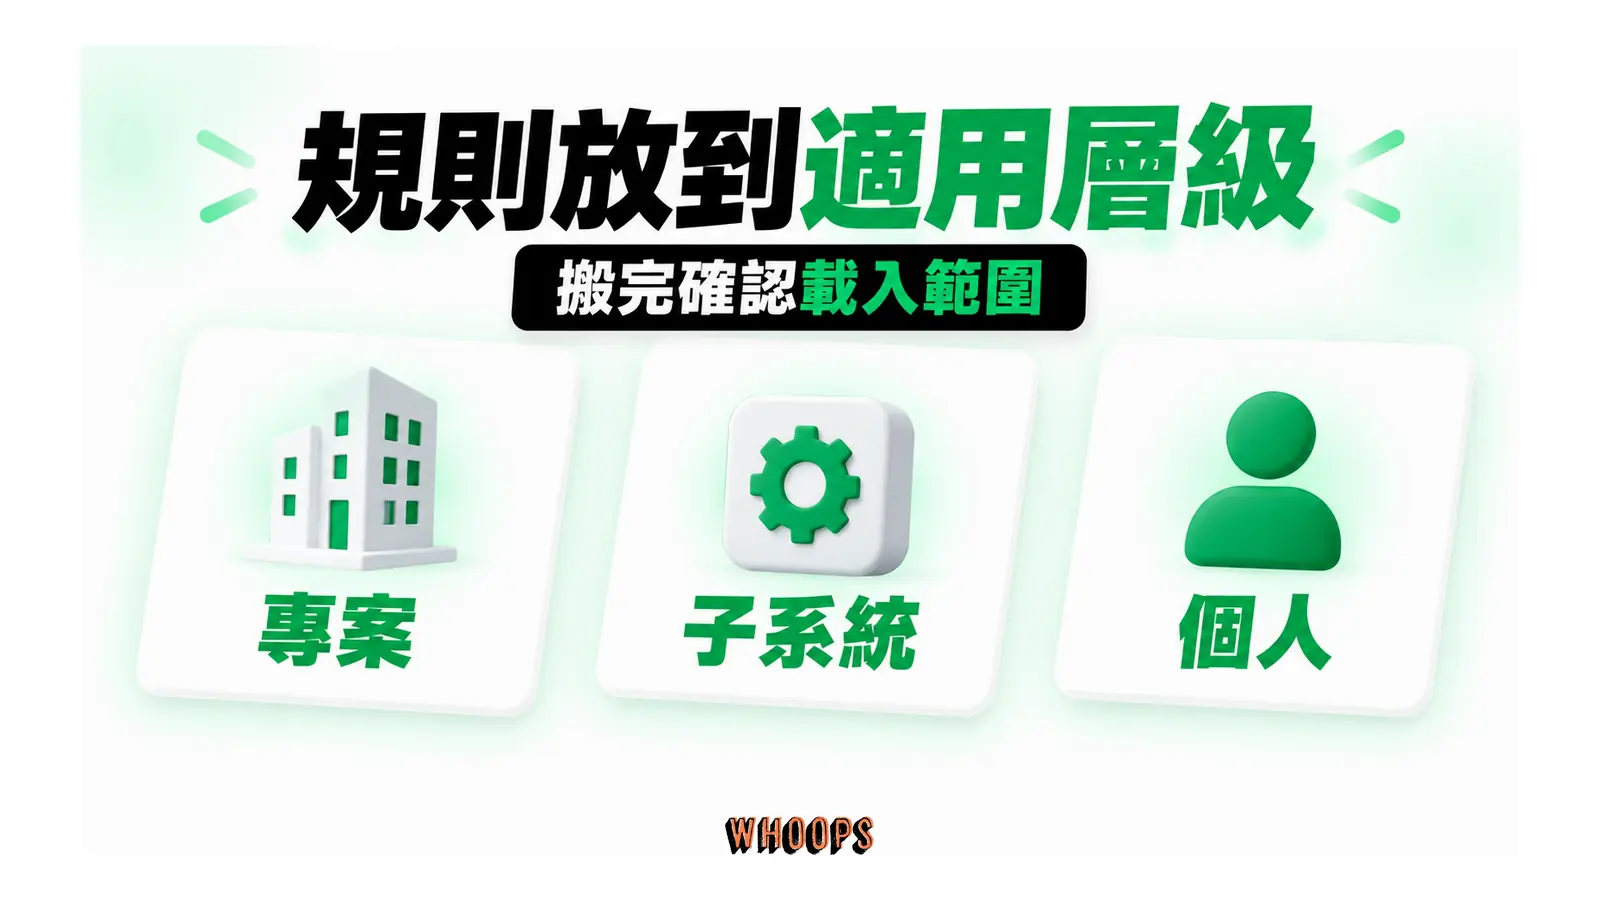
修剪之外還有搬家的選項。專案根目錄、子目錄與個人層級各有自己的 CLAUDE.md,載入範圍不同:只影響某個子系統的規則放到子目錄,只屬於你個人偏好的放到個人層級,根目錄留給整個專案都適用的骨架;路徑限定的規則還能放進 .claude/rules/,只在 Claude 動到對應檔案時載入。要留意 @ 路徑語法引入其他檔案只是整理長檔案的手段,那些檔案在啟動時照樣全部載入,省不了 context;真正按需載入的機制是前一節的 skills。搬完家再跑一次 /context,確認留下來的每一行都該在場。
執行紀律上,把 CLAUDE.md 當程式碼對待:納入版本控制、出問題時優先 review 它、定期修剪、每次修改後觀察行為是否真的改變。行為沒變好就回滾,這條紀律在後面 A/B 驗證一節會展開成完整流程。
Codex 使用者:AGENTS.md 與自訂指示的同場體檢
Codex 這邊的對應檔是 AGENTS.md:它在你儲存庫裡的每次任務都生效,所以 OpenAI 的建議是頻繁重訪,對每一條指令問它是否仍然必要。建檔、驗證讀取、沒生效的排查流程,站上的AGENTS.md 入門指南已經講過,這裡聚焦升級後的體檢。同樣走三類盤點,同樣把「一律先問」改寫成環境事實加可自主範圍,同樣把固定閱讀清單換成情境綁定。差異在細節:Codex 的 skill 生態與 Claude Code 共用 SKILL.md 標準,描述精簡化的原則完全互通;AGENTS.md 常見的肥厚來源是「歷史事故層」,某次部署出事後加的一條規則、某次溝通誤會後補的一段說明,這些內容值得逐條對照當下模型的能力重新判斷一次。
OpenAI 在文章結尾給了一個省力的起點:請 GPT-6 Astra 自己稽核。把那篇文章的原則餵給它,讓它 audit 你的 AGENTS.md、skills 與常用提示詞。實際可用的中文版模板長這樣:
請逐條閱讀我的指示檔(CLAUDE.md/AGENTS.md/skill 描述),
對每一條輸出:
1. 分類:補模型短處的防呆/描述我世界規則的邊界或知識
2. 證據:你目前世代是否已內建這個行為,依據是什麼
3. 建議:刪除/改寫/保留,改寫的話給出改寫後的句子
4. 風險:如果照建議執行,最壞情況會發生什麼
不要修改任何檔案,只輸出這份清單。
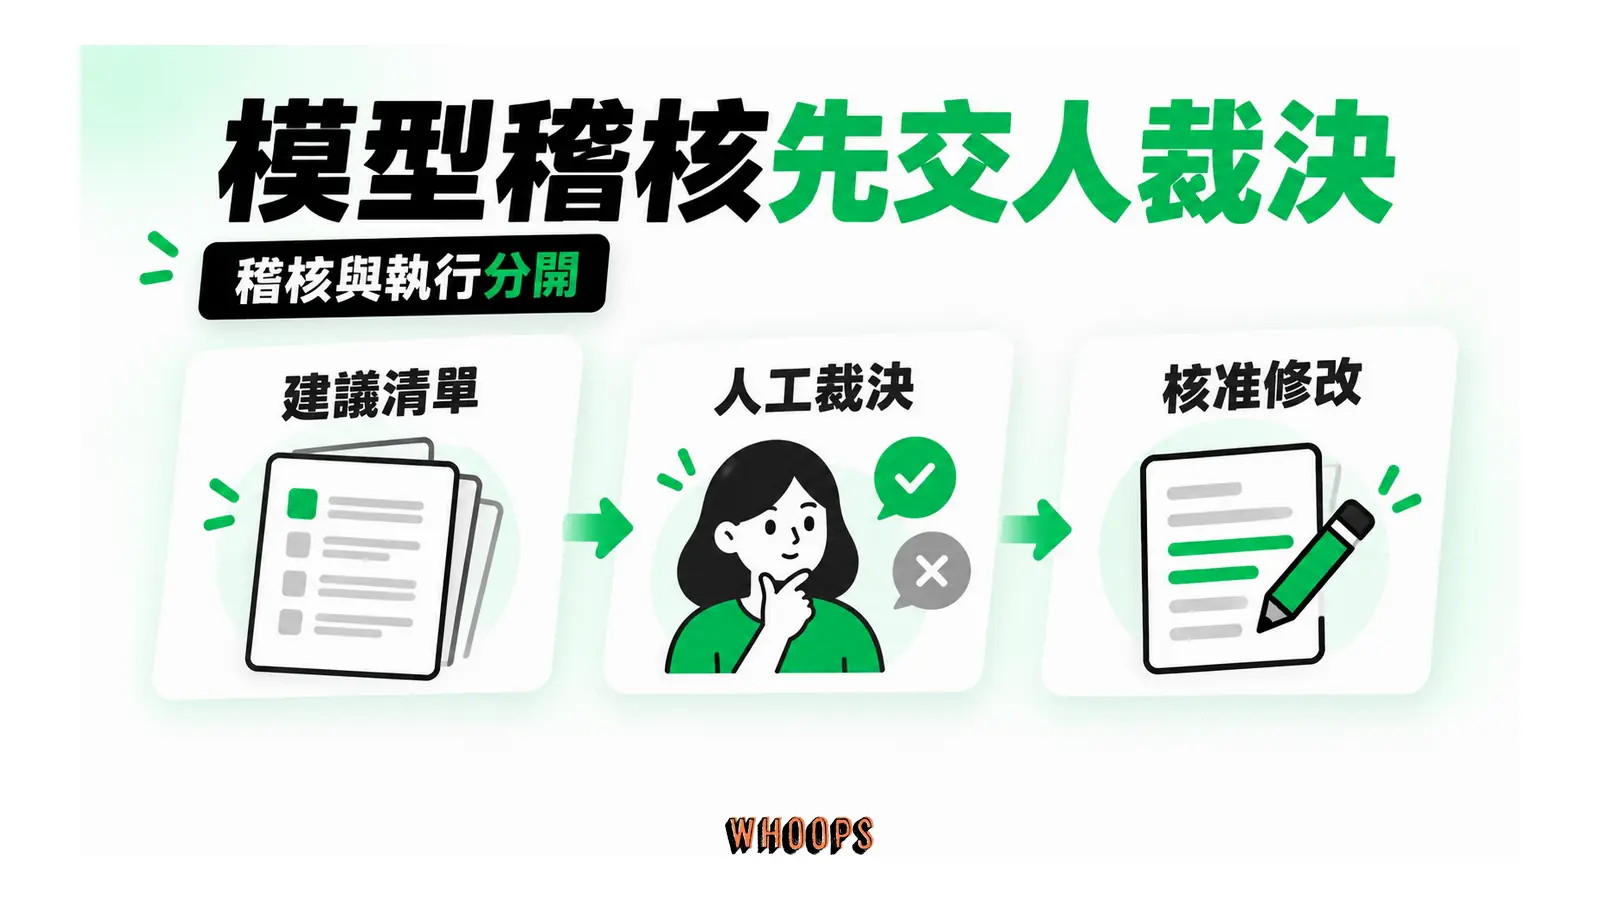
用的時候記住兩件事。模型的建議是草稿,不是判決:它看不到你過去為什麼寫下某條規則,也沒有承受過刪掉它的後果,每一條「刪除」建議都要過你自己的三類盤點。模板末行「不要修改任何檔案」建議保留:稽核與執行分開,你才有從容裁決的空間,這也是把自己從「逐步確認」解放出來之後,真正值得保留的人為檢查點。
ChatGPT 的自訂指示也套用同一套體檢。它的載入特性與 AGENTS.md 相同:每個對話開頭生效,內容每輪重送。累積一年的自訂指示常見三種肥肉:對已經是預設行為的叮嚀、與當下工作無關的舊專案背景、互相打架的偏好(同時要求簡短與鉅細靡遺)。體檢動作整套照搬:攤開、三類分箱、把「一律」換成範圍句式、刪掉模型已經會做的事。差別只在介面,原理完全相通。
工具軸的延伸操作,例如任務進行中追加導引指令、手機遠端接手主機、跨機交接與 AGENTS.md 的備份管理,站上的Codex 進階操作指南有完整整理;GPT-6 Astra 這個模型本身的定位、能力與費用,另有專文介紹。這裡把視角收攏回主線:工具的功能面會持續演化,指示檔的體檢紀律是跨版本通用的。
升級後檢查清單:觸發時機、掃描法與 A/B 驗證
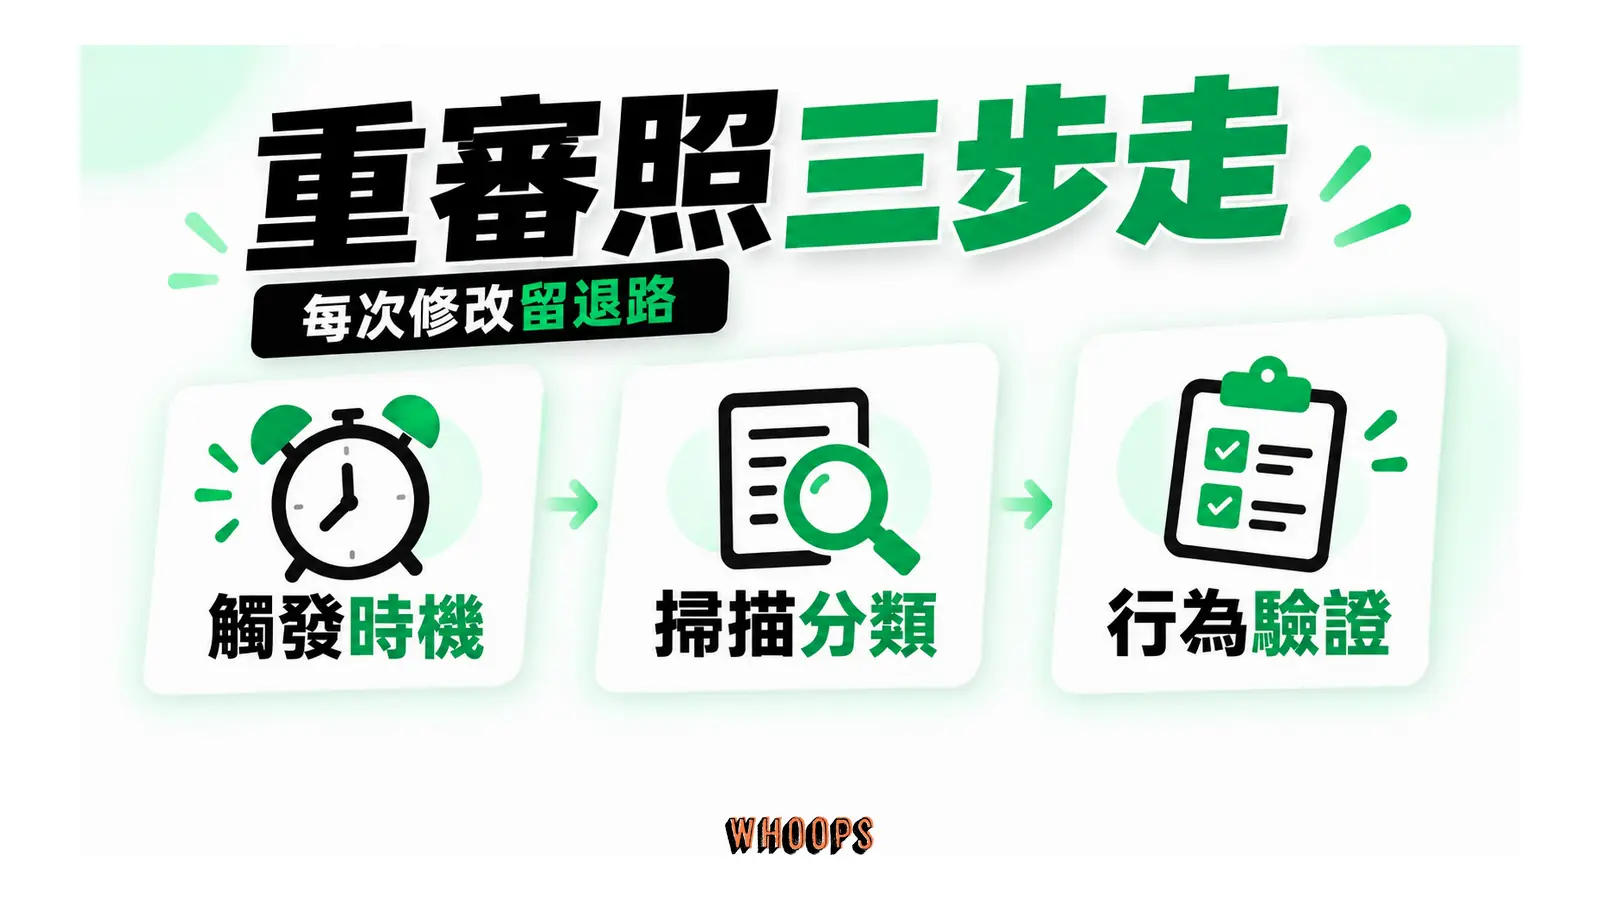
前面拆開講了原理與改寫術,這一節把它們收斂成可以直接執行的三步流程:什麼時候做、怎麼掃、怎麼驗。整輪跑下來通常是一到兩個小時的事,取決於指示檔的數量。
第一步:對觸發時機保持警覺
左右捲動檢視完整表格
| 訊號 | 看到的現象 | 該做的事 |
|---|---|---|
| 模型世代切換 | 訂閱方案或工具的預設模型換新、你主動升級模型 | 排一次完整盤點,三類分箱走完 |
| 規則被跳過 | 指示檔明明有規則,agent 還是做了不該做的事 | 先懷疑檔案太長、規則被淹沒,修剪而非加話 |
| 反問已答的問題 | agent 拿指示檔已寫過的事來問你 | 找出對應那條,把措辭改具體,不是重複張貼 |
| 行為改變 | 早停、過度測試、頻繁確認、任務變慢 | 對「防呆類」指令逐條懷疑,多數病因在指示檔 |
| 例行保養 | 每季一次的輕掃 | 跑關鍵詞掃描與 /doctor 類工具,只處理命中項 |
第二步:關鍵詞掃描,把肥肉標記出來
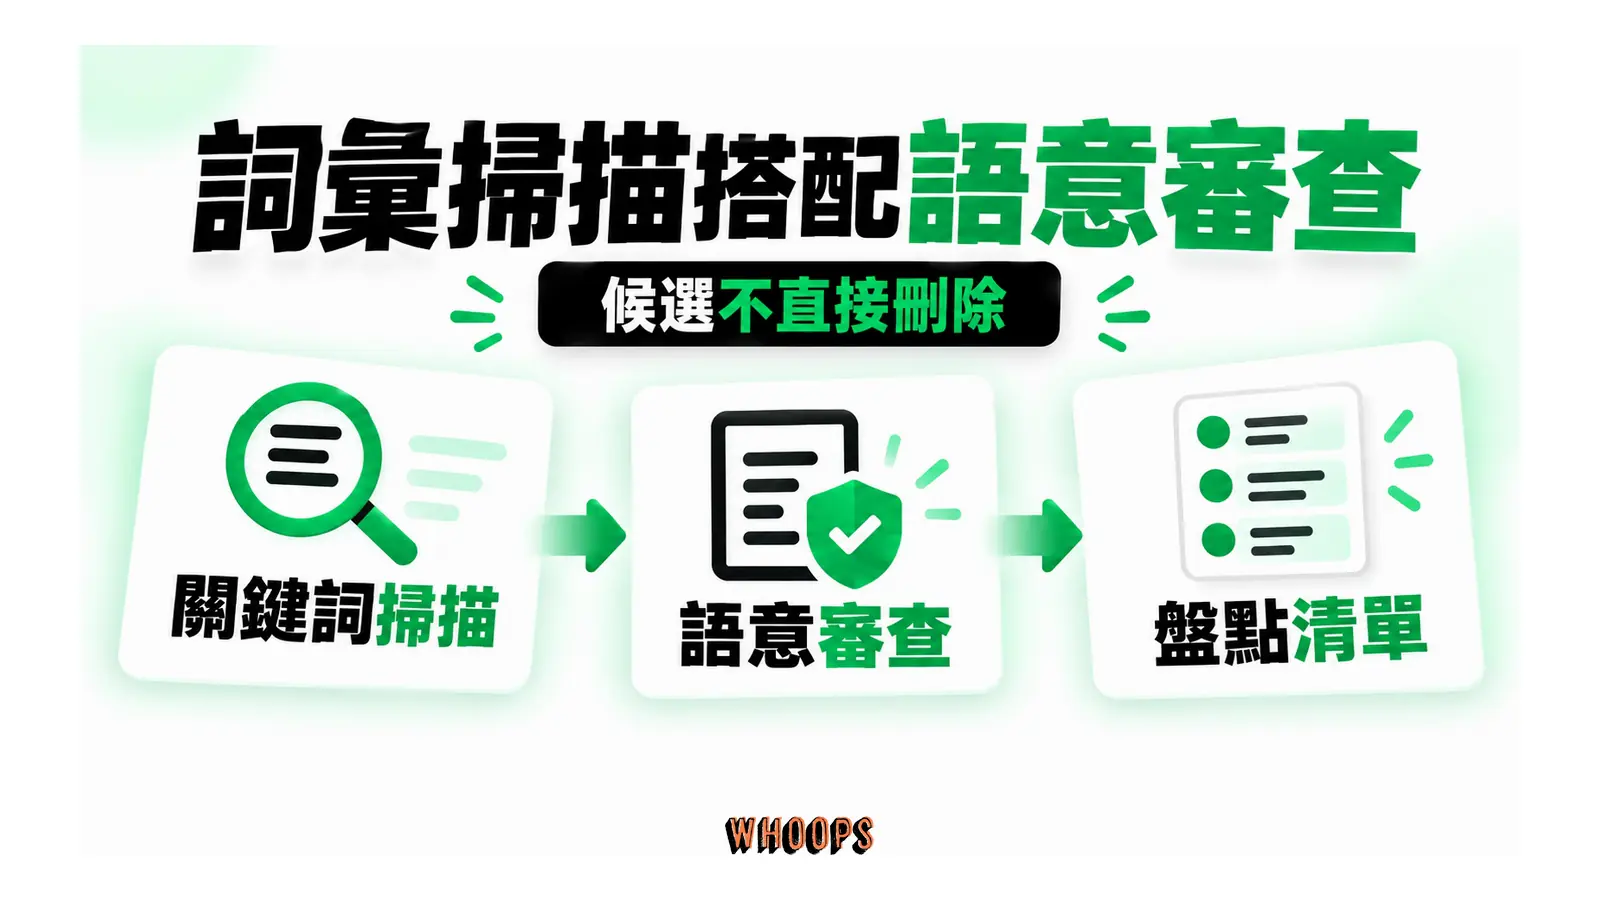
關鍵詞掃描的角色是分診。例行輕掃時,它就是主流程:掃完只處理命中項;完整盤點時,它負責開場把高風險段落標記出來,之後仍然回到逐條判斷,沒有命中關鍵詞的行一樣要過三類分箱。在指示檔裡搜尋這批詞彙特徵:
- 一律、必須、禁止、不得:高壓詞。確認它防的是後果(保留)還是某代模型的能力(改寫或刪)。
- 先詢問、先確認、取得同意:人工確認規則的特徵詞,優先改寫成安全範圍句式。
- 記得、不要忘記、切記:能力提醒的特徵詞,優先驗證是否已內建。
- 每次、修改前先閱讀:固定閱讀清單的特徵詞,改成情境綁定。
- 第一步、第二步、然後、接著:食譜化的特徵詞,整段候選三段式重寫。
詞彙掃描撈不出語意層面的冗餘,所以搭配前一節的自我稽核模板,讓模型對每條指令輸出分類與建議,你只做裁決。兩條路徑交叉,漏網率最低。
第三步:A/B 驗證,讓行為證明減肥成功
改完指示檔,用同一組任務比較前後版本。流程固定五件事:
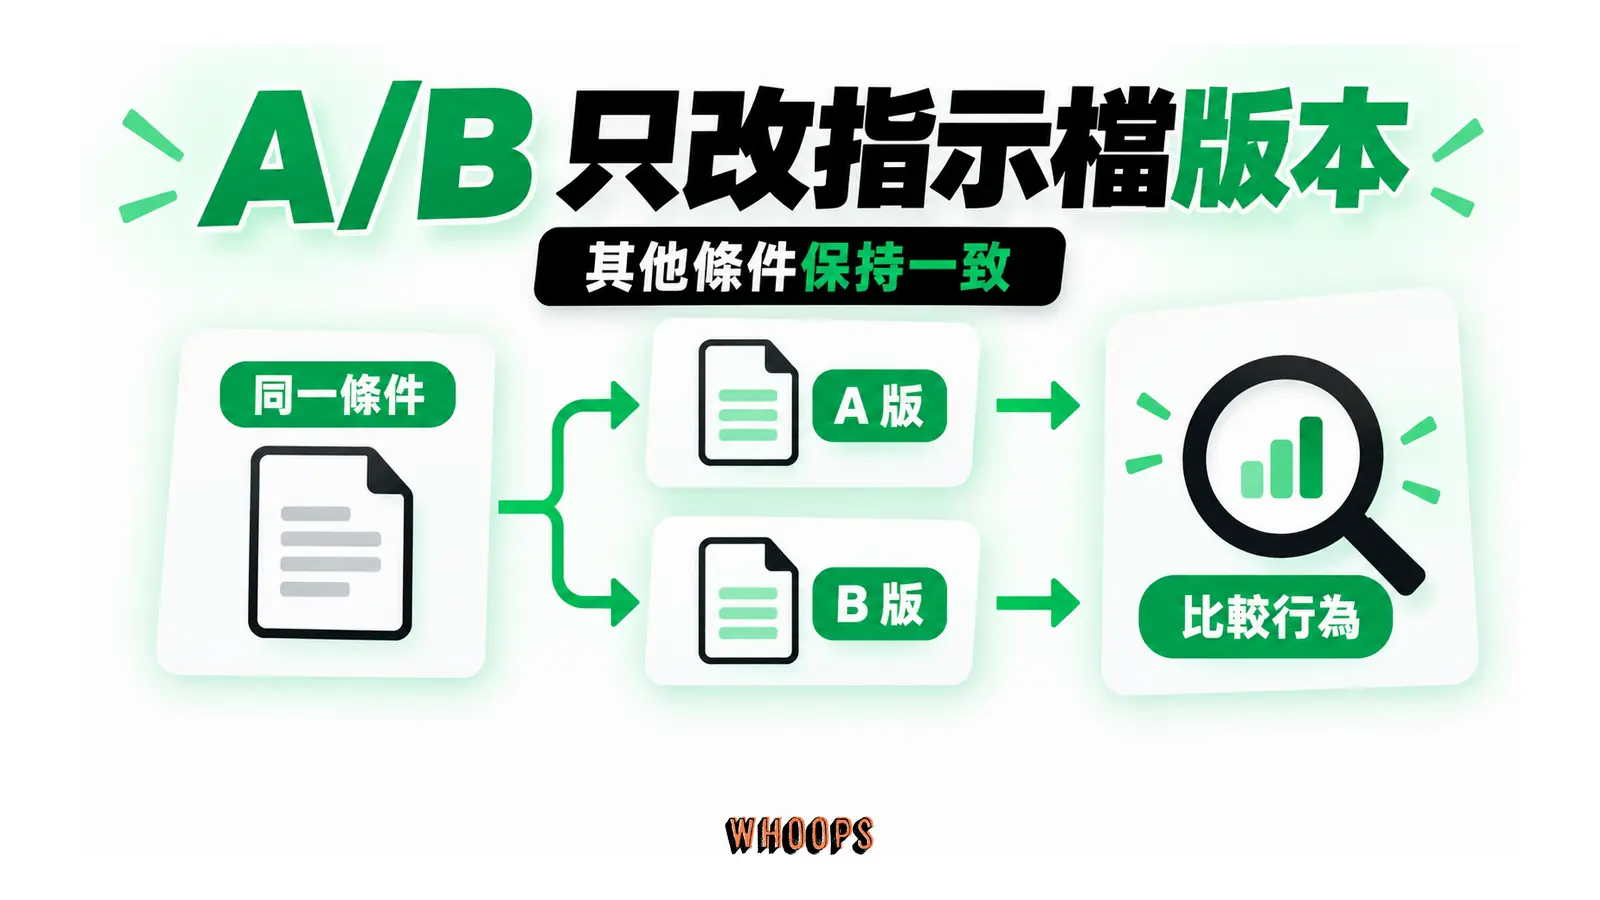
- 固定任務集:挑 3 到 5 個代表性任務,寫下來不再更動。組合建議:一個日常小修改、一個跨多檔的重構、一個會踩到安全邊界的任務、一個需要領域知識的任務。
- 單一變數:只改指示檔版本。任務內容、模型、工具設定全部維持一致,不然差異沒有歸因對象。
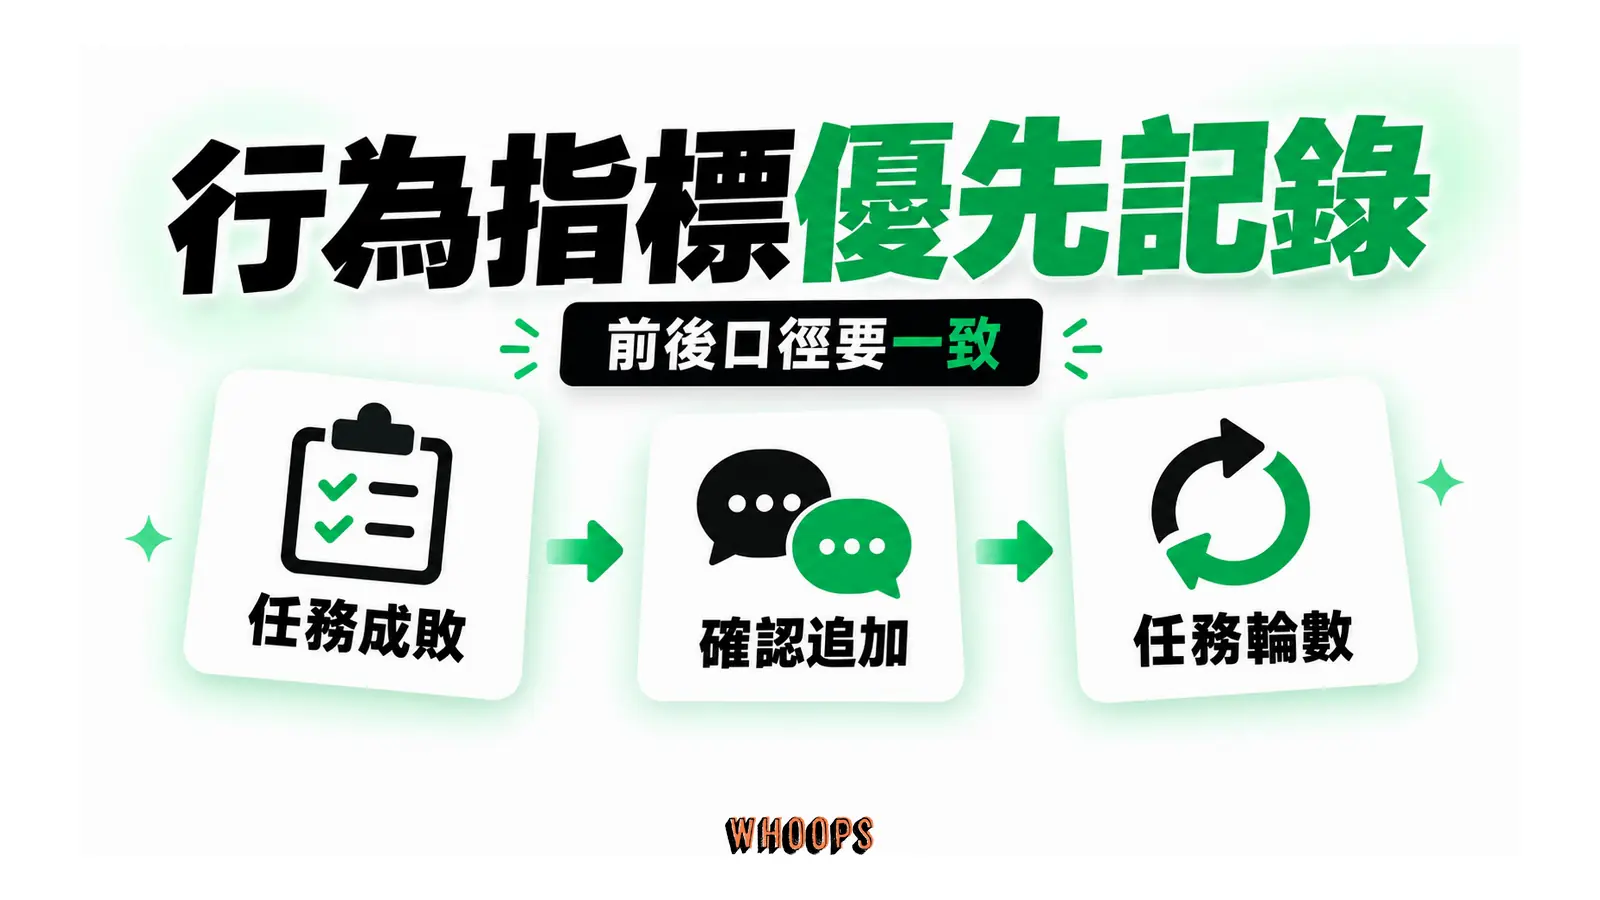
- 量行為指標:任務成敗、agent 停下來詢問的次數、你追加指令的次數、任務輪數。行為指標比 token 指標重要:減肥的成功定義是該自主的自主、該停的停,省 token 是紅利。
- 重複跑兩三次:agent 行為有自然變異,單次結果可能是運氣,兩三次的趨勢才可信。
- 保留回滾路徑:指示檔進版本控制,任何一次回歸失敗就回到上一版,再從中恢復被刪的規則,找出肇事的那一條。
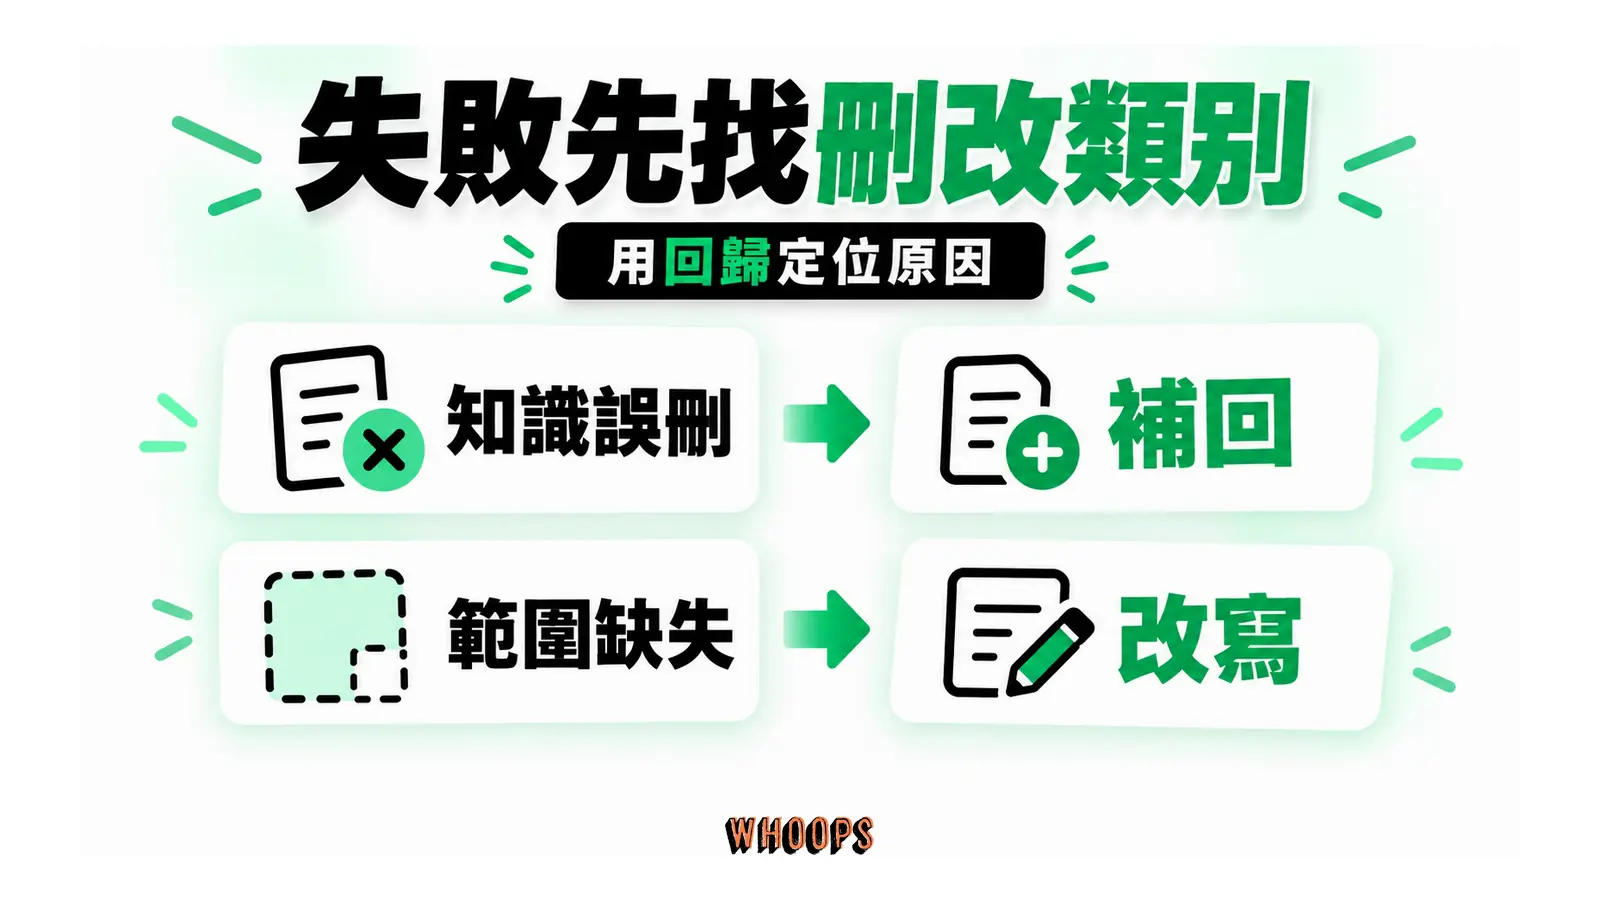
兩種失敗模式提前認識,可以少走彎路。刪過頭:把領域知識誤判成防呆,agent 開始犯「它怎麼會不知道這件事」的錯,這時回到盤點表,第三箱的東西要加回來。改錯方向:把「一律先問」直接刪掉而沒換成安全範圍句式,低風險自主了,高風險也跟著裸奔,正確動作是改寫,不是移除。
量測本身不必上工具。每次任務結束花三十秒記三個數字:成了沒有、停下來問了幾次、你追加了幾次指令;token 用量看工具內建的統計就夠。數字粗糙沒關係,A/B 比較需要的是前後口徑一致,而非絕對精準。累積三五個任務,趨勢通常就清楚了,屆時再決定這輪減肥收工還是加緊。
冗餘指令的成本帳:每輪重送都在付費
把成本講清楚,因為它把前面所有章節串成一個閉環。指示檔、skill 描述、自訂指示,都屬於每輪重送的固定輸入;固定輸入的成本乘上輪數,就是乘數效應。示意計算再精緻一點:1,800 個中文字的指示檔大約 3,000 token 出頭,一個平均 30 輪的任務重送 30 次,單一任務就吃掉約 9 萬 token 的輸入;一個團隊十個人、每人每天三個任務,一年累積下來的量級自己乘。提示詞快取能把重送成本壓低,但兩個前提常被忽略:快取靠前綴比對命中,你一編輯指示檔,變更點之後的內容就無法命中,這一段下次請求要按未快取價格重算;快取讀取有折扣,長期占用的固定內容仍然按快取價逐輪收費。帳要細算的話,輸入、輸出、快取三種用量各有讀法,站上的AI Token 帳單診斷指南提供了完整的對帳方法。
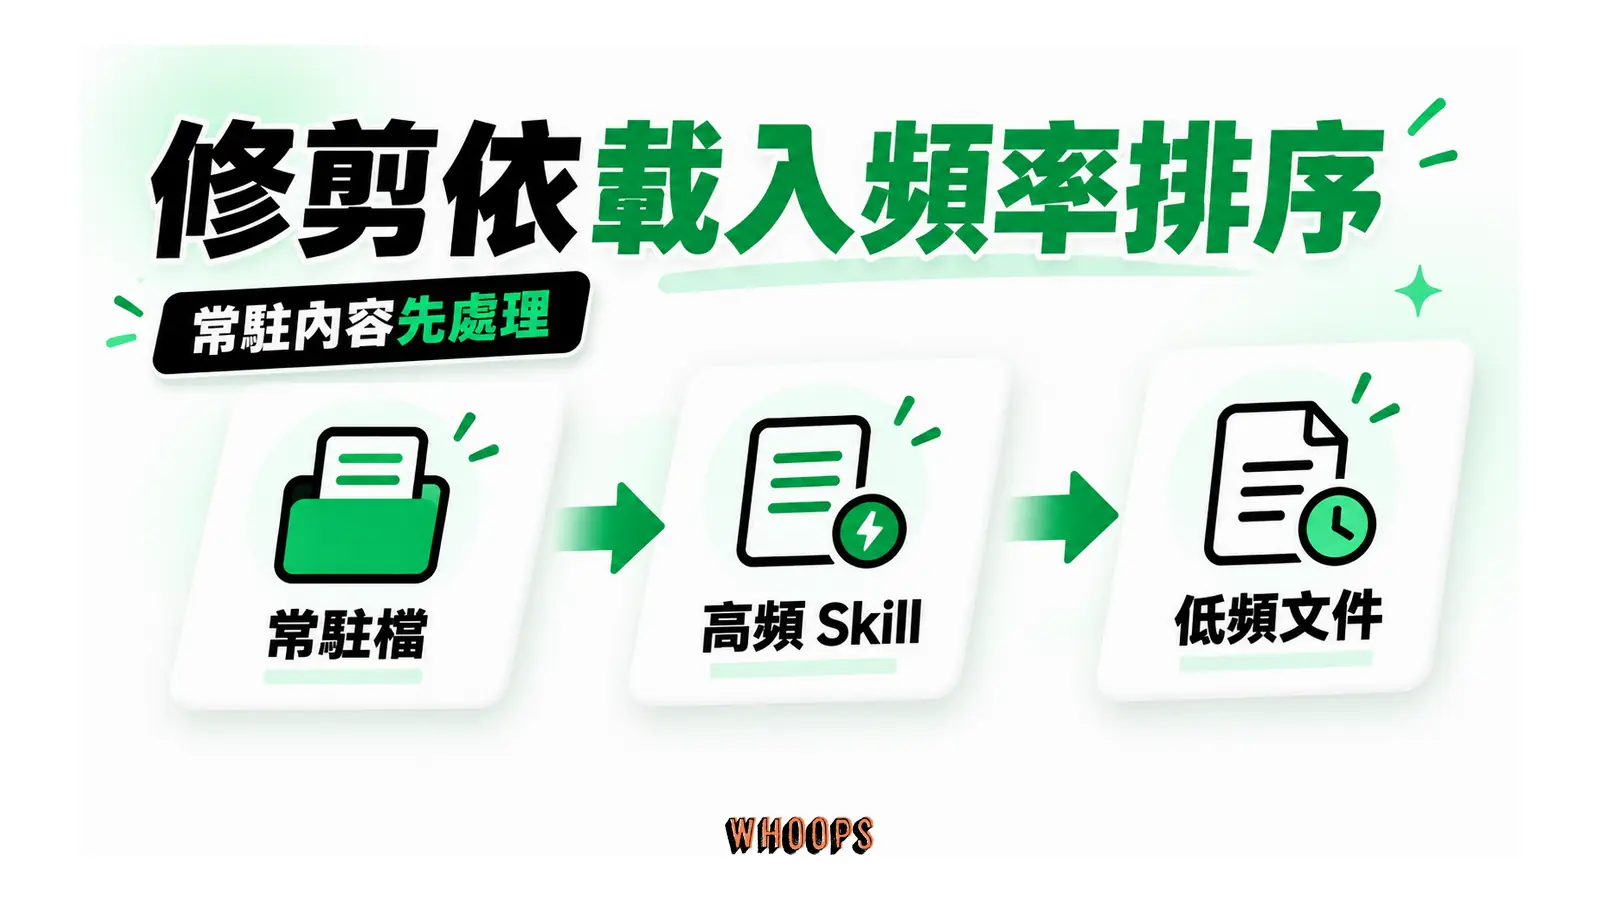
如果時間有限,按載入頻率排優先序。第一順位是每次都載入的常駐檔:CLAUDE.md、AGENTS.md 與 skill 描述,它們的成本乘上所有任務的輪數。第二順位是高頻 skill 的本文,每周都會觸發的那些。第三順位才是低頻文件,季節性 skill 與封存的專案說明,它們占的是儲存空間,不是每輪的 context。同樣一小時的修剪時間,花在常駐檔上的回報最高,這也是為什麼本文的重審流程從這兩類檔案走起。
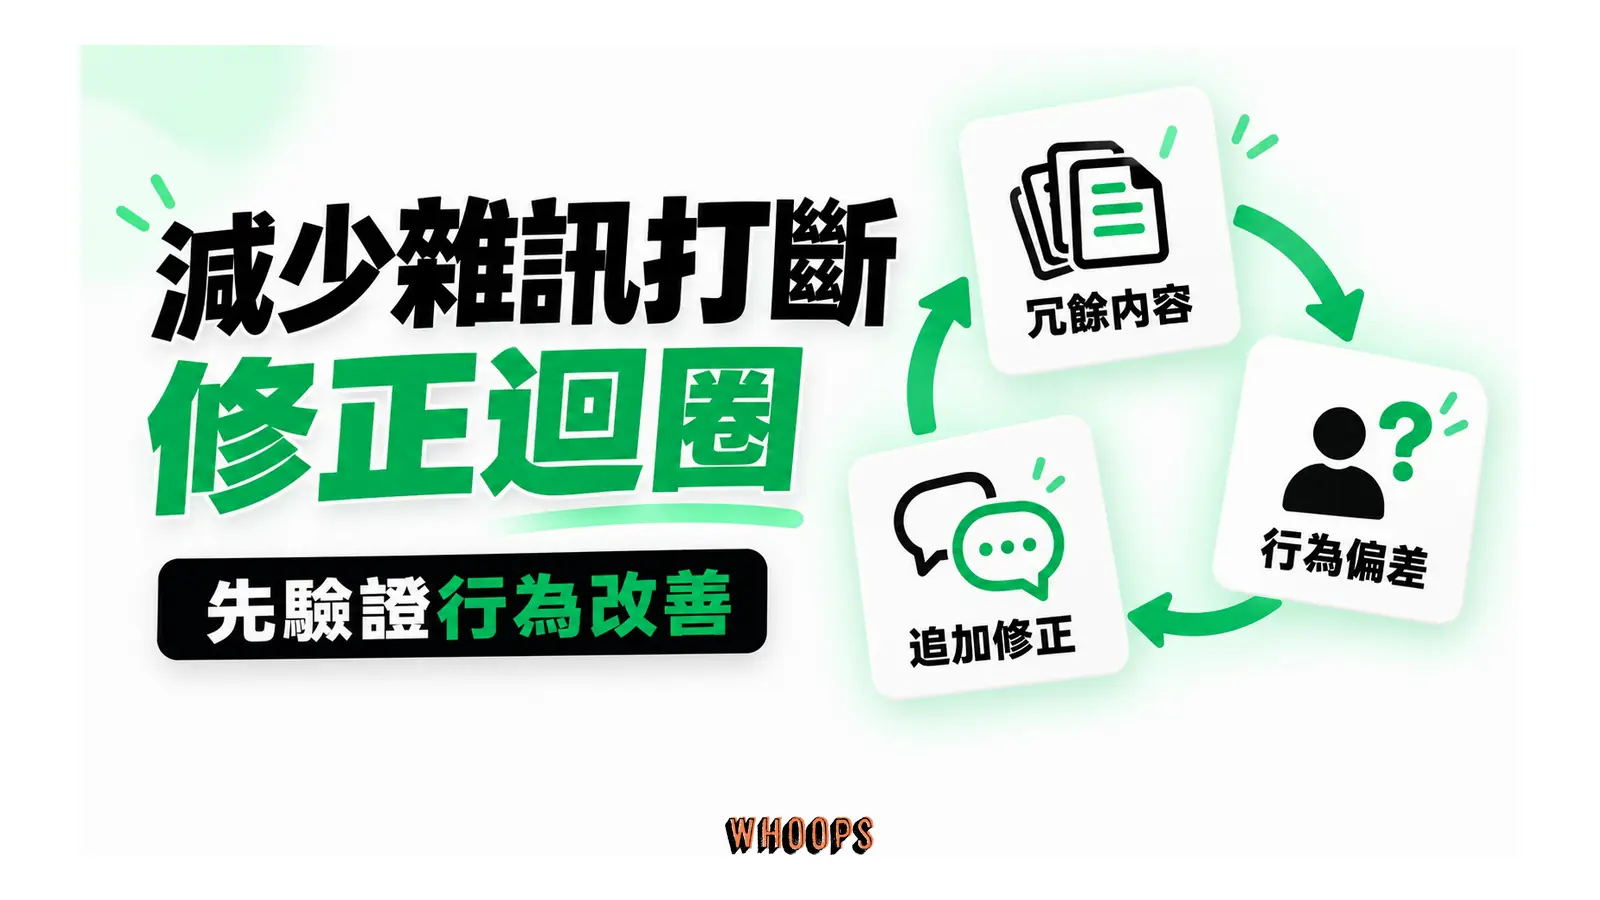
但真正的成本大頭不在帳單,在行為退化鏈:context 被冗餘指令占滿,關鍵規則被擠到邊緣,行為開始偏差,你追加修正指令,輪數上升,壓縮提早發生,規則再被摘掉一次。這條鏈上每一環都在花錢,而且花得比 token 單價更貴:修正一個走偏的任務,往往比讓它走對更耗輪數。指令減肥打斷的正是這條鏈的源頭。所以評估收益時,行為指標在前,token 帳單在後:中斷次數下降、追加指令變少、任務一次做對的比例上升,這些改善會自然壓低輪數,token 支出跟著下降,順序對了,兩個都拿到。
回到開頭那句:模型升級之後,把指示檔也升級。三類盤點先分箱再動刀;「一律先問」改寫成環境事實加可自主範圍,高風險清單具體到動作;食譜換成目標、限制、完成條件;改完用固定任務集驗證,版本控制留退路。升級後的指示檔只留下三種東西:任務完成時該長什麼樣、哪些線不能跨,以及模型從檔案裡猜不到的背景。而這套流程本身也經得起下一次升級:指示檔越精簡,下一輪減肥越快,你把博物館清成了工作檯,之後每次只需要擦灰塵。