上下文工程是什麼?管理 AI 脈絡的四種方法
上下文工程把模型生成當下看得到的全部資訊當成有限資源來設計,涵蓋系統提示、對話歷史、工具定義與檢索內容。內容說明它與 prompt 工程的差別、context rot 的退化與長輸入成本,並整理寫入、選取、壓縮、隔離四種實作方法,加上快取前綴穩定的省錢紀律。
- 上下文工程
- context engineering
- 上下文窗口
- 脈絡窗口
- context rot
- prompt engineering
- 提示工程
- RAG 檢索
- AI Agent
- Claude Code
- KV-cache
- 提示快取
- token 成本
- 子代理
- 記憶工具
約 27 分鐘閱讀作者:Whoops 編輯團隊
模型回答得好不好,取決的不只是你打的那一段字。系統提示、對話歷史、工具定義、檢索進來的資料,加上模型自己先前生成的內容,這一切在生成當下看得到的資訊,是它做判斷的全部依據,這整包東西叫脈絡(context)。上下文工程(context engineering)就是把它當成有限資源來設計與管理的做法。Anthropic 工程團隊 2025 年 9 月的文章給的定義是「在推論期間策劃並維護最佳 token 集合的一組策略」,白話說,就是每一輪都重新決定哪些資訊該進到模型眼前、哪些該留在窗外。
這個詞在 2025 年年中快速竄起。6 月 27 日,Shopify 執行長 Tobi Lütke 在貼文中表示偏好多用 context engineering 一詞,因為它更貼近核心技能:為任務提供夠完整的脈絡,讓任務對 LLM 而言是可解的。Andrej Karpathy 隨後附議,他的理由是人們聽到 prompt,想到的是日常使用時丟給模型的短任務描述,但在每個工業級的 LLM 應用裡,真正的功夫是把窗口填得恰到好處,他形容這是「為下一步把恰到好處的資訊填進脈絡窗口的藝術與科學」,範圍涵蓋任務描述與解釋、few-shot 範例、RAG、相關資料、工具、狀態與歷史、壓縮。這兩段原話由Simon Willison 在同日的網誌完整引述,他自己的判斷是這個詞的望文生義比 prompt engineering 更貼近本意,因此留得住。
代理對話常達數百輪,因此需要謹慎的脈絡管理策略。LangChain 引 Cognition 團隊的說法,稱上下文工程是打造 AI 代理的工程師的第一要務。Phil Schmid 在2025 年 6 月 30 日的整理裡講得更直白:多數代理失敗已經不是模型失敗,而是脈絡失敗。Manus 團隊的表態同樣直接:把籌碼押在上下文工程,讓改善以小時而非週為單位出貨。站上的AI Agent 指南談代理的原理與落地,這裡聚焦其中最容易被忽略的一層:模型眼前那份不斷變動的資訊。
先澄清一個常見誤解:上下文工程沒有取代 prompt 工程,而是把它包進更大的範圍。把一段指令寫清楚依然重要,站上Prompt 撰寫指南談的結構方法照樣適用,差別在於上下文工程把「寫提示」從一次性的動作,變成每一輪都要重做的策劃。接下來先拆解脈絡窗口裡裝了什麼、為什麼塞滿反而變笨,再依 LangChain 的分類整理四種動態管理方法,涵蓋寫入、選取、壓縮、隔離,並補上靜態層的設計紀律與快取帶來的成本槓桿。
重點先看
- 定義:脈絡是模型生成當下看得到的全部 token,窗口是它的工作記憶。上下文工程=在每一輪推論前策劃這份內容的紀律,是 prompt 工程的自然延伸而非取代。
- 退化:輸入越長,模型回想與運用資訊的精度越低,單一干擾項就會拖累表現。窗口放大增加的是容量,無法消除品質問題。實際送入的 token 越多,費用越高。
- 內容:脈絡含系統提示、使用者訊息、對話歷史、長期記憶、檢索結果、工具定義、輸出格式定義七個組成,全部計入窗口用量。
- 四法:寫入(存到窗外)、選取(拉對的進來)、壓縮(摘要與修剪)、隔離(子代理分工),對應不同的任務形態。
- 成本:前綴穩定、只附加不改寫,快取命中價差達十倍。系統提示開頭放時間戳之類的小動作,會直接殺死快取。
脈絡窗口裡到底裝了什麼
先把比喻講清楚。Karpathy 把 LLM 比作一種新的作業系統:模型像 CPU,脈絡窗口像 RAM,也就是模型的工作記憶。Claude 平台文件對窗口的定義與此一致:模型生成回應時可參考的全部文字,包含回應本身。視模型而定,Claude 目前多數新模型提供 1M token 窗口、單次請求最多 128k 輸出,其餘如 Sonnet 4.5 是 200k,OpenAI 的 GPT-5.1 是 400k,Gemini 1.5 Pro 則早在 2024 年初就端出 1M。窗口大小看似充裕,但文件同時提醒:脈絡並不是多多益善。
那麼「脈絡」具體包含哪些東西?Phil Schmid 的清單列了七個組成:系統提示(定義行為的初始指令)、使用者提示(眼前的任務或問題)、狀態與歷史(這次對話至今的往來)、長期記憶(跨多次對話累積的知識庫)、檢索資訊(從文件、資料庫或 API 找來的外部知識)、可用工具(它能呼叫的函式定義)、結構化輸出(回應格式的定義)。LangChain 的分類粒度更粗,把脈絡內容歸成三類:指示、知識、工具。兩份清單不衝突,前者適合盤點「有哪些東西會佔窗口」,後者適合思考「每類內容怎麼進出」。
對照 Karpathy 列舉的範圍可以看出共識:任務描述與解釋、few-shot 範例、RAG、相關資料(含多模態)、工具、狀態與歷史、壓縮,幾乎每一項都對應到清單裡的一個組成與一種管理動作。這也是這個詞站得住腳的原因,Willison 的觀察是 prompt engineering 常被訕笑成「把字打進聊天機器人的浮誇說法」,而 context engineering 光看字面就逼近本意,望文生義的成本低得多。對中文讀者,把它理解成「脈絡的工程管理」即可,重音在管理,不在咒語式的措辭。
容易被忽略的是計價與容量口徑。Claude 平台文件明說:請求裡的一切都計入窗口,系統提示、每一則訊息(含工具結果、圖片與文件)、工具定義,連模型這一輪的輸出與延伸思考內容都算。也就是說,窗口不是「你貼了多少字」,而是「模型這一眼看了多少 token」。對 API 用戶,這直接等於帳單,概念可以回頭看站上的Token 計算與計費解析。
介面端的處理也值得認識。開 API 的工程師自己管理窗口,Claude 的網頁版則是把這件事接過去,以先進先出的滾動方式維護對話,舊內容在滿的時候被推出去。用量回報也是內建功能,每個回應都會在 usage 欄位回報該次請求消耗了多少。另有一個容易誤算的細節:多媒體的計法,單次請求最多可包含 600 張圖或 PDF 頁,200k 窗口的模型是 100,很多人以為圖片不佔位,實際上佔得比想像中兇。
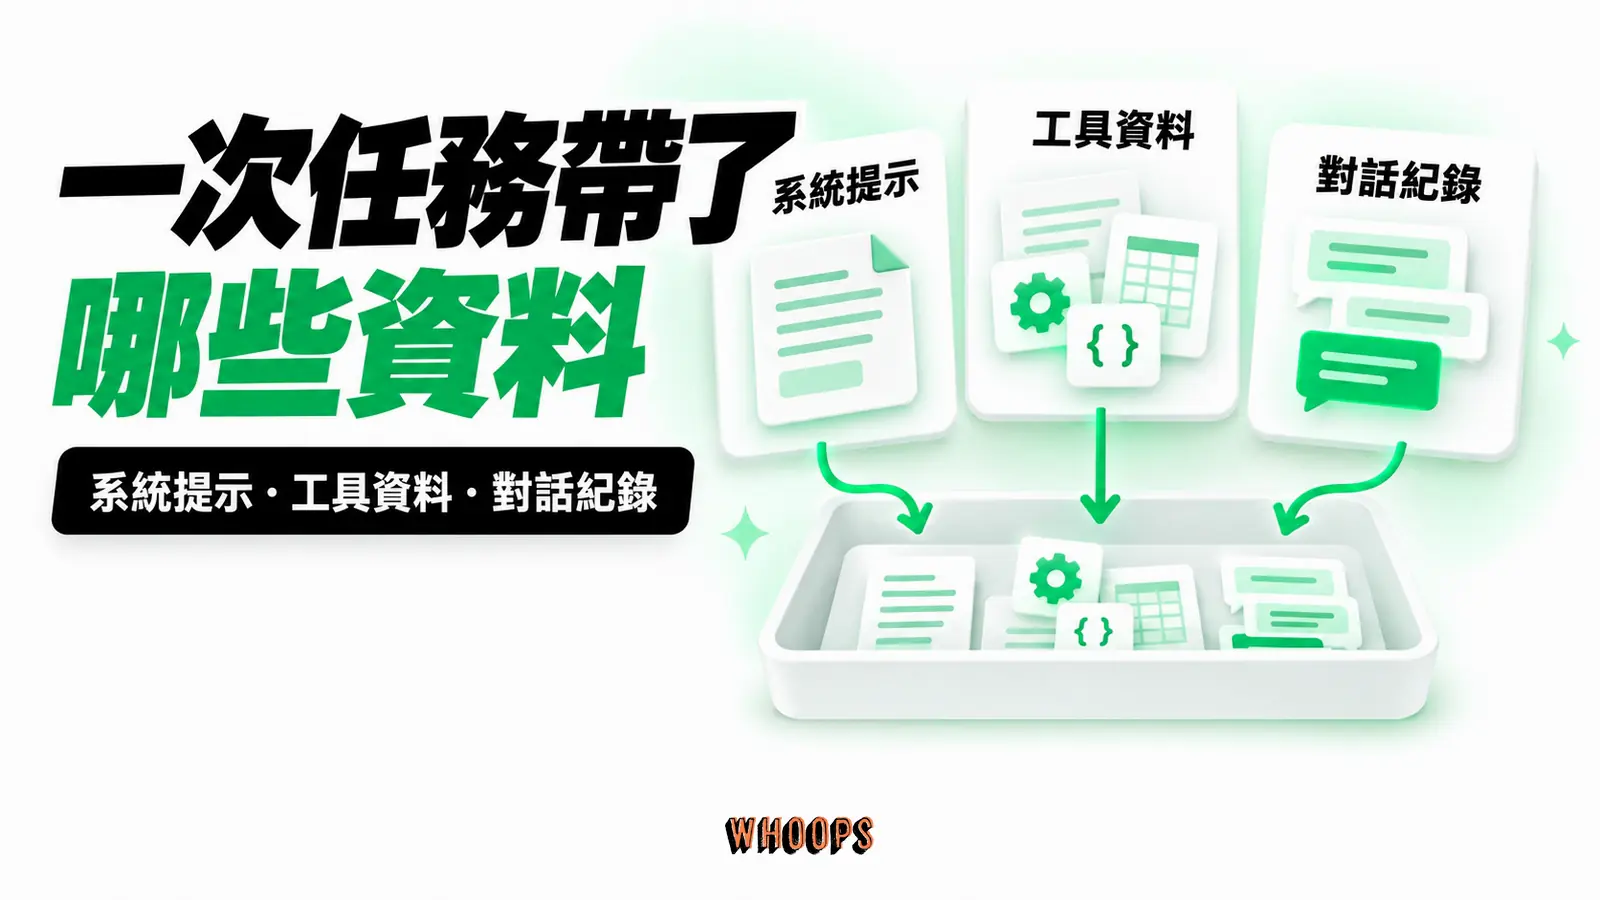
為什麼要花力氣理解這份清單?因為它改變了「顧好提示」的定義。Phil Schmid 舉過一個傳神的例子:假設 AI 助理收到一封簡短 email,對方問明天有沒有空快速 sync 一下。脈絡貧乏的版本只看得到這句請求,回覆會是「謝謝你的訊息,明天可以,請問你想約幾點」這類正確但機械的句子。脈絡豐富的版本裡,程式碼的工作重心移到呼叫模型之前,把該有的背景先湊齊,包括行事曆(顯示明天滿檔)、與此人的往來信件(決定語氣)、聯絡人清單(確認他是重要夥伴)、送邀請與寄信的工具。於是回覆變成「明天我整滿,週四上午有空,邀約已經發出,有問題再說」。同一個模型、同一個任務,差別只在模型眼前有什麼。Schmid 自己的總結是:便宜展示與神奇代理的差距,就在你提供的脈絡品質,魔法不在更聰明的模型或更巧的演算法,而在為對的任務給對的脈絡。
為什麼塞滿反而變笨:退化與四種失敗
脈絡管理的核心理由,是一個被稱為 context rot 的現象,可譯為脈絡腐化。Anthropic 的說法是:窗口裡的 token 越多,模型從中正確回想資訊的能力就越低,而且這個特性出現在所有模型身上,脈絡因此必須被當成邊際報酬遞減的有限資源。他們並用人的處境類比:LLM 跟人一樣,注視的內容一多,過了某個點就會失焦或混亂。Chroma 的同名研究(2025 年 7 月)把這件事量了出來:研究團隊評測 18 個模型,把題目難度固定、只改變輸入長度,發現表現隨長度呈現非均勻的退化,就連非詞彙比對的檢索或複製文字這類簡單任務也不例外。
這份研究有兩個對實作很有感的發現。其一是問題與答案的語意相似度越低,退化越快,代表「資料在窗口裡」不等於「模型想得起來」。其二是干擾項的效果:即使只放一個干擾項,表現也低於基準線,放四個時退化更嚴重。研究的結論一句話道盡上下文工程的價值:資訊在不在脈絡裡不是全部,怎麼呈現更重要。
退化的來源有架構層的理由。Transformer 讓每個 token 都能注意其他每個 token,n 個 token 形成 n² 的成對關係,脈絡一長,這些關係就被拉薄。Anthropic 用「注意力預算」來描述:每個新 token 都會消耗一部分預算,並強調退化是漸進的坡而非斷崖,長脈絡下模型依然堪用,只是精度打折。
工程面上,LangChain 轉述 Drew Breunig 的整理,把長脈絡引發的問題分成四種。毒化是幻覺進入脈絡,失焦是脈絡壓過模型訓練,混淆是多餘脈絡影響回應,衝突是脈絡各部分互相矛盾。
還有成本帳。代理式的用法每一輪都重送整段脈絡,Manus 團隊公布平均輸入輸出 token 比約 100 比 1,因此把 KV-cache 命中率視為影響成本與延遲的關鍵指標。Anthropic 的多代理研究系統則量到,多代理架構的 token 消耗約為一般對話的 15 倍。這兩個數字說明:脈絡的「重量」既是品質問題,也是荷包問題。
靜態層的紀律:系統提示與工具定義
四種動態方法之前,先把不動的部分顧好。Anthropic 對系統提示的建議是抓對「高度」:一端是把邏輯硬寫死在提示裡的脆硬編碼,另一端是空泛到沒有訊號、還預設模型自己懂背景的抽象指示,好提示落在兩者之間的甜蜜區。目標是「完整勾勒期望行為的最小資訊集」,而且最小不等於短,該給的背景一次給足。工具定義同理:每個工具要自足、能抗錯、用途明確,而最常見的失敗是工具集臃腫、功能重疊,讓模型站在岔路上不知選哪個。判斷標準很實際:若人類工程師說不清某情境該用哪個工具,代理不可能答得更好。
工具爆炸是真實的風險。Manus 團隊的觀察是,只要開放使用者自帶工具,遲早有人掛上數百個來路不明的工具,武裝過度的代理反而變笨,所以他們的原則是避免在迭代中途動態增刪工具。替代做法是遮蔽而非移除:用感知脈絡的狀態機管理工具可用性,在解碼階段直接遮蔽不該出現的選項,工具定義本身不動,快取與歷史紀錄都不受傷。他們還刻意讓工具名稱帶一致前綴,瀏覽器相關都以 browser_ 開頭、命令列以 shell_ 開頭,要限定某狀態只能選某群工具時,靠前綴就能辦到。
few-shot 範例也有同樣的雙面性。Anthropic 的立場是範例仍然是好實踐,對 LLM 來說範例是勝過千言萬語的圖畫,但他們看過太多團隊把邊角案例塞成一張洗衣清單,試圖在提示裡窮舉每一條規則,這個方向他們明確不建議,正確做法是回頭策劃少而典範的多樣範例。Phil Schmid 從系統角度補充核心原則:確保模型不缺關鍵細節,垃圾進、垃圾出,知識與能力都要在需要且有幫助時才供給。Manus 的觀察是語言模型擅長模仿,脈絡越均一,代理越脆。
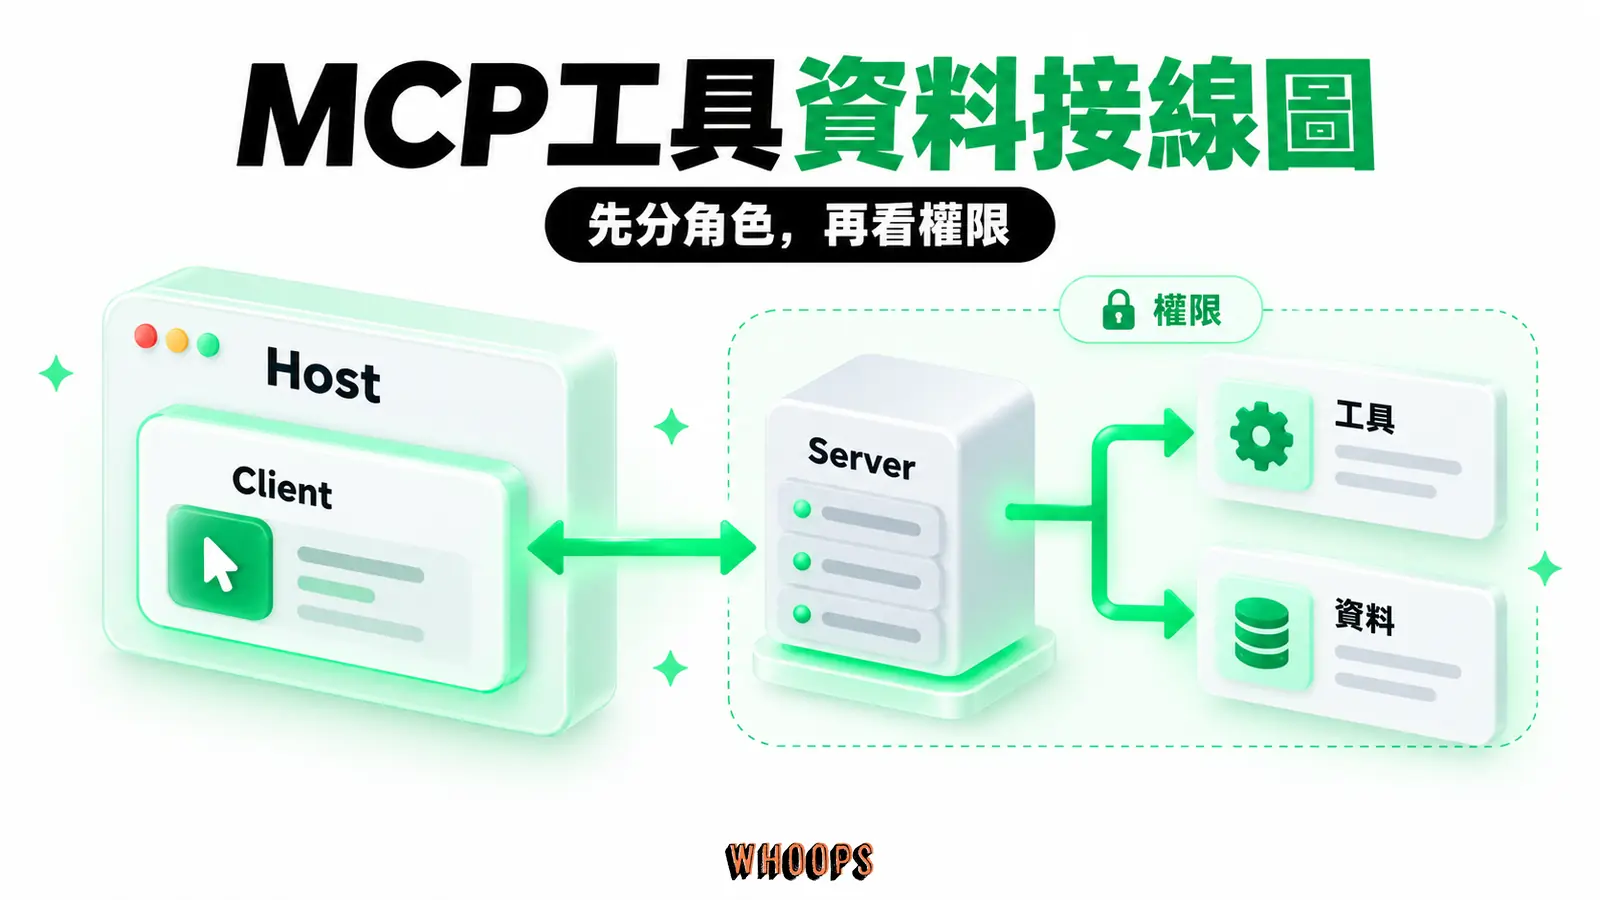
桌面端的實作已經把這些紀律產品化。以 Claude Code 為例,MCP 工具的完整 schema 預設延遲載入,模型只先看到工具名稱,需要時才經 tool search 載入特定定義,避免數十個工具描述一開場就佔掉窗口。官方文件也開了清單:你輸入任何字之前,CLAUDE.md、自動記憶、MCP 工具名稱與 skill 描述都會載入脈絡。這也是站上MCP 介紹裡工具軸的延伸:接上更多工具之前,先想清楚每個工具的定義會長期佔據每一輪的脈絡。
四種方法總覽:寫入、選取、壓縮、隔離
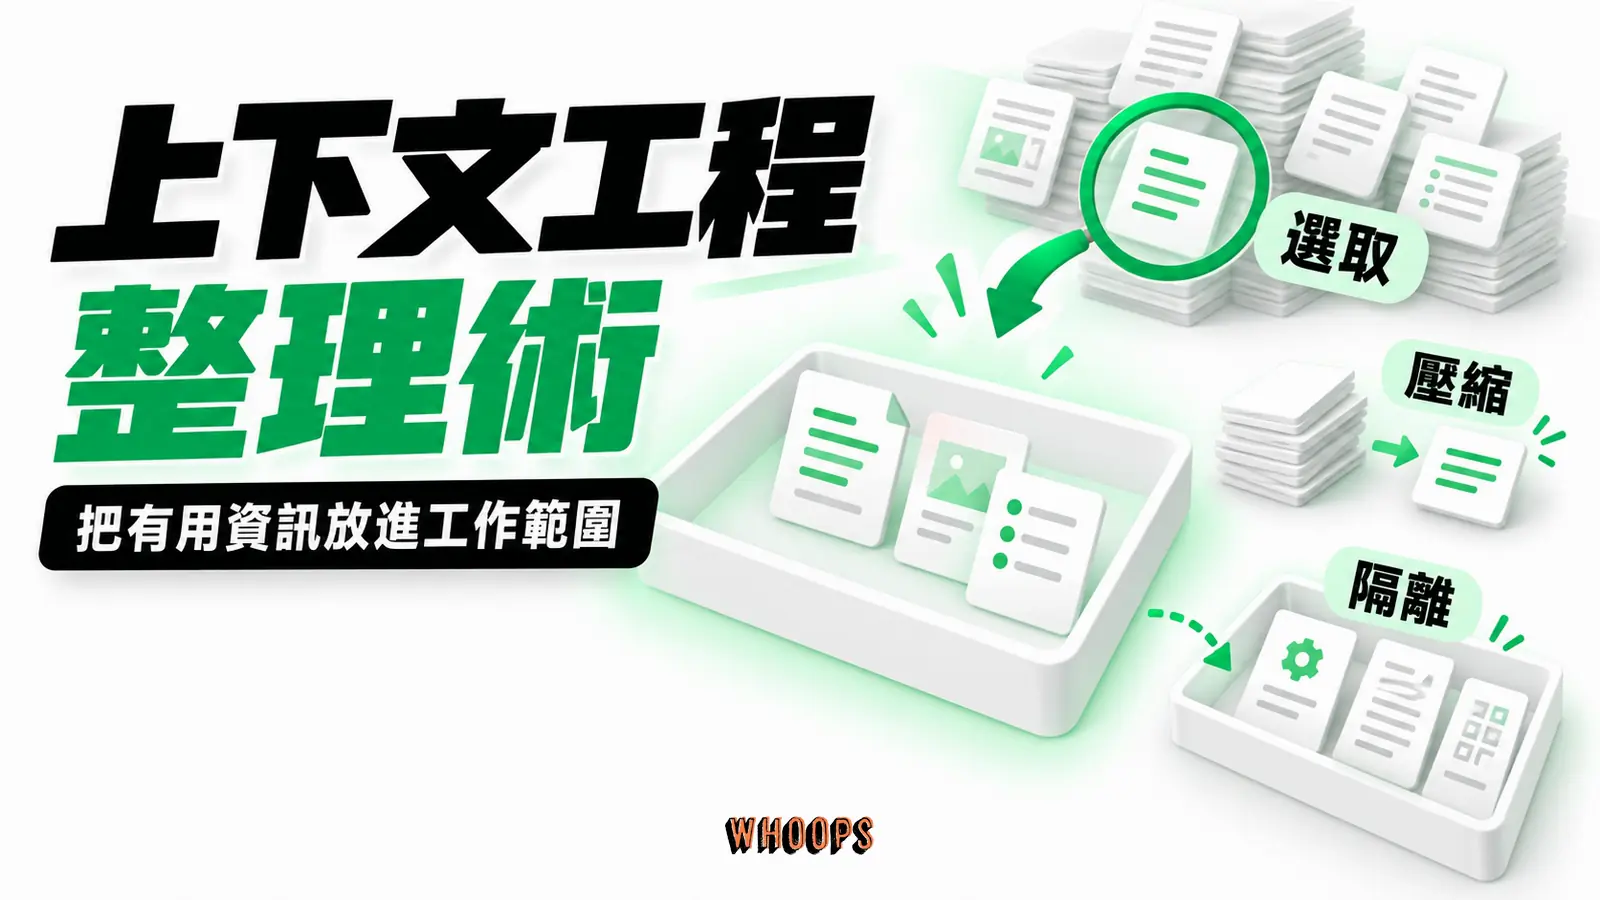
LangChain 2025 年 7 月的整理把動態的脈絡管理分成四個動作:寫入(write)是把資訊存到窗口外備用,選取(select)是把對的資訊拉進窗口,壓縮(compress)是只留下任務需要的 token,隔離(isolate)是把脈絡切開分給不同的執行單位。四個動作不是擇一使用,而是依任務形態組合,真實系統裡寫入與選取成對出現(先存後取),壓縮接在長對話後面,隔離墊在最重的探索底下。Anthropic 給出的對應關係可以直接當選擇題用:需要大量來回對話的任務適合壓縮,有明確里程碑的迭代開發適合筆記,需要平行探索的研究分析適合多代理架構。
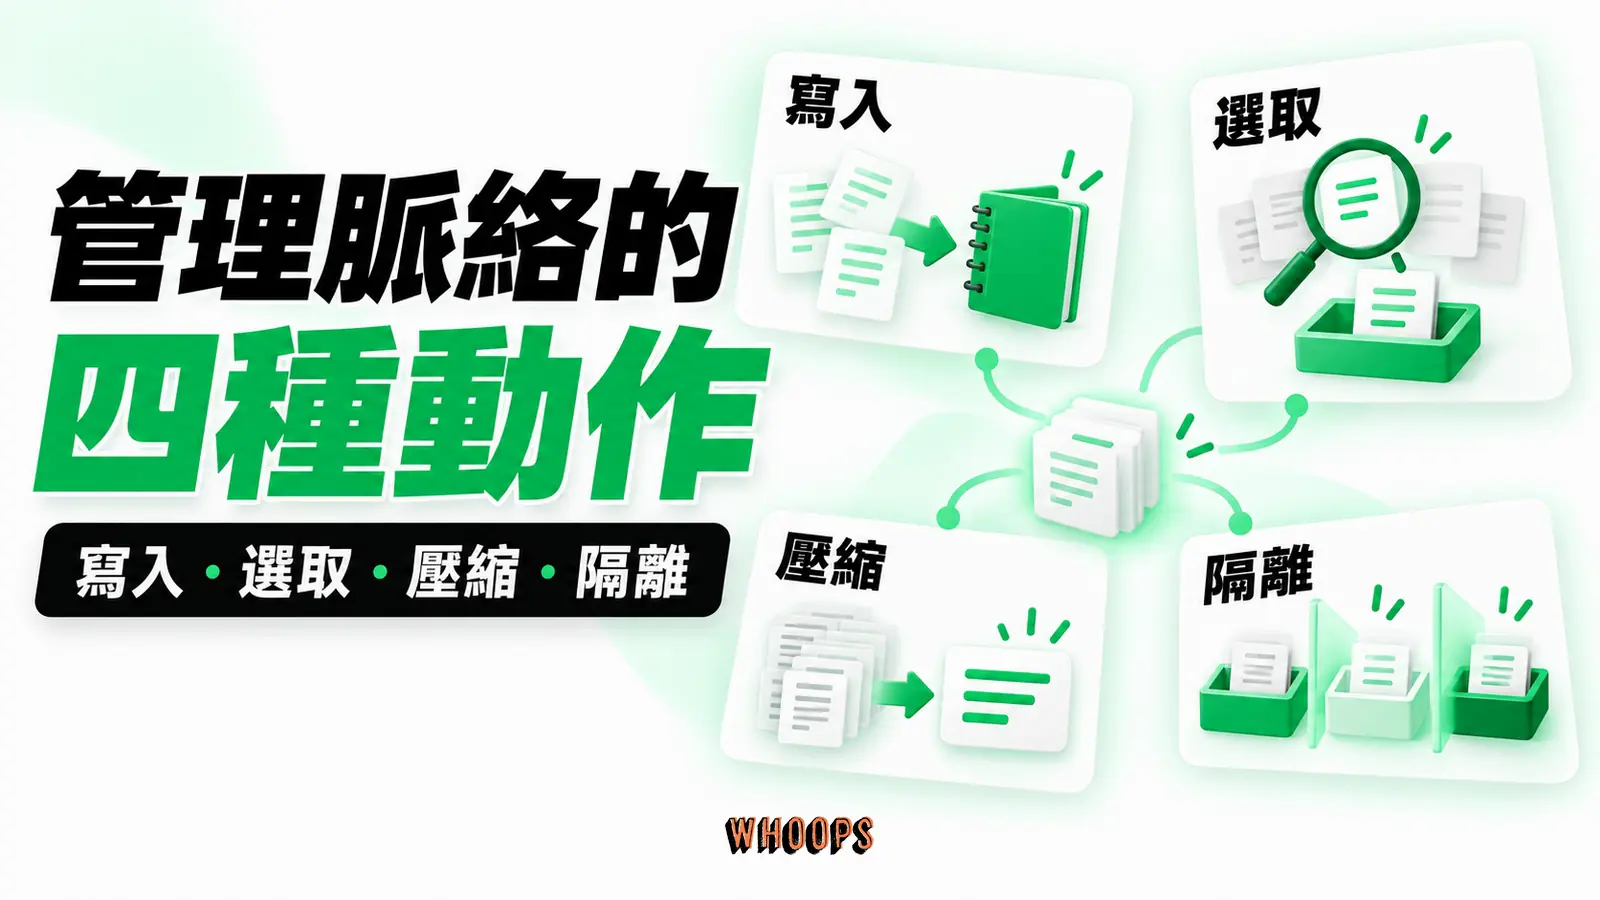
| 方法 | 核心動作 | 適合的任務形態 | 代表機制 |
|---|---|---|---|
| 寫入 | 把重要資訊存到窗口外 | 跨任務、跨對話要延續的狀態 | 筆記檔、待辦清單、記憶工具 |
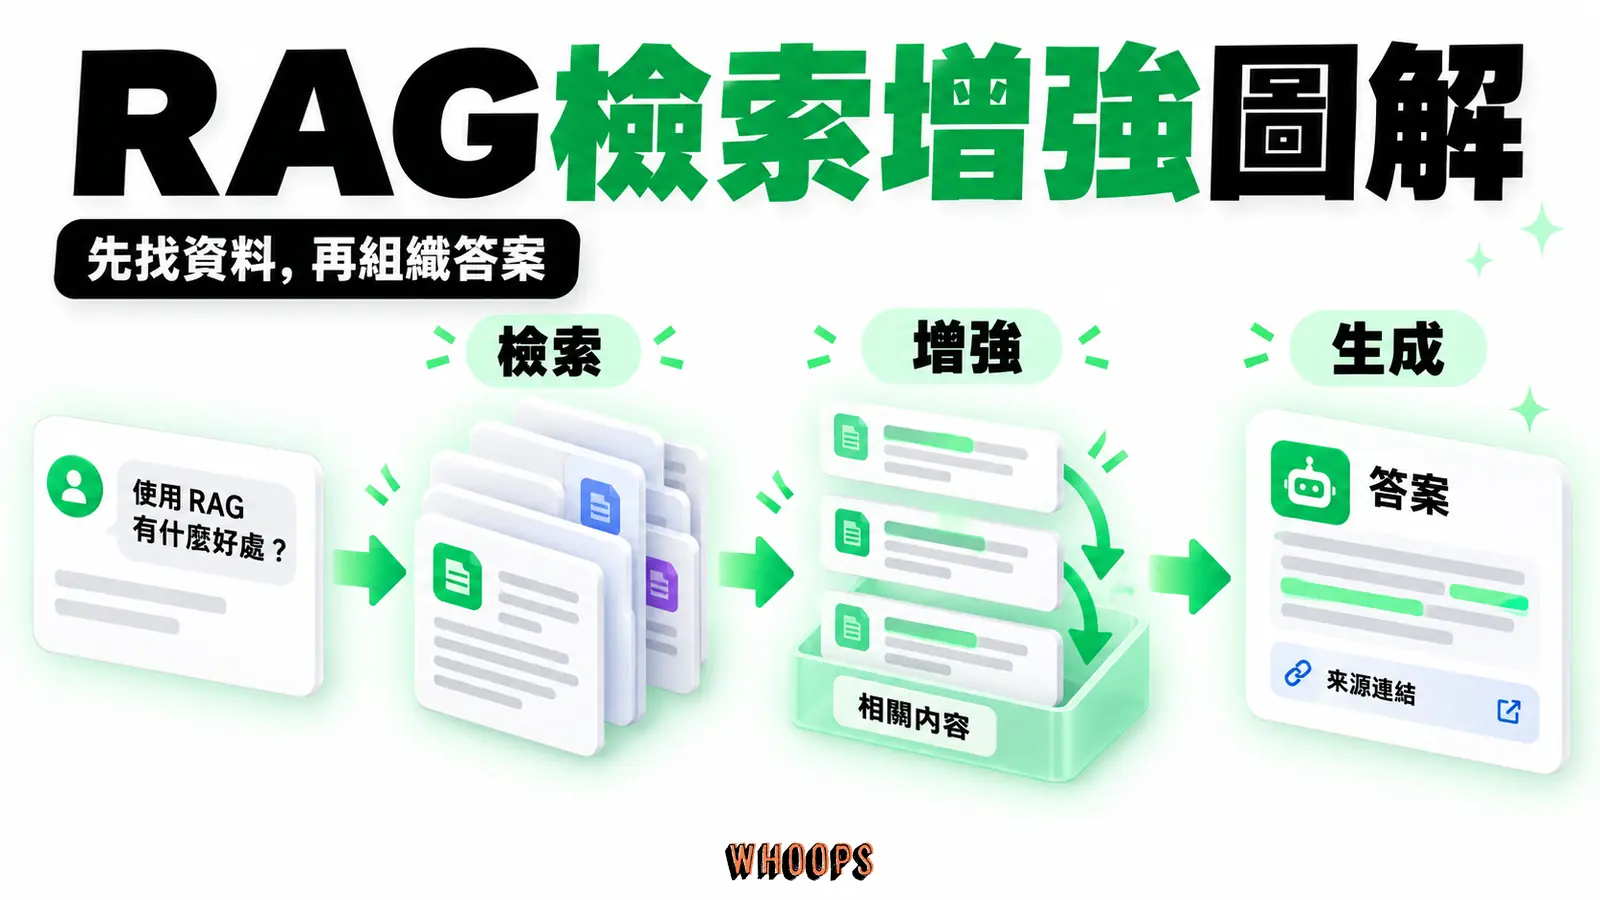
| 選取 | 把對的資訊拉進窗口 | 資料量大但每次只用一小撮 | RAG、即時載入、工具檢索 |
| 壓縮 | 摘要與修剪既有內容 | 長對話、多輪往返 | 自動壓縮、工具結果清除 |
| 隔離 | 切分脈絡給子代理 | 平行探索、大量閱讀 | 子代理、沙箱 |
方法一:寫入,把重要的事放到窗口外
寫入的本質是幫模型外接記事本。LangChain 稱之為 scratchpad:代理在執行任務的過程中,把中途的發現寫到脈絡窗外,需要時再讀回來。Anthropic 的多代理研究系統就是標準用法,主研究員先想清楚方法、把計畫存進記憶,因為一旦超過 200k token 就會被截斷,計畫必須先保住。Anthropic 工程文章把這套稱為結構化筆記:代理定期把筆記寫到窗口外的記憶,之後再拉回窗口,Claude Code 的待辦清單、自製代理的 NOTES.md 檔案都是同一個模式。
寫入的極致形態是讓檔案系統變成脈絡本身。Manus 團隊把檔案系統稱為終極脈絡:容量無限、天生持久、代理可直接操作。他們的壓縮因此講究「可還原」:網頁內容可以丟,只要 URL 還在,文件內容可以省,只要沙箱裡的路徑還查得到,縮短脈絡不至於永久丟失資訊。待辦清單在他們手裡還有第二個功能:任務平均要跑約 50 次工具呼叫,Manus 靠不斷重寫 todo 清單,把全局目標覆誦到脈絡末端,把計畫推進模型的近期注意力範圍,降低長迴圈裡的目標偏離。
記憶能撐起什麼規模的連續性,Anthropic 舉過 Claude 玩寶可夢的例子,這也是記憶改變代理能力的非程式域案例。代理在數千個遊戲步間追蹤目標,包括過去 1,234 步的練等進度,以及皮卡丘朝 10 級目標升了 8 級。脈絡重置後,它讀取自己的筆記,繼續多小時的練等與迷宮探索。
產品端已經把這類機制做進一般使用者摸得到的地方。2025 年 9 月 29 日,Anthropic 的公告宣布在開發者平台上推出 context editing 與記憶工具的公開測試:記憶工具讓模型透過檔案系統在窗口外存取資訊,可以在專屬記憶目錄裡建、讀、改、刪檔案,跨對話保存。內部評測的數字值得記:記憶工具搭配 context editing 比基準提升 39%,在 100 輪的網頁搜尋評測裡,context editing 讓代理完成原本會因脈絡耗盡而失敗的工作流,token 消耗同步減少 84%。ChatGPT、Cursor、Windsurf 也都有根據互動自動生成、跨 session 保存的長期記憶機制。Claude Code 則是以 CLAUDE.md 檔案承載專案指示,自動記憶只載入前 200 行或 25KB,先到的為準。LangChain 的補充是,許多程式代理會用特定檔案保存指示這類程序性記憶,有時也保存範例這類情節性記憶。
方法二:選取,把對的資訊放進來
選取處理的是「進窗口的許可證」。選取的常見形態是 RAG,把與任務相關的文件片段送進脈絡,站上的RAG 原理介紹補充這種檢索方法。工具本身也可以被檢索:LangChain 引的研究顯示,把 RAG 套在工具描述上、只載入與任務相關的工具,選工具的準確率提升三倍。這對 MCP 掛好掛滿的場景是直接解方。
更有代理味的形態是即時載入。Anthropic 觀察到團隊正從「推論前預先處理所有資料」轉向 just in time 策略:代理只持有輕量識別符,像檔案路徑、存好的查詢、網頁連結,執行時再用工具動態載入需要的內容。Claude Code 是現成例子:模型可以寫定向查詢、把結果存起來,用 head 與 tail 這類指令分析大量資料,從頭到尾不把整份資料載入脈絡。Anthropic 的類比是人類認知:我們不會背下整座圖書館,而是依賴檔案系統、收件匣、書籤這類索引,按需取用。
即時載入附帶一個常被低估的紅利:參照本身的 metadata 就是訊號。Anthropic 指出,檔名出現在 tests 資料夾與出現在核心邏輯目錄,暗示的用途不同,資料夾層級、命名慣例、時間戳都在告訴代理這份資訊何時、如何被使用。讓代理自主導航與檢索,等於啟用漸進式揭露:檔案大小暗示複雜度,命名慣例暗示用途,時間戳是相關性的代理指標,每一次互動產生的脈絡餵給下一個決策,代理一層一層拼出理解,工作記憶裡只留必要的部分。Claude Code 對這套的實作是混合式的:CLAUDE.md 直接預載進脈絡,其餘靠 glob 與 grep 在環境裡導航、即時取出檔案,避開過期索引的問題。要付的代價也明說了:執行期探索比拿預先算好的資料慢,而且需要扎實的工具與導航設計,不然代理會把窗口浪費在走死路上。最有效的代理因此常用混合策略:一部分資料預先取得以換取速度,其餘照自己的步調在執行期探索。
選取做不好也有帳單之外的代價。Willison 舉過一個例子:他請 ChatGPT 生成圖片,模型自行從記憶裡取出他的位置資訊注入圖中,這類不受控的記憶檢索,可能讓部分使用者覺得脈絡窗口不再屬於自己。對開發者,LangChain 的提醒是動手前先鋪兩塊地基:有能力看見進出模型的資料、追蹤代理每一步的 token 用量,有了這兩樣,才知道力氣該花在哪個環節,改了才知道有沒有效。
方法三:壓縮,摘要、修剪與工具結果清除
壓縮是面對長任務的第一個槓桿。這類任務會連續工作數十分鐘到數小時,例如大型程式庫遷移或全面研究,代理需要專門技巧繞過窗口限制。壓縮的定義很具體:對話接近窗口上限時,把內容摘要、再用摘要重啟一個新的脈絡窗口。Claude Code 的行為是最好的參考樣本,官方的脈絡窗口文件寫明:接近上限時會自動壓縮,滿窗口不會終止你的工作階段。LangChain 引的資料補上具體門檻:超過窗口的 95% 就執行自動壓縮,摘要對象涵蓋完整的使用者與代理互動軌跡。壓縮後會自動重讀本次工作階段中已讀或已編輯的檔案,最多五個,優先選最近修改者。超過 5,000 token 的檔案只保留路徑參照,用過的 skill 內文會重新注入,上限為每個 5,000 token、合計 25,000 token。主動操作的手法有兩個:跑 /compact 時帶上指示,摘要就會保留你指定的重點,而不是讓自動流程猜。也可以用 /autocompact 設個門檻,例如 500k,讓自動壓縮提早啟動。平台文件對長時間對話與代理式工作流的立場一致:服務端壓縮是主要的脈絡管理策略。
壓縮的風險在於失真。Anthropic 直言壓縮的藝術在於取捨,下手太重會丟掉當下看不出重要性、後面才知道關鍵的細節,調校建議是先把 recall 拉滿,確實捕捉軌跡裡每一段相關資訊,再回頭刪冗,提高 precision。相對安全的輕量作法是工具結果清除:工具早就在訊息歷史深處被呼叫過,原始回傳值沒有留在脈絡裡的必要。這個機制已經產品化為 context editing,接近 token 上限時自動清除過時的工具呼叫與結果,單獨使用就有 29% 的表現提升(搭配記憶工具 39%,同一段內部評測)。
取捨時有一類內容特別容易被清錯:失敗紀錄。直覺上,清掉錯誤的嘗試、讓脈絡乾淨,看起來更安全,Manus 團隊的看法正好相反:抹掉失敗等於抹掉證據,沒有證據,模型無從調整。當模型看得到失敗的行動與隨之而來的錯誤訊息或堆疊追蹤,它會內隱地更新信念,降低重複犯同樣錯誤的機率。他們甚至把錯誤恢復視為真正代理行為的清楚指標。壓縮與清理時,失敗的行動與錯誤資訊不宜一律清除,因為它們能幫助模型降低重犯機率。
與壓縮同族但更粗暴的是修剪。LangChain 的區分是:summarization 用 LLM 蒸餾出重點,trimming 用規則直接過濾,例如刪掉較舊的訊息。修剪見效快,但被刪掉的內容回不來,適合明確知道舊訊息無用的場景。摘要的施力點也不只在工作區塊尾端:LangChain 建議在代理設計的特定環節插入摘要,例如後處理 token 密集的搜尋工具回傳,或在代理與代理的交接邊界做知識移轉前的收斂。這一步的工程量不小,Cognition 為了做好摘要專門微調了一個模型,多少說明把「該留的留下來」做好從來不是便宜的事。
至於壓縮與開新對話的取捨,Claude Code 官方給的判準可以直接借用:換到無關的工作就跑 /clear,舊對話會擠掉你接下來需要的檔案,而且每一則新訊息都在替舊內容付成本。同一份文件也提醒 /rewind 的存在,可以從指定訊息往前或往後摘要,需要的時候比全量壓縮更外科。這幾個指令的差別記住一條就好:保留脈絡用壓縮,拋棄脈絡用清除,兩者都是把窗口還給接下來的任務。
方法四:隔離,子代理與沙箱分工
隔離的思路是別讓單一代理背著全部狀態,把脈絡切開分掉。Anthropic 的描述是:專門的子代理用乾淨的脈絡窗口處理聚焦任務,主代理掌握高層計畫,子代理去做深度技術工作或找資料。關鍵在回傳的形態:每個子代理可以用掉數萬甚至更多 token 探索,回來的只是一份蒸餾過的摘要,通常 1,000 到 2,000 token。關注點因此分離,搜尋的髒活留在子代理的窗口裡,主代理專心綜合與分析。
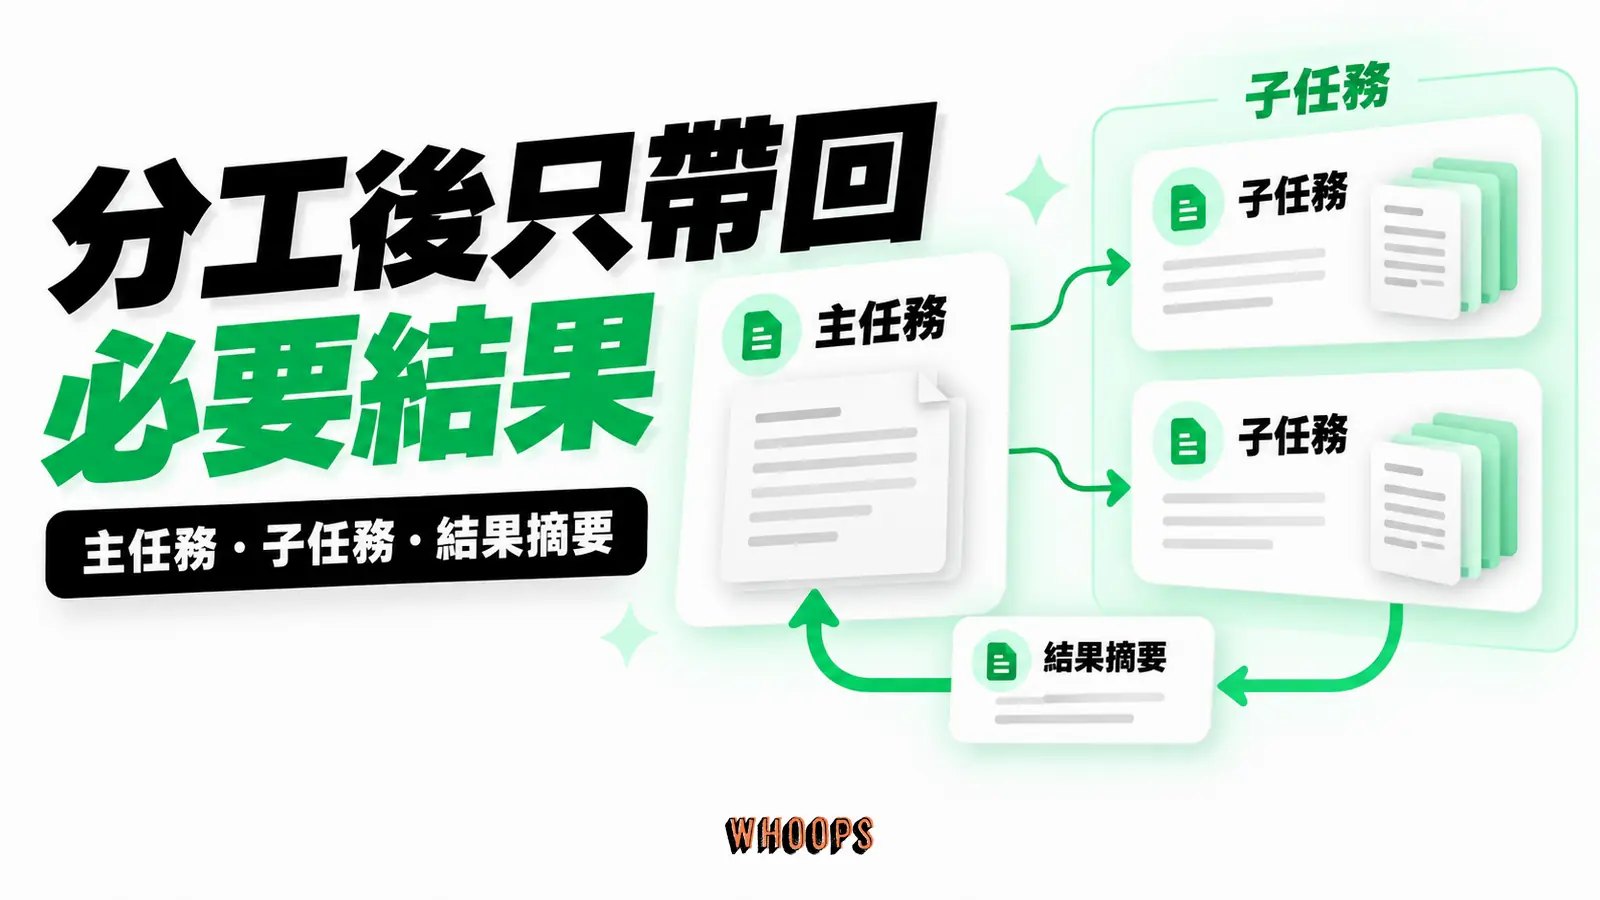
成效有實證也有代價。Anthropic 的多代理研究系統報告指出,多個隔離脈絡的代理優於單代理,原因正是每個子代理的窗口可以專注在更窄的子任務上,子代理平行探索、互不干擾。代價是 token 用量,約為一般對話的 15 倍,而且需要謹慎的提示工程來規劃子代理的工作。Claude Code 把這個模式做進指令列:研究類的大檔讀取交給子代理,檔案內容留在它的窗口裡,你的窗口只收到摘要。沙箱是同一邏輯的另一面,把 token 密集的物件放在執行環境裡,只把結論傳回模型。LangChain 進一步點名執行期的狀態物件:把欄位設計好,每一步只把該給模型看的欄位露出去,其餘隔離在狀態裡,效果等同沙箱,不需要真的開一個執行環境。
成本槓桿:快取友善的脈絡設計
脈絡的成本有一個常被忽略的槓桿:快取。Manus 團隊 2025 年 7 月的分享講得最白:若只能挑一個生產階段的指標,他們會挑 KV-cache 命中率,因為它同時決定延遲與成本。前綴相同的請求可以重用快取,Claude Sonnet 的快取輸入是 0.30 美元/百萬 token,未快取是 3 美元,十倍價差。在 100 比 1 的輸入輸出比下,輸入快取命中率會明顯影響帳單。
吃到快取的設計紀律只有兩條半。前綴保持穩定:系統提示開頭放精確到秒的時間戳,是最常見的錯誤,一個 token 的差異就會讓後面的快取整串失效。脈絡只附加不改寫:別回頭修改先前的行動與觀察,序列化要具確定性,很多語言的 JSON 物件不保證鍵順序,會默默弄壞快取。剩下半條是必要時明確標快取斷點。Claude 平台的快取說明文件給的計價結構呼應這套邏輯:以 Sonnet 5 為例,基本輸入每百萬 token 2 美元,快取寫入 2.5 美元(5 分鐘 TTL)、4 美元(1 小時 TTL),命中讀取 0.2 美元,輸出 10 美元,換算下來寫入貴 25%、命中是基本輸入的 0.1 倍。TTL 的選擇也有官方指引:系統提示的使用頻率高於每 5 分鐘一次,就續用 5 分鐘快取,因為它會持續被免費刷新。兩個門檻值得記:低於最小可快取長度(Sonnet 5 是 1,024 token)的提示直接不快取,而且不會報錯。OpenAI 端同樣給價差:GPT-5.1 輸入 1.25 美元、快取輸入 0.125 美元、輸出 10 美元(每百萬 token,官方模型頁牌價)。
工具端的失效點也值得記。Claude Code 的快取文件把快取分層說明:對話層變動不影響系統提示與專案脈絡層,系統提示層一變全部失效,因為後面所有內容都掛在不同的前綴後面。具體的失效觸發包括換模型、工具定義集改變與壓縮。換模型時,即使內容相同也會整段重讀。工具定義集若在輪次間變動,系統提示層的快取會失效。壓縮後的新歷史也不與舊前綴共用。對應的操作建議也因此簡單:開場就定好模型與強度,把 /compact 留給任務之間的自然休息點,任務中改動越少,命中率越高。Claude Code 預設替你處理提示快取,除非你主動停用,但看懂失效規則仍然值得,因為重建快取會讓下一個回應又慢又貴。
不寫程式也用得上:三個日常習慣
把視角換回網頁版對話,四種方法照樣有對應。習慣一,換任務就開新對話,這是 /clear 的民用版,判準也相同:下一個問題放進全新對話若完全說得通,舊脈絡對它就是純粹的干擾與成本。習慣二,貼資料前先整理:與其傾印整份原始文件,先給結論、清單與出處連結,這對應 Phil Schmid 定義裡的「以對的格式供資訊」,也是 Chroma 結論「呈現方式比在不在場重要」的日常版。習慣三,把會反覆用到的背景放進記憶或專案,讓它脫離單次對話穩定生效,不必每次重新貼上。用記憶功能時記得定期回頭整理:記憶是選取方法的輸入,內容越雜,選錯的機率越高,位置資訊被注入不相干請求的那類案例,源頭都是累積了沒在管的記憶。
寫作場景尤其吃這套。用 AI 協助產文的常見痛點是長對話越聊越失焦,這正是脈絡失焦的民用版。把大綱、素材清單、用語慣例放進專案層次管理,任務切換時重開對話、只帶必要的背景,配合站上SEO 文章寫作指南的架構方法,模型的輸出會穩定得多。寫作時的 few-shot 也要節制。同質脈絡可能讓代理更脆,多樣且典範的範例較符合來源建議。研究階段同理,查到的資料先寫進筆記檔再開寫作對話,引用與數字就有固定出處,不需要每次重貼整批原始內容。
三個常見誤解
誤解一:窗口越大,就不需要管理脈絡。Anthropic 對此有直接回應:等更大窗口不是解法,可預見的未來裡,各種尺寸的窗口都逃不過脈絡污染與資訊相關性的問題。Chroma 那邊還有一個反向提醒:主流的長脈絡評測在針堆裡找針的題型上接近滿分,容易讓人以為長脈絡問題已經解決,但他們把題目換成語意比對後,退化就現形了。Manus 的實測補上第二刀:超過一定長度後效能照樣退化,就算窗口帳面上撐得住,長輸入的成本也不會放過你,網頁與 PDF 的觀察結果一塞就爆,是代理場景的家常便飯。容量與品質是兩個不同的軸。
誤解二:上下文工程等於更高級的寫提示技巧。Phil Schmid 的定性是一個系統,不是一條字串:脈絡是在主 LLM 呼叫之前運行的系統的輸出,動態生成、依任務裁剪。Anthropic 的講法則是迭代:與寫一次 prompt 的離散任務不同,上下文工程在每次決定要傳什麼給模型時都要重做策劃。把它當提示技巧的進階版,會漏掉工具、記憶、檢索這幾塊真正的大頭。Anthropic 的提醒可以借來收尾:挑戰不只是寫出完美提示,而是每一步都審慎策劃哪些資訊進入模型有限的注意力預算。
誤解三:資料塞好塞滿比較保險。Chroma 的干擾項實驗已經否證這條:一個干擾句就能壓低表現,四個加乘惡化。毒化失敗模式再加一層風險,模型先前的幻覺留在脈絡裡,會被後續輪次當成事實引用,日常對應的症狀就是「模型越聊越篤定地引用自己先前講錯的話」。脈絡的價值密度比總量重要,這正是 Anthropic 那句「找最小的高訊號 token 集合」的意義。要實踐這條,工具端已經把開口做得很低:Claude Code 用 /context 看分類細目,用 /memory 直接編輯 CLAUDE.md 與自動記憶檔,看得到才管得住。
導入前的檢查清單
要把它落實到自己的工作流或產品,依序過五個問題。第一,你的痛點是哪一種:回想精度、成本、還是長任務的穩定性,對應的解法不同。第二,靜態層先自查:系統提示的高度對不對、工具集有沒有臃腫重疊,這層不修,動態方法都是在漏水的桶子裡舀水。第三,動態四法怎麼配:要延續狀態靠寫入,資料量大靠選取,多輪往返靠壓縮,平行探索靠隔離。第四,快取友善度:前綴穩不穩定、內容是不是只附加,這題沒顧好,前面省的 token 都會在帳單上吐回去。第五,觀測手段在哪:至少要能看到每一步的 token 用量與快取命中,Claude Code 用 /context 就有即時的分類細目,網頁版用戶至少對對話長度與失焦徵兆保持意識,退化與成本都會先在用量上現形,數字比感覺可靠。
回到最初的問題:上下文工程是什麼。一句話版本:把模型眼前的工作記憶當成稀缺資源來設計,在每一輪推論前策劃它的內容。Anthropic 的收尾建議是做最簡單可行的事,別為了工程而工程。把脈絡當成珍貴的有限資源,仍是打造可靠代理的核心。從今天的對話開始練習:下一個問題,值得一份乾淨的脈絡。