Headless WordPress 是什麼?無頭架構優缺點入門
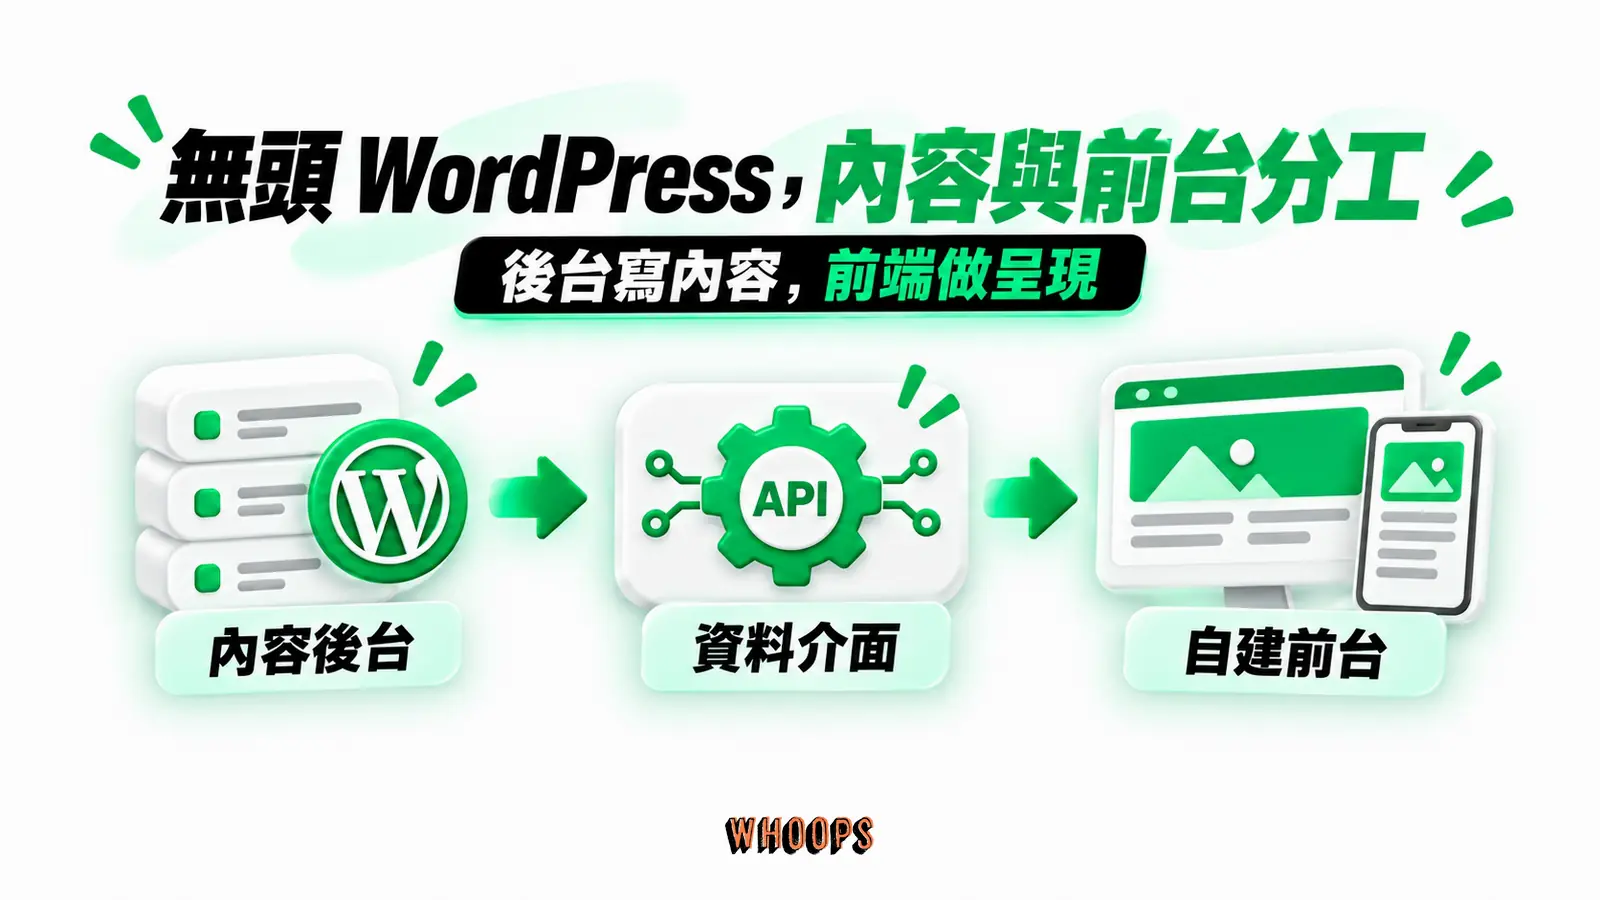
無頭 WordPress 把內容管理與頁面呈現拆開:WordPress 留在後台當編輯台,前台改由自建前端經 REST API 或 WPGraphQL 取 JSON 內容渲染。從兩條 API 路線的差異、應用程式密碼驗證、快取同步,到 SEO 與資安影響,依序拆解並附導入前檢查清單。
本頁目錄
- 無頭的定義:把「頭」拔掉之後,剩下什麼
- 傳統 WordPress 架構長什麼樣
- REST API:每一個 WordPress 站都內建的資料通道
- 這條通道平常就在工作
- 一個請求長什麼樣:分頁、欄位篩選與內嵌
- WPGraphQL:把查詢的主導權交給前端
- REST 與 WPGraphQL 怎麼選
- 權限與驗證:讀取寬鬆,寫入嚴格
- 前端怎麼接上 WordPress
- 內容的形狀:拿到的是 HTML 字串,渲染責任在你
- 內容更新怎麼同步:建置、快取與重新驗證
- 預覽與編輯體驗的變化
- 無頭之後,團隊怎麼分工
- SEO 影響:渲染方式決定搜尋引擎看到什麼
- 效能面:無頭不保證快,快取做得好才快
- 資安面:API 是開著的門,要懂它的鎖
- 誰適合走向無頭
- 誰不適合
- AI 時代的接軌:自建前端的門檻正在下降
- 導入前的檢查清單
- 收尾:無頭買的是控制權,付的是責任
無頭 WordPress 是把網站的內容管理與頁面呈現拆成兩套系統的架構:WordPress 繼續負責寫作、編輯與資料儲存,前台頁面交給另一套前端程式,經由 WordPress 內建的 REST API 或外加的 WPGraphQL 介面取得內容後自行渲染。編輯流程留在熟悉的後台,頁面怎麼長出來則換一組人、一套技術與一套新的運維責任。
這個選項值得認識的原因,在於 WordPress 的普及規模。W3Techs 在 2026 年 9 月的網站技術市占統計裡,記錄 WordPress 被 40.2% 的網站使用,在內容管理系統的市占率是 58.8%。當一個內容平台有這樣的覆蓋面,它的資料介面能做什麼、拆開前後端要付出什麼代價,就不只是工程團隊的內部話題,也是內容經營者與行銷團隊會被問到的架構題。
這份入門整理幾件事:無頭架構的定義與運作原理、REST API 與 WPGraphQL 兩條路的差異、權限與驗證怎麼運作、前端怎麼接、內容更新怎麼同步、SEO 與資安的實際影響,收在一份導入前的判斷基準與檢查清單。
無頭的定義:把「頭」拔掉之後,剩下什麼
Headless 直譯就是無頭,頭指的是網站的呈現層,也就是訪客看到的頁面。Vercel 的 Headless WordPress 指南給的定義是:無頭架構把前端與後端解耦,拆成可以各自獨立擴張的基礎設施。套到 WordPress 上,後端就是 WordPress 本體,負責內容的寫入、儲存與管理工作流程,前端則分開搭建,只向 WordPress 要資料。
WordPress 平時不是這樣運作的。Astro 官方文件的說法可以直接引來當對照:WordPress 是一套自帶前端的內容管理系統,但它也能作為無頭 CMS,把內容供應給 Astro 專案。換句話說,無頭不是 WordPress 缺了什麼,而是刻意不用它內建的那顆頭,讓頁面從別的地方長出來。
拆開之後,分工就變了。Vercel 指南對無頭 WordPress 的一句描述是,它讓你保留既有的內容工作流程,同時演進前端以追求更好的效能。內容團隊繼續在後台寫稿、上傳媒體、管理分類,開發團隊拿到的是資料介面與頁面渲染的完整控制權。這份控制權是無頭架構買到的東西,代價則散落在後面幾個段落:渲染責任、快取同步、預覽流程,這些工程責任落到自建前端這一側。
一個幫助理解的比喻:無頭化之後其實有兩顆頭。WordPress 那顆頭留在後台,給編輯與管理者看,功能一樣齊全。訪客看到的是你自建的新頭,五官由你決定。所謂無頭,拿掉的是 WordPress 同時負責前後台呈現的這個預設,並沒有把哪一邊砍掉。釐清這一點,後面討論的每一項成本與收益才不會張冠李戴。
傳統 WordPress 架構長什麼樣
要理解拆開的意義,先看沒拆開時的樣子。傳統的 WordPress 架站裡,前台頁面由 WordPress 內建的呈現層直接輸出,這個呈現層就是佈景主題,頁面長相、選單結構、版面配置都屬於它的職責,所以挑主題、改主題是WordPress 架站流程裡的一等大事。
在這個架構裡,外掛生態與前台綁在一起。表單、購物車、快取、SEO 標籤,這類外掛負責的正是訪客頁面上的輸出,屬於 WordPress 自帶前台的一部分。編輯體驗這一側則由區塊編輯器負責,WordPress 開發者文件說明,REST API 是區塊編輯器的基礎,也能支撐主題、外掛與外部應用打造管理及發布內容的新介面。也就是說,資料介面本來就內建在系統裡,無頭架構只是把這個介面從內部用途升級為對外供應內容的主要通道。
兩種架構的差異,可以用一張表先概覽,細節在後面各節展開。
左右捲動檢視完整表格
| 面向 | 傳統架構 | 無頭架構 |
|---|---|---|
| 頁面渲染者 | 佈景主題(WordPress 內建呈現層) | 自建前端(框架在瀏覽器或伺服器端渲染) |
| 內容來源 | WordPress 直接輸出 HTML | 前端經 REST API 或 GraphQL 取 JSON 內容 |
| 編輯體驗 | 後台寫作 | 後台寫作(工作流程保留) |
| 前台預覽 | 與前台同一套輸出 | 需另接前端預覽機制 |
| 前台外掛效果 | 直接生效 | 視外掛而定,前台輸出類需重做 |
| 運維範圍 | 一套 WordPress | WordPress 加一套前端與其部署管線 |
REST API:每一個 WordPress 站都內建的資料通道
無頭架構的第一條路,用的是 WordPress 自己的介面。Astro 文件以網址加上 /wp-json/wp/v2/ 示範 REST API 位址。WordPress 站預設有這套 API,未啟用 pretty permalinks 時則可改用 rest_route 查詢參數。這條通道不是外掛裝出來的,它隨系統一起提供。
歷史脈絡有助於理解它的定位。WordPress 4.7 的發布公告寫明,這一版內建了文章、留言、分類詞、使用者、後設資料與設定的 REST API 端點,並定位為以清楚、標準驅動的介面,提供機器可讀的外部存取,為外掛、主題、應用程式開啟新的互動方式。從那一版起,內容端點成為核心的一部分。
端點涵蓋的資源是完整的內容面。API 參考頁為每個端點列出可用的參數與回應資料格式,資源從文章、頁面、分類、標籤、媒體、留言、使用者,到設定、搜尋、區塊類型與外掛,都有對應的路由與方法。規劃無頭站時不需要記住全部端點,但要知道介面的涵蓋面到哪裡,因為前端要呈現的每一種資料,都要先確認它在 API 裡拿得到,拿不到的部分就要在後端補做暴露的工作。
形態上,這是一個 REST 風格的 JSON 介面。開發者文件的定義是:REST API 提供一個讓應用程式與 WordPress 站互動的介面,以 JSON 物件傳送與接收資料。整份參考文件補充,它一律使用 JSON 作為請求與回應格式,錯誤回應也不例外。概念上要分開兩個詞:路由是一條可映射到多個 HTTP 方法的 URI,單一方法加上路由的組合才叫端點。以 wp/v2/posts 這條路由為例,GET 端點回傳文章列表,POST 端點則接受帶驗證的請求來建立新文章。
還有一個分散式的特性值得知道。WordPress 的 REST API 不像許多服務有一個集中的 API 根,它分散在每一個支援它的站上,各自提供、各自發現。要確認一個站有沒有這條通道,做法輕量:對網址發一個 HEAD 請求,WordPress 會在所有前台頁面自動加上 Link 標頭,指出 API 的根位置。遇到 /wp-json/ 開不出來回傳 404 的站,官方文件的提醒是啟用 pretty permalinks,或改用 rest_route 查詢參數。註冊面還有一個細節:自訂文章類型與自訂分類法要在 wp/v2 命名空間裡出現,註冊時得加上 show_in_rest 設為 true,這在開發者文件的自訂內容類型章節有完整說明。
這條通道平常就在工作
把 REST API 當成無頭架構的專屬配備,是常見的誤解。開發者文件的說明是,它是區塊編輯器的基礎,也能支撐主題、外掛與外部應用打造管理及發布內容的新介面。你在後台打的字,編輯器就是經由這條通道在存取內容。對在主題或外掛裡寫互動功能的開發者,文件也點出它比舊式的 admin-ajax 機制更可預期、更結構化,讓人少花時間在取資料上,多花時間做體驗。換句話說,這扇門本來就開著,無頭架構只是把門外的路正式修通。
消費這條通道的程式,位置也不受限。開發者文件列出的範圍從 PHP、Node.js、Go、Java 到 Swift、Kotlin,任何能發 HTTP 請求並解讀 JSON 的語言都能與 WordPress 互動,參考文件並補充,API 使用內建的 HTTP 特性與動詞,現成的 HTTP 客戶端就能理解。名單裡也包含行動平台開發常用的 Swift 與 Kotlin,手機應用把 WordPress 當內容後端,是這條通道的另一種自然用途,網站與應用程式共用同一份資料。
一個請求長什麼樣:分頁、欄位篩選與內嵌
實際向 API 要資料時,三組參數決定了回應的形狀。第一是分頁。per_page 指定一次回傳的記錄數,整數範圍是 1 到 100,官方說明設上限的原因是大型查詢會傷害站點效能。集合類端點的回應會附上 X-WP-Total 與 X-WP-TotalPages 兩個標頭,分別告訴你集合的總記錄數與總頁數,前端據此決定還要不要繼續翻頁。
第二是欄位篩選。一篇文章的 API 回應包含基本資訊、後設資料、媒體資訊與其他資源的連結,不是每次都要全拿。加上 _fields 查詢參數,就能只要求回應裡的部分欄位,WordPress 會跳過不需要的欄位,省掉文件形容為可能昂貴的內部運算與查詢。對前端來說,回應變小,傳輸與解析的負擔隨之降低。
第三是內嵌。回應物件裡的 _links 屬性依關係分組列出相關資源的連結,例如 author 描述資源與作者的關係。帶上 _embed 參數,伺服器就會把這些相關資源直接內嵌進回應,從 5.4 開始還能指定只要哪些關係,減少 HTTP 往返次數。這些參數的完整行為收錄在開發者文件的全域參數章節。也是因為內容與資料以 API 形式敞開,用 Claude Code 經 MCP 介面直接讀寫 WordPress 內容的自動化工作流,走的正是同一條通道,這點在後面 AI 段落會再回來。
把這些參數組起來,一個實際的查詢會長這樣:向 /wp/v2/posts 發請求,帶上 per_page 控制筆數,用 _fields 指定作者、編號、摘要、標題與連結。若要加上 _embed 取得關聯資料,還須核對欄位篩選後的回應是否保留所需內嵌資料。開發者文件示範上述 _fields 欄位清單,文件並提醒 _fields 從 5.3 開始支援巢狀屬性,註冊了許多後設欄位的站可以只取其中一個鍵值。學會讀這一行查詢字串,等於學會無頭前端的取料語言。
WPGraphQL:把查詢的主導權交給前端
第二條路是 GraphQL。WPGraphQL 官網的自我介紹是:一個免費、開源的 WordPress 外掛,為任何 WordPress 站提供可擴充的 GraphQL schema 與 API。它不是核心內建的,要另行安裝,裝了之後站上多出一個 GraphQL 端點,Vercel 指南記錄它的預設位置是 /graphql。
GraphQL 與 REST 的根本差異在查詢的主導權。WPGraphQL 官網說明,用戶端發出宣告式查詢,要求確切需要的資料,回應就給確切被要求的內容,不多給。REST 若未使用 _embed,取得文章、作者與分類可能需要多次往返,GraphQL 則能在一次往返裡把巢狀的關聯資料取齊,官網形容這對慢速的行動連線也夠快。對內容結構複雜、頁面需要多種關聯資料的站,一次查詢取齊是實際的開發體驗差異。
這個專案在生態裡的位置有官方背書。2024 年 10 月 WordPress 官方公告宣布 WPGraphQL 成為 WordPress.org 上的 canonical plugin(官方背書、確保長期支援的外掛地位),外掛頁面並說明這確保了長期支援與持續成長的使用者和貢獻者社群。同一頁標示的數字看,活躍安裝 30,000 以上,測試至 WordPress 7.0.6。同頁也列了它與 Next.js、Astro、SvelteKit 等現代框架相容、能在單一查詢取齊資料的特性,以及以快取失效為訴求的 Smart Cache 延伸。
延伸生態讓這條路更完整。官網列出的配套包含把 Advanced Custom Fields 欄位暴露進 schema 的 ACF 延伸,外掛頁也列出訴求快取失效的 Smart Cache,再加上啟用後就在後台的 GraphQL IDE,查詢、欄位、快取三件事都有對應工具。對已經用 ACF 組織內容的站,這代表走向 GraphQL 不必放棄既有的欄位結構。
REST 與 WPGraphQL 怎麼選
兩條路沒有絕對的優劣,選擇取決於依賴與查詢形態。REST 的優勢是零安裝:任何 WordPress 站開箱就有,文件齊全,而且 _fields 可縮小回應,_embed 可內嵌關聯資料、減少往返。WPGraphQL 的優勢是查詢表達力:巢狀關聯一次取齊、按需給欄位,加上已成 canonical plugin 的長期支援地位與快取失效的生態。一個務實的判斷方式是:單純讀公開內容、想少一個相依套件,先從 REST 開始。內容模型複雜、頁面資料組合多變、或團隊已用 GraphQL 工具鏈,WPGraphQL 的省力才會顯現。
左右捲動檢視完整表格
| 比較項 | REST API | WPGraphQL |
|---|---|---|
| 取得方式 | 核心內建,零安裝 | 安裝外掛(免費開源) |
| 資料格式 | JSON(含錯誤回應) | JSON(GraphQL 查詢結果) |
| 欄位控制 | _fields 參數篩選 | 查詢本身宣告所需欄位 |
| 關聯資料 | _embed 內嵌部分關係 | 單次查詢取巢狀關聯 |
| 生態定位 | 核心功能,編輯器也依賴它 | canonical plugin,官方公告背書 |
選 REST 或 WPGraphQL 時,應先盤點公開與受保護資料的讀寫需求。下一節依 WordPress REST API 官方文件說明驗證與權限。
權限與驗證:讀取寬鬆,寫入嚴格
無頭架構的第一個資安問題是:API 開著,誰能讀到什麼。Astro 文件的說法可以當基準:REST API 預設就對外部請求開放資料讀取,不需要驗證,但匿名讀取本身不能修改你的資料或站點設定。開發者文件把界線說得更細:站上公開的內容,經 API 一般也公開可取,而私密內容、密碼保護內容、內部使用者、自訂文章類型與後設資料,要有驗證或你明確設定才拿得到。換句話說,後台的公開設定會影響 API 的可見性,自訂內容是否進 API 還要確認暴露設定。
要寫入,就需要驗證。WordPress 內建的標準驗證是 cookie 驗證,但它依賴 WordPress 的 cookie,因此只適用於 API 在 WordPress 內部使用、且當前使用者已登入的情境,自建的前端在別的網域上,用不了這條路。開發者文件對遠端應用的建議從 5.6 版起有了內建答案:Application Passwords(應用程式密碼),在使用者的編輯頁面就能產生,透過 Basic Auth 在 https 上傳遞。官方整合指南補充了細節:這組密碼有 24 個字元,不用特殊字元,只由大寫、小寫與數字組成,輸入時帶不帶分隔空格都可以,系統驗證前會把空格剝掉。它預設只在走 SSL 的站點上對所有使用者可用,用途是給程式呼叫,不是給人拿去登入後台,官方整合指南明講它是為應用程式的程式化使用而生,不是人類的互動式工作階段。舊的 XML-RPC 介面也能直接拿它取代帳號的真實密碼。
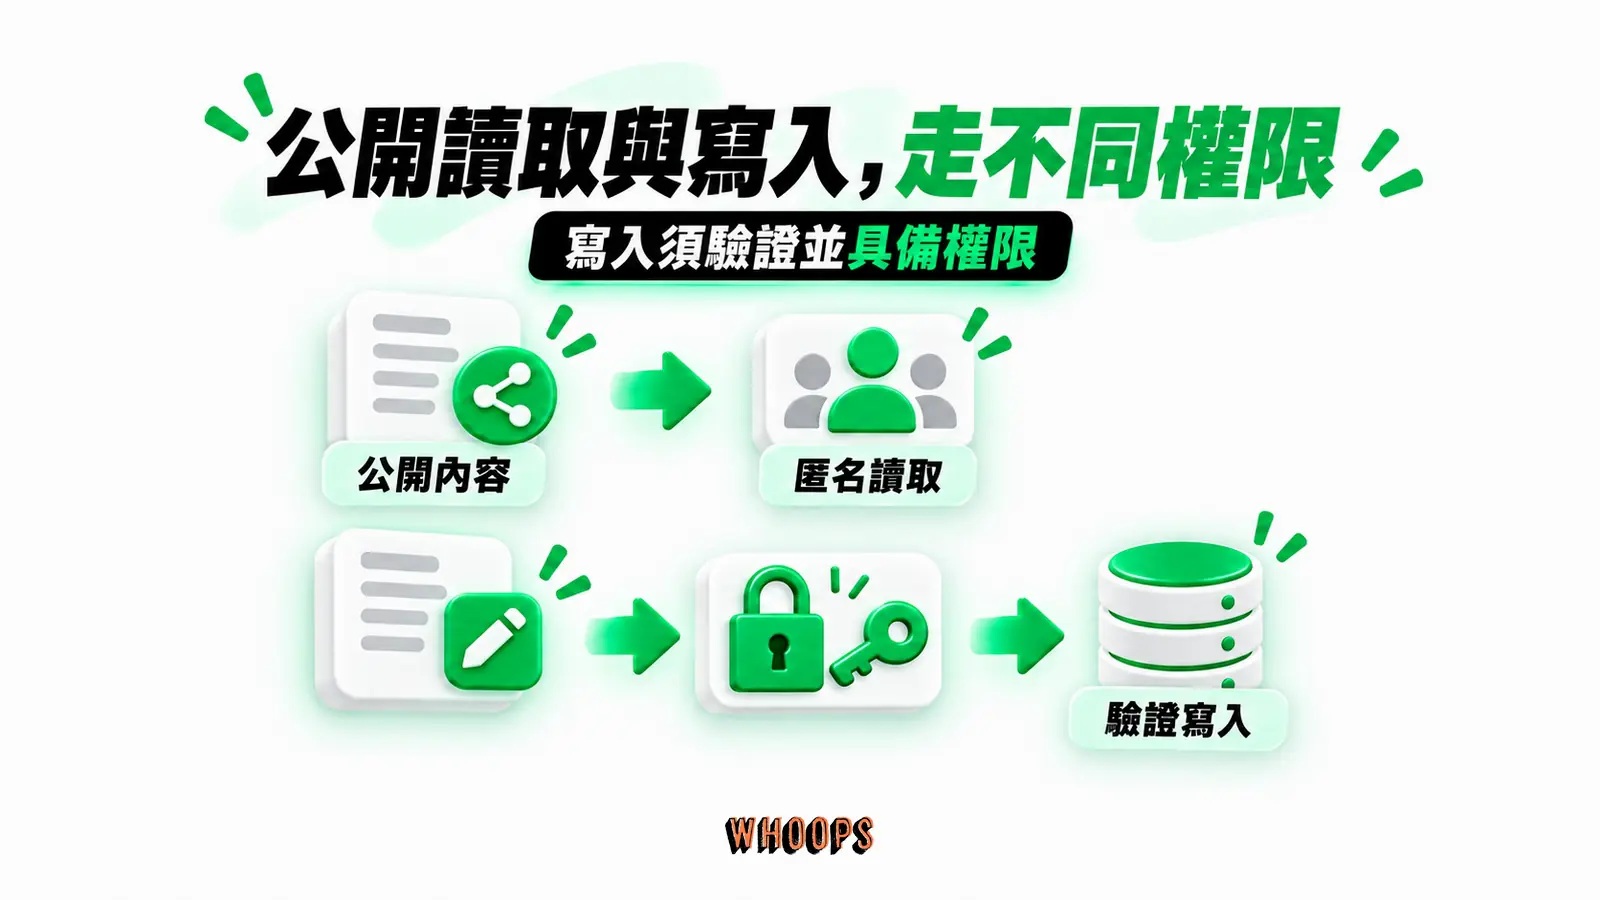
取得憑證也有正式的授權流程,不必請使用者手動複製貼上。整合指南說明,REST API 根網址的回應裡帶有授權資訊,應用程式可以引導使用者到 wp-admin 的 authorize-application.php 頁面,以 app_name 這個必填參數標示應用程式名稱,並以 success_url 指定核准後的導回網址,憑證就能自動送回應用程式。要注意的是,success_url 這類參數必須使用 https,走 http 會直接得到錯誤。這套流程讓連結 WordPress 帳號成為一般應用也能提供的安全體驗。
管理面也有設計。應用程式密碼會記錄最近一次使用的時間與 IP,整合指南說明 Last Used 欄位的準確度在 24 小時內,用來找出不再使用的憑證並安全撤銷。逐應用發放憑證的思維在這裡成立:一個前端、一組密碼,換掉前端就撤掉那一組,主帳號密碼不必跟著換。若專案需要別的驗證模式,開發者文件也註明可用外掛支援,例如 OAuth 伺服器與 JSON Web Token 類的方案,細節收在驗證章節。
前端怎麼接上 WordPress
後端就緒後,前端的接法在框架官方文件裡有範例:Vercel 的 Next.js 指南與 Astro 文件提供了整套流程。Vercel 指南的流程是:裝 WPGraphQL 外掛,建立 Next.js 專案,把環境變數 WORDPRESS_API_URL 指向 GraphQL API,資料就從 WordPress 後端進到前端頁面。指南並提供以 create-next-app 直接複製 cms-wordpress 官方範例的起手式。Astro 文件這一側則強調不必加裝什麼就能起步:WordPress 內建的 REST API 就能把資料連進 Astro,抓資料後以 set:html 指令把資料屬性渲染進頁面。
接線的細節比想像中親民。指南的步驟是在後台的外掛搜尋找到 WPGraphQL,安裝並啟用,側邊選單隨即多出 GraphQL 區塊,裡面的 GraphQL IDE 可以直接撰寫並測試查詢。還沒有 WordPress 伺服器的人,指南建議用 Local 之類的工具在本機先起一個。專案跑起來之後,本機開發伺服器上的首頁,文章內容就是從 WordPress 後端來的,這一刻等於親眼看見無頭架構在動:兩個系統,一個管內容,一個管畫面。
自訂內容類型是一個常見的接線點。Astro 文件提醒,要在 API 裡使用文章與頁面以外的自訂文章類型,得先在 WordPress 後台設定,讓它透過 REST API 暴露出來,這呼應了前面 show_in_rest 的註冊細節。內容模型先在後台想清楚,前端的查詢才不會一直改。
這條路也可以放進架站方式的比較。若正考慮提示詞架站服務,先確認前端與資料介面由誰提供、日後由誰維護。無頭 WordPress 則把訪客頁面交給自建前端,開發團隊取得較多呈現控制權,同時要安排部署、監控與更新。比較的重點是責任分工是否符合團隊能力。
內容的形狀:拿到的是 HTML 字串,渲染責任在你
從 API 拿到的文章內容,主體是一段 HTML 字串。Astro 文件示範以 set:html 指令把它放進頁面,這個細節點出無頭前端的日常課題:框架對字串的預設處理是轉譯而非解析,要把內容當 HTML 注入頁面,得用框架提供的明確指令。內容裡的區塊結構、媒體引用、連結,進到前端後怎麼呈現、要不要再加工程,都是前端團隊的工作清單。
這也是無頭架構把雙面刃講清楚的地方。拿到原始 HTML 字串,代表前端可以自由決定排版、拆解區塊、重組元件,彈性完整,同時代表內容格式一旦在 WordPress 端變動,前端這側要接得住。內容與呈現解耦,耦合並沒有消失,只是搬進了前端的程式碼裡。
區塊編輯器的內容也可以再加工。外掛目錄裡有把 Gutenberg 區塊轉成 JSON 經 WPGraphQL 取用的社群外掛,想逐塊解析、逐塊設計元件的團隊有這條路,想整段 HTML 直接注入的團隊則維持原樣。兩種做法對應兩種前端哲學,成本與彈性各異,重點是在動工前決定,不要混著做。
內容更新怎麼同步:建置、快取與重新驗證
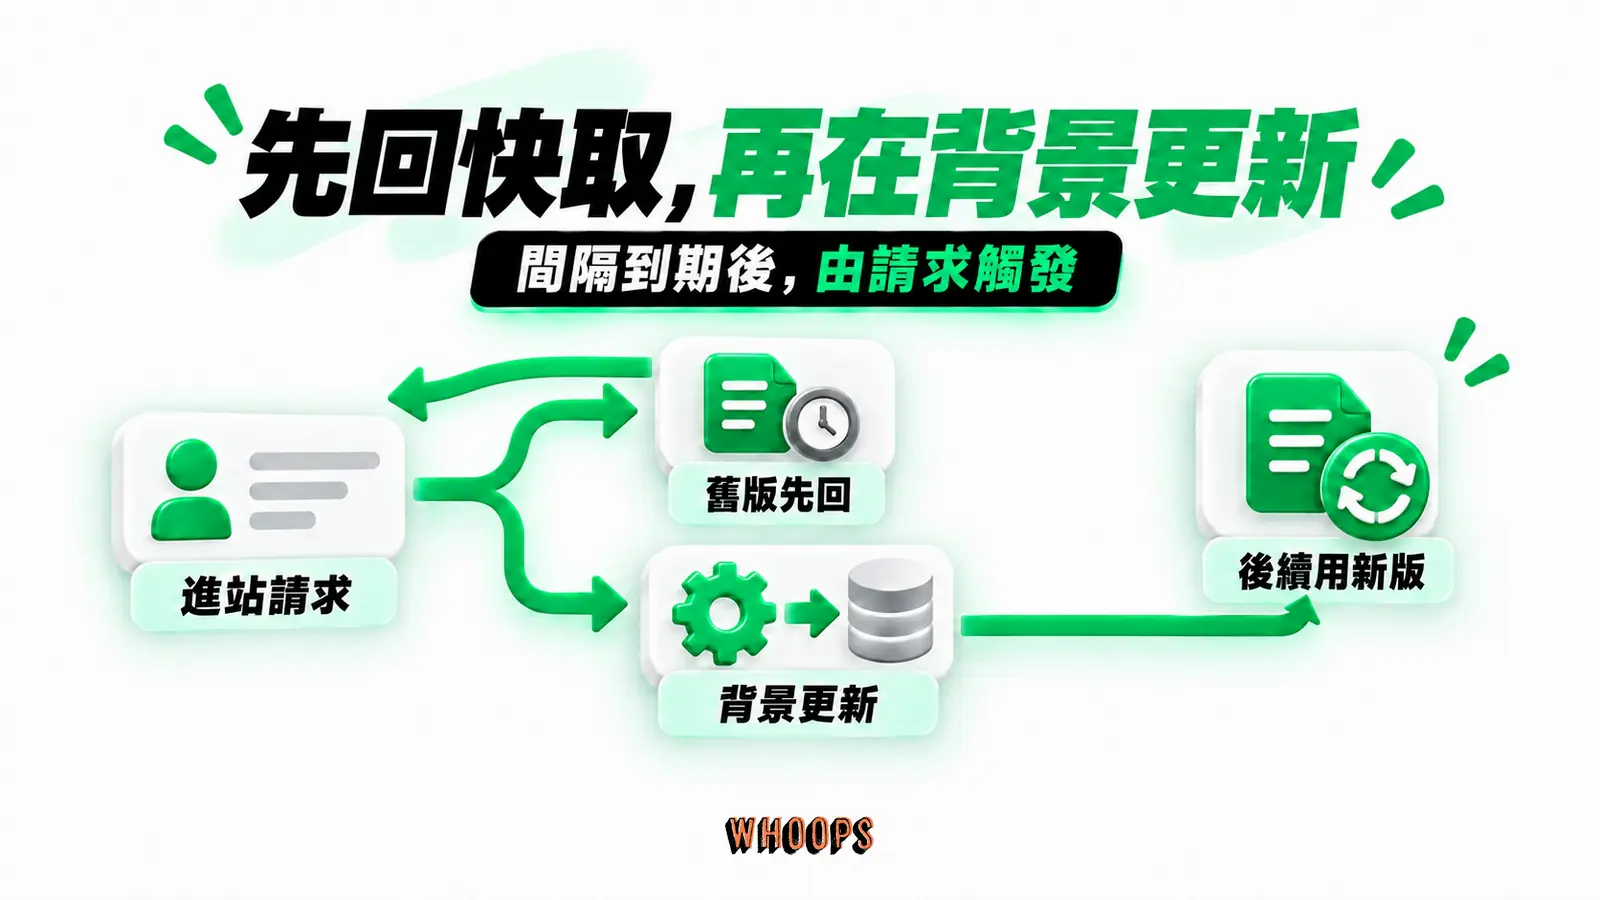
無頭站把內容源與訪客頁面分開後,編輯按下發布,前台什麼時候會更新?答案取決於前端的渲染策略。Vercel 指南介紹的 Incremental Static Regeneration(增量靜態再生,ISR)機制,允許不重新部署網站就更新來自 WordPress 的內容。做法是在頁面層級設定 revalidate 屬性,定義一個時間間隔,由進站請求觸發背景檢查 WordPress 的內容更新。重新驗證進行中,訪客先拿到快取版本,更新版本存在就接著換上,這種模式一般稱為 stale-while-revalidate。
同步策略其實是一條光譜。一端是發布時全站重建,站點規模變大後,全站重建的時間成本容易成為瓶頸。中間是由進站請求觸發的背景重新驗證,revalidate 設定的是下次可觸發檢查的間隔,也影響內容新鮮度與負載。另一端是事件觸發的前端頁面更新。WPGraphQL Smart Cache 的標籤式失效處理 WordPress API 查詢快取,不能替代前端頁面的更新安排。沒有標準答案,對的選擇取決於編輯部的發布節奏,以及訪客對內容時效的期待。
快取帶來的韌性有時比即時更重要。Vercel 指南描述的情境是:WordPress 伺服器停機時,託管的前端不受影響地繼續服務流量,端出快取裡最近生成的靜態內容,等內容源恢復上線再顯示新內容。對高流量站來說,內容源與呈現層分離後,一台掛了不等於全站掛了。
同步的間隔設定則是新形態的發布作業課題。revalidate 設定檢查間隔,間隔到期後,仍需進站請求才會觸發背景檢查。間隔到期的訪客先拿到快取版,更新版在重新生成完成後接上。若進站請求頻繁,間隔設得太短會增加背景檢查負載。追求發布後盡快可見的站,須規劃前端頁面的更新或快取失效,不能只依賴內容源 API 的快取設定。網站速度優化的舊知識在這裡仍然適用,在無頭架構裡,還要依實作檢查前端頁面與 WordPress API 兩側的快取。
預覽與編輯體驗的變化
編輯後台本身在無頭架構裡是不變的,寫作、媒體、分類照舊,這是官方與框架文件一致描述的賣點:內容工作流程留在原處。變的是按下預覽之後的世界。傳統架構裡,預覽與訪客看到的是同一套前台輸出,所見即所得。無頭架構裡,WordPress 的預覽連結開出來的是它自己那顆已經不在前線的頭,不是訪客真正會看到的頁面。
所以預覽要能用,得在前端單獨接線。Vercel 指南的範例程式裡,頁面層級的函式簽名就帶著 preview 旗標,這正是無頭站把預覽當成前端功能來開發的證據。實務上這代表一條新的工作項目:草稿預覽的權限、路由與快取排除,要在前端的方案裡一併設計,編輯部的驗收流程也要跟著調整。
無頭之後,團隊怎麼分工
架構拆開之後,人的分工也跟著拆開。內容團隊的世界幾乎不變,寫作、審稿、媒體管理照舊在後台進行,這是官方與框架文件一致強調的保留項目。前端團隊接手訪客看到的一切,從資料查詢、版面元件到錯誤處理。維運的角色則變成看顧兩套系統:WordPress 的主機與更新,加上前端的部署管線與監控。三種角色的介面變清楚了,代價是溝通必須更正式,誰改了什麼、影響哪一側,需要有文件可循。
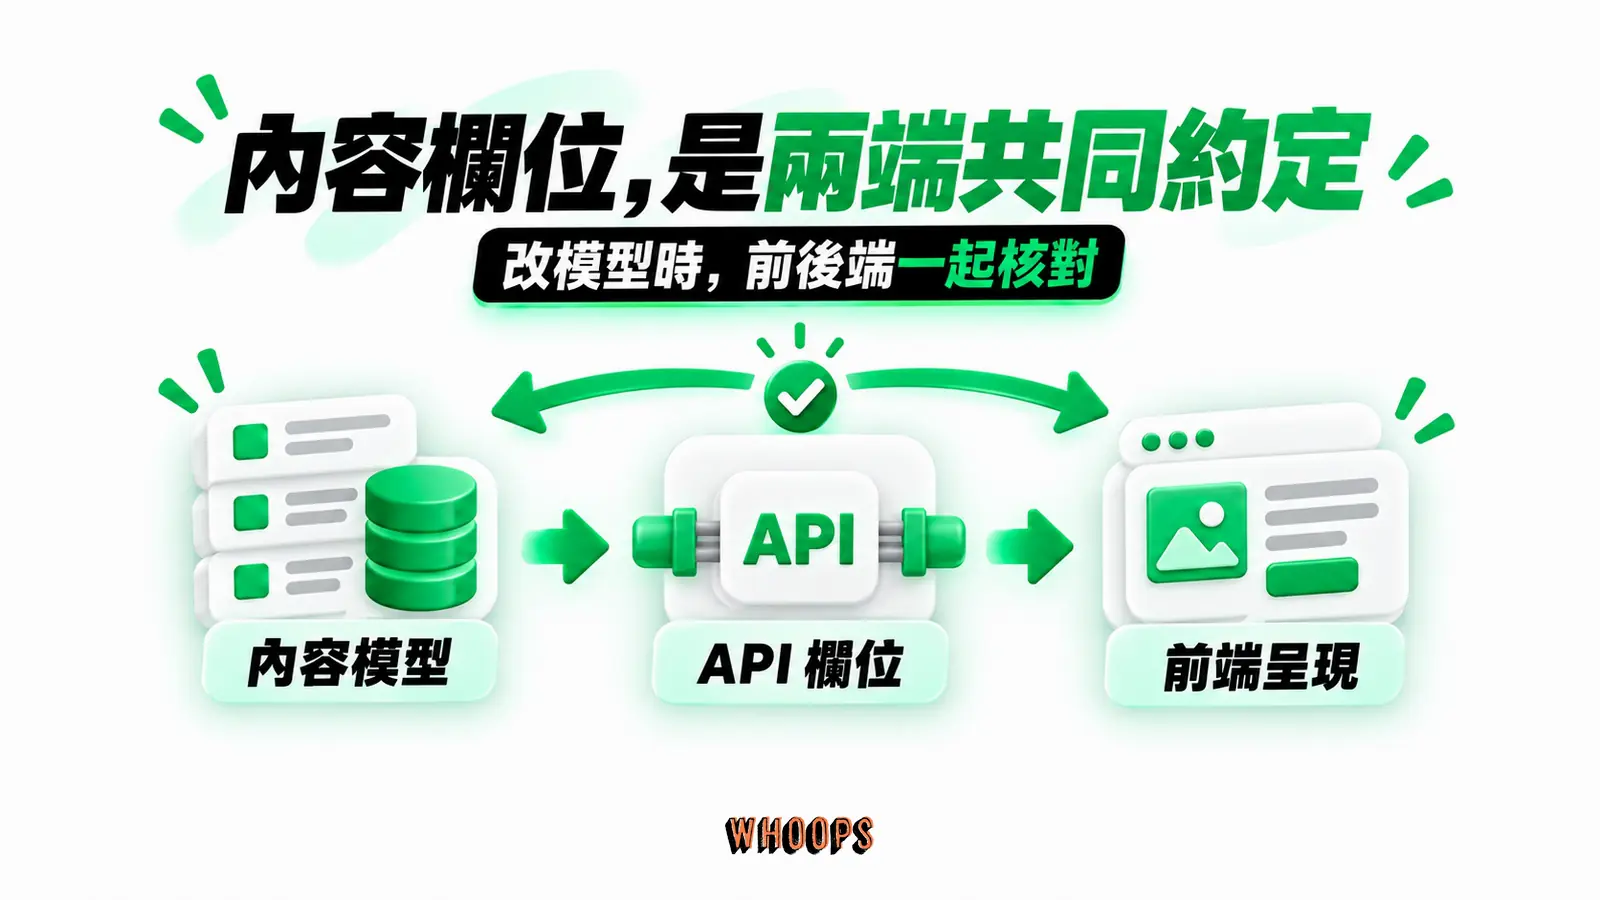
介面約定裡最重要的那份文件,是內容模型本身。自訂文章類型要不要進 API、欄位怎麼命名、分類法怎麼對應,若選 REST API,自訂文章類型能否進入介面要看註冊時的 show_in_rest。若選 WPGraphQL,則須另行確認所需類型已納入 GraphQL schema。後端改了模型,前端的查詢與元件就要跟著改,這份聯動在傳統架構裡由主題開發者一個人吸收,在無頭架構裡變成兩個團隊之間的約定。把內容模型當成契約來管理,是無頭專案能不能走下去的關鍵。
SEO 影響:渲染方式決定搜尋引擎看到什麼
無頭架構對 SEO 的影響,核心變數是頁面怎麼被渲染出來。Google Search Central 對 JavaScript SEO 的說明指出,Google 處理 JavaScript 網頁應用有三個主要階段:檢索、渲染、索引。Googlebot 會把頁面排進渲染佇列,文件說明頁面可能在佇列裡待上幾秒,也可能更久,等到資源許可,才由無頭 Chromium 渲染頁面並執行 JavaScript,再以渲染後的 HTML 建立索引。
如果前端採用 app shell 模式,初始 HTML 不含實際內容,內容要等 JavaScript 執行後才生成,那麼搜尋引擎與其他爬蟲看到的,取決於它們會不會、以及多快執行 JavaScript。Google 文件對此的建議直白:伺服器端渲染或預渲染仍然是好主意,它讓網站對使用者與爬蟲都更快,而且並非所有機器人都能執行 JavaScript。選擇靜態生成或伺服器端渲染的無頭前端,讓送進回應的 HTML 就帶著內容,是把這個風險直接移除的做法。
頁面元素與連結的處理原則,Google 文件也有明確立場。以 JavaScript 把連結注入 DOM 沒有問題,只要符合可檢索連結的最佳實務。meta description 與 title 元素可以用 JavaScript 設定或變更,這對無頭前端是好消息,因為這些輸出本來就要由前端的程式動態組合。canonical 的建議則更保守:最好的方式是寫在 HTML 裡,如果非用 JavaScript 不可,就必須確保設定的值與原始 HTML 一致,避免兩套來源指向不同網址。
狀態碼是無頭前端容易疏忽的一環。Google 文件說明,回傳 HTTP 200、且未被 robots 排除的頁面會進入渲染佇列,而狀態碼非 200 的頁面,例如 404 錯誤頁,渲染可能被跳過。前端的錯誤處理如果為了畫面好看,把找不到的頁面也回成 200 加一段友善訊息,搜尋端看到的訊號就跟使用者看到的不一致。讓每種情境回該回的狀態碼,是無頭站對搜尋引擎誠實的基本方式。
其餘的 SEO 工作項目跟著搬位置。標題、描述、canonical、結構化資料這些輸出,過去隨前台一起交給 WordPress 生態處理,無頭之後要由前端從 API 拿資料自行組出來,這是WordPress 站的 SEO 基礎在新型態下換了位置,並沒有消失。能不能做好,取決於前端有沒有把這些輸出當成一等公民來實作。
效能面:無頭不保證快,快取做得好才快
把無頭架構直接等同於高效能,是一種常見的過度簡化。真實的因果鏈是:無頭前端把頁面生成換成可以預先建置或快取的靜態輸出,訪客拿到的是已經算好的頁面,這才快得起來。如果前端每次請求都向 WordPress 即時拉資料再渲染,瓶頸只是換了位置。Vercel 指南裡 ISR 與 stale-while-revalidate 那一套,講的就是怎麼讓快取新鮮度與請求效率同時成立。
對使用者體驗指標的影響也是同一個邏輯。預先建置的頁面回應時不需現場組裝資料,對Core Web Vitals的 LCP 是有利條件,互動複雜的頁面則要留意前端打包的 JavaScript 體積,別讓框架的成本吃掉靜態化的紅利。無頭給的是控制權,指標的成績單仍由實作品質決定。
資安面:API 是開著的門,要懂它的鎖
無頭架構把 WordPress 的資料介面推到第一線,幾個官方立場值得放在心上。第一,REST API 不該停用,開發者文件的常見問題寫得明確:停用它會破壞依賴它的後台功能。若要降低暴露,文件給的答案是收緊讀取面,在 rest_authentication_errors 篩選器加上登入檢查,要求所有 API 請求先通過驗證,這對匿名的外部存取是實質關閉。
第二,跨源請求的設計有它的歷史背景。官方文件說明,WordPress 的 REST API 不驗證進站請求的 Origin 標頭,公開端點因此可從任何網站存取。這是刻意的設計決定,因為收緊 CORS 限制會擋掉部分驗證方法,系統改以 nonce 機制防範跨站請求偽造,CORS 不擔任這個角色。要自己加嚴的站,可以換掉預設的 CORS 標頭函式,這些細節都在常見問題章節。
第三,別因為無頭就鬆掉內容源的基本防護。WordPress 本體仍然是對外服務,登入保護、更新、防火牆這些WordPress 資安基本功一件都不能少,主機環境的選擇同樣決定了 API 的回應品質與防護底線。無頭前端把頁面流量分開後,內容源的 API 負載仍取決於取資料、渲染與快取的設計,規劃容量時要依實作估算。
憑證傳輸的前提也值得單獨看。應用程式密碼預設只在走 SSL 的站點可用,不是刁難,整合指南把原因說白了:沒有加密的連線上,這組憑證有可能在網路途中被攻擊者看見。若遠端應用需以應用程式密碼呼叫 WordPress REST API,憑證須經 https 傳遞,這項傳輸條件應在規劃階段確認。
誰適合走向無頭
綜合前面的材料,適合無頭的情境有清楚的輪廓。內容要供應多個通路的站,例如網站加行動應用,同一份內容經 API 供應不同端點,無頭是自然形態。有前端工程資源的團隊,想用自己選的框架與元件系統做頁面,WPGraphQL 官網那句分工描述就是寫照:內容創作者用他們熟悉的 CMS,開發者用他們熱愛的框架與工具。對內容供應穩定性要求高的站,Vercel 指南描述的快取容錯,內容源停機時前端照常服務,是有價值的韌性。
多通路是輪廓最清楚的情境。API 的消費者名單裡有 Swift 與 Kotlin 這類手機應用開發常用的語言,把 WordPress 當成手機應用的內容後端,網站與應用程式讀同一份資料,內容團隊只需要維護一個地方。GraphQL 在這個情境的價值也更直接,一次查詢取齊巢狀資料的特性,對頻寬敏感的行動端是實際的省。當你的內容要同時餵網站、應用程式、甚至更多端點時,無頭不是追流行,而是題目本身長成的形狀。
誰不適合
反向的判斷更常被忽略。WordPress 開發者文件有一句話值得抄下來:如果你的網站已經照你期待的方式運作,你不該覺得被迫使用 REST API,蓋主題或外掛也不需要它。對形象網站、部落格與內容行銷站,傳統架構加上主題與外掛可能已能滿足需求。無頭化新增的部署、預覽、快取與驗證工作,未必能換得對等收益。沒有前端開發資源的團隊,維護一套前端程式的成本可能壓過彈性帶來的好處。要判斷自己站在哪一側,架站方式的整體比較是比技術流行更好的起點。
有幾個訊號出現時,可以更快畫出結論。團隊裡沒有人能持續維護前端程式,這是最硬的門檻。前台重度依賴外掛輸出,表單、報價、結帳流程都屬於前台輸出,導入無頭時,這些功能須逐項確認如何在新前端實現,或尋找替代方案。若編輯部要求按下預覽就看到最終版面,預覽機制需要額外工程,應把這筆成本納入收益評估。SEO 外掛產生的結構化資料與元標籤占了流量命脈,前端就要整套接手。訊號愈多,愈該把無頭放在評估清單的後面。
AI 時代的接軌:自建前端的門檻正在下降
無頭架構的一項進入障礙,是要維護一套自建前端。這個前提正在鬆動。以提示詞驅動的Vibe Coding 開發方式,讓非本科系的使用者也能生成可運作的前端程式,接 API、渲染內容、部署上線的整條鏈,工具的協助比以往完整。前端成本下降,無頭取捨的天平就跟著移動:本來因為養不起前端而放棄的團隊,現在多了一個可以認真評估的選項。
同一個趨勢也出現在內容操作側。經由 MCP 介面把 WordPress 交給 AI 代理操作的做法,讀寫走的正是這套 API 通道,等於把無頭架構的資料介面同時用於人與機器。生成式工具把前端的殼做出來,資料介面把內容餵進去,兩者在目前的工具鏈裡已經可以對接,剩下要自己扛的,是品質、維運與持續演進的責任。
導入前的檢查清單
決定評估無頭架構時,把這些項目逐一過一遍,有助於提前發現常見的接線與維護問題。
左右捲動檢視完整表格
| 檢查項目 | 要確認的事 | 依據出處 |
|---|---|---|
| 內容模型 | 確認自訂文章類型與分類法能否由所選介面取用。REST 路線檢查 show_in_rest,WPGraphQL 路線檢查 GraphQL schema | WordPress 開發者文件與 WPGraphQL 官網 |
| API 路線 | REST 零安裝起步,或裝 WPGraphQL 走 /graphql 端點 | 官方文件與外掛頁 |
| 驗證設計 | REST 路線若需遠端寫入或讀取受保護內容,可評估應用程式密碼(24 字元、https、Basic Auth)及撤銷流程。WPGraphQL 路線須另行確認驗證方式 | WordPress 驗證文件與官方整合指南 |
| 渲染策略 | 靜態生成、伺服器端渲染或 ISR,決定搜尋引擎與訪客拿到什麼 | Google 文件與 Vercel 指南 |
| 快取同步 | revalidate 間隔或事件觸發失效,發布後多久可見要有共識 | Vercel 指南 |
| 預覽流程 | 草稿預覽的前端路由、權限與快取排除 | Vercel 指南範例 |
| SEO 輸出 | 標題、描述、canonical、結構化資料由前端組出 | Google 文件 |
| 內容源防護 | WordPress 本體的資安與主機容量不因無頭而打折 | 開發者文件 |
| 內容源權限 | 確認內容源可安裝外掛、可存取 API、可控制主機環境(自架與託管的差異可併入評估) | 站內基礎比較 |
收尾:無頭買的是控制權,付的是責任
回頭看整條脈絡,無頭 WordPress 不是新平台,而是把 WordPress 既有的資料介面升級為主角的架構選擇。它買到的東西很明確:前端的完整控制權、多通路供應內容的彈性、快取帶來的韌性。要付的帳單也一樣明確:渲染、預覽、快取、驗證、SEO 輸出,這些工程責任落到自建前端這一側。
放在光譜上看也一樣清楚。傳統 WordPress 自帶前台,主題與外掛仍可處理既有需求。無頭 WordPress 把訪客頁面交給自建前端,增加呈現控制權,也增加渲染、部署與維護的工作。兩種架構的責任差異,要依實際分工評估。現行的工具環境把無頭那一端的進入成本往下拉,但責任的本質沒有變。
所以判斷的問題從來不是無頭好不好,而是你的站需要那份控制權到什麼程度,以及誰來扛那份責任。內容單純、資源有限的站,官方那句不該覺得被迫使用,就是最好的定心丸。內容通路多元、前端能力到位的站,無頭架構讓 WordPress 從網站系統變成內容引擎,這是它真正的位置。