社群貼文會被 AI 搜尋引用嗎?FB、IG、Threads 的 GEO 優化指南
社群貼文會被 AI 搜尋引用嗎?BrightEdge 對代表約 3 億次月搜尋的美國市場主題群量到,Google AI Overviews 每 15 筆搜尋就有 1 筆引用社群內容,Facebook 貼文被引用達 1,950 萬次。這篇拆解各平台可索引現況(IG 專業帳號 2025 年 7 月起預設開放、Threads 公開貼文可收錄)、貼文被 AI 取用的寫法(結論前置、事實密度、可摘錄句子)、與社群訊號排名迷思的界線,以及用 Search Console 平台屬性與側錄題組衡量的完整做法。
會,而且數字比多數人直覺的大。BrightEdge 在 2026 年 7 月發布的研究,以該公司 AI Hyper Cube 對約 3 億次月搜尋所屬主題群的分析為基礎,量到 Google 的 AI Overviews 裡平均每 15 筆搜尋就有 1 筆以社群內容作為答案素材:Facebook 貼文出現在 1,950 萬個 AI 摘要的來源清單裡,Instagram 被引用 87.7 萬次,TikTok 有約 7.8 萬次獨立引用。你經營的粉絲專頁貼文、IG Reels 的說明欄、Threads 上的公開短文,都可能在某一個問題的 AI 答案裡,被搬去當「某個網友這樣說」或「某篇貼文提到」的那段文字。
但「會被引用」有一個硬性前提與兩個實務原則,層次不同。硬性前提是平台要放行:貼文所在的位置必須是搜尋引擎與 AI 系統讀得到的公開網頁,這一層由平台的索引政策決定,2025 年 7 月之後各家的開放程度差很大,不公開的內容連候選都談不上。兩個實務原則是編輯層面的:把關鍵資訊以文字寫進內文(重要事實只放在圖片或口白裡,機器能穩定讀到的部分很有限),以及讓貼文直接回答某個具體問題(品牌心情文與活動宣傳,在多數查詢下能被取用的素材很少)。這兩條是業界從可觀察現象整理出來的寫法建議,值得照做,效果則要在自己的側錄裡驗證,後文會再交代界線。
這篇要把社群貼文當成 AI 搜尋的答案資產來管理,按順序處理五件事:數據怎麼判讀、各平台現況差在哪、貼文要怎麼寫才會被搬走、成效怎麼衡量、以及哪些風險必須先想清楚。已經有 GEO 概念的讀者,可以把這篇當成資產清單的擴編:從「官網內容怎麼被 AI 引用」延伸到「官網之外的公開內容怎麼被引用」,兩者的底層邏輯相通,操作手法卻不一樣。
每 15 筆搜尋有 1 筆:三個數字怎麼判讀
先把BrightEdge 的研究數據攤開。研究單位是該公司的 AI Hyper Cube,量測方式是分析代表約 3 億次月搜尋的主題群組與其 AI 答案,統計哪些來源反覆出現。三個核心數字:Facebook 在 1,950 萬個 AI Overviews 裡被列為來源,Instagram 87.7 萬次,TikTok 約 7.8 萬次獨立引用;研究自己的換算口徑是:每 15 筆搜尋有 1 筆的答案用到了社群內容,其中 Meta 兩個平台合計占了絕大多數。
Facebook 與 Instagram 之間二十二倍的落差,有兩個看起來合理的解釋方向,但它們是假說,這份研究並沒有驗證成因。一個是供給面:Facebook 累積的公開文字存量本來就遠大於 Instagram,粉絲專頁、公開社團裡堆了十幾年的問答與在地資訊,AI 檢索得到的原料多,被引用的絕對次數自然高。另一個是內容形態:Instagram 以圖片與短影片為主,機器真正讀得到的文字(內文說明欄)經常只有一行,能被摘錄的句子相對少,被引用次數低未必等於平台不重要,也可能反映文字承載量的差異。對經營者的啟示仍然實際:在 Instagram 上把必要資訊寫進說明欄,是在補這個平台文字供給的缺口,至於「寫滿說明欄會不會直接提高引用率」,當成可以自己測試的假說來驗證,比當成保證來期待穩當。
引用與流量要分開看。AI 摘要把答案直接寫在搜尋結果頁上,使用者看完可能不點任何連結,社群貼文被引用帶來的常常是曝光與印象,而非可點擊的造訪。這不代表沒有價值:被引用代表你的說法成為某個問題的答案素材之一,品牌名稱、商家名稱有機會出現在答案正文或來源標籤裡,這種存在感有機會累積成品牌層面的效益,例如品牌字搜尋量的變化,但那是需要分開追蹤的可能效益,無法從引用次數直接換算。把「被引用」直接換算成流量 KPI,是操作社群 GEO 時最常見的第一個失望來源。
這份研究以美國市場的搜尋樣本為主,數字不能平移到台灣。台灣使用者的提問行為、各平台的市占結構、AI 摘要的觸發頻率都與美國不同,每 15 筆有 1 筆這個比例在台灣搜尋環境裡可能更高也可能更低,目前沒有等量級的本地量測可以引用。因果鏈本身值得沿用:平台開放索引、機器讀得到文字、句子能回答問題、AI 答案引用它,這四個環節的概念在哪個市場都通用,但每一環的實際通過率要用本地側錄驗證,不能假設與美國樣本相同。
AI 搜尋為什麼回頭找社群內容
Google 自己把動機講得很白。Search Central 在 2026 年 7 月宣布 Search Console 平台屬性的官方部落格文章開頭就寫:當人們愈來愈傾向尋求第一手觀點與不同內容格式,Google 要讓站長與創作者更容易看到「所有內容」在搜尋裡被發現的狀況。這句話透露的方向是:Google 把社群與影片平台上的內容,正式當成搜尋生態的第一級公民對待,不再只是站外的外圍訊號。
社群內容補上的是官網內容的三個結構性缺口。第一個是時效:店家臨時公休、商品召回、活動改期,這類資訊最先出現的地方幾乎都是社群貼文,官網要等人更新頁面,BrightEdge 量到的 Facebook 高頻引用情境,正是球賽轉播資訊、商品召回、門市歇息這類及時查詢。第二個是在地:某家店的停車場入口、某個市場裡哪攤好吃,這種顆粒度的資訊很少被寫進官方頁面,卻大量存在公開社團的討論裡。第三個是經驗:真實使用者踩過的坑、修好的方法、買了後悔的理由,第一人稱的經驗敘述正是 AI 摘要偏愛的「某用戶表示」句式來源。
對品牌的意義是答案的原料清單變長了。過去談搜尋能見度,管理的資產是官網頁面;進入 AI 搜尋世代,AI 組答案時取材的範圍是整個公開網路,官網、社群貼文、論壇討論、影片說明、新聞報導全在同一個候選池裡。GEO 與 SEO 的資源分配怎麼想,站上的GEO 與 SEO 取捨分析有完整的決策框架,這篇聚焦其中一塊:官網之外,你能控制的部分。
平台別:誰的貼文會被 AI 讀到
「社群平台」不是一個同質的整體,各平台對搜尋引擎的開放程度,決定了你的貼文在第一關就被篩掉還是進入候選。現況可以整理成一張表:
左右捲動檢視完整表格
| 平台 | 可索引現況 | 被 AI 引用的角色 |
|---|---|---|
| 2025 年 7 月起專業帳號公開內容預設可被搜尋引擎索引 | 生活風格、文化、美食、旅遊、購物情境 | |
| 公開粉絲專頁與公開社團內容可被檢索,個人動態通常需要登入 | 在地與社群訊號:及時資訊、公告、社群討論 | |
| Threads | 公開貼文與個人檔案可被 Google 收錄,平台以 sitemap 主動供清單 | 即時討論與觀點,文字密度高 |
| X | 公開個人檔案與貼文可能被搜尋引擎索引,官方提供刪除、改為受保護與更新過期結果的工具 | 即時觀點與產業討論 |
| TikTok | 影片頁面可被索引,文字承載量受限於說明欄 | 流行趨勢與優惠情報 |
| 討論串公開可索引,長年高頻出現在搜尋結果 | 第一手經驗與除錯討論 | |
| YouTube | 影片頁與說明可被索引 | 步驟化教學與深入解說 |
這張表的讀法要分兩層:Facebook、Instagram、TikTok、Reddit、YouTube 的角色定位,來自前述 BrightEdge 研究的觀察;Threads 與 X 兩欄的角色描述,是依平台屬性與收錄現況所做的編輯判斷,不是同一份研究的量測結果。引用量數字只屬於 Facebook、Instagram 與 TikTok 三個平台,本篇所引的研究未公布其他平台的引用總量。
表裡最需要單獨說明的是 Instagram,因為它有一個多數經營者沒察覺的預設值翻轉。2025 年 7 月 10 日起,Instagram 正式讓專業帳號(商家與創作者帳號)的公開內容,包含貼文、Reels、輪播,自動開放給 Google 等搜尋引擎索引,功能預設開啟,成年帳號適用,不想被收錄的人要到隱私設定裡找到「允許公開照片和影片出現在搜尋引擎結果中」這個選項手動關閉,這項變更的報導細節在當時已經整理得很清楚。換句話說,如果你經營的是商家帳號且從沒動過這個設定,你的公開內容已經符合被搜尋引擎索引的條件;至於個別貼文有沒有被實際抓取與收錄,仍取決於搜尋引擎自己的判斷,符合條件與確定收錄是兩件事。對多數經營者,問題已經從「要不要開放被索引」變成「開放出去的內容值不值得被引用」。
Threads 走了另一條路:平台主動鋪路。公開貼文與個人檔案可被 Google 檢索收錄,平台的 robots.txt 放行 Googlebot,還宣告了多個 sitemap 把熱門貼文與個人檔案清單交給搜尋引擎,同一時間把 GPTBot、ClaudeBot 這類 AI 訓練爬蟲擋在門外,開放給搜尋、封鎖給訓練是它的一貫立場。Threads 貼文在 AI 摘要裡的能見度實測、收錄機制的證據細節,站上的Threads 被收錄機制指南有第一手拆解,這篇不重複。
X 的狀況可以用官方文件倒推:X 的說明中心有一整頁教使用者把個人檔案與貼文從 Google 搜尋裡移除的說明,官方使用的字眼是公開內容「可能被搜尋引擎索引」,官方提供的工具是刪除貼文、改為受保護,以及為已刪除或受保護內容申請更新過期的搜尋結果,頁面上也一併解釋了為什麼這類貼文有時還會殘留在搜尋結果裡。Google 端的佐證更直接:Search Console 的平台屬性支援 X,等於 Google 承認 X 內容在搜尋裡有可量測的表現。對文字型創作者,X 與 Threads 是同一類選擇:文字密度高、有機會被索引、單則貼文就能承載一個完整論點。
Facebook 的處境最特殊。1,950 萬次的被引用量說明它的公開內容確實被 AI 大量取用,研究裡被引用的具體範例之一是球隊官方粉絲專頁的賽事轉播公告;但研究沒有提供粉專、社團、個人帳號的來源拆分,所以「哪些帳號類型的內容實際被引用、各占多少」無法從總量推導。判斷自己 Facebook 內容的能見度,以個別頁面是否公開、是否需要登入、搜尋引擎實際抓不抓得到為準,用 site: 搜尋抽查是入門的檢驗方式(查得到可以確認搜尋可見;查不到不能直接斷定未索引,Google 官方也說明 site: 結果並不完整)。TikTok、Reddit 與 YouTube 各自的位置由它們的內容形態決定:影片平台吃文字承載量的虧,Reddit 吃「你無法擁有那個頁面」的虧,YouTube 在研究裡被觀察到的角色是步驟化教學的來源。Reddit 與其他論壇的操作邏輯(選版、帳號、參與討論而不是貼連結)與本篇的社群經營是兩套打法,站上的Reddit 與論壇 SEO 指南有完整處理。
台灣的社群結構怎麼套這張表
上表的角色定位混合了研究觀察與編輯判斷,套到台灣還要再過一層本地濾網,而這一層的結論應該是選題假說,不是已驗證的事實。幾個方向值得排進本地測試:Facebook 在台灣的使用基礎深厚,地方社團、媽媽社團、車友社團、在地店家的公告大量存在這個生態裡,「在地資訊」這類問題的素材供給在台灣特別充足,在地商家經營 Facebook 的內容庫,有機會對應到同樣性質的查詢。Threads 在台灣的討論熱度高,文字密度大、話題從時事到消費經驗都有,公開貼文可被索引,是一個值得測試的文字型引用來源。Reddit 在國際研究裡扮演第一手經驗的角色,但台灣使用者問在地問題的場域經常是 Dcard、Mobile01 與 PTT,側錄題組可以把這些本地論壇的內容與 Reddit 一起納入觀察,比較實際的選源情況,操作上併入論壇那一套打法管理即可。這些方向共同的驗證方式,是在側錄題組裡觀察本地答案實際引用了哪些來源,用本地資料校準平台優先序。
調整完權重,選平台的判斷準則可以用一句話收斂:你的顧客會問的問題,屬於哪個平台的強項。餐飲與旅遊的視覺探索可以先測 Instagram,即時公告與售後問答可以先測 Facebook,觀點與討論可以先測 Threads 與 X,教學先測 YouTube、趨勢與開箱先測 TikTok。這個分配同樣是選題假說,實際哪個平台在你的品類裡被引用,用側錄題組校準。資源有限的團隊不需要全部都做,挑一到兩個「顧客問題屬性」與「平台引用角色」重疊度最高的先做深,做深一個平台的可引用內容庫,比五個平台都發一模一樣的宣傳文有用。
AI 怎麼讀一則貼文:三層過濾
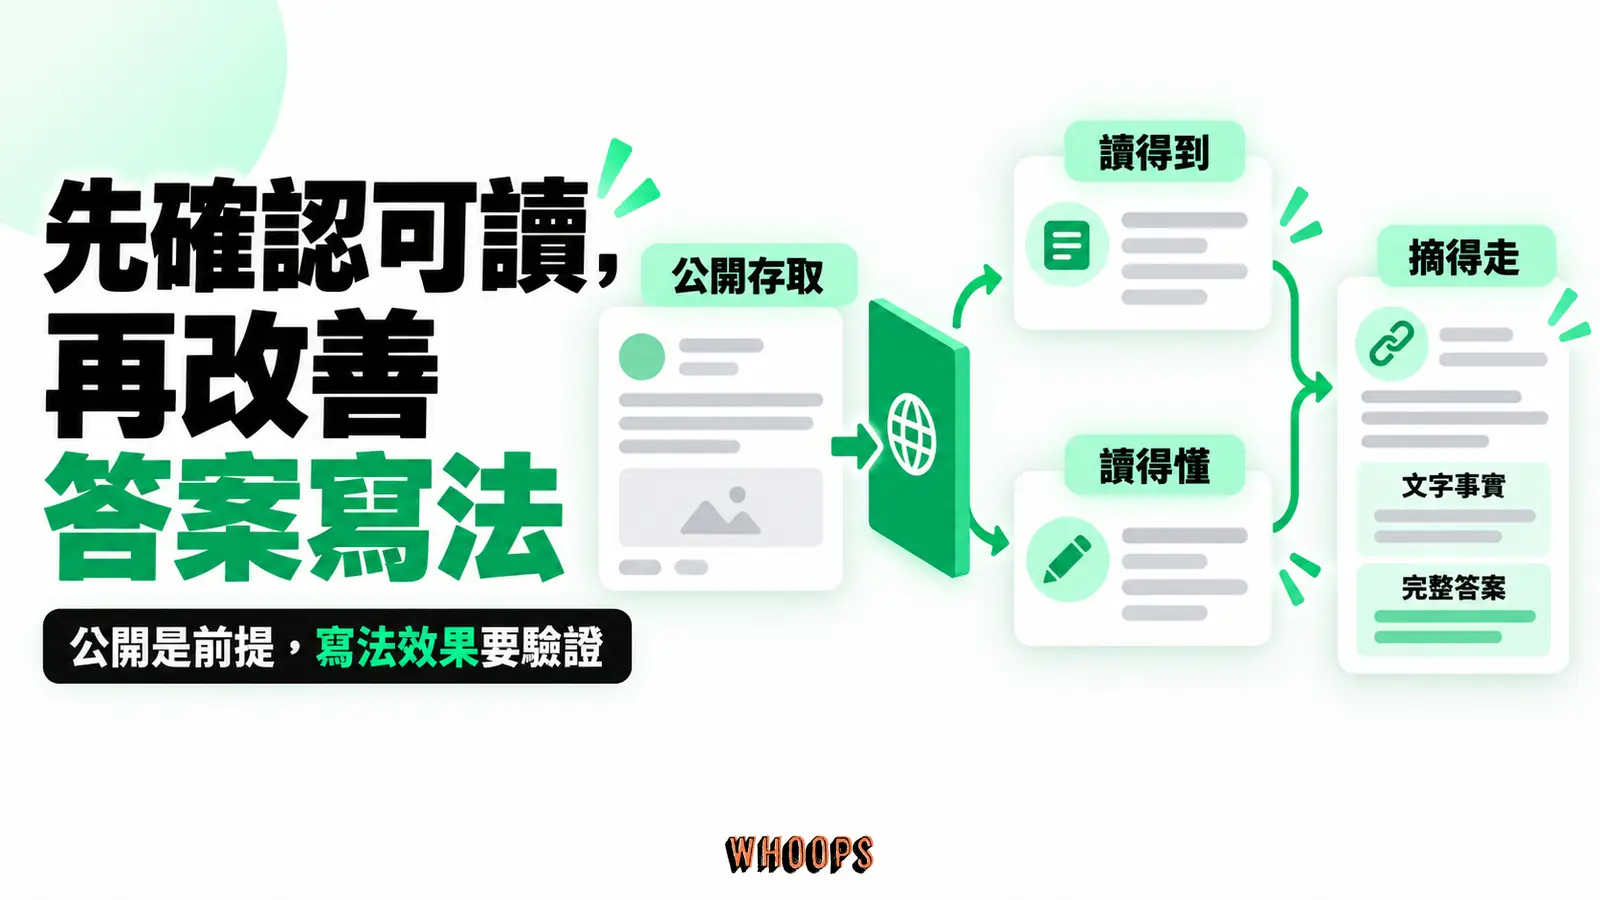
把「貼文被 AI 引用」拆開看,一則貼文要通過三層過濾,每層淘汰的理由不同,修法也不同。搞混層次,是努力沒有回報的主因:在第三層拼命改寫字句,問題卻出在第一層根本沒被索引,白忙一場。
第一層是讀得到,也就是可及性。平台政策放行、帳號形態符合(IG 的專業帳號)、貼文設為公開,三個條件同時成立,貼文才有機會以一般網頁的形態被檢索與收錄。這一層屬於開關題:對照上一節的表格逐項確認,把該開的開關打開。但開關打開只是取得資格,搜尋引擎對哪些頁面實際抓取、收錄、呈現,有它自己的判斷,官方也明講符合資格並不保證收錄。多數經營者的問題出在這層而不自知。以 Instagram 為例,用個人帳號而非專業帳號經營商業內容,或貼文設為限定追蹤者可見,內容就不在這波開放範圍裡;其他平台要各自對照表格與帳號設定確認。
第二層是讀得懂,也就是機器實際拿到的文字是什麼。爬蟲抓回一則貼文的頁面時,直接可讀的是內文說明欄的文字與帳號名稱;寫在圖片裡的價格表、只存在影片口白裡的教學步驟,能被擷取的程度依平台處理媒體的方式而異。Hashtag 本身是文字、讀得到,但一串標籤通常不足以形成帶條件的完整答案。這層的實務結論很簡單:圖片與影片是給人看的,文字說明欄是給機器讀的,發 Reels 時把三個重點、一個結論、常見問題的答案寫進說明欄,就是在補這層的洞。
第三層是摘得走,也就是句子能不能脫離前後文單獨成立。AI 摘要標記來源時掛的是頁面連結,答案文字則是從頁面內容組出來的;由此出發的合理工作假設是:一段能獨立回答問題的文字,比一段需要上下文才看得懂的鋪陳,更有機會被選進答案。對應的實務做法是把結論與條件寫進同一句、讓每段自成單元。這與官網內容的「可摘錄性」是同一個概念,站上的AI 偏好內容規劃指南裡找、挑、取、組四段流程把這個概念拆得更細,同樣的檢查搬到社群貼文上完全適用,只是社群的版本更短、更口語、更要求第一句就成立。
寫法:把貼文寫成可摘錄的答案素材
過了三層過濾之後,剩下的是寫法問題。原則只有一條:設想某個人正在搜尋框打一個具體問題,AI 在組答案時從你的貼文裡搬一句話走,那句話要能獨立回答那個問題。以下五個操作都從這條原則推導出來。
先看一次答案裡的引用長什麼樣
講操作之前,值得實際打開 AI 摘要看一次引用的樣貌。AI Overviews 的答案段落會掛來源連結,點開是一排被引用的頁面,被引用的社群貼文就混在新聞稿、官網頁面、論壇討論之間,以一般網頁的身分列出。這個畫面至少說明一件事:被標記為來源的是「頁面」,也就是那一則貼文本身,而非整個帳號的權威排名。從這裡可以推出一個合理的工作假設(合理,但屬推斷):AI 取用時看的是頁面裡的語句能不能回答眼前的問題,把內容寫成一句句可獨立成立的答案,是對這個假設最划算的回應。後面的寫法原則都建立在這個假設上,你可以用自己的側錄去檢驗它。
結論與數字放在第一行
讀者滑動態的耐心只有一兩行,這一條光是為了人的注意力就值得做;至於 AI 取材時對貼文開頭給多高權重,沒有公開證據,把它當成順帶的可能收益即可。把結果、價格、結論、日期放在第一行,第二行以後才補細節。「我們家的新品上市了,大家快來看看」是宣傳;「無糖茶第二件半價到 10 月 31 日,全家便利商店獨賣」是答案素材,後者每一個名詞都可能在某個查詢裡被對上。數字要寫具體的:打折中不如寫 79 折,降價中不如寫從 1,200 降到 890,機器與讀者都只認得具體的數字。
事實密度:把名稱、地點、條件寫進內文
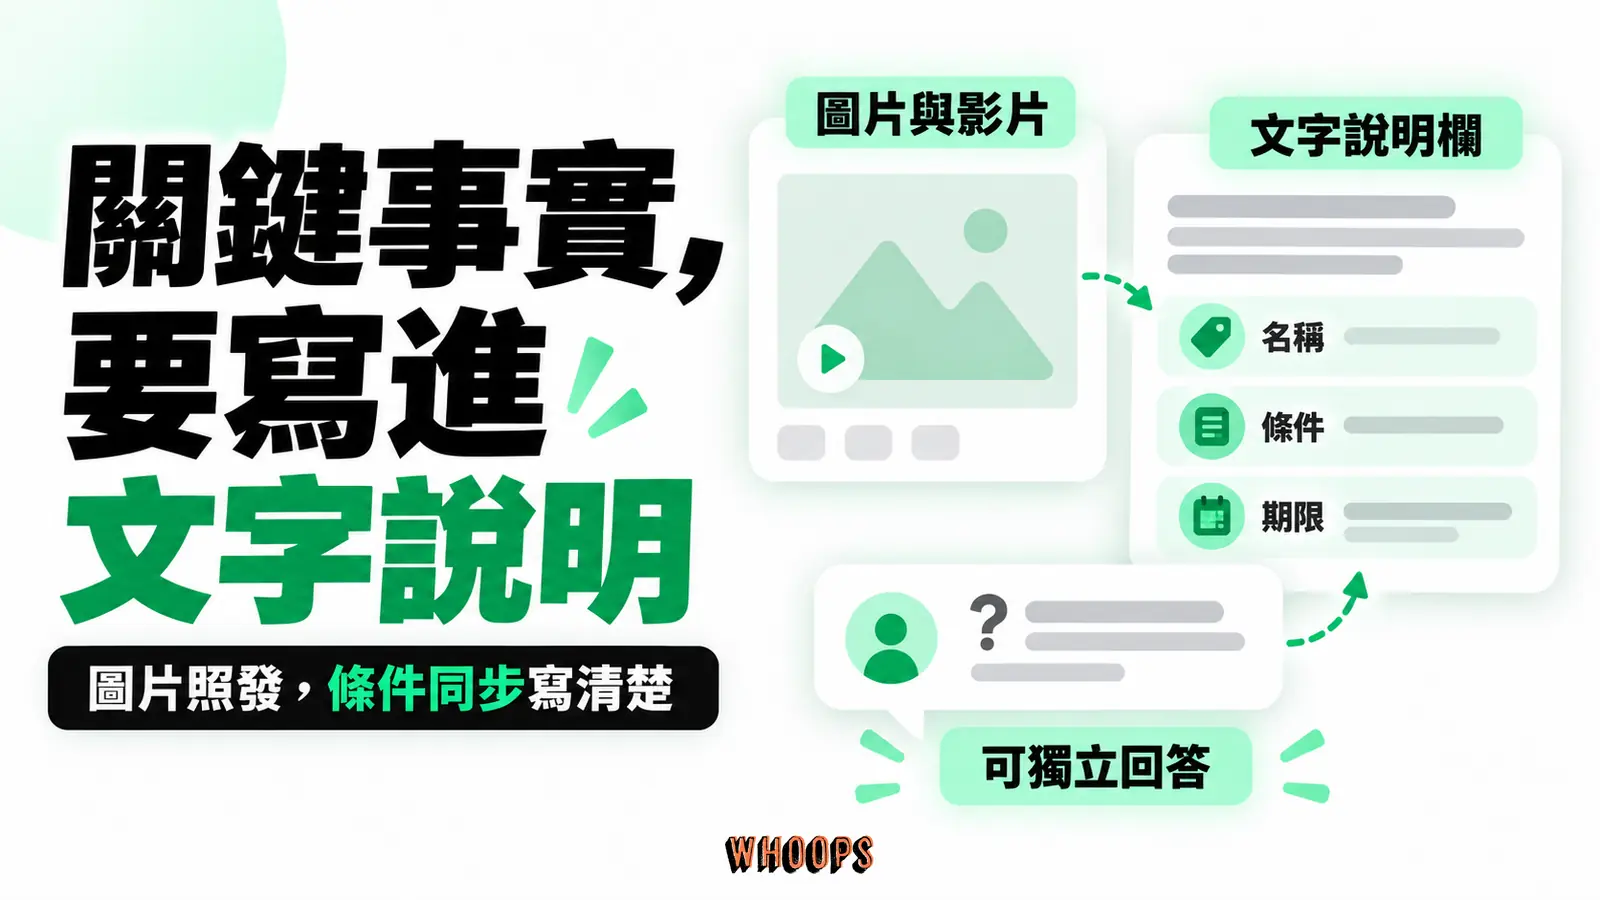
查詢與內容的配對靠的是文字重合與語意相關,把可對應的實體(品牌名、產品名、地名、店名、規格、期限)用文字寫進內文,是讓查詢有材料可以對上的基本工。這聽起來像常識,實務上最常見的失誤正好相反:價格做在圖片上、店址只標在照片角落、優惠條件只出現在影片口白,內文說明欄留一句「詳見圖」。修正的方式是把關鍵事實用文字再寫一遍,圖片負責美觀,文字負責被找到。在地商家尤其要寫完整的營業資訊:地址、營業時間、公休日、聯絡方式,這些固定事實用文字寫進內文,在地查詢的配對才有材料可對。
一則貼文回答一個問題
貼文的引用價值來自「針對性」。一次塞五個主題的貼文,每個主題都只能淺淺帶過,讀者掃過去抓不到重點,單一主題的深度也撐不起完整回答。把內容切成一則貼文處理一個主題:一則講退換貨流程,一則講故障排除,一則講保養方法,各自獨立成立;圍繞同一主題的附帶資訊(例如講回烤做法時順帶講保存期限)仍然合理,與「五個不相干主題塞成一則」是兩回事。這對習慣「一篇貼文講完全部」的經營者是心態調整,但 AI 摘要搬走的本來就是片段,你先切好片段,等於先幫它做好分類。
小帳也能被引用,粉絲數不是門票
BrightEdge 在同一份研究裡特別標記了一個現象:AI 的影響力與社群聲量不等同,來自小眾帳號的公開貼文與影片,同樣能影響 AI 怎麼描述一個品牌、產品或地點。這給出的編輯結論是:互動數字不能直接換算引用機會,內容與問題的相關性才是你能努力的方向。對小商家與新帳號,這是進入門檻相對低的一場賽局,一則把某個具體問題回答得乾淨漂亮的貼文,被引用的機會不會只因為帳號追蹤者少就消失。反過來對大帳號,這也是提醒:千篇一律的品牌宣傳文,在這場賽局裡的價值低於想像。
帳號本身也是訊號
貼文被引用時,來源標記的是帳號,帳號名稱、簡介、類別、商家資訊的完整度,決定這個來源在答案裡呈現出什麼樣貌。商家帳號把商家資料頁填滿(地址、電話、營業時間、網站連結),等同於在平台內掛了一份結構化履歷;帳號名稱包含可辨識的品牌字或店名,被引用時的品牌暴露才有意義。匿名帳號、名稱只有綽號的帳號,即使內容被引用,品牌層面的收益也會打折。
一則貼文的改寫對照(示意)
用一個假設情境把五個操作串起來。一家麵包坊要做「冷藏麵包回烤」的教學貼文,多數版本的寫法是:一張出爐照,配文「今天的麵包出爐了,買回家記得回烤更好吃喔」。這則貼文有溫度,但對機器來說,可配對的實體只有麵包、回烤兩個詞,沒有條件、沒有步驟、沒有可搬走的句子。
改寫後的版本(示意):「冷藏可頌回烤的家用烤箱做法:上下火 180 度預熱 5 分鐘,關火後放入烤 3 分鐘,取出放涼 1 分鐘再吃,酥皮會回到剛出爐的狀態。冷藏保存三天內吃完,冷凍可以放兩週,回烤前不用退冰。本店冷藏盒裝可頌各大超市皆有售,售價 95 元。」第一行是結論(做法與條件),中段是步驟與保存事實,結尾是價格與通路,每一句都能獨立回答一個查詢(可頌怎麼回烤、冷藏可頌保存期限、可頌多少錢)。圖片照發,溫度照顧到,差別只在文字說明欄同時把機器要的東西給齊。這種寫法不需要改變品牌口吻,只是把「對追蹤者說話」與「對搜尋者回答」兩件事,在同一則貼文裡同時完成。
與「社群訊號影響排名」的老迷思劃清界線
講社群與搜尋,繞不開一個流傳十幾年的說法:按讚分享會影響排名。Google 從 2014 年以來多次公開說明,社群互動計量不是直接排名因子,站上的社群訊號與排名關係的完整考據把官方說法的演變與間接影響的路徑整理過,結論是直接因果不存在,間接影響有機制。社群 GEO 的邏輯與那套說法必須分開,因為兩者運作的層次不同。
社群訊號迷思的主張是「互動數字傳導排名」:讚多、分享多,網頁排名就跟著上去,這條路被官方否定。社群 GEO 的機制是「內容本身成為答案素材」:貼文以一個公開網頁的形態被索引、被檢索,在某個查詢下因為內容相關且可摘錄而被 AI 引用,中間經過的環節是內容的檢索與配對,不是互動數字的傳導。互動量不能單獨推定引用機會,一則零互動的貼文可以被引用,一則十萬讚的貼文也可能從來不被引用;內容與查詢的相關性,是經營者可以著手改善的方向。
這個區分對資源分配有實際影響。如果社群對搜尋的價值走訊號傳導,那麼衝互動數是正確投資;如果走內容配對,那麼把力氣花在「回答對的問題」上,方向更貼合這個機制。可觀察的間接效益仍然存在:被引用之後品牌名稱的曝光增加,品牌字搜尋量可能跟著變化,內容被更多人看到後也可能產生外部連結,這些間接路徑與訊號迷思不衝突,但它們是值得分開追蹤的副產品,不值得當成主要目標去衝。
把官網內容拆成社群貼文的做法
多數品牌手上已經有大量素材:官網的產品頁、常見問題、教學文章、部落格。把這些內容拆成社群貼文,是最省力的起手式,因為事實已經查證過,剩下的是改寫成社群的形態。哪些內容適合拆,判斷標準是「有沒有人會用一個問題來找它」。
四類內容通常最容易對上具體查詢,是拆文時的優先順位。問答型:官網 FAQ 裡的每一題,幾乎都可以原樣變成一則貼文,問題當第一行,答案寫兩到五行。比較型:A 與 B 差在哪、什麼情況選 A,比較結構天生貼近查詢句式。數據型:自家統計、測試結果、價格盤點,具體數字本身就是可引用的素材。時事在地型:法規變動、季節提醒、在地活動,時效性內容在社群上的檢索生命週期短,但對應的查詢在期間內相當集中。相對地,品牌故事、團隊介紹、得獎公告這類內容,能對應的查詢相對少(「某品牌創辦人是誰」「得過哪些獎」這類查詢存在),拆文時把它們排在四類之後,依具體查詢需求決定要不要做。
拆法有兩種節奏。一種是化整為零:把一篇長文按痛點切段,每段改寫成一則獨立貼文,分批發布,每則貼文自帶完整答案,結尾視平台規則補上原文連結。這種做法的優點是產出穩定,一篇教學文可以餵兩三週的內容日曆,缺點是要克制「每則都塞連結」的衝動,價值先給足,連結是補充。另一種是濃縮為精華:把全文結論提煉成一則長貼(Threads 或 Facebook 的長文格式都適合),第一行給結論,後面用條列補過程,讀者掃完就能用。兩種可以並行,濃縮版打頭陣,拆段版慢慢跟。
用問答型的拆法走一遍(示意)。假設官網的常見問題裡有一題:「網路訂蛋糕可以指定配送時間嗎?」官網版答案寫了三段,含前置時間、冷鏈配送範圍與節日規則。拆成貼文時的形態:第一行直接給答案「網路訂蛋糕可以指定配送時段,但要提前 48 小時下單,僅限週二到週五配送」;接下來兩三行補節日例外與配送範圍;結尾一句「完整配送規則與訂購連結在留言區」。這則貼文回答的查詢意圖非常明確(訂蛋糕配送時間),答案自帶具體條件(48 小時、週二到五),可搬走的第一行就是一個完整答案。官網 FAQ 裡的每一題都能這樣處理,二十題的 FAQ 拆完,就是二十則有引用價值的貼文庫。
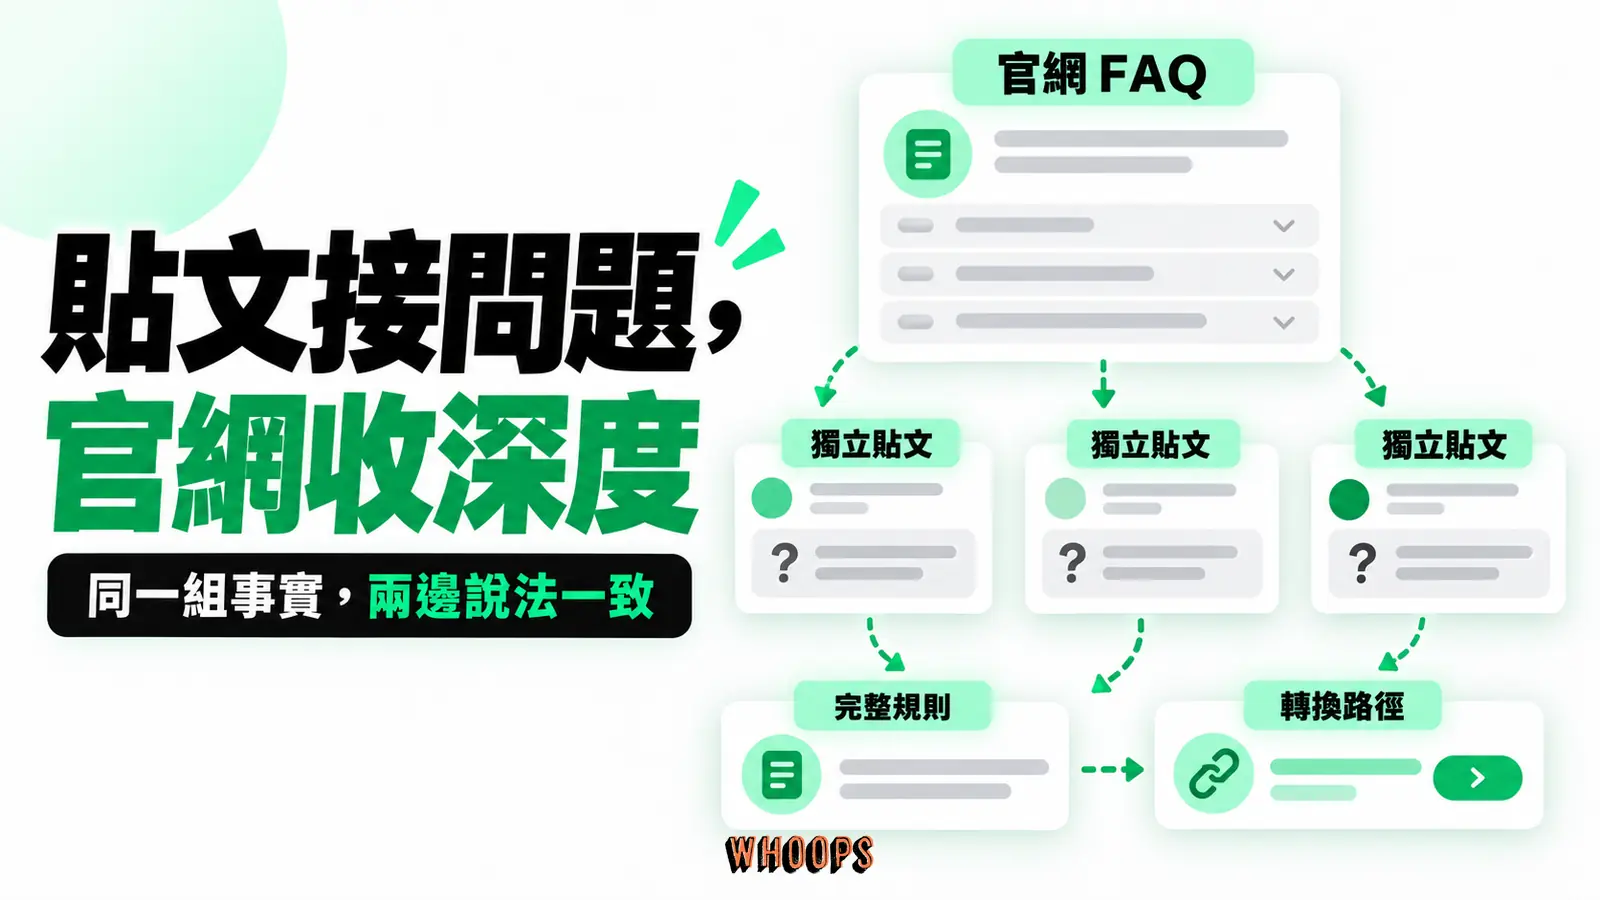
貼文與官網的分工要想清楚:貼文接問題,官網收深度。貼文的任務是在查詢發生的當下提供可引用的答案片段,官網的任務是承載完整論述、結構化資料與轉換路徑。兩邊說法要一致,價格、條件、流程在貼文與官網如果對不上,AI 兩邊都讀得到,矛盾會被看見,信任會被扣分。這也是為什麼拆文前值得先盤一次事實:所有要寫進貼文的數字,官網上都查得到、對得上,這個紀律比任何寫作技巧都值錢。
衡量:GSC 平台屬性與側錄題組
過去衡量社群內容在搜尋裡的表現,只能間接推測;2026 年 7 月起,Google 把量測工具直接開出來了。Search Console 推出「平台屬性」,一種新的資源類型,讓創作者把 Instagram、TikTok、X、YouTube 帳號加入 Search Console 驗證,直接看見哪些搜尋字詞把人帶到你的社群內容,以及 Google 探索(Discover)裡的表現。三種報表:效能報表看曝光點擊與熱門貼文查詢,洞察報表看流量趨勢與帳號被發現的方式,成就報表記錄里程碑。功能在 7 月 7 日公告時標明數週內漸進推出,Google 已於 7 月 29 日公告平台屬性全球開放,並同步發布了社群與影片內容成效的分析指南(洞察報表裡可以看帶入流量的查詢主題群與其上升下降趨勢);如果帳號裡找不到入口,照著設定文件的流程檢查帳號資格與驗證步驟即可。沒有自己網站的創作者也能用,這是 Google 對「社群內容是搜尋生態一部分」最實質的表態,平台屬性的設定說明在 Google 支援中心可以查到完整步驟。
平台屬性量的是 Google 搜尋與 Discover 的整體成效,AI 功能的表現也包含在整體數字裡,但報表無法直接辨識「被 AI 引用」發生了幾次,AI 摘要裡的個別被引用狀況仍要分開測。實務上可行的做法是固定題組側錄:挑十到二十個顧客真的會問的問題(不是品牌字,是品類與情境字),每月固定時間在 Google 搜尋、AI 模式與一兩個聊天機器人裡各問一遍,記錄答案裡有沒有出現社群來源、是不是你的來源,把結果整理成趨勢。側錄時固定地區、語言與登出狀態,並保存答案文字與來源連結,能降低個人化與介面變動對跨月比較的干擾。這個量測不求精確計數,求的是方向:社群來源在這批問題的答案裡出現的頻率有沒有上升,你的帳號有沒有開始出現。單次答案的變動是雜訊,跨月的趨勢才是訊號。
側錄紀錄的欄位設計得簡單才能長久。資料的單位是「問題 × 引擎 × 測試月份」各一列,每列四個欄位就夠:測試日期與引擎、問題、答案裡出現的社群來源(平台與帳號名)、自己是否在列。用試算表逐月累積,指標先定義兩個就夠:引用出現率等於含社群來源的答案數除以有效答案數,品牌出現率等於你的帳號出現的答案數除以同一個分母。分母的操作定義要固定:成功回答但沒有社群來源的紀錄計入分母,引擎未觸發 AI 摘要、拒答或出錯的紀錄另計不進分母,每個引擎與模式分別算趨勢,避免分母組成變動干擾跨月比較。半年後回看,就能回答三個問題:這批問題的答案裡,社群來源的佔比是升是降;哪個平台在你的品類裡最常被引用;你的帳號出現過幾次、都在哪些問題上。紀錄本身不要追求窮盡,題組固定比題組全面重要,因為比較的基準一旦改變,累積的趨勢就斷了。
兩種量測各有不能越界的解讀。平台屬性裡的曝光代表貼文出現在搜尋結果,被引用發生在 AI 摘要裡,兩者會互相關聯但不是同一件事;側錄看到自己被引用,也不保證有點擊,多數情況下答案已經把需求消化掉。衡量社群 GEO 的健康指標應該是三個:搜尋可見度(以效能報表裡搜尋結果的曝光為準;資料空白未必等於沒被索引,可能只是還沒有曝光,或新加入的屬性還在累積資料)、引用出現率(含社群來源的答案數佔有效答案數的比例)、品牌出現率(你的帳號出現的答案數佔同一分母的比例)。這三項裡,搜尋可見度只在平台屬性支援的四平台上量得到;Facebook 與 Threads 觀察後兩項,搜尋可見度用 site: 抽查做定性確認即可,兩種口徑不要混在同一條趨勢線裡。三個都動了,再回頭看流量與轉換,順序才不會錯,也才不會把前後因果倒著讀。
風險與誠實限制
這套打法有三個限制,先講清楚再動手。第一,證據基礎集中在 Google 體系。AI Overviews 的引用數據、Search Console 的平台屬性、各平台的索引開放,全部是 Google 生態的事實;ChatGPT 與其他模型的檢索機制不同,取材行為沒有等量級的公開數據,把它們也納入側錄題組觀察即可,不宜用 Google 的數據推論它們的行為。第二,樣本與市場差異。引言裡的數字來自美國市場的大型樣本,台灣的社群使用結構與美國不同,各平台的內容供給與角色分配可能都有差異,數字要當參考座標,選題假說與檢查框架可以沿用,實際的選源傾向與寫法效果仍要以本地側錄驗證。
第三個限制最根本:平台資產不是你的資產。社群帳號建立在別人的地基上,演算法改版、帳號停權、平台政策轉向(今天預設開放索引,明年未必),都可能讓累積的引用基礎一夜歸零。索引政策本身就有前例可循:Instagram 從近乎全封閉走到預設開放只花了幾年,過程中平台單方面決定、經營者只能跟著調整,開放與否的開關一直握在平台手裡。這個限制不改變行動建議,只改變配置方式:社群貼文承接查詢與引用,官網承接深度與轉換,兩邊互相導流,任何一邊垮掉,另一邊還在。純粹把所有內容資產放在單一平台上經營,在 AI 搜尋世代承擔的風險比過去更高,因為你要守的平台決策變數從一個變成了兩個。
收斂成一份可以照著走的檢查清單。現況盤點:確認每個帳號的形態與索引狀態(IG 是否專業帳號、索引設定是否開著、貼文是否公開)。內容改造:回頭看最近十則貼文,第一行有沒有結論或數字,事實是不是寫在文字裡,有沒有一句話能被單獨搬走。素材擴編:從官網 FAQ 挑十題,改寫成十則獨立貼文。量測上線:Instagram、TikTok、X、YouTube 的帳號加進 Search Console 平台屬性,並建立側錄題組(Facebook 與 Threads 不在平台屬性支援清單,用 site: 搜尋抽查補蹤),排定每月一次的節奏。一季後回頭看健康指標的變化(支援平台看三項,Facebook 與 Threads 看引用與品牌兩項),再決定加碼或調整。社群貼文被 AI 引用這件事,門檻不在技術在紀律,把每則貼文都當成一次回答陌生人提問的機會來寫;有沒有效果,讓側錄題組的跨月趨勢告訴你,但要記得側錄看到的是同期變化,模型、平台供給與介面也會變動,趨勢不能單獨歸因於某一項寫法。從今天起發的下一則貼文,就是這套紀律的第一個練習題。