執行成本 vs 理解成本:AI 時代的稀缺上移與判斷力帳本
AI 把執行成本打平,理解成本沒有消失,只是轉成驗收成本與出錯成本。PNAS 家教實驗顯示無防護 GPT-4 在工具移除後成績低於對照組,BCG 顧問實驗顯示邊界外任務正確率下降。稀缺上移到判斷力、品味與問對問題,三者都是理解的產品,附理解最小劑量三訊號與先萃取判斷再打包 Skill 的順序。
- 執行成本
- 理解成本
- AI 範式轉移
- 認知外包
- 認知卸載
- AI 技能化
- AI 依賴
- 批判性思考
- 判斷力
- AI 時代稀缺能力
- 表現與能力
- 倖存者偏差
- 知識萃取
- Agent Skills
約 26 分鐘閱讀作者:Whoops 編輯團隊
「AI 把執行成本打到比理解成本低,所以理解可以跳過。」這句話你近來大概聽過某個版本:先把知識找到、結構化,打包成可執行的流程交給 Agent,你自己的理解停在 20 分,系統卻能做出 80 分的成果。這個論斷的前半是真的,而且重要:執行與理解確實被拆開了,這是生成式 AI 帶來的真變化。後半則把帳記錯了邊。理解成本沒有下降,它只是換了一張發票,從「學費」改成「驗收成本」與「出錯成本」,而且常常由看不見它的人支付。
這場辯論值得認真打完,因為兩邊手裡都有真證據。接下來先把成本帳拆開:執行與理解為什麼是兩種不同性質的成本;再檢驗流行的 20/60/80 能力分層,看「被拉到 60 分」的究竟是誰的分數;然後追問稀缺往哪裡移動,以及知識來源的可信度該怎麼算;終場收在一條不同的路:理解的最小劑量,以及把知識打包給 Agent 的正確順序。
執行成本與理解成本,從來是兩本帳
先把兩個詞釘牢。執行成本,是把已經定案的判斷變成產出的成本:找齊資料、統一格式、依規格落實、把會議結論排成簡報。理解成本,是形成判斷本身的成本:判斷什麼重要、什麼可信、數字怪在哪裡、出錯了往哪裡追。在 AI 出現之前,這兩本帳通常綁在一起結算:你得很懂定價,才做得出一份定價方案;你得很懂受眾,才寫得出一封轉換信。綁得太久,久了大家就忘記那是兩筆錢。生成式 AI 把綁繩剪斷了,這是它真正的歷史位置,流行說法看見了這一點,嗅覺沒有問題。
執行與理解拆開,歷史上也不是第一次。工程計算機普及之後,結構工程師不再手算矩陣,但沒有人因此主張結構學可以跳過;試算表把重複計算自動化之後,懂模型的人產能暴增,不懂模型的人則多了一種把錯誤算得更快的方法。工具移動的是門檻,移不動的是責任:簽名的人要懂。生成式 AI 的差異在規模與介面,它把這個拆開延伸到文字與判斷密集的工作,於是第一次,簽名的人可以低成本假裝自己懂。流行說法把這個新能力描述成新自由,帳務的角度看,它是一張延後支付的合約。
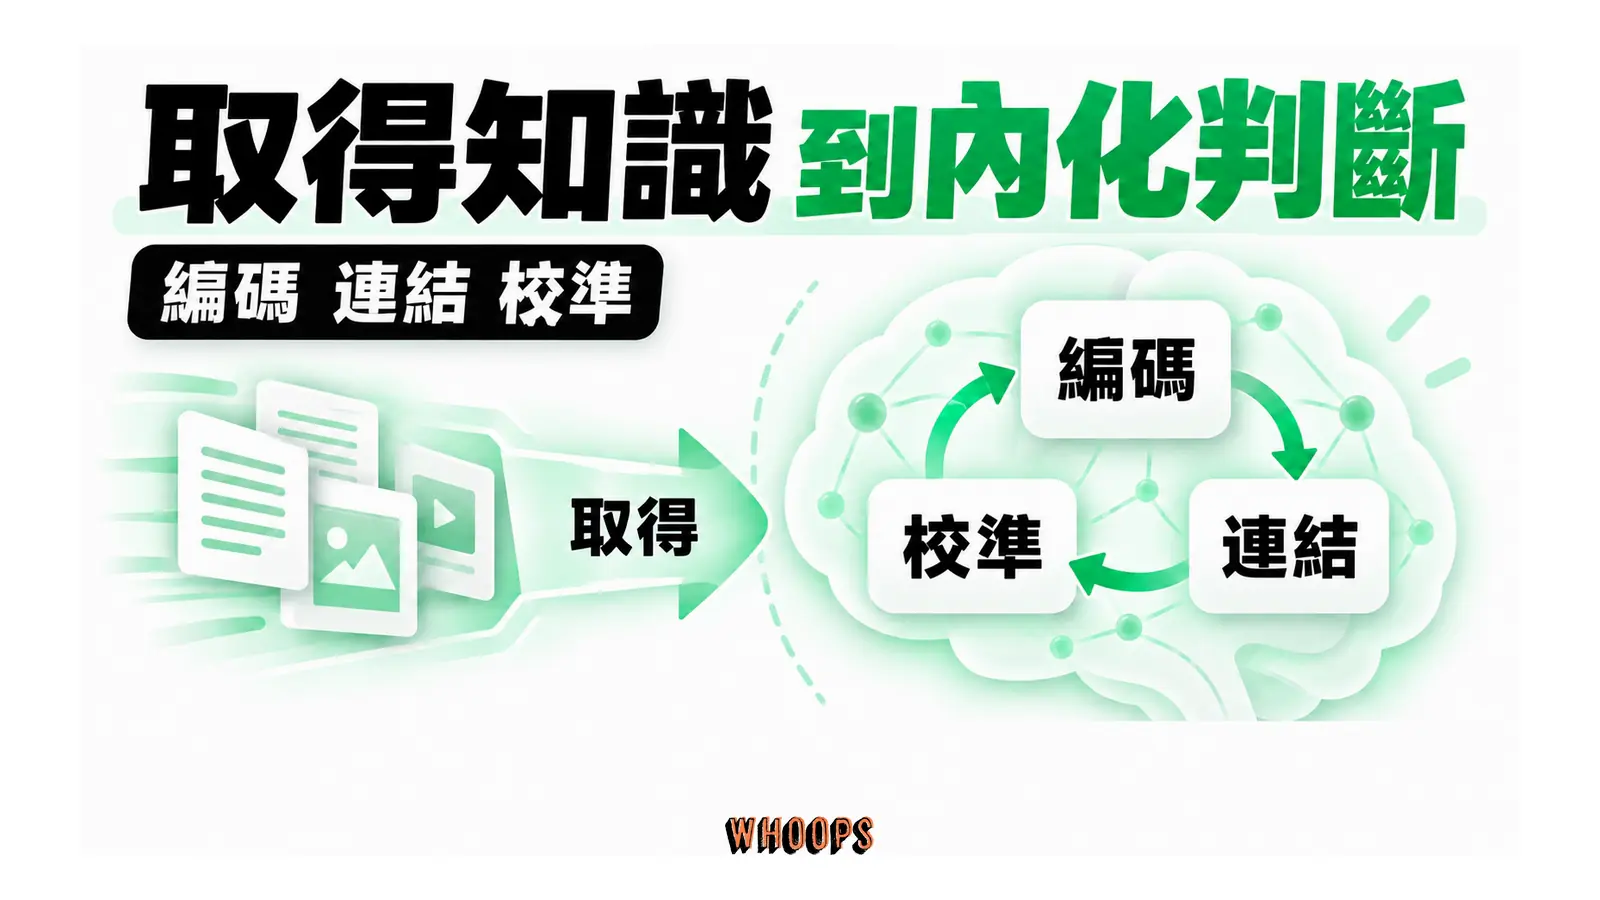
取得成本與內化成本
剪斷之後,拆開理解成本會看到兩層。一層是取得成本:資料在哪、讀不讀得到、術語擋不擋路。另一層是內化成本:讀進去的東西要編碼進長期記憶、掛上既有的知識網,判斷要在一次次回饋裡校準。編碼、連結、校準這三個動作疊起來,就是理解複利的機制,證據與細節在站上的AI 時代知識管理一文拆過,這裡直接引用結論:複利以費力為輸入,以之後更快更好為輸出。生成式 AI 壓縮的是取得成本,檢索、摘要、初稿從「一個下午的專案」變成「一次按鈕」。內化成本它付不了,因為那是一張生理帳單,戶名只能是你的大腦。認知科學裡的合意困難研究講了幾十年同一件事:讓練習當下變費力的條件,長期成效反而更好;費力是輸入,理解是輸出。模型的價值主張恰恰是移除費力,這是商業上聰明的選擇,也是它與理解複利站在對面的原因。
兩張新帳單:驗收成本與出錯成本
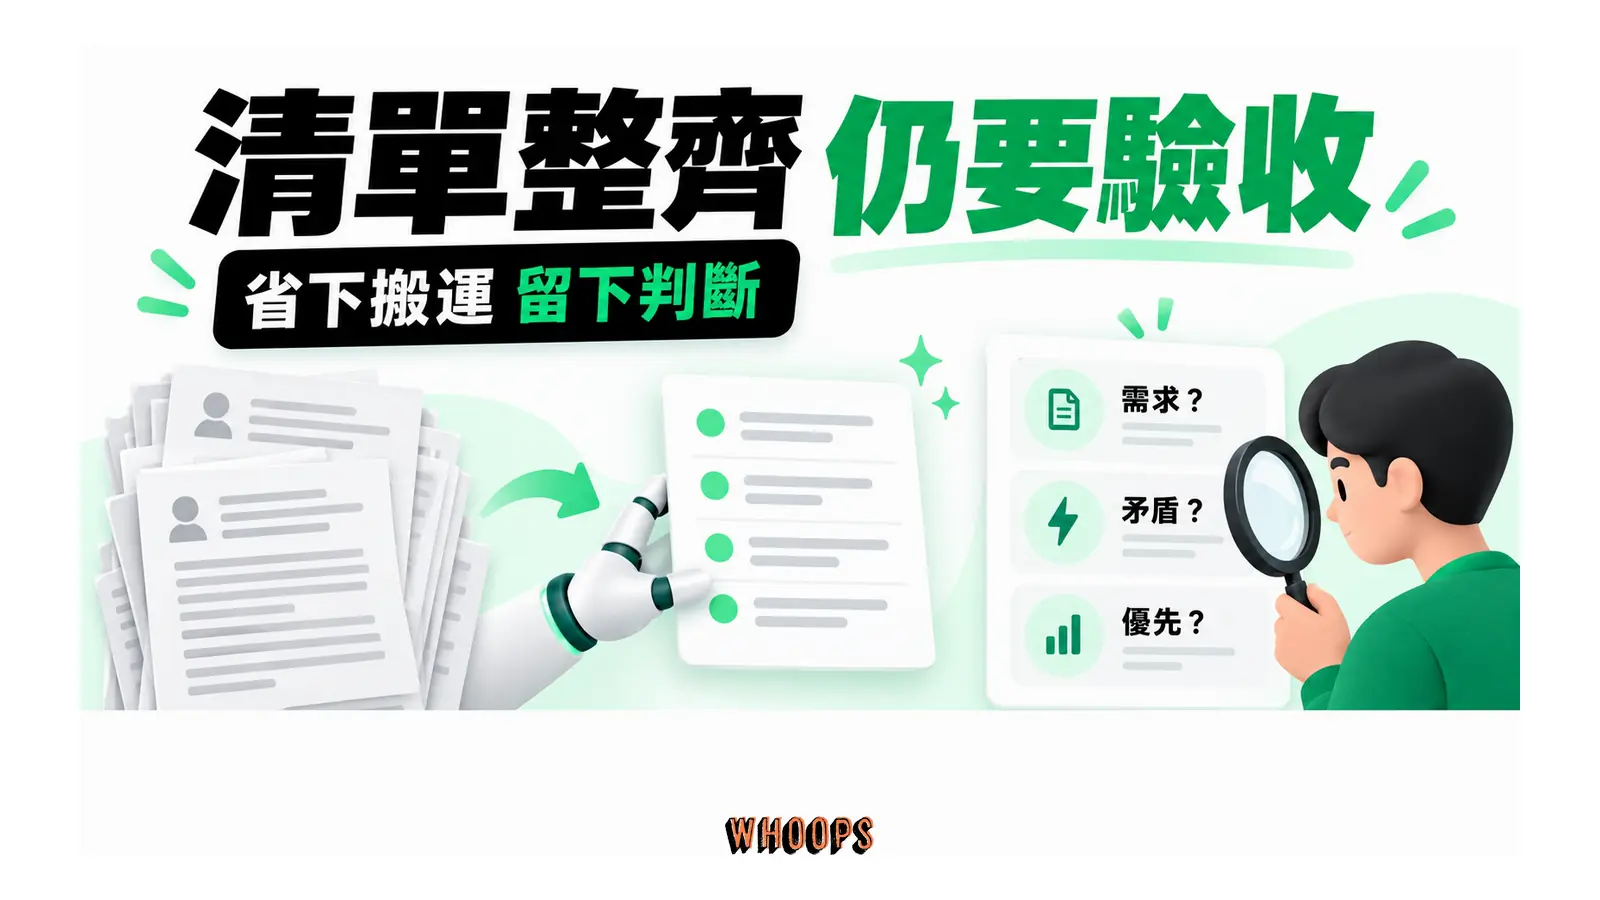
所以那句流行口號的正確改寫是:執行成本被外部化了,理解成本原封不動。帳單沒有消失,轉成兩張新的。第一張叫驗收成本:產出既然不是你做的,你得看得出它哪裡錯,而看得出錯的前提,是你對這個領域有足夠的理解。第二張叫出錯成本:看不出來的部分不會憑空消失,由客戶、同事或市場代收,通常外加利息。舉一個具體的場景就能看見兩張帳單怎麼開出來。你接下一個任務,把二十份客戶訪談逐字稿整理成需求清單。搬運、去重、格式統統可以交給模型,這是執行,交出去省下的時間是真紅利。但需求清單的每一行都是判斷:受訪者這句抱怨是情緒還是需求、兩個人說的矛盾該怎麼調解、哪一條該排優先。模型會給你一份看起來工整的清單,排序的理由它不會附上,因為排序就是理解本身。你若照單全收,驗收成本當場掛零,出錯成本靜靜計息;你若逐行檢查,就會發現自己付的理解成本,一毛都沒少,只是付的時機從讀逐字稿挪到了對帳的時刻。
20 分的人在這個結構裡最吃虧,因為驗收 80 分的輸出,本身就需要 60 分以上的理解。心理學在搜尋引擎時代就量到過這個陷阱:2015 年的九項實驗(Fisher 與同事刊於《實驗心理學:總論》的研究)發現,線上搜尋過資訊的人,會系統性高估自己知道多少,把「查得到」誤記成「我會」,個人知識與外部可得資訊之間的界線被模糊掉。疊上加碼的是自動化偏誤:人傾向採納自動化系統給的建議,忽略沒有系統背書的相反資訊,即使那資訊是對的。兩個效應合起來,描出一個不舒服的圖像:人最容易在不懂的地方,對機器的輸出最放心。執行成本的紅利請領,但請看清楚代價欄,你簽下的本票是理解,只是到期日延後了。
60 分是誰的分數:表現與能力要分開記帳
分層模型本身值得先說公道話。把一個領域的人粗分為 20 分的入門者、80 分能穩定產出者、95 分靠這行吃飯的專業者,然後宣稱:AI 把大量 20 分的人拉到 60 分,而 80 分以上的比例沒有變動。這個觀察本身站得住,一百個人的房間裡,八十幾分的高手向來只有個位數,工具出現前後都是。問題出在少了一步解釋:被拉到 60 分的,究竟是人的能力,還是人加上工具的表現?這一步差別,決定了你是該繼續往上爬,還是可以安心停在原地。
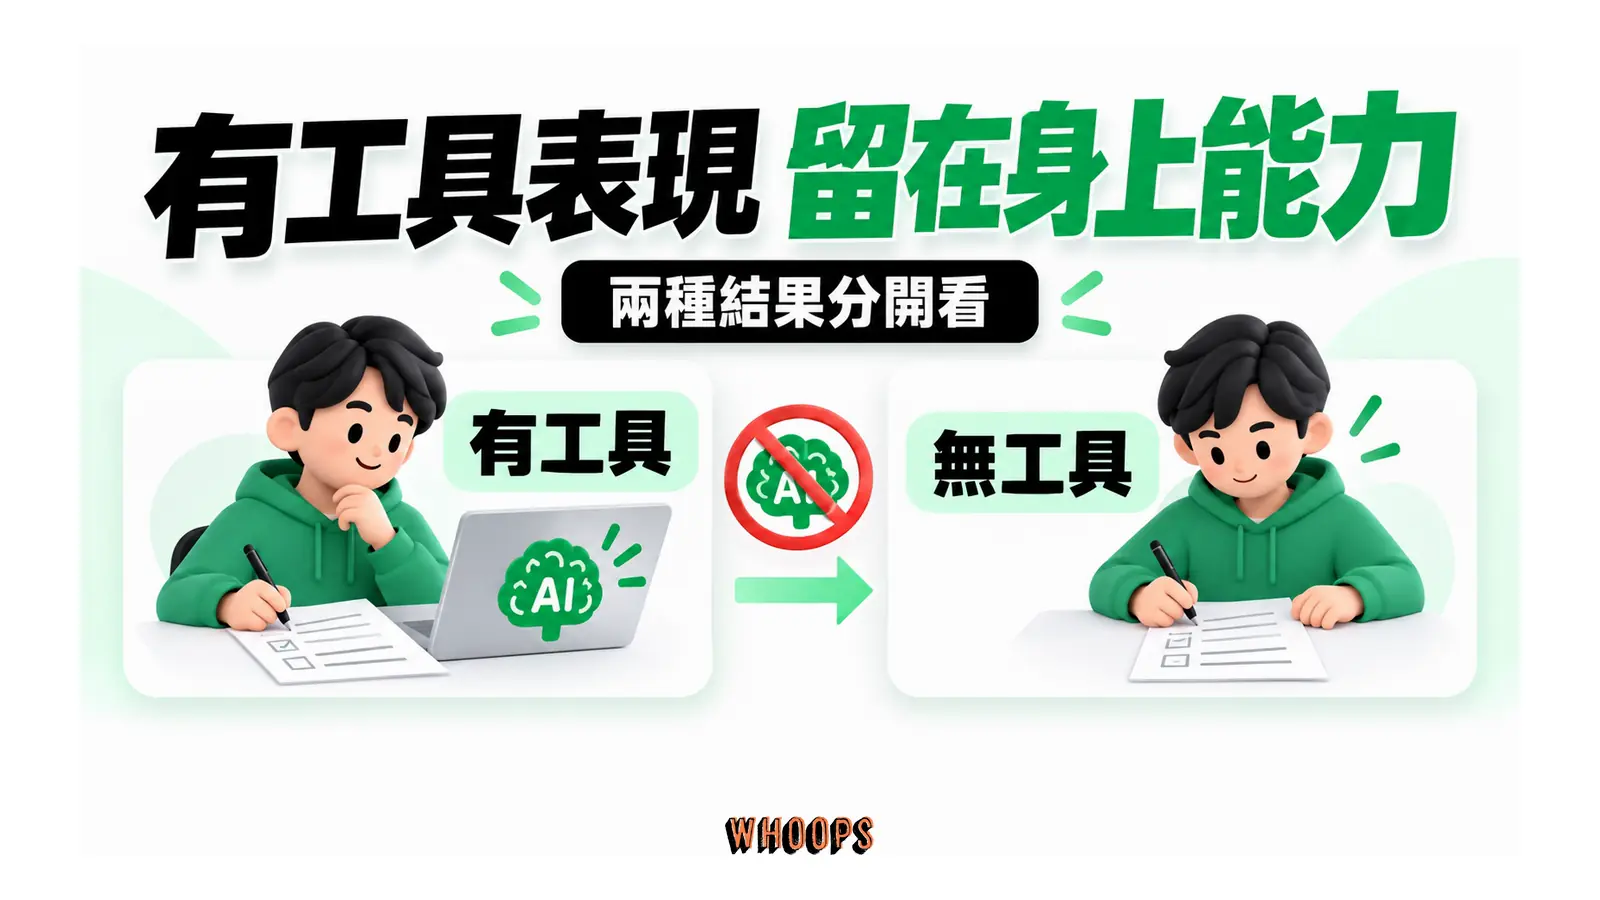
這一步剛好有實驗證據。2025 年發表於 PNAS 的田野實驗讓將近一千名高中數學生使用 GPT-4 家教,分成模仿一般聊天介面的標準版,與加了學習防護提示的家教版。練習階段的數字很漂亮:標準版組成績提升 48%,家教版提升 127%。工具移除後的考試,方向翻轉:標準版組的成績,比從未使用 AI 的對照組低 17%。研究者用了一個直白的說法,學生在練習裡把工具當拐杖。同一批學生,兩種分數:練習分數是表現,有工具加持的表現;考試成績是學習,留在身上的殘餘。「AI 把人拉到 60 分」拉的是第一種。工具一收走,分數回落,甚至低於沒用過的人。分層模型把這 60 分畫在人的身上,實驗告訴我們,它記在人機系統的帳上,而系統的帳隨時可以止付。
企業側有更大樣本的對照。與波士頓顧問公司合作的預註冊田野實驗(2023 年以工作論文發布、2026 年正式線上刊於 Organization Science 期刊)讓 758 位 BCG 顧問在 18 項貼近顧問工作的實驗任務上使用 GPT-4:在 AI 能力邊界之內的任務,用 AI 的人多完成 12.2% 的任務、速度快 25.1%,品質也顯著提升;在邊界外的一項複雜任務上,用 AI 的顧問提出正確解的機率,比不用 AI 的同事低了 19 個百分點。研究者把這個現象命名為鋸齒狀前沿:邊界內外的任務可以出現在同一條工作流程裡,外觀難度還很接近。你無法靠「看起來難不難」判斷自己站在哪一邊,能判斷的依據是對任務的理解,而這恰恰是 20 分的人還沒有累積的東西。對照分層模型,這裡藏著更冷的一句話:60 分的舒適區,正是讓人不知不覺走進邊界外的原因。
| 研究 | 有工具時 | 工具移除或邊界外 | 對分層模型的含義 |
|---|---|---|---|
| PNAS 高中數學家教實驗 | 練習成績提升 48%,防護版 127% | 移除後比對照組低 17% | 被拉高的是表現,能力帳上沒有進帳 |
| BCG 顧問實驗,758 人 | 邊界內多完成 12.2% 任務、快 25.1% | 邊界外正確率低 19 個百分點 | 難度看不出邊界,靠理解判斷位置 |
| 腦波寫作實驗,54 人 | 產出較流暢、較同質,所有權感較低 | 難以正確引述自己剛寫完的文章 | 過程可能沒有經過編碼 |
表裡第三列的研究稍後展開。到此可以先回答本節的問題:60 分是借來的分數,暫時記在你名下。80 分之所以沒有變多,第一層解釋是,要把表現換成能力,中間需要編碼與校準的練習,而把執行交出去的人,最常把練習的輸入一起交出去。工具拿走的是產出過程裡的費力段落,而費力段落正是能力漲價的櫃檯。
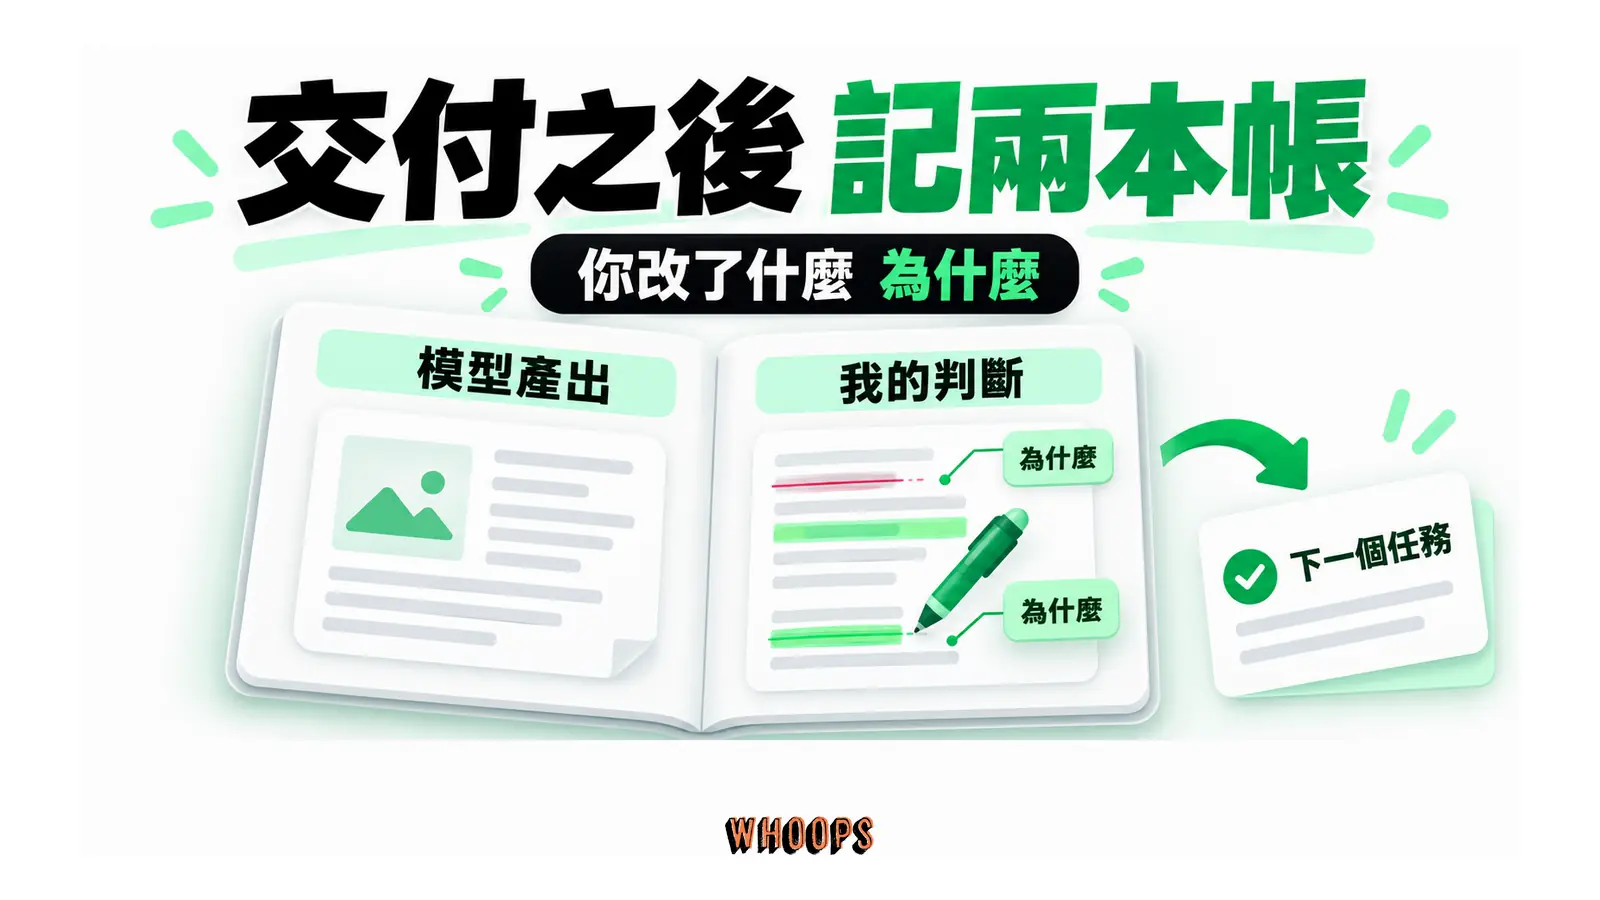
把這個原則變成個人工具,只需要一本雙欄帳。每次交付之後記兩行:這次產出裡,模型寫了什麼、你改了什麼;改動裡有幾處,你說得出理由。第一欄是表現欄,記錄工具替你完成了多少;第二欄是能力欄,記錄這次交付經過了多少你的判斷。連記一個月,兩欄的比例會告訴你,你正在累積的是作品集還是判斷力。這個帳本不禁止外包,它只讓你看見:有些月份產出漂亮,能力欄卻是空的。帳一旦看見,取捨才有得談。
更深的問題:80 分的供給,可能正在被抽走
分層模型是一張靜態的照片,漏掉了動態的事實:今天的 95 分,是十年前的 20 分一路爬上來的。爬的路徑有名字,叫練習、犯錯、回饋。新手時期被退過的稿、算錯過的報價、搞砸過的專案,是專業判斷的本金。如果這條路斷了,80 分與 95 分不會只是「沒有變多」,而是會開始變少。這是比分布不變更值得擔心的劇本,而且它已經有早期的徵兆。
第一個徵兆來自大腦。2025 年 6 月上傳 arXiv 的腦波預印本把 54 位參與者分成純腦、搜尋引擎、大型語言模型三組寫散文,第四場交換部分人的條件:語言模型組的腦區連結最弱,對文章的所有權感受最低,而且難以正確引述自己剛寫完的作品;曾經用模型的參與者改回純腦寫作時,連結依然偏低。研究者在題名裡用了認知負債這個隱喻:當下省下的力氣,之後連本帶利還。這份研究要誠實對待:預印本、尚未經同儕審查、樣本數十人、文體只有一種,它量到的是歷程差異,還不是能力的判決。但「難以引述自己剛寫完的東西」這條行為線索,與 PNAS 的考試成績指向同一個地方:過程可能沒有經過你。
第二個徵兆來自日常使用者。2025 年刊於 Societies 期刊的混合方法調查(666 人)發現,AI 工具使用頻率與批判性思考量表分數顯著負相關,而且這層關係由認知卸載中介:用得愈頻繁,卸載愈多,批判性思考的量表分數愈低。橫斷面相關讀不出因果,方向也可能反過來,思考偏好低的人本來就更依賴工具。2025 年 4 月 CHI 會議上的知識工作者調查補上了信心這一側:319 位知識工作者交出 936 個第一手使用案例,自陳對 AI 愈有信心,批判性思考的投入愈少;對自己愈有信心,投入愈多。要注意這量到的是參與者自陳的投入程度,不是客觀能力測驗的結果。兩種信心,兩個方向,而模型輸出的流暢與自信,正在餵養其中比較危險的那一種。
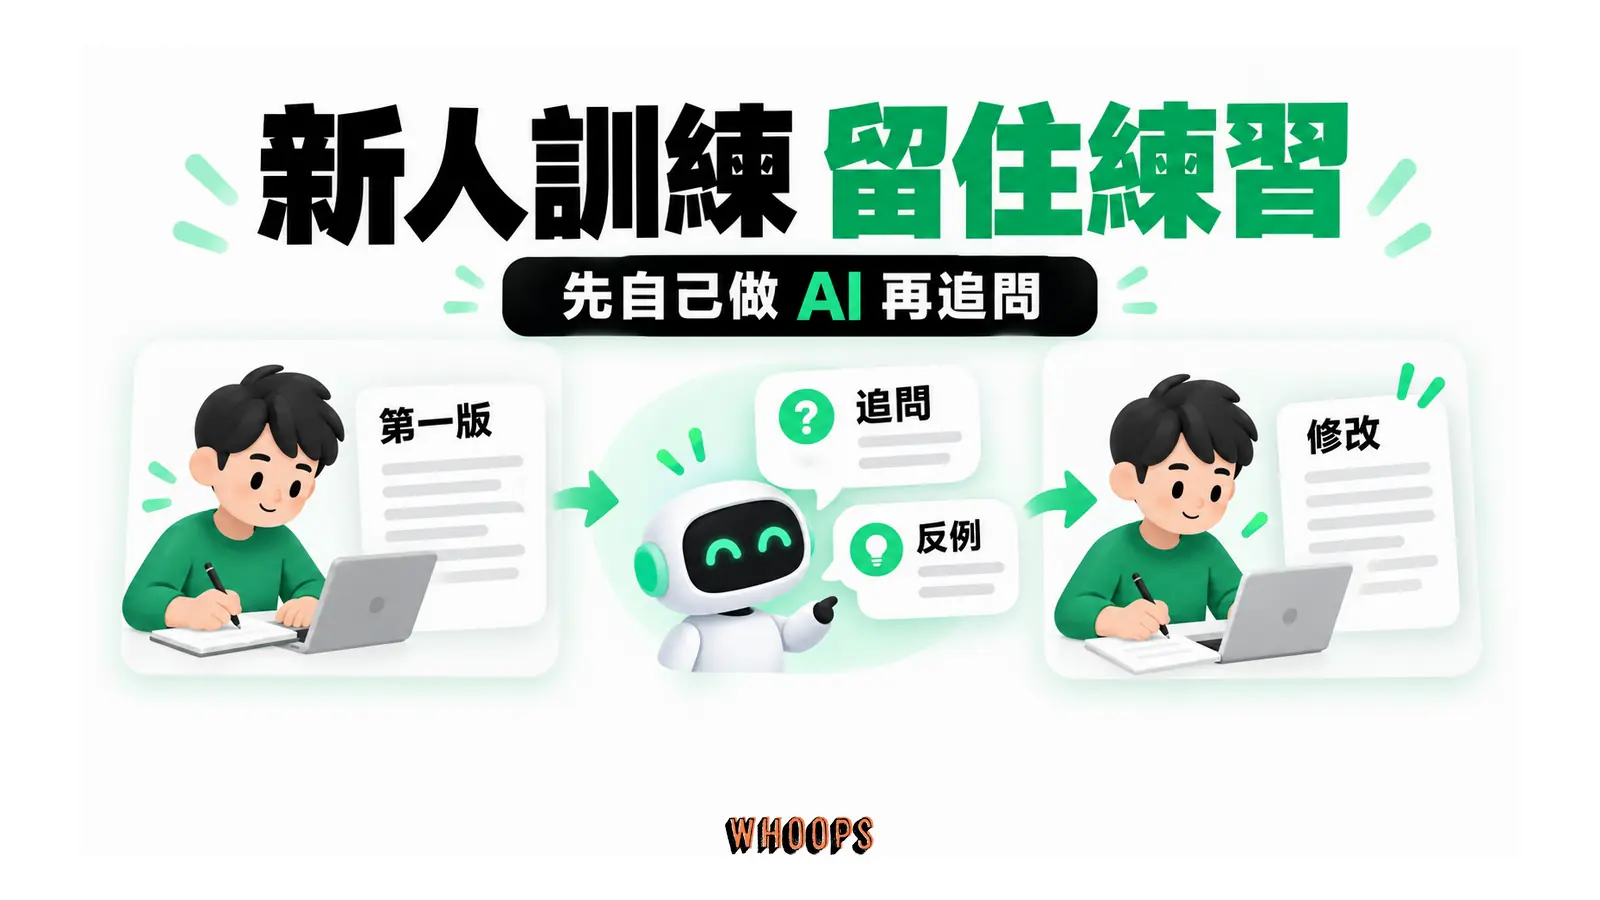
第三個徵兆藏在組織裡。新人期是能力建立的窗口,也是產能壓力最大的階段。如果訓練期直接用無防護的工具衝產出,等於把編碼練習整批跳過,而且產能報表上看不出任何異狀,看得見的是產出篇數,看不見的是獨立作業能力。帶人的主管可以借用 PNAS 實驗的啟發:同樣的模型,防護版把 AI 的位置從代筆者換成陪練員,負面效應就大幅緩解。對應到職場,就是讓新人自己出第一版,模型負責追問、找漏、給反例;兩種用法都叫用 AI,留下的練習量天差地遠。一個組織這樣設計,留住的是梯子;一整個世代跳過練習,十年後 95 分的來源就會枯竭。80 分供給減少的原因,可能很殘酷:停在 60 分太舒服了,舒服到沒有人去付 80 分那一段的理解成本。
80 分的定義本身也值得再壓一次。分層模型說 80 分是概念吃透、能穩定做出成果的人。穩定兩個字裡藏著維修能力:模型改版、市場轉向、題目落在訓練資料的縫隙裡,系統開始出錯時,20 分的理解修不了 80 分的系統,你連故障登記表都填不出來。流行說法自己都承認,模型的預設答案只是平均正確;而平均正確的東西,遇到不平均的情境,恰好就是出錯的地方。判斷眼前是不是不平均的情境,需要理解。這個需求在分層圖上沒有欄位,在實務上天天出現。
供給面的帳還可以算得更硬一點。一個工作者的成長曲線,粗略等於他每年親手完成的判斷次數,乘上每次判斷收到的回饋品質。用模型代工的判斷,既沒有經過你,回饋也不會打到你身上,兩個乘數同時歸零。新人第一年若把需求判斷、報價判斷、優先序判斷全部代工,履歷上的專案數會很漂亮,判斷次數那一欄卻接近空白;第三年遇到市場反轉,兩種人的差距才一次結清。訓練期把產能開到滿,等於用未來的判斷力換今天的交付速度,這筆交換划不划算,至少要在睜著眼睛的狀態下簽。
稀缺上移是對的,但移到位的東西叫理解
辯論的另一邊也有真東西,該承認的要承認。知識存量的價值確實在跌:查得到的事實、背得出的規格、照抄不會錯的格式,這些東西的記誦價值被搜尋與 AI 壓縮。這甚至不是新聞,2011 年刊於 Science 的四項實驗(Sparrow、Liu 與 Wegner 的研究)就發現,當人預期資訊之後查得到,對內容本身的回憶率下降,對去哪裡找的回憶率上升。外部儲存可靠的時候,大腦本來就會把資源挪走。生成式 AI 只是把這條走了十五年的曲線畫得更陡。
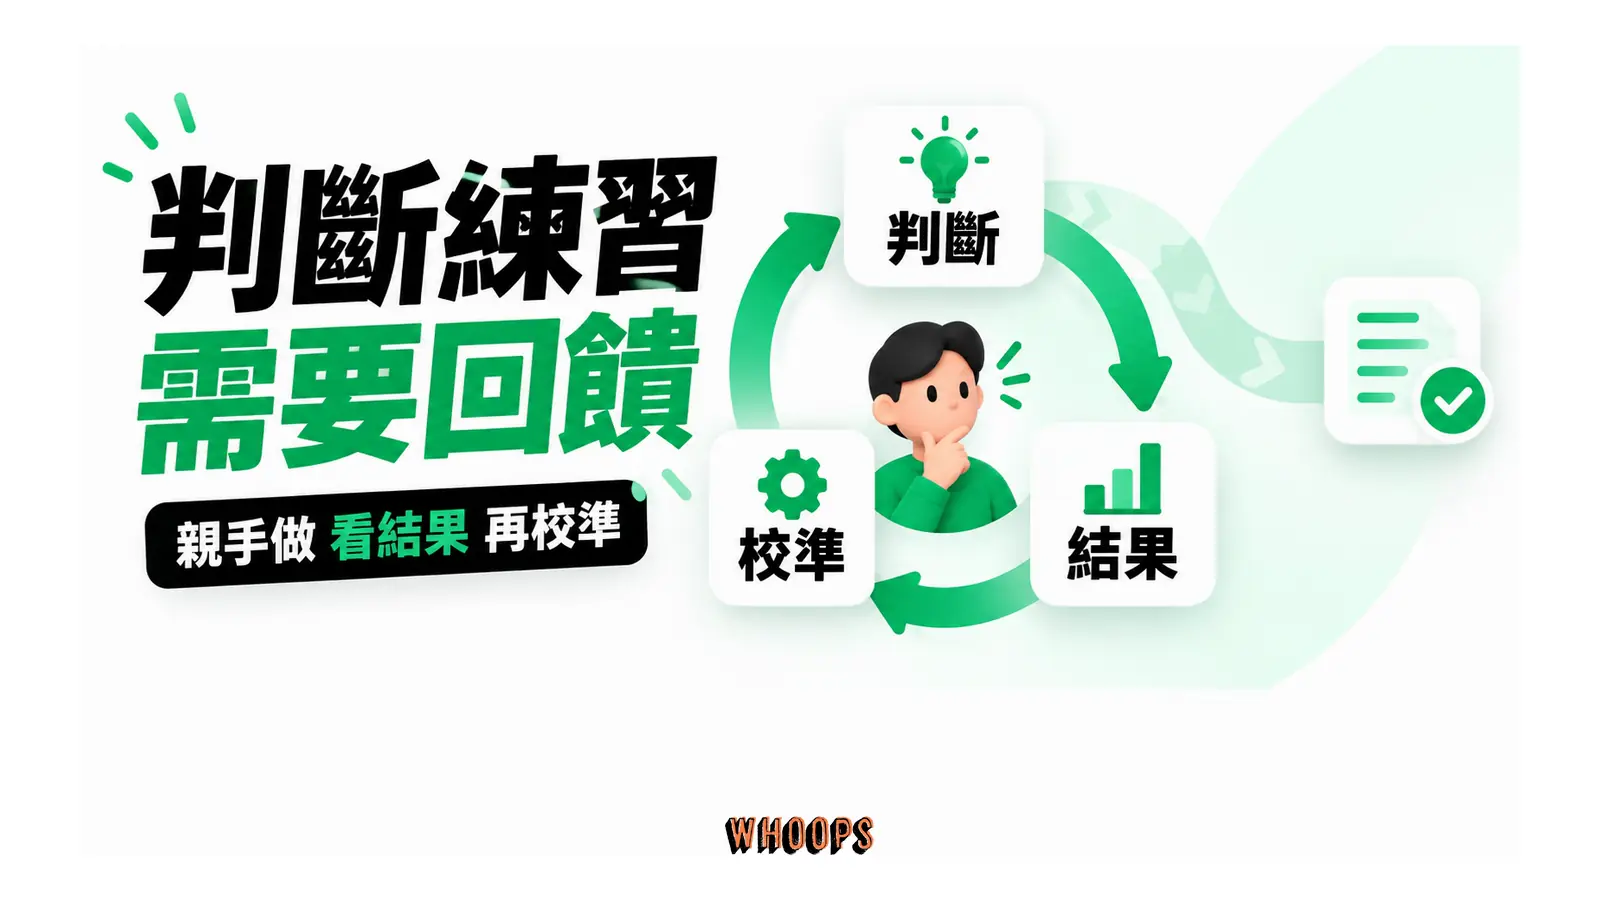
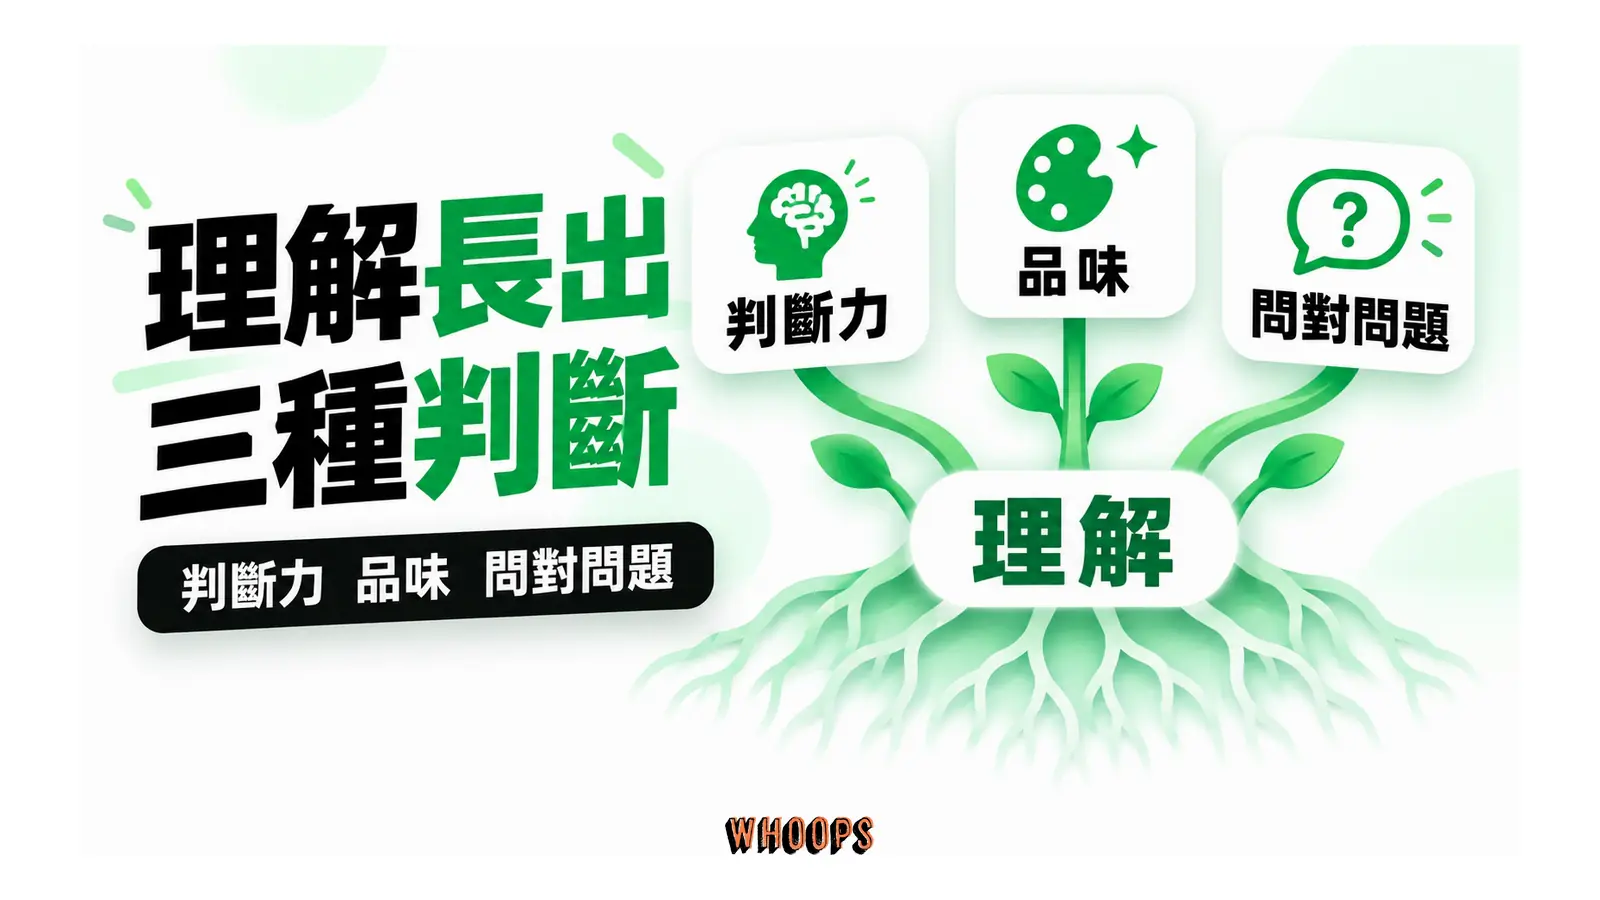
但檢驗稀缺上移之後的清單,會看到一個有趣的結構。上移後公認值錢的東西有三樣:判斷力,知道什麼重要、什麼可信;品味,在同類作品裡挑得出高下;問對問題,把模糊的需求變成可執行的提問。這三樣有共同的原料。判斷力是校準的產物,要靠預測、看到結果、修正模型,一輪一輪磨出來。品味是大量好壞判斷累積出來的直覺,沒有看過夠多好東西與壞東西,直覺無從起跳。問對問題的前提,是你腦中有這個領域的地圖,知道哪裡是懸崖、哪裡是平地、哪裡有別人踩過的坑。三樣全是理解的產品。稀缺上移,移到位的東西仍然叫理解,只是從知道事實上移到形成判斷。
流行說法在這裡有一個沒有解決的內部矛盾。它要你用幾個問題快速調研陌生領域:核心概念是什麼、專家在判斷什麼、好成果由哪些環節構成、常見錯誤有哪些、執行步驟是什麼。這組問題問得很好,正是領域地圖的骨架。可是這些問題的答案,就是理解本身;更進一步,判斷答案的好壞,需要比答案本身更多的理解。一個 20 分的人拿到 80 分的調研結果,連這份結果是不是 80 分都驗收不了,更別說發現模型把兩個互相矛盾的主流說法縫成了和諧的假共識。這個矛盾到了打包階段還會放大:把 60 分的認知結構化,得到的是一套穩定執行 60 分認知的流程,規模化之後,平庸也被規模化了。
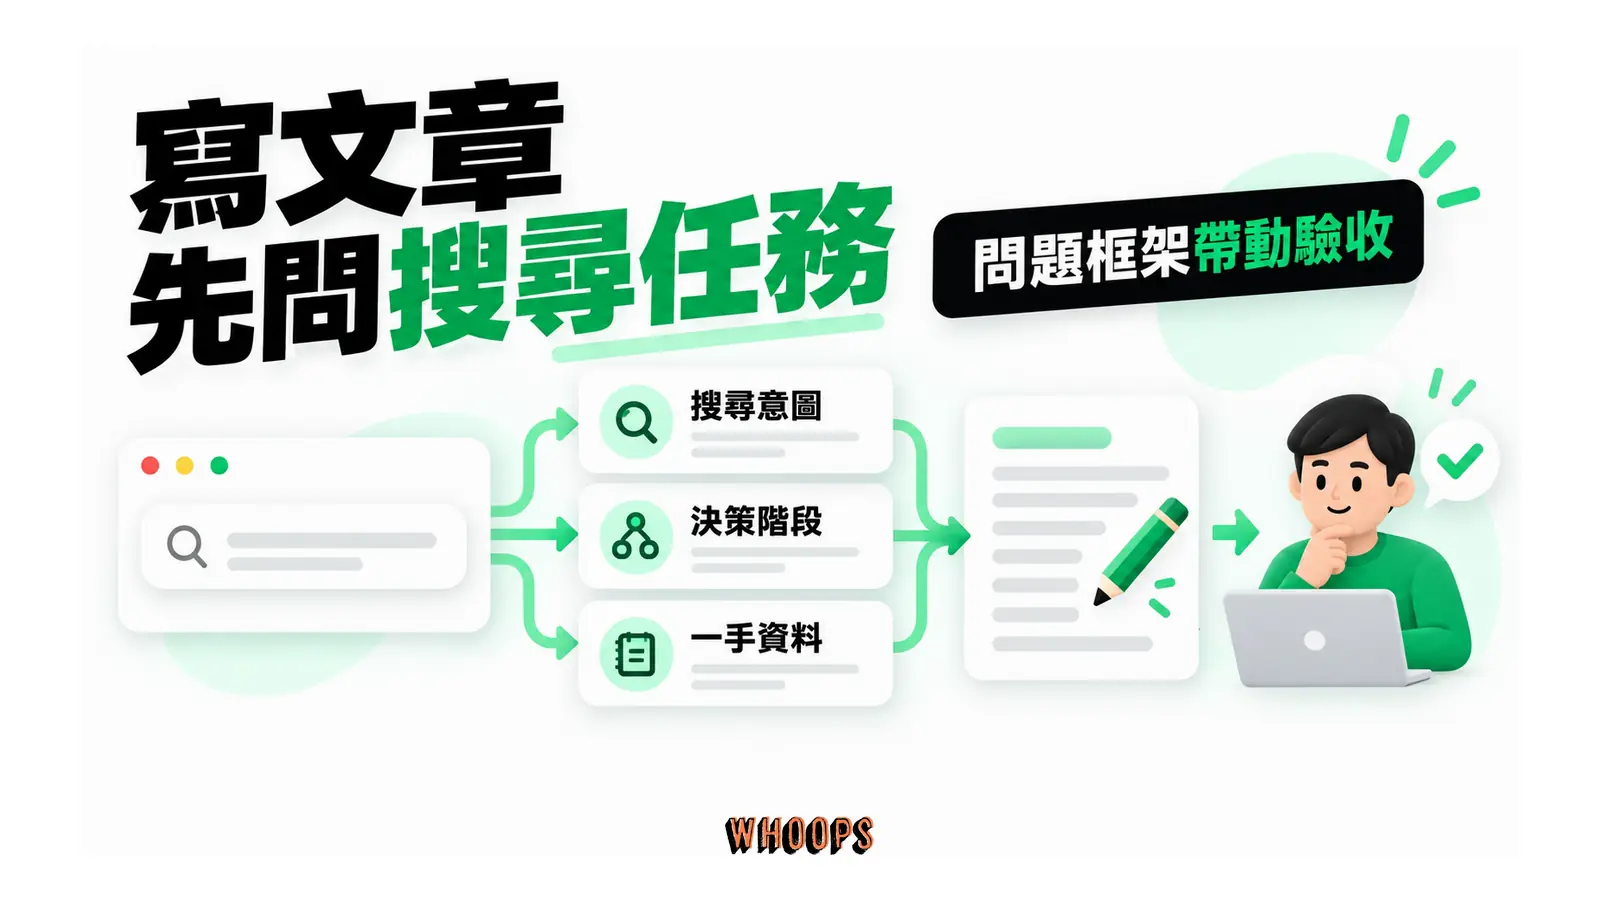
問對問題值多少,拿一個熟悉的工作來看就很具體。同樣是操作搜尋與內容,一種提問是「幫我寫一篇會排名的文章」,模型會還你一份結構完整的中規中矩長文,可用,但與它給其他一千個人的版本差距有限;另一種提問是先問自己:這組關鍵字背後的搜尋意圖是什麼、搜尋者站在決策旅程的哪一階段、現有排名前十的結果滿足了什麼、又漏了什麼、我手上有哪些別人沒有的第一手資料。前一種提問,模型只能回以平均值的答案;後一種提問的前提,是你腦中有這個領域的地圖與判斷,模型的輸出在你的框架裡被拆解、被驗收、被重組。兩種用法都叫用 AI,一種在消費模型的上限,一種在消費自己的上限。
修正後的命題是:AI 讓答案變便宜,讓問題變貴。執行技能這一層,分層圖上 40 到 60 分的那段工夫,確實在貶值,這是紅利也是淘汰,對買方是好事,對只會這段工夫的人是壞事。頂層稀缺的東西沒有換人,原料仍然是理解。差別在劑量與位置:哪些理解該全額支付,哪些只需要驗收劑量。這是下一節的題目,也是整場辯論真正可以落地的地方。
單一作者有濾網,AI 也有:知識來源的可信度
這場辯論裡最有價值的一個提醒,是讀書要小心作者立場。單一作者通常代表一個流派,傾向多講成功、少講失敗,案例經過挑選,這正是倖存者偏差的三道濾網:成功案例是被挑出來的、平台放大的都是倖存者、退場者不說話。只讀一本書,等於把整個領域先過了某一個人的濾網,才輪到你看到它。商管書最嚴重:寫書的人多半是活下來的創辦人,他歸納的成功法則,沒有對照組。
傳統的解法一直存在,叫主題閱讀:找立場衝突的幾本書對讀,自己當比對器。站上的閱讀習慣指南把這件事拆成可執行的系統,從選書、分析閱讀到筆記輸出。這是手動的跨源綜合,慢,但比對這個動作由你執行,判斷長在你身上。流行說法承認這個痛點,讀通一個領域要翻很多本不同立場的書,很花時間,然後端出一個跳過的方案:AI 能全面比較所有流派,挑證據強的當主軸,以論文為基礎,從根源杜絕偽知識。方案的前半有價值,後半把模型的綜合講成了沒有濾網的綜合,需要修正。
模型的四道濾網
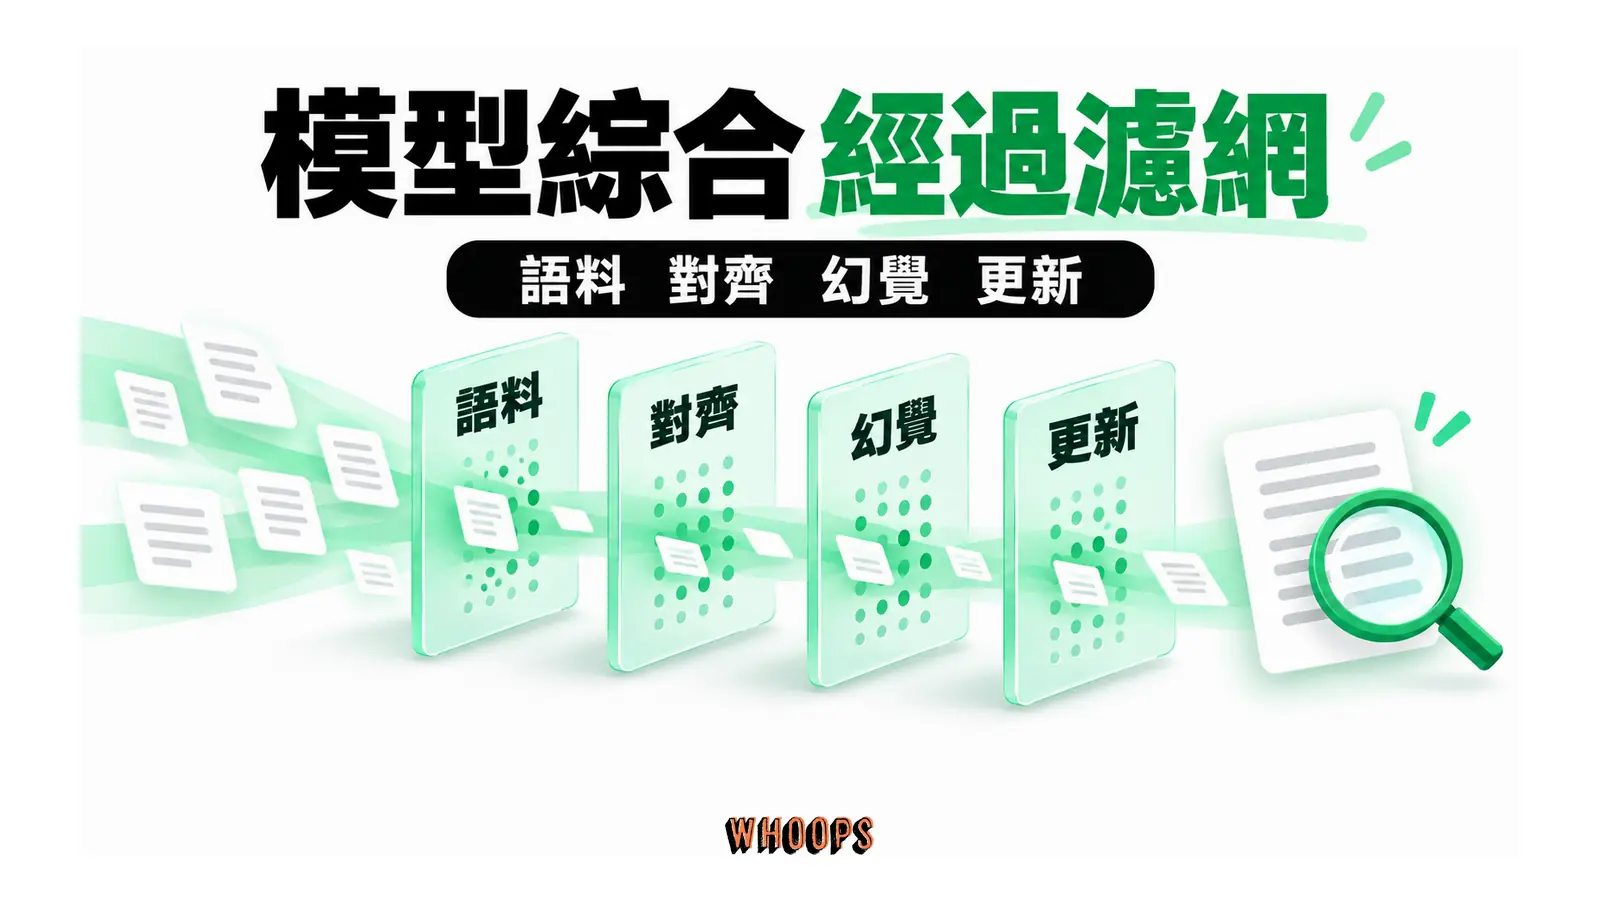
模型的輸出至少過四道自己的濾網。第一道是訓練語料的選擇:付費牆內的學術全文、企業內部的操作知識、沒有數位化的老師傅經驗,要麼不在語料裡,要麼權重稀薄,所謂全面,上限是語料收過什麼。第二道是後訓練的拉力:對齊過程獎勵主流、安全、共識的答案,這是平均正確的來源之一,綜合的結果天然偏向人多的一側,而非證據強的一側,而學術前沿常常長在人少的那一側,當年逆著共識走的論文,在模型眼裡與被淘汰的說法競爭同一個位置。第三道是幻覺與混淆:模型會生成不存在的引用、把兩個研究的結論縫成一個沒有人做過的發現,錯誤樣態與逐項查核的方法,站上的AI 幻覺查證指南有系統性整理。第四道是知識截止與更新落差:模型對世界的認識停在訓練那一刻,之後的修正、翻案、撤稿,要靠檢索與你去補。
以論文為基礎,仍要過安檢
以論文為基礎這半句,同樣要過安檢。學術文獻有自己的檔案櫃問題:得到顯著結果的研究比較容易被刊出,做出空結果的研究躺在抽屜裡,這層出版偏誤本身就是知識來源的一道濾網。單一研究與效應量、原始研究與重現結果,判斷它們的高下需要方法論素養,也就是另一種理解。以論文為基礎提高下限,這是真的;杜絕偽知識,是行銷語言,連職業研究者都會被模型的流暢摘要騙過,把轉述當成原文。查證的動作沒有捷徑,只有先後:模型給的是第一版線索,原文才是證據。
| 知識來源 | 它替你做了什麼 | 它容易漏掉什麼 | 穩健的對策 |
|---|---|---|---|
| 單一作者專書 | 整理好的框架與系統性論述 | 失敗案例、對立流派的論點 | 主題閱讀,跨立場對讀 |
| 模型的綜合 | 速度、廣度、即時的第一版 | 付費牆內容、非主流證據、可驗證的出處 | 出處逐一查核,交集才採用 |
| 第一手文件 | 原始數據與方法細節 | 脈絡與可讀性,閱讀成本高 | 關鍵主張的最終裁決層 |
跨濾網比對的三步流程
兩邊的濾網都攤開之後,穩健的結構反而清楚了:跨濾網比對。主題閱讀給你立場差異的地圖,模型給你快速的第一版綜合,第一手文件給你最終裁決,三者交集的地方才是可用的知識。你不需要讀完所有的書,也不需要放棄模型的綜合速度;需要留住的只有一件事:比對的判斷在你手上執行。因為它是理解複利的本金,把比對外包掉,等於把利息的來源整個讓渡。
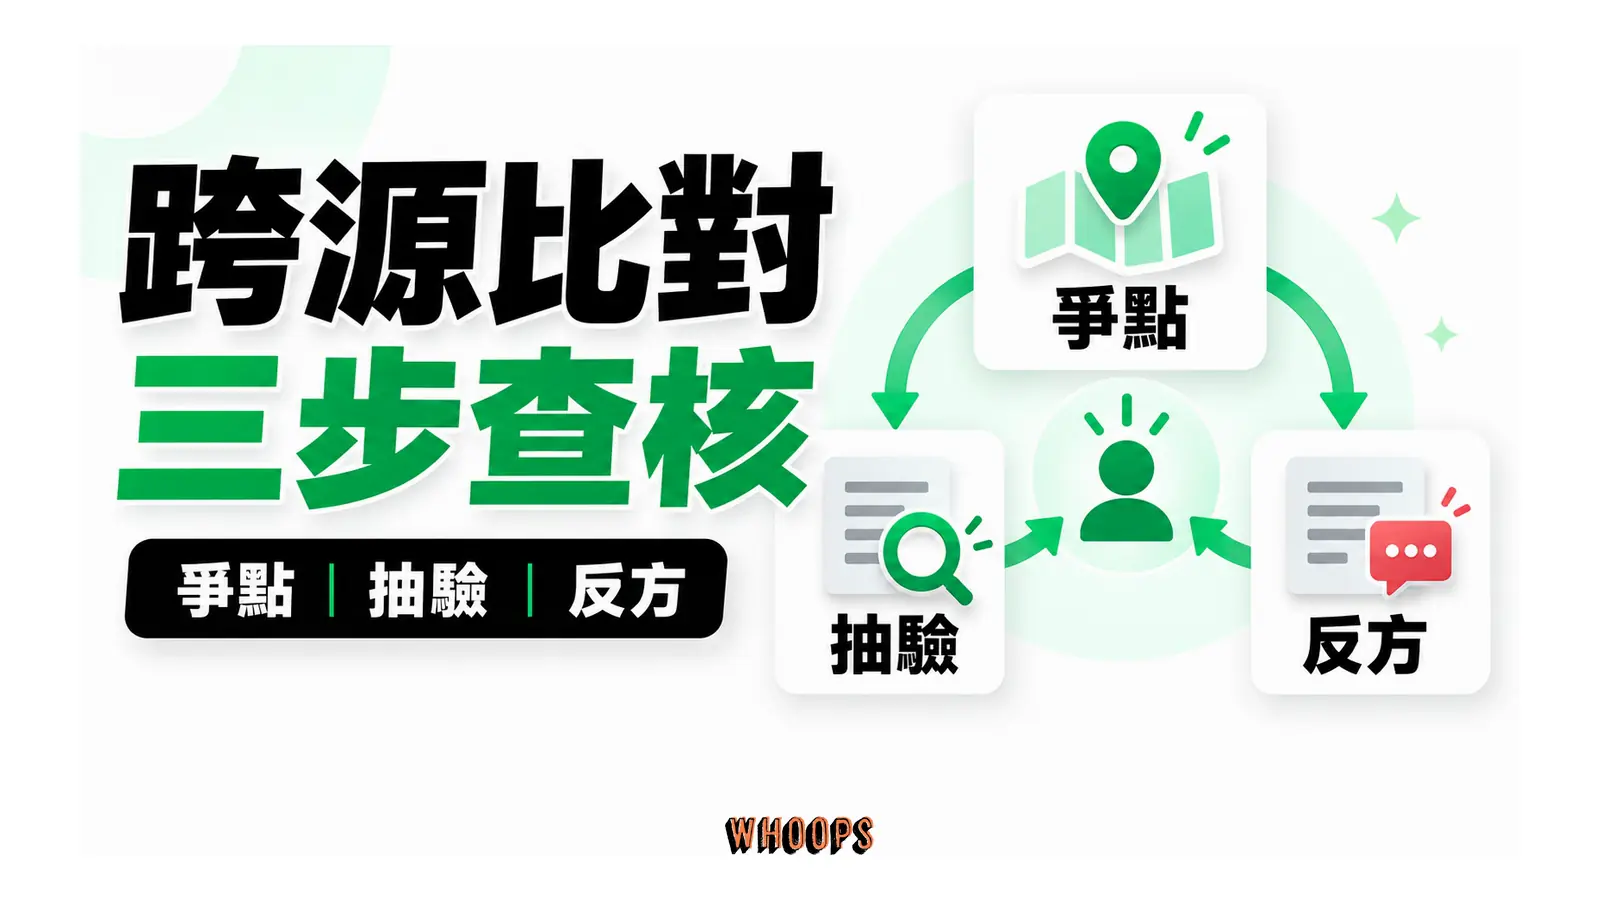
落成可操作的流程是三步。第一步,先問爭點,不問答案:讓模型列出這個議題上有哪些流派、各自的立場與主要批評,把它從答案機降級成地圖機。第二步,出處抽驗:模型給出的引用,挑兩三條回原文對照,看轉述是否忠實、日期與數字是否屬實;抽驗的失敗率會教會你,這個模型在這個領域需要多大的折扣。第三步,找一篇反方原文精讀:模型的主流綜合在哪個方向上壓平了分歧,反方原文會指出來,這正是你的比對判斷長出來的地方。三步做完,你對這個主題的理解,已經超過直接抄綜合答案的人一大截,而且這份理解會留下來。
理解的最小劑量:能驗收、能追問、能維修
說了這麼多代價,反向的澄清也要做足:這條思路要你付的理解成本,遠比「從 20 分讀到 95 分」少。理解有一個最小劑量,剛好夠你安全地使用工具、承接產出的程度。低於這個劑量,你拿到的每一份產出都是未爆彈,拆彈的不是你,是出事之後的你;達到這個劑量之後多付的部分,才是在買 80 分。劑量的概念把理解從懂不懂的二選一,變成可以計量、可以分配的投入,這是它實用的地方。
用行為檢核的三個訊號
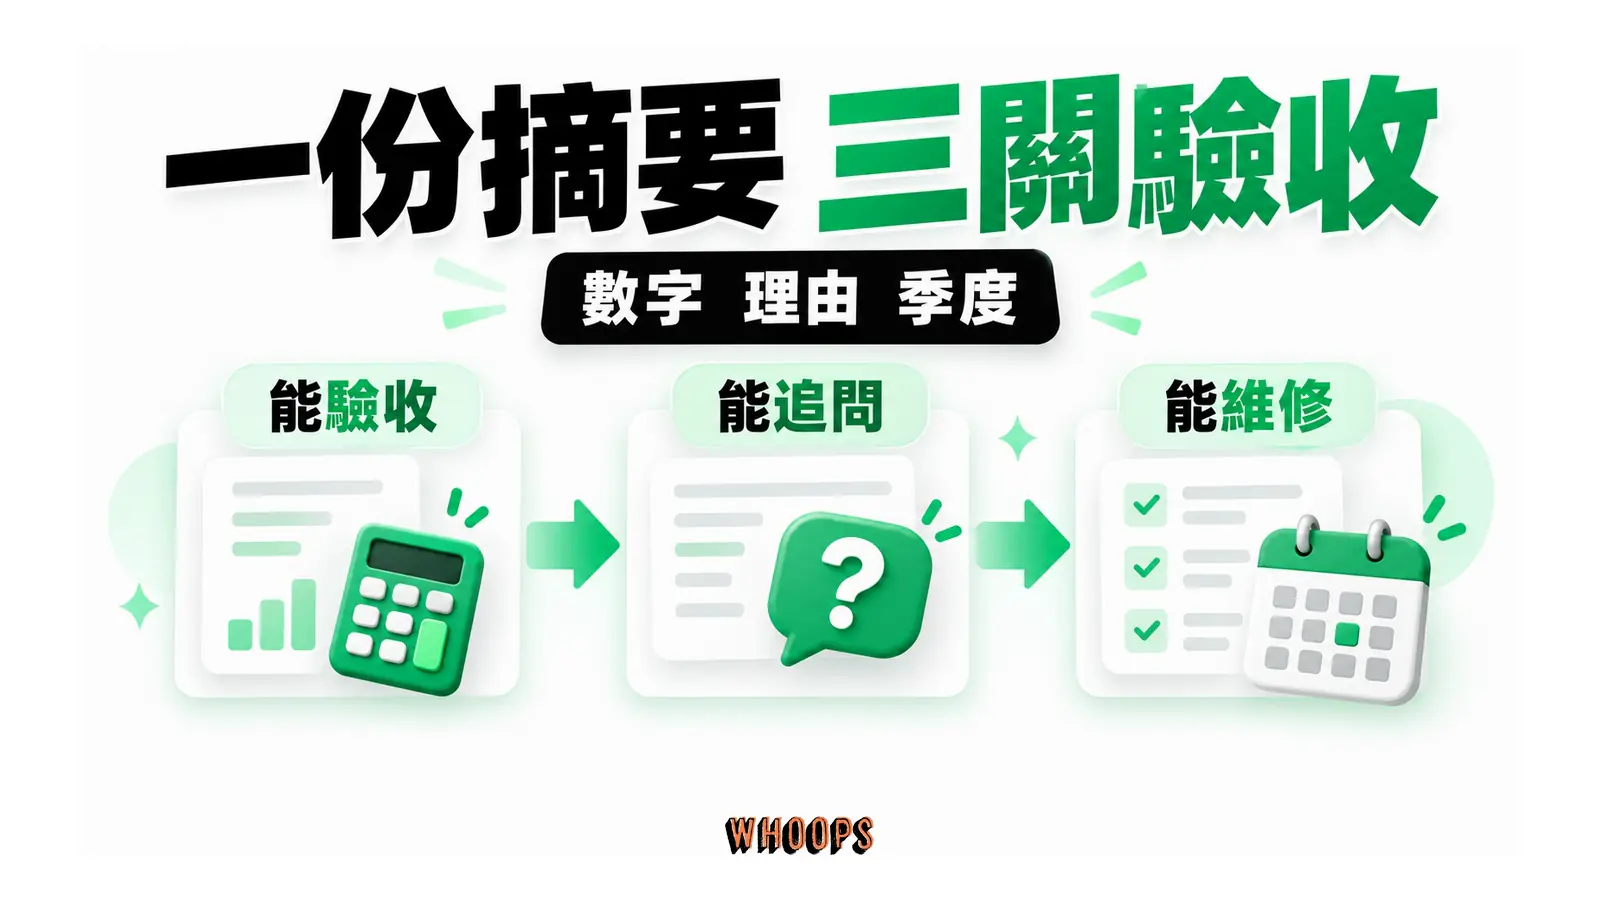
最小劑量有三個訊號,全部可以用行為檢核,不用自評。能驗收:拿到輸出後,你找得出至少一個問題,或者有把握說明為什麼找不到;完全挑不出毛病時,先懷疑自己沒看懂,再懷疑它真的沒錯,這個順序不能倒。能追問:主管或客戶問「為什麼這樣做、不那樣做」時,你答得出取捨的理由,答不出的部分就是劑量缺口,回去補那一段就好。能維修:情境變了、工具改版了、結果開始飄了,你知道去哪裡調、找誰問、怎麼驗證調整後有沒有效。三個訊號對應三種理解:領域的品味、決策的因果、系統的結構。
拿一個常見任務演練:你請模型摘要一份法說會紀錄,準備帶進明天的主管會議。能驗收的版本是,毛利率的換算你算得出來,成長率的基期你對得出來,數字一怪你會回頭翻原文。能追問的版本是,主管問「衰退的兩個驅動因子是什麼、哪一個是一次性」時,你答得出來,或者至少知道模型摘要裡哪一段不足以支撐回答。能維修的版本是,下一季模型抓錯季度、把去年基期當成今年,你會發現。三個訊號補的是同一件事:你知道自己不知道什麼。劑量檢查不過關的任務,模型做得再快,你都只是在轉發一封你沒讀過的信。
按領域分層支付劑量
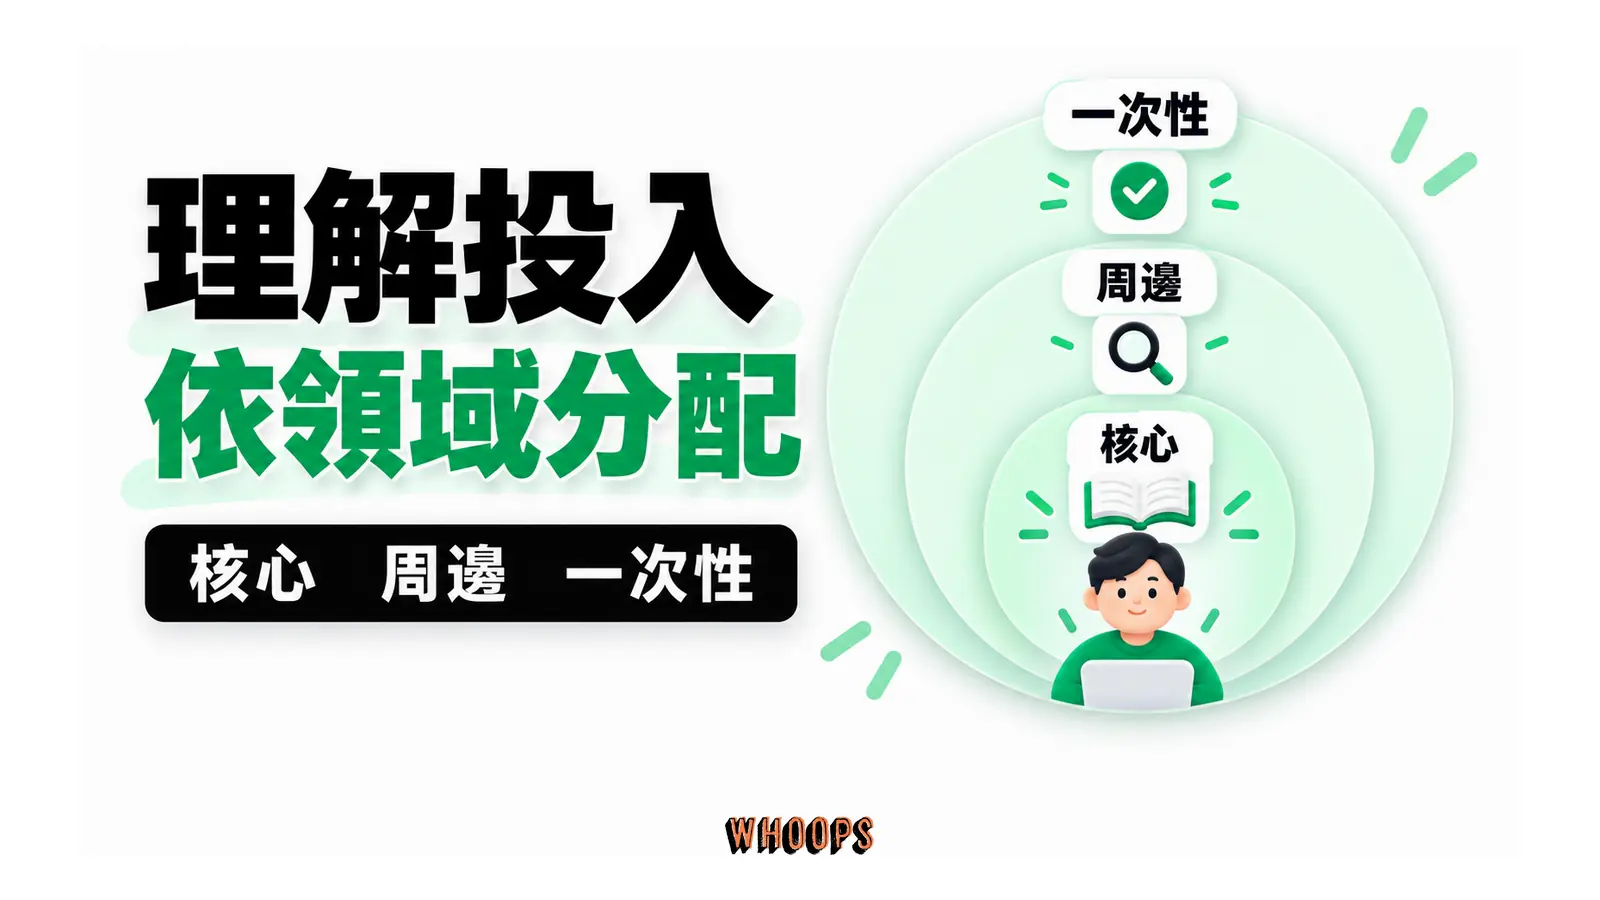
劑量還可以按領域分層支付。核心謀生領域付全額:該內化的概念、該建立的領域地圖,用自己的大腦完成,因為這裡的判斷品質直接決定你的行情,而且這是模型唯一拿不走的資產。周邊協作領域付驗收劑量:懂到能驗收、能溝通就夠,細節留給領域內的專家,你只要知道邊界在哪。一次性任務付抽查的成本:執行外包,成果抽驗,出錯的後果可承受就好。站上知識管理一文的三問檢核(會變成你的能力嗎、出錯時你看得出來嗎、三年後需要它長在身上嗎)是同一件事的另一種問法;劑量概念疊上去之後,答案從要不要用工具,變成這個領域該投多少理解。
維持劑量的兩個習慣
兩個低成本的習慣可以把劑量維持住。引述檢查:模型草稿裡每個關鍵主張,你都應該說得出出處,說不出的去查,查不到就刪;這一條同時是幻覺的防線。無工具重測:固定一項工作,一季一次不開任何工具重做,讓能力的水位自己現形;這一條防的是漂移,也就是能力悄悄滑落而產能報表毫無動靜的情況。兩個習慣一個防錯、一個防漂,加起來一季花不到半天,是整篇討論裡投報比最高的兩個動作。
打包知識的正確順序:先萃取判斷,再交給 Agent
流行路線圖的最終形態是四步:找到知識、結構化知識、打包成 Skill、交給 Agent 執行。這條路本身沒有問題,而且基礎建設已經到位:2025 年 10 月 Anthropic 為 Claude 推出 Agent Skills,官方公告把 Skill 定義為裝了指令、腳本與資源的資料夾,模型工作時掃描可用的 Skill、按需載入最小必要的內容,應用程式、開發工具與 API 三個介面通用。有問題的是路線圖沒畫出來的前提:結構化這一步,可以由不懂的人完成嗎?
結構化的實質,是知識萃取:把藏在經驗裡的判斷外化成可傳授、可執行的規則。站上的知識萃取方法整理過完整的工具箱,從事後回顧、關鍵事件自訪到放聲思考。萃取有個殘酷的特性:你萃取不出自己沒有的判斷。20 分的人去結構化一個領域,最好的情況是把 60 分的共識整理成清單,再包裝出 80 分的外觀;差的情況是把以訛傳訛做成流程圖,讓它以穩定的速度複製錯誤。真正的結構化,要麼來自你自己的實作判斷,要麼來自把專家的判斷系統性取出。兩者都貴,兩者都繞不過,這是路線圖上唯一不能加速的一步。
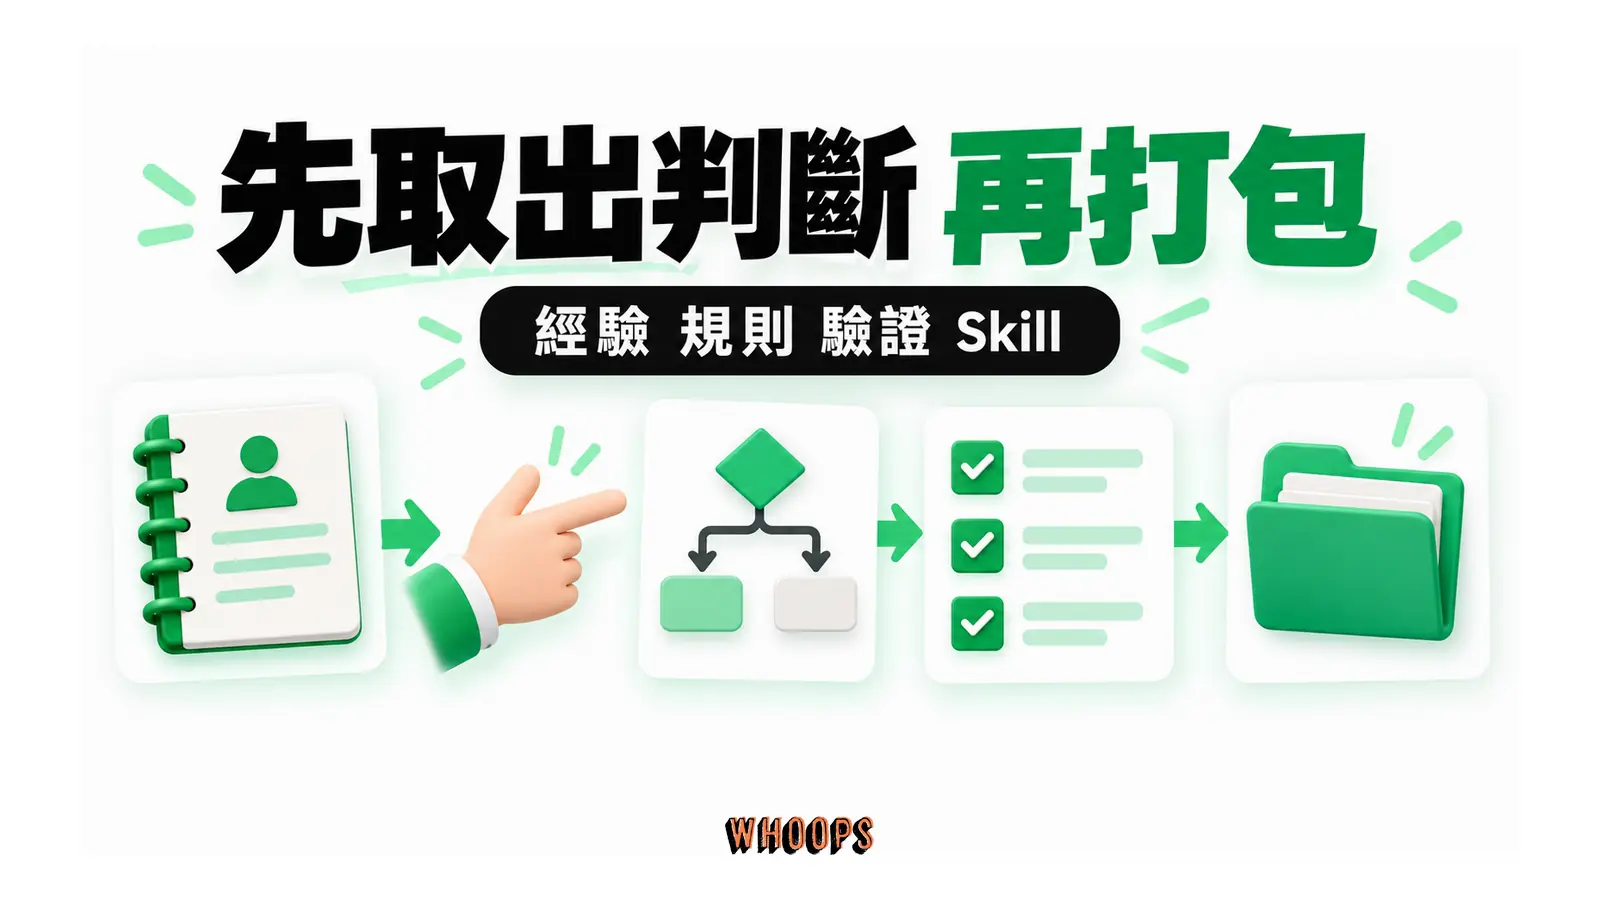
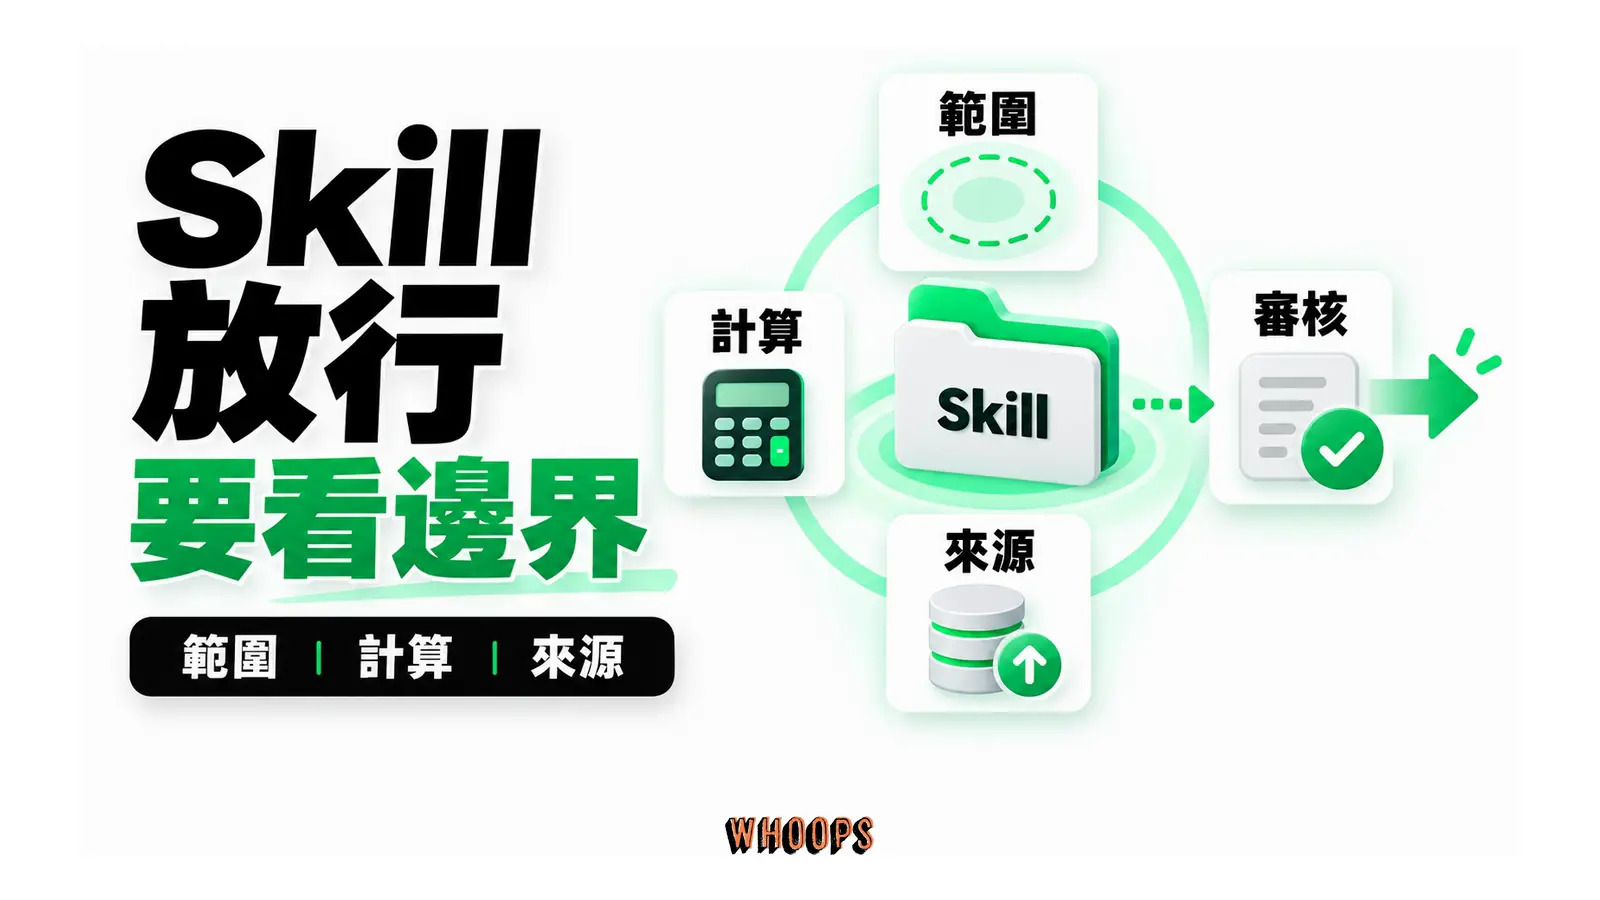
打包這一步的工程事實,反而站在謹慎這一邊。Claude Skills 指南拆過成敗的關鍵:一支 Skill 的生死常常取決於範圍收窄,判斷什麼放進去、什麼擋在外面,本身就是理解動作;讓 Skill 帶腳本,把模型不可靠的計算交給程式碼,也是同一種邊界判斷。官方公告裡還有一條值得抄進採購合約的提醒:Skill 會授予模型執行程式碼的權限,來源必須可信。換句話說,把知識打包給 Agent 的每一個工程決策,收窄、放行、信任邊界,都是理解的前線。跳過理解的打包,產出的是自動化的平庸,而且掛著 80 分的招牌,直到第一個邊界案例把它拆穿。
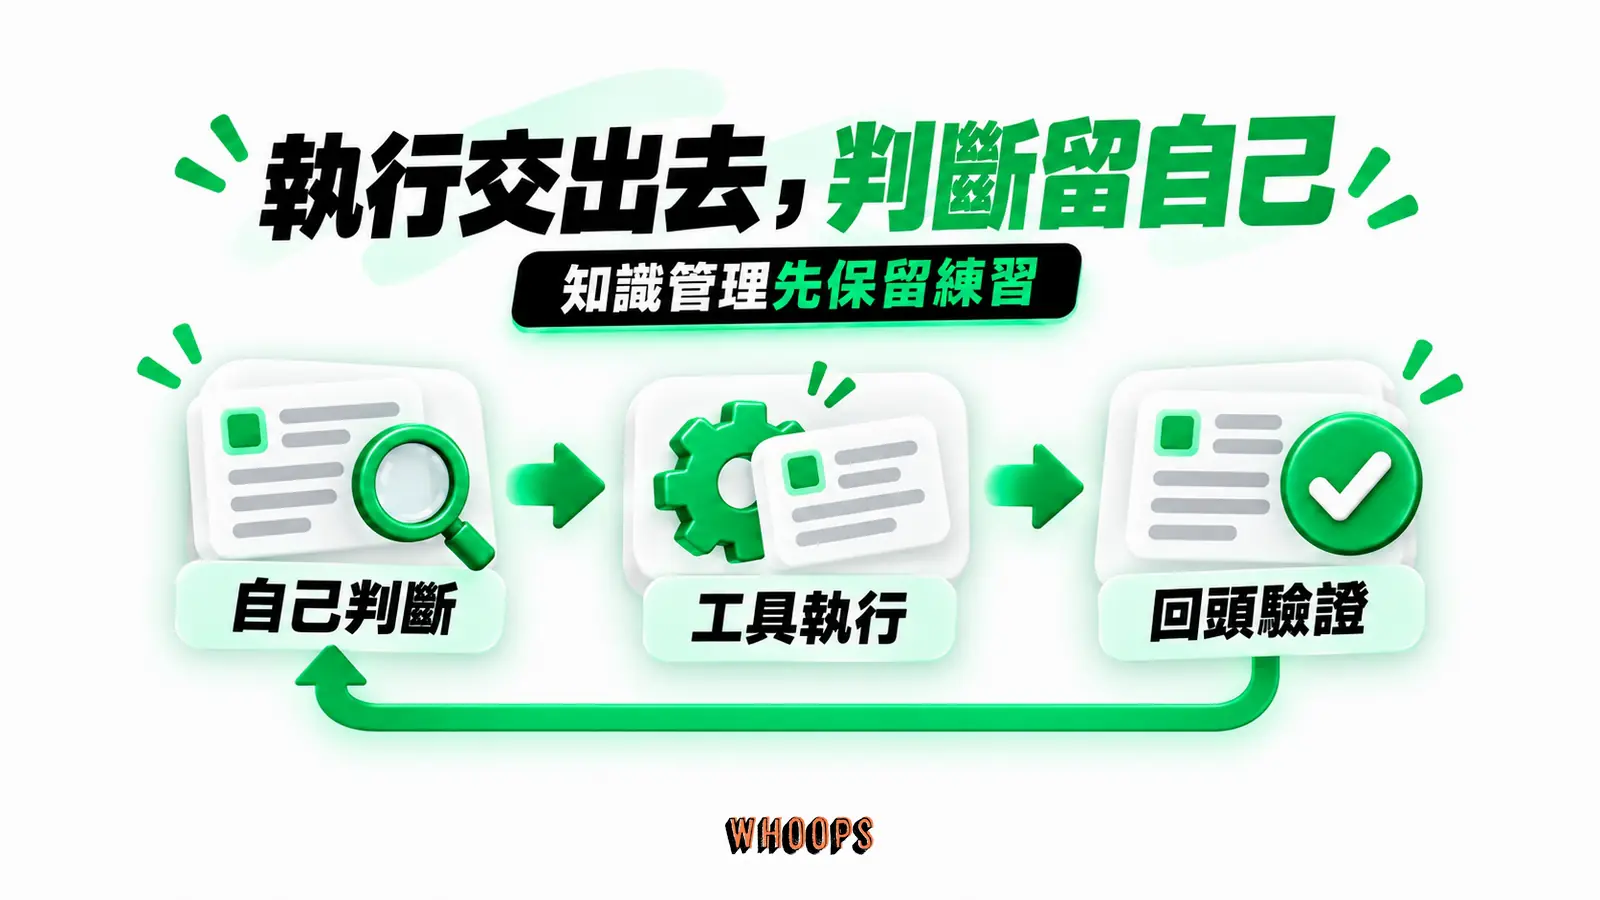
組織與個人側的落地,站上也有現成框架。一人公司的 AI 自動化把這件事講成一條軸:AI 放在草稿側,判斷側留給自己,一段工作該不該交出去,用任務性質、可驗收性、後果可承受性判讀。把本篇的劑量概念疊上去,順序就完整了:先確認理解到位,或者先把判斷萃取到手,再結構化,再打包,再交給 Agent 執行。每一步都可以用 AI 加速,沒有一步可以被 AI 代替做決定。路線圖沒有錯,錯的是把起點畫在知識,真正的起點是判斷。
分數要記在誰身上
回到標題的問題。AI 把人人拉到 60 分,拉的是有工具時的表現,分數記在人機系統的帳上,而且 PNAS 實驗裡使用無防護介面的那組,工具移除後的考試成績低於從未使用的人。跨過 80 分的人沒有變多,因為 80 分從來賣的是判斷,判斷的原料是理解,理解的原料是費力,這三個環節沒有一個因為執行變便宜而跟著降價。稀缺上移的預言兌現了一半:你知道什麼,確實不再值錢。另一半它沒有說出口:值錢的判斷力、品味與問對問題,恰恰是理解的高階產品。
所以真正的行動建議很短。執行成本的紅利,請領,這是這個時代給每個人的折價券。領了之後,把省下的時間投回理解複利的人,才會是讓 80 分變多的那群人;把省下的時間拿去再生產 60 分產出的人,則是在幫別人的 80 分打工。AI 不會替任何人跨過 60 到 80 的那一段,它只會放大你原本就在走的方向,往判斷走的人被放大判斷,往外包走的人被放大外包。分數終究要記在誰身上,這件事工具從來沒有決定權,決定權一直在簽帳單的那雙手上。