倖存者偏差:為什麼成功行銷案例會騙了你
倖存者偏差如何誤導行銷案例?從返航轟炸機、退場基金與成功個案,學會檢查分母。
- 倖存者偏差
- 選擇偏差
- 成功案例
- 樣本分母
- 行銷分析
約 28 分鐘閱讀作者:Whoops 編輯團隊
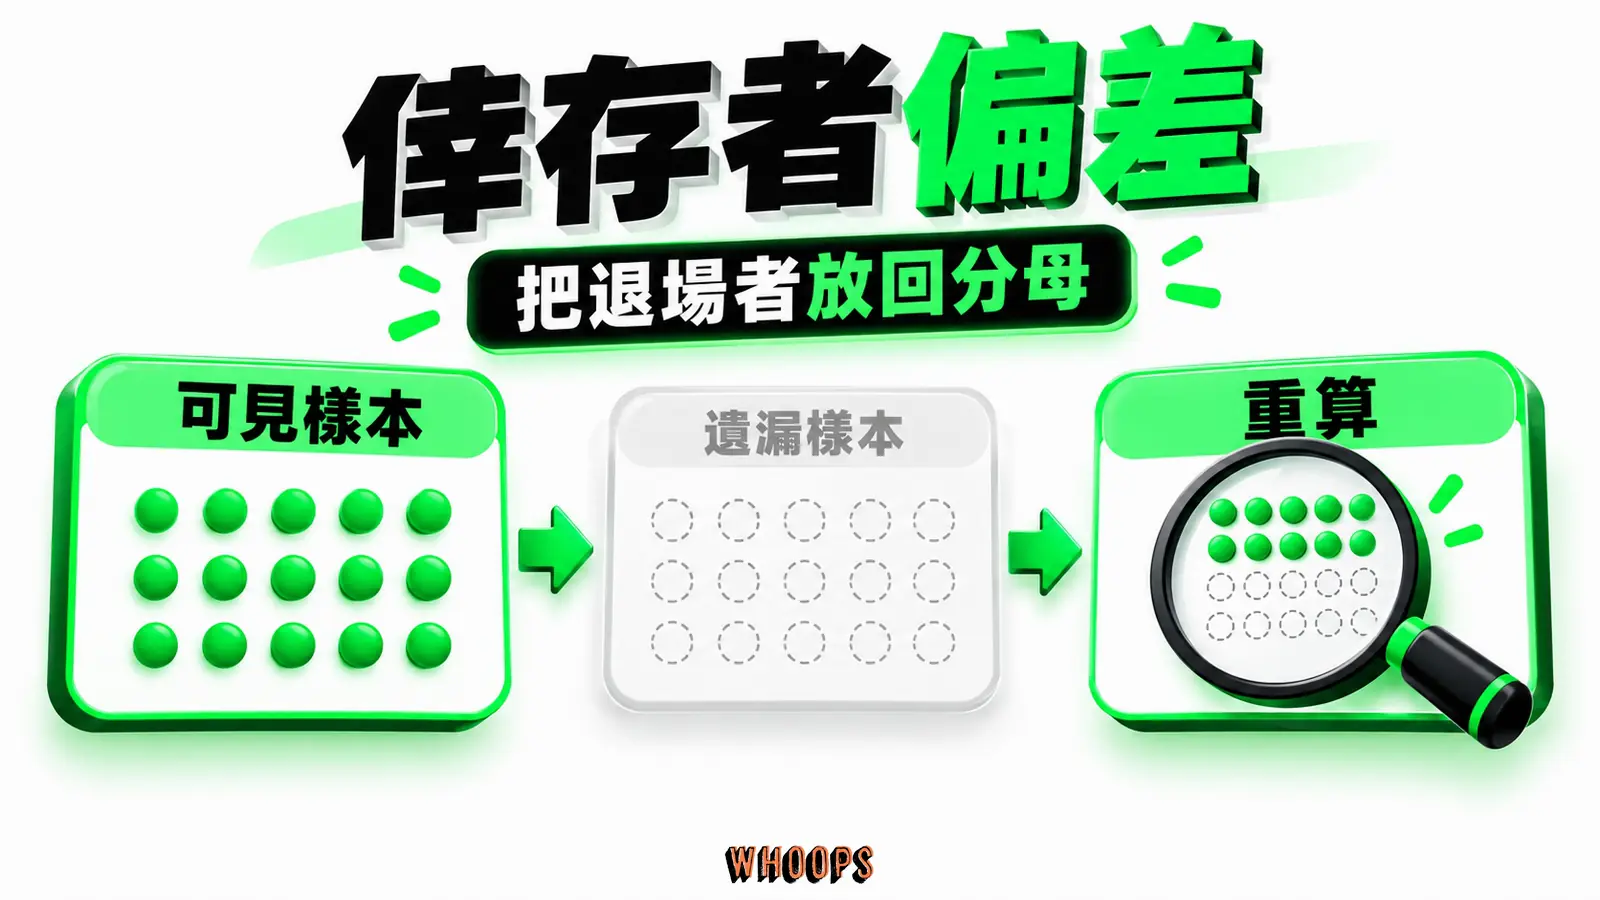
倖存者偏差(survivorship bias)是一種選擇偏差:你手上的樣本,已經先被「活著、還在場、被看見」這組條件篩過一輪,沒通過的案例容易被排除或較難觀察。用這種樣本去推論全部母體,結論往往會偏向表現較好的一側。成功行銷案例正是這種樣本:能寫進個案、站上講台、出現在推薦流裡的品牌,都先活過了一場少有人替失敗者記錄的淘汰賽。 實際判讀時,先問樣本原本包含誰、誰在觀察前退出、退出原因是否與成效有關;找不到退場者資料時,應把結論寫成可見樣本的描述,而非所有案例的平均結果。
這個偏差最有名的故事來自二戰:數學家 Abraham Wald(華爾德)盯著返航轟炸機的彈孔,建議軍方把裝甲加在彈孔最少的部位。流傳的版本只有一句翻轉,史料裡的版本卻厚得多,也更有用。它同時展示濾網怎麼讓判斷歪掉,以及怎麼把被濾掉的成員算回分母。這兩件事,正是行銷人引用成功案例之前最需要的能力。
重點先看
一、倖存者偏差的結構:樣本先被「存活且可見」的條件篩過,退場者不提供資料,推回母體時結構性偏樂觀。
二、華爾德故事的流傳版是後人壓縮:史料裡他交付的是用返航機的資料估計存活機率的整套方法,備忘錄 1943 年寫成後從未對外發表,1980 年才靠一箱舊紙重見天日。
三、行銷場景的三道濾網:成功案例是被挑出來的、平台給你看的是倖存者、退場者不再說話,三道都往同一個方向偏。
四、基金業實測:以 1976 年底的 361 檔基金為起點,追蹤其中 188 檔大基金到 1993 年。只看存活檔,等於每年多算 0.9069 個百分點的績效。
五、立刻能做的動作:引用任何成功案例前,先問分母是誰、濾網在哪、把退場者放回分母後結論還成立嗎。
你聽過的彈孔故事
流傳的版本這樣開場:1943 年,美軍轟炸機在德國防空砲火下損失慘重,軍方想找人算清楚怎麼止損,找上了哥倫比亞大學統計研究組(Statistical Research Group,SRG)那批被稱作奇才的學者。裝甲是選項之一,但裝甲很重,裝太多會明顯拖累飛機性能,所以空軍將領的問題是:該裝多少、裝在哪裡。
彈孔的分布有了答案:多數傷在機身,引擎一帶反而很少。軍方打算把裝甲加在彈孔最密的機身上。華爾德喊了停,該加強的是引擎。理由只有一句:你忘了受損最重的飛機根本沒有回來,你看不到它們。德軍砲火的命中想來不至於專挑地方,返航機上引擎的損傷數遠少於隨機分布該有的數量,這說明引擎才是弱點。流傳版收在這裡:建議被採納,這套判讀彈孔的技術後來又跟著打了兩場戰爭。
這個故事會紅,原因不神祕。它有一個乾淨的翻轉,內行人看到別人看不到的東西。它有一個方便遷移的道理,死者不說話,你聽到的全是活人的證詞。行銷人聽到這裡應該已經有感:成功案例就是彈孔圖,畫的是活下來那批人的傷口分布。
問題是,這個漂亮版本有多少是真的?把史料攤開之後,故事會變慢、變厚,也變得更能用。
史料裡的華爾德:八份備忘錄與一箱舊紙
八份從未發表的備忘錄
珍珠港事件把美國捲進二戰之後,哥倫比亞大學成立了 SRG,一批統計學家替軍方解決測量與決策問題。考據論文的開篇就從珍珠港事件四十週年寫起,作者點明,SRG 與反潛作戰研究組都因那場參戰而設,後者後來改名為作戰評估組(OEG),成為美國海軍分析中心(Center for Naval Analyses)的一部分。華爾德 1902 年生於當時奧匈帝國境內、今日羅馬尼亞的 Cluj,母語是匈牙利語,原在維也納做純數學,因為猶太身份失去奧地利的教職,赴美後在哥倫比亞大學任教,是 SRG 最早的成員之一。按美國數學會專欄的說法,SRG 聚集了一批人,其中有許多戰後統計學界最知名的人物,還有兩位後來獲得諾貝爾經濟學獎的經濟學家。專欄引一本近年著作對華爾德的形容是「房間裡最聰明的人」,隨即補了一句,那個房間裡聰明人一向不少。
飛機存活率的問題落到他手上,1943 年他交出八份備忘錄,編號從 SRG Memo 85 到 SRG Memo 126,合計超過一百頁。
這批文件後來的命運比內容更像故事。海軍分析中心 1980 年 7 月重印時的說明寫得明白:這項工作從未對外發表過,只有部分原始備忘錄的複本在流通,方法本身曾被用在韓戰與越戰的資料分析上。1984 年 6 月,Mangel 與 Samaniego 在《美國統計學會期刊》(Journal of the American Statistical Association)第 79 卷第 386 期,第 259 至 267 頁發表考據與重算,摘要的第一句就定位了整件事:華爾德使用取自倖存者的資料,估計飛機的脆弱度。論文頁面至今可查,一般讀者才算有機會看懂備忘錄在算什麼。
重印本身是場意外。SRG 於 1946 年關閉辦公室時,把一批鬆散文件留了下來。主持 SRG 的 W. Allen Wallis(瓦利斯)1980 年前後搬離羅徹斯特的住家,清出一箱 SRG 舊紙,交給海軍分析中心的 DePoy 處理,請他評估箱裡每一件東西值不值得留。DePoy 後來自述,他讀完全箱,判定多數不值得保存,留下的只有華爾德的一疊東西,略做編輯後以華爾德的名義在 1980 年 7 月重印成八份文件。美國數學會專欄作家 Casselman 對這段始末下了句評語:有紀錄的歷史,繫於幾條細線。備忘錄重印全文現在可以在網路上讀到。
華爾德實際算了什麼
考據論文轉述的作戰問題很樸素。返航飛機帶著彈孔回來,彈孔散在機翼、機尾、機身各處,指揮官要決定兩件事:用什麼戰術能提高存活率,加強哪些部位撐得住任務。加強等於增重,增重會拖累任務表現,所以資源有限。而決策的基本難處在於,指揮官不知道沒回來的那些飛機,彈孔長在哪裡。統計上的麻煩也一樣:被擊落飛機的資料無法觀測。考據論文說,如果這些缺損的資料拿得到,存活率可以用標準方法估,實際上拿不到,這是整個問題的起點。
華爾德的做法不是看圖說故事。他寫下一條基本方程式,把「返航機裡中了一彈、兩彈、三彈的比例」這些看得到的數字,與「每多中一彈還能撐住的機率」這些看不到的未知數連起來。推導用了一個假想實驗:假設敵人用的是不會擊落飛機的假彈,返航機身上的彈孔會呈現什麼分布。真彈與假彈兩個世界一對照,差額就是被擊落的那一部分。遞推的骨架可以白話講:挨了第一彈會倒下的數量,取決於出擊總數扣掉完全沒中彈的。挨了第二彈會倒下的數量,再從前一輪剩下的裡面扣。一彈一彈往回推,只要每一彈的殺傷機率估得出來,失蹤者的下落就能逐彈還原。美國數學會專欄對此的形容是,華爾德做的是魔術師的活,沒辦法讓死者開口,卻能從空氣裡抓出幾隻兔子。八份備忘錄裡,有五份在處理同一個問題:怎麼從只有返航者的資料裡,估計未返航飛機的損害。美國數學會專欄給它的定調是:這套方法的招牌,在於能估出從未返航的飛機身上的損害。
考據論文用一組示範數字重跑了整套計算。資料是編出來的假設任務,論文作者與華爾德本人都寫明了這一點,不是戰場實錄。任務出動 400 架,返航 380 架:沒中彈 320 架,中一彈 32 架,中兩彈 20 架,中三彈 4 架,中四彈 2 架,中五彈 2 架,未返航 20 架。在「每一彈的致死力道相同」的簡化假設下解方程式,得到單發命中後的存活機率是 0.851,反過來說每一彈擊落飛機的機率是 0.149。考慮抽樣誤差後,存活機率的 95% 信賴區間是 0.797 到 0.921,把標準拉到 99%,區間放寬成 0.782 到 0.947。
估出每一彈的殺傷力之後,考據論文再往下算每一彈數的擊落比例:第一彈擊落全體的 0.02980,第二彈 0.01344,第三彈 0.00399,第四彈 0.00190,第五彈 0.00087。考據論文兩位作者順手示範了這些數字怎麼用。他們點出,撐過 i 彈的存活機率,從一彈到兩彈下降 0.130,兩彈到三彈下降 0.204,三彈到四彈下降 0.235,越到後面掉得越快。面對這種數字,飛行員可以長出一條退場規則:撐過三彈可以再撐,挨了第四彈就該考慮脫離戰鬥。任務規劃者也能多一項估算派出規模的依據。這一類應用,已經跟流傳版那句「裝甲裝引擎」完全不同路。
華爾德自己的備忘錄裡有另一組假設數字:任務 400 架,返航 359 架,返航機身上的彈孔合計 202 個。兩組數字是兩份文件各自的示範例,算法相同,數值各自獨立,引用時要認清是哪一份。
引擎的彈孔為什麼少
部位分析是流傳版對應的史料核心。把飛機分成引擎、機身、油料系統與其他四個部位,每個部位占機身表面積的比例是量得出來的。考據論文的示範數字裡,引擎部位占表面積 0.269,彈孔卻只占全部 102 個彈孔裡的 0.186。引擎占的地方比它分到的彈孔多出一大截,這個落差指向一件事:引擎中彈的飛機較不容易返航,那些彈孔也較不容易進入返航資料。
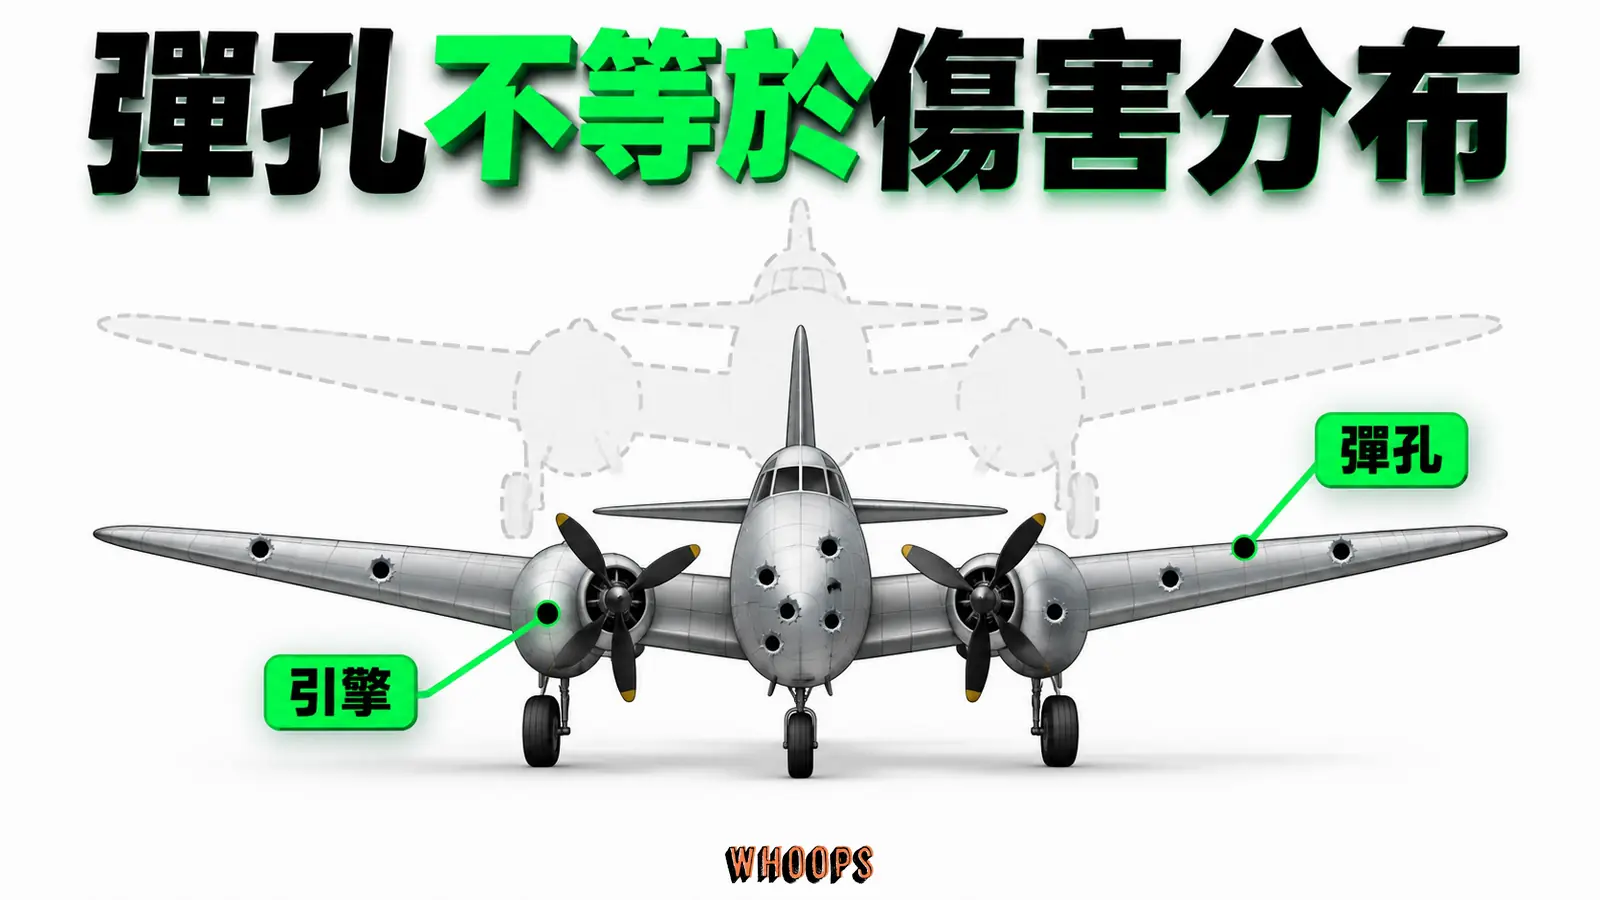
把比例代回去算,單發命中後的存活機率,全機平均 0.851,引擎只有 0.588,機身 0.940,油料系統 0.973,其他部位 0.939。考據論文的結論句寫的是:在這組數字下,飛機最脆弱的部位是引擎區。華爾德備忘錄那組數字的結構一樣,引擎部位被單發命中後遭擊落的機率是 0.39,全機平均只有 0.15。
「彈孔少的部位才致命」這個結論,第一手紀錄出自瓦利斯本人 1980 年刊在《美國統計學會期刊》的 SRG 回憶文,他在文末的回應裡寫道:軍方傾向保護返航機上彈孔最多的部位。華爾德依據堅實的理由假設,作戰中的命中均勻分布在機身表面。於是越脆弱的部位,彈孔越不可能出現在返航機上,因為打到脆弱部位的飛機越沒有機會回來提供資料。從這些前提出發,他設計出估計各部位脆弱度的方法。那個前提本身就是限制:均勻分布是假設,無法從返航資料直接量得。
還有一個細節值得記下。考據論文的摘要說這套方法用於二戰、韓戰與越戰,兩位作者在文末回應裡的說法卻保守得多:他們不知道二戰期間這套方法是否真的被採用,雖然備忘錄在戰爭夠早的階段就已經可用。他們確知的是,越戰期間海軍分析中心用它分析 A-4 攻擊機的存活率,分析導致了結構修改,改善了 A-4 的存活表現,萊特派特森空軍基地也用同樣方法研究 B-52 的改善。同一批作者,兩份文件,兩種說法,想引用這段歷史的人最好兩句都留著。
流傳版與史料版對照
把兩個版本放在同一張表上,差距一目了然。
| 面向 | 流傳版說法 | 史料記載 |
|---|---|---|
| 故事核心 | 華爾德一句話點醒軍方:彈孔少的地方才要裝甲 | 八份備忘錄建立估計存活機率的完整方法,部位結論是計算結果 |
| 證據存量 | 一句話翻轉,華爾德直接給出裝甲建議 | 瓦利斯回憶文兩處簡短提及,加上備忘錄本身,就這些 |
| 那些彈孔圖 | 網路上大量流傳畫滿彈孔的飛機圖,其中一處宣稱是華爾德的手繪圖 | 史料無法確認華爾德是否畫過手繪圖。網路配圖甚至出現二戰當運輸機用的 C-47 |
| 給軍方的建議 | 華爾德建議把裝甲裝在引擎 | 備忘錄裡沒有裝甲建議,SRG 的慣例是只回答被問的問題,決策留給軍方 |
| 示範數字 | 被當成真實戰損紀錄引用 | 備忘錄與考據論文都標明數字是假設的示範例 |
美國數學會的專欄把流傳版判定為「講得通的合理重構」:故事也許是真的,核心確有堅實的種子,但最精彩的那些橋段幾乎沒有證據。關於史料庫存,專欄講得直接:關於華爾德的飛機損害工作,我們有的是瓦利斯回憶文裡兩處簡短而含糊的提及,加上備忘錄本身,就這樣,其餘一切都該當成小說看。專欄同時提醒,網路上的彈孔配圖大量張冠李戴,滿篇都是畫滿彈孔的飛機,有的宣稱是華爾德本人的手稿,而沒有人知道他畫過任何圖,最離譜的配圖用的是 C-47,一款二戰主要擔任運輸的機種,鮮少真正投入戰鬥,專欄譏為配圖的標準似乎只有「有引擎、會飛」。專欄也補了另一面:少數網站播出美軍飛機被擊落的真實影片,那些畫面提醒讀者,在曼哈頓上城的安逸裡發展的抽象技術,最終押著什麼樣的賭注。同一個故事也進過專書:Ellenberg 2014 年由 Penguin 出版的《How Not to Be Wrong》以華爾德開場,該專欄稱它是較好的合理重構之一。
拆完故事,該留下的東西反而更清楚。方法本身經得起考據:參與討論的統計學家 Berger 評價,以當年統計學的技術水準看,這項工作很難被超越,華爾德光靠直覺的力道就摸到了那些細微的結構關係。考據論文的總結更重:這套處理是定論級的,在資料允許的範圍內,估計結果已經是夠大樣本下能做到的最好。神話是把一百頁數學壓成一句金句的代價,而那句金句裡真正可遷移的部分,是濾網的結構。
倖存者偏差的統計結構:條件於存活
從統計結構看,這是一個條件於存活的樣本:你手上的每一筆資料,都附帶「這個成員活著」的條件。返航機的彈孔統計,條件是飛機回來了。成功案例集,條件是品牌還在、案例被挑中、講者願意講。條件本身不會寫在資料裡,它藏在抽樣過程中,所以讀資料的人看不見自己在看一個被篩過的世界。
拿考據論文那組數字把結構走一遍,會看得更具體。400 架出擊,20 架未返航。已知的是架數,缺的是這 20 架各自的中彈資料。你問「中一彈的飛機有多少架」,資料只能回答「返航機裡有 32 架中一彈」,至於沒回來的 20 架各中了幾彈,永遠不知道。華爾德能往下走,靠的是假設把缺口補起來:如果每一彈的威力相同,返航機的彈數分布本身就藏著死亡率。假設對不對,決定結論對不對,這個解法能不能用,華爾德自己也寫明了前提。這是引用這類分析時最該抄的部分。
備忘錄還誠實標出了這種推論的天花板。考據論文把完全模型寫清楚:400 架觀測分到 11 格的多項分布。華爾德在文件裡明講,命中部位的比例與各部位的存活機率,沒辦法從同一份返航資料同時估出來,兩個未知數只有一組觀測。等致死度的簡化解,也只適用於事先就知道每一彈威力相同的情境,他把這句警告寫進了原文。考據論文文末的回應另補了一個華爾德沒考慮的因素:機組員。二戰期間的研究顯示,已經撐過三次任務的機組,後續存活率明顯更高,飛機的脆弱度因此不是唯一的變數。把倖存者樣本推回母體,永遠要靠假設,而假設要攤開來受檢。
把同樣的結構搬到行銷,讀法就出來了。沒回來的 20 架,對應看不到的退場者。部位彈孔占比與面積占比的落差,對應案例中某種做法的出現頻率與它在全體中的真實占比。市面上的個案合集是返航機,每個案例身上的「彈孔」是它願意公開的戰術與數字。下架的商品、停更的頻道、收掉的店,是沒回來的那批,它們的彈孔分布永遠缺席。行銷決策的基本難處,跟 1943 年那個指揮官一模一樣:你不知道沒回來的長什麼樣,而你的供應商、你的講座、你的資料來源,都沒有義務替你把那 20 架找回來。
這個偏差跟數字判斷的偏差是鄰居,但方向不同。錨定效應講的是錨點牽動數字判斷。倖存者偏差講的是分母被藏起來,連哪些數字該納入判斷都不清楚。前者作用在可見數字的參考點,後者作用在可見樣本的組成。
第一道濾網:成功案例是被挑出來的
把倖存者濾網放到行銷場景對應,至少有三道,而且都往樂觀的方向偏。第一道在案例誕生之前就開始作用。個案研究有入選條件,得獎記錄有評審門檻,講座與課程也只會留下被挑中的現身說法。這幾道關卡疊下來,能見光的案例同時具備三種身分:活著的成功者、願意分享的成功者、被別人認為值得宣傳的成功者。被淘汰的連成為案例的資格都沒有。你翻開行銷成功案例集,看到的是通過篩選的那批,書裡若沒交代篩選條件,讀者就看不出這批案例是怎麼形成的。
這件事在組織研究裡有正式的處理。Denrell 2003 年在《組織科學》(Organization Science)第 14 卷第 3 期,第 227 至 243 頁發表的論文指出,觀察者向其他組織學習時,可得的組織樣本可能有偏,也可能對失敗抽樣不足。按論文的講法,任一時刻看得見的組織,都是某個篩選過程的倖存者。他的推演顯示,在這種樣本裡,不可靠、無根據、高風險的集中式做法,看起來會比可靠、有根據、分散的做法更有效,即便那些做法與全體母體的績效沒有關聯。長出來的證據會有說服力,卻可能誤導,而且不需要任何人說謊。
母體的規模可以用官方統計校準。美國勞工統計局《每月勞動評論》(Monthly Labor Review)引用該局資料寫道,新設立的事業單位有 20% 撐不過第一年,32% 撐不過前兩年,50% 撐不過前五年。勞動統計局的這組數字的用途在於提醒分母:若以前五年來看,每一位站上講台分享成功經驗的經營者背後,大約有一位同行沒有撐過。
從這組條件判讀,會得出比「成功案例都不可信」有用的結論。案例裡的戰術描述可以真、數字可以真、因果可以真,同時整份案例集仍然是偏的,因為試了同一套戰術而退場的人,不在合集裡。要估「這套做法的成功率」,案例集幫不上忙。要學「這套做法的內容」,案例仍然可用,只要你知道自己拿到的是什麼。消費心理學處理購買當下的判斷,說服心理學處理訊號已可見時的說服工具。倖存者濾網發生在更上游,在你決定要看誰之前,樣本已經被篩過了。
第二道濾網:平台給你看的都是倖存者
第二道濾網是平台的力量。熱門榜、推薦流與演算法精選呈現的,是仍在場且被推薦的帳號與內容。一個頻道出現在你的首頁之前,先通過了存活篩選,再通過了可見性篩選。你在平台上研究「現在什麼內容有效」,拿到的是雙重篩選後的樣本,而演算法不會展示安靜退場的那批人後來去了哪裡。
研究「爆紅案例的共同點」時,你比對的是通過可見性篩選的內容,未爆紅或已退場的內容不在樣本裡。想找反例也難,沒爆紅的內容沒有被誰藏起來,只是被推不進你的視野,等於一座你想抽樣卻走不進去的圖書館。鐵粉經濟的數學處理過創作者收入的調查資料,任何「平台創作者平均收入」的說法,先要看退場的創作者有沒有被算進分母,因為離開的人不會出現在平台的活躍統計裡。
成長故事的敘事風險也在這裡。飛輪效應式的越推越順論述,前提是輪子一直在轉。分享飛輪經驗的每一個人,都是輪子還在轉的那批,停轉的飛輪沒有講者。聽完飛輪故事該問的問題,跟看彈孔圖該問的一樣:這張圖是誰畫的,誰沒有被畫進去。
第三道濾網:退場者不說話
第三道濾網最安靜。商品下架之後,頁面連同銷量一起消失。頻道停更之後,不再有新的內容發聲。公司倒閉之後,官網與原本的資料也會跟著退場。退場者連反駁的介面都沒有了,資料跟著人一起退場。口碑與評論也可能經過自我選擇:口碑行銷仰賴顧客自願發言,但主動留下評語的人未必代表全體顧客;滿意、不滿或體驗特別強烈的人都可能更有動機發言,沉默顧客的感受則不會直接出現在評論樣本裡。這個偏差有多大,共同基金業留下過一次乾淨的實測。Elton、Gruber 與 Blake 以 1976 年底名錄中的 361 檔普通股基金為起點,追蹤其中的大基金到 1993 年 12 月,論文 1996 年 10 月刊於《財務研究評論》(Review of Financial Studies)第 9 卷第 4 期,第 1097 至 1120 頁。論文全文在紐約大學的檔案庫可以讀到。
把消失的基金找回來
消失的基金去哪了,是整個研究的關鍵。論文摘要開頭就寫明因果的方向:基金之所以消失,論文給的原因指向表現太差。緒言再補了第二個理由,規模小到管理階層認為不值得維持,而這個理由也與績效差有關。消失的基金以合併收場的居多,部分會併入同一家族的其他基金,合併之後,管理機構仍能收取費用,原基金的差勁紀錄則從多數紙本與電子資料來源裡消失。論文對這個現象的描述是:從 Wiesenberger 年鑑這類名錄抽樣,會拿到「編製當時還存在」的基金的完整報酬史,但對期間內消失的基金一無所知,而多數經典的基金績效研究正是這樣抽樣的。作者把方法命名為「跟著錢走」(follow the money):投資人的錢被併到哪裡,報酬就追到哪裡,併入條款逐一換算,併入之後繼續追蹤承受基金的表現,全樣本的績效才追得出來。
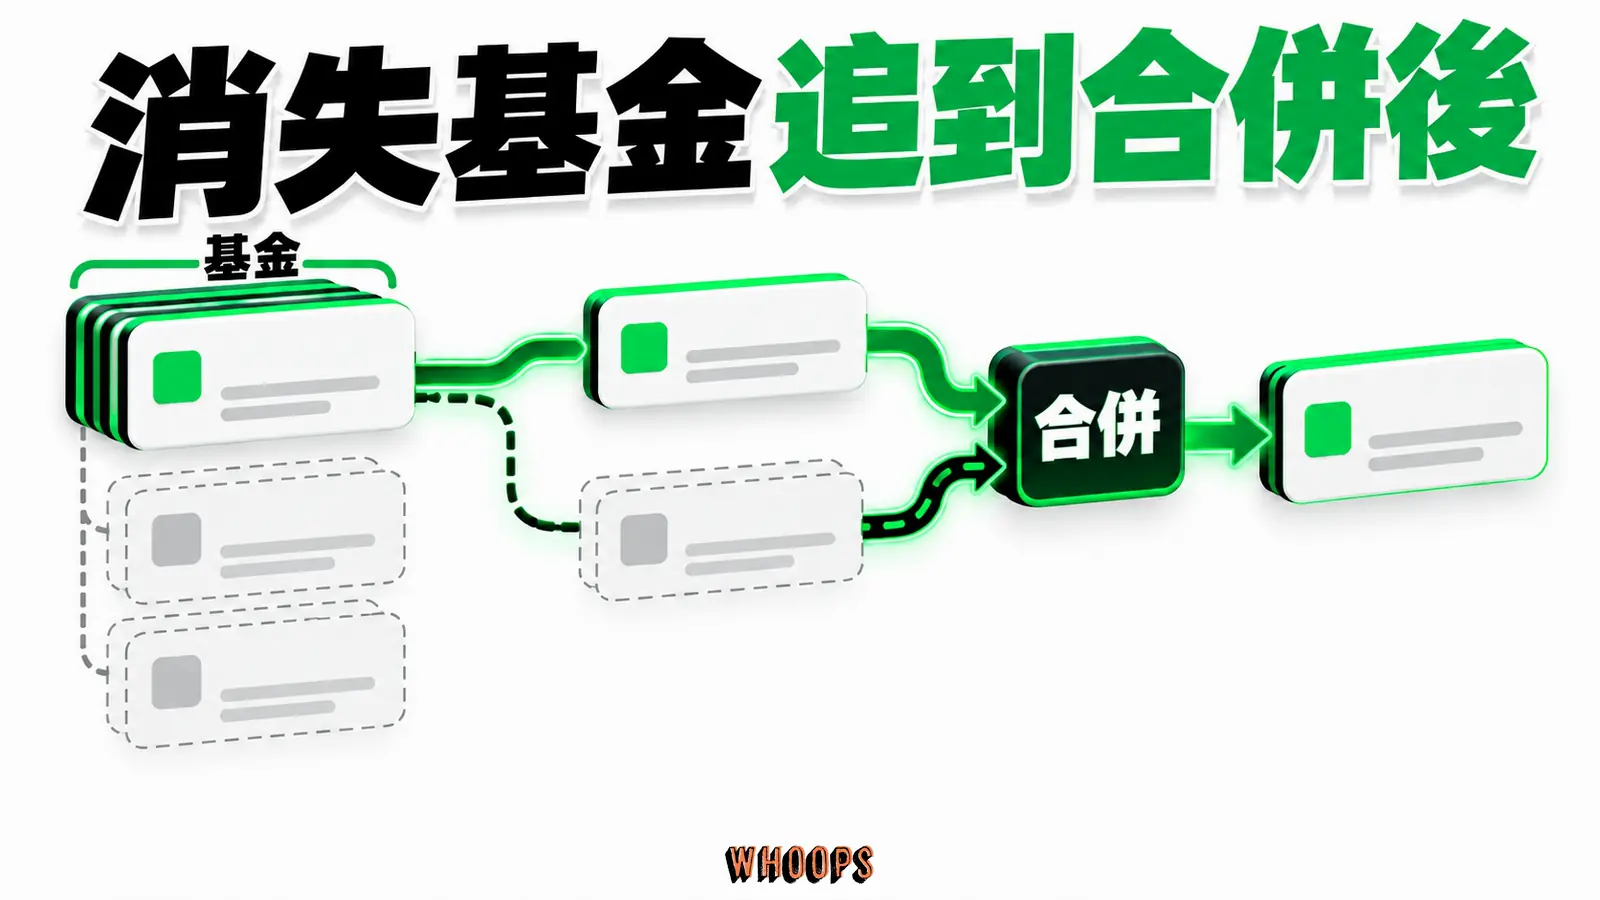
帳目從大檔看起。361 檔按規模分成兩組:1,500 萬美元以上的 207 檔,以及不到 1,500 萬美元的 154 檔;逐檔追蹤的是大基金那組。小檔的報酬很難追,基金不再列入名錄之後,極小基金甚至可能無法取得後續報酬,所以報酬計算用大檔,淘汰比例的推算用全體名錄。大檔中有 19 檔屬於不對一般大眾開放的受限基金而剔除。其餘 188 檔中,13 檔曾從名錄上無聲消失,作者逐一追查,12 檔其實被併了,1 檔只是改名。最終帳目是 42 檔被併、146 檔活到 1993 年底。全樣本的帳目要再推一層:小檔裡同樣有 20 檔受限基金剔除,其餘 134 檔中,30 檔查到被併、67 檔還在,還有 37 檔從名錄上消失後去向不明。作者把大基金那組「12 檔被併、1 檔改名」的追查結果,按 12 比 1 分給這 37 檔,推估全樣本被併約 106 檔、存活約 216 檔,小檔被併的比例推得比大檔高。一個「基金平均績效」的數字要用哪一邊當分母,這份帳目就是答案。
偏差有多大
數字出來之後,偏差不再是修辭。被併的基金從成立到合併為止的超額報酬(alpha),平均每年是負 2.8779 個百分點。全樣本 32.97% 被併、67.03% 存活,加權之後全樣本的超額報酬是每年負 1.0338 個百分點,而只看存活檔會得到高出全樣本每年 0.9069 個百分點的成績。換另一個存活定義重算,估計值是每年 0.734 個百分點。不到一個百分點,聽起來不大,但這是該研究用兩種存活定義重算都得到的正向高估。論文對偏差的定義寫得很乾淨:存活檔與全樣本的報酬差,就是倖存者偏差。
同篇論文整理的先前估計,畫出了這個偏差的區間:債券基金約每年 27 個基點(basis point,1 個基點等於 0.01 個百分點),股票基金的估計從每年 10 至 30 個基點、20 至 80 個基點到 150 個基點都有,還有研究估被併與未併兩組的超額報酬差達每年 3% 到 5%,取決於各家怎麼定義存活、用原始報酬還是風險調整後的報酬。方法不同,數字不同,結論一致:只拿當期還存在的基金抽樣,基金績效會被高估。
三道濾網可以收成同一張檢查表。
| 濾網 | 誰被濾掉 | 引用前該做的動作 |
|---|---|---|
| 案例挑選 | 試過同樣做法但退場的品牌與專案 | 問案例怎麼被選中,找同批起步的全體名單 |
| 平台可見性 | 停止更新或未被推薦的帳號 | 把「現在還看得到」與「當時存在過」分開清點 |
| 退場沉默 | 下架商品、收掉的店與被併的基金 | 追蹤退場者後來的數字,放回分母重算 |
你讀的研究也有檔案櫃
行銷人引用的不只案例,還有「研究顯示」。研究這一行有自己的倖存者濾網。當時任職於哈佛大學的 Rosenthal,1979 年在《心理學通報》(Psychological Bulletin)第 86 卷第 3 期,第 638 至 641 頁把它命名為檔案櫃問題(file drawer problem)。論文記錄裡的極端版本是:期刊登滿了那 5% 碰巧顯著的結果,實驗室後頭的檔案櫃塞滿了其餘 95% 不顯著的研究。你引用顯著結果時,仍要檢查它是否通過了「夠漂亮才刊得出」這道篩選,這道篩選在研究方法學裡的正式名字是出版偏誤(publication bias)。
要藏多少篇才能翻盤
Rosenthal 給了一個可以算的檢驗法,後來叫 fail-safe N:算出「還要多少篇平均零效果的研究塞在檔案櫃裡,才會把眼前的整體結論壓回 p=.05 邊緣之外」。這個數字越大,結論越摔不死,Rosenthal 給它的名字是「對零結果的容忍度」。他的示範算例給了直覺:1969 年一篇整合了 94 個實驗的回顧,需要 3,263 篇零效果研究才能翻盤。1976 年另一篇整理 311 個研究的回顧,需要 49,457 篇,接近五萬篇。這類結論面對檔案櫃問題時較不容易被少量零效果研究翻盤。
反面更該記。Rosenthal 提醒,小樣本又只是勉強顯著的整體結果,幾篇沒發表的研究就夠翻盤:15 篇平均 Z 值為 0.50 的研究,合併起來的顯著水準是 0.026,只要檔案櫃裡再藏 6 篇平均零效果的研究,顯著就變不顯著。行銷文案裡「研究顯示」四個字後面,如果只站著少數幾個研究,這個數字就是你該有的警覺規模。看研究時先問自己:要藏幾篇,這個結論就會倒。答不出來,就先保留結論。這種監看自己判斷過程的能力,正是元認知的用武之地。
引用前的三問
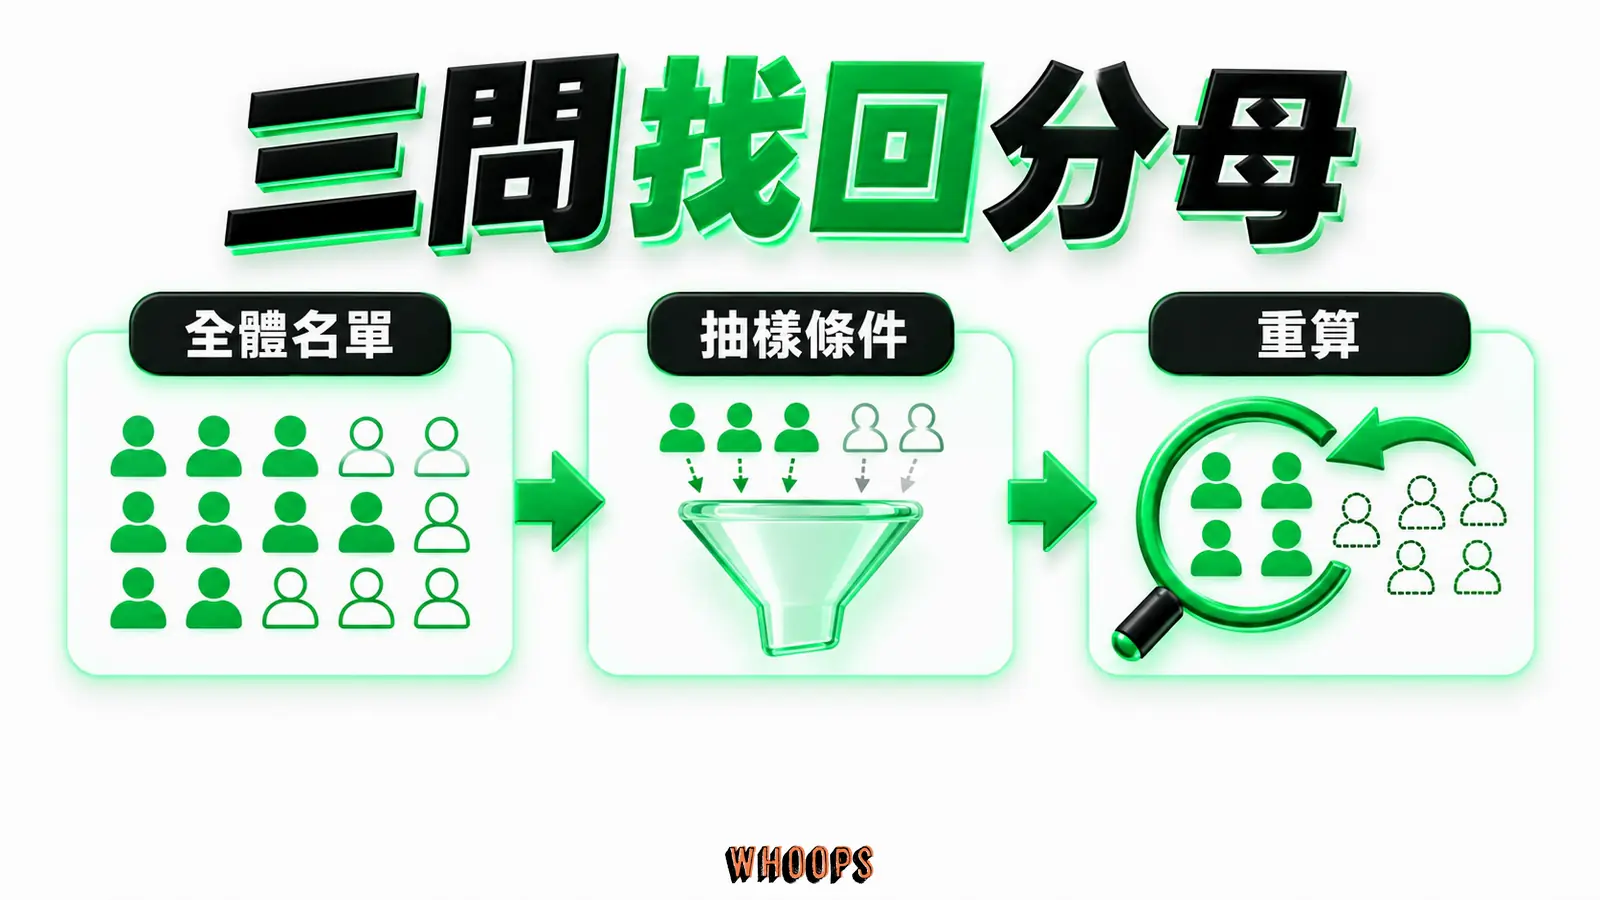
把案例、數字與研究收斂成一套可以帶著走的檢查法:引用任何成功證據之前,依序問三個問題。
第一問:分母是誰
案例簡報上那個漂亮的成功率是除出來的,除法需要分母。問分母,就是問誰有資格進樣本:同期出發的所有品牌、註冊過的全部帳號、發行過的每檔基金,還是只剩還活著的那批。基金研究的高估從名錄開始:名錄只列當期存在的基金,於是拿名錄算出來的平均績效,天生只含存活者。行銷的高估也從名單開始:案例宣稱訪談了一批成功品牌,就要追問這批品牌是從多大的池子裡挑出來的,被省略的就是分母。同樣的問題也適用於自己的報表,先確認名單怎麼形成、哪些人不會進入資料,再畫出分母的邊界。
第二問:濾網在哪
分母正確還不夠,要問是什麼條件決定你看得到誰。案例有入選機制,平台有推薦機制,研究是否發表可能受顯著性篩選,退場有沉默機制。把濾網講清楚,等於把資料的適用範圍講清楚。講不出濾網的證據,只能當故事聽,當勵志可以,當決策依據不行。實務上最快的檢驗,是直接問對方三個小問題:樣本怎麼來的、期間多長、有沒有被剔除的成員。三個小問題答得出來,資料的來源就清楚了。
第三問:退場者放回去,結論還在嗎
第三問最費工,也最值錢:把消失的那批找回來,放回分母重算,結論撐不撐得住。基金業的答案是,存活檔的成績每年高出全樣本 0.9069 個百分點。華爾德的整套方法,本質上就是在做這件事,用假想實驗把沒回來的飛機算回來。對應到行銷實務,動作有三個:找全體名單或註冊資料當分母,向證據提供者要抽樣條件與期間,自己做一次含退場者的重算。做不到完整重算,至少把「這個數字不含退場者」標在結論旁邊。
三問之外還有一個加分的觀察點:證據提供者敢不敢承擔透明的成本。昂貴訊號理論檢驗的是訊息發送者敢不敢付出代價。從這個角度判讀,敢公開完整樣本與失敗紀錄,本身可視為一種成本訊號。只給成功者名單的,則沒有交代濾網條件。
邊界:倖存者偏差不等於全是假的
知道倖存者偏差之後,有兩個過頭的反應要避免。一個是照單全收,看什麼成功故事都信。另一個是全盤否定,拿偏差當萬用反駁,凡是自己不同意的結論都推給偏差。濾網偏掉的是樣本的方向,不會把案例裡的每個動作變成謊言。通過篩選的經營者,他分享的交易價值判斷、受眾觀察與流程設計仍然可能是真的、可學的。該修正的是你對「這套做法的成功率」的估計,而非「這套做法的內容」的真偽。
華爾德自己的工作也標出了修正的天花板。把倖存者樣本推回母體要靠假設:命中均勻分布、每一彈等致死,都是為了讓方程式可解而設,他自己就寫明了解的適用前提。部位占比與部位存活率無法從同一份資料同時估出,機組員的經驗還會再攪動一遍。對應到行銷,任何「把退場者算回來」的重算也有自己的假設,退場的原因很多,每一條假設都要亮出來受檢,跟彈孔圖一樣。檢驗倖存者偏差要養成的習慣,是知道自己正在看哪一層樣本,以及這一層樣本回答得了什麼、回答不了什麼,不必因此懷疑一切。
這些後續,華爾德本人沒能看到。他在 1950 年的一場空難中,於印度南部的山區離世,生前沒有機會寫下自己的版本。他的方法後來仍被用於飛機存活率分析,他的故事則被壓成一句金句四處流傳。對行銷人來說,這兩件事是同一堂課:資料會活下去,神話也會,而你要引用的是前者。
下一步
從手邊一份你準備引用的成功案例開始,做一次三問體檢:查出它的分母,找出它的濾網,把找得到的退場者放回分母重算一次結論。算完之後你會得到兩樣東西:一個修正過的預期,以及下一次聽到「研究顯示」與「某某品牌就是這樣做起來的」時,本能浮現的那三個問題。養成這個習慣之後,成功案例並沒有變得不能讀,它只是回到正確的位階,故事歸故事,分母歸分母。