SLM 部署實戰:小模型怎麼幫 AI Agent 省成本
SLM 部署實戰指南,拆解 AI Agent 的模型呼叫成本結構,整理路由分類、工具參數抽取、摘要壓縮與投機解碼四個可放小型語言模型的位置,比較 Ollama、llama.cpp 與 vLLM 三條本地部署路線的量化、上下文與並發配置,並附雲端牌價換算與上線前的檢查清單。
- SLM 部署
- 小型語言模型
- AI Agent 成本
- SLM Agent
- Ollama
- llama.cpp
- vLLM
- 投機解碼
- 模型路由
- LLM 級聯
- GGUF 量化
- 結構化輸出
- 本機推論
約 29 分鐘閱讀作者:Whoops 編輯團隊
AI Agent 的帳單問題,本質上是「呼叫次數」乘上「每次 token 單價」的問題。代理在迴圈裡反覆呼叫模型、把工具回傳塞回上下文、再生成下一步,一個任務跑下來,模型呼叫的次數與每次輸入的長度會一起膨脹。SLM(小型語言模型)介入的方式有兩種:把高頻、格式明確的步驟換成小模型,或讓小模型在大模型前面先把關。兩條路做起來一點也不神祕,但每一步都有工程細節要對:牌價怎麼讀、位置怎麼挑、上下文怎麼設、失敗怎麼退,這些細節弄對了,省下來的錢才不會以品質的形式賠回去。
這條路在業界有清楚的參照點。Anthropic 在 2024 年 12 月的工程文章裡把代理定義為「在迴圈中依環境回饋使用工具的 LLM」,也直說代理式系統是在用延遲和成本換任務表現,同一篇文章給出的省錢範例,就是把簡單常見的問題路由給小模型、困難罕見的留給大模型。學界側,2023 年 5 月的 FrugalGPT 論文算過熱門模型 API 的價差可以到兩個數量級,並把降本手段整理成三類。官方工程實務與研究結論指向同一件事:模型分層是 Agent 降本的主要槓桿。
站上先前的 SLM 總論處理了小模型是什麼、跟 LLM 的五維度差異、量化與接入管道。接下來走部署軸,聚焦四個實戰問題:Agent 的錢到底花在哪、小模型在架構裡能站哪些位置、本地端與雲端各怎麼落地、上線前要檢查什麼。文中的牌價與規格,依各官方文件於 2026 年 9 月的版本凍結查證,牌價會改版,動手前建議回官方頁面再對一次。
這份內容寫給三種狀態的團隊:Agent 功能已經上線、看著用量成本往右上走的,正在評估把哪一段搬離雲端旗艦模型的,以及想要本地跑模型但不知道從 Ollama、llama.cpp、vLLM 哪個開始的。不需要先讀完模型理論,手上有真實的工作負載數字,就能跟著算。
一次任務等於很多次呼叫:Agent 的成本結構從牌價看起
要理解 Agent 為什麼貴,先看單次呼叫的帳怎麼組成。模型 API 按輸入與輸出 token 計費,輸入通常明顯便宜於輸出。而代理的每一次迴圈,要把先前的對話、系統提示與工具執行結果重新送回模型當輸入,任務走得越深,輸入越長,而且是每一次呼叫重複計費。一個「幫我查幾個來源再寫摘要」的任務,模型可能被叫上好幾次,第二次以後的輸入裡有一大半是前幾輪自己生成的內容。token 的切分與計算邏輯,站上的 Token 完全解析有完整說明,這裡直接用牌價算帳。
把三家雲端牌價攤開,同一家族內的大小模型價差非常可觀。OpenAI 的開發者定價頁上,gpt-5.5-pro 輸入每百萬 30 美元、輸出 180 美元,gpt-5.4-mini 是 0.75 與 4.50 美元,gpt-5.4-nano 則是 0.20 與 1.25 美元。Anthropic 的牌價頁上,Opus 5 為輸入 5 美元、輸出 25 美元,Sonnet 5 是 2 與 10 美元,被定位為速度與成本取向的 Haiku 4.5 是 1 與 5 美元。Google 的 Vertex AI 定價裡,Gemini 3.8 Flash 在 2026 年 12 月 31 日前的介紹價是輸入 0.75 美元、輸出 3.75 美元,2027 年 1 月 1 日起回到標準價 1.50 與 7.50 美元,更輕的 3.5 Flash-Lite 輸入為 0.30 美元。FrugalGPT 論文說的「兩個數量級」,在 2026 年的牌價上依然成立:旗艦級與最小級的輸出單價差距,OpenAI 是 180 對 1.25 美元。
| 模型 | 輸入牌價(每百萬 token) | 輸出牌價(每百萬 token) | 定位 |
|---|---|---|---|
| OpenAI gpt-5.5-pro | 30.00 美元 | 180.00 美元 | 旗艦推理 |
| OpenAI gpt-5.4 | 2.50 美元 | 15.00 美元 | 標準級 |
| OpenAI gpt-5.4-mini | 0.75 美元 | 4.50 美元 | 小級雲端模型 |
| OpenAI gpt-5.4-nano | 0.20 美元 | 1.25 美元 | 最小級雲端模型 |
| Anthropic Opus 5 | 5 美元 | 25 美元 | 複雜代理編碼與企業工作 |
| Anthropic Sonnet 5 | 2 美元 | 10 美元 | 高效能代理模型 |
| Anthropic Haiku 4.5 | 1 美元 | 5 美元 | 速度與成本取向 |
| Gemini 3.8 Flash(2026 年底前介紹價) | 0.75 美元 | 3.75 美元 | 輕量雲端模型 |
這張表要挑著讀。牌價是單價不是預測,實際帳單還受快取、批次與服務層級影響,後面會專門算。結構面的訊息比數字本身重要:每一家都把「小一號」的模型放在旗艦價格的幾分之一到百分之一區間,這不是偶然,是供應商自己把模型分層賣。Agent 的機會就在這裡,你的架構若只認得一個旗艦模型名稱,等於每一步都使用同一個高價層級,供應商替你準備好的分層,一行程式碼都沒用到。
先拆流程再選模型:工作流模式裡的小模型機會
換模型之前,先把 Agent 的流程攤開。Anthropic 那篇工程文章價值最高的部分,是把「代理式系統」拆成工作流與代理兩級:工作流的步驟由程式碼預先定義,代理才是模型自己決定下一步。這個區分對降本至關重要,因為工作流裡的每個位置的輸入輸出形態是固定的,正好是小模型能接手的地方。文章列了幾種基本模式,逐一來看小模型的機會。兩級之間可以混搭,而每個模型呼叫的位置都能分開檢查,這對降本是好消息:能被程式碼定義的部分,模型等級是可以逐一指定的。
提示鏈把任務拆成步驟序列,每次 LLM 呼叫處理上一次的輸出,中間可以插程式檢查點。翻譯、改寫、摘要、抽欄位這類中間步驟,輸出格式被下一步約束著,小模型接手的風險可控。檢查點本身也常用模型做,判斷「上一步是否達標」是二元分類,更不需要旗艦模型。
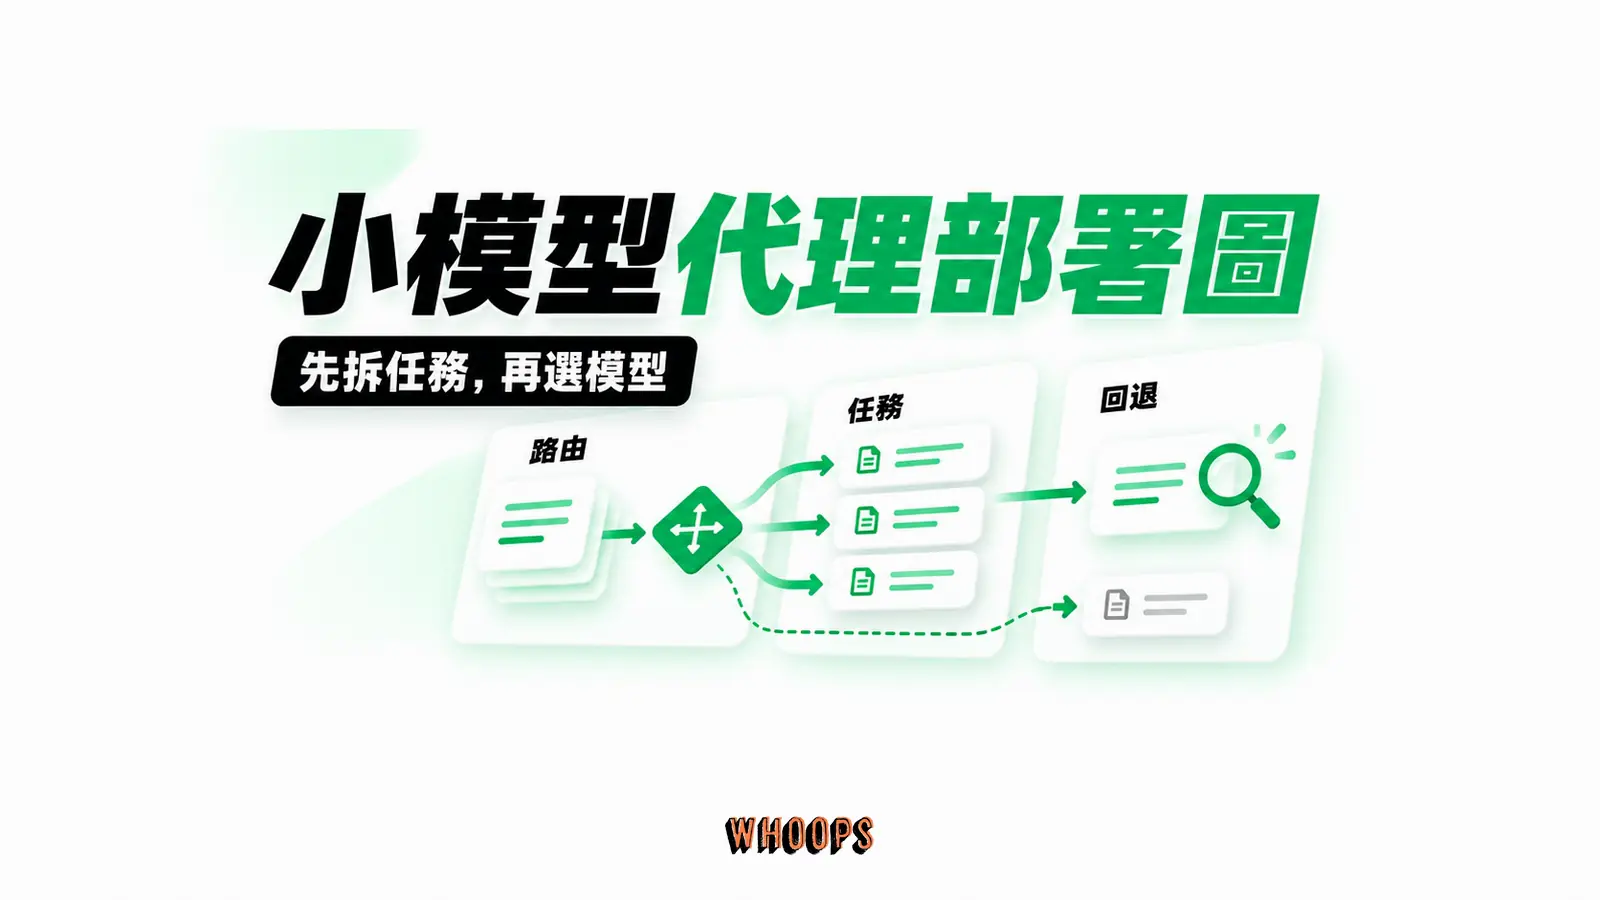
路由對輸入做分類,導向專門的後續任務,官方點出它的價值是關注點分離,能為每種輸入建更專門的提示。分類輸出通常就是一個標籤,這是全鏈路裡對模型容量要求最低的位置,卻直接決定後續呼叫的單價,省錢槓桿最大。
平行化讓多個 LLM 同時工作、輸出由程式彙整,兩種變形是分段與投票。投票特別適合小模型:同一個判斷跑多次取多數,用次數換穩定度,每次呼叫的單價壓得越低,這個模式越划算。分段則是把獨立子任務撒出去,文件各段落的抽取、多來源的初篩,是標準的小模型工作。平行化的省錢邏輯跟路由不同:路由省的是後續呼叫的單價,平行化省的是把高價呼叫拆成多次低價呼叫的總和,兩者在同一個架構裡可以同時成立。
編排者-工人模式由一個中央 LLM 動態拆解任務、派給工人 LLM、再彙整結果。這是「大腦用大模型、手腳用小模型」最直接的骨架:編排者保留規劃與拆解能力,工人做的是被明確定義過的子任務,程式碼生成除外,文件查找、資料整理、格式轉換這類工人,小模型勝任愉快。
評估者-優化者讓一個 LLM 生成回應、另一個在迴圈中提供評估與回饋。評估那一側如果有清楚的評分標準,例如檢查清單或格式規範,小模型就能當裁判,它不需要寫得比作者好,只需要指出哪裡不符合規範。至於完整意義上的代理,模型自己在迴圈中決定下一步的那種,規劃核心仍然建議留給能力上限高的模型,外圍動作才是小模型的地盤。
五種模式掃下來,共同規律很清楚:小模型的機會窗口在「格式明確、頻率高、後果可控」三個條件同時成立的位置。格式明確,輸出就能被 schema 約束。頻率高,省下的單價差才會乘出規模。後果可控,單點失敗能被下一步或檢查點接住。三個條件缺一個,就把那個位置留給大模型,這是比「全面換小模型」務實得多的策略。
小模型在 Agent 架構裡的四個位置
把工作流的視角落到具體架構上,小模型值得放的位置可以歸納成四個,每個對應不同的任務形態與風險。這四個位置可以單獨用,也可以疊著用,疊的時候從最上游的開始,越上游影響的呼叫次數越多。
第一個位置是入口的路由與分類。使用者的請求進來,先由小模型判斷意圖、語言、難度與緊急度,再決定送進哪條處理流程或哪個等級的模型。Anthropic 文章裡的範例就是這個形態:簡單常見問題走 Haiku 4.5,困難罕見問題走 Sonnet 4.5,後者牌價是前者的三倍,輸入 3 對 1 美元、輸出 15 對 5 美元。路由判斷本身輸出短、格式固定,正是小模型擅長的工作。而它每一次判對,後面整串呼叫就跟著走對價格,這是四個位置裡槓桿最長的一個。
第二個位置是工具呼叫與參數抽取。代理要查資料、發信、寫資料庫,得把自然語言轉成結構化的呼叫參數,回傳的資料要抽取成欄位、分類成標籤。這類工作的輸出是 JSON 而非開放文本,模型只要學會照 schema 填格子。Ollama 在 2024 年 12 月加入的結構化輸出,就是把輸出約束在 JSON schema 定義的格式內,官方把它列為比 JSON mode 更可靠一致的選項。工具與資料怎麼接給模型,可以另看站上的 MCP 運作解析,這裡聚焦模型端。
第三個位置是摘要與上下文壓縮。代理的記憶會隨任務膨脹,搜尋結果、文件內容、前幾輪對話會回灌成輸入 token。讓小模型先把長內容壓成要點,再交給負責決策的模型,輸入帳單會直接縮水。這個位置的要訣是把「保留標準」寫進提示裡:哪些欄位不能丟、數字照抄不改寫,否則省下的 token 會變成決策品質的隱形成本。長任務的輸入裡,工具回傳常常比對話本身佔得多,壓縮這一段對輸入帳單的槓桿,通常比改寫提示更直接。
第四個位置比較特別:小模型當大模型的草稿。投機解碼讓小模型快速猜出接下來的 token,大模型一次批次驗證這些猜測,猜對的直接採用。2022 年 11 月提出的原始論文在 T5-XXL 上實測 2 至 3 倍加速,而且輸出與直接用大模型完全相同,因為驗證權在大模型手上,整個過程不需要重新訓練或改架構。llama.cpp 的說明文件把機制寫得很直白:草稿模型是一個小得多的模型,快速起草、目標模型單批驗證,草稿命中率高的時候加速明顯。llama.cpp 的文件列出多種做法,包含獨立的草稿模型與 EAGLE-3 等:EAGLE-3 讓小草稿模型讀取目標模型的隱藏狀態來預測下個 token,接受率比同尺寸的獨立草稿更高。它省的是時間不是 token 帳單,適合「要大模型品質、又要低延遲」的場景,跟前三個位置省錢的邏輯不同,可以並存。
路由與級聯的研究證據
模型分層不是江湖偏方,是有論文支撐的設計模式。2023 年 5 月提交的 FrugalGPT 論文把降本策略整理成三類:提示調適、LLM 近似、LLM 級聯。級聯指的是先問便宜模型、不滿意再往上問貴的。論文的實驗數字是:FrugalGPT 級聯在達到最佳單一模型(當年的 GPT-4)表現的同時,成本最高減 98%,或在相同成本下把準確率再往上推 4 個百分點。要注意這是 2023 年模型組合上的結果,數字不能直接搬到今天,但「便宜模型先答、貴模型把關」的架構結論一路被後續工作沿用。
往後一年,路由有了更系統化的做法。2024 年 6 月提出、2025 年 2 月改版的 RouteLLM 論文訓練了路由器模型,在推論當下動態選擇強模型或弱模型,實驗顯示部分情境成本降超過 2 倍且不犧牲回應品質。論文還觀察到,兩端的模型在測試時被替換掉,路由器效能仍能維持,顯示路由器具有遷移能力。對部署者的啟示是:路由這層可以獨立成一個可替換的組件,不必跟特定模型綁死;遇到模型改版時換掉兩端的模型,路由表現仍要重新驗證一輪,而不是沿用原設定直接跑。
一個換型走查:客服代理的四段拆法
拿一個常見的客服代理當例子,把四個位置走一遍。使用者訊息進來,第一段是意圖分類,帳號問題、訂單查詢、退貨申請還是技術支援,輸出一個標籤,這段放小模型,呼叫量最大、格式最死。第二段是參數抽取,從訊息裡抓出訂單編號、日期、品項,組成查詢條件去打內部系統的 API,一樣是小模型加結構化輸出。第三段是文件壓縮,知識庫撈回來的長文件先壓成跟問題相關的段落,控制第四段的輸入長度。第四段才是答案生成與行動決定,要不要退款、要轉真人還是給連結,這段涉及判斷與政策,放大模型,而且只在分類與抽取都順利完成後才呼叫。
走查的重點是看呼叫次數的分布。四段裡前三段幾乎每一則訊息都會走到,第四段只有真正需要生成回覆時才觸發,加上級聯的退守設計,簡單問題在第二段之後就能用範本回覆結案。把牌價表套上去:前三段走 nano 或本地小模型,第四段按難度分給 Haiku 或 Sonnet,帳單結構會從「每次互動都付旗艦價」變成「多數互動付小模型價、少數互動付旗艦價」。這就是兩個數量級差距在架構上的兌現方式,不必碰觸模型訓練。走查還有一個附帶好處:四段拆開後,每一段的提示、評估樣本與失敗案例可以分開管理,日後要換任何一段的模型,影響範圍都看得見,比整顆代理一起換安全得多。
本地部署三條路:Ollama、llama.cpp 與 vLLM
把小模型放進 Agent,第一個決策是跑在哪裡。雲端小模型(mini、nano、Flash、Haiku 這些級別)改個模型名稱就能上線,本地部署則是把推論搬進自己的機器,逐次計費的 API 費用改由硬體、電力與維運成本取代。本地這條路的工具鏈已經成熟,三個名字先記住:Ollama 管易用,llama.cpp 管精控,vLLM 管吞吐。
Ollama:最快上手的本機推理引擎
Ollama 把模型下載、量化版本管理與 API 服務打包成一套指令就能跑的工具,是個人與小團隊最常見的起點,官方部落格的入門示範就是一行 pull 指令把模型拉下來,模型庫頁列出每個模型的檔位與標籤,下載哪個版本一目了然。對 Agent 開發者最重要的兩件事,它都有官方答案。一是相容性,2024 年 2 月起 Ollama 內建相容 OpenAI 的 Chat Completions 端點,把客戶端的 base_url 指向 http://localhost:11434/v1,使用 OpenAI Chat Completions 介面的客戶端就能接入,官方部落格也以 Vercel AI SDK 與 Autogen 兩個框架示範接法。二是輸出約束,前述 2024 年 12 月的結構化輸出用 format 參數傳入 JSON schema,Python 與 JavaScript 官方函式庫都支援,工具參數抽取這類任務可以直接靠它收緊輸出。
隱私是本地部署的另一個動機。Ollama 的常見問題文件寫得明白:本地執行時,提示與資料不會回傳給官方。對照代理工作負載會把內部文件、客戶資料塞進提示的特性,這一條對某些產業是硬需求。資料邊界的完整評估仍然要往應用層看,日誌、遙測與模型更新連線是獨立的工程課題。官方另提供純本地模式,環境變數 OLLAMA_NO_CLOUD 設為 1 即可關閉 Ollama 的雲端功能。關掉之後,本機推論這一段的資料邊界就落在自己基礎設施內,應用日誌、遙測與更新連線仍要按前述逐項檢查。採購面要同步確認的還有資料中心的所在地與條款,本地推論把這段談判直接縮短,對合約面的溝通效率也是一種節省。
llama.cpp:量化與硬體預算的精控
llama.cpp 是本地推論引擎,模型權重要存成 GGUF 檔案格式,其他格式的權重可以用倉庫內附的轉換腳本轉檔。README 列出的整數量化位階從 1.5-bit 一路到 8-bit,涵蓋 1.5、2、3、4、5、6、8 位元,用途寫得直白:更快的推論與更低的記憶體用量。對部署者的意義是,同一個模型可以按硬體預算選擇體積檔次,記憶體不夠時降位階,而不是放棄模型。同一份權重從 8-bit 降到 4-bit,佔用約砍半,代價是某些能力會滑落,滑多少要用自己的任務量,不能只看別人的評測。
對 Agent 開發者,它的函式呼叫支援值得細看:chat 元件加入了 OpenAI 式的函式呼叫,llama-server 加上 --jinja 旗標即可啟用,而且涵蓋所有模型。支援分兩級,Llama 3.x、Qwen 2.5、Mistral Nemo 等有原生格式,其他模型走通用模板,文件明言通用模板會消耗更多 token 且效率較低。挑模型的時候把「有沒有原生工具呼叫格式」列入條件,帳單與穩定性都會感謝你。
vLLM:伺服器等級的吞吐
當代理的呼叫量從「自己用」變成「一個團隊或一項服務」,瓶頸會移到吞吐與併發,這是 vLLM 的場子。這個源自 UC Berkeley Sky Computing Lab 的專案,自我定位是「容易、快速、便宜的 LLM 服務」,核心技術是用 PagedAttention 管理注意力的 KV 記憶體,配合連續批次、分段預填與前綴快取,把 GPU 的單位時間產出拉高。文件列的量化支援從 FP8、INT8、INT4 到 GPTQ、AWQ、GGUF 都有,投機解碼也內建了 n-gram、EAGLE 等多種實作。對 Agent 場景特別有用的兩個特性:前綴快取能讓「同一個系統提示反覆出現」的迴圈負載少付重複計算,OpenAI 相容的 API 伺服器則讓它無縫接進既有的 Agent 框架。如今它由 2000 多位貢獻者與數十個機構共同維護,是伺服器端開源推論的主力選項。
| 工具 | 適合誰 | 關鍵特性 | Agent 接入點 |
|---|---|---|---|
| Ollama | 個人、小團隊、快速原型 | pull 指令拉模型,模型庫可選檔位,本地不回傳提示 | OpenAI 相容端點+JSON schema 結構化輸出 |
| llama.cpp | 要精控量化與硬體預算的人 | GGUF 模型格式與 1.5 至 8-bit 整數量化 | llama-server 的 --jinja 函式呼叫 |
| vLLM | 服務化、多並發的正式環境 | PagedAttention,連續批次與前綴快取 | OpenAI 相容 API 伺服器 |
什麼時候不必自己架
本地部署不是必經之路,三個條件看一下就能判斷。沒有穩定的高頻量,帳單數字還沒有大到讓人緊張,雲端 nano 級按次付費的彈性就先夠用。沒有資料落地要求,提示內容本來就要經過外部服務,本地推論的隱私紅利拿不到。沒有維運人力,模型服務掛掉要有人修,半夜的併發尖峰要有人調,這些工在小團隊裡經常沒有主人。三個條件都不成立,雲端小模型加路由已經能拿到模型分層的大部分好處,本地的帳等量上來再算也不遲。
模型怎麼挑:參數量、量化與工具呼叫支援
本地引擎選好後,下一步是挑模型。Ollama 的模型庫把主流開源小模型的檔位列得很清楚:Meta 的 Llama 3.2 走 1B 與 3B 兩個小檔位,標了工具呼叫支援。Google 的 Gemma 3 從 270M 一路到 27B,官方描述是單張 GPU 就能跑的最強模型。Qwen 3 同時提供密集與 MoE 架構,最小 0.6B,標籤含工具呼叫與思考模式。Hugging Face 的 SmolLM2 有 135M、360M、1.7B 三個尺寸,IBM 的 Granite 3.1-MoE 提供 1B 與 3B 兩個為低延遲用途設計的檔位,微軟的 Phi-4 則是 14B,DeepSeek-R1 家族最小也提供 1.5b 的蒸餾檔位並標了推理與工具標籤。這串名單不用背,挑的時候記住三個過濾器就夠:參數量對上硬體預算、標籤有沒有 tools、授權符不符合商用。授權要逐個模型卡確認,例如 Phi-4-mini 掛 MIT,其他家族各有各的條款。
拿一個模型當例子看規格怎麼讀。微軟的 Phi-4-mini 在 模型卡上是 3.8B 參數、MIT 授權、支援 128K token 上下文,訓後訓練特別強化了指令遵循與函式呼叫,設計用途開宗明義列了三條:記憶體與算力受限的環境、延遲敏感的場景、數學與邏輯推理。模型卡同時把限制講得誠實:這個規模存不下太多事實知識,使用者可能遇到事實錯誤,官方建議用搜尋引擎或在 RAG 設定下補足。這段話對 Agent 部署者是最重要的一課:小模型負責格式與流程,事實與知識交給檢索,檢索增強的原理與價值可以搭配站上的 RAG 解析。
Agent 視角還有一個容易被忽略的規格:上下文長度。Phi-4-mini 支援 128K token,對照前述 Ollama 預設上下文 4096 的欄位,模型能力與執行環境是兩件事,模型撐得住的長度,服務端沒設好就吃不到。挑模型的時候,把「模型卡宣告的上下文」跟「執行環境實際配置的上下文」一起看,再對照自己任務的迴圈長度,三者對得起來,長任務才不會在中途斷訊。
量化與記憶體的帳,這裡用部署視角快速算一遍,概念與代價的完整討論在總論那篇。權重佔用的記憶體約等於參數量乘上每個權重的位元數除以八:4-bit 量化下每參數約 0.5 byte,一個 4B 模型的權重約 2 GB,8-bit 則約 4 GB,1.7B 的模型在 4-bit 下權重不到 1 GB。這是只有權重的下限估算,執行時還要加上 KV cache、輸入內容與框架本身的開銷,而 KV cache 會隨上下文長度與並發數成長,Agent 的長迴圈正是吃這一塊。把「權重預算+上下文預算」分開列,硬體採購才不會只對一半。
成本帳怎麼算:兩個換算例子
把前面的牌價換算成具體場景。假設你的 Agent 每月處理 10 萬次入口路由,每次輸入連同系統提示約 1,500 token、輸出約 100 token,月輸入量是 1.5 億 token、輸出 1,000 萬 token。這一步若由 gpt-5.5-pro 處理,輸入 4,500 美元加輸出 1,800 美元,每月 6,300 美元。換 gpt-5.4-mini 是 112.5 加 45 美元,每月 157.5 美元。換 gpt-5.4-nano 則是 30 加 12.5 美元,每月 42.5 美元。同一份工作,模型選擇的差距超過百倍。這組數字是照牌價直乘的試算,真實用量會因提示長度、快取命中與批次比例而不同,但數量級的對比不會騙人。
第二個例子換 Anthropic 家族算同樣的量。10 萬次呼叫、每次輸入 1,500、輸出 100,走 Opus 5 是輸入 750 美元加輸出 250 美元、每月 1,000 美元,走 Haiku 4.5 是 150 加 50 美元、每月 200 美元,前者是後者的 5 倍。5 倍不如前面那組百倍搶眼,但把入口路由從旗艦換到小級,一樣的量、一行設定的改動,每月省下 800 美元,這是大多數團隊第一個該做的交換。若這一步的判斷品質真的吃緊,Sonnet 5 落在中間,每月 400 美元,當退守選項。
雲端直上:快取與批次先做
換模型之前,有兩個槓桿不用動架構就能拉。一是提示快取,代理的系統提示、工具清單與前綴對話在迴圈中重複出現,正是快取的甜蜜點,牌價上 Haiku 4.5 的快取讀取每百萬 0.10 美元、是原輸入價的一折,Opus 5 的快取讀 0.50 美元也是輸入價的一折。OpenAI 側同理,gpt-5.4 的快取輸入 0.25 美元、是原價 2.50 美元的十分之一,gpt-5.4-mini 快取輸入 0.075 美元。迴圈裡前綴穩定而且真的命中快取時,Agent 的有效輸入單價才會往下修。用 Haiku 4.5 粗算:假設迴圈輸入裡系統提示與工具清單佔一半且穩定命中快取,這一半的單價從 1 美元降到 0.10 美元,另一半維持原價,整體輸入成本約省下四成五,一行模型選擇都不用改。二是批次,Anthropic 的批次處理直接 5 折,OpenAI 的批次價同樣對半,例如 gpt-5.4-mini 批次降到輸入 0.375 美元。批次的代價是等待,代理迴圈內部吃不到,但內容改寫、標籤清理、日報彙總這類非即時的批次工作,就是為批次而生的形狀。
本地部署的帳換一種算法。同樣 10 萬次路由跑在本機的 4B 模型上,沒有逐次計費的 API 帳單,成本變成硬體折舊、電力與維運時間。這筆帳要誠實地算:一張能順跑 4-bit 4B 模型的顯卡不是免費的,模型更新、失敗重試與監控也是工。本地路線的甜區在「高頻、穩定、格式固定」的工作負載,用量越大,硬體攤提越薄,低頻或爆發性的用量,雲端小模型按次付費反而輕鬆。兩條路不互斥,可以搭配使用,例如用路由把大宗流量送到本地、疑難與備援留給雲端。
上線前的檢查清單與常見陷阱
本地 Agent 上線前,有一個坑官方文件直接點名:上下文預設值。Ollama 的常見問題寫明預設上下文視窗是 4096 token,而它的上下文長度文件更進一步說,網頁搜尋、代理與編碼工具這類需要大上下文的任務應該設到至少 64000 token,官方示範的設定方式就是用環境變數把服務端設成 64000。兩份文件合起來讀,結論很直白:代理工作負載不該依賴出廠預設,上線前先把上下文設到至少 64000 token。解法是 OLLAMA_CONTEXT_LENGTH 環境變數或 API 的 num_ctx 參數,代價是記憶體,官方也明言上下文調大會增加執行模型的記憶體需求。新版文件把預設值改成依 VRAM 分級,低於 24 GiB 的卡仍是 4k 起跳,24 到 48 GiB 是 32k,代理場景一樣要手動拉高。
第二個陷阱是把小模型放在它撐不住的位置。Phi-4-mini 模型卡那句「存不下太多事實知識」值得貼在部署文件裡。小模型跑開放式知識問答,幻覺的成因與對策在站上的 AI 幻覺指南有完整整理,Agent 場景的短版原則是:事實查證交給檢索或工具,模型只負責編排與格式。換模型之前,用自家任務的真實樣本跑一輪評估,Phi 的模型卡自己也建議使用者在各自的應用裡測試,因為基準分數不會告訴你繁體中文客服語料上的表現。
第三個陷阱在並發與資源配置。Ollama 的行為細節:模型預設在記憶體駐留 5 分鐘,閒置後卸載。可同時載入的模型數預設是 GPU 數的三倍,純 CPU 推論為 3。單模型的並行請求數預設 1,而且記憶體需求會隨並行數乘上上下文長度放大,官方給的例子是 2K 上下文配 4 個並行請求會配置成 8K。排隊上限 OLLAMA_MAX_QUEUE 預設 512。這些預設值對單人使用剛好,對服務化的 Agent 流量就要按機器規格重算。keep_alive 參數能把駐留時間拉長或縮短,讓熱門模型常駐、冷門模型讓位,是把有限 VRAM 用在刀口上的基本手段。要確認模型實際落在哪種記憶體,ollama ps 的 Processor 欄會顯示模型載入 GPU、CPU 或混合,跑一輪壓力測試後看這個欄位,比猜測可靠。
還有一個提醒來自官方工程文章本身:從最簡單可行的方案開始,需要時才加複雜度。這句話在降本語境下有雙重含義。一來,別為了省錢把架構先弄複雜,一個穩定的路由判斷,效果好過三層快取加兩層級聯的精密系統。二來,換模型的每一步都要有量測:換之前記錄任務成功率與單位成本,換之後對照,沒有數字的「感覺變便宜了」不算降本,品質跌掉後產生的修復成本,也要計入換型後的單位成本。
版本與升級也要有一條紀律。雲端牌價會改版,模型會汰舊,本地模型的量化版本會更新,這些變動任一項都可能讓原本調好的表現漂移。做法是把「模型名稱、版本、端點」當成配置管理,升級前跑一輪評估集回歸,通過才切。RouteLLM 那個路由器可以換兩端模型的觀察,在這裡同樣適用:分層架構的好處之一,就是每次只動一小段,出事時回滾也只回滾那一小段。
起步路徑:四個動作
四個動作把前面的線索收斂成一條可執行的路。第一,盤點現有 Agent 的呼叫結構,把每一次模型呼叫的位置、輸入輸出長度與頻率列成表,找出格式明確、頻率最高的三個位置。第二,裝 Ollama,從模型庫拉一個帶 tools 標籤的小模型,先把上下文環境變數設成 64000 再開始測。第三,把 Agent 客戶端的端點指向本機的 OpenAI 相容位址,跑一輪真實任務的回歸,記錄成功率與延遲。第四,只有一個位置通過回歸時才切流量,切了之後對照量測,失敗就退回,通過再換下一個位置。整條路不需要一次到位,逐段換型、逐段回歸,本來就是這條路的走法。
量測怎麼設,決定這條路走得穩不穩。每個換型位置至少記三組數字:任務成功率,用固定樣本集算,換模型前後各跑一輪。單位成本,把該位置的月帳單除以完成任務數,而不是只看 token 總量。延遲分布,看中位數也看尾端,代理的使用者體感常常被尾端拖垮。三組數字都要在切流量前有基線,否則「換完感覺還好」跟「換完變好」分不出來。樣本集本身也要保養,新的失敗案例進來就補進去,它會跟著你的產品長大,是換型路上最值得累積的資產。
三種角色怎麼看這件事
行銷與產品角色看的是單位經濟。Agent 功能上線後,每一次使用者互動背後是幾次模型呼叫、每個月的互動量成長曲線會把帳單推向哪裡,這兩個問題決定功能的毛利。把入口路由與摘要壓縮換成小模型,是產品端少數不動功能體驗就能拉開成本結構的工程槓桿。如果 Agent 的概念與落地流程還在起步,可以先從 AI Agent 實戰指南把基礎術語對齊。
開發者看的是可控性與替換成本。OpenAI 相容端點已經是本地與雲端的公分母,把模型名稱與端點抽成配置,路由層獨立成組件,換模型就是改一行設定加上一輪回歸測試。量化的選擇、上下文的配置、並發的調校,這些細節在 Ollama 與 llama.cpp 的官方文件裡有清楚答案,部署前照著文件對一遍,比試錯省時間。真正要自己扛的是評估集:自家任務的樣本、評分標準與失敗案例庫,這是模型供應商給不了的資產,也是路由器能不能落地的前提。工程順序上,先把單一位置的模型抽換做成開關,再談級聯與快取,每加一層機制就多一個失效模式,複雜度要花在量測證明值得的地方。
採購與管理者看的是風險與帳務週期。以 Ollama 本地執行為例,提示與資料不回傳官方,代價是硬體資本支出與維運人力,雲端小模型把固定成本換成變動成本,但要追蹤牌價改版與資料處理條款。兩者的交界處,生效日這類細節值得記進合約檢查表,例如 Gemini 3.8 Flash 的介紹價在 2026 年 12 月 31 日截止,隔天回到標準價,按介紹價編的年度預算會在跨年時失準。無論選哪邊,先把前面兩個換算例子套上自己的用量跑一遍,再談策略。
回到最初的問題:小模型怎麼幫 Agent 省成本?答案不在模型本身,而在架構。把代理拆成路由、抽取、摘要、決策四段,前三段交給跑得動、改得動、看得住的小模型,第四段按任務難度選級,該級聯就級聯。牌價兩個數量級的差距是設計空間:FrugalGPT 與 RouteLLM 提供級聯及路由的研究證據,Anthropic 的工程文章則提供依問題難度路由模型的範例,剩下的就是把自己的工作量放上去算一遍。算完你會發現,問題很少是「要不要用小模型」,而是「哪一段先用」,牌價表跟呼叫結構攤開,答案通常自己會浮出來。