SerpApi 教學:SERP API 串接、計費規則與 MCP 應用
SerpApi 教學涵蓋 GET 串接、回應欄位、成功才計費與每小時吞吐規則,附方案表試算與 Claude 的 MCP 接法,2026 年 9 月 10 日查證。
本頁目錄
- SerpApi 是在做什麼:把搜尋結果頁變成 JSON
- 開工之前:註冊帳號與取得金鑰
- 金鑰放哪、怎麼驗證
- 第一支請求:GET 打向 Search API 端點
- URL 查詢字串的長相
- 第一次打不通的三種錯誤
- 看懂回應:organic_results、狀態碼與空結果
- organic_results 與常用欄位
- 狀態碼對照
- search_metadata.status 與空結果
- 參數技巧:地區、裝置、分頁與垂直搜尋
- location、gl、hl:地區與語言
- device 與 google_domain
- start 與 tbm:分頁和垂直搜尋
- SerpApi 專屬參數:交付、輸出與欄位過濾
- 計費規則:成功才計費,快取不算錢
- 什麼算一次有效查詢
- 用 Account API 看餘額
- 方案、吞吐與帳務細節
- 方案表與每小時吞吐
- 速度模式的價格乘數
- 超額、退款與方案異動
- 免費額度的示意算例
- Python 套件:serpapi 與 google-search-results 的新舊地雷
- serpapi.Client 五行上手
- 錯誤處理
- 各引擎查詢鍵不同
- 舊套件 google-search-results 的地雷
- MCP 入口:讓 AI 助手用同一組額度查搜尋
- Claude Code 與 Claude Desktop 的接法
- search 工具與參數
- 用量計在既有訂閱內
- 與 DataForSEO 的關係
- 評價、價格觀感與訴訟現況
- 社群與評論怎麼說
- Google 訴訟的時間線
- 保障與合規面
- 下一步
SerpApi 是把 Google 等搜尋引擎的結果頁抓回來、整理成 JSON 或 Markdown 供程式讀取的商用 API,註冊之後一支 GET 請求就能取得排名、標題、連結與摘要。真正需要時間弄懂的部位是計費:只有成功的搜尋才計入方案額度,出錯與失敗不計,快取命中免費。這組規則算清楚,帳單和 429 才不會一起找上門。
重點先看
- 串接本身很單純:金鑰放進 api_key 參數,查詢字串放進 q,GET 請求打向 Search API 端點,engine 預設就是 google。
- 計費只算成功的搜尋。出錯、失敗不計,一小時內命中快取免費,回傳 100 筆與空結果都算同樣一次。
- 每小時吞吐是常見的撞牆點:月量少於 100 萬次的方案,每小時上限是方案量的 20%,超過會收到 429。
- 方案搜尋用完時觸發自動提前續約,查證當下的定價頁未見按次計算的超額費。訂閱 7 天內、用量未逾 20% 可全額退款。
- MCP(Model Context Protocol)是同一組額度的新入口,Claude Code 一行指令就能掛上官方託管端點,用量計在既有訂閱內。
- 現在就能做:花約 10 分鐘註冊帳號、到後台複製私密金鑰,用免費方案的每月 250 次額度打出第一支請求。
SerpApi 是在做什麼:把搜尋結果頁變成 JSON
SerpApi 是一家提供 SERP 資料 API 的公司,服務與公司同名,官方拼法固定是 S 小寫、A 大寫。官網首頁的自述是把 Google 與其他搜尋引擎的結果「快速、簡單、完整」地透過 API 抓回來,輸出 JSON 與 Markdown 兩種格式,內容涵蓋自然結果,也涵蓋地圖、在地、購物、知識圖譜等區塊,欄位包括連結、價格、評分、評論與複合摘要。
名稱容易混,先固定用法。SerpApi 指公司與服務本身,SERP 資料 API 是這類服務的泛稱,兩個詞不要互換。全小寫的 serpapi 只在講 Python 套件時出現,與服務是兩回事。
自己寫爬蟲的人都知道這件事的維護成本:選擇器會過期、版面會改版、擋爬蟲的機制會升級。SERP 資料 API 把這一層外包給服務端,程式只負責發請求、收 JSON。SerpApi 官網宣稱的基礎設施包含全球 IP、完整的瀏覽器叢集,而且每個請求都含驗證碼處理。location 參數會把請求導向離目標地點最近的代理伺服器,地理設定交給服務端調度。
引擎涵蓋範圍以官網頁尾的 API 清單為準,橫跨約 20 個平台:Google、Bing、Yahoo、DuckDuckGo、Baidu、Yandex、Brave、Naver、YouTube、eBay、Amazon、Walmart、Apple、Facebook、Instagram、Yelp、Tripadvisor、OpenTable、Home Depot、Zillow,其中 Google 專屬 API 約 58 支。查證的頁面未見單一的引擎總數,要確認某個平台吃不吃,直接查頁尾清單。
挑引擎的原則很樸素:主力查詢走 Google,其他平台按目標市場加。做跨境內容的人會需要 Bing 與 Yandex,做影片研究的人會需要 YouTube,清單在官網頁尾,按需求挑就好。
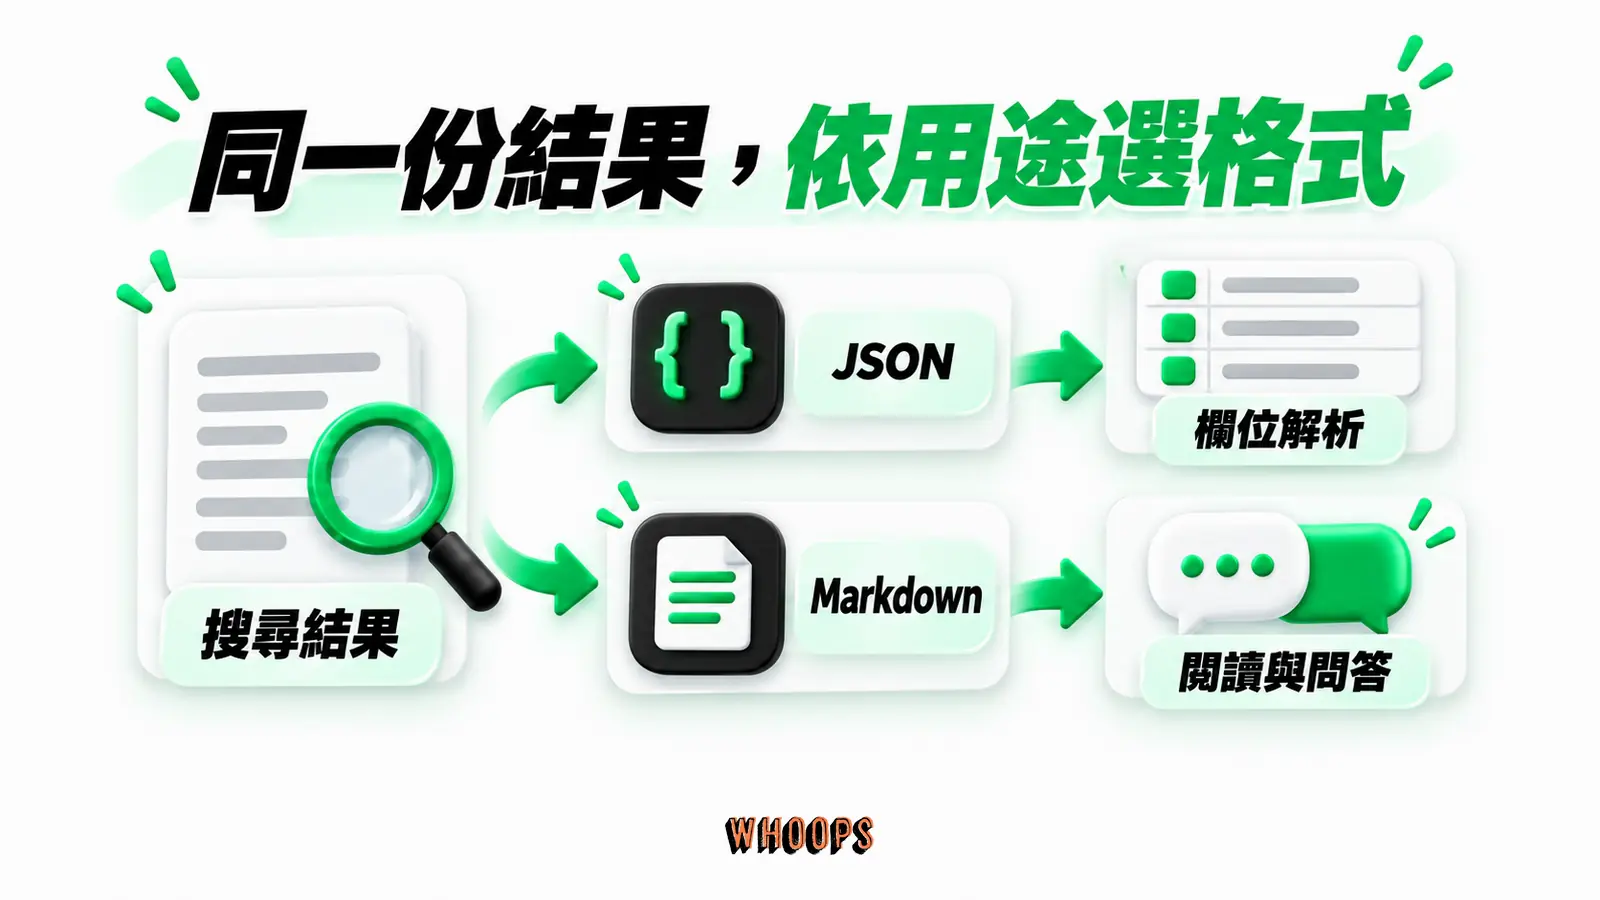
兩種輸出格式各有位置。JSON 給程式消費,結構化欄位可供解析,實際欄位依查詢結果而異。Markdown 給人或語言模型讀,官方把它定位成 LLM 最佳化的輸出,把結果頁壓成適合餵進模型的文字形態。同一份搜尋結果,餵儀表板用 JSON,做摘要與問答用 md,兩種格式可以並存。
平台數與 API 數是兩個層次的數字:約 20 個平台是網站或服務的層次,Google 專屬約 58 支是單一平台內的端點層次。看文件時先分清楚這兩層,找 API 才不會迷路。
這些結構化資料的用途集中在排名追蹤、SERP 特徵研究與競品監控。回應裡的 position、related_questions、knowledge_graph 等欄位,足以支撐每天記錄同一組關鍵字的排名變化、觀察問題型結果的出現與消失、追蹤知識圖譜卡片的內容變動。結果頁本身也在變化,AI Overviews 出現之後,結果頁的組成又多了一類,背景可以搭配站上對AI Overviews 與 SEO 關係的分析。還不熟悉結果頁上有哪些區塊的人,先看搜尋結果頁的組成再回來,後面的欄位解讀會順很多。
官網列出 15 個客戶標誌,包含 Nvidia、Shopify、Perplexity、Adobe、Samsung、KPMG、Ahrefs、Grubhub、Salesforce、Thomson Reuters 等。名單只代表官網的陳列,個別客戶實際怎麼用它,本次查證未見說明,也不必推測。
把欄位組合起來,可以推出幾種常見的成品:position 配上日期畫排名曲線,related_questions 的變動記錄問題需求的消長,knowledge_graph 的內容變化用來觀察實體資料的更新。這些推論都錨定在回應欄位本身,欄位拿得到,場景就成立。反過來看,只需要偶爾查一兩次、沒有要累積資料的人,直接開搜尋頁面看就好,不必為此引入一套 API。
開工之前:註冊帳號與取得金鑰
註冊在官網完成,接著進帳號後台。金鑰在後台的金鑰頁產生,官方文件稱它為 SerpApi 私密金鑰,後續所有請求、套件與 MCP 端點都靠這組字串驗證身分。它等同密碼:放環境變數,不要寫進程式碼,不要提交到版本庫,也不要貼進任何對話或文件。
金鑰放哪、怎麼驗證
驗證方式是 api_key 查詢參數。查證當下的官方文件頁只描述這一種驗證,未見 OAuth 或表頭驗證的說明。官方 Python 套件的範例是從環境變數 SERPAPI_KEY 讀金鑰,沿用這個慣例,換機器部署時只要改環境變數,程式不用動。
金鑰頁在官方文件裡以 manage-api-key 的路徑名稱出現,401 錯誤訊息也指向同一頁。找不到金鑰入口時,從錯誤訊息反查,這條路徑在除錯時會反覆用到。
免費方案提供每月 250 次搜尋、每小時上限 50 次,對走完一次完整串接測試來說夠用,先在免費額度內把流程跑通,再決定要不要付費。
免費額度內值得測的項目不少:基本查詢與欄位解析、location 與 gl、hl 的組合差異、start 翻頁、tbm 的垂直結果,以及 Account API 的餘額回報。把這些都走過一遍,付費前的疑問會少一大半,升級後的程式也不用重寫。
註冊後也可以先看過帳號後台的方案頁與定價頁再動手。心裡先有方案數字,測試時看到回應就會自然聯想到成本,養成每次查詢都知道花多少額度的習慣,之後付費的帳單不會有意外。
第一支請求:GET 打向 Search API 端點
URL 查詢字串的長相
SerpApi 的Search API 端點用 GET 呼叫,必填參數兩個:q 帶查詢字串,api_key 帶私密金鑰。engine 可不填,預設值是 google。最小可用的請求長這樣:
GET https://serpapi.com/search?api_key=YOUR_API_KEY&engine=google&q=coffeeq 支援 Google 的搜尋運算子,例如 site:、inurl:、intitle:,也支援 as_dt、as_eq 這類進階參數,等於把 Google 進階搜尋的語法原樣搬進 API。想看台灣的結果,加上對應 Google 國碼與語言代碼慣例的 gl=tw 與 hl=zh-TW,需要更精準時再用 location 指定城市層級的地點。
運算子的實用場景很多。site: 加網域可以追蹤單一站台的收錄狀態,intitle: 把標題命中特定詞的頁面撈出來,inurl: 適合找網址帶特定字串的頁面。競品監控的典型做法,就是拿 site: 限定對手網域,定期記錄前段結果的頁面變化,做法與追蹤自家網站完全同一套。
查詢字串的組裝照 URL 的規則來:空白與特殊符號要編碼,多個參數用 & 串接。用參數形式傳查詢時,多數語言的 HTTP 函式庫會代為編碼,自己拼整串網址時才要留意。
拿到回應後先做兩件事:存成檔案,展開看一次。先看 search_information 確認查到的查詢與結果狀態,再展開 organic_results 的前幾筆,確認 position、title、link、snippet 都是預期的形態。先做這一步,後面寫解析程式時會省很多猜測。
第一次打不通的三種錯誤
- 400:缺必填參數,錯誤訊息會寫 Missing query q parameter.,先檢查 q 有沒有帶到。
- 401:金鑰無效,錯誤訊息會指向金鑰管理頁,回後台確認金鑰複製完整、沒有多餘空白。
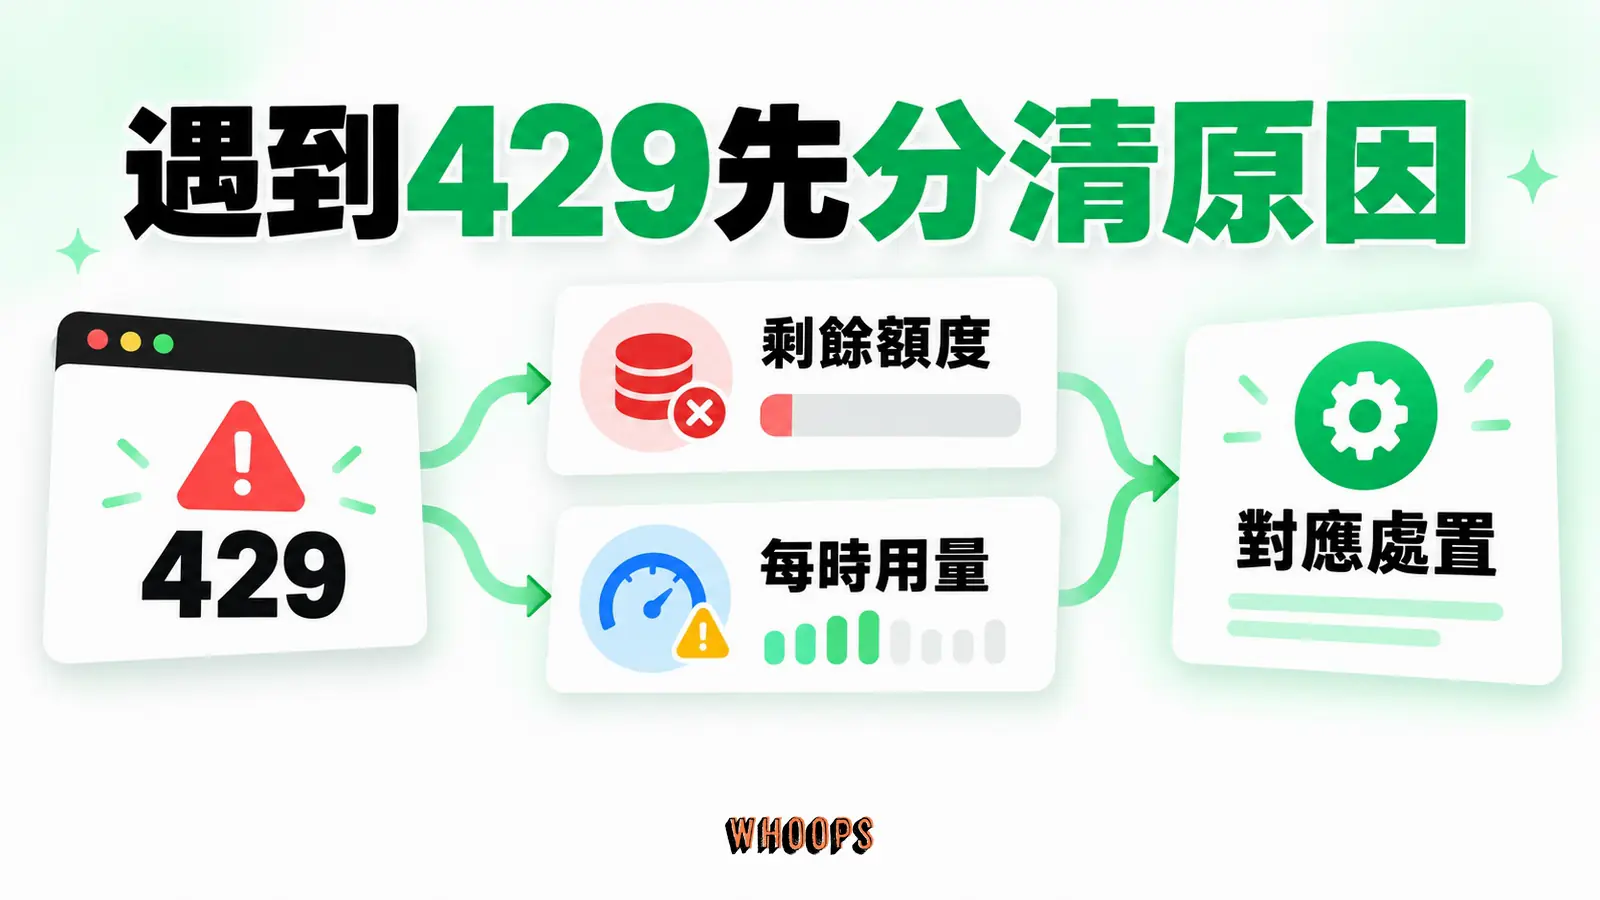
- 429:超過每小時吞吐上限,或帳號搜尋用完,用完時的訊息是 Your account has run out of searches.。
429 常被當成速度問題,實際上有兩種觸發:吞吐撞牆與額度用完。排查順序固定先查餘額、再查每小時用量,兩者都能用 Account API 看得到,不必用猜的。
重試邏輯分兩邊:500、503 這類 SerpApi 端的錯誤與吞吐造成的 429 可以等待後重試,503 官方建議稍後再發,400 與 401 屬於設定問題,修好參數或金鑰再發才有意義。
看懂回應:organic_results、狀態碼與空結果
organic_results 與常用欄位
回應的頂層是一組常見欄位:search_information 放查詢本身的資訊,organic_results 放自然結果,related_questions 放問題型結果,knowledge_graph 放知識圖譜卡片,local_results 與 local_map 放在地結果,related_searches 放相關搜尋,serpapi_pagination 放分頁資訊。這份清單截取自官方範例,實際回應以查詢內容為準。
organic_results 是被消費的主力區塊,每筆結果包含 position、title、link、snippet,以及 redirect_link、displayed_link、thumbnail、favicon、snippet_highlighted_words、sitelinks、source 等欄位。做排名追蹤吃 position 和 link,做摘要分析吃 snippet,要辨識站台來源時用 source 和 displayed_link。
三種場景對欄位的取用各不相同。排名追蹤存 position、link 與查詢時間就夠,資料量小、可以長期累積。特徵研究要記 related_questions、knowledge_graph 出現與否,欄位存在本身就是訊號。競品監控拿 site: 限定網域後,追蹤頁面在哪些查詢下擠進前段,變化的時間點就是情報。
related_questions 每筆含 question、snippet、title、date、link,等於把問題型結果結構化,適合記錄某個查詢下出現哪些延伸問題、什麼時候消失。search_information 的 query_displayed、total_results、time_taken_displayed、organic_results_state、results_for 用來確認查詢當下的結果狀態。serpapi_pagination 提供 current、next、next_link、other_pages,分頁爬取時靠它判斷終點。
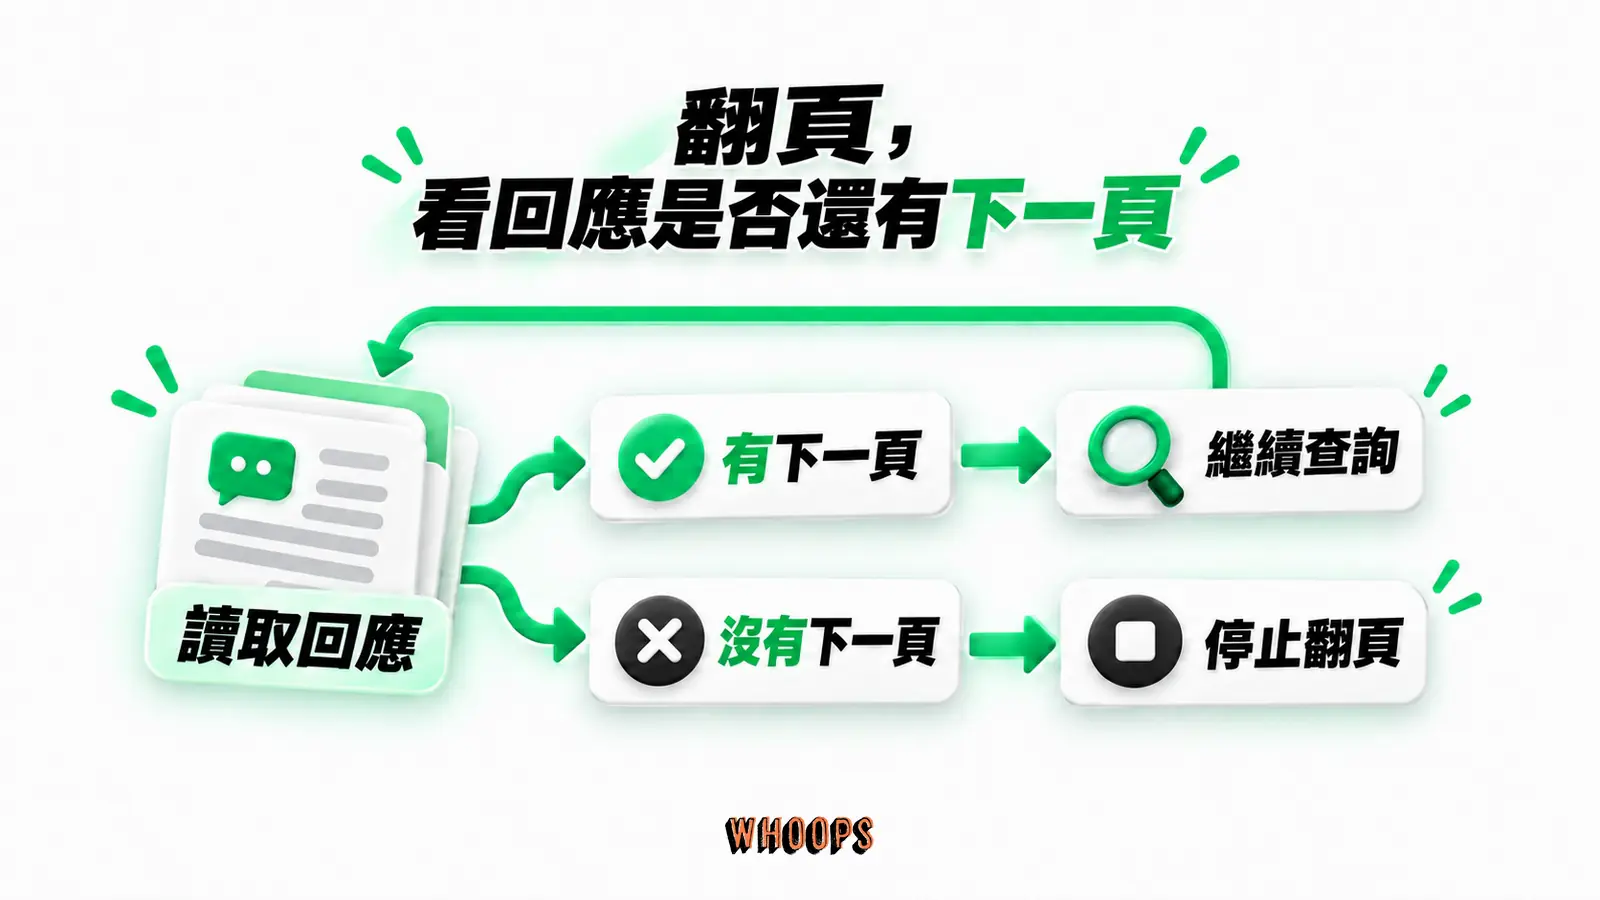
翻頁的實務用 start 配 next_link。第一頁的 start 給 0,之後按 serpapi_pagination 回傳的 next 值遞進,直到 next 不再出現。別用固定頁數硬跑,結果總數會隨查詢變動,以回應裡的分頁欄位為準。
頂層欄位還有 related_searches、perspectives、things_to_know、refine_this_search、immersive_products 等家族,出現與否取決於查詢內容。做結果頁研究時,這些新形態的區塊值得與自然結果分開記錄,組成的變化本身就是研究題材。要長期累積,一開始就把存檔結構定成查詢日期加原始 JSON,之後要補做任何分析都有原料。
狀態碼對照
每個狀態碼對應不同的處置,寫錯誤處理時,對照官方的狀態碼文件走:
左右捲動檢視完整表格
| 狀態碼 | 意義與處置 |
|---|---|
| 200 | 成功。空結果集也是 200,一樣視為成功。 |
| 400 | 缺必填參數,例如 Missing query q parameter. |
| 401 | 金鑰無效,錯誤訊息指向金鑰管理頁。 |
| 403 | 帳號無權限或已刪除。 |
| 404 | 資源不存在。 |
| 410 | 封存結果已過期刪除。 |
| 429 | 超過每小時吞吐上限,或帳號搜尋用完。 |
| 500、503 | SerpApi 端的錯誤,503 官方建議稍後重試。 |
search_metadata.status 與空結果
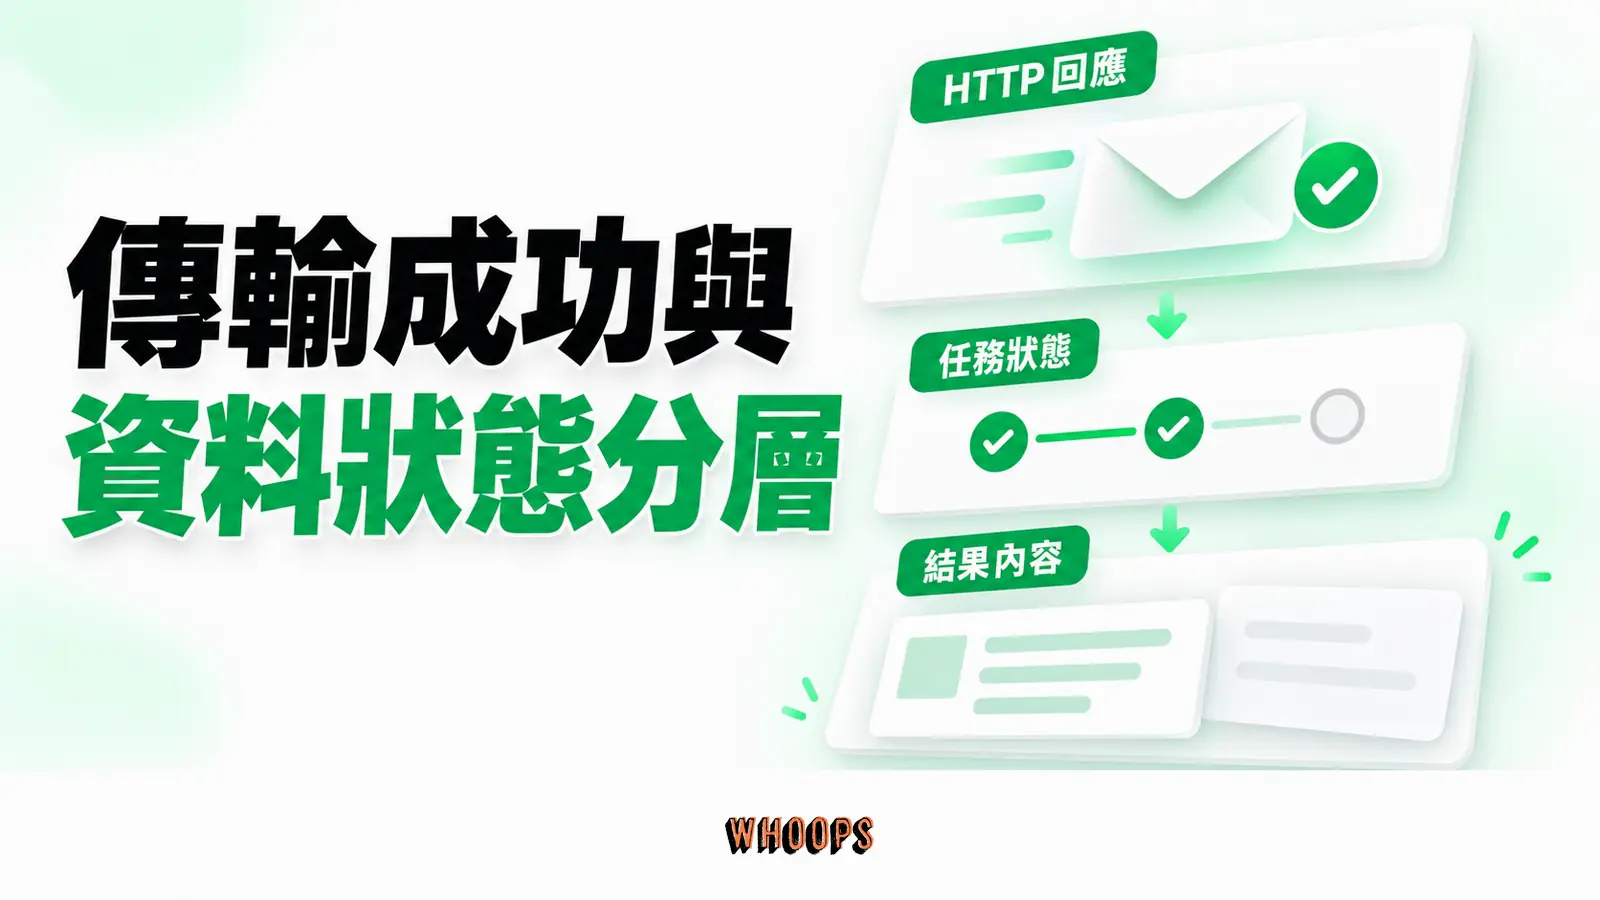
HTTP 200 之外,回應內還有 search_metadata.status,值有四種:Success、Processing、Queued、Error。空結果集是 200 加 Success,頂層的 error 鍵可能帶 Google hasn't returned any results for this query. 的訊息。寫排程時把空結果視為成功,因為計費也是這樣算的。
參數技巧:地區、裝置、分頁與垂直搜尋
參數多,但日常會用到的組合固定幾組。先用一張表把常用的留下來,細節往後展開:
左右捲動檢視完整表格
| 參數 | 作用 | 官方說明的要點 |
|---|---|---|
| q | 查詢字串,必填 | 支援 site:、inurl:、intitle: 等運算子與 as_dt、as_eq 等進階參數 |
| api_key | 私密金鑰,必填 | 帳號後台的金鑰頁取得 |
| engine | 指定引擎 | 可不填,預設 google |
| location | 地點 | 建議城市層級,不可與 uule、lat、lon 併用 |
| gl | 兩字母國碼 | 例如 us、fr |
| hl | 語言代碼 | 例如 en、es-419 |
| device | 裝置 | desktop、tablet、mobile,預設 desktop |
| start | 結果偏移量 | 0、10、20 類推,做分頁 |
| tbm | 垂直搜尋 | isch 圖片、lcl 在地、vid 影片、nws 新聞、shop 購物 |
| async | 交付稍後取回 | 不可與 no_cache 併用 |
| output | 輸出格式 | json、html、md |
location、gl、hl:地區與語言
location 建議給到城市層級,它影響的是請求的地理設定,也就是前面提過的最近代理導向。地區指定有三種方式:location 吃城市層級的字串,官方對它的建議也寫得具體,而且明載不可與 uule、lat、lon 併用,uule 用 Google 編碼的位置值,手上已經有編碼時才用得上,lat 與 lon 是 GPS 座標,適合需要精準座標的查詢,兩者要成對並搭配一致的 gl,否則拿到的結果集會與預期錯位。radius 用公尺指定半徑,桌面版的範圍是 1 至 199,平板與手機是 1 至 1000。
gl 與 hl 是交給 Google 判讀的代碼:gl 兩字母國碼,hl 語言代碼。對應 Google 的國碼與語言代碼慣例,台灣是 tw 與 zh-TW。要限制國家再用 cr,例如 countryFR|countryDE,要限制語言用 lr,例如 lang_fr|lang_de。地區參數的組合容易出錯,訣竅是固定一組基準組合,其餘每次只動一個參數,比對回應再調。
device 與 google_domain
device 可給 desktop、tablet、mobile,預設 desktop。要比較兩種裝置拿到的結果時,這個參數就是切換的開關。google_domain 預設 google.com,要特定 Google 網域的結果時才需要動它。
device 與地區參數可以組合。手機加在地是在地消費型商家典型的視角,桌機加全國適合內容站與 B2B 的排名觀察。先想清楚報表要回答誰的問題,再決定參數組合,比每一種組合都排程一次省額度。
start 與 tbm:分頁和垂直搜尋
start 是結果偏移量,0、10、20 依此類推,搭配 serpapi_pagination 的 next_link 就能翻完整個結果集。tbm 切換垂直搜尋:isch 是圖片、lcl 是在地、vid 是影片、nws 是新聞、shop 是購物,省略時就是一般搜尋。tbs、safe、nfpr、filter 是過濾參數,需求明確時再加。
垂直搜尋把同一支端點變成多種資料來源。tbm 設 lcl 拿在地商家結果,配合 location 做本地市場調查。設 nws 拿新聞結果,品牌公關的監控可以直接排程。設 isch 拿圖片結果,shop 拿購物商品與價格。一套金鑰、一支端點,換一個參數就換一個資料面,成本都進同一個帳本。
SerpApi 專屬參數:交付、輸出與欄位過濾
json_restrictor 可以過濾欄位縮小回應,zero_trace 是不留下搜尋資料的隱私模式參數,適用範圍以官方方案頁當期標示為準。參數細節隨官方文件更新滾動,部署前以當期文件核對。
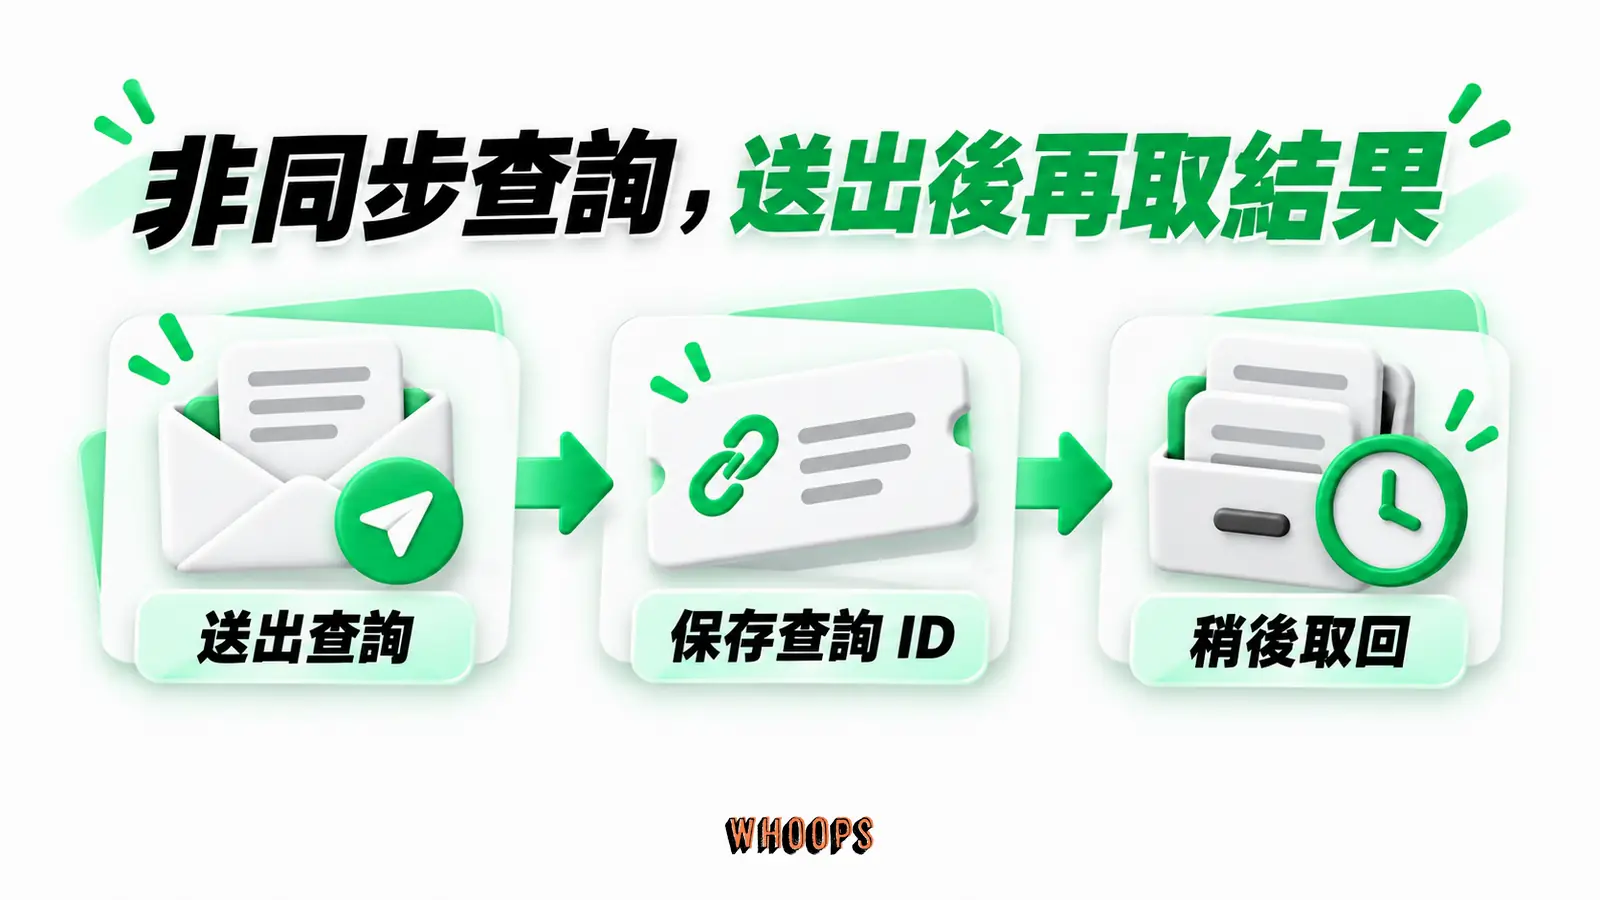
另一組專屬參數處理交付與輸出。async 設成 true 之後,請求交給 Searches Archive API,稍後再回頭取回結果,不必逐筆等回應。代價是它不可與 no_cache 併用,Ludicrous Speed 帳號也不適用,需要絕對新鮮的資料時走同步請求。output 可選 json、html 或 md,md 形態是為 LLM 準備的,要串語言模型的應用直接選它。
計費規則:成功才計費,快取不算錢
什麼算一次有效查詢
官方對計費單位的定義寫得很白:只有成功的搜尋才計入月搜尋數,快取的、出錯的、失敗的搜尋不計。回傳 100 筆結果與回傳空結果集,都算同樣一次搜尋。這句話要讀兩遍,因為它同時定義了收費與不收費的邊界。
由此推導出操作結論。出錯與失敗的嘗試不計額度,重試成功的那次仍照規則計入,因此重試可以設,但要配上退避與次數上限。空結果也是一次成功查詢,用罕見字詞做探測時,每個沒有結果的查詢都還是花一次額度,成本要事先算進去。
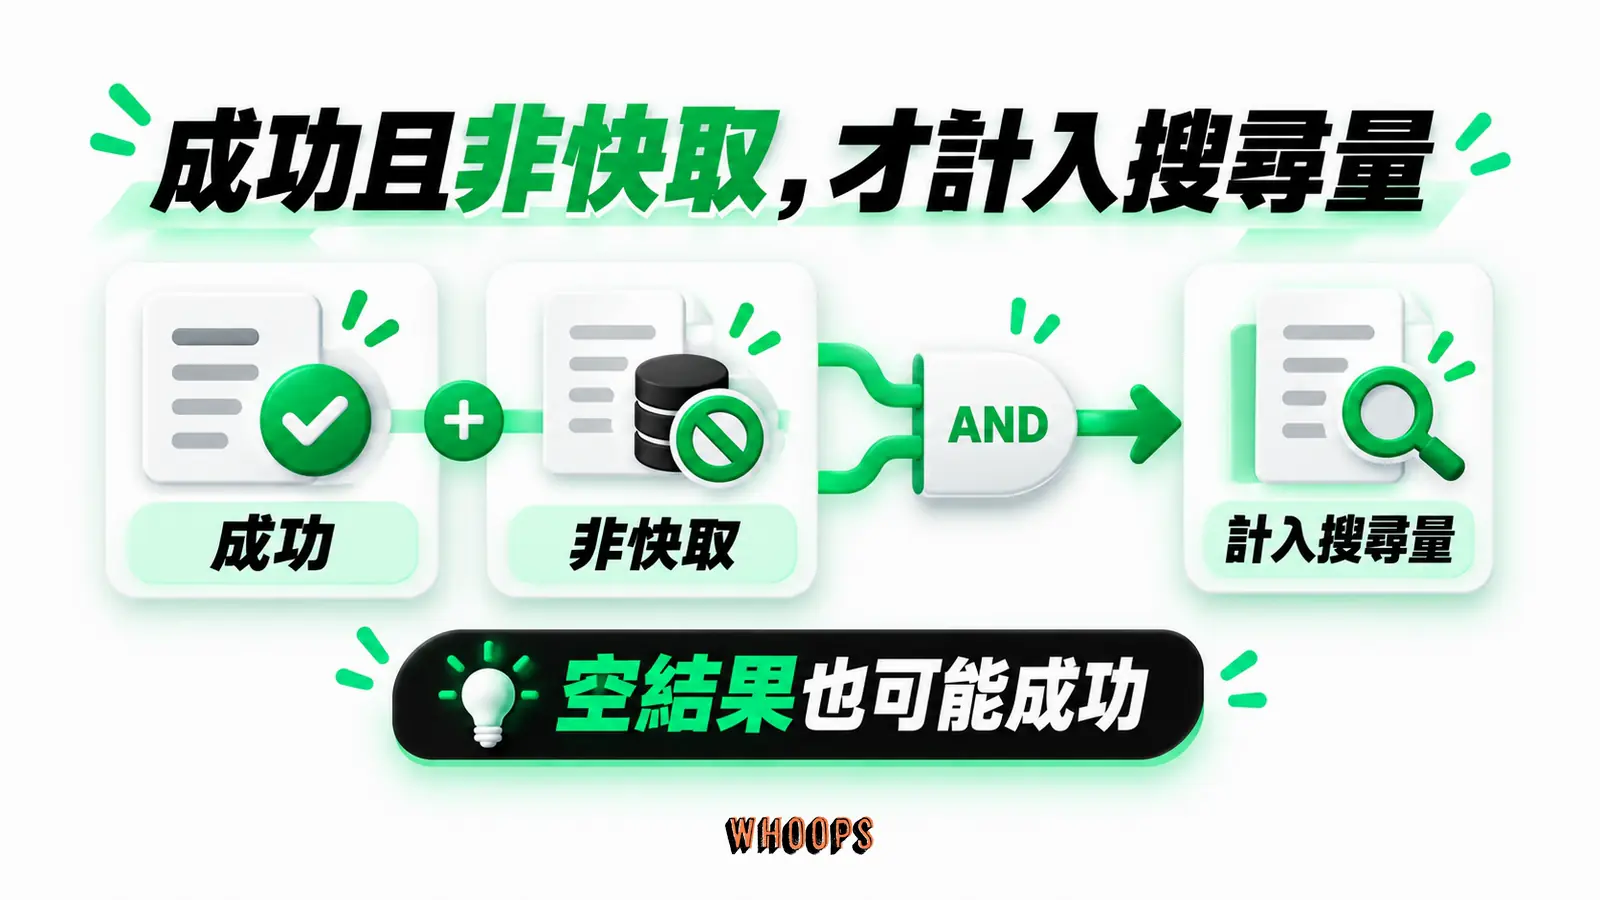
快取規則是另一個關鍵:快取一小時後過期,命中快取的搜尋免費、不計入月搜尋數,要強制重新抓取就加 no_cache=true。同一個小時內的重複查詢,命中的走快取、不計額度。對排名追蹤的影響很直接:變化偵測的間隔要拉超過一小時,間隔內重複查詢可能拿到快取結果,間隔拉不開又必須新鮮資料時,才用 no_cache 換新,代價是每次都計費。
no_cache 的使用可以整理成判斷句:一小時內的資料同質性可接受就走快取,時效會影響決策才強制重抓。內部儀表板每小時刷新一次,走快取剛好。警報系統要當下的排名變化,重抓的額度就該編進預算,兩種需求不要混在同一組查詢裡。
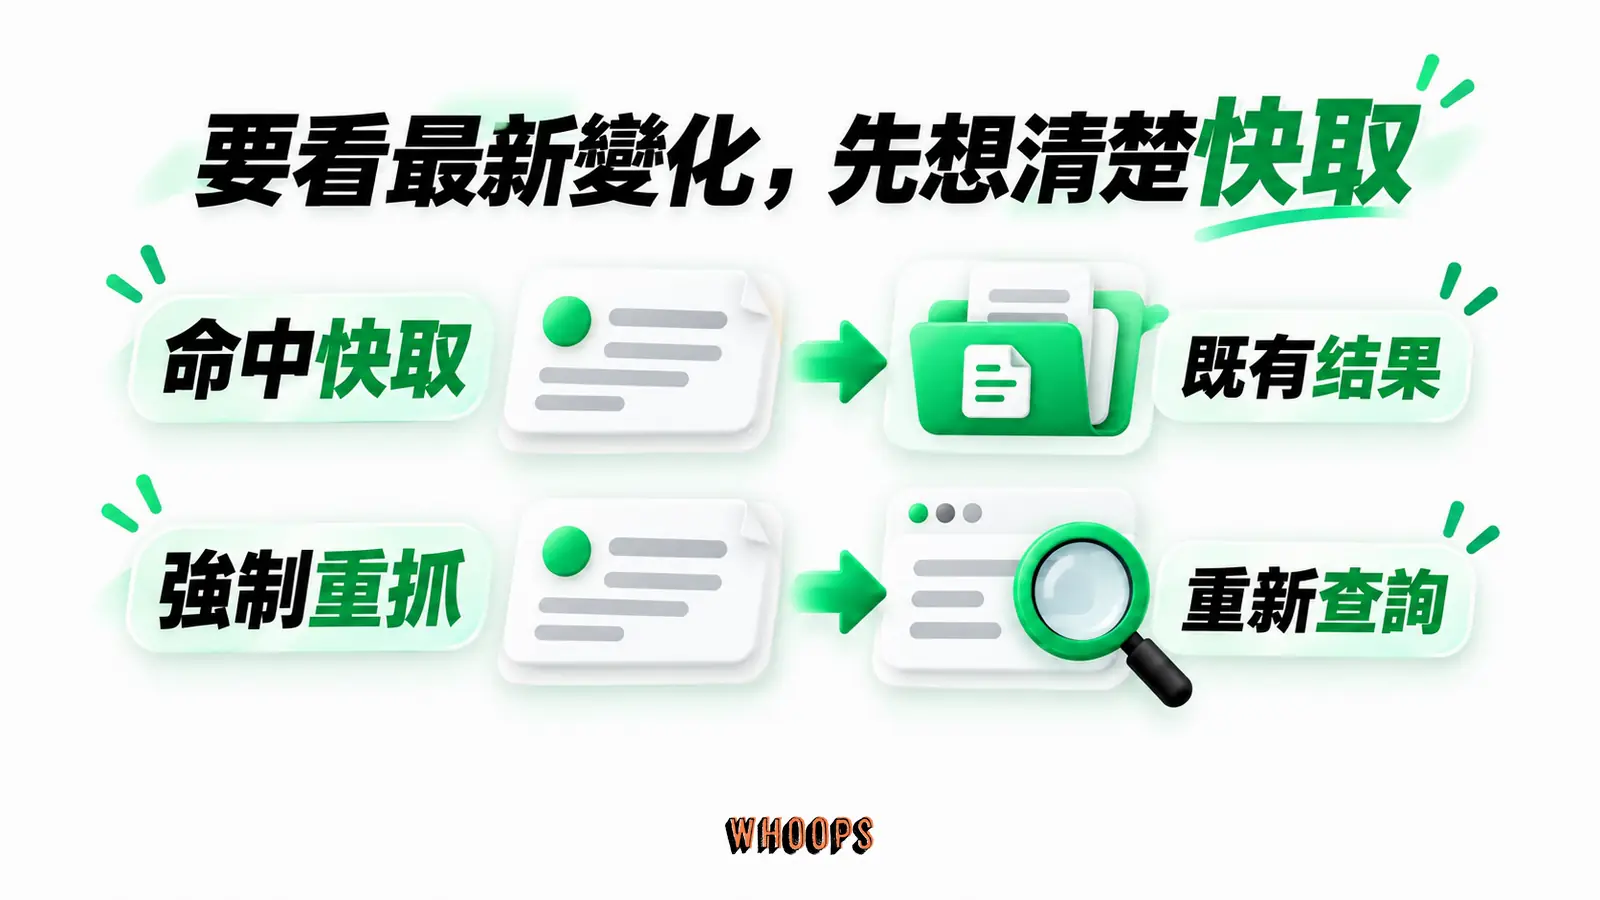
把兩條規則合起來看,控制成本的重點在於減少重複計費的成功查詢,請求次數本身是次要。開發與測試階段把同一組查詢集中在同一小時內跑,重複的查詢若命中快取就不計額度,反覆跨小時重跑同樣的測試,才是帳單無聲上漲的常見原因。
用一個示意情境把規則走一遍。某個小時內,同一組查詢打了 5 次,第 1 次計費,後 4 次假設都命中快取,走免費。隔一個半小時再打 2 次,快取已過期,再計 1 次。期間有 3 次逾時失敗,全部不計。查一個幾乎沒有結果的長尾詞,回空結果集,照樣算 1 次。把這幾條合起來,成本模型就是成功且非快取的查詢次數,乘上方案換算出來的單位成本。
用 Account API 看餘額
帳務判斷不需要猜。Account API 端點免費而且不計入月搜尋數,用 api_key 當參數,回傳 plan_name、plan_renewal_date、searches_per_month、plan_searches_left、extra_credits、total_searches_left、this_month_usage、this_hour_searches、last_hour_searches、account_rate_limit_per_hour 等欄位,足以寫出撞牆前的告警。排程加上餘額檢查,多數 429 可以在觸發前主動處理。
告警的設定不必複雜。每小時固定查一次 Account API,記下 plan_searches_left 與 this_hour_searches,一個看存量、一個看速率,超過自訂門檻就通知。這支呼叫免費,數字直接來自官方帳務,做為成本監控的基礎很夠。額度與金額也要分開看:月搜尋數在續約時補滿,費用在續約時發生,兩者同時發生但意義不同。
把額度換成金額看更有感。以 Starter 換算,一次計入額度的搜尋約 0.025 美元,一個月一千次就是 25 美元,快取省下的每一批重複查詢都是直接的現金。單位成本隨方案量級下降,先把查詢紀律練好,再換到大量級,帳才守得住。
方案、吞吐與帳務細節
方案表與每小時吞吐
方案與價格以 2026 年 9 月 10 日官網定價頁為準,官方隨時可能調整,採購前以當期頁面核對。計費方式是月繳、無長約、隨時取消,目前公開定價頁列 Free、Starter、Developer、Production、Big Data,較高量級請洽 Enterprise;以下僅列目前可核對的公開方案:
左右捲動檢視完整表格
| 方案 | 月費 | 每月搜尋數 | 每小時上限 |
|---|---|---|---|
| Free | 0 美元 | 250 | 50 |
| Starter | 25 美元 | 1,000 | 200 |
| Developer | 75 美元 | 5,000 | 1,000 |
| Production | 150 美元 | 15,000 | 3,000 |
| Big Data | 275 美元 | 30,000 | 6,000 |
| Enterprise | 洽詢報價 | 依合約 | 依合約 |
Production 的欄位在頁面上標註最多人用,可以當作中小型專案的參考點,不代表它適合每個人。更大用量目前在公開定價頁導向 Enterprise 洽談;不要沿用舊 Cloud 級距或公式,採購前應取得當期書面報價。
超過公開方案的查詢量時,先整理月量、每小時尖峰、延遲及支援需求,再請 SerpApi 提供 Enterprise 報價。
目前公開的 Free、Starter、Developer、Production、Big Data 方案,每小時上限均為各自月額度的 20%。Free 的 250 次對應每小時 50 次,Starter 的 1,000 次對應 200 次,表格裡每一列都符合這個比例。更大量級的每小時吞吐應按當期 Enterprise 條款或官方報價確認,不能沿用舊 Cloud 公式。
吞吐是方案保證的每小時成功搜尋數,官方建議把搜尋平均分散在小時內。換算成節奏,Free 的每小時 50 次除以 60 分鐘,平均每分鐘不到 1 次,單批超過每小時上限的任務要拆到多個小時執行,否則 429 會比額度用完更早出現。把每月量除以 720 小時先算出平均每小時預算,再對照方案上限,是排程設計的第一步。
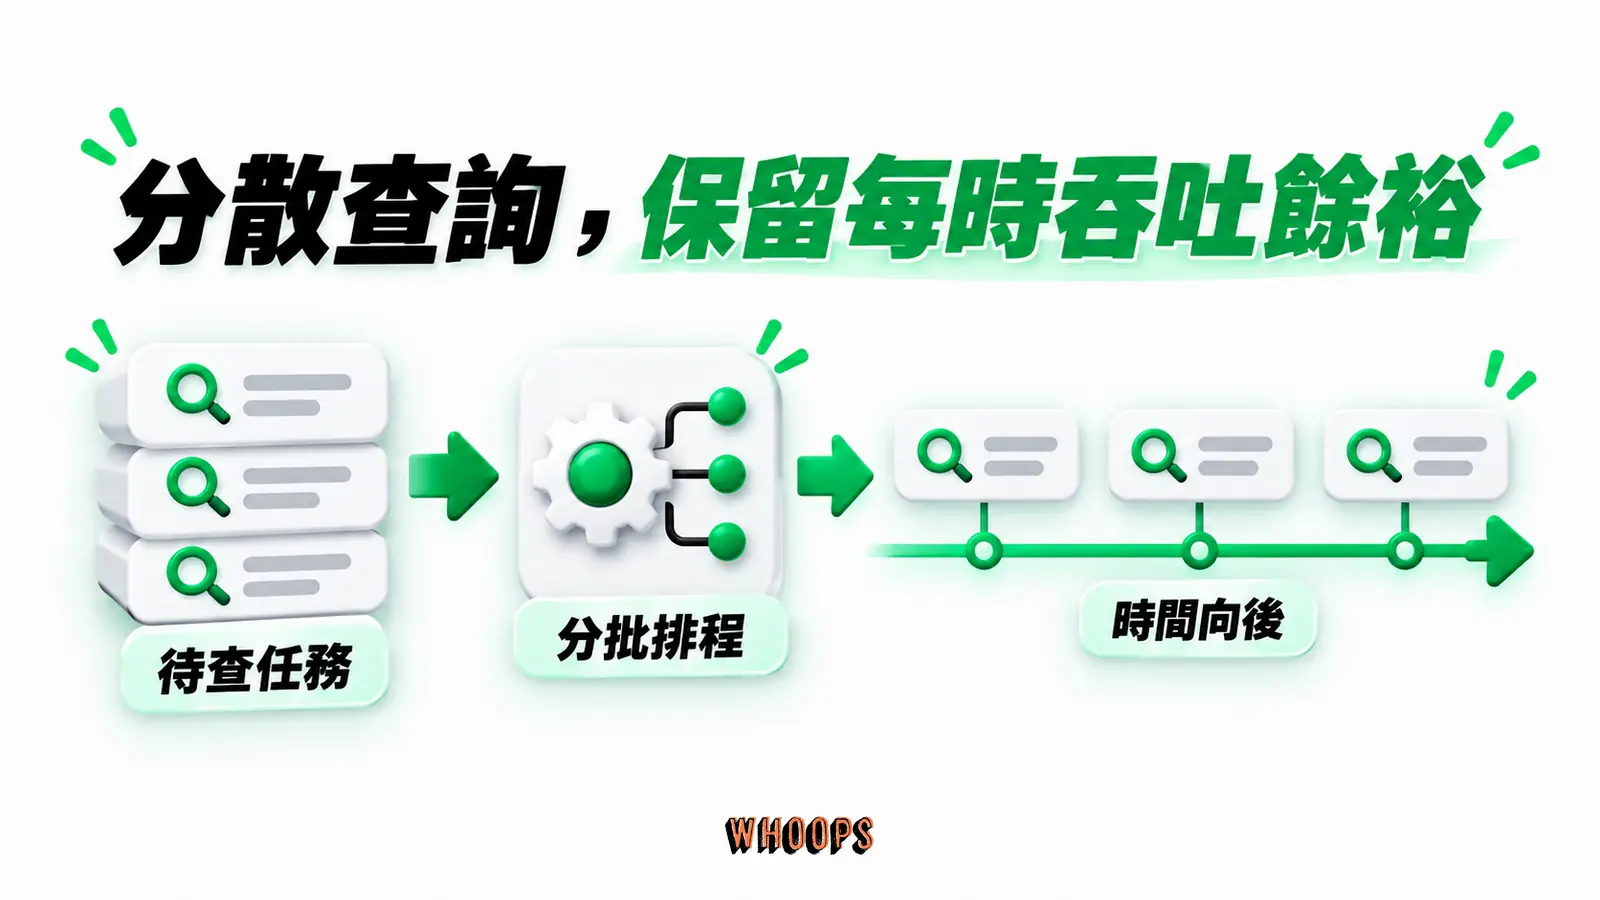
規模化的換算同樣是乘法,以下仍是示意。100 個關鍵字每天查一次,一個月約 3,000 次,落在 Developer 方案 5,000 次的量級內,每小時上限 1,000 次對一天一批的排程也充裕。300 個關鍵字每天一次,一個月約 9,000 次,對應 Production 的 15,000 次。關鍵字數乘頻率乘天數,對照方案表就能選級,誤差主要來自重試與 no_cache 的比例。
大量級用量的吞吐不能套用舊 Cloud 公式;把預估尖峰與總搜尋量交給官方,核對 Enterprise 條款中的速率與費用。
速度模式的價格乘數
需要更快時,速度模式用價格乘數換速度。Best Effort 是 1 倍。Ludicrous Speed 是 2 倍,官方數字是相對 Best Effort 平均快 2.2 倍、p99 快 4.2 倍,出自Ludicrous Speed 頁面。Ludicrous Speed Max 是 4 倍,相對 Ludicrous Speed 平均再快 9.6%、p99 再快 35.4%,基準見Max 產品頁。模式選擇看應用對延遲的敏感度:官方數字換到的是平均速度與尾延遲,排程型的追蹤工作對這兩項的需求,低於即時應用。
超額、退款與方案異動
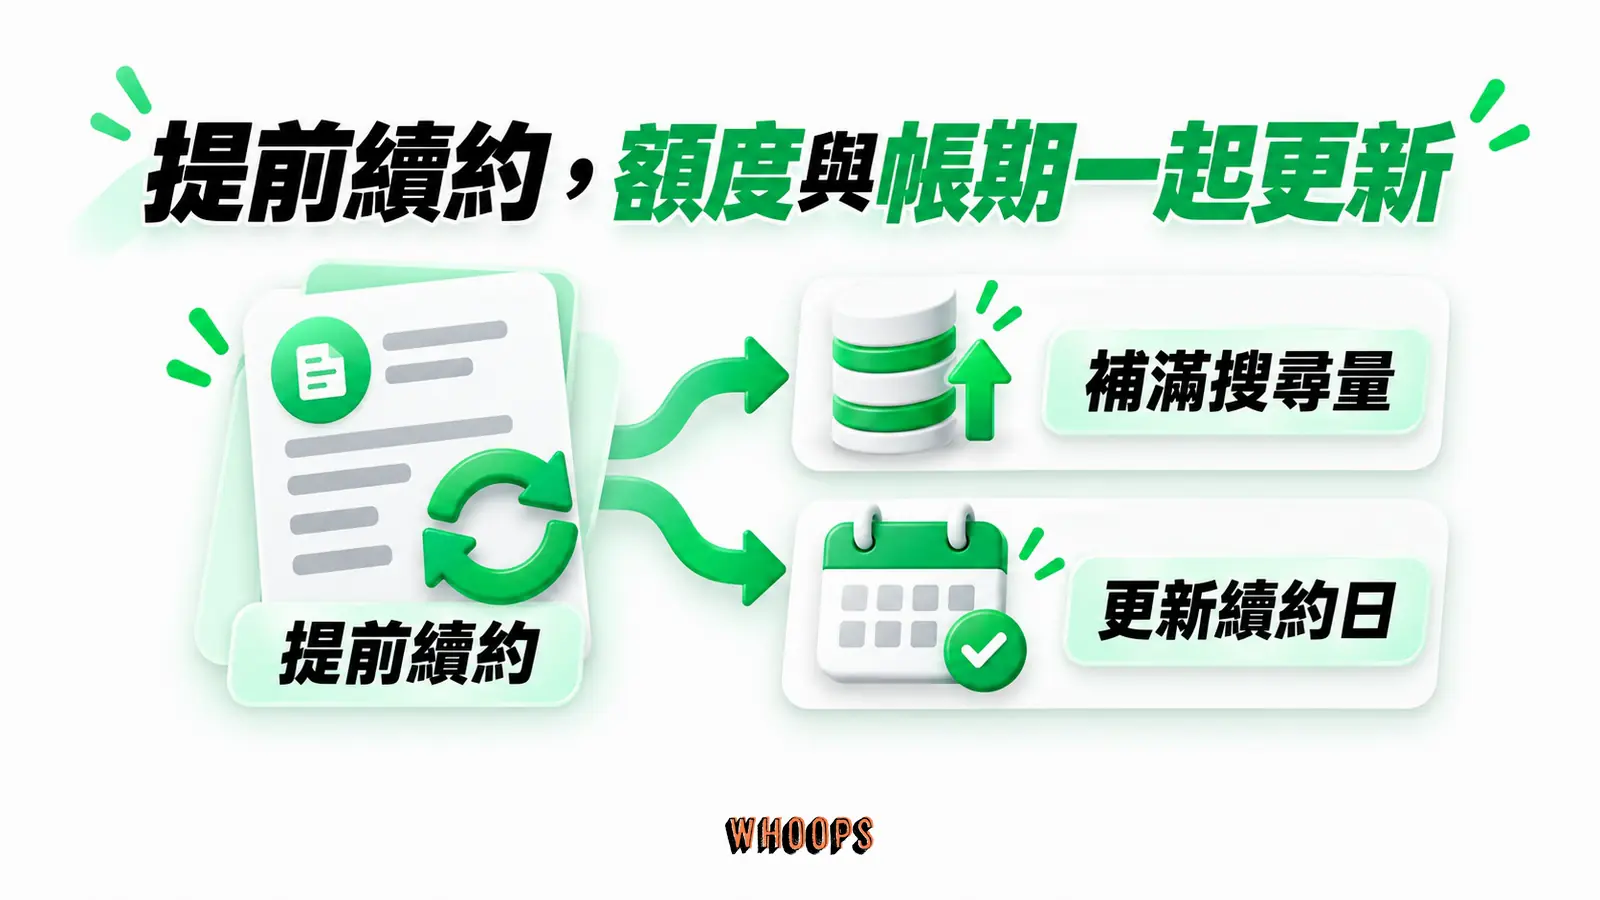
搜尋用完時,官方的設計是自動提前續約,可在方案頁開關,也可以改成手動續約。續約後搜尋數補滿、續約日重設。查證當下的定價頁未見按次計算的超額費,費用提前發生的方式是換一輪帳期,不是加價罰款。不想半夜斷料的人開自動續約,想硬控制預算的人關掉它,改成餘額告警加手動續約。
退款條件是訂閱後 7 天內可全額退款,除非已用超過 20% 的搜尋數。方案異動的規則:升級隨時可做、只補差價、續約日不變。降級保留續約日、之後以較低價續約,剩餘搜尋移入 Extra Credits 額度。取消後到續約日前,剩餘搜尋仍可用。定價頁未見年繳折扣,預算規劃先以月繳計算。
這些規則推出實用的採購節奏:先買小方案、不夠再升,不必一開始就買大。有季節性高峰的專案,高峰過後降回原級,移入 Extra Credits 的剩餘搜尋可以續用。試用期結束要取消,到續約日前的資料蒐集仍可完整收尾。
免費額度的示意算例
以下換算為示意,用免費方案的實數推導。250 次除以 30 天,每天約 8 次。追蹤 20 個關鍵字、每週記錄一次,一個月約 80 至 86 次成功查詢,免費額度夠用還有剩。同樣 20 個關鍵字改成每天查一次,一個月約 600 次,免費額度不夠,要上 Starter 以上。同一小時內的重複查詢若命中快取就不計額度,把查詢集中還能壓成本。實際排程要同時留吞吐餘裕,把整天的批次集中同一小時送出時,每小時 50 次的上限可能比月總量更早到頂。
免費方案也可以當長期的低量基線。個人網站追幾個核心關鍵字、每兩三天記錄一次,可以一直待在免費級。把這條基線與付費方案放在同一張表裡比較,升級時點會更清楚:超過基線且需要每日資料的那一刻,就是切換的訊號。
關鍵字清單的挑選本身也有方法:先看搜尋量與意圖,再決定哪些值得每天追蹤,站上有關鍵字搜尋量的說明可以搭配使用,把免費額度花在值得追的查詢上。
Python 套件:serpapi 與 google-search-results 的新舊地雷
serpapi.Client 五行上手
HTTP 直接呼叫之外,官方的 Python 整合頁提供專用套件,目前的名稱是 serpapi,用 pip install serpapi 安裝,最小可用的版本長這樣:
import os
import serpapi

client = serpapi.Client(api_key=os.getenv("SERPAPI_KEY"))
results = client.search({"engine": "google", "q": "coffee"})
results 是 SerpResults 物件,用起來像標準字典再加上便利函式。原始碼在 GitHub 的 serpapi/serpapi-python 儲存庫,MIT 授權。output 設成 md 時回 Markdown 字串,官方稱平均省約一半 token,要餵 LLM 的應用直接用這個格式。
從舊套件搬到新套件,改動集中在兩處:匯入與初始化從 GoogleSearch 換成 serpapi.Client,取結果從 get_dict() 換成直接操作 SerpResults 物件。搬完之後跑一次對照,同一組參數在新舊套件各查一次,欄位一致就能切換。不需要 SDK 的場景也成立,端點是純 GET,任何能發 HTTP 請求的環境都能用,shell 腳本與試算表的外掛都算。
兩種接法的分工看頻率。長期跑的服務用套件,錯誤處理與逾時設定都現成。一次性檢查用 curl 或任何 HTTP 工具直接打,打完即棄。金鑰都從環境變數來,切換接法不用改金鑰的管理方式。
錯誤處理
失敗時拋 serpapi.HTTPError 或 serpapi.TimeoutError,可檢查 e.status_code:401 是金鑰無效、400 是缺參數、429 是速率或額度,錯誤內容在 e.error。timeout 可在初始化時設定。套件做的封裝不改變計費與吞吐規則,該查的餘額、該分散的排程一樣要做。
實務上把 e.status_code 分三類處理:參數與金鑰類的錯誤發出警示,交給人處理,429 先查 Account API:若是每小時吞吐上限,就降速等待;若是月額度用盡,須補足額度或調整方案,等待本身不會解決,伺服器端的錯誤走有限度重試。分類處理的程式碼不長,卻能讓排程在無人值守的時段自行消化多數狀況。
各引擎查詢鍵不同
換引擎時注意查詢鍵的名字不一定是 q。Yahoo 用 p,YouTube 用 search_query,Walmart 與 Naver 用 query,eBay 用 _nkw,Apple App Store 用 term。寫共用的查詢層時,把引擎與查詢鍵整理成一張對照表,比散落各處的條件判斷好維護。
舊套件 google-search-results 的地雷
PyPI 上的 google-search-results 是早期的官方套件,用法是 from serpapi import GoogleSearch,再呼叫 search.get_dict()。其儲存庫已公告即將棄用、改用 serpapi-python,套件仍標 Python 3.7+ 與 MIT 授權。地雷在命名:舊套件安裝後匯入的模組也叫 serpapi,與新套件撞名,兩者並存的命名混淆是已知問題。環境裡有舊套件時,先移除再安裝新套件,可以省下追查匯入來源的時間。
MCP 入口:讓 AI 助手用同一組額度查搜尋
不想寫程式的人,另一個入口是 MCP。SerpApi 的官方 MCP server 是開源專案 serpapi/serpapi-mcp,MIT 授權,Python 專案用 uv 執行。官方的 MCP 整合頁提供託管端點:網址是 https://mcp.serpapi.com/ 後接金鑰再接 /mcp,走 http 傳輸。官方目前建議用 Authorization Bearer 表頭,讓金鑰不進入網址與一般 URL 日誌;無法設定表頭的客戶端才採網址路徑方式。協定本身的背景,站上有MCP 的介紹可以先補。
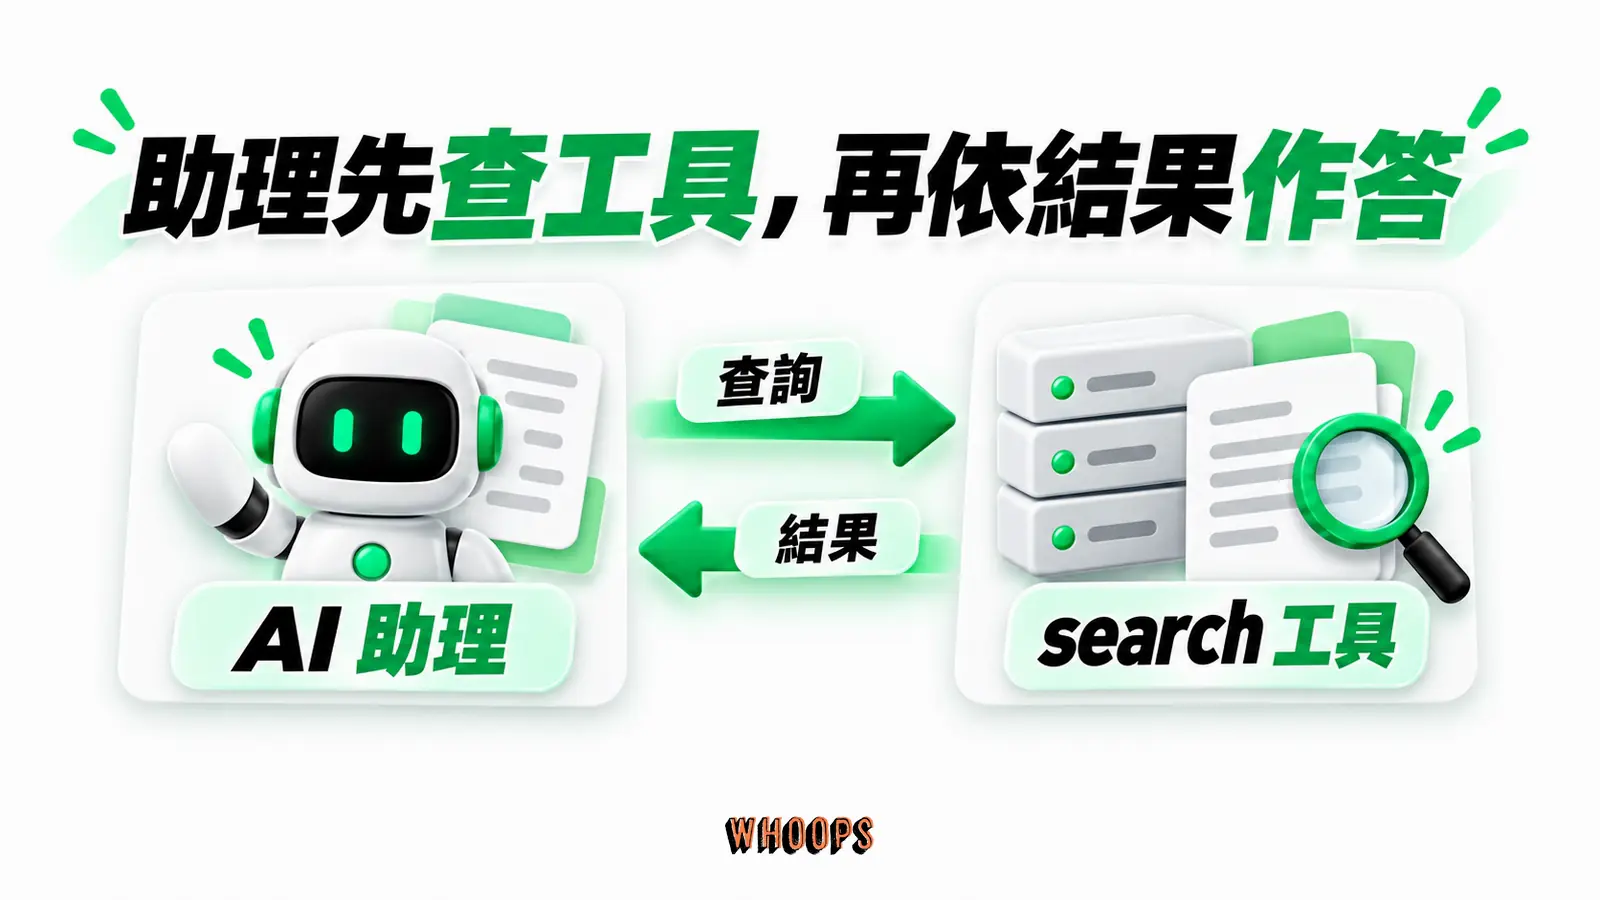
接上之後,查詢可以不離開對話視窗。請助理查某個詞在特定地區的結果,助理呼叫 search 工具,拿到回應後摘要作答。抽查資料、看某個查詢下的結果組成,走的都是同一個工具與同一組額度,非開發者也能用到 SERP 資料。
Claude Code 與 Claude Desktop 的接法
Claude Code 用一行指令掛上託管端點:
claude mcp add --transport http serpapi https://mcp.serpapi.com/YOUR_SERPAPI_API_KEY/mcpClaude Desktop 在設定檔的 mcpServers 區塊加一組物件,type 是 http,url 用同一個託管端點:
{
  "mcpServers": {
    "serpapi": {
      "type": "http",
      "url": "https://mcp.serpapi.com/YOUR_SERPAPI_API_KEY/mcp"
    }
  }
}- Cursor 與 VS Code 有一鍵安裝徽章,裝完即用。
- 其他支援 streamable-http 的客戶端,端點網址同一個。
- 要自架就取回 serpapi/serpapi-mcp 儲存庫,執行 uv sync 之後用 uv run 跑 src/server.py,端點指向本機 8000 埠的相同路徑。
- Claude Desktop 另有 .mcpb 副檔名的安裝包,開檔即裝、以本機 stdio 執行,金鑰放 SERPAPI_API_KEY 環境變數。
四種接法對金鑰的暴露面不同。託管端點可用 Bearer 表頭或網址路徑驗證;官方優先推薦表頭,因為金鑰不會出現在網址及其日誌。網址路徑只適合無法設定表頭的客戶端。自架把端點收回本機。.mcpb 安裝包以 stdio 在本機跑,金鑰走環境變數。照團隊的日誌與安全要求挑一種即可,四種接法連到的工具都一樣。
search 工具與參數
工具面有一個主工具 search,官方說明它涵蓋所有引擎,預設回 JSON。另有選用的 search_table 與 search_dashboard:前者給可排序的結果表,後者給摘要指標、來源分布圖與可展開細節,兩者需要宿主支援 MCP Apps 擴充,對應的提案編號是 SEP-1865,不支援的宿主會直接忽略。設計目的是把大量 SERP JSON 擋在模型的上下文視窗外,避免一次查詢塞爆視窗。沒有獨立的 google_search 工具,查 Google 就是走 search。
search_table 與 search_dashboard 的價值在篩選。結果表讓人用欄位排序找標的,摘要指標讓人先看分布再決定要不要展開細節,兩者都把判斷權留在模型外面,由人下決定。宿主不支援時它們只是安靜不存在,主流程不受影響。
search 的參數:params.q 必填。params.engine 預設 google_light。params.location 做地區過濾。params.output 省略回 JSON,設 md 回 Markdown,官方稱平均砍一半 token 用量。mode 設 compact 會剝掉 JSON 的中繼資料。每個引擎的 schema 以資源形式暴露在 serpapi://engines,模型可以自己查某個引擎吃哪些參數。官方範例呼叫長這樣:
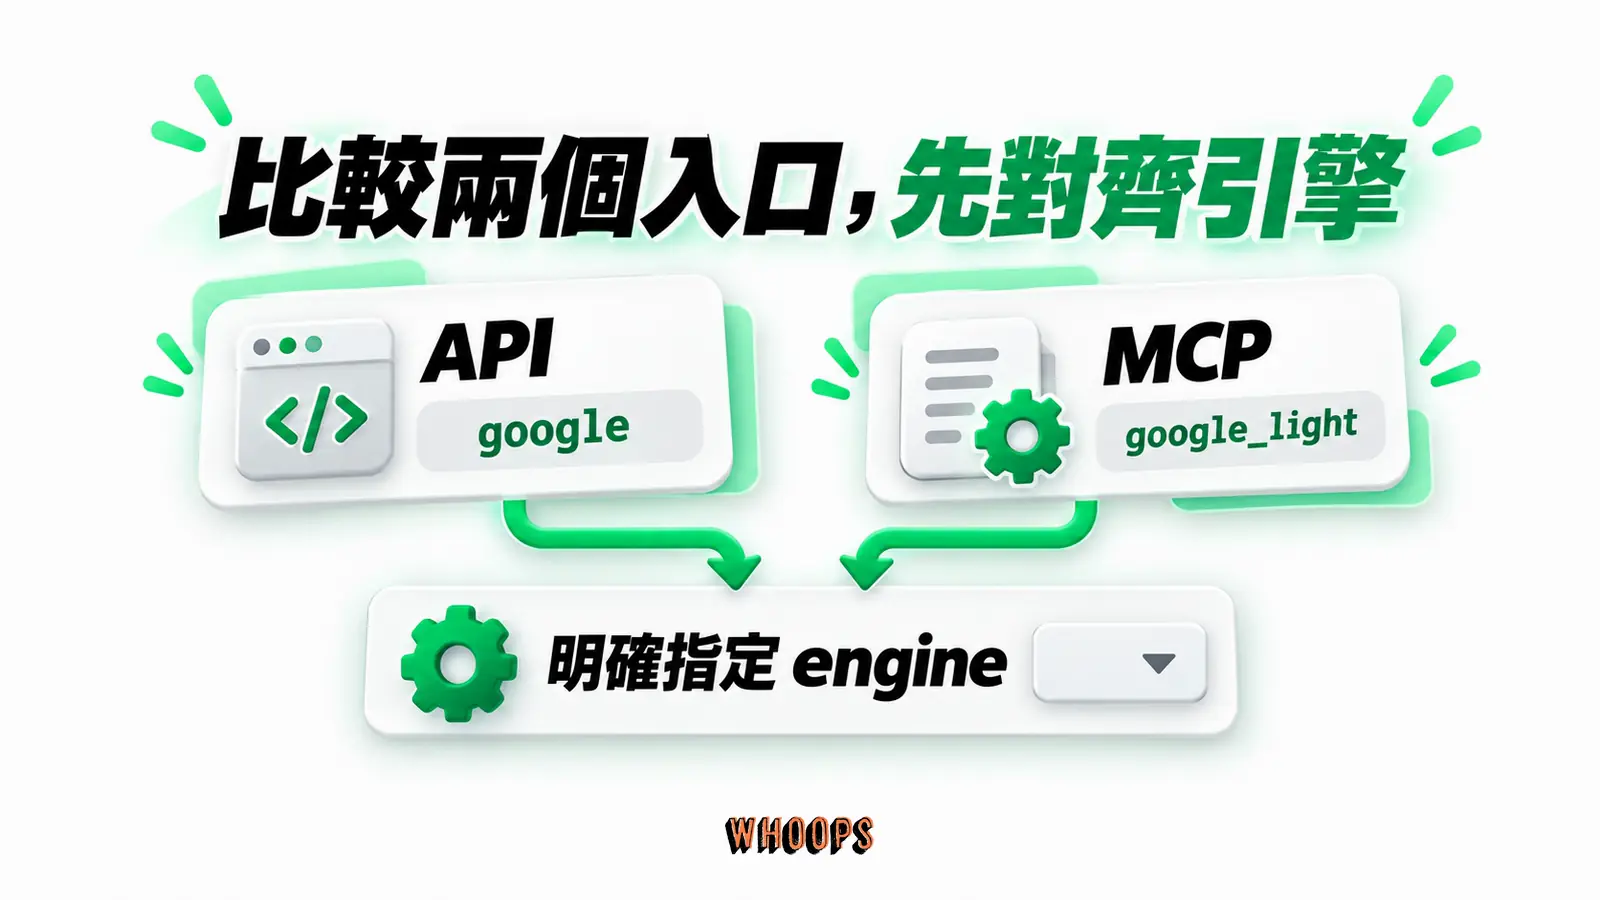
{"name": "search", "arguments": {"params": {"q": "coffee shops", "location": "Austin, TX"}}}一個容易忽略的差異:直接呼叫 API 時 engine 預設 google,MCP 的 search 工具預設 google_light。要與自有程式拿同一種結果,記得在參數裡把 engine 指回 google,兩邊預設值不同,不指定的話結果可能對不上。
用量計在既有訂閱內
MCP 的用量計在既有 SerpApi 訂閱內,沒有額外的工具實作費,速率限制錯誤的官方建議是等待或升級方案。它不是獨立計費的產品線,消耗的就是方案裡的搜尋數,免費方案的 250 次照樣適用。用 AI 助手大量查詢時,額度與速率限制以方案為準,助理不會因為換了入口就多出額度。
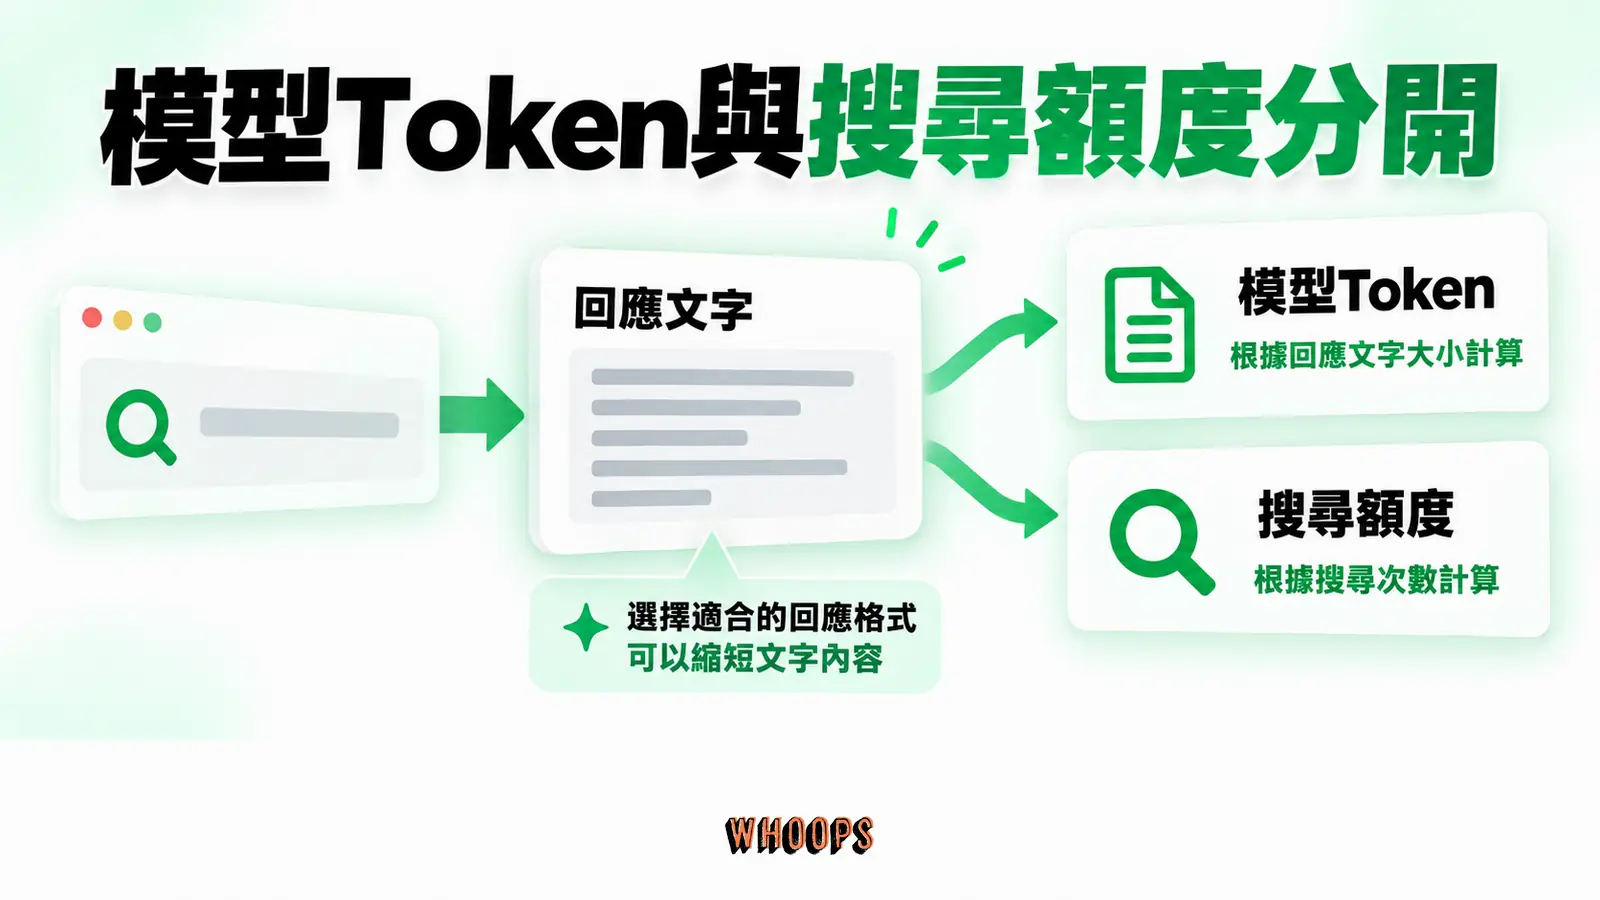
可依任務選擇 Markdown 或 JSON:官方稱 Markdown 平均可減少約一半 token;若用 JSON,mode=compact 可去掉中繼資料。compact 不會再精簡 Markdown,兩種設定不能當成疊加節省。省的是模型的上下文空間,不是搜尋額度,兩種成本要分開管理。要完整欄位做分析時才回 JSON,把省 token 與要資料兩種需求分開配置。
把關鍵字研究整個搬進 AI 助手的人,可以參考站上用 Claude 串資料 API 做關鍵字研究的實例,同一套接法換資料來源就能重用。工具與參數面隨官方更新滾動,接之前以當期文件核對一次。
與 DataForSEO 的關係
SerpApi 與 DataForSEO 常被放在一起討論,兩家都提供搜尋資料服務。核心差異可以先看計費方式:SerpApi 走月訂閱方案,方案內含每月搜尋數;DataForSEO 採預付餘額、按任務計費。需要逐項比較功能與選型條件時,可看SerpApi 與 DataForSEO 選型比較;想先認識 DataForSEO 的運作方式,可讀DataForSEO 基礎介紹。
評價、價格觀感與訴訟現況
社群與評論怎麼說
第三方評分方面,2026 年 9 月 10 日的搜尋摘要顯示,Octoparse 的比較文引用 G2 的 4.8/5與 Trustpilot 的 4.9/5,評論數分別是 28 則與 96 則,評論摘句包含「極度可靠且易於使用」與「非常紮實的 SaaS 產品,容易起步也容易規模化」。這兩組分數與摘句經過轉述鏈,原始頁面的數字會隨時間變動,引用時保留來源與日期。
兩個分數的評論基數都不大,28 則與 96 則的樣本適合當方向參考,撐不起嚴謹的滿意度結論。摘句的性質倒是值得看:收錄的摘句提到可靠、易用與穩定這些字眼。
價格的觀感,社群討論常見「穩定但偏貴」的評價。Reddit 的 r/webscraping 有使用者寫「我喜歡 serpapi。他們算貴,但就是穩定可用」,r/n8n 的討論也有使用者確認「他們偏貴」。討論裡常被點名的替代品包含 Scrape.do、Zyte、Serper、ScrapingBee、SearchApi,以及 Tavily、Exa 這類 AI 原生搜尋服務。各家的價格宣稱來自廠商或第三方,具體數字不引進,方向性的貴或便宜,用自己的量級試算就有底。採購角度的整體工具盤點,可搭配站上的SEO 工具比較一起看。
Google 訴訟的時間線
訴訟是採購前該知道的事。據 Reuters 於 2025 年 12 月 19 日的報導,Google 在美國加州北區聯邦地院對 SerpApi 提起著作權訴訟,案號 4:25-cv-10826,主張 SerpApi 繞過安全防護、以假搜尋抓取並轉售受著作權保護的搜尋結果資料。SerpApi 在官方部落格自述於 2026 年 2 月 20 日聲請駁回,主張「Google 才是世界上最大的爬蟲」。
2026 年 7 月 20 日,法院裁定准予駁回動議,Search Engine Land 以「Google 輸掉對 SerpApi 的關鍵 DMCA 主張」為題報導。搜尋摘要顯示,部分請求被駁回後不得再訴,Google 獲准就部分主張修正再提。CourtListener 的判決檔紀錄顯示,2026 年 9 月 4 日仍有後續文件,訴訟尚未完全落幕。SerpApi 官方部落格的裁定公告屬於官方的自述。
訴訟仍在進行,後續可能變化,對使用的影響無法預先給定論,也不做合法或違法的判斷。採購敏感的專案,把這條風險記進評估清單,定期追蹤進度再決定。
要追蹤的人看兩個位置即可:法院判決檔的更新,與雙方的公告。判決檔給時間點,公告給各自的立場,都是公開資訊,不需要法律背景也能持續關注。服務面的任何變動,以官網當期說明為準。
保障與合規面
官方提供的保障數字:SLA 99.95%,官方說明所有方案適用、罰則額度 100%,進階支援文案提及可達 99.97%。安全認證有 SOC 2 Type II、SOC 3 與 ISO 27001,清單見官方安全頁。U.S. Legal Shield 內含於 Production 方案以上,保障額度達 200 萬美元,官方的描述是涵蓋合法用途下的搜尋引擎資料抓取與解析。ZeroTrace 模式讓搜尋參數、檔案與資料不留存,它在官網首頁與定價頁的適用方案標示不一致,以官方方案頁當期標示為準。
把保障面整理成採購檢查表:SLA 與罰則額度、安全認證、退款期限、方案異動彈性、訴訟風險、U.S. Legal Shield 的適用層級。每一項都有官方數字或日期可對,評估時逐項確認,比憑印象打分容易向決策會議交代。社群裡的「偏貴」評價,對照包含的驗證碼處理、代理網路與 SLA 之後,才會變成可以討論的命題。
下一步
收在同一組行動上。10 分鐘內做完三件事:註冊帳號、到後台複製私密金鑰、用 q 與 api_key 打出第一支請求,回應裡看到 organic_results 就算打通。
卡關時照著對號入座:回應是 400 先檢查 q,401 先回金鑰頁確認,429 先看 Account API 的存量與速率兩個數字。三種情況都有明確的下一步,不會停在錯誤訊息前面。
同一天,接上 Account API,把剩餘額度與每小時用量印出來,對照方案表判斷免費額度夠不夠。同一週,用示意算例換算自己的關鍵字清單與查詢頻率,決定方案層級,再把 MCP 掛進 Claude,讓同一組額度多一個入口。
方案價格與訴訟進度都會變動,擴大用量前回官網核對當期數字,再決定下一步。