PageSpeed Insights 判讀指南:先看誰的體驗,再看分數
PageSpeed Insights 報告上半部是 CrUX 真實訪客統計、下半部是 Lighthouse 模擬測試,兩種證據要分開讀:本文拆解網址與來源層級、樣本不足退回順序、第 75 百分位燈號與僅缺 INP 的評估規則,釐清 PSI、Search Console、DevTools 與 CrUX 分工,再用假設案例走完排序與驗收。
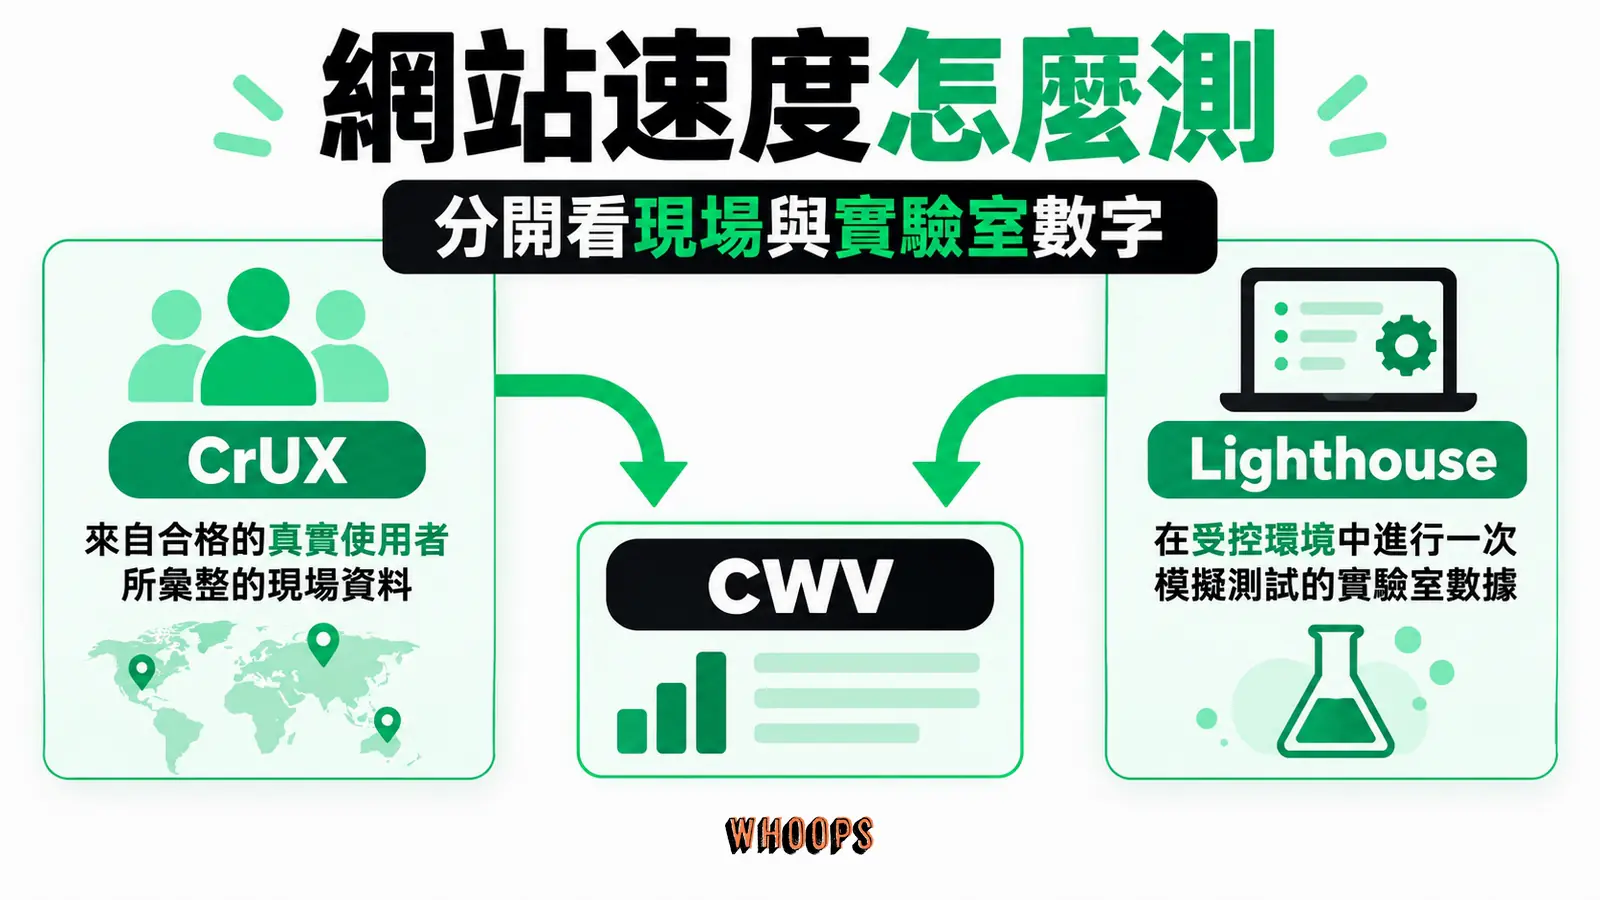
PageSpeed Insights(常被簡稱 PSI)是 Google 免費提供的網頁效能檢測工具:貼上一個公開網址,它會回給你一份報告,裡面同時裝著兩種性質完全不同的資料。上半部是「真實訪客資料」,來自 Chrome 使用者體驗報告(CrUX)的實測統計,回答「訪客用得順不順」;下半部是 Lighthouse 在模擬環境裡跑出來的分數與診斷,回答「這次載入可能卡在哪」。判讀這份報告的關鍵順序只有一句話:先確認資料在說誰的體驗,再看燈號,分數擺在末位。順序顛倒,就會出現「我們 95 分了為什麼還有人抱怨慢」或「沒有資料是不是就代表通過」這兩種最常見的誤讀。
幾個會直接改變結論的事實先講清楚。真實訪客資料以PSI 官方說明為準:它統計的是過去 28 天、以第 75 百分位呈現的體驗,而且只涵蓋符合回報資格的 Chrome 使用者,不是你的全部訪客;單一網址樣本不足時,報告會退回「來源層級」的全站彙整資料,來源層級也沒資料時,報告就無法提供任何真實訪客資料,而缺資料只代表「無法判定」,不代表通過。下半部的 Lighthouse 效能分數,官方色階是 0 到 49 不佳、50 到 89 需要改善、90 到 100 良好,官方同時明說 100 分極難達成、也不是預期目標。分數是模擬環境裡單次載入的診斷結果,燈號才是多數訪客體驗是否達標的證據,兩者可以同時一綠一紅而不矛盾。
這篇以 Google 官方文件為本寫成,主要引用來源為 PSI 說明、Lighthouse 分數文件、CrUX 方法論與 Google 搜尋的網頁體驗說明,查證時間為 2026 年 10 月;文中示範用的站點情境均為假設案例,會逐一標明。速度測試的完整方法論(固定條件量測、瓶頸分類、回測節奏)站上另有七步流程的深度拆解,這篇聚焦在 PSI 這個工具本身的報告判讀:每個數字是誰量出來的、在什麼條件下有效、判讀到什麼程度就該停手。
快速重點:PSI 報告上半部(CrUX 欄位資料)以第 75 百分位呈現多數觀測體驗是否達標,受影響的比例另看分布長條;下半部(Lighthouse 模擬)提供改善線索。先看資料層級是網址還是來源,再對三個門檻看燈號,分數只當診斷參考。90 分以上良好,100 分官方明說非預期;沒有欄位資料只代表無法判定。僅 INP 樣本不足時仍可依 LCP 與 CLS 評估,缺 LCP 或 CLS 則無法評估。
一份報告、兩種證據:上下半部各自證明什麼
把報告切成兩半看,閱讀壓力會小很多。上半部「真實訪客資料」來自 CrUX 資料集:Google 從符合資格的 Chrome 使用者身上蒐集實際瀏覽體驗,彙整成過去 28 天的統計,每天更新。它的價值在於「證據」兩個字,模擬測試再怎麼跑,都造不出真實裝置、真實網路、真實廣告投放下的體驗,只有欄位資料能告訴你訪客真的遇到了什麼。它的限制也很明確:指標種類少、看不到個別訪客、也定位不了原因。官方說明直接建議,lab 資料適合除錯,欄位資料適合確認真實體驗,兩者用途要分開。
下半部由 Lighthouse 在模擬環境裡產生,PSI 官方把它稱為 lab diagnostics,提供效能、無障礙、最佳做法、SEO 四類檢查。它的價值在於「可對照」:同一個網址、同樣的模擬條件,重跑幾次通常能得到相近的結果,比本機自行量測更容易建立一致的基準,因此適合當改善前後的對照依據,也適合交給工程師重現問題,但別把它當成百分之百的承諾,分數仍會浮動。它的限制是模擬就是模擬,手機模式跑在中階裝置加行動網路的組合上,跟你訪客手上的旗艦機、光纖網路或公司防火牆都不一樣。
在畫面上辨認兩半很直觀:欄位區塊會標明「過去 28 天」的期間、指標名稱後面跟著分布長條與一個百分位數值,有時則會標明這一頁的樣本不足、欄位資料退回了整個來源的層級;模擬區塊則以幾個圓形分數開場,下面接著機會(Opportunities)與診斷(Diagnostics)清單。看到分布長條與 28 天字樣,你在讀統計;看到圓形分數與建議清單,你在讀一次受控實驗。認出自己正在讀哪一種,比記住任何單一數字都重要。
兩種資料各自看得到的問題也不一樣,這決定了排錯時該先問哪一邊。只有欄位資料看得到的:地區與裝置差異(同一頁對光纖環境的訪客與低速行動網路的訪客,體驗不同)、載入後的互動卡頓、廣告投放變動造成的週期性波動、真實快取狀態下的重訪體驗。只有模擬環境給得出的:單次載入的完整資源瀑布(哪個請求擋住了渲染)、阻塞鏈的先後順序、可重複對照的量化基準。排錯的時候先把問題分類,再決定信哪一邊,會省下大量互相矛盾的困惑。
很多判讀爭議都源自把兩種資料混著讀。正確的對應關係是:主張「多數訪客的體驗達標與否」,看上半部的燈號與分布長條;主張「問題出在某張圖或某段程式」,靠下半部的診斷找線索。用 92 分的模擬成績反駁訪客抱怨,或用欄位資料的橙燈直接斷定是哪支外掛拖慢,都跨過了各自證據的邊界。當兩邊結論不一致時,那不是誰對誰錯,是兩種資料本來就在講不同條件下的事,後面會專門拆。
讀報告的第一個動作:確認資料在說「誰」
打開報告,在看任何數字之前先確認三件事:裝置分頁(手機還是電腦)、資料層級(這個網址,還是整個來源)、資料是否存在。三件事各自獨立,忽略任何一件都會讓後面的判讀失去意義。這一步不需要任何技術背景,只是養成先看標籤再看數字的習慣。
資料層級最容易被忽略。PSI 的欄位資料有兩種呈現粒度:網址層級代表你貼進去的這一頁;來源層級(origin)代表整個網站,官方的定義是以 https://www.example.com 這類網址定址的完整站點,涵蓋網站所有頁面的全部體驗。判定順序是固定的:網址樣本充足就顯示網址層級;頁面太新或真實訪客太少,就退回來源層級的彙整;連來源層級都不夠,報告就無法顯示任何真實訪客體驗資料。所以報告上標著「來源」二字時,那些燈號說的是全站的加總體驗,把它當成任何單一頁面的成績單都會失真:流量大的頁面主導著這組數字,冷門頁的狀況則會被整站平均掉。
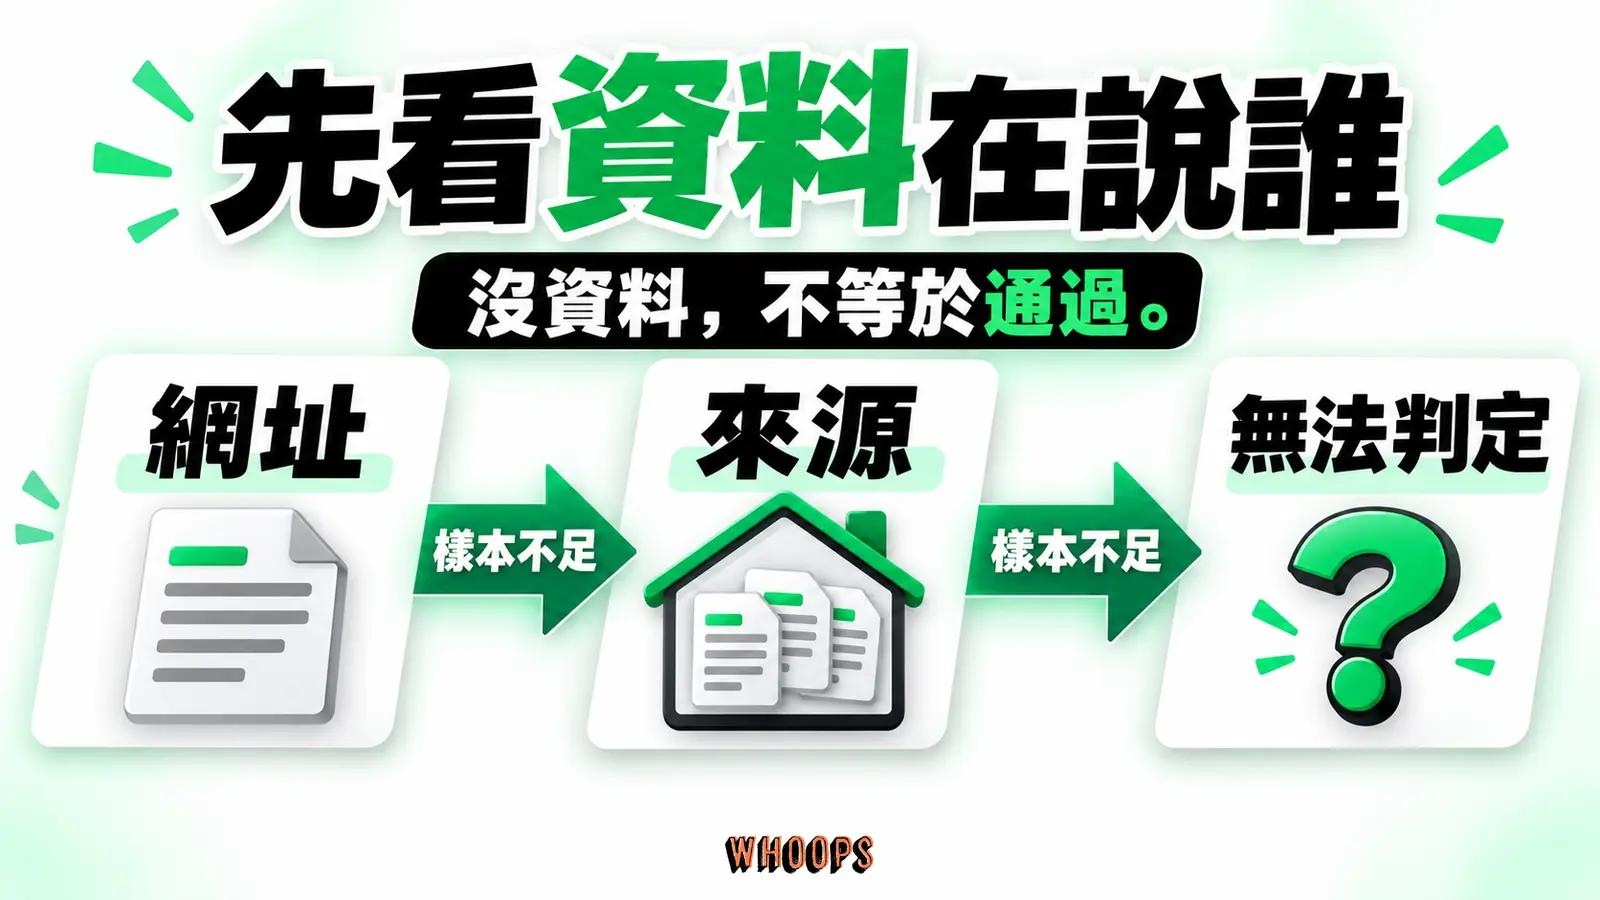
「沒有資料」的判讀也要照規則來。官方 FAQ 列過幾個常見原因:頁面剛發布、真實使用者樣本太少、頁面未達資料集的收錄門檻。CrUX 方法論補上了關鍵細節:頁面必須「公開可探索」,用的是與搜尋引擎相同的可索引性判準,HTTP 200、無 noindex 設定,而且要「夠熱門」,最低訪客數未公開。這代表一頁長期測不到欄位資料,有可能是能見度問題而非速度問題,值得順手檢查頁面的索引狀態;但反過來說,沒資料就只是沒資料,官方寫得很直白,此時無法顯示任何真實使用者體驗,判讀上既談不上良好也談不上不通過,你需要的是另一種量測方式,不是焦慮。
實務上要摸清自己網站的資料分布,做法是抽測而非通測。挑首頁、一兩個主力分類頁、幾篇近期有流量的文章頁,分別貼進 PSI 看哪些頁面拿得到網址層級資料。通常的結果是:首頁與高流量頁有自己的資料,長尾頁全部落在來源層級。這份抽測名單就是你的「可監測頁面群」,之後追蹤改善時盯著這幾頁,比每次隨機測一頁然後被層級差異搞得團團轉有效率得多。
還有兩個藏在方法論裡的細節,會影響你對「這一頁」的想像。第一個是 CrUX 會把網址裡的查詢參數與錨點剝掉再彙整,多數時候這是好事,同一頁的各種追蹤參數版本會合併計算;但官方也提醒,若你的網站用 ?productID=101 這類參數區分不同商品頁,它們可能被併成同一筆資料。第二個是單頁應用程式(SPA)用 JavaScript 切換畫面,使用者看來換了頁面,底層的體驗卻都歸因到最初載入的那個網址。這兩種情況都會讓「網址層級」的燈號與你認知的頁面邊界對不上。
裝置分頁則要分開判讀、不要平均。手機與電腦的欄位資料來自不同的訪客群,Lighthouse 也用不同的模擬條件各跑一次,兩邊的分數與燈號本來就可能差一大截。實務上優先看訪客占比高的那一側,多數內容站的流量以手機為主,就把手機報告當主戰場,電腦綠燈不能抵銷手機橙燈。
三個燈號怎麼讀:第 75 百分位、門檻與樣本不足的評估規則
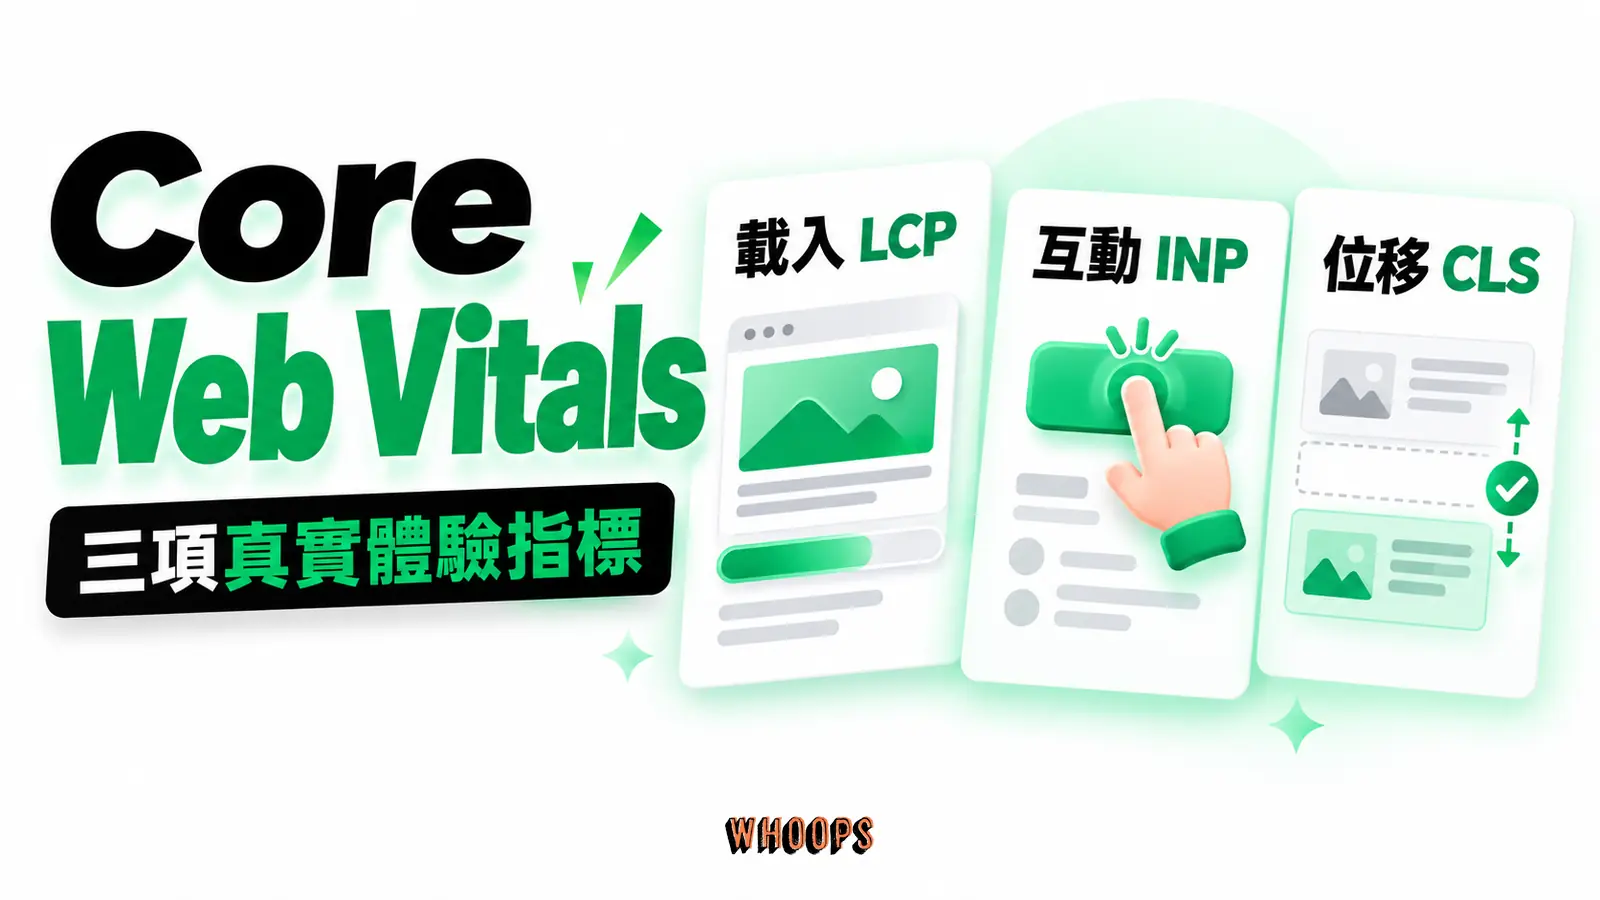
Core Web Vitals 的三項指標,門檻在Web Vitals 的官方定義裡寫得很清楚:LCP(最大內容繪製)2.5 秒內、INP(互動至下次繪製)200 毫秒內、CLS(累計版面配置位移)0.1 以內。用訪客的話來說:LCP 問的是「頁面上最大的那塊內容(通常是首圖或大標題區)多久才出現」,INP 問的是「我點下去之後,畫面多久才理我」,CLS 問的是「我要點的按鈕會不會在我點下去的前一秒被廣告推走」。三個問題分別對應載入、互動與視覺穩定三種性質不同的體驗面向,門檻則是官方用來判定良好體驗的建議標準。
PSI 的欄位區塊會為每項指標畫出綠、橙、紅三段分布長條,並在最上方標一個數字。那個數字是第 75 百分位,也是評估的唯一依據。它的意義要讀對:LCP 顯示 2.4 秒,代表 75% 的觀測體驗不超過 2.4 秒,同時也代表有四分之一的體驗比這更慢;官方選這個位置,是為了讓多數使用者體驗良好時才算過關,刻意看往偏慢的那一端。所以綠燈的合理解讀是「四分之三的訪客在門檻內」,不能推論成「每個訪客都順」。
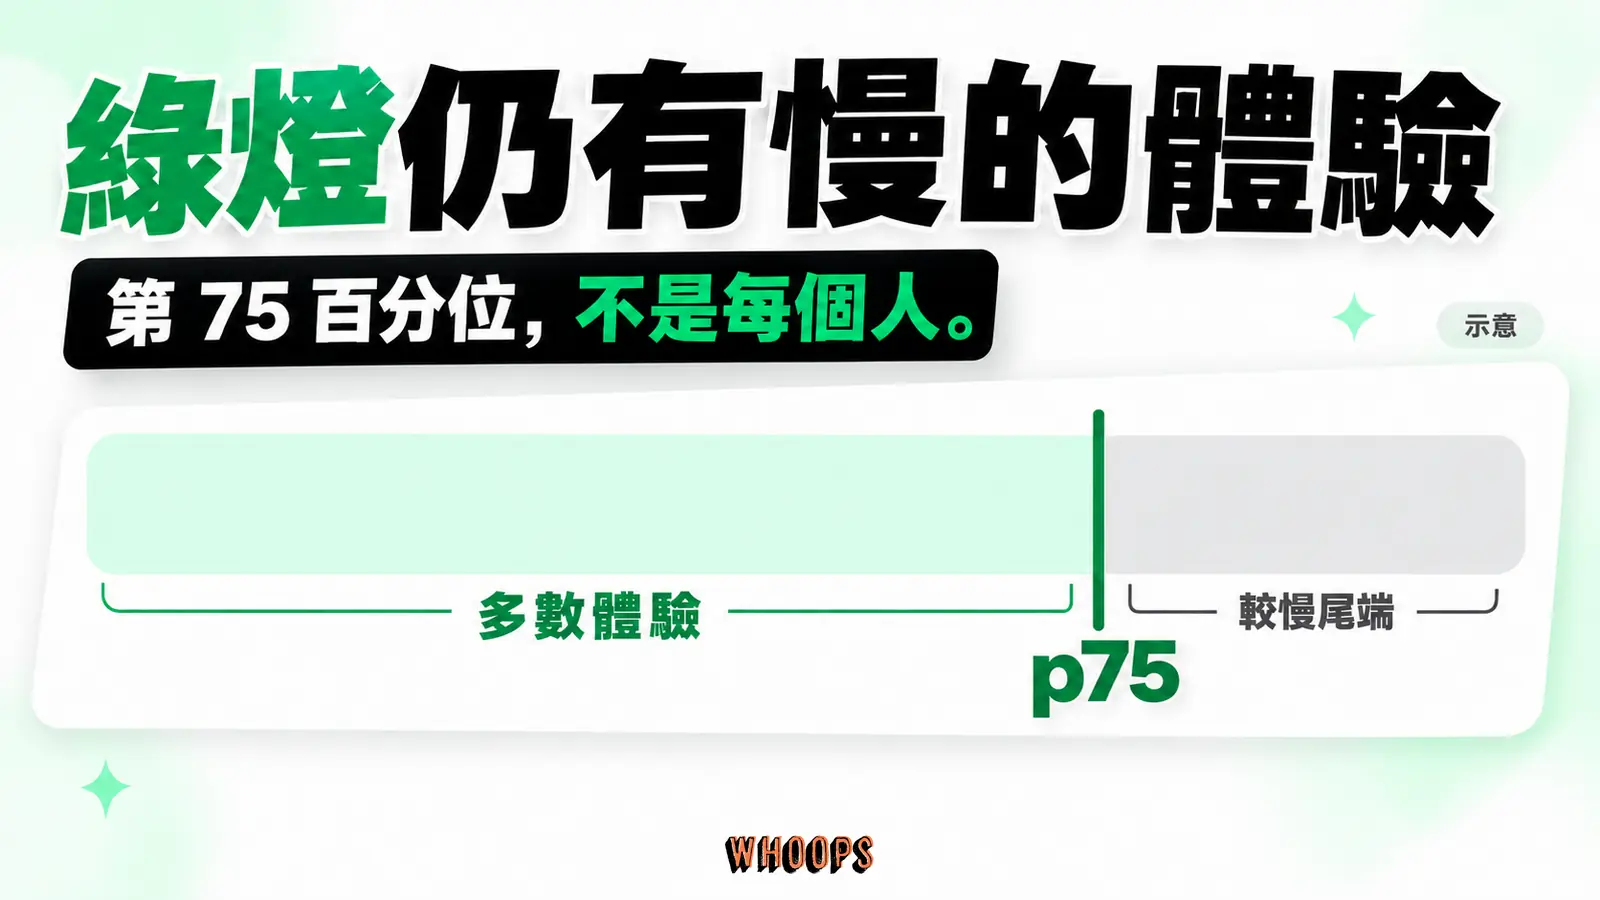
分布長條比百分位數字更值得細看,因為它把「少數人有多慘」攤開了。舉個假設的讀法:某頁 LCP 的長條顯示綠 78%、橙 15%、紅 7%,第 75 百分位 2.3 秒落在綠色門檻內。燈號綠了,但那 7% 的紅色代表一部分訪客等了超過四秒才看到主要內容。把比例放回流量脈絡感受一下規模:若這頁一天三千次瀏覽、而且全部訪客的分布與這個 Chrome 樣本相近,粗估相當於每天約兩百次等待超過四秒的載入。要記得兩個前提:CrUX 給的是觀測樣本的比例,不是全體訪客的人數,這裡只是把比例放回流量情境的粗估。官方文件也給過同型的例子:LCP 橙色長條 11%,意思就是 11% 的觀測值落在 2.5 到 4 秒之間。燈號決定評估結果,占比決定改善的急迫感,兩個都要看。
三種燈色的含義也各自不同,別只看成及格與不及格。綠色代表第 75 百分位落在良好門檻內,多數體驗過關;橙色代表第 75 百分位落在「需要改善」帶,至少有四分之一的體驗沒有達到良好門檻;紅色代表第 75 百分位本身落在最差那一級,至少四分之一的訪客體驗比「不佳」門檻還慢,急迫性完全不同。LCP 3.1 秒的橙燈與 4.5 秒的紅燈,雖然都不「通過」,紅燈卻保證至少四分之一的體驗落在最差那一級,橙燈沒有這個保證,差距在受害的深度與急迫性;至於受害的規模,要回到分布長條的占比才算得出來。把燈色與分布占比放在一起讀,你對「該多急」的判斷會比只看通過與否精準得多。
Core Web Vitals 的通過判定有一套明確的樣本規則,這是 PSI 判讀最容易漏掉的一段。官方寫的順序是:三項指標資料都充足時,三項的第 75 百分位都要是綠色才算通過;只有 INP 資料不足時,LCP 與 CLS 兩項都綠仍可通過評估;但只要 LCP 或 CLS 任一項資料不足,這個頁面或來源就「無法評估」。換句話說,看到「通過」兩個字時,心裡要自動補上適用條件:這是在可用樣本上的判定,INP 可能根本沒參與計分。互動少的內容頁正好常落在這種情況,訪客不點按鈕,INP 樣本自然少,通過是真的,但「互動流暢」四個字不在保證範圍裡。
時間感也要建立起來。欄位資料是滾動的 28 天視窗,每天更新,這代表部署修正之後,新體驗要一天一天摻進統計、舊體驗要一天一天退出去,數字是漸變而非跳變。修正上線當天就期待燈號轉綠並不合理;相對地,也不必傻等滿 28 天,趨勢通常在中段就能看出方向。PSI 的資料每天更新這件事還有另一個用處:同一頁連續幾天的燈號變化,比單日的截圖更值得留存。
欄位區塊裡的兩個補充數字可以當線索,別升級成主角。FCP(首次內容繪製)與實驗性指標 TTFB(首位元組時間)同樣以第 75 百分位呈現,官方也給了門檻(FCP 1.8 秒、TTFB 800 毫秒);TTFB 偏高時,問題方向常指向伺服器回應或轉址鏈;FCP 過關而 LCP 越線,代表畫面有東西出現了、但最大的那塊內容拖在後面,嫌疑集中在首圖或主要區塊的載入路徑。它們不在 Core Web Vitals 的計分範圍裡,紅了不必急著當成災難,先拿來輔助定位問題的層次。
Lighthouse 分數:模擬環境裡的一次載入,被壓縮成一個數字
下半部的四個圓形分數裡,效能分數最常被單獨截圖、單獨流傳,也最常被過度解讀。先看它怎麼來:PSI 在 Google 資料中心跑 Lighthouse,手機模式模擬中階裝置(官方文件舉的例子是 Moto G4)加行動網路,電腦模式模擬有線連線的桌機,測試位置在北美、歐洲或亞洲的機房之一。你的網頁在這套固定條件下載入一次,各項指標被換算、加權,壓縮成一個 0 到 100 的數字。它很會回答「在這套條件下這次載入表現如何」,完全不回答「我的訪客覺得快不快」。機房位置這一點也有實務含義:若你的訪客集中在台灣,而測試從歐洲機房出發,跨洋延遲會先反映在伺服器回應類指標上,這是條件差異,不一定是你的主機慢。
分數帶的官方定義沒有神祕空間:Lighthouse 的分數文件寫明 0 到 49 紅色不佳、50 到 89 橙色需要改善、90 到 100 綠色良好。值得連同記住的是官方對 100 分的態度:達成極為困難、也非預期,並給了一個具體換算,從 99 分推到 100 分所需的指標改善量,大約等於從 90 分推到 94 分。官方用這個換算給了「要不要再拚最後幾分」一個基準:換句話說,同樣幅度的指標改善,在 90 分附近能換到四分,在 99 分附近只換到一分。這幾分值不值得投入工程資源,官方沒有替任何人回答,但換算本身已經說明:把同樣的改善量花在分數較低的頁面,帳面效益大得多。
分數的組成也值得看一眼,因為它解釋了「為什麼改了圖片分數不動」。以 Lighthouse 10 的權重為例:TBT(總阻塞時間)佔 30%,LCP 與 CLS 各佔 25%,FCP 與 Speed Index 各佔 10%。每個原始指標值依一條從真實網站資料(HTTP Archive)導出的分布曲線換算成分數,第 25 百分位對到 50 分、第 8 百分位對到 90 分,曲線在高分段越走越陡,官方描述為報酬遞減。這套機制一起說明了兩件事:權重高的指標變動對總分影響大;總分越高,每加一分要付的改善量越大。權重表本身也曾改版,Lighthouse 8 的 CLS 只佔 15%、還含已除役的 Time to Interactive。要比較不同時期的分數,先確認當時的 Lighthouse 版本與計分設定,跨版本的分數不一定能直接比大小。
分數會浮動,而且多半不是你的網站變了。官方列出的常見變異來源包括 A/B 測試與廣告投放的變動、網路路由變化、測試裝置效能差異、會注入程式的瀏覽器擴充功能、防毒軟體。PSI 因為跑在 Google 機房,條件比本機穩定得多,但廣告與第三方腳本帶來的變動仍然存在。官方的建議一語中的:與其把網站效能想成一個數字,不如想成一片分布。實務操作就是同一頁多跑幾次看區間,比較前後版本時固定網址、裝置與條件,別挑最高那次當成果。想理解特定分數是怎麼組出來的,官方的評分計算器可以拉動各項指標看總分變化,拿它跟報告對照,很快就能看出哪項指標卡住了你的分數。
看總分還要養成一個習慣:分數相同,痛點可能完全不同。兩個都拿 85 分的網站,一個是 LCP 偏慢(內容出現得晚)、一個是 TBT 偏高(點了沒反應的風險大),修法、負責的人與預期效益全不一樣。這就是為什麼看分數永遠要連著底下的指標明細一起看:分數告訴你「離良好帶多遠」,明細告訴你「往哪個方向走最近」。反過來說,只回報總分的速度報告,等於把地圖摺起來只留距離數字。
建議清單的讀法也講究順序。Lighthouse 把可改善項分成「機會」與「診斷」兩區:機會區標示預估可節省的時間(例如消除阻擋渲染的資源、適當調整圖片大小),診斷區提供沒有直接換算時間的觀察(例如主執行緒工作量大、DOM 節點數偏多)。預估節省時間是排序參考而非承諾,把清單從上往下照做不等於分數會等量上升;更穩的用法是把機會項當假設,回到欄位資料驗證它對應的指標是否真的是你的痛點,再動手。
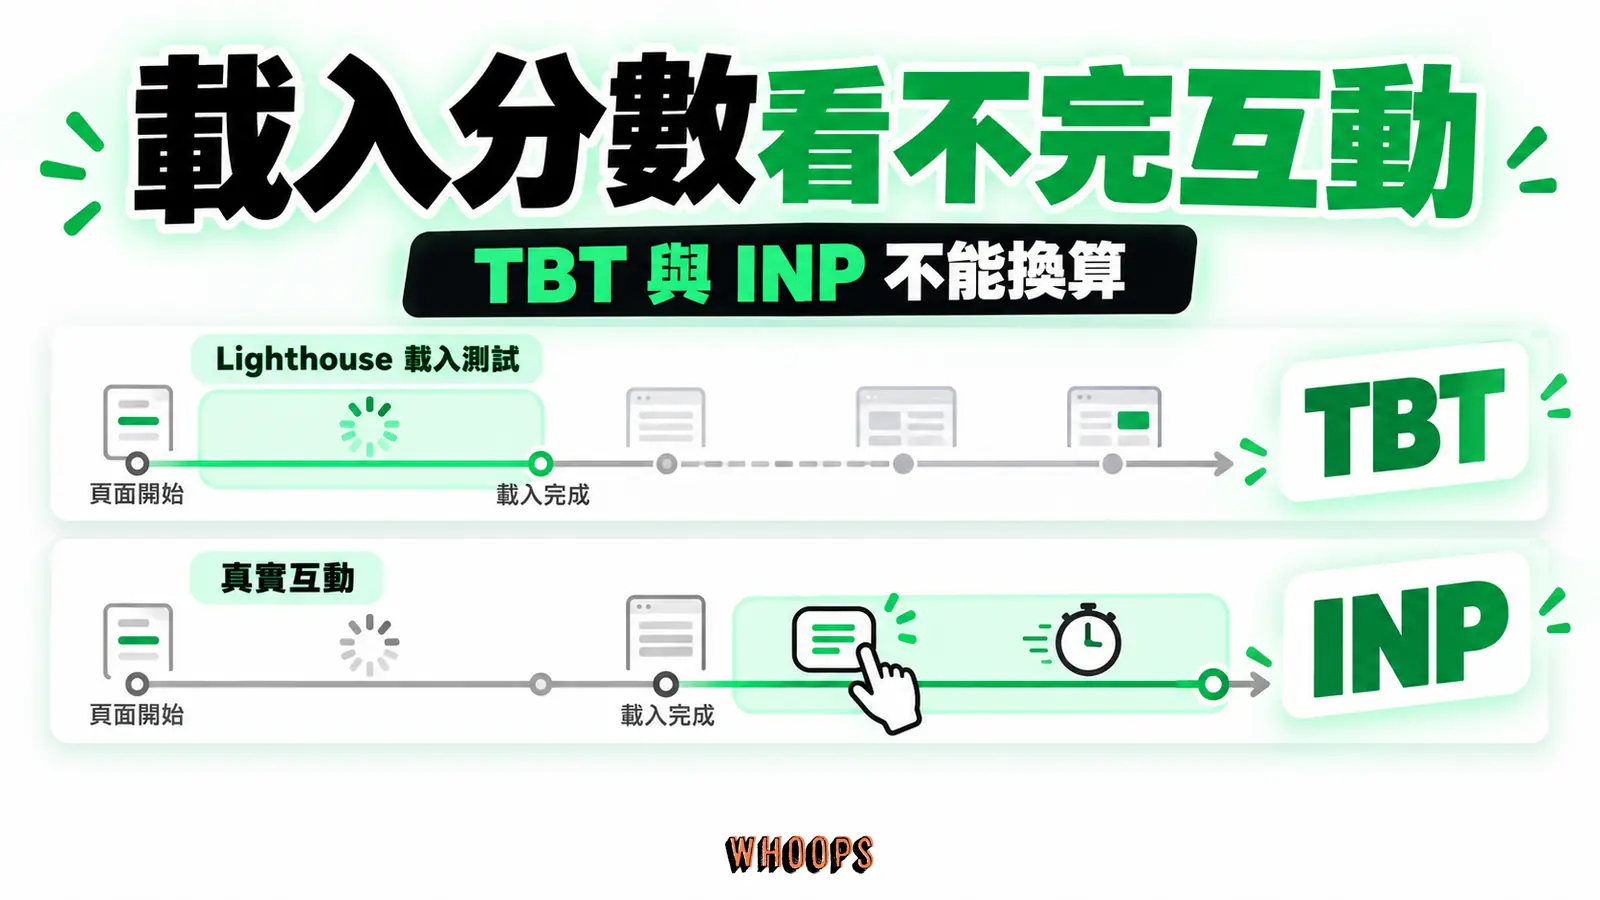
分數與 INP 的關係,則是很多人栽過的坑。Lighthouse 效能分數裡根本沒有 INP 這個指標,加權清單裡的互動代表是 TBT;TBT 高通常意味著主執行緒被長任務佔住、點擊容易卡,但兩者不能換算。一般的導航模式測試不會真的去點你的按鈕,點擊之後才發生的延遲,模擬載入測不到。官方工具指南也直說,欄位資料與模擬資料不一致時,特別在載入後的 CLS 與 INP 這類問題上,Lighthouse 建議的參考價值有限。INP 的完整來龍去脈(它如何取代 FID、為什麼導航測試生不出 INP 數字)可以再讀INP 與 FID 的深度說明。
效能之外的三個分數:無障礙、最佳做法、SEO 各自證明什麼
效能分數旁邊還有三個圓圈,定位要先擺正。無障礙分數檢查的是對輔助技術友善的基本面,圖片替代文字、文字對比、表單標籤關聯、標題階層;最佳做法分數檢查工程慣例,主控台錯誤、已棄用的 API、HTTPS 與跨來源連結安全、帶已知漏洞的前端程式庫。這兩個分數是健檢報告:改善它們通常對訪客有實質好處(螢幕閱讀器的使用者、老舊瀏覽器、安全連線),但與搜尋排名沒有直接關係,紅了不代表 SEO 出事,綠了也不會帶來流量。
SEO 分數最需要澄清。它量測的是 Lighthouse SEO 類別裡那組自動檢查:頁面是否被 noindex 或錯誤的 HTTP 狀態擋住、是否缺 meta 描述、robots.txt 是否有效之類的機械項目,也就是「搜尋引擎爬蟲能不能順利讀懂這一頁」的檢查清單,CrUX 方法論甚至建議用這組檢查來確認頁面的可探索性。滿分代表檢查項目全部通過,僅此而已:它不是收錄證明,也不是排名預測,更不涵蓋內容品質、意圖匹配或連結這些排名系統真正較勁的維度。這個分數真正有用的場景是抓低級錯誤,例如某次改版不小心讓整批頁面帶上 noindex,SEO 檢查會立刻亮紅,這時它救的是能見度,不是排名。
對排名這件事,Google 在網頁體驗的官方說明裡的講法值得完整記住:Core Web Vitals 確實用於排名系統,但在 Search Console 的 Core Web Vitals 報告或第三方工具拿到好成績,不保證頁面在搜尋結果名列前茅;只為了 SEO 理由追求完美分數,未必是時間的最佳用途。官方同時說明,網頁體驗沒有單一訊號,核心排名系統看的是一組對齊網頁體驗的訊號,且以頁面為基礎評估。工具分數與搜尋結果之間,隔著相關性、內容品質與多種訊號,把 SEO 分數滿分直接當成排名保證,等於讀錯了它量測的東西。
四個入口的分工:PSI、Search Console、DevTools 與 CrUX 資料集
Google 的速度工具不只 PSI 一個,彼此的資料範圍與組織方式不同,數字對不起來幾乎是常態。理解分工之後,你會知道每個數字該向誰對帳,也會知道哪個問題該換哪個工具問。
PSI 的位置是「單頁快診」。貼上一個公開網址,同時拿到該頁(或其來源)的欄位資料與 Lighthouse 診斷;因為測試由 Google 伺服器執行,條件比本機跑穩定,適合當對照基準。官方對各工具適用時機的整理也點出它的兩個邊界:只能測公開網址,開發中的站測不了;沒有欄位資料時就只剩模擬資料可看。它還有一個常被忽略的用途:競爭對手的公開頁面一樣測得到,做同業基準比較不需要任何授權,把同業主力頁與自家主力頁放在同一套條件下比,比市面上的「速度排行榜」踏實得多。
Search Console 的 Core Web Vitals 報告是「站點盤點」視角,資料同樣來自 CrUX,但組織方式改成網址群組:相似頁面(例如同一個範本的商品頁)被併成一組,以組內最弱的指標定狀態,只顯示已建立索引網址的示例。報告的官方說明提醒了一個反直覺的細節:只要群組的 LCP 與 CLS 資料量達標就會列入,狀態依最弱指標顯示,所以一個 CLS 低落但 INP 良好的群組,照樣亮不良。PSI 依網址或來源組織、Search Console 依群組組織,這是兩邊數字常常對不攏的結構性原因;官方還給過一個具體情境:少數效能差但吃掉大部分流量的網址,在 Search Console 只會顯示少量不良網址,來源層級的工具卻可能顯示高比例的不良體驗。對不起來時先查資料範圍,不要先懷疑工具壞了。
群組制還有一個使用上的陷阱:示例網址不等於群組全貌。官方說明直說報告顯示的是示例,不是已索引網址的完整清單;工具指南也提醒,群組裡若混著長尾少訪頁,示例頁可能全數過關、群組狀態卻亮紅,因為慢的正是那些沒被列出來的頁面。看到這種矛盾,把示例頁當線索往群組裡的類似頁面追,而不是懷疑報告算錯。
Chrome DevTools 的 Performance 面板是工程師的顯微鏡。它開啟時的即時指標畫面能邊操作邊看 CWV 數值,適合抓載入後才發生的問題;錄製下來的追蹤記錄則展開網路、渲染、繪製、腳本每個層面的細節,是重現 INP 卡頓的主要工具。它是實驗室性質的工具,跑在你自己的機器上,結果受本機條件影響,用來找原因可以,用來代表訪客不行。
再往源頭走是 CrUX 資料集本身。API 版本每天更新、能查到網址或來源層級;BigQuery 版本每月更新、只有來源層級。多數網站不需要直接碰它,但要知道它是上面所有欄位資料的上游,也記得CrUX 的方法論寫明:資料只代表符合回報資格的 Chrome 使用者,iOS 上的 Chrome、Android WebView 與其他 Chromium 瀏覽器都不在採集範圍。你的訪客如果大量來自 Safari 或手機 App 內嵌瀏覽器,欄位資料說的就只是其中一部分人的體驗。官方指南也老實說了 CrUX 作為公開資料集的極限:它給不了單一 LCP 元素是哪個、登入與登出使用者誰比較慢這類切分,要這種細節得自建真實使用者監控(RUM),把 web-vitals 程式庫接進分析工具自己收資料。不過直接查 CrUX 也有工具介面給不了的好處,例如國家層級的切分:跨區經營的站能藉此看出「慢的是哪個市場的訪客」,這類視角在 PSI 報告裡看不到。
四個入口走完,分工其實很乾淨:PSI 回答「這一頁現在狀況如何」,Search Console 回答「哪一批頁面需要處理」,DevTools 回答「卡頓發生在哪一行」,CrUX 資料集提供「脫離工具介面的原始統計」。三項指標本身的定義與優化實戰,站上的核心指標入門與CWV 優化攻略有完整展開。
把報告變成待辦:一個假設案例走完排序、交辦與驗收
判讀的最後一哩路是把數字變成可執行的工作。用一個假設情境示範,數字皆為虛構。某內容站的手機 PSI 報告:欄位資料標示「來源」層級,LCP 第 75 百分位 3.1 秒(橙)、INP 260 毫秒(橙)、CLS 0.05(綠);Lighthouse 效能分數,首頁 92 分、隨機點開的三篇文章頁落在 60 到 70 分之間。站長的直覺反應通常是「分數好差,全面優化」,正確的反應卻是三個提問:誰受害、哪裡受害、能不能重現。
先處理「誰受害」。燈號掛在來源層級,代表這是全站彙整,但彙整分不出受害者是散在大量頁面、還是集中在少數高流量頁,兩種情況在來源層級的燈號上長得一樣。手邊另一條線索是首頁 92 分與文章頁 60 多分的落差,它讓「文章頁範本承載主要問題」成為頭號嫌疑,但這是待驗證的假設,不是結論。驗證的方法就是把受害頁面收斂出名單:抽幾篇有流量的文章頁逐一測,或到 Search Console 的 CWV 報告看「LCP 需要改善」的網址群組。LCP 橙燈在手機上,改善方向多半落在首圖與主內容的載入路徑,這也是 Lighthouse 診斷有機會幫上忙的領域,模擬環境對載入類問題的重現性較好。
INP 橙燈走另一條路。模擬測試測不到點擊後的延遲,這時 Lighthouse 的建議僅供參考,真正要做的是請工程師在實機上重現「打開選單、展開目錄、送出留言」這類高頻互動,用 DevTools 錄製找出延遲最長的互動與其呼叫堆疊。兩種燈號,兩種除錯姿勢,混用就會事倍功半。
排序不靠直覺,靠三層由硬到軟的準則。最硬的是證據強度:燈色與分布長條直接標出急迫性,這個案例的 LCP 橙燈代表四分之一訪客等超過三秒,紅色占比若再往上爬,急迫性跟著加權。第二層是槓桿大小:同樣一次修正,落在單頁、文章範本或全站共用資源,能照顧到的流量差好幾個量級;前一步收斂出的受害名單若集中指向文章頁範本,改範本就是高槓桿的選擇,但名單收斂出來之前,先以單頁規格處理,不預設範本是共犯。最軟的是驗收定義:講得出「哪個燈號轉綠、哪個數字降到多少」的項目優先進佇列,講不出的先留在候選。三層都過,才排進工作佇列。改善建議裡那些與三項 CWV 門檻不直接對應的項目(例如快取原則類提示),先移到佇列末端:它們對首次造訪的載入類指標影響通常有限,但不是無效,快取對重訪與多頁瀏覽的體驗有實質好處,值不值得提前做,看回訪流量占比與欄位資料說話。
交辦給工程師時,把判讀脈絡一起交出去,驗收才有共同基準。一份堪用的工單至少包含五件事:
- 網址與裝置分頁:哪一頁、手機還是電腦。
- 資料層級與指標:來源層級 LCP 橙燈 3.1 秒,或網址層級 INP 260 毫秒。
- 可重現的操作:哪個按鈕、哪段流程、在什麼條件下看得到延遲。
- 判讀依據:附上報告連結或截圖,標明測試日期。
- 完成定義:哪個燈號轉綠、哪個數字降到多少,而不是「把分數弄上去」。
一句「手機文章頁的 LCP 來源層級橙燈 3.1 秒,首圖載入是主要嫌疑,請驗證並改善,目標是 LCP 第 75 百分位回到 2.5 秒內」遠比「請把分數弄到 90」有用,因為前者給了可驗收的完成條件,後者只設了模擬分數的目標,沒有交代要改善哪一種真實體驗。
驗收分兩拍。當天用同一套條件重跑 Lighthouse,與改動前的基準對照,確認修正方向有效,再實際走一次原本卡的流程,順手檢查表單、追蹤碼與版面有沒有被改壞;欄位資料那拍要等,28 天滾動視窗裡新體驗逐步摻入,盯著趨勢走穩即可,不必每天截圖焦慮。若網站同時自建了 RUM,兩邊數字有出入也是常態,CrUX 的母體是符合資格的 Chrome 使用者、以 28 天視窗統計,自建監控則收得到更多瀏覽器(以指標支援為限)的即時體驗,母體與視窗都不同,對帳時先對齊口徑。真正要把「速度」當成經營議題的站,這套流程的完整版本(含瓶頸分類與投資停損)在站上的速度測試方法論裡;至於 LCP、CLS 實際要改哪些東西,圖片、字型、腳本的手法整理在載入速度優化指南。
兩種情況,先別急著動工
第一種:新站或低流量站測不到欄位資料。這是常態而非異常,收錄門檻本來就會把樣本不足的頁面排除在外。此時能做的是用固定條件的重複模擬量測建立自己的基準線,維持每次條件一致,趨勢照樣可信;真的需要真實訪客數字,才評估自建監控。急著為了「生出欄位資料」去做沒有必要的改版,是把工具的採樣機制誤讀成自己的問題。
第二種:兩層資料互相矛盾。模擬 95 分但 INP 燈號紅,或燈號全綠但分數難看,兩種組合都常見且都能解釋:前者是載入類模擬看不到互動問題的典型樣貌,後者常見於模擬條件比訪客平均裝置嚴苛的站。處理順序固定,先確認比較的東西同層(網址對網址、同期對同期、同裝置對同裝置),再判斷該信哪一邊:主張訪客受害看欄位燈號,找原因看模擬診斷。矛盾本身就是資訊,它告訴你問題長在模擬看不到的地方,或條件差異大到需要換基準。
速度與排名、轉換之間的關係,屬於另一層決策問題,在網頁速度與排名的完整討論裡展開;這裡的底線是,PSI 報告本身不回答商業問題,它只負責把體驗現況與改善線索攤在你面前。
要向上級或客戶報告速度工作時,判讀紀律同樣適用。單獨一個「手機 68 分」的截圖最容易引發誤解與錯誤期待;帶著條件報告才站得住:哪一頁、哪個裝置、資料是網址還是來源層級、燈號現況、趨勢往哪走、下一步做什麼。條件講清楚,「分數從 68 到 74」這種小變動就不會被當成空轉,燈號轉綠那天的成果也不會被歸因成運氣。報告的品質,最終決定速度工作能不能持續拿到資源。
收在一個使用原則上
PSI 是決策工具,不是成績單。每個數字出廠時都自帶條件:資料層級、樣本身分、百分位位置、模擬環境、更新節奏,把條件讀懂,數字就會說話;忽略條件,同一份報告可以支持任何結論。固定的閱讀順序值得養成習慣:裝置、層級、燈號、分布、分數,到了建議清單才動手。停手與否也照這個順序判斷:分數進到 90 分以上的良好帶,就不必再為滿分追加工程,但分數本身不是停手令,模擬 90 幾分而燈號仍橙紅的站,該修的還是得修;燈號綠了,才把力氣移向內容與轉換,搜尋排名的主力訊號在內容與相關性,轉換則是流量真正要換成的成果。100 分,留給有餘裕的完美主義者。工具存在的目的,是讓你更快回到真正重要的事上。