ChatGPT Intelligent UI 是什麼?GPT-6 互動圖表與即時工具生成使用指南
ChatGPT Intelligent UI 是 OpenAI 於 2026 年 10 月 7 日隨 GPT-6 全方案推送上線的互動回應技術,回答可組合圖表、按鈕、表單與即時工具。本指南以官方公告與說明中心查證方案對應、四種回應形態、提問寫法與中文範例、串流元件與編譯器原理、44% 開答提前的正確解讀與十個限制。
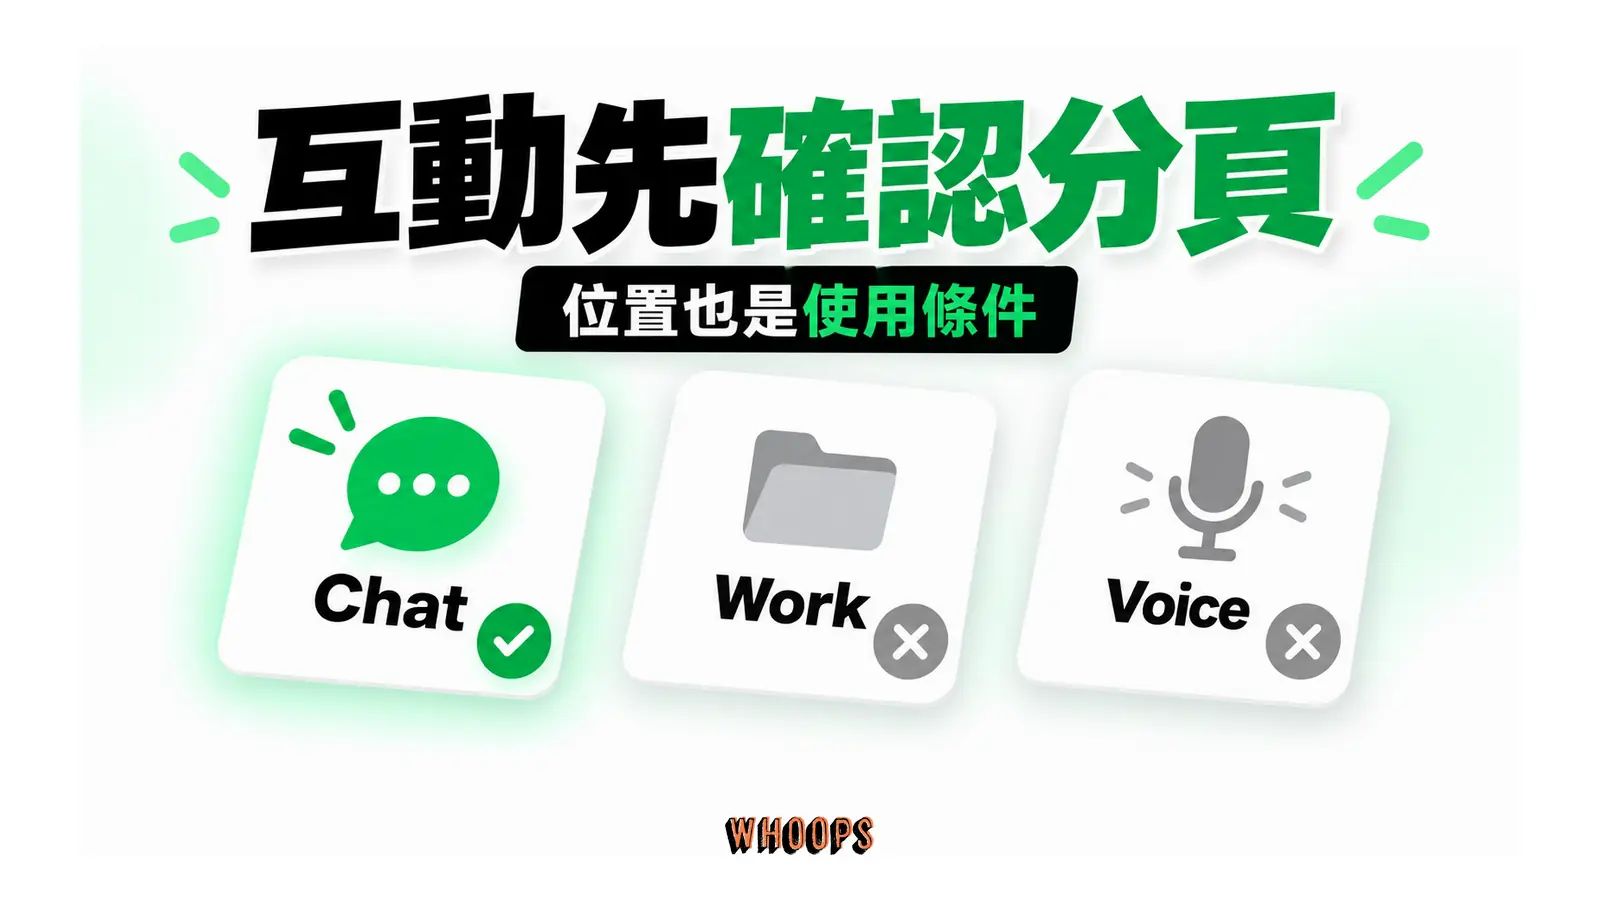
OpenAI 在 2026 年 10 月 7 日發布GPT-6 for everyone 公告,把 GPT-6 推進所有 ChatGPT 方案,同時上線 Intelligent UI 這套回應技術:回答不再只由文字構成,模型會依問題當場組合圖表、按鈕、表單與可直接操作的小工具,全部發生在同一則對話裡。付費方案(Plus/Pro/Business/Enterprise)當天起陸續拿到 GPT-6 Sol,免費與 Go 用戶自 10 月 8 日起分批收到 GPT-6 Luna,兩款都能生成這些互動回應。使用前有兩個會直接改變體驗的條件要先記住:這套介面只存在於 Chat 分頁,Work 分頁與語音模式都沒有;推理設定從 Instant 到 Extra High 都支援,但名為 Pro reasoning 的推理檔位底層換成 GPT-6 Astra,官方明載這個檔位不在涵蓋範圍。
這篇指南把官方公告與OpenAI 說明中心的可查證資訊整理成一篇可操作的使用指南:誰能用、四種回應形態長什麼樣、提問怎麼寫才容易拿到好用的介面、背後的串流元件與編譯器原理、速度數字的正確讀法,以及十個容易誤解的邊界。文內的事實與日期以 2026 年 10 月 10 日查核的官方文件為準;功能採全球分批推送,個別帳號的實際狀態可能落後公告日幾天。想先弄懂 GPT-6 家族的 Sol、Luna、Astra 分工,可以搭配站上的GPT-6 Sol 與 Luna 深度解析一起讀。
重點速覽
- Intelligent UI 屬於 GPT-6 世代新加入的回應組合能力:模型依問題決定用純文字、並排比較、可點擊的圖解,還是一個能輸入參數的工具來回答,簡單問題仍然回純文字。
- 開放範圍:四個付費方案(Plus/Pro/Business/Enterprise)自 2026 年 10 月 7 日起使用 GPT-6 Sol;Free 與 Go 自 10 月 8 日起分批收到 GPT-6 Luna。官方以每週超過 12 億名 ChatGPT 使用者為這次推送的規模基數。
- 能生成的東西:並排比較版面、參數可調的圖解教學、帶地圖與停留建議的行程、退休儲蓄試算、聚餐分帳、可玩的小遊戲,都直接長在對話裡。
- 速度改善要讀對指標:碰到要上網查資料的問題,新一代 GPT-6 Instant 可比 GPT-5.6 Instant 早 44% 開始作答。量的是開答時間,完成時間屬於另一件事。
- 技術底盤:一組原生串流元件庫,加上一個在模型輸出過程中同步處理介面的編譯器,讓介面逐段出現,無須等整則回應生成完畢。
- 想調淡視覺效果:設定裡的 Simple 模式會減少視覺與互動元件,設定後仍可能有部分出現。
- 硬邊界:僅限 Chat 分頁;Work 分頁與 Voice 模式不支援;Work 與 Codex 底下的模型未隨這次更新變動;元件狀態只在同一對話內保留。
一句話定義:會自己組出介面的回答
這套能力的核心改變,是把「回答的長相」也交給模型決定。過去 ChatGPT 的回應以文字為主、偶爾附上圖片或表格,版面固定;現在 GPT-6 被訓練成會判斷問題的性質,自己挑選文字、圖形、可點按鈕、表單、圖表與互動體驗的組合方式。官方的說法是:比較型問題可能最適合並排呈現,解釋型問題用互動圖解更容易懂,若純文字就是最有用的答案,模型也會直接給文字。換句話說,它並沒有把每個回答都強行變成花俏介面,判斷「什麼時候不值得做介面」同樣是訓練目標的一部分。
跟過去「回答裡附一張生成圖片」的經驗相比,差別在於元件是活的。一張靜態圖只能看;現在生成的圖解可以點、計算器可以拉參數、清單可以打勾,操作結果會留在對話裡。這讓 ChatGPT 從「問答機」往「當場做出一次性工具的工坊」移動了一步:你需要一個只會用三十分鐘的分帳器,當場描述、當場生成、用完即棄,不必多裝什麼工具或註冊服務;對話與其中的狀態,仍照 ChatGPT 一般的對話與資料設定處理。
範圍也劃得很清楚。這次更新只動 Chat 分頁的體驗,官方公告明載 Work 與 Codex 背後的模型不在變更範圍內;語音模式同樣沒有這套介面。把它理解成「聊天介面的一次大改版」比「整個 ChatGPT 都變了」更準確。
跟前一代的回答比,差別在哪
把時間往回撥一個世代,感受會更具體。GPT-5.6 時代的回答再長,本質上仍是一份排版過的文件:標題、清單、表格,讀完即止;如果要看圖,模型給的是一張生成好的靜態圖片,無法點、無法改。進階一點的使用者會開分析工具畫圖表,或把資料丟進程式環境跑一段程式碼,但那已經離開「問一句、得到答案」的直覺流程,進入另一種操作模式。
這套互動回應填起鴻溝的方式,值得從使用者行為的角度看。以前「問」與「操作」是兩個世界:問答在對話框,操作在別的工具裡;現在一次提問的產物本身就能操作,追問與調整發生在同一個地方。這對不熟工具的人影響最大:不需要知道試算表怎麼寫公式、不需要會任何繪圖軟體,只要把想調的數字說出來,介面就長出拉桿。對熟練使用者,省下的則是「把問題翻譯成工具語言」的那一步。
有一個常被問的對照是 Canvas 與分析工具。Canvas 處理的是文件共同編輯,主體仍是文字;分析工具處理的是你上傳的資料,產出圖表但流程獨立。這套互動回應的定位在兩者之前的那一段:問題還在成形、需求還很口語的階段,就先拿到一個能摸的東西。三者在 ChatGPT 裡並存,各自服務不同成熟度的需求,用錯階段的工具,才是效率損失的常見來源。
先確認資格:你的方案拿到哪個模型
這波推送的方案對應關係,官方在公告與說明中心講得很一致:付費四方案拿 GPT-6 Sol,免費兩方案拿 GPT-6 Luna,兩款都為日常對話調校,也都用得到這套互動介面。對照表如下。
左右捲動檢視完整表格
| ChatGPT 方案 | 開放起日 | Intelligent UI | 拿到的模型 | 備註 |
|---|---|---|---|---|
| Free | 2026/10/8 起 | 支援 | GPT-6 Luna | 全球分批推送,依帳號陸續開通 |
| Go | 2026/10/8 起 | 支援 | GPT-6 Luna | 同上,分批開放 |
| Plus | 2026/10/7 起 | 支援 | GPT-6 Sol | 推理設定 Instant 到 Extra High 皆可 |
| Pro | 2026/10/7 起 | 支援 | GPT-6 Sol | Pro reasoning 走 GPT-6 Astra,無此介面 |
| Business | 2026/10/7 起 | 支援 | GPT-6 Sol | 隨方案推送 |
| Enterprise | 2026/10/7 起 | 支援 | GPT-6 Sol | 實際開放依 workplace 管理員設定而定 |
分批推送是這幾天最常見的疑問來源。官方沒有給出所有帳號都完成開通的日期表,只承諾全球陸續開放;如果帳號還沒看到互動介面,先確認三件事:模型選單是否已出現 GPT-6、是否停在 Chat 分頁(而非 Work)、推理設定是否落在 Instant 到 Extra High 之間。三者都符合卻仍未開通,多半只是推送順序問題,等幾天再試即可,不需要重灌 App 或重設帳號。各方案的用量與額度差異,整理在ChatGPT 與 Claude 方案額度比較。
確認帳號狀態時,最可靠的位置是新對話的模型選單,它反映的是帳號當下的實際組態,比任何新聞報導或社群截圖都準。選單裡看到 GPT-6 字樣,代表模型層已經推送;接著在同一則對話裡丟一個需要比較或試算的問題,就能驗證介面層是否跟上。兩者分開確認是有理由的:裝置版本與快取可能讓顯示狀態短暫不同步,重新整理或換一個裝置再確認一次,通常就會一致。
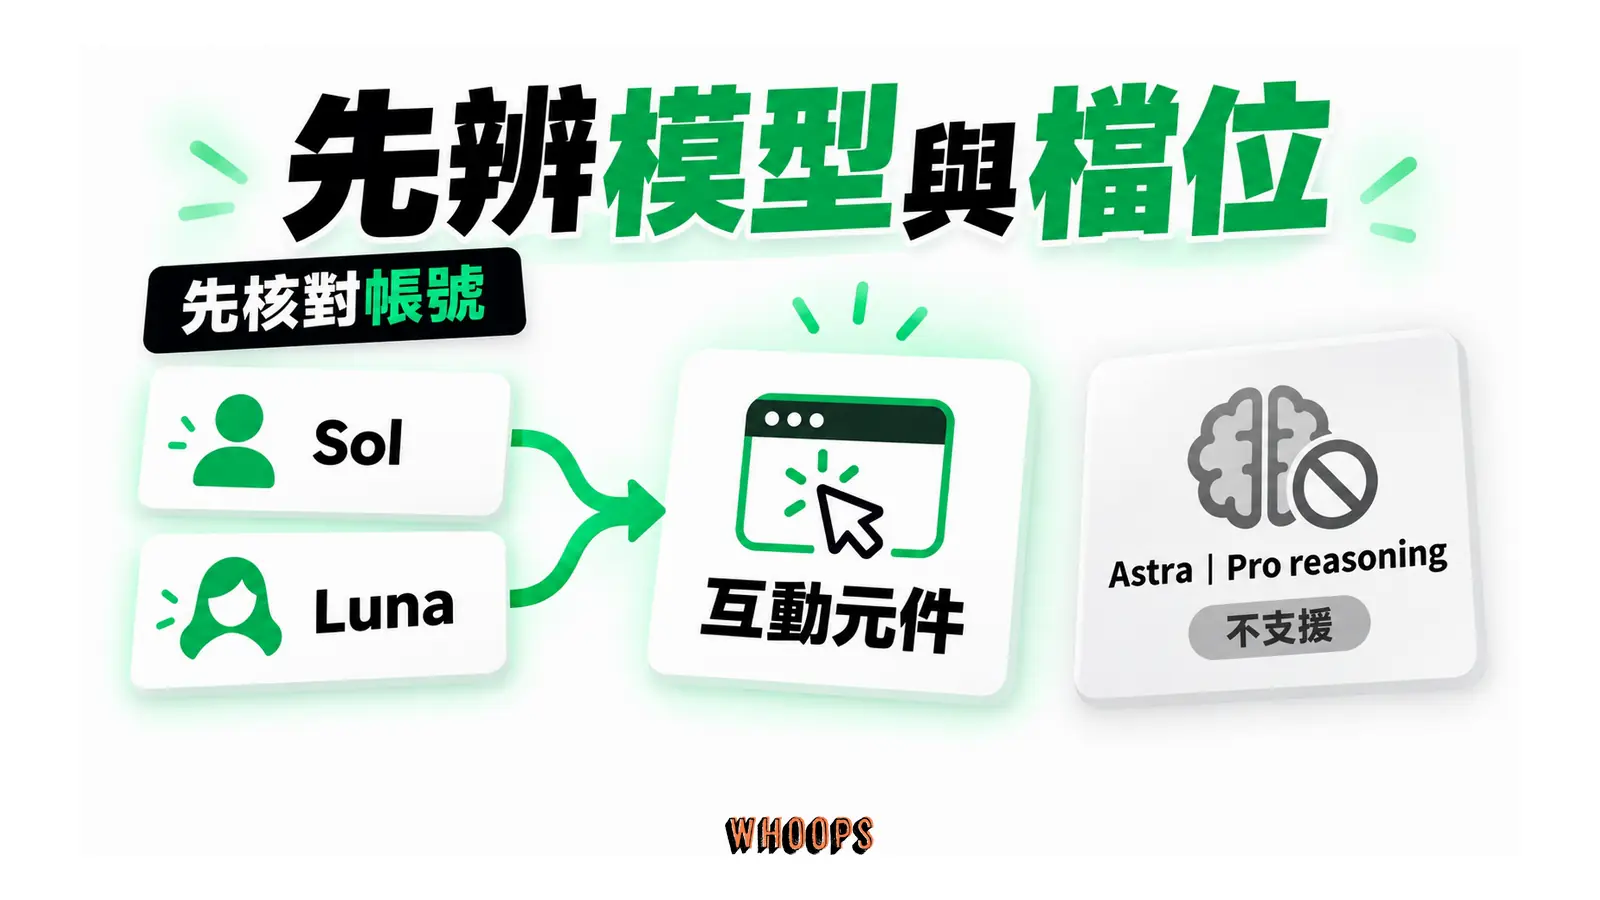
Pro 用戶有一個專屬的陷阱值得單獨說。Pro 方案平常拿 GPT-6 Sol,但推理選單裡的 Pro reasoning 檔位底層換成 GPT-6 Astra,說明中心明載該檔位拿不到這套互動介面。也就是說,同一個 Pro 帳號,選 Sol 配一般推理設定看得到互動介面,切到 Pro reasoning 就會回到純文字體驗,這中間的落差是設計使然,並非故障。Astra 的定位與能力,站上的GPT-6 Astra 完整解析有深入說明。
把時間軸拉長一點看,這已經是 GPT-6 一個月內第二次擴大觸及面。公告開頭就交代,第一批 GPT-6 模型在上個月已先向付費客戶推出;10 月 7 日這波再推進到全方案,並讓免費用戶也拿到互動介面。對照 OpenAI 同期發布的訊息,模型層的更新(Astra、Sol、Luna 各自的位置)與產品層的更新(互動回應、分頁分工)是兩條並行線,前者影響能力上限,後者影響一般人每天摸到的體驗。這篇指南聚焦後者;模型面的完整地圖,搭配前述兩篇家族解析閱讀即可補齊。
打開之後:四種回應形態與各自的觸發問法
把公告裡的示範拆開看,輸出可以歸成四種形態。分清楚形態的好處很實際:你知道自己要的是哪一種,提問就更容易命中,看到生成的結果也知道要檢查什麼。
第一種是並排比較。比較型的問題,模型會把選項拉成左右並列的版面,讓差異直接對得上眼,取代過去一大段文字裡穿插數字的寫法。這是最輕量的形態,通常不涉及複雜互動,但閱讀效率的提升最立即。日常可以用在方案比較、供應商比價、職缺條件對照;把要比的維度先列清楚,版面就會照你的維度排。
第二種是可點擊的解構圖與參數式教學。官方的首頁示範是一輛七速自行車:回答裡出現一張可互動的分解圖,車架、輪組、傳動、煞車、把手五個系統分別可點,點下去展開該系統的功能說明,等於把一頁百科變成一件可以拆著看的教具。統計學的中央極限定理也在示範之列:樣本數量可以現場調整,抽樣分配跟著變形,抽象概念因此變成可操作的實驗。這個形態對學生、教學者與需要向他人解釋複雜系統的人最有感,重點在「改一個輸入、看到後果」,理解就發生在那個當下。
第三種是帶地圖與結構的計畫。官方示範裡,規劃公路旅行時停靠點會直接落在地圖上,附上哪些繞路值得的註記;週末烤肉聚餐的排程則把時間軸、採買量與烹調步驟組合在一個畫面裡,人數一改,採買份量跟著重算。這種形態的價值在於把散落在長篇文字裡的時間、地點、數量收攏成一眼可讀的結構,規劃類提問是天然素材:家庭旅遊行程、專案時程、活動籌備清單都適用。
第四種是現場生成的一次性工具,也是這次更新裡想像空間最大的一塊。公告明列的例子包括探索儲蓄成長的計算器、聚餐分帳工具與可以直接玩的小遊戲;以分帳為例,輸入每個人點的菜與金額、勾選誰分到哪道,稅與小費的處理方式也能指定,算出每人應付金額。工具用完就留在那則對話裡,不佔空間、不需要登入任何服務。四種形態共用一個前提:輸出的數字與結論仍然要自己複核,介面好看不代表計算正確,這點在後面的限制段會再展開。
拿到回應後先判斷形態對不對,比急著修改內容更省事。問題本身在比東西,卻收到一篇長文字,補一句「做成並排比較表,維度是這幾項」通常就會重排;問題需要感受數字隨參數變化,卻只拿到一張靜態圖,改問「讓我可以調整某個變數的互動圖解」即可。形態判斷的速查很直覺:要比較就指名維度、要理解就指名可調的輸入、要規劃就給時間與地點、要算就給欄位與規則。多數「它怎麼只給我文字」的失望,源頭都出在提問沒有把期待的形態講出來,模型於是挑了最保守的呈現。
提問方法:怎麼寫才容易拿到好用的介面
生成介面的品質,很大程度取決於提問裡有沒有把三件事講清楚。第一是把可變動的參數說明白:哪些數字你想要現場調(人數、金額、年限、費率),單位與合理範圍先給,模型才知道滑桿該綁在哪個變數上。第二是說明你打算怎麼用這個結果:要並排比較就列出比較維度,要教學就指名希望可以調整哪個輸入,要工具就直接描述輸入欄位與輸出。第三是把假設寫進提問:服務費一成、含稅或未稅、年化報酬假設多少,這些先講,生成的工具才不會帶著隱藏假設上線。
以下五個中文提問範例可以直接複製去試,分別對應不同形態,也順便示範參數怎麼寫。
- 比較型:「幫我比較三種行動電話資費方案,做成並排比較表,維度包含月費、網路流量、合約年限與違約金,資費名稱我稍後提供。」
- 教學型:「用互動圖解釋複利與通貨膨脹的消長,我可以調整年化報酬率(0% 到 10%)與通膨率(0% 到 5%),看二十年後實質購買力的變化。」
- 計畫型:「規劃四天三夜的環島行程,家庭出遊兩大兩小,把每天停靠點放到地圖上,標出親子友善景點與建議停留時間。」
- 工具型:「做一個部門聚餐分帳工具,12 人參加、餐廳收一成服務費、三人有墊款,可以輸入每人點餐金額,並算出每人應付與墊款人回收金額。」
- 工具型(財務試算):「做一個勞工退休金自提模擬器:月薪 6 萬,自提比率用滑桿在 0% 到 6% 之間調整,雇主提繳 6%,假設年報酬 4%,顯示 30 年後的累積金額,並列出每年明細。」
第一次生成很少一次到位,迭代才是正常用法。修改生成的工具時,指出具體位置比整段重述有效:「把年限的滑桿上限拉到 40 年」「加一欄考慮每年獎金三個月的情境」「服務費改成可勾選」,這類針對單一元件的指令,模型通常直接改在原介面上;若要換整個形態(比較表改成工具、圖解換成清單),明說要換成什麼,避免模型在同一則回應裡疊出四不像。迭代三輪仍不滿意的話,開新對話、帶著前一次學到的規格重講一次,成功率往往高於在舊對話裡來回纏鬥,因為每次追問都會把對話歷史越墊越厚,早期的錯誤假設也會跟著被記住。
兩個調校介面風格的官方管道要記住。其一是 Custom Instructions:在自訂指示裡寫下偏好,例如「回答保持簡潔」或「比較選項時盡量用表格」,這些偏好會引導回應的版面傾向;單一對話裡也可以直接要求換一種呈現方式。其二是整體開關:若覺得視覺化太多,在網頁版設定裡,找到 Personalization 區的 Layout and Visuals 頁籤、選 Simple,回應會改成較簡潔的呈現,官方說明特別註明這會減少視覺與互動元件,部分元件仍可能出現,它是一個減量開關,不是總開關。
用中文提問一樣能觸發各種回應形態,官方文件並未把語言列為功能條件;不過介面文字與欄位標籤的細緻度,會隨模型對語境的理解浮動,數字、單位與專有名詞在提問裡寫得越精確,生成結果的可用度就越高。需要對外使用的內容,先讓它生成草稿、再請模型校一遍用語,流程上通常比事後逐字手工修改快,也不容易漏掉欄位裡的翻譯腔。
還有一個容易被忽略的行為細節:元件的狀態保存範圍。說明中心寫明,部分元件(例如勾選清單)在同一個對話裡重新整理後仍會保留狀態,但狀態不會跨對話延續。實務上的意思是,做好一份勾選進度的工作清單後,繼續在同一則對話裡使用它;開新對話等於拿到一張白紙。重要結果要自行複製出來存檔,把對話當成唯一的存放位置並不可靠。
原理拆解:串流元件庫與編譯器怎麼讓介面邊生成邊出現
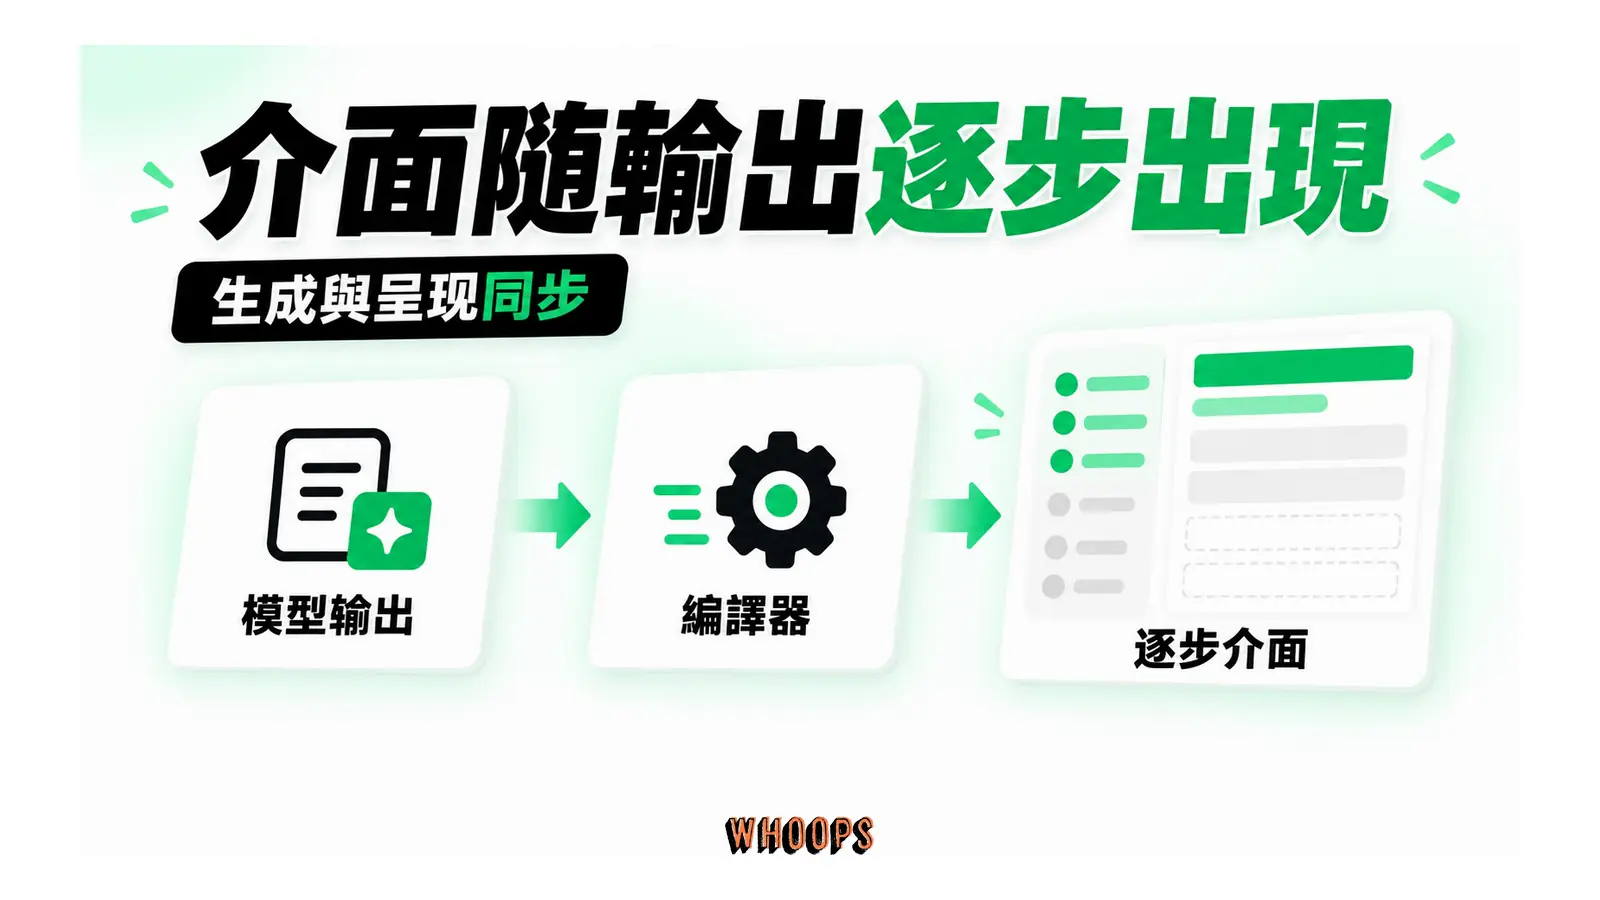
官方對這套技術的交代有兩個名字:一組原生的串流元件庫,以及一個在模型生成內容的過程中同步處理介面的編譯器。元件庫把按鈕、圖表、表單這些常見元素做成現成規格,每則回應因此有共同的設計基礎;模型的工作是決定這些零件怎麼組、內容怎麼放。編譯器則解決體驗問題:介面隨模型輸出逐段渲染出現,使用者不必等整則回應生成完畢才開始讀。這兩件事加起來,就是「回答還在生成、畫面已經可用」的關鍵。
設計判斷本身也是訓練出來的。OpenAI 表示他們擴充了訓練方法,讓模型對內容組織、版面、視覺化與互動的使用時機做判斷,訓練過程包含評估模型自己排出的介面是否清楚、有用、完整;模型同時學到什麼時候一則純文字回應就夠了。官方也坦承模型的設計判斷還有進步空間、可創作的元件範圍會繼續擴充,這等於替未來幾個月的迭代先掛了號。
為什麼要大費周章建元件庫與編譯器,直接生成一張圖片不是更簡單?原因在互動與正確性的張力。圖片生成模型畫一個「像」計算器的東西很快,但按鈕按了沒有反應、數字改了不會重算;原生元件每個都有確定的行為,按鈕就是按鈕、滑桿就是滑桿,資料流由系統保證,模型只決定怎麼組合。這個設計等於把「看起來對」與「真的能動」分開處理:外觀與佈局交給模型的判斷,互動的可靠性由元件庫背書。使用者也因此拿到一個穩定的心理模型:同一種元件在每次回應裡的行為一致,學一次就到處能用。
放在既有的工具生態裡看,這條路線的位置更清楚。要一個可分享、可長期使用的網頁工具,過去的答案是自己寫或找現成服務;GPTs 與外掛把常用流程包成可重複呼叫的應用;這套能力補上的是「拋棄式」這一格,即問即做、用完即棄,中間沒有部署與安裝。已連接的外掛(例如 Gmail、Health、Finance)在這次更新後照常運作,兩套機制並存而不互斥。對使用者來說,判斷標準很簡單:這個工具會用第二次嗎?會,就走正式工具;不會,就讓它當場生成。
串流渲染對體驗的意義,值得單獨體會。傳統做法要等模型把整段結果寫完、再整包渲染,長回答的等待期畫面停在原地;編譯器讓介面隨輸出逐段長出來,使用者在生成過程中就開始讀、開始理解結構,等到收尾時心裡已經有底。這與 GPT-6 邊想邊答的回答策略互相配合:內容提前開始流出的同時,承載內容的介面也提前成形。官方把這套體驗定位成跨網頁與行動裝置一致,行動裝置上讀長回答,也吃得到這種邊生成邊出現的呈現方式。
速度數字的正確讀法:快的是開始回答,完成時間是另一回事
這波更新裡最常被引用的數字是 44%:官方內部測試顯示,遇到需要上網查資料的問題時,新一代的 GPT-6 Instant 可比 GPT-5.6 Instant 早 44% 開始作答。這個數字有兩個必須掛在一起的限定:量測對象是開始回答的時間,因此不應讀成整則回應的完成時間縮短四成多;數字來自 OpenAI 內部測試,屬於官方宣稱,尚無獨立第三方驗證。對日常使用的實際意義是「等第一個字出現的時間變短」,追問長答案時的總等待仍取決於任務本身的複雜度。
第二組數字給重度代理任務的使用者。官方在一項內部的高價值日常代理任務評測裡量到:開到 GPT-6 Extra High 時,起跑時間落在 GPT-5.6 Medium 這一級,整體評分卻優於前代最高推理檔的成績。換言之,以往「想高分就得久等」的取捨被往有利方向推了一把:接近中檔的反應速度、高檔的產出品質。同樣要記住這是內部評測的相對比較,落在實際工作上的幅度會隨任務而不同。
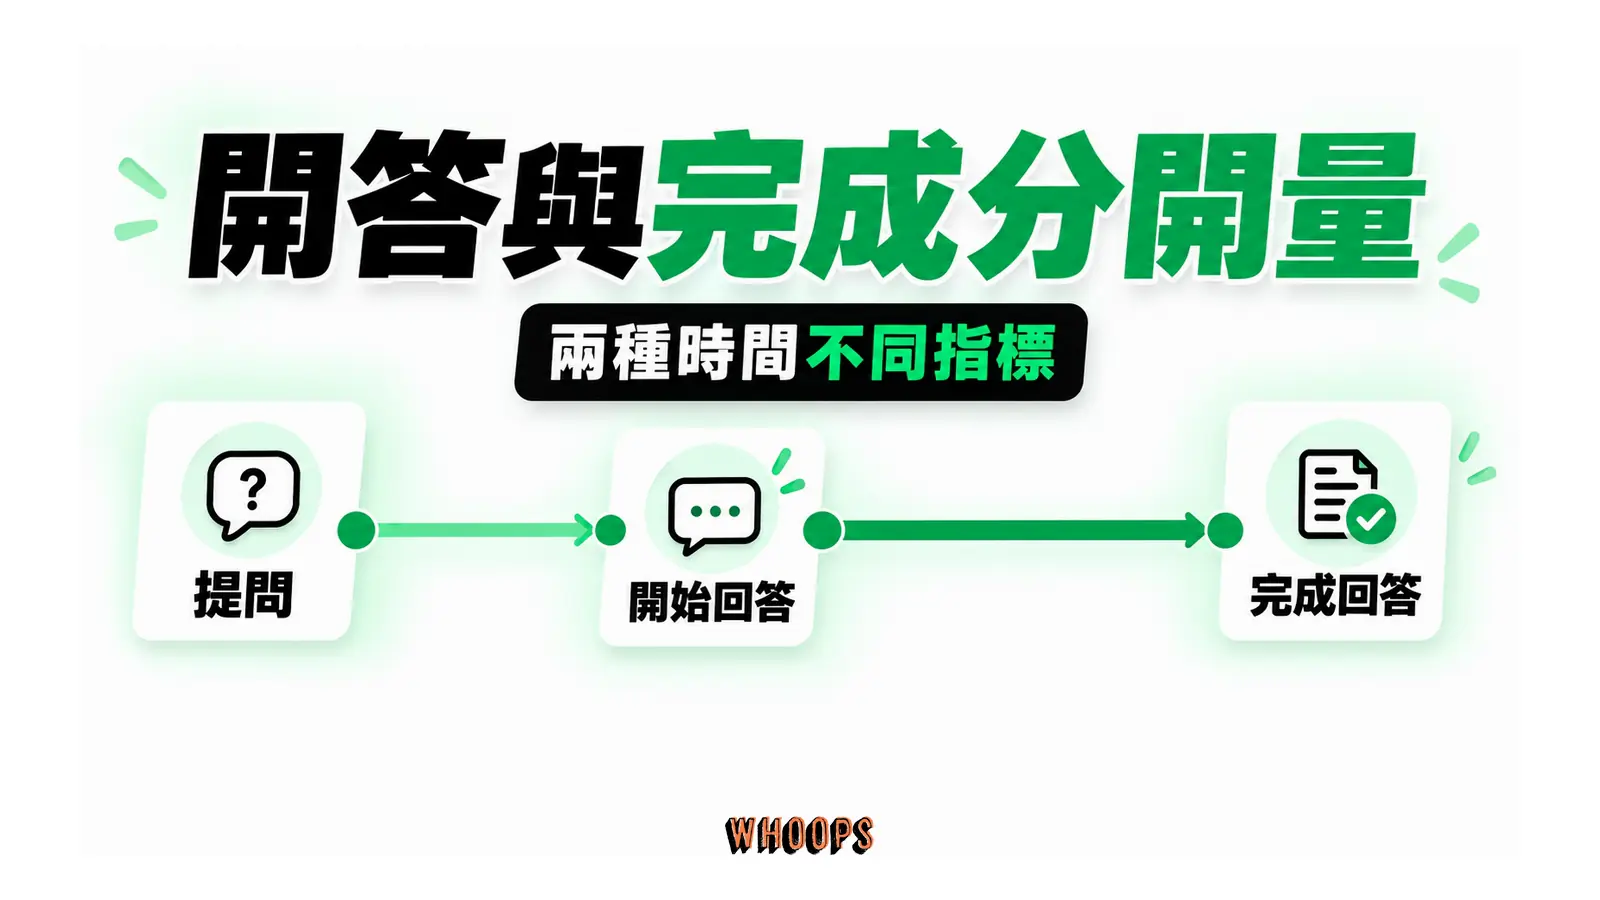
能提前開答的原因,是 GPT-6 學會把思考與作答交錯進行。官方描述,模型會把使用者的等待時間納入考量,用當下已有的知識與查找結果先組出部分答案,之後逐段補上,每段都要有實質資訊、不灌水,且整則回答讀起來要與一口氣寫完一樣連貫。這對使用方式的影響很直接:答案會更早開始出現,讀到一半就可能已經拿到可用的部分結論,但重要決策仍應等整則回應收完再下判斷,特別是涉及查證的任務。
網路搜尋的品質也有官方宣稱的改善:GPT-6 對「什麼時候該查」的判斷更好,更可靠地找到能支持答案的資料;官方另用一組困難的網路搜尋題做內部評測,並說明這組題目是為了測試模型的已知弱點而蒐集;在這組題目上,GPT-6 比前一世代更常正確處理到問題的關鍵面向。公告未提供這些評測的原始分數細節,這裡因此只保留方向性描述;對搜尋重度使用者來說,值得自己設計幾個固定問題,在新舊模型間做前後對照。
要驗證這些數字落到自己工作上的幅度,做法比想像簡單。挑五到十個工作裡真實會出現、而且你知道正確答案的題目,組成固定題組,分別在新舊模型上跑一輪,記錄兩件事:第一個字出現的時間,以及答案需要修多少才可用。固定題組的好處是可以比較,幾輪下來你會拿到屬於自己任務分佈的提前量,這比官方的平均值更貼近你的使用場景,也更值得作為要不要把某類工作正式搬到 GPT-6 的依據。
提前開答在日常使用裡的體感,還受到兩個因素調節。一是問題的形態:需要查證、需要工具呼叫的問題,等待本來就長,開答提前帶來的解脫感最明顯;閒聊式的短問答兩代都快,差異不容易察覺。二是閱讀節奏:能邊生成邊讀的使用者,實際感受到的「等待」比計時器顯示的更短,因為理解在輸出過程中就已經開始。把這兩點納入考量,對「到底快多少」的期待會更貼近真實,也更能把省下的時間用在刀口上。
安全與資料邊界:官方交代了什麼
安全段落有三個與使用方相關的要點。第一,GPT-6 的安全訓練建立在 Astra 世代的多項進展上,對企圖繞過安全訓練的攻擊抵抗力更強,官方特別點名跨多輪對話調整手法的攻擊;第二,針對資安攻擊、生物風險與暴力相關的高風險濫用,防護訓練已依真實世界使用經驗更新,同時減少對無害請求的不必要拒答,並學會利用對話歷史與情境辨識單一提示詞看不出來的風險;第三,模型對自身能力邊界的表達更誠實,包括在缺少資訊或工具時明說。退步面官方也沒有藏:部分安全評測項目分數較前代低,官方經人工複查與對抗式紅隊測試,判定這些不合規回應多屬低嚴重度,並以系統層緩解措施處理。改善與退步的完整對照,收在官方發布的GPT-6 系統卡。
資料與隱私面的官方口徑相對精簡,但有幾件事可以確定:互動元件的狀態存在對話裡,跨對話不留存;已連接的外掛照常運作,官方也未在這篇說明中宣布外掛權限規則的變更;Enterprise 的開放範圍由各組織的管理員設定決定,企業用戶實際能用到什麼,以自家管理後台的政策為準。至於把營收數字、客戶名單這類敏感資料輸入生成的試算工具之前該不該三思,官方文件沒有逐案規範,答案落在各組織自己的資料分級政策上:對話介面便利歸便利,資料分級的判斷標準不應因為工具好用而放寬。
企業採用的評估順序也值得參考。先由 IT 或資安確認組織的資料政策與 ChatGPT 方案設定,再開放小範圍試點,把「哪些資料可以輸入」寫成明確規則,比全面禁止或全面放任都更可行。試點期間收集的素材很簡單:哪些任務真的省了時間、哪些生成結果出過錯、使用者自然發展出哪些提問句式。這些紀錄會成為下一步擴大使用的依據,也是日後評估同類功能時現成的比較基準。
誰該現在就開始用:七種工作情境的實際得失
行銷與內容工作者可以把 Intelligent UI 當成「假設測試的速寫本」。預算分配的情境拉桿、廣告費率級距的對照、內容產能的排程模擬,這類內部討論用的試算,當場生成一個可調介面,比回頭開試算表快,也比口頭描述具體。要留意的是對外發布的數字仍要走正式流程:生成工具算出來的東西是草稿,公版素材上的每一個數字都要有可回溯的來源。另一個被低估的用法是問答設計:把客戶常見問題做成可調參數的情境產生器,第一線人員自己拉條件就能產出對應的回應草稿,這比把 FAQ 文件讀熟再人工組裝快得多,也讓新人有一個可以摸索的環境。對剛接觸 ChatGPT 的同行,ChatGPT 新手完整教學可以先把基礎操作補齊。
教學與知識傳遞的場景收益最明顯。可點擊的解構圖把「講解」變成「探索」,學習者自己點開每個零件的功能,比被動讀一段描述記得牢;參數式圖解則讓抽象概念有了實驗台。企業內訓、課堂教材、對客戶的觀念溝通,都可以用「給我一個可以調某個變數的圖解」這個句式量產雛形,再決定哪些值得做成正式教材。
財務與行政的日常碎片任務是最沒有爭議的應用。聚餐分帳、團購彙整、津貼試算、報表口徑的快速驗算,這些每個月出現一次、每次規格都略有不同的小工具,正是拋棄式生成的甜蜜點:描述需求的前後花費比找到並學會一個現成工具低。至於正式的財務建模與審計軌跡,仍然屬於試算表與專業系統的領域,兩者不衝突。
產品與專案管理者拿到的是決策會議的即時助手。估時的情境模擬、資源分配的拉桿、時程壓縮的取捨對照,這些會議裡「如果改成這樣呢」的問題,以前要回座位開檔案才算得出來,現在當場生成一個可調的簡化模型,討論可以就在那個介面上收斂。要提醒的是這類模型的假設通常被極度簡化,拿來對齊直覺與方向很有效,寫進正式計畫前仍要用專業工具重算。
人資與營運的行政流程也有甜蜜點。教育訓練的排程模擬、休假與排班的快速試排、內部活動的預算分配,這些一年出現幾次、每次規則都微調的小工具,正是描述成本遠低於建置成本的場景。與其每次都拜託資訊單位或自己硬學新工具,把規則講清楚讓它當場組一個,用完就放下,對非技術職系來說門檻低了整整一個量級。
研究與知識管理型的工作者得到的是另一種幫助:把讀到的東西快速變成可操作的整理。讀完一份長報告,讓模型把論點做成可以逐項展開的樹狀整理;比較三份來源對同一件事的說法時,要求做成可切換視角的對照;文獻回顧的初稿清單用勾選元件管理進度。這些應用共同的形狀是「把理解外顯化」:你讀進去的東西,經過一次描述,變成看得見、點得動的結構,遺漏與矛盾在結構裡比在純文字裡更容易被看出來。
對開發者與產品團隊,價值在溝通而非生產。用一個當場生成的互動原型向利害關係人展示「如果使用者可以調這個參數會怎樣」,比投影片有效;但生成出來的介面沒有經過任何工程檢驗,直接當產品上線並不成立。更值得觀察的是戰略層:官方在公告結尾把方向說得很白,幾十年來都是人去學習軟體的固定介面,未來的軟體會圍繞人的目標動態組合。當任務入口從搜尋引擎與應用程式轉向能直接完成任務的 AI 介面,內容與服務的曝光邏輯也會跟著移動,這個變局在GEO 與代理式搜尋的布局指南有專門討論;這波 AI 入口競爭的上一手棋,則可以回看ChatGPT Dots 的深度解析。
同一個需求,入口怎麼選
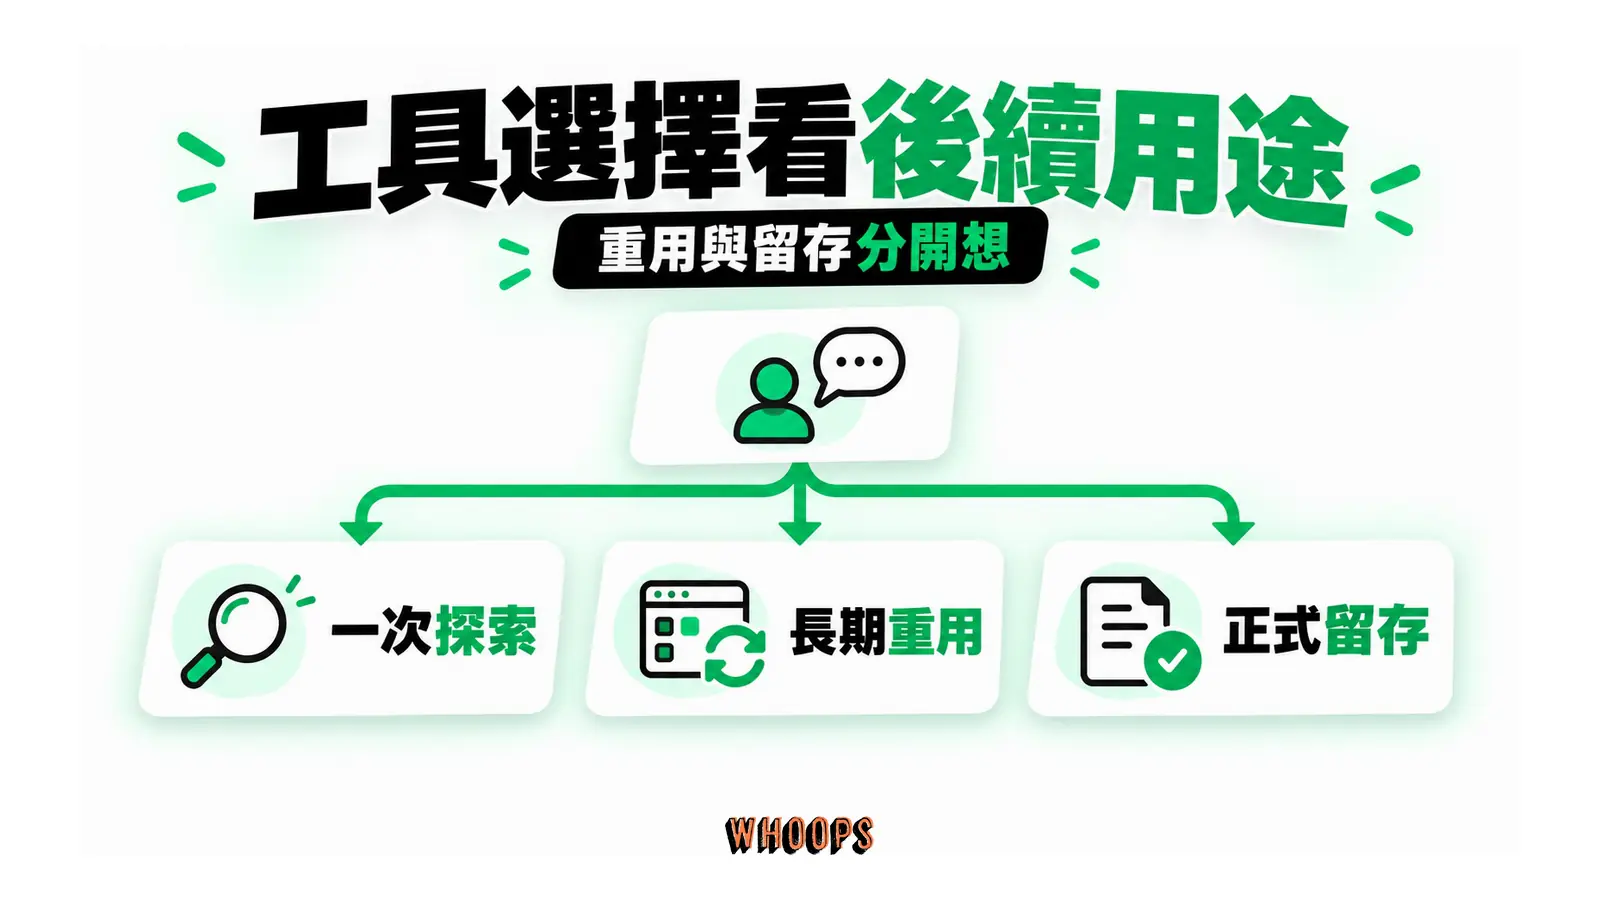
同一個需求往往有好幾個入口能做,選錯入口的代價是繞遠路。判斷的第一個問題是使用次數:只用一次或幾次的試算、比較、示意,讓 Intelligent UI 當場生成最快;會反覆使用、要交給別人用的,走 GPTs 或正式工具,把規格固定下來。第二個問題是資料敏感度:涉及客戶資料、財務細節或任何受規範的資訊,先確認組織政策允許輸入對話式服務,再考慮方便性。第三個問題是輸出的壽命:對話裡的元件不跨對話保留,任何要留檔、要審計、要交接的產出,最終都該落在正式文件或系統裡,介面生成只是中間的思考輔助。把這三問套上去,大部分「到底該用哪個」的猶豫都會消失。
生成結果不理想時,有四個修正動作依序試。第一,指出缺了什麼:直接說明欄位、維度或參數,例如「加上服務費欄位」,單點修改的成功率最高。第二,換形態:文字改表格、表格改工具,講清楚要換成什麼。第三,給範例:貼一小段你期望的版面描述或欄位清單,模型模仿具體範例的能力比理解抽象形容可靠。第四,重開對話重講:對話歷史太長時,早期的誤解會一路殘留,帶著已經想清楚的規格重新描述,往往比在舊對話裡救回來快。四個動作都試過仍不理想,通常代表這個需求本身已經超出拋棄式工具的複雜度,該考慮正式工具了,這也是一個有價值的訊號。
十個限制與常見誤解
- 只存在 Chat 分頁:Work 分頁沒有這套介面,官方說明中心明確寫著不支援。
- 語音模式沒有:Voice 交談維持純對談體驗,看不到互動介面。
- Work 與 Codex 底層未變:這次更新不觸及這兩個產品線的模型。
- 例外是 Pro reasoning:該檔位底層為 GPT-6 Astra,不在涵蓋範圍。
- 狀態不跨對話:勾選進度、輸入過的參數只留在原對話,開新對話即重來。
- 推送無確切完成日:官方未公布全部帳號開通的日期,沒看到功能多半是分批順序問題。這段期間網路上流傳的「教學」常把個別帳號的狀態講成通則,對照官方頁面再採信會穩妥許多。
- 效能數字是內部測試:44% 與代理任務評測都來自 OpenAI 內部,尚無獨立驗證。
- Simple 是減量非關閉:設定後視覺與互動元件會減少,部分仍可能出現。
- 介面不等於正確:計算與事實仍要複核,模型可能生成好看但算錯的工具。元件的互動行為可靠,模型填進去的數字與邏輯仍由生成當下的推理決定,公式寫錯的計算器一樣會一路錯到底。
- 行動裝置體驗因版本而異:官方定位為跨網頁與行動裝置的體驗,實際呈現以帳號當前版本為準。
十分鐘驗證清單:確認你的帳號吃到哪些更新
與其在社群訊息裡猜自己有沒有被開通,花十分鐘按下面順序走一遍,答案就會很清楚。
- 檢查模型選單:新對話裡看模型選項是否已出現 GPT-6(方案對應為 Free 與 Go 使用 Luna、付費方案使用 Sol,選單實際顯示以帳號為準)。
- 確認位置:在 Chat 分頁測試,避開 Work 分頁與語音模式。
- 發一則比較型提問:例如兩個方案的多維度比較,看是否出現並排版面。
- 發一則工具型提問:用前面範例裡的分帳或試算提問,看是否生成可輸入、可調整的介面。
- 測一次 Simple 開關:照前段路徑切到 Simple,回同一對話再問一次,感受差異後再決定留在哪個模式。
- 記錄命中的情境:哪些提問拿到了好介面、哪些回到純文字,把有效的句式存下來,累積成自己的提問庫。
收攏:把介面生成當成新的提問能力
Intelligent UI 真正值得認真看待的地方,在於它改變了「提問」這個動作的單位。以前的提問換回一段文字,現在的提問可以換回一個能操作的環境;會提問的人得到的回報變大了,能把需求描述成參數、假設與呈現偏好的人,拿到的介面會明顯好用。這也是為什麼前面花了一整節講提問方法:工具的門檻降低了,勝負移到問題的定義能力上。
邊界同樣要放在秤上。一次性、低風險、試算與溝通性質的任務,儘管讓它當場組介面;需要重複使用、多人協作、審計軌跡或對外承諾的流程,正式工具的位子沒有被取代。功能還在分批推送、元件庫還在擴充、設計判斷官方自認仍有進步空間,現在的聰明做法是把它納入日常工具箱的一格,邊用邊累積自己領域裡的提問句式,等後續版本把能力墊高時,你已經帶著一套驗證過的用法在線上。
回到採購與學習的決策:這不是一個需要立刻付費升級才能體驗的功能。Free 與 Go 用戶分批拿到 GPT-6 Luna 後,四種回應形態都能用得到,先用免費額度把提問句式練起來,再依實際工作負載決定要不要往上買,是成本最低的路徑。付費方案的加分在 Sol 的能力與更大的額度,兩款模型在互動介面的支援範圍上並沒有分別;預算該不該加,回到各方案額度與自己用量的交集,這個交集只有自己的使用紀錄能回答。