AI 影片提示詞指南:從分鏡到產出的通用框架、鏡頭語言詞彙表與四家官方寫法對照
AI 影片提示詞跟生圖差在時間軸、運鏡與連續性三個維度。本文以 2026 年 10 月 9 日查證的 Veo 3.1、Seedance、Sora 2(封存指南;產品與 API 已停止服務)、Midjourney V1 四份官方文件為本,整理鏡頭距離、角度、運鏡英文詞彙表、七位置通用骨架、五個行銷場景原創範例與首拍除錯順序。
本頁目錄
- 影片提示詞跟生圖差在哪:時間軸、運鏡、連續性
- 時間軸:動作有先後,秒數有限制
- 運鏡:鏡頭本身就是一個角色
- 連續性:跨鏡頭的主體與物理要一致
- 鏡頭語言詞彙表:距離、角度、運鏡的英文術語
- 鏡頭距離(景別):主體在畫面裡多大
- 拍攝角度:鏡頭從哪個高度看
- 運鏡:鏡頭在播放期間怎麼動
- 先當分鏡師:從行銷目標到鏡頭清單
- 通用骨架:把一段影片提示詞拆成七個位置
- 四家官方文件怎麼教:同一套骨架的四種格式
- Google Veo 3.1:要素清單式,鏡頭與聲音詞彙直接內建
- Seedance:自然語言分段,鏡頭切換語撐起多鏡頭敘事
- Sora 2:四段式結構,細節提示換控制力
- Midjourney V1:圖轉影片,動態強度二分
- JSON 欄位式與時間戳寫法:官方規格還是社群慣例
- 原創範例庫:五個行銷場景的提示詞長怎樣
- 中文想法怎麼變成英文提示詞
- 場景一:電商產品動態展示(八秒、兩顆鏡頭)
- 場景二:知識型內容開場圖解(六秒、單鏡頭)
- 場景三:社群短影音鉤子(直式 9:16、五秒)
- 場景四:品牌形象 B-roll 空鏡(八秒、單鏡頭)
- 場景五:活動資訊宣傳字卡(六秒、單鏡頭)
- 首拍不滿意怎麼改:一層一層除錯
- 交付前檢查:浮水印、授權與五項目檢
- 工具怎麼選:把這套框架帶去對的平台
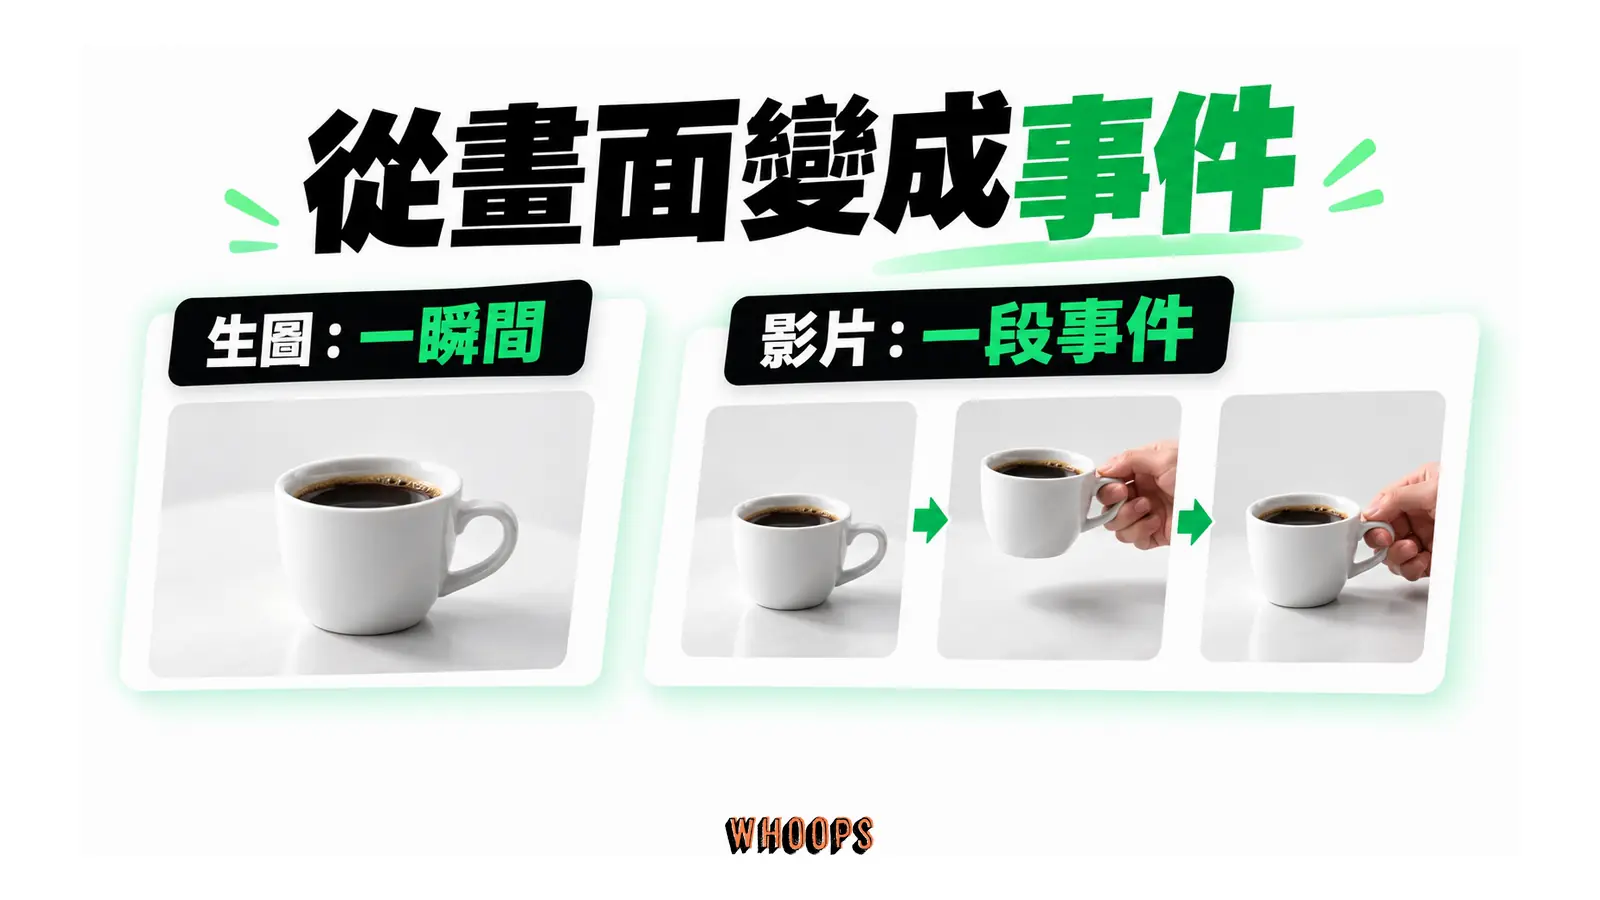
AI 影片提示詞跟生圖提示詞的最大差異,一句話說完:你在描述一段事件,而不是一個畫面。生圖只要交代主體、風格與光線,模型凍結一瞬間就完工;影片模型要在數秒到三十秒的篇幅裡演出先後順序,鏡頭自己會動,主體跨鏡頭不能變形,所以提示詞要多管三個變數:時間軸、運鏡、連續性。這篇指南把這三個變數拆開教,給你一套鏡頭距離、拍攝角度與運鏡的英文詞彙表,一個能套進任何工具的七位置骨架,再用 2026 年 10 月 9 日一手查證的四份官方文件,對照 Google Veo 3.1、Seedance、Midjourney V1 與已停產的 Sora 2(封存指南)各自留下的寫法,收在五個可以直接複製修改的行銷場景範例與首拍失敗的除錯順序。
先講會改變你寫法的關鍵事實。第一,四份官方文件背後的原理幾乎互通,格式卻不一樣:Veo 用要素清單、Seedance 官方用自然語言分段加鏡頭切換語、Sora 2 的封存指南用四段式結構、Midjourney 走圖轉影片加動態強度二分,學會一套通用骨架就能全部搬用。第二,網路上流傳的 JSON 欄位式提示詞是社群發展出來的整理法,Veo 官方文件列的是要素建議而非 JSON 格式,這點後面會用原文說清楚,避免你把社群慣例當成官方規格。第三,鏡頭術語建議用英文寫:四份官方文件的範例與建議詞彙都以英文電影術語為本,Veo 官方更載明英文完整支援、其他語言未經評估而成果可能有差異,Seedance 官方指南則明載提示詞支援中文與英文兩種語言。
影片提示詞跟生圖差在哪:時間軸、運鏡、連續性
把生圖提示詞的習慣直接搬來寫影片,是新手成果不穩的最大原因。生圖模型輸出的是靜態幀,畫面裡的動作只是暗示;影片模型輸出的是一段播放過程,任何你沒交代的地方,模型都會自己腦補成某種運動。三個新維度各自對應一種寫法改變,拆開看。
時間軸:動作有先後,秒數有限制
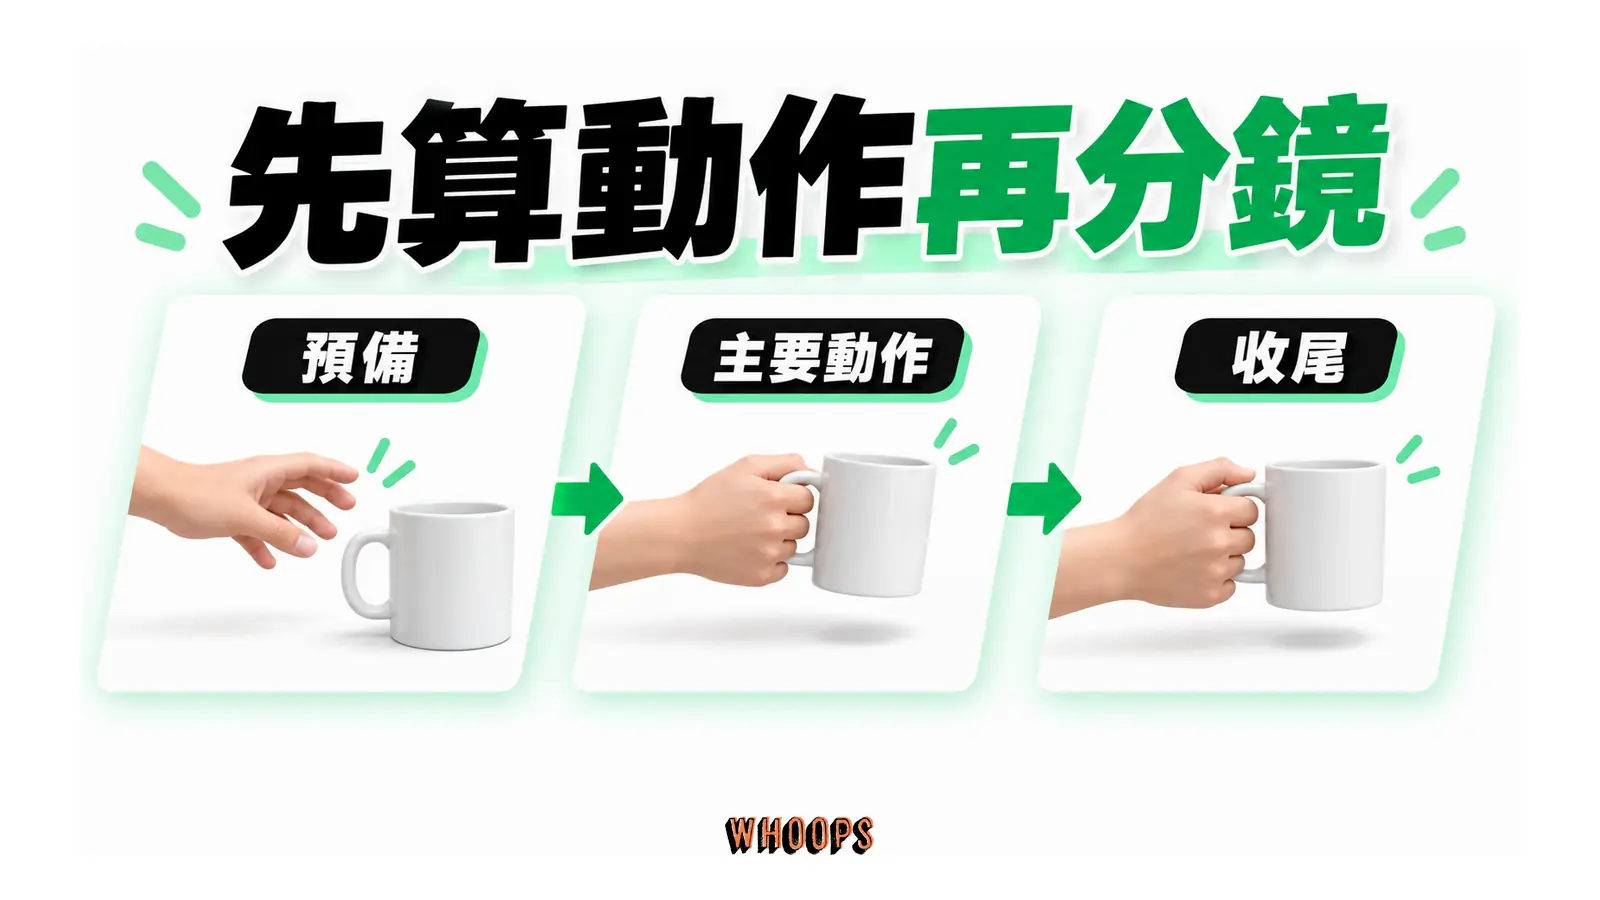
影片提示詞裡的動作要按發生順序寫。官方文件在這點上立場一致:Seedance 官方指南教進階使用者「依照動作發生的時間線清楚描述多個動作」,才能做出單角色多動作或多人多動作;Sora 2 的封存指南建議把每個動作寫成明確的節拍,例如演員走四步到窗邊、停頓、在最後一秒拉開窗簾。順序錯了,模型照樣照你的文字順序演,成果就會卡成一團。
秒數是硬限制,也該寫進規劃。各家單次生成長度不同:Veo 3.1 是四、六、八秒,Midjourney V1 起始五秒,Seedance 2.0 系列落在四到十五秒、現行的 2.5 單次最長可到三十秒,Sora 2 的封存指南則記載到二十秒。短秒數意味著一個鏡頭塞不下太多事,Sora 的封存指南甚至直接建議,兩段四秒分開生成再剪接,效果好過直接生一段八秒,指令遵循度更好。規劃時先算好每個動作吃幾秒,再決定這個鏡頭要不要拆。
秒數分配有個好用的粗算法:一顆鏡頭一個主要動作,預備與收尾各留半秒到一秒。開門這種單一動作,推門一秒、走進來一秒、回頭一秒,三秒正好;若想加上放下東西再坐下,動作弧變成三段,秒數就該往六到八秒爭,或者拆成兩顆鏡頭。反過來算也成立:客戶給你一支十五秒的檔期,扣掉字卡與 logo 動畫大約五秒,畫面只剩十秒,那就是兩顆四秒或一顆八秒的結構,分鏡從這裡倒推,不會做出塞爆的鏡頭。
運鏡:鏡頭本身就是一個角色
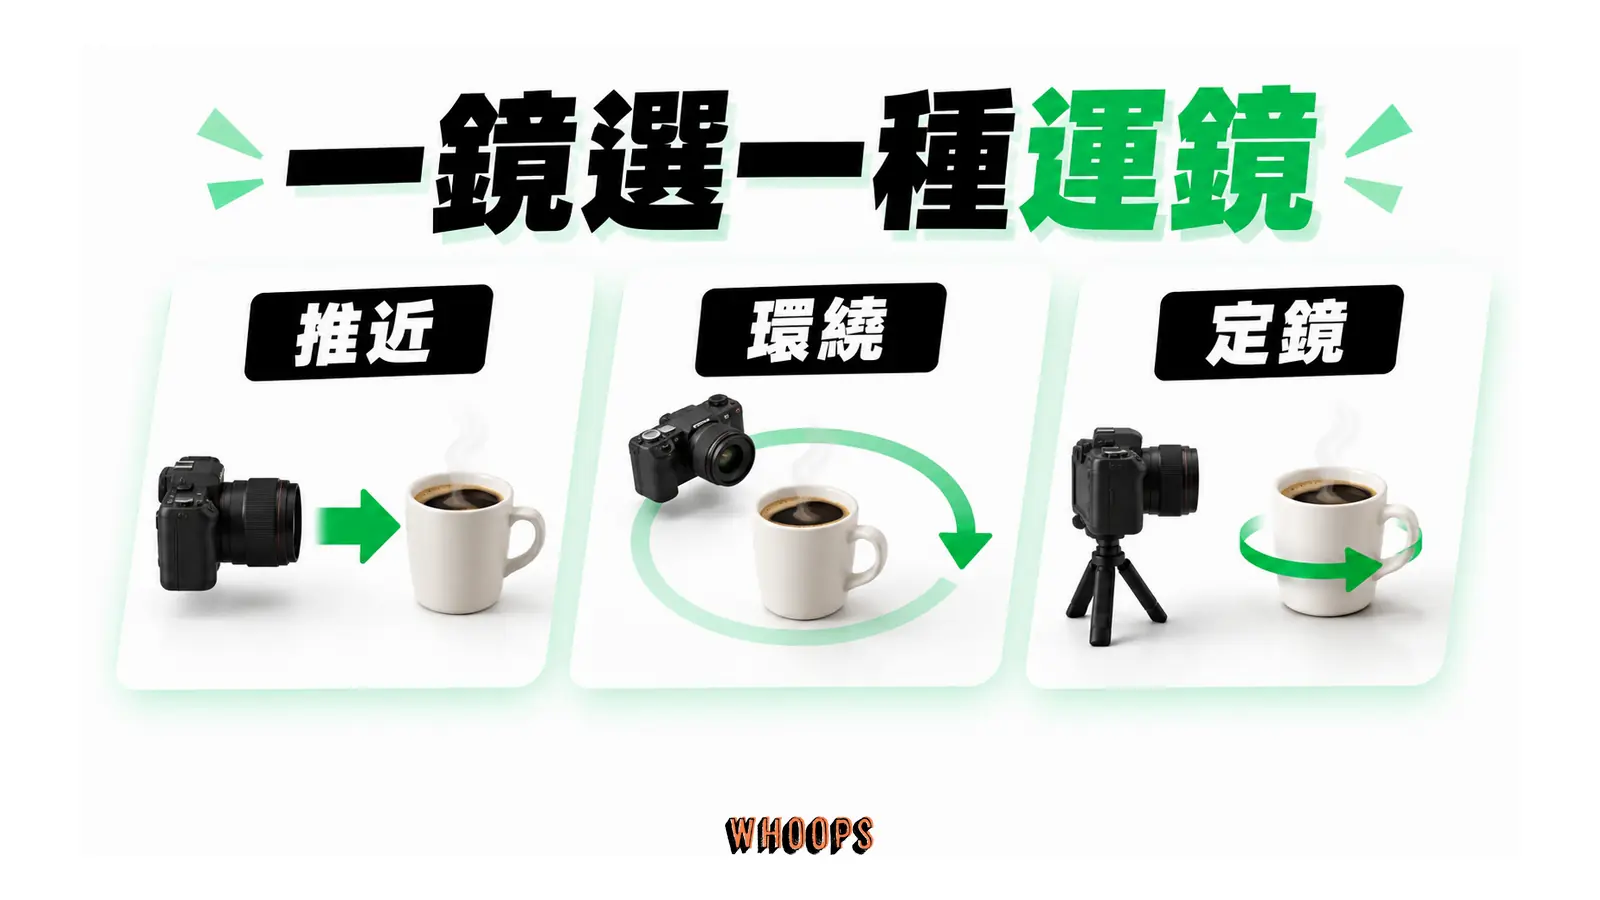
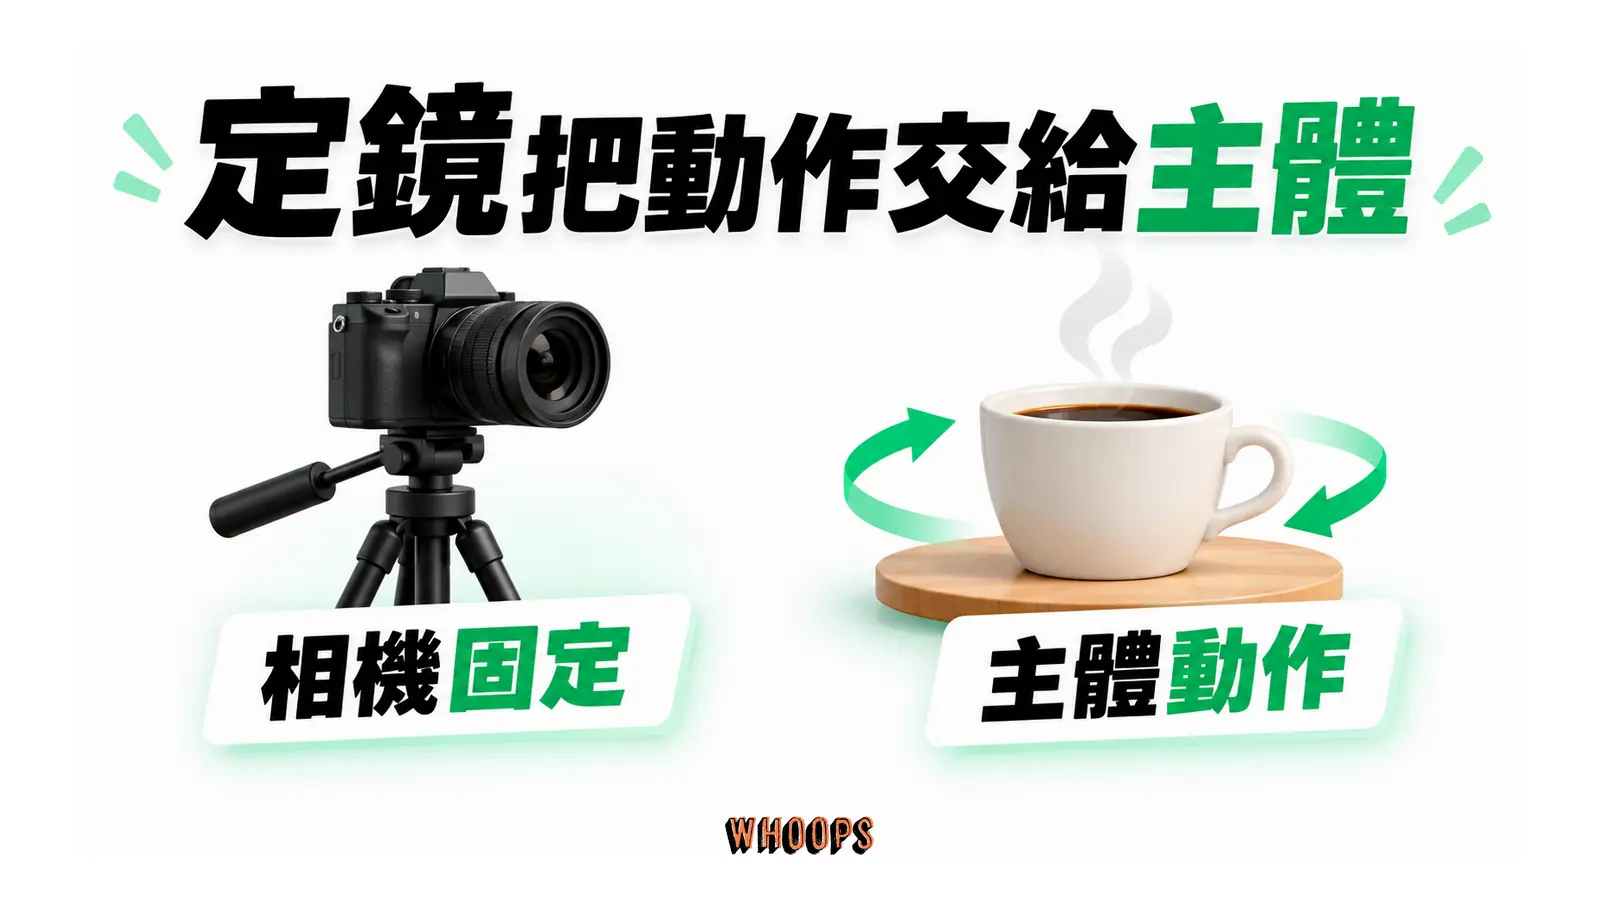
生圖提示詞決定的是拍攝那一刻的角度與距離;影片提示詞要多決定一件事:鏡頭接下來怎麼動。同樣一個產品放在桌上,鏡頭緩慢推進是迫近感,繞著產品環繞是立體展示,固定不動只讓產品自己轉又是另一種氣質。你不寫,模型就亂選,這是「明明描述得很清楚、畫面卻一直亂晃」的主要病因。運鏡詞彙表在下一節,這裡先記住原則:一個鏡頭用一個主要運鏡,不要把 push in 加 orbit 加 pan 全塞進同一句。
連續性:跨鏡頭的主體與物理要一致
影片有兩種連續性。縱向是同一顆鏡頭內的物理合理:手拿杯子的角度、水流進杯子的速度、布料皺褶的變化,模型物理模擬不準時就會穿幫。橫向是鏡頭之間的主體一致:上一顆鏡頭的模特兒換到下一顆鏡頭,臉、服裝、色調不能飄。官方工具的解法分成兩派:Seedance 官方指南說多鏡頭提示詞會依你的描述維持主體、風格與場景的連續性;Sora 2 的封存指南則示範過角色參考做法:上傳一段兩到四秒的影片當角色錨點,一次生成最多掛兩個角色,這套思路可遷移到現行工具的角色一致性功能。生圖模型沒有這些問題,因為它只需要對一幀負責。
實務上對抗飄移最有力的武器其實在生圖端:先把主體的定裝圖用生圖模型修到滿意,再以圖生影片。Veo 的參考圖最多掛三張,Midjourney 整個影片功能就是建立在起始幀之上,連結尾幀都能指定,Sora 封存指南對參考圖的要求則是解析度須與目標輸出一致。這條路把「文字描述的一致性」換成「同一張圖的一致性」,可靠度直接跳一級,代價是多一道前置工序,重要專案幾乎都值得。
三個維度加起來,影片提示詞的工作量大約是生圖的三倍,但結構化之後並不難寫:先想分鏡,再套骨架,接著按工具格式微調。後續幾節就是這條路徑的每一步。
鏡頭語言詞彙表:距離、角度、運鏡的英文術語
鏡頭語言是百年電影工業沉澱下來的共通詞彙,四家官方文件示範的提示詞與詞彙建議都以英文電影術語為本,Veo 官方並載明英文完整支援、其他語言未經評估而成果可能有差異,因此鏡頭術語寫英文是最穩的選擇。官方文件直接列出的詞彙包括:Veo 官方在鏡頭位置與運動的建議裡列了 aerial view、eye-level、top-down shot、dolly shot、worm's eye 這類詞;Seedance 官方指南說模型能準確回應 tracking shot、pan left/right、truck left/right 等運鏡提示。下表整理成三組,每個詞附行銷與知識內容情境的效果說明,直接挑用。
鏡頭距離(景別):主體在畫面裡多大
左右捲動檢視完整表格
| 英文術語 | 中文慣稱 | 畫面內容 | 行銷情境效果 |
|---|---|---|---|
| extreme wide shot | 大遠景 | 主體只佔畫面極小部分,環境主導 | 開場建立世界觀,適合品牌形象片 |
| wide shot | 遠景 | 主體完整可見加上周圍環境 | 展示空間、店面、使用情境 |
| full shot | 全景 | 人物全身入鏡 | 展示穿著、全身動作、舞蹈 |
| medium shot | 中景 | 人物腰部以上 | 對話與操作演示的主力景別 |
| medium close-up | 中特寫 | 胸部以上 | 講述型內容、表情與口白兼具 |
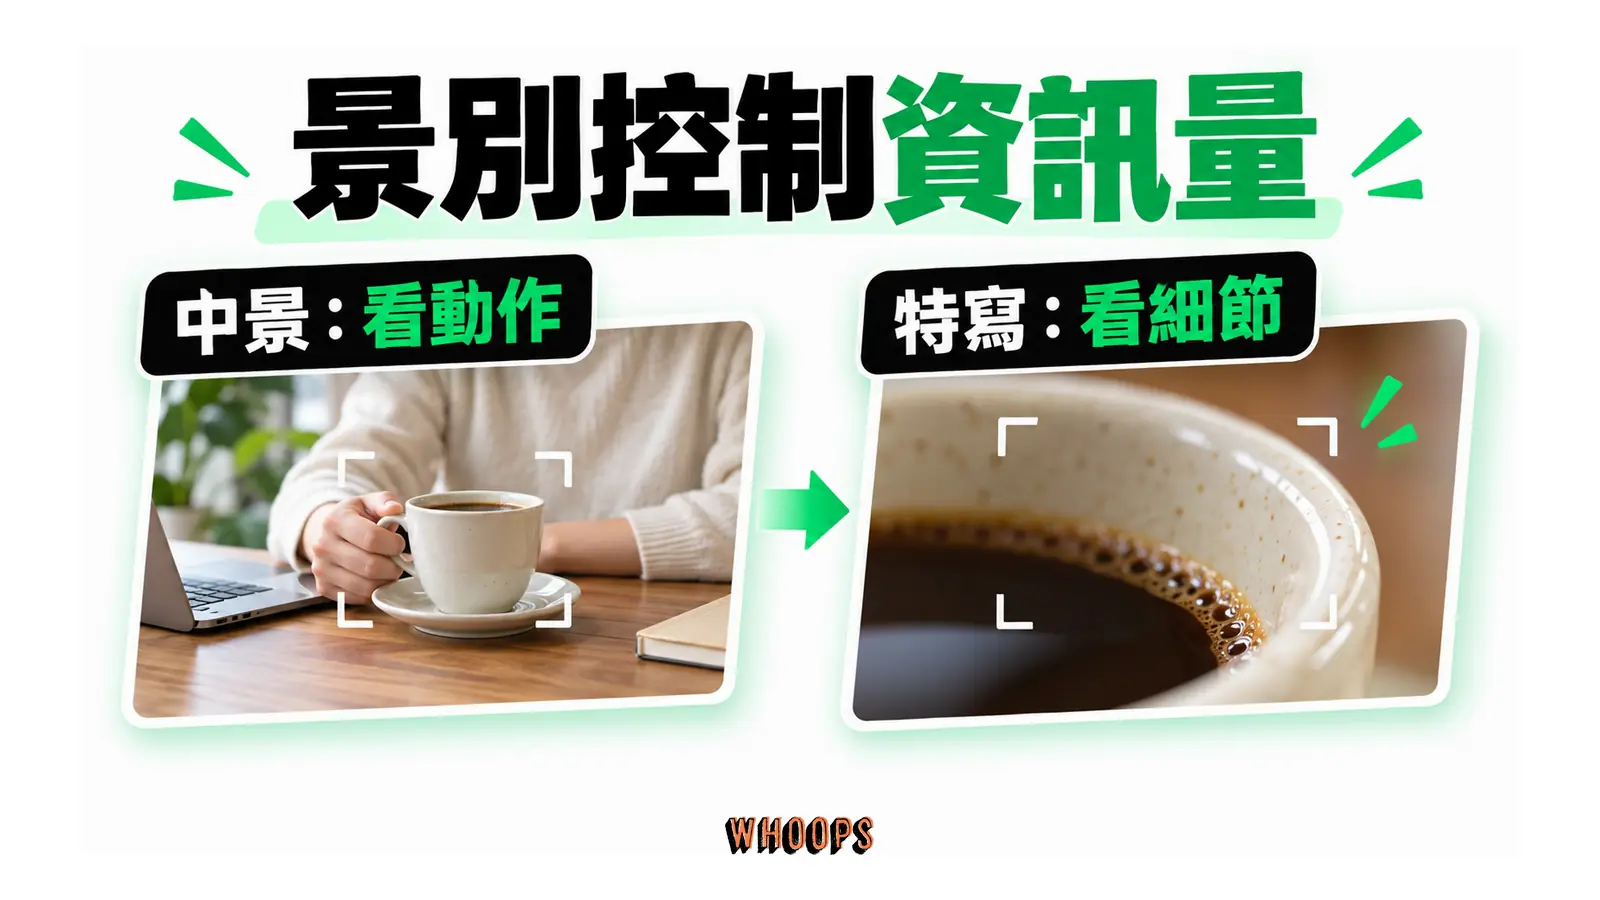
| close-up | 特寫 | 臉部或單一物件滿框 | 情緒、產品細節、質感工藝 |
| extreme close-up | 大特寫 | 局部放大,如眼睛、按鍵 | 張力與懸念,強調微小訊息 |
| macro shot | 微距 | 極近距離,可見紋理細節 | 材質、水珠、織物、食品表面 |
行銷影片常用節奏是中景與特寫輪替:中景交代誰在做什麼,特寫給觀眾看細節,來回切換就自然產生節奏感。Seedance 官方指南也把 long shot、full shot、medium shot、close-up 列為可用專業景別描述,Veo 官方同樣把 wide shot、close-up、single-shot、two-shot 放進構圖建議,這組詞跨工具通用。
拍攝角度:鏡頭從哪個高度看
左右捲動檢視完整表格
| 英文術語 | 中文慣稱 | 鏡頭位置 | 效果 |
|---|---|---|---|
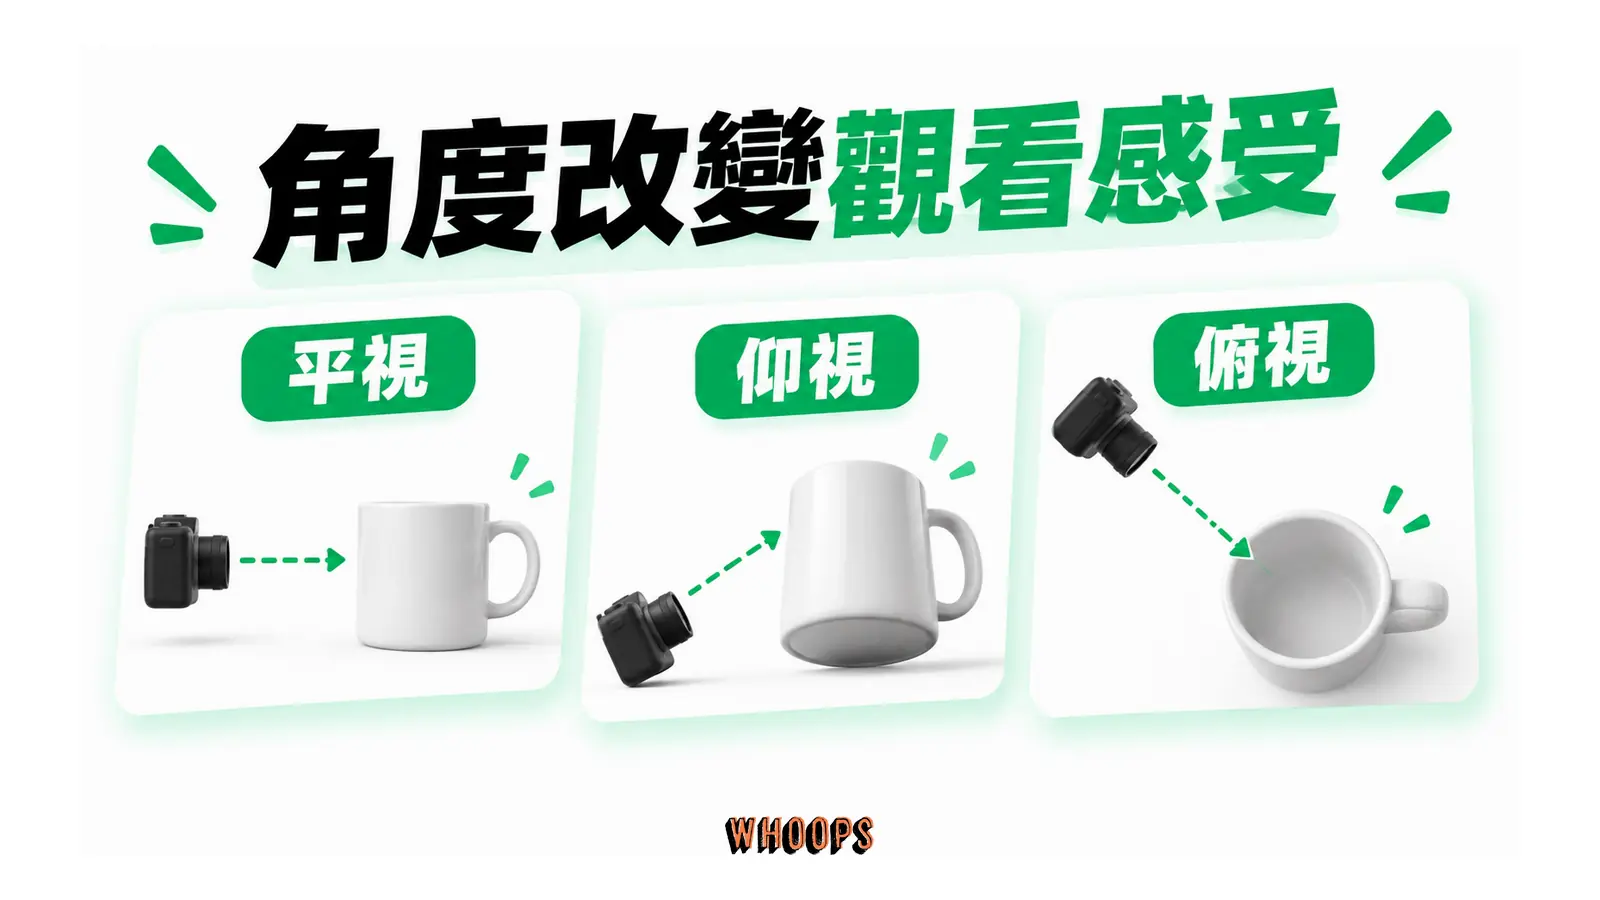
| eye-level | 平視 | 與主體視線同高 | 中性自然,多數內容的預設值 |
| low angle | 仰角 | 從低處往上拍 | 氣勢、權威、產品的英雄感 |
| high angle | 俯角 | 從高處往下拍 | 主體顯得渺小、處境感 |
| bird's-eye view | 鳥瞰 | 正上方垂直往下 | 桌面布局、開箱、圖解動畫 |
| worm's eye view | 蟲視 | 貼近地面往上 | 誇張透視、建築與高度感 |
| Dutch angle | 斜角 | 鏡頭刻意傾斜 | 不安、動感、非主流氣息 |
| over-the-shoulder | 過肩 | 越過一人肩上看另一人 | 對話感、教學演示的臨場感 |
| POV / first-person | 主觀視角 | 模擬主角眼睛所見 | 沉浸、體驗、實際操作視角 |
| aerial / drone shot | 空拍 | 無人機視角俯瞰大地 | 開場大場面、Veo 官方範例愛用 |
角度是情緒語言。賣旗艦產品用 low angle 給英雄感,做教學用 eye-level 加 over-the-shoulder 保持親近,開箱或料理內容用 bird's-eye view 讓桌面動線一目了然。Veo 官方建議的 aerial view、eye-level、top-down shot、worm's eye 全在這組詞裡,Seedance 官方也示範過 underwater shot、aerial shot、high-angle、low-angle、macro 與「以某物為前景」的寫法。
運鏡:鏡頭在播放期間怎麼動
左右捲動檢視完整表格
| 英文術語 | 鏡頭動作 | 效果與適用 |
|---|---|---|
| static shot / locked-off | 固定不動 | 穩定專業,讓主體動作自己說話 |
| pan left / pan right | 原地水平轉動 | 掃過環境、揭露新元素 |
| tilt up / tilt down | 原地垂直轉動 | 由下往上揭露全貌,或反向收尾 |
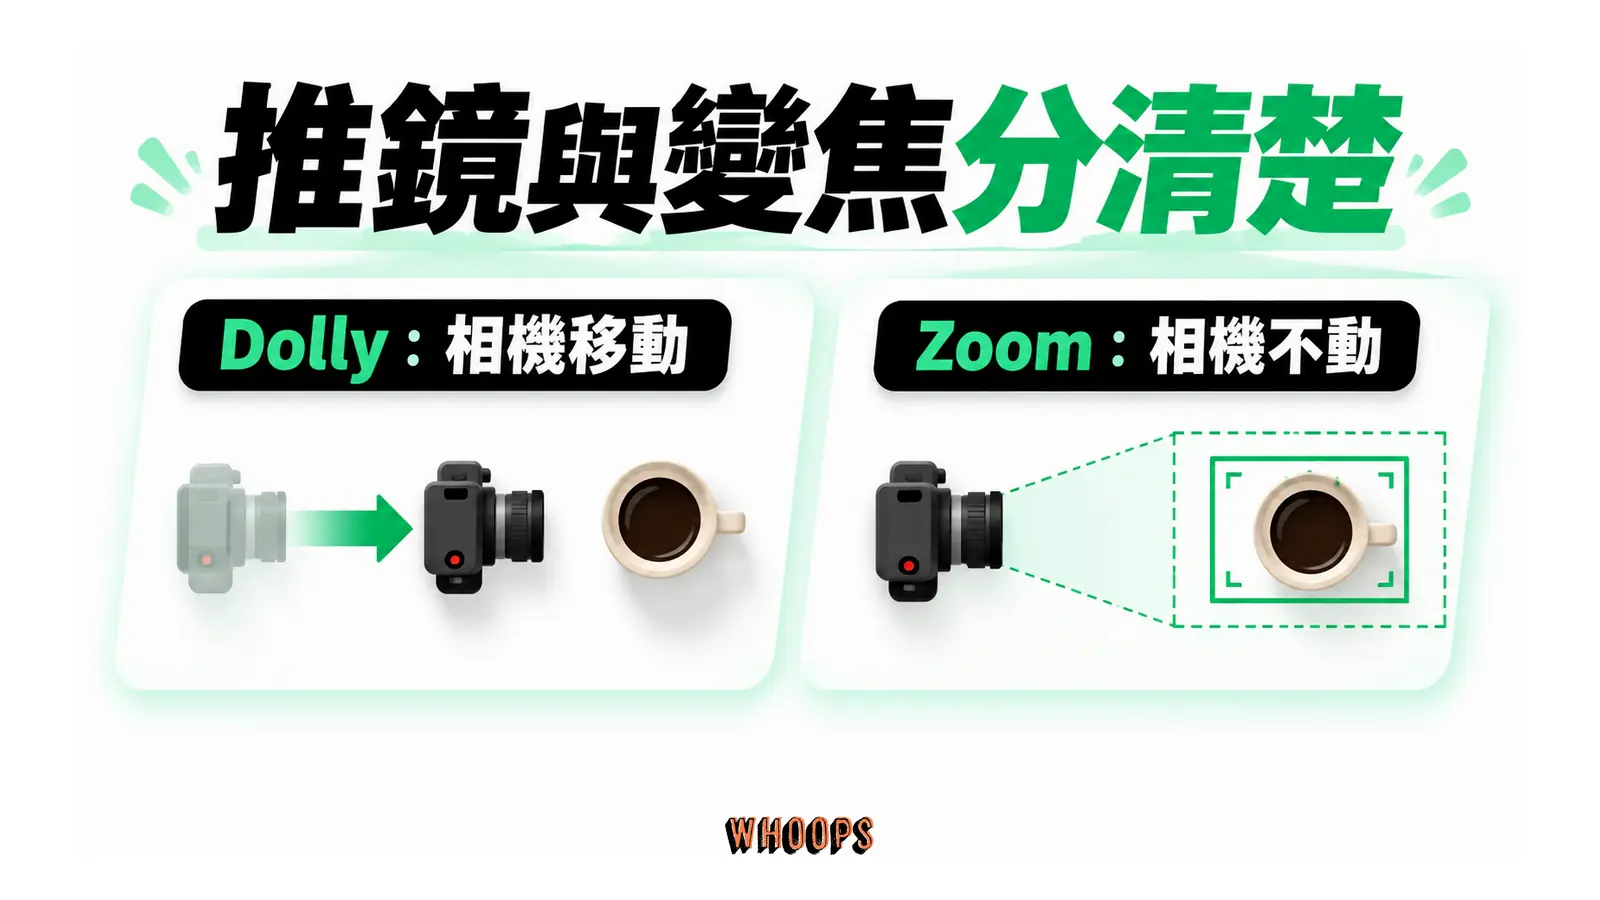
| dolly in / push in | 整顆鏡頭推近主體 | 迫近感、專注、情緒升高 |
| dolly out / pull back | 整顆鏡頭拉遠 | 揭露環境、收場、孤獨感 |
| truck left / truck right | 整顆鏡頭平行移動 | 跟著走動的主體側移 |
| tracking shot / follow | 跟隨主體移動 | 追逐、旅行、運動感 |
| crane up / crane down | 吊臂升降 | 儀式感開場與收尾 |
| orbit / arc shot | 環繞主體轉圈 | 立體展示產品、空間感 |
| zoom in / zoom out | 鏡頭內變焦 | 快速聚焦或放大處境 |
| dolly zoom | 推近同時變焦 | 暈眩效果,背景壓縮主體不變 |
| handheld | 手持晃動 | 紀錄片感、臨場、緊張 |
| FPV | 第一人稱穿越機 | 高速穿越空間的刺激感 |
dolly 與 zoom 常被混用,但對模型是兩回事:dolly 是鏡頭物理移動,透視會變;zoom 是鏡頭內變焦,透視不變。要那種「慢慢逼近主角」的電影感寫 slow dolly in,要那種「畫面突然放大」的廉價感才寫 zoom in。Seedance 官方指南給的範例能看出顆粒度:push(推入)、pull(拉出)、pan(搖)、move(橫移)、circle around(環繞)、follow(跟隨)、rise(上升)、zoom(變焦)都有對應示範,進階還能把多個運鏡組合成一鏡到底的長鏡頭,例如從寵物視線高度開始、跟著跑動、接近主角時上搖、再緩慢環繞。
還有一個容易漏寫的欄位是「鏡頭不動」。你要的是產品自己轉、環境自己活(窗簾飄、蒸氣升),就明白寫 static locked-off camera,把動作全部留給主體,否則模型可能好心幫你加一堆不必要的運動。
三張表不必一次背完。入門先記九個詞就夠工作:景別抓 medium shot 與 close-up,角度抓 eye-level 與 low angle,運鏡抓 static、dolly in、orbit、tracking、pan,這九個詞的排列組合已能覆蓋多數行銷與知識內容的鏡頭需求。其餘的詞在需要特殊效果時回來查,用過兩次自然就記住。判斷自己是否學會的標準很簡單:看一支喜歡的廣告,能說出它每顆鏡頭用的距離、角度與運鏡,你就已經在用導演的眼睛看影片了。
先當分鏡師:從行銷目標到鏡頭清單
提示詞寫不好,問題多半出在還沒想清楚就要模型開拍,文筆反而次要。動筆前先做分鏡師的工作,把「我要一支產品影片」這種目標語言,翻成三到五列的鏡頭清單,每一列只有四個欄位:這顆鏡頭給誰看、主體是什麼、發生一個什麼動作、鏡頭怎麼處理。這張清單就是全部提示詞的原料,之後每顆鏡頭照骨架展開成完整提示詞,工作就變成填充題。
鏡頭數量先被兩件事決定:平台與注意力。直式社群動態的前三秒決定留存,清單第一顆鏡頭必須是畫面最有張力的那顆,概念鋪陳全部往後放或乾脆刪掉;放在官網首頁或簡報裡的橫式素材沒有滑走的壓力,可以從容地用一顆緩慢的空鏡開場。同一份素材要跨平台用,就規劃直式與橫式兩張清單,生成後硬裁是下策,模型對畫面邊緣的處理不保證禁得起裁切,重新生成一幅直式構圖比事後補救省事。
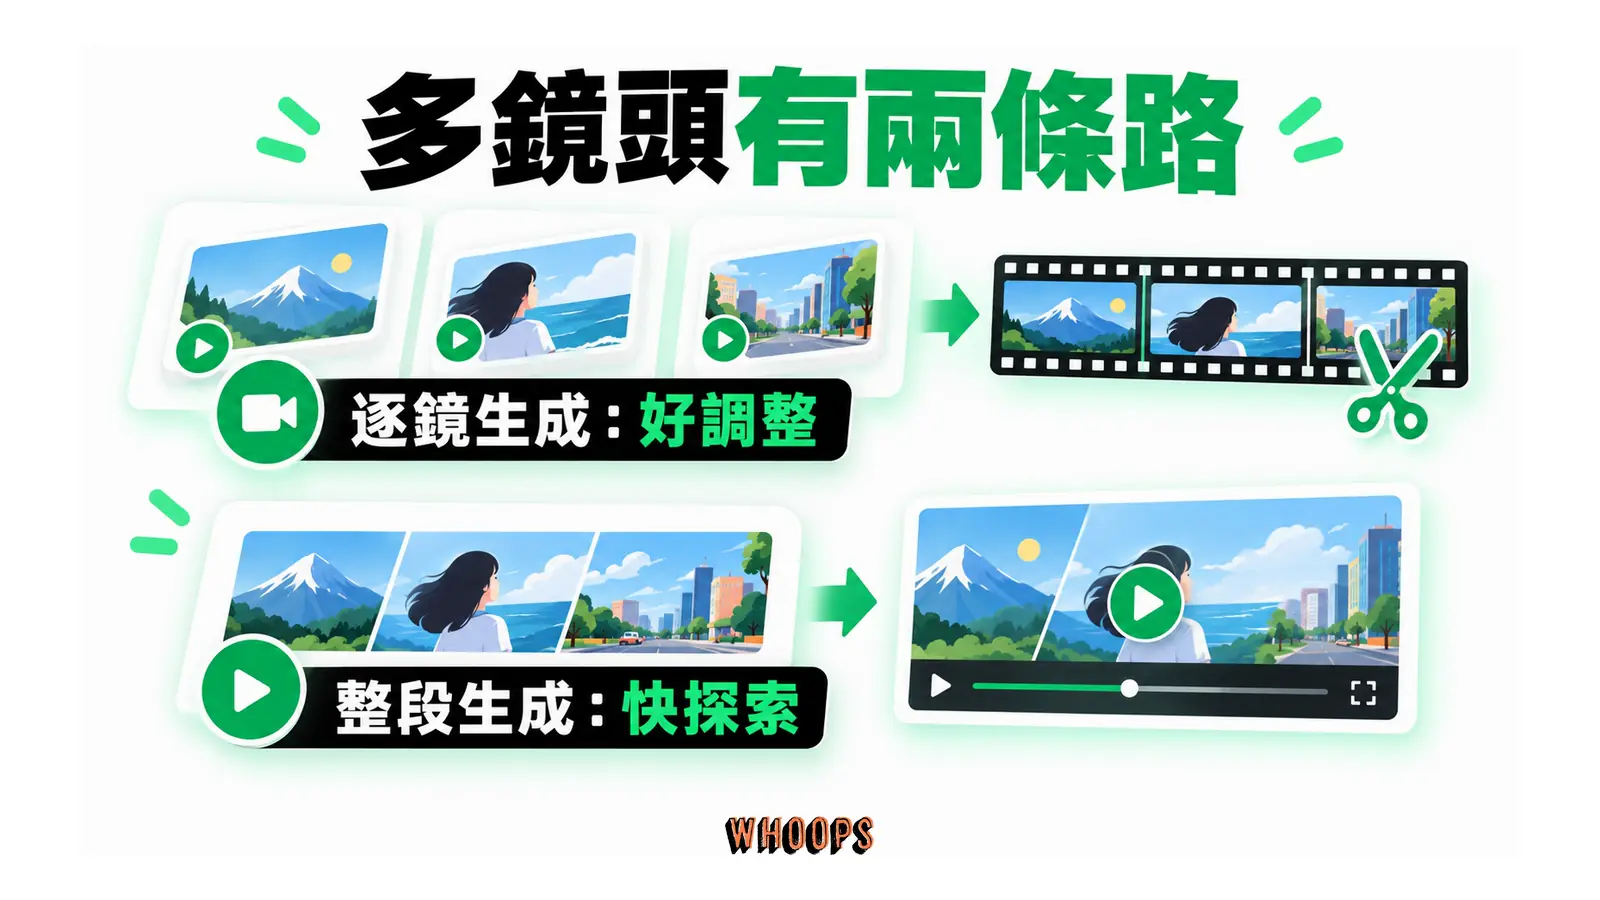
多顆鏡頭的組裝有兩條路。路線一是一鏡一份提示詞,生成後進剪輯軟體接起來,控制力最高,單顆失敗重滾不影響其他顆,重要專案走這條。路線二是把整段分鏡寫進同一份提示詞,用 Seedance 官方的鏡頭切換語或 Sora 封存指南的節拍清單讓模型自己換鏡頭,速度快、適合探索氣氛,但換鏡點的詮釋權在模型手上。實務上的折衷是:關鍵鏡頭(開頭鉤子與產品特寫)單獨生成,過場與空鏡用整段式快速鋪量。
分鏡階段還要決定聲音的命運。要原生對白與環境音的專案,鏡頭清單就得連聲音一起想,因為對白長度倒推鏡頭秒數,四秒裝不下兩句以上的話;打算後製配音或配樂的專案,生成時專心顧畫面就好,聲音留白反而乾淨。這個決定越早做,骨架第六格越不會白寫。
通用骨架:把一段影片提示詞拆成七個位置
詞彙備齊後,組裝有固定順序。寫任何一顆鏡頭的提示詞前,先當自己的分鏡師:這顆鏡頭給誰看、要傳達什麼、鏡頭從哪到哪,想清楚再動筆,產出穩定度會直接反映在生成結果上。一個鏡頭用一段提示詞,七個位置由前往後填。
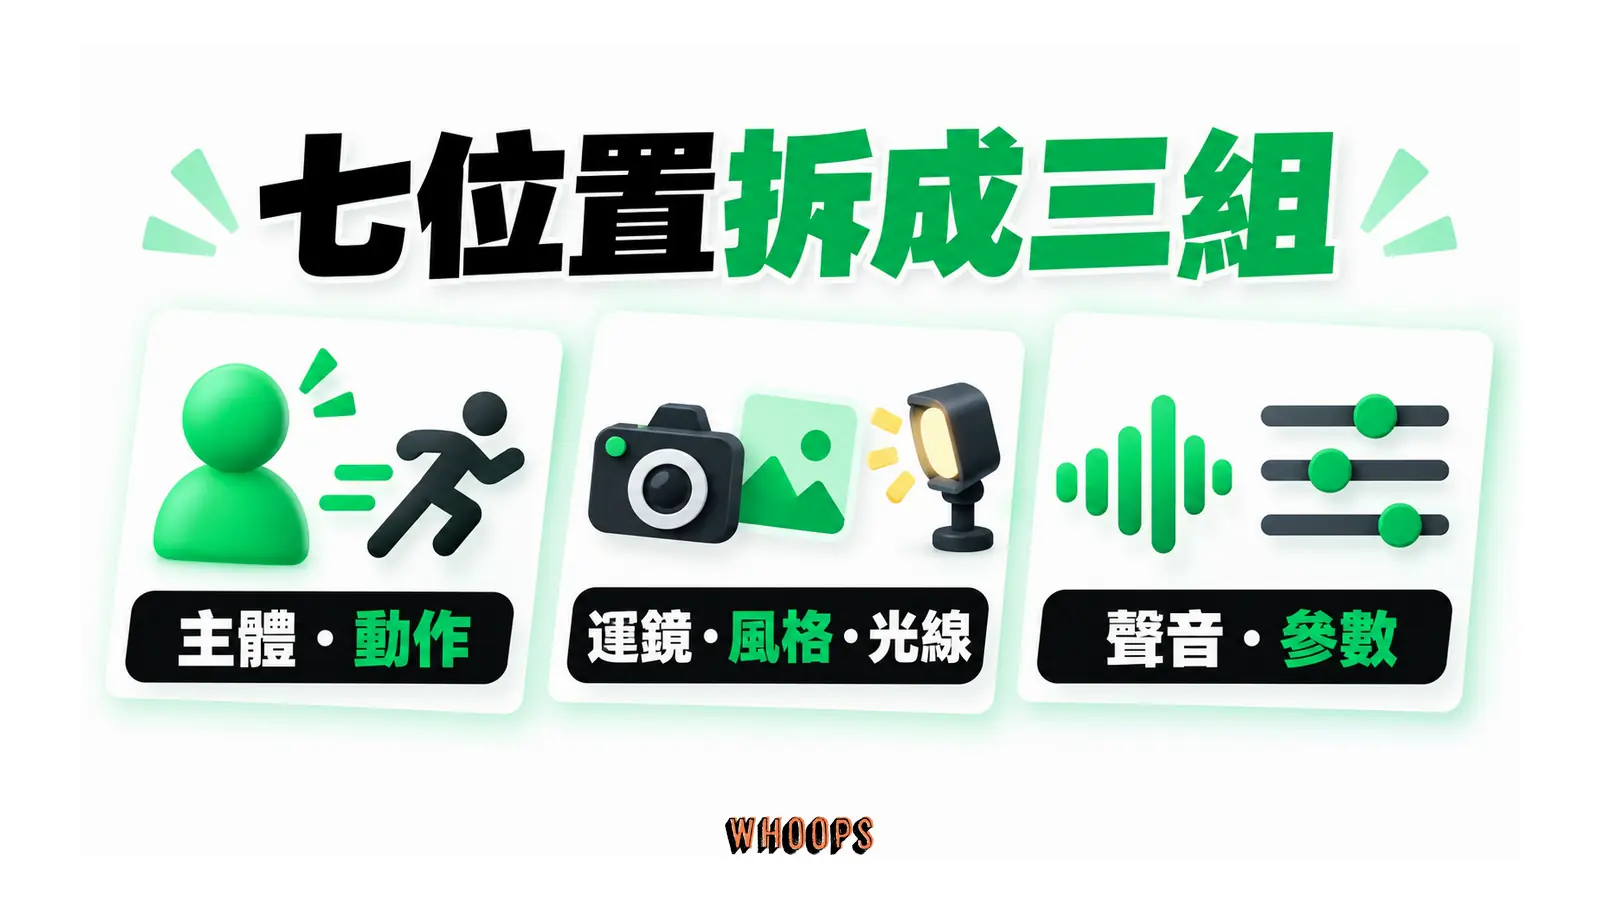
- 主體:誰或什麼,加外觀錨點。人的衣著髮型、產品的材質顏色、場景的風格年代,細節越具體,跨鏡頭越不容易飄。
- 動作:發生什麼事,按時間順序寫,一個鏡頭一個主要動作弧。多個小動作用先後連接詞串,不要寫成並列。
- 運鏡與構圖:鏡頭距離、角度、怎麼動。從詞彙表挑一個景別加一個運鏡,兩者寫成兩個子句。
- 風格:片型或視覺流派。寫實廣告、70 年代浪漫電影、停格黏土動畫、2D 手繪,片型一錨,調色與質感就跟著走。
- 燈光與氛圍:光源方向、色溫、氣氛。黃昏暖光、陰天柔光、霓虹夜色,這格決定成片的情緒層。
- 聲音:對白、音效、環境音。支援原生音訊的工具才需要寫,對白用引號、音效明寫、環境音描述場景聲景。
- 技術參數:時長、比例、解析度。能用參數指定的就用參數,不要塞進敘述文字裡。
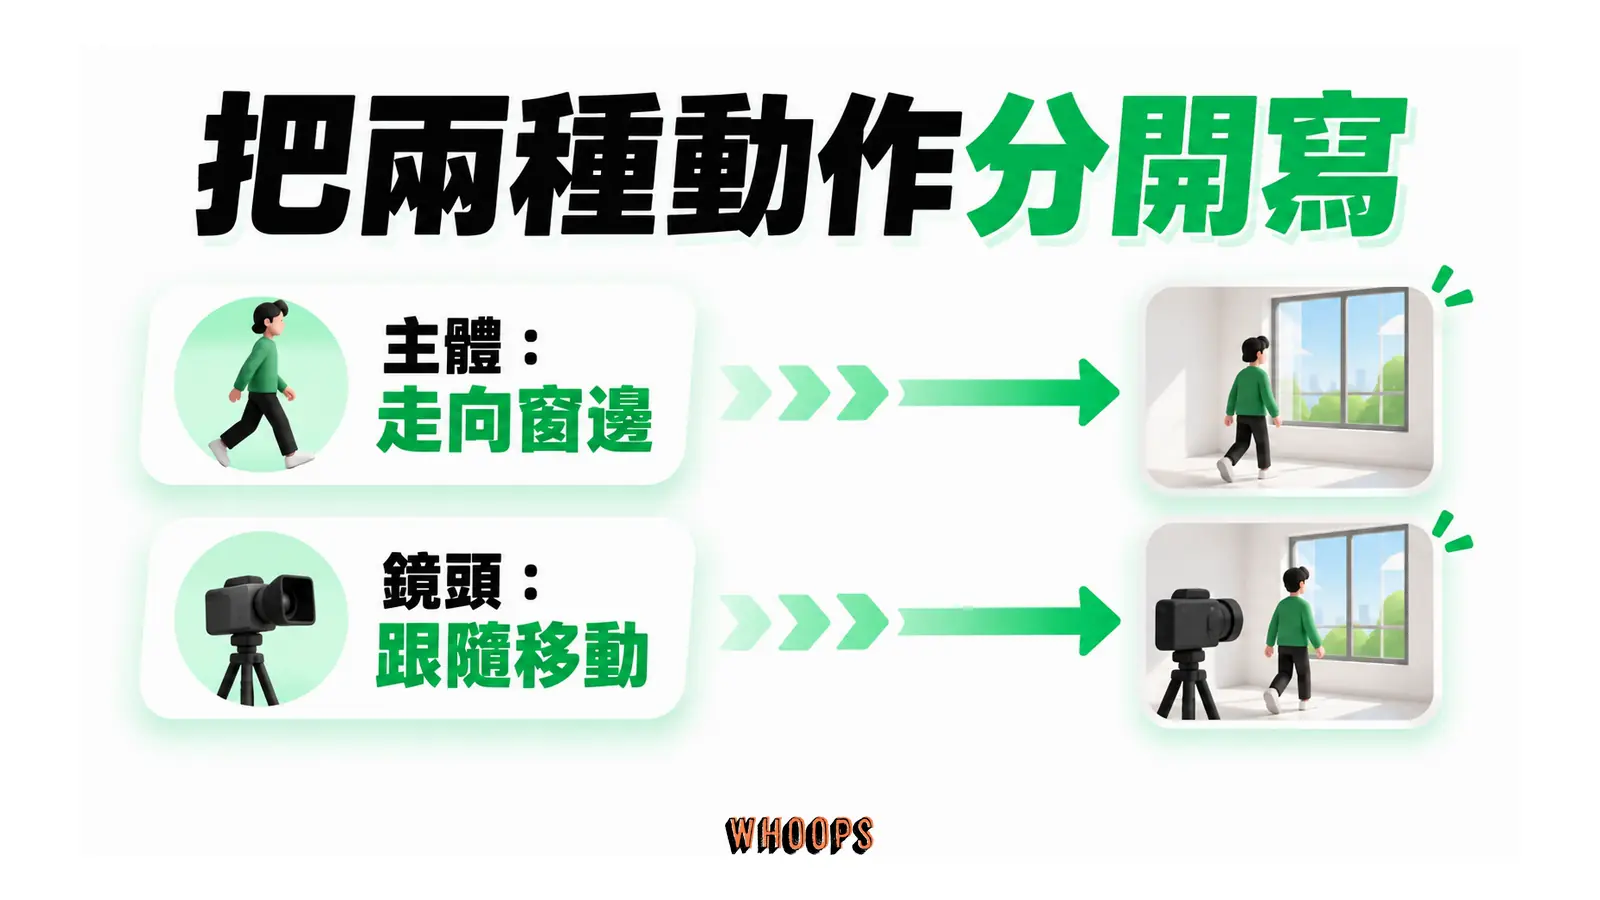
七個位置裡最值得單獨練的是第二與第三格的分工。Sora 2 封存指南把這條講成原則:每顆鏡頭給一個明確的鏡頭移動,加一個明確的主體動作,鏡頭的動寫一個子句,主體的動寫另一個子句。混在同一句「鏡頭跟著她開心地走向窗邊」裡,兩種運動會互相稀釋,模型常乾脆兩個都削弱。拆成「slow tracking shot following her(鏡頭)」加「she walks to the window, smiling(主體)」,指令遵循度立刻不同。
第六格聲音對照各家寫法:Veo 官方給三種提示法,對白用引號括住並可加語氣註記、音效直接明寫(輪胎摩擦、引擎怒吼)、環境音描述整個場景的聲音風景;Sora 封存指南更進一步建議把對白寫在獨立區塊,讓模型分得清哪些是畫面描述、哪些是台詞,四秒鏡頭配一到兩句短對白就好,長講話會打壞節奏。不需要聲音的工具或場景,這格整個略過。
第七格用參數思維想:Veo 走 durationSeconds 與 aspectRatio,Seedance 在文字結尾掛 --duration 5 --resolution 1080p 這類指令,Midjourney 則有 --motion、--bs 等參數。敘述裡寫「來一段 8 秒」不如參數選 8 秒精準,這也是下一節對照四家文件時最實用的差異點。
四家官方文件怎麼教:同一套骨架的四種格式
以下內容全部以 2026 年 10 月 9 日一手查證的官方文件為本,逐家拆格式。看懂差異後你會發現:換工具不用重學,只要把七位置骨架換個包裝。
Google Veo 3.1:要素清單式,鏡頭與聲音詞彙直接內建
Google 官方 Veo 3.1 文件(2026 年 10 月 9 日查證)把提示詞當一張要素清單:主體、動作、風格是必想的三項,鏡頭位置與運動建議用 aerial view、eye-level、top-down shot、dolly shot、worm's eye,構圖用 wide shot、close-up、single-shot、two-shot,對焦與鏡頭效果用 shallow focus、deep focus、macro lens、wide-angle lens,氛圍用藍色調、夜晚、暖色調這類色彩光線描述。官方強調好提示詞「描述性強且清楚」,先有核心想法、再用修飾詞疊細節、加上影片專用術語,並提醒文字輸入上限 1,024 個 token。
聲音是 Veo 的強項,原生生成、預設開啟。官方建議對白放在引號裡並可註記語氣(例如低聲呢喃),音效明寫出來(輪胎尖叫、引擎轟鳴),環境音則描述場景的聲音風景。參數側,單次生成四、六或八秒,比例 16:9 或 9:16,解析度 720p 起跳;1080p、4K 與參考圖功能都必須選八秒,參考圖最多三張;輸出 24fps 並帶 SynthID 浮水印。要強調臉部細節時,官方有個小密技:在描述中用 portrait 這個字。
Seedance:自然語言分段,鏡頭切換語撐起多鏡頭敘事
Seedance 官方提示詞指南(ByteDance 旗下 BytePlus 平台的官方文件,頁面載明 2026 年 9 月 28 日更新)給了一條清晰的學習曲線。入門公式只有「主體+動作」:一隻小貓對鏡頭打呵欠,就能出片。進階到多動作時,照時間線描述單人多動作或多人多動作;再進階到運鏡,官方明說模型能準確回應 tracking shot、pan left/right、truck left/right 這類提示,推、拉、搖、移、環繞、跟隨、上升、變焦各有示範,還能組合成一鏡到底的長鏡頭。提示詞語言明載支援中文與英文。
Seedance 官方最獨特的一段是多鏡頭能力:同一份提示詞裡可以寫多個場景切換,用「camera switch/鏡頭切換」這句話連接,模型會依描述維持主體、風格與場景的連續性,換場後再描述新出現的人或物即可。這是「一支提示詞生一整段分鏡」的官方路徑,跟自己切三段提示詞再剪輯是兩種工作法,前者快、後者可控,重要專案建議後者。參數掛在文字結尾,格式如 --resolution 1080p --duration 5 --camerafixed false,比例支援 1:1、3:4、4:3、16:9、9:16、21:9 六種。版本現況補一筆:上述指南以 1.0 為本,BytePlus 的 Seedance 2.5 官方頁(2026 年 10 月 9 日查證)已把單次生成上限從 2.0 系列的十五秒拉到三十秒,並支援時間戳編輯與單次最多五十個參考素材(官方拆分為最多三十張圖片、十支影片、十段音訊),寫長分鏡的籌碼比指南時代多了一倍。
Sora 2:四段式結構,細節提示換控制力
先交代狀態,這份文件要當歷史文件讀。Sora 2 官方提示詞指南(OpenAI 開發者文件,2026 年 3 月更新版)目前標示為封存文件;OpenAI 的官方停產說明載明 Sora 網頁版與應用程式已於 2026 年 4 月 26 日停止服務,官方棄用清單則載明 Videos API 與 sora-2 系列模型於 2026 年 9 月 24 日退役、未列替代方案(均於 2026 年 10 月 9 日查證)。產品與 API 都已走入歷史,不代表這份指南沒有價值:它是四份官方文件裡對提示詞結構講解最完整的一份,方法論照樣搬去任何現行工具用。
它的結構最像一份迷你拍攝腳本,四段依序是:場景散文描述(人物、服裝、場景、天氣)、電影攝影(鏡頭、取景與情緒)、動作清單(每條一個明確節拍或手勢)、對白區塊(配合片段長度的短句)。官方哲學一句話:提示詞越詳細,控制力與一致性越高;提示詞越輕,模型自由發揮的變異越大。同一份提示詞重跑結果也會不同,這是生成機制的本質,不是 bug。
這份文件有兩個值得抄走的細節。第一是強弱詞對照:官方示範把模糊的「cinematic look」換成「Anamorphic 2.0x lens, shallow DOF, volumetric light」這種具體鏡頭與光線語言,成效差距立見,這正是鏡頭詞彙表的價值。第二是剪輯策略:官方建議把長鏡頭拆成多段短生成再接起來,指令遵循度更好。角色一致性的思路同樣可遷移:為重複出現的人物建立固定的視覺與文字錨點,提示詞裡用名字點名他們。編輯既有影片時,官方原則是「一次一個受控變更」,例如同鏡頭換成 85mm 鏡頭,這個原則等等在除錯段還會用到。
Midjourney V1:圖轉影片,動態強度二分
Midjourney 官方影片文件(2026 年 10 月 9 日查證)代表另一個流派:先有一張圖,再讓它動。生成從五秒起跳,之後可用延長功能每次加四秒、最多四次、總長上限二十一秒;解析度預設 480p,Standard、Pro 與 Mega 方案可在 Fast Mode 選 720p。它不要求你寫完整分鏡,提示詞重心只有一個:動態。
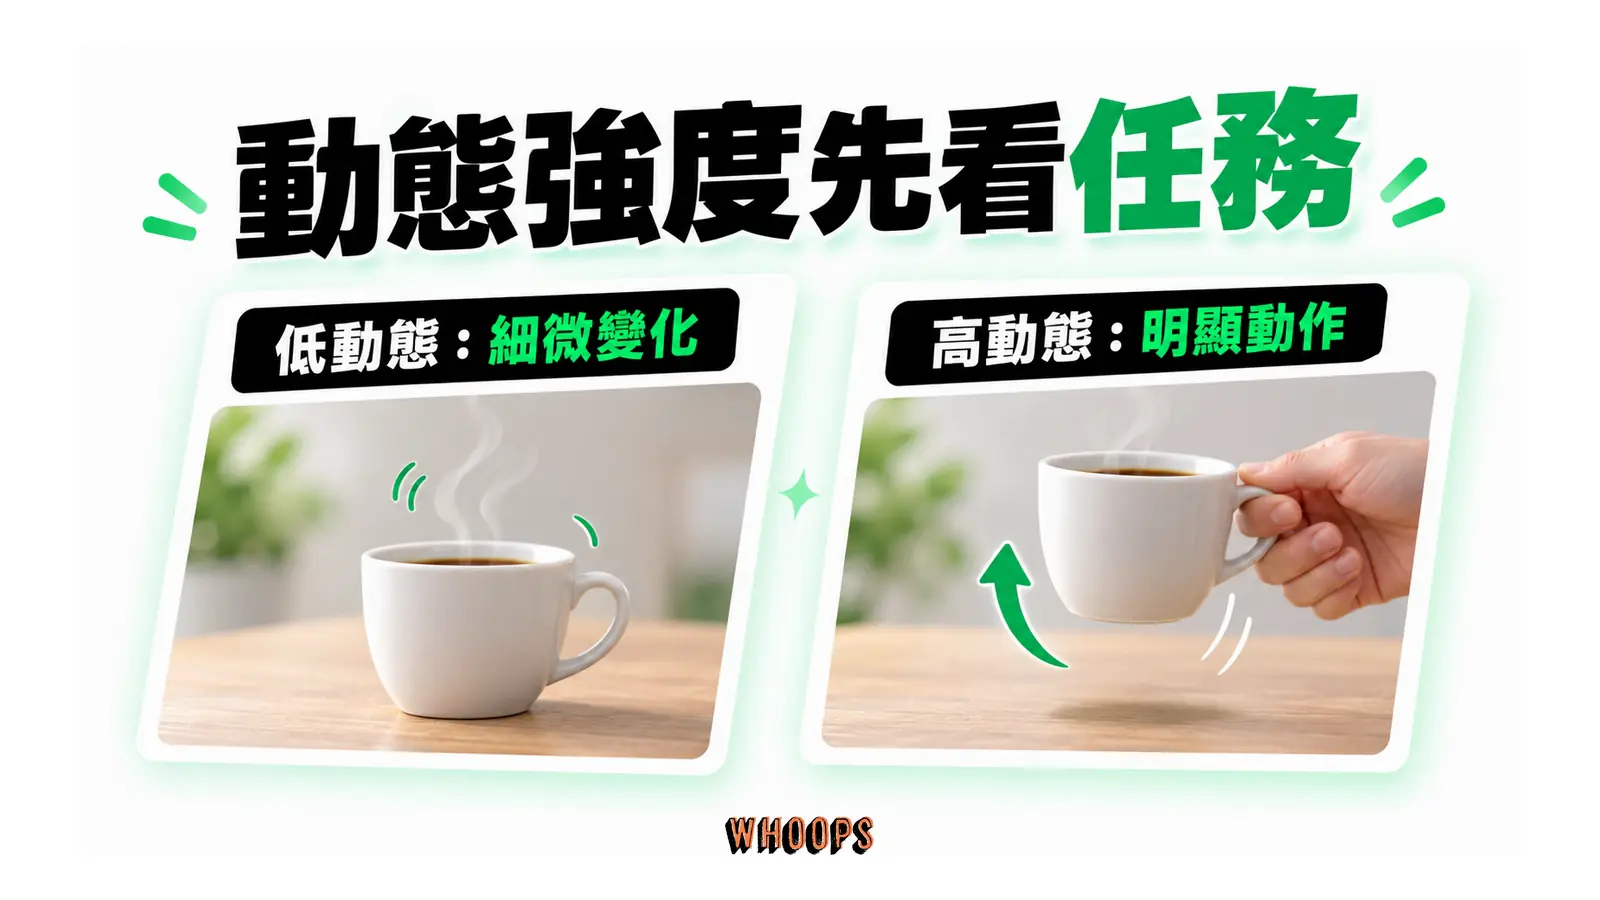
動態強度是二分的,官方定義值得原文理解:低動態為預設,容易產出靜態場景、低鏡頭運動、慢動作或細微的人物動作;高動態容易產生大鏡頭動作與大的人物動作,但也可能出現不寫實或怪異的動作。參數寫法是 --motion low 與 --motion high。官方還有一個 --raw 參數,降低 Midjourney 慣常添加的創意發揮,讓你的提示文字對結果更有影響力,追求精準控制的場合記得開。這套「強度二分」簡化了決策:要氛圍選低、要事件選高,微調交給提示詞裡的動作描述。
JSON 欄位式與時間戳寫法:官方規格還是社群慣例
網路上流傳的 Veo JSON 提示詞,把畫面描述、風格、鏡頭、燈光、聲音等拆成一格格欄位,看起來很工程、很好複製。要分清楚的是:Veo 官方文件列的是要素建議的清單,並沒有要求或定義 JSON 格式;欄位式寫法是創作者社群把官方要素搬進 JSON 的整理術。它不是沒價值,好處很實際:欄位名固定,批次生產時容易逐欄修改、容易版本管理、餵給程式或工作流也方便。但別把它當成官方規格崇拜,工具更新時,跟著官方文件改要素,而不是跟著某份流傳的欄位模板。
時間戳寫法現在有了官方版本。1.0 時代的官方指南用文字明寫切換點,Seedance 2.5 的官方文件則明載時間戳編輯,可對指定時間點做精準修改,提示詞範例也示範了用 @Image 1、@Video 1 這類標籤直接點名參考素材的寫法;Sora 封存指南處理時間順序用的則是節拍清單。結論很簡單:分段概念通用,具體語法以你手上那個平台的官方說明為準,查不到就退回自然語言按順序描述,這是所有模型都吃的基本款。
原創範例庫:五個行銷場景的提示詞長怎樣
以下五個範例全部是原創示意,場景取自行銷與知識內容工作的真實需求,提示詞可以整段複製去改。每個範例先給兩句中文分鏡思考,再給英文提示詞本體;英文刻意用簡單句型,術語按前面詞彙表挑選。想先補齊「這支影片要放在哪、給誰看、怎麼被衡量」的策略層,可以搭配短影音行銷攻略先想清楚再動手,提示詞解決的是執行層。
中文想法怎麼變成英文提示詞
不需要很好的英文,需要的是固定句型。把骨架七位置排成一個句子模板:[景別] of [主體+外觀錨點], [運鏡], [動作按順序], [風格], [光線氛圍], [聲音], [技術參數]。以場景一的咖啡杯為例,逐格填入就得到完整句子,中間只用逗號連接,不用勉強寫成複雜從句;唯一的例外是第七格技術參數,照前面的原則用工具參數指定、不寫進敘述句。模型的閱讀方式接近掃描關鍵詞與短語,句子素一點完全無妨,術語用對比文法漂亮重要十倍。
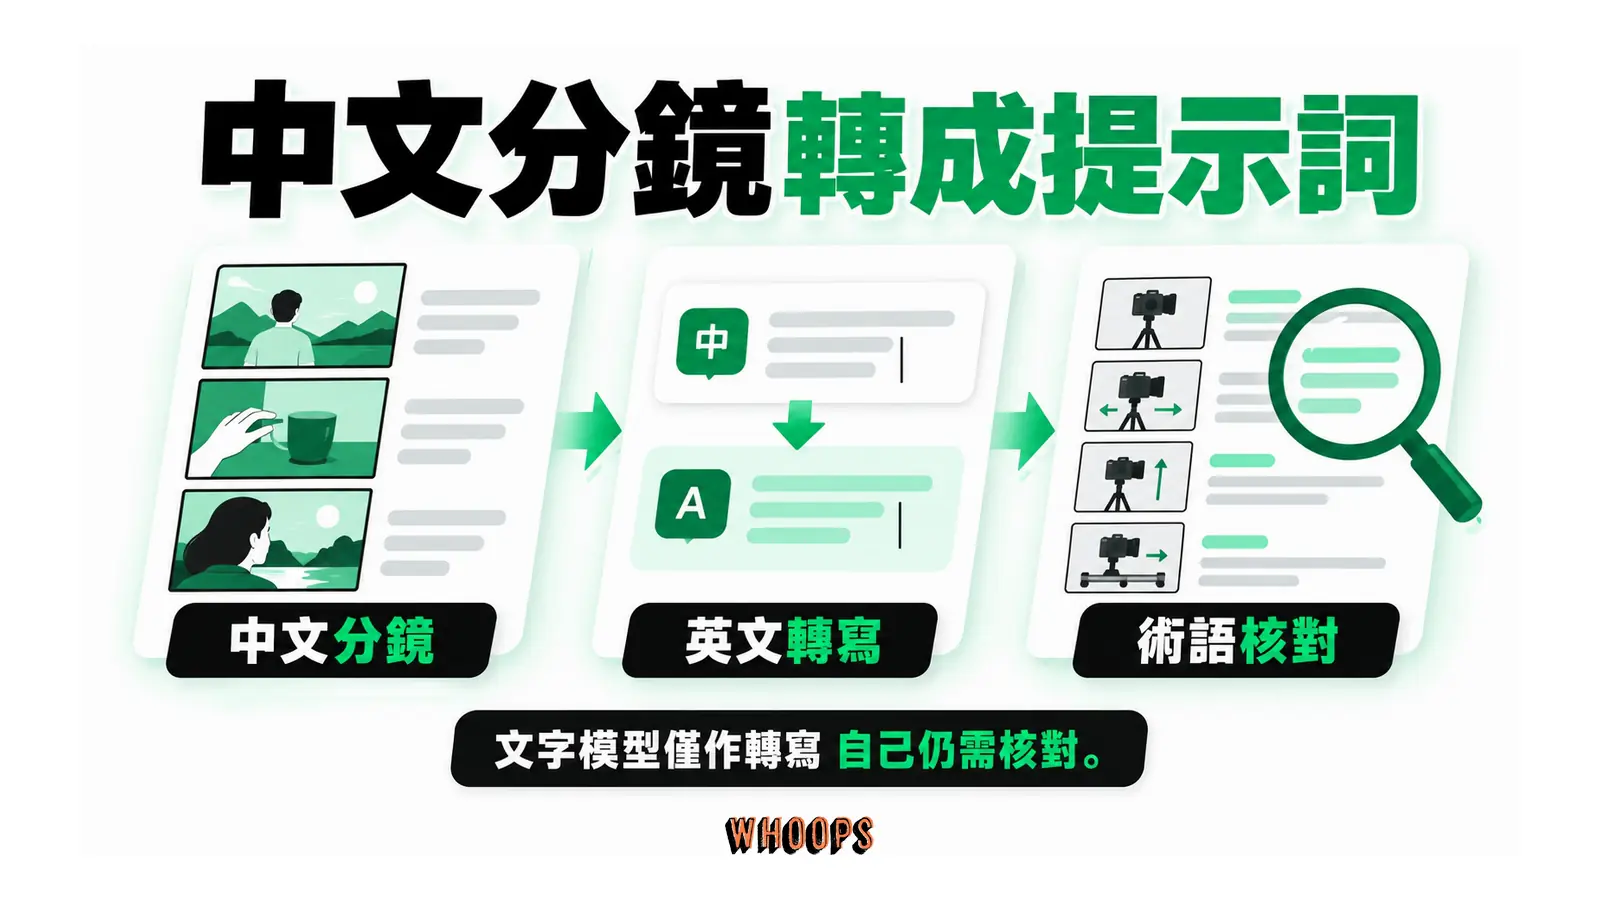
中文直譯有兩個常見誤區。一是把「運鏡」翻成 camera movement 然後接中文思維的長描述,正確做法是直接用具名術語 slow dolly in、orbit shot,一個詞就是一個指令。二是同一個概念中英並列寫兩次,以為加強語氣,其實可能讓模型收到兩個相近但不同的訊號,例如 dolly in 和 zoom in 同一句出現,模型會在兩種透視之間妥協出怪結果。一個概念一個詞,選了就不要回頭。
不想逐字手寫,工作流可以外包一半:把中文分鏡寫清楚,再請任何一個文字模型按七位置骨架轉成英文,自己回頭只檢查術語正確與否。網路上的影片提示詞產生器做的本質上就是這一步,產出品質完全取決於你餵進去的中文物料有多具體,中文端先照這篇的分鏡與骨架想清楚,工具端隨便換都好用。
場景一:電商產品動態展示(八秒、兩顆鏡頭)
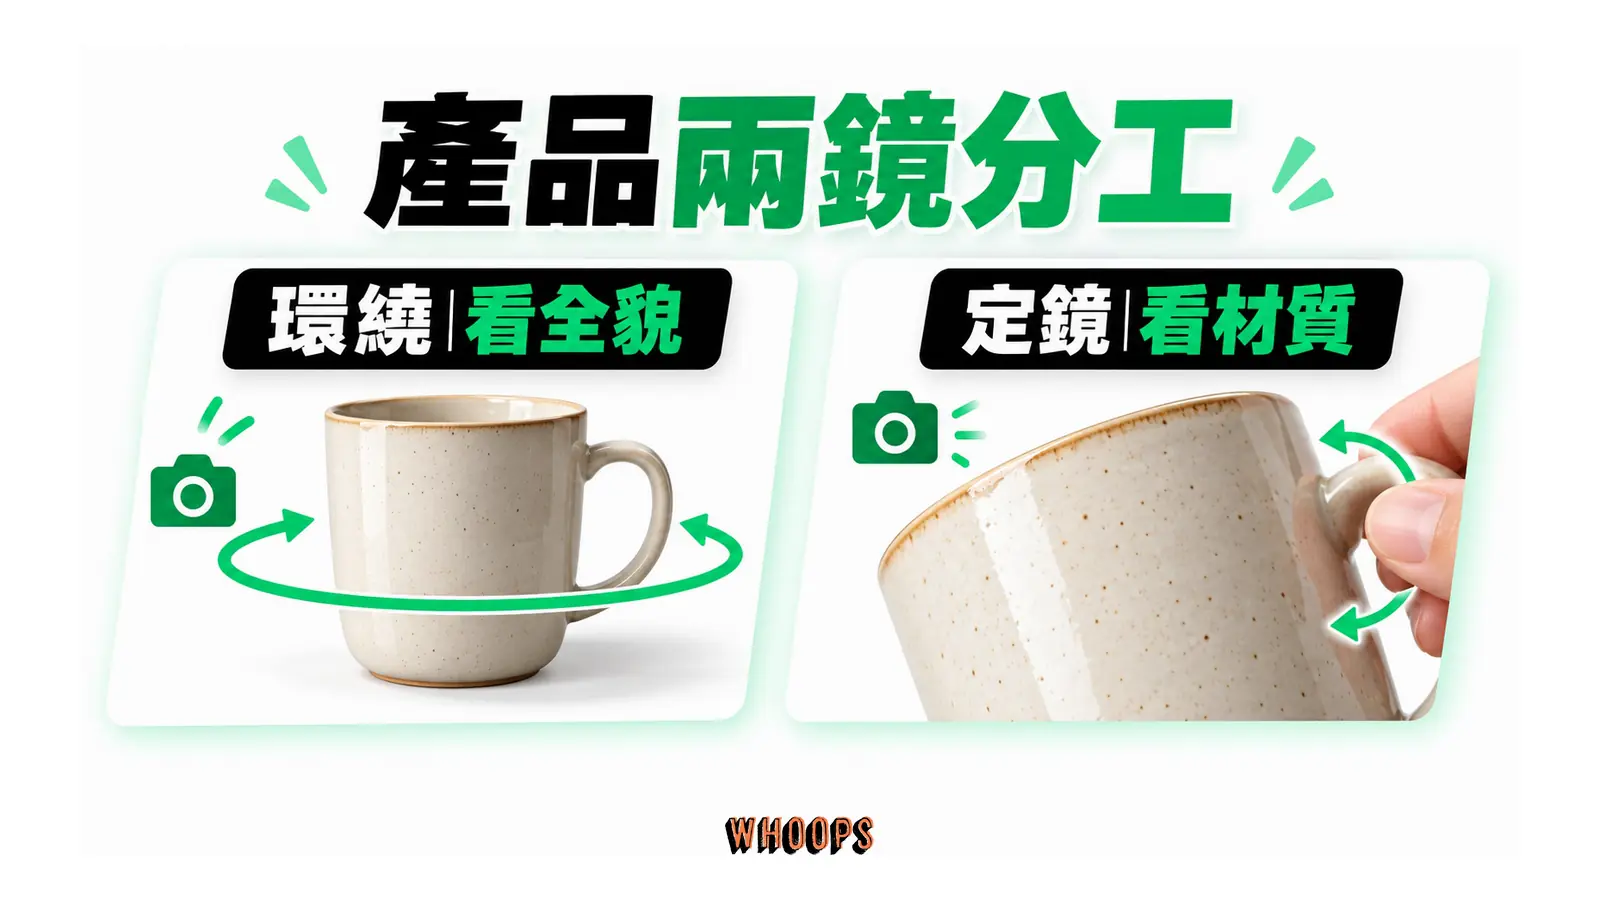
目標是讓商品頁的靜態圖動起來。分鏡:先一顆環繞鏡頭立體展示產品,再切特寫給質感細節,鏡頭都保持穩定,把視覺重心留給產品本身。
Medium shot of a matte ceramic coffee mug in warm beige, sitting on a light oak table by a window. Slow orbit shot around the mug, camera stays steady at eye level. Soft morning window light, gentle shadows. Photorealistic product film style. Ambient sound: quiet cafe atmosphere with faint background chatter.
Camera switch. Extreme close-up of the mug's glaze texture, static locked-off camera. A hand enters the frame and gently rotates the mug a quarter turn. Shallow depth of field, warm tones. SFX: soft ceramic slide on wood.
這組的關鍵抉擇:兩顆鏡頭刻意換運鏡策略,第一顆用 orbit 給立體感、第二顆改成定鏡讓手部動作當主角,避免連續兩顆都在動造成視覺疲勞;Camera switch 一詞借用 Seedance 官方的換鏡語法,在支援多鏡頭的平台上可直接連著跑。材質錨點寫了霧面陶瓷與淺橡木,跨鏡頭色調就靠這兩個錨鎖住;秒數照第七格原則用參數指定,整段一次生成掛 --duration 8,拆成兩顆分別生成再剪接則各掛 --duration 4。
場景二:知識型內容開場圖解(六秒、單鏡頭)
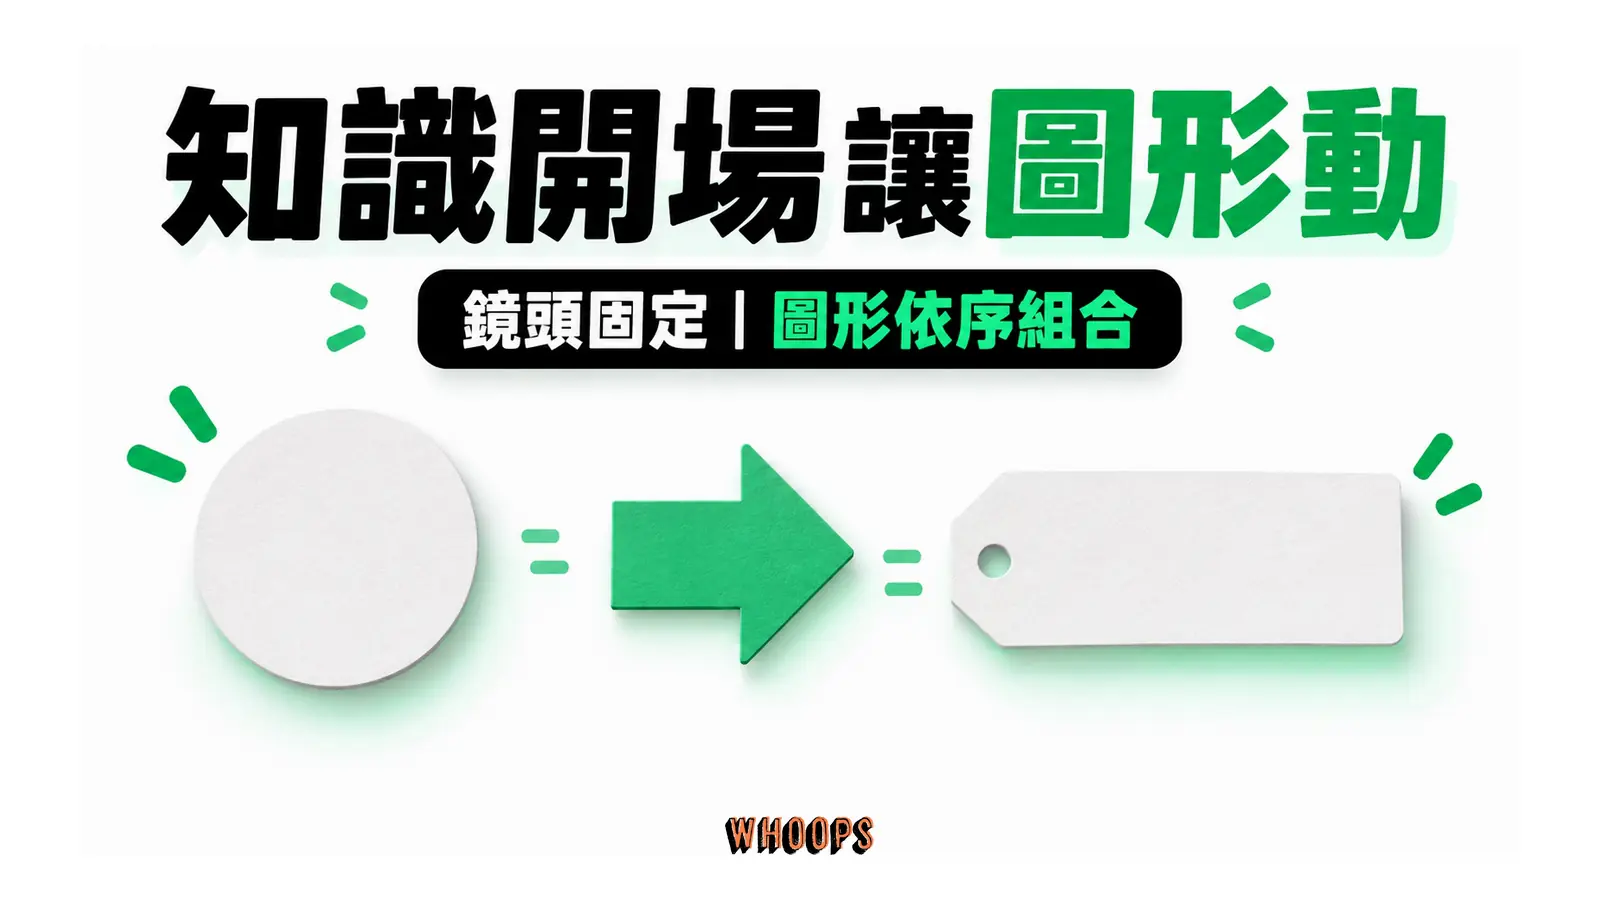
目標是影片頻道或課程單元的開場動態圖。分鏡:一個俯視桌面的定鏡,抽象圖形自己組合成標題概念,乾淨不搶戲,讓旁白有空間進來。
Top-down bird's-eye view of a clean white desk, static locked-off camera. Minimal geometric paper cutouts slide into frame one by one, arranging themselves into a simple diagram. Bright even studio lighting, minimalist style with generous negative space. Smooth stop-motion feel, 2 seconds per beat: circle slides in, arrow connects, label card settles at center.
知識內容開場的通則在這裡:鏡頭絕對不動,動作全部留給圖形,觀眾的注意力才不會被運鏡搶走;時間順序用每兩秒一拍明寫,模型對節奏的掌握比一句「慢慢組合」可靠得多。文字卡片刻意寫 label card 而非指定文字內容,字進剪輯軌道後製,避開模型寫字出錯字的雷區。六秒規格照第七格用參數下:Seedance 掛 --duration 6,Veo 用 durationSeconds 6。
場景三:社群短影音鉤子(直式 9:16、五秒)
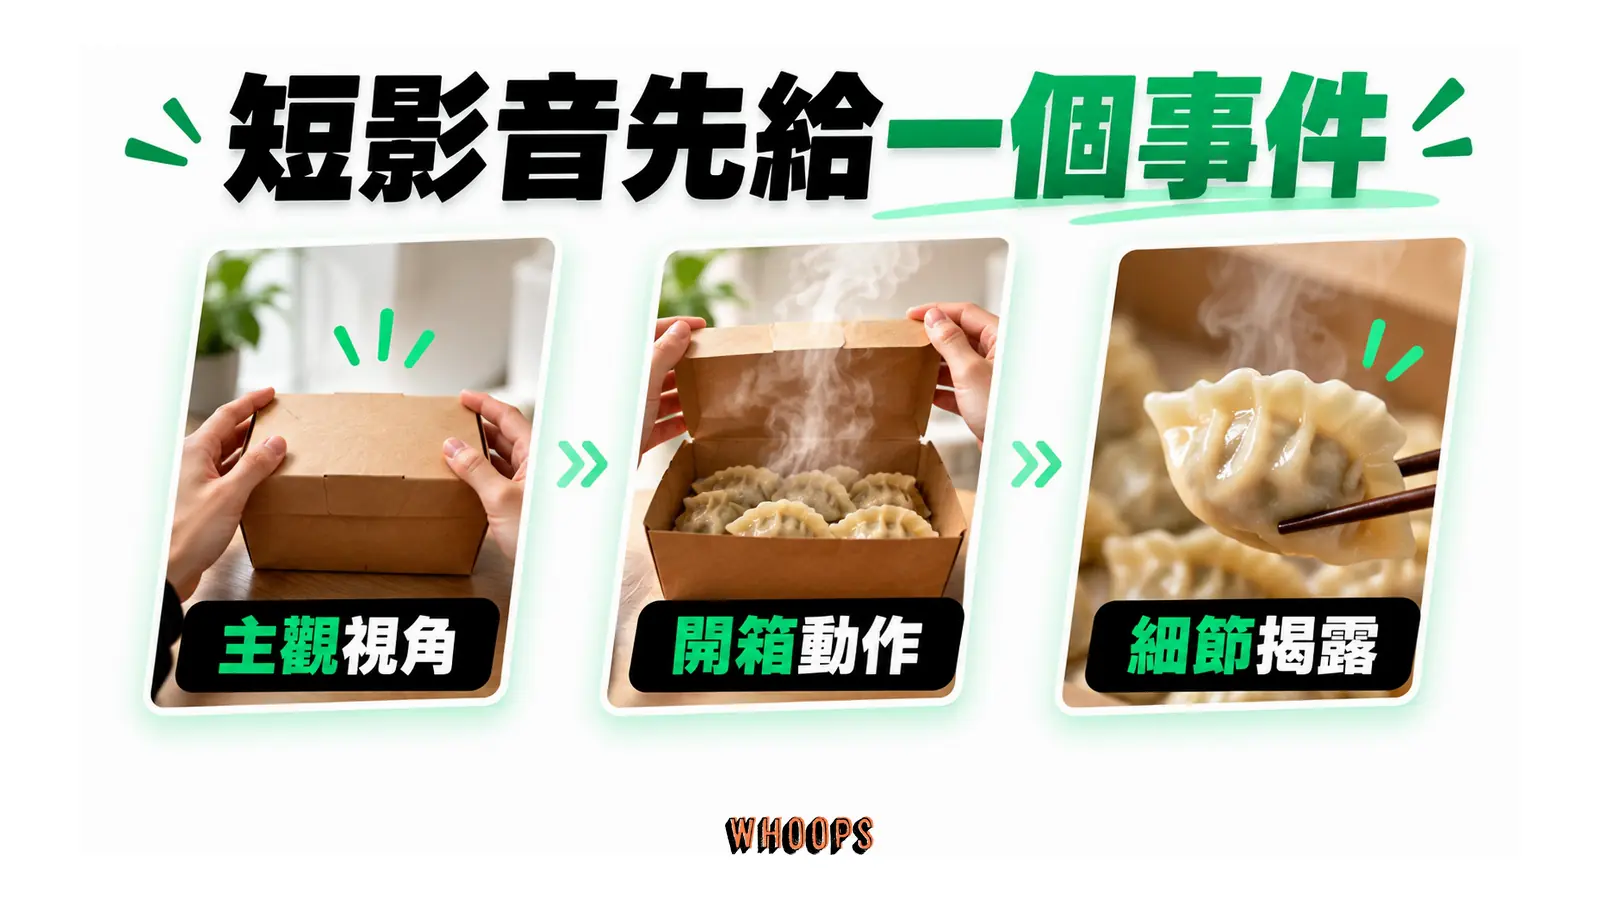
目標是滑動快速的社群動態裡搶住前三秒。分鏡:主觀視角製造沉浸感,一個簡單動作加一個視覺反差,動態強度走高,訊息單一。
POV first-person shot, handheld feel: hands open a kraft paper lunch box on a street food stall counter. Quick tilt down as steam rises from fresh dumplings, then push in on the glistening skin texture. Warm afternoon sunlight, vivid saturated colors, energetic street food vlog style. SFX: sizzling pan, lively market ambience.
直式鉤子的寫法重點在於動作密度與視角選擇:POV 讓觀眾變成當事人,開箱這個動作自帶懸念,前兩秒就有事發生。這裡刻意用了兩個運鏡(tilt down 接 push in),是社群內容可接受的例外,因為每個都短促且服務同一個動作弧;若改成兩個長運鏡疊加,成品通常會晃到看不清主體。五秒與九比十六這兩個規格同樣不寫進敘述,照第七格用參數下:Seedance 在文字結尾掛 --duration 5,比例依平台參數設定;Veo 沒有五秒檔位,同樣的鉤子退到四秒或六秒(durationSeconds 4 或 6),比例用 aspectRatio 9:16。
場景四:品牌形象 B-roll 空鏡(八秒、單鏡頭)
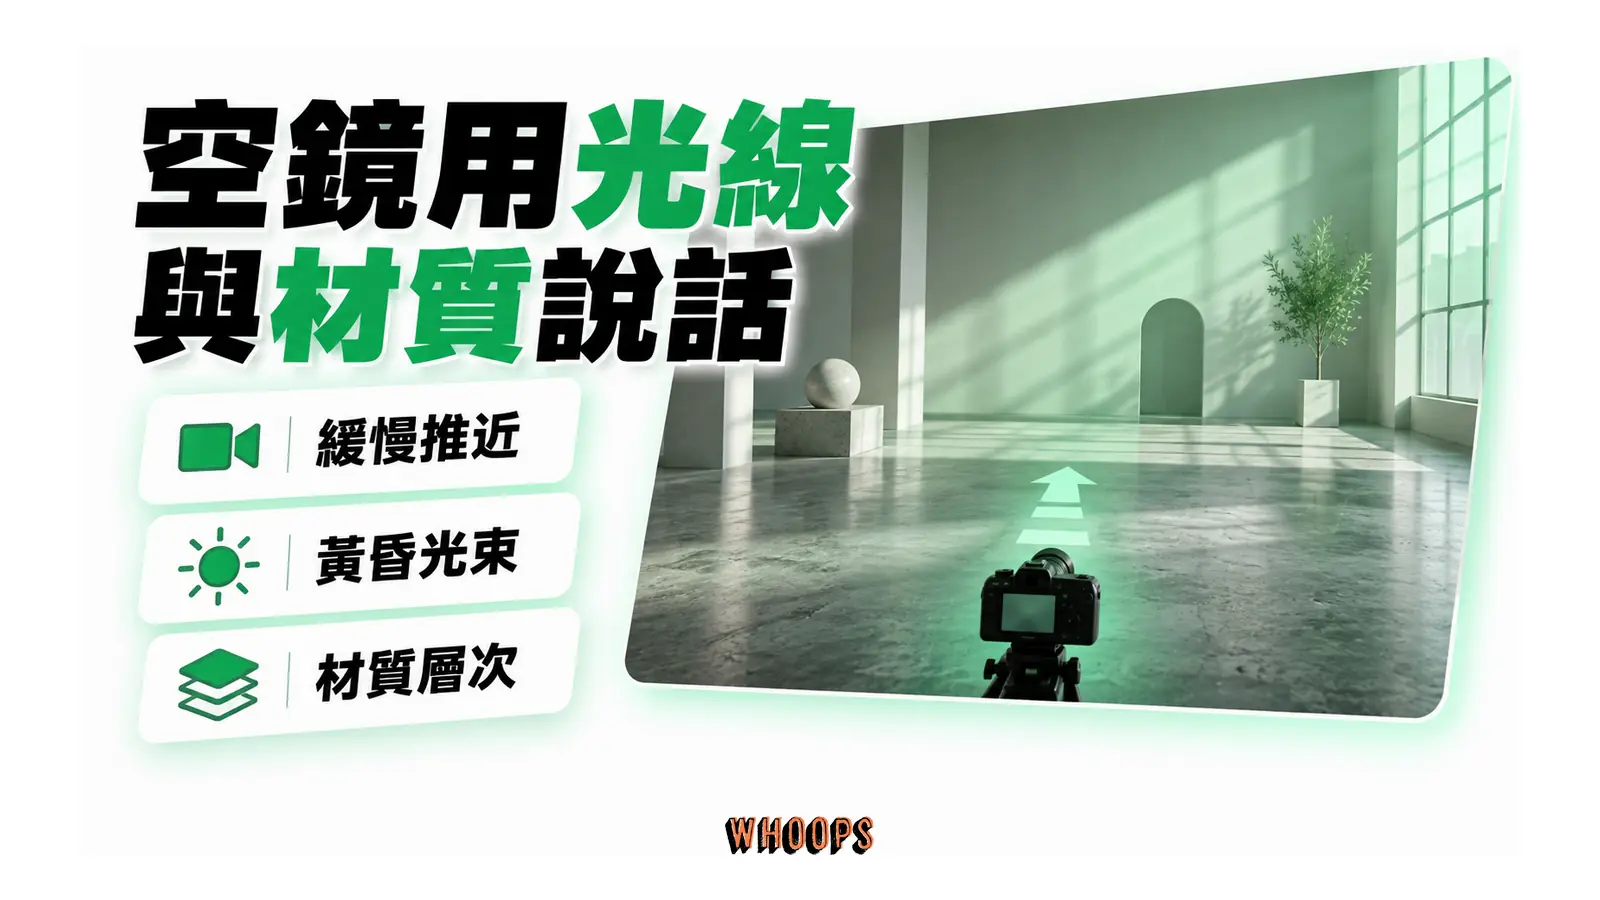
目標是官網或簡報裡鋪氣氛的背景素材,不放主角、不放字。分鏡:一顆緩慢移動的空鏡,讓光線和材質變化當主角,動態壓低,質感拉高。
Wide shot of an empty modern studio space at dusk, slow dolly in through soft golden-hour light streaming across a concrete floor. Dust particles float in the light beams. Muted warm palette, shallow cinematic grade, 35mm film texture with subtle grain. Ambient sound: distant city hum, quiet and calm.
B-roll 的品質全押在光線與材質兩格:黃昏光束加漂浮灰塵給了畫面層次,35mm 底片顆粒這種風格錨比形容詞有效,Sora 封存指南把模糊的「電影感」換成具體鏡頭語言的示範就是同一個道理。空鏡唯一要克制的是運鏡,slow 一個字讓 dolly in 不至於變成搶戲的推進,放在文字後面當視覺底襯剛好。八秒正好是 Veo 的原生檔位(durationSeconds 8),Seedance 則掛 --duration 8。
場景五:活動資訊宣傳字卡(六秒、單鏡頭)
目標是活動預告或公告的動態字卡。注意:AI 影片模型生成文字容易出錯字,正確做法是讓它生成乾淨的動態背景,字卡進剪輯軟體後製上字,這個分工能省掉大量重滾。
Medium shot of flowing silk fabric in deep teal, slow-motion waves rolling from left to right, static camera. Soft diffused lighting with a subtle rim highlight along each fold, elegant premium style. One dominant motion arc: fabric rises, crests, and settles. No text, no watermark.
字卡情境最容易犯的錯是叫模型直接生成活動名稱與日期,中文文字的生成正確率目前仍不可靠,重滾十次不如後製一次。這份提示詞的分工清楚:模型只負責讓絲綢波動得優雅,末尾明寫不要文字與浮水印,後製軌道再疊上品牌字體與資訊,版權與字體授權也都留在自己手上。六秒同樣用參數指定(--duration 6 或 durationSeconds 6),敘述裡的動作弧已按這個長度設計。
首拍不滿意怎麼改:一層一層除錯
首拍成功率沒有人掛保證,專業工作流的核心是除錯順序,靠系統化修正取代祈禱運氣。第一步先診斷問題出在七個骨架位置的哪一層,第二步只改那一層再重跑。Sora 封存指南對影片編輯的原則「一次一個受控變更」同樣適用提示詞迭代:一次改兩三個地方,成效變好你也不知道是哪個改動的功勞,變壞更不知道要退哪個。
常見症狀對照表如下,按「先懷疑什麼、再改什麼」排。
左右捲動檢視完整表格
| 症狀 | 先改哪層 | 具體做法 |
|---|---|---|
| 主體走樣、細節飄 | 主體 | 加外觀錨點:材質、顏色、服裝、年代;跨鏡頭掛參考圖或角色功能 |
| 動作沒演出來或亂接 | 動作 | 拆成節拍按順序寫;一鏡只留一個動作弧;秒數不夠就拆鏡頭 |
| 鏡頭亂晃亂轉 | 運鏡 | 只留一個運鏡詞;要穩就明寫 static locked-off camera |
| 風格飄忽、質感不對 | 風格 | 用具體片型錨住(70 年代浪漫電影、停格黏土動畫),比形容詞堆疊有效 |
| 光線平淡、情緒不到位 | 燈光氛圍 | 寫光源方向加色溫(黃昏逆光、窗邊柔光),不要只寫「好看的光」 |
| 對白嘴型不同步、音效突兀 | 聲音 | 對白縮到一到兩句短句;音效明寫、環境音減量;別跟畫面描述一起改 |
| 物理崩壞、肢體怪異 | 技術參數 | 縮短時長、降低動態強度(Midjourney 從 high 退回 low);若是動作過載,回到動作層簡化後再重跑 |
| 每次重跑結果差太多 | 技術參數 | 固定 seed;Veo 官方明說 seed 不保證重現、但能略為提升穩定度 |
改的順序本身也是省錢順序。主體與動作的修正回報率最高,先改這兩層;運鏡與風格排在中間;物理崩壞的情況反覆改提示詞收效有限,降動態強度或縮時長往往更直接。成本紀律再往前推一層:試拍階段用低解析度短秒數跑,確認分鏡與動作成立後再上全畫質,Midjourney 的 480p 到 720p、各家的解析度選項都是為這個節奏設計的。把試錯留在便宜的那端,是 AI 影片製作跟傳統拍片最不一樣的省法。
走一次完整的除錯案例。假設場景一的第一版成果有兩個問題:杯子顏色從霧面米色漂成亮面白色,第二顆鏡頭的手轉動作太快像快轉。診斷:第一個是主體層的錨點沒被吃進去,第二個是動作層缺乏節奏。第二輪只改兩處,主體句加上 matte beige glaze, non-glossy finish 重複錨定材質,動作句把 rotates a quarter turn 改成 slowly rotates a quarter turn over three seconds。重跑後顏色穩了、轉速正常,但發現光線比第一版暗,第三輪只補光線格 soft morning window light from the left,其他一律不動,三輪收工。整個過程每一輪都能講清楚改了什麼、為什麼,這比一次改五個地方然後擲筊可靠得多。
交付前檢查:浮水印、授權與五項目檢
生成完成不等於可交付。授權與浮水印是第一道檢查:Veo 官方文件載明輸出帶 SynthID 隱形浮水印,其他平台是否加可見浮水印、隱藏標記或中繼資料,依平台與當下輸出設定而定,交付前自己確認;商業使用的權利範圍依你訂閱的方案與平台條款而定,接案或代理出稿前,花十分鐘讀完當下方案的授權條款,比事後爭議便宜太多。真實人物肖像與知名角色的生成禁令也要在發想階段就避開,多數平台對真人臉孔與侵權角色有明確限制。
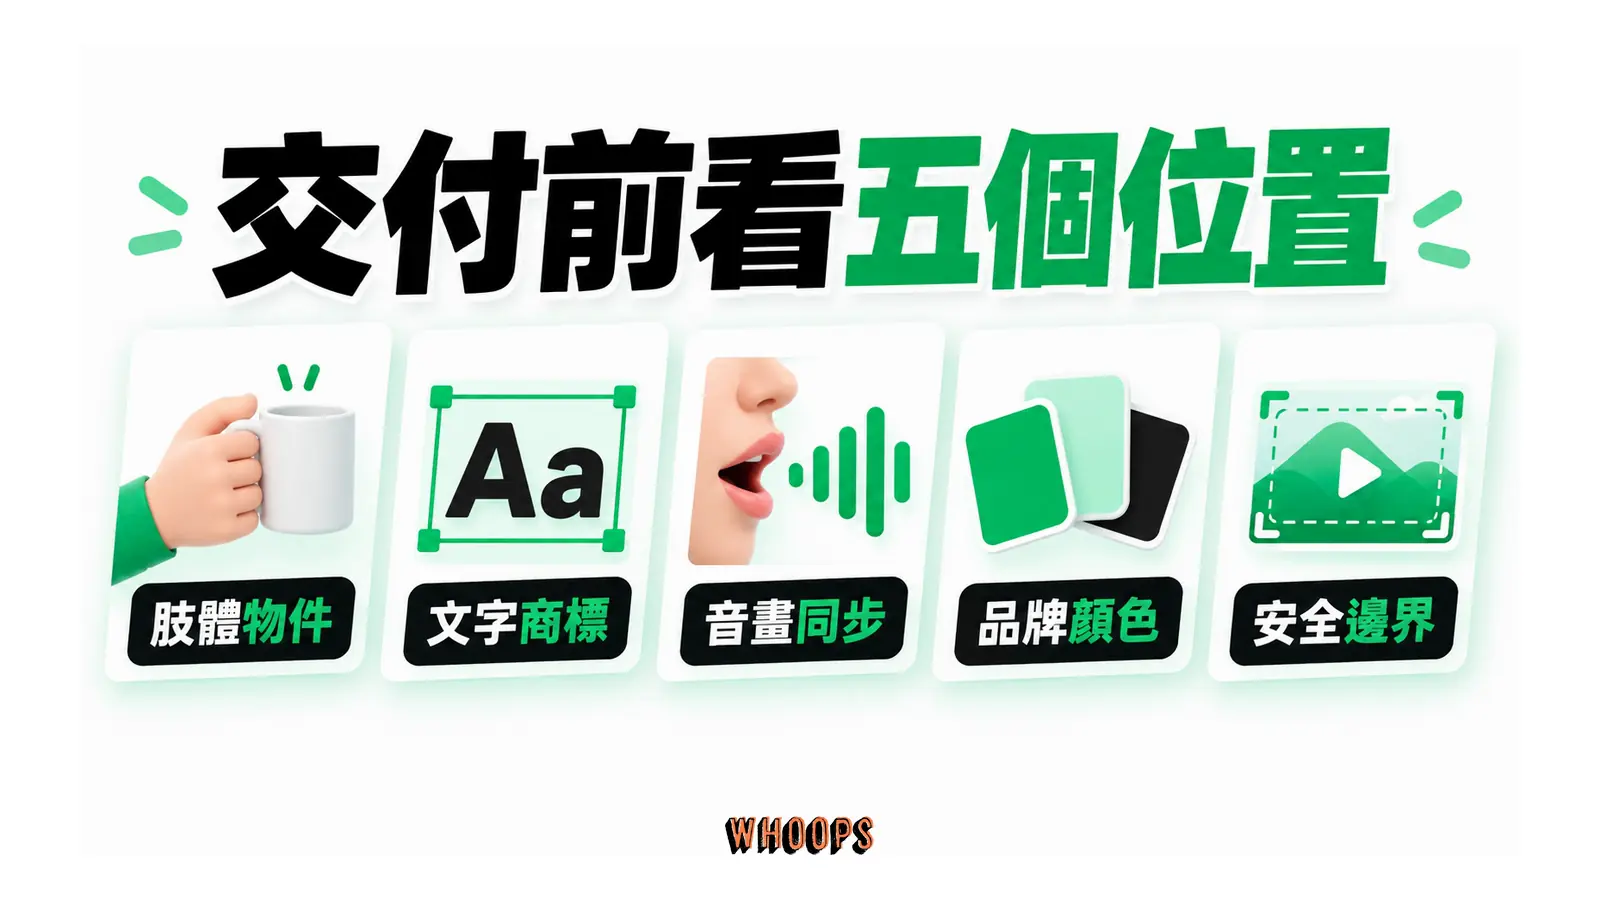
畫面本身跑一張五項檢查清單:手指與物件邊緣有沒有融在一起或數量錯誤,這是現階段模型最常見的穿幫點;文字與商標有沒有被模型自己生成(該後製的就要後製);音畫是否同步,對白尤其要逐句聽;品牌色與產品色是否還原,色漂通常出在風格格寫太重;比例與安全邊界,直式素材的上下緣在部分播放器會被介面裁掉,關鍵訊息留在中間八成。清單跑完才進剪輯軟體做最終整合。
還有一件小事值得養成習慣:把每一版的提示詞連同成果編號存檔。生成結果不可完全重現,同一份提示詞下次跑會得到不同版本,哪一版提示詞配哪一版成果,只存在你的檔案裡。這份紀錄在客戶要求「跟上次那支一樣感覺」的時刻就是唯一的依靠。
工具怎麼選:把這套框架帶去對的平台
這篇講的是跨工具的提示詞框架,選工具本身是另一個題目,這裡給分流原則與站內延伸。第一個分流是入口:文字直生影片(Veo、Seedance 等)適合從零到有;圖轉影片(Midjourney V1、多數平台的圖生影片模式)適合已經有定稿視覺、要它動起來的場合,首幀圖的品質直接決定成片上限,生圖階段的選型與提示詞寫法看生圖模型完整比較。已經有一張平圖、只想加 3D 視差動態、不需要真實影片敘事,Immersity AI 的 2D 轉 3D 動畫是更輕的路。
第二個分流是需求強度。要原生對白與音效,選聲音原生生成的模型;要長片,先查各家單次上限與延伸次數,Midjourney 的二十一秒上限與 Veo 的八秒就是兩個量級;要多鏡頭一致性,Seedance 官方的鏡頭切換連續性是最直接的現行路徑,用參考圖錨定角色的思路(Sora 封存文件示範過)也能在多數平台實現。單一工具的完整教學,例如 Grok 從生圖到影片的工作流,站內有Grok Imagine 完整指南;台灣可用的影片模型牌桌與費用比較,則看MiniMax 指南的影片選型段,兩篇都把該工具的提示詞細節講得更深。
Google 生態的現況值得單獨記一筆:Gemini API 的影片功能總覽頁(2026 年 10 月 9 日查證)目前把 Gemini Omni Flash 列為建議的預設影片模型,Veo 3.1 留給場景延伸、末幀控制與既有管線整合這類專門能力。工具推陳出新的速度快,但七位置骨架與鏡頭詞彙表是跟著電影語言走的東西,換模型不用重學。
第一支影片的建議路徑:挑一件你真的要用的素材,寫一顆八秒內的單鏡頭,七位置骨架填滿,運鏡只用一個詞,先用低解析度跑兩輪除錯,再上全畫質。骨架跑順一次,之後每個新工具都只是換包裝。